コース
PyTorchで学ぶTransformerモデル
2時間
9.2K
KTransformers はオープンソースの推論フレームワークで、推論中にCPU と GPU が別々のエキスパートを能動的に実行できるため、GPU メモリよりはるかに大きい Mixture-of-Experts(MoE)モデルを動かせます。vLLM のようなフレームワークも重みの CPU へのオフロードに対応していますが、KTransformers は MoE モデルのスパース構造に特化して設計されています。
本チュートリアルでは、KTransformers と SGLang を使って、重みが 192 GB の VRAM に収まらない 320B パラメータの GLM-5.3-Flash を実行します。CPU と GPU のメモリ使用量を監視し、エキスパートの配置を試し、OpenAI 互換 API をテストし、Pi に接続してローカルのコーディングエージェントとして使います。
要点はシンプルです。CPU メモリを単なるあふれ用ストレージとして扱うのではなく、KTransformers は推論時に CPU 計算と GPU 計算の両方を活用します。
KTransformers は、GPU の VRAM と CPU の RAMを組み合わせて超大規模言語モデルを実行するためのオープンソース推論フレームワークです。通常は大規模モデルを提供するには重みの多くを GPU メモリに読み込む必要があり、GLM-5.3-Flash クラスのモデルではコストが急増します。
KTransformers は異なるアプローチを取ります。多くの MoE エキスパート重みをシステムメモリに保持し、GPU メモリは GPU 加速の恩恵が大きい推論部分のために確保します。
これは MoE モデルと相性が良好です。というのも、すべてのトークンで全エキスパートを使うわけではないからです。例えば GLM-5.3-Flash には 288 のルーティング対象エキスパートがありますが、各トークンではそのうち 8 個(と共有エキスパート 1 個)だけをルーターが選択します。したがって KTransformers はエキスパート計算を CPU と GPU に分散できます。
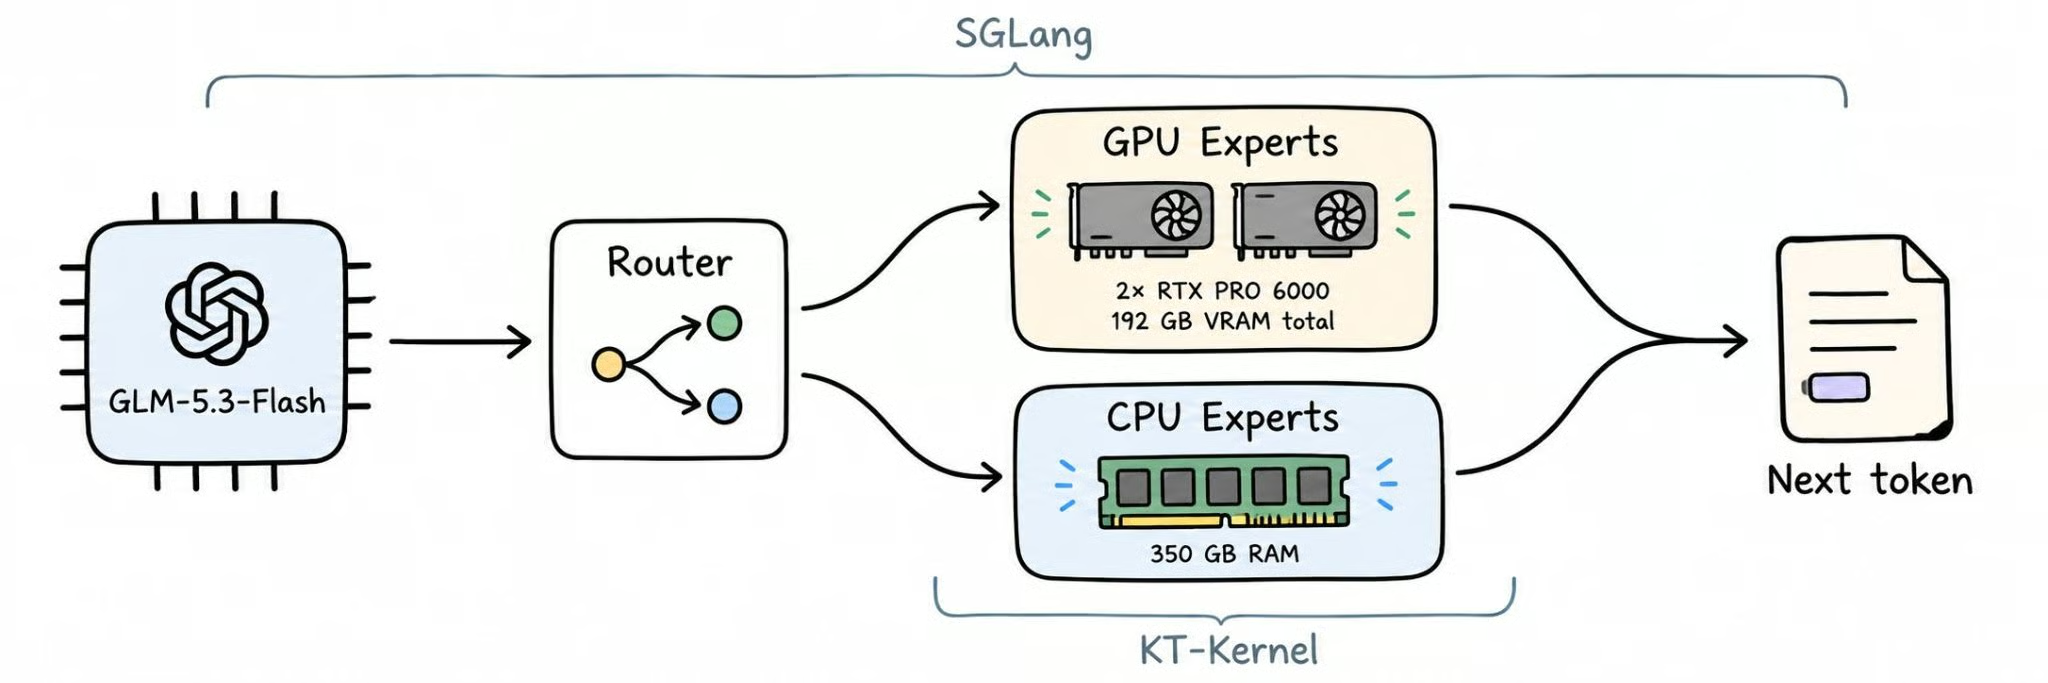
現在の KTransformers スタックは、異種 CPU-GPU 推論のためにKT-Kernel と SGLangを統合しています。各コンポーネントの役割は次のとおりです。
KTransformers は、エキスパートスケジューリングのチュートリアルで説明されているように、ワークロードのパターンに応じてエキスパート配置を変更することも可能です。
言い換えると、KTransformers はCPU メモリと GPU メモリをひとつの推論システムとして扱い、モデル全体を GPU の VRAM に収める必要をなくします。これによって、本来ならはるかに多くの GPU メモリを必要とする非常に大きな MoE モデルを、より少ない GPU メモリのハードウェアで動かせます。
GLM-5.3-Flash は Z.ai が 2026 年 8 月に MIT ライセンスで公開した、ネイティブにマルチモーダル対応のオープンウェイト MoE モデルです。名称に「Flash」とありますが、実際には大規模で、総パラメータは 320B、トークンあたりのアクティブは約 18B です。
ローカル推論で重要な仕様は次のとおりです。
zai-org/GLM-5.3-Flash)は約 306 GiBKTransformers は公式の FP8 重みを直接読み込むため、変換や追加の量子化は不要です。ベンチマークやモデルの全体像は、GLM-5.3-Flash ガイドを参照してください。
GLM-5.3-Flash に関しては、ハードウェア要件の多くがシステム RAM に関わります。KTransformers 公式の GLM-5.3-Flash チュートリアルでは、少なくとも 350 GB のシステムメモリ確保を推奨しています。
本チュートリアルでは、おおよそ次の構成の RunPod インスタンスを使用します。
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11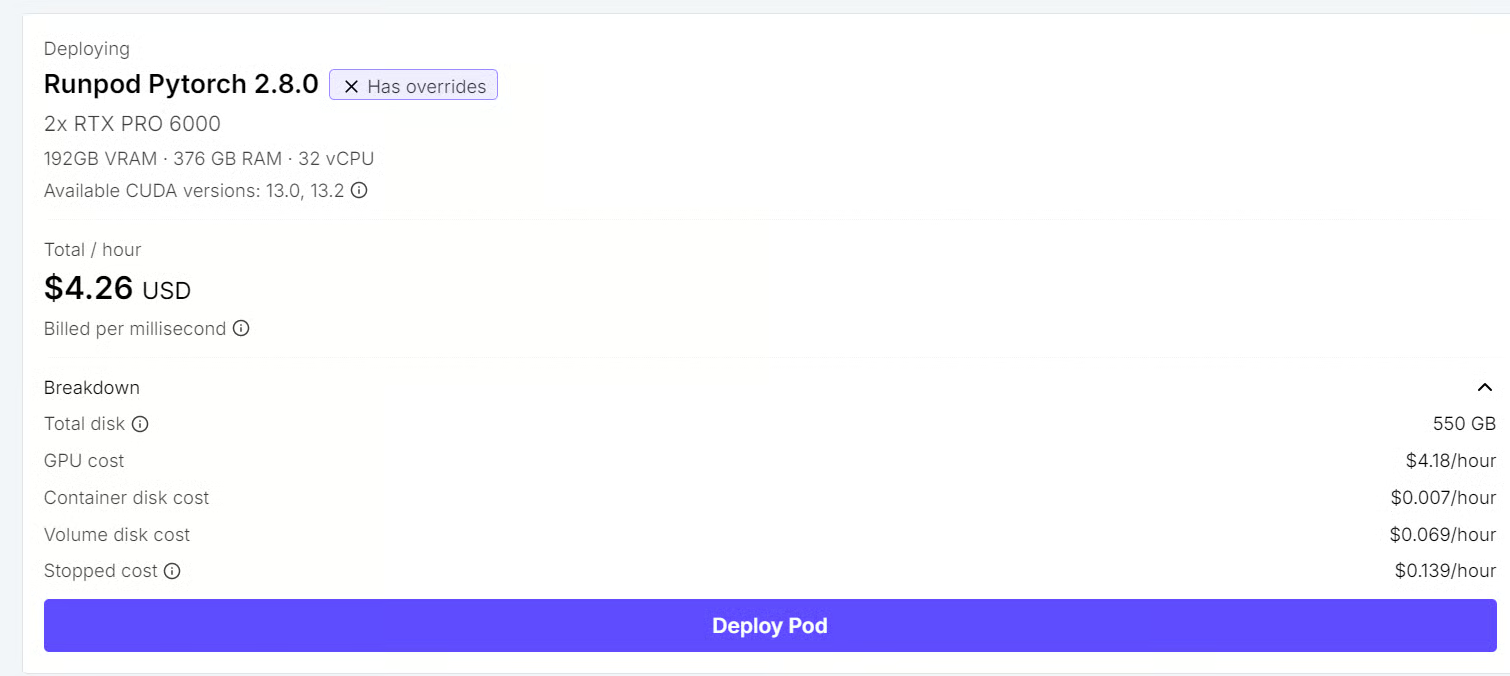
GLM-5.3-Flash の公式 FP8 チェックポイントは約 306 GiB(約 329 GB)で、GPU は合計 192 GB の VRAM しかありません。したがってフルモデルをそのまま GPU メモリだけに読み込むことはできません。
代わりに、KTransformers は MoE の重みの大部分をシステム RAM に保持し、有用な計算を GPU に寄せます。350 GB の推奨値は、モデル重みと実行時オーバーヘッドを収める余裕を持たせるためのものです。
GPU メモリを増やしても、この構成で RAM が不要になるわけではありません。CPU メモリは KTransformers の異種推論設計の重要な要素であり、エキスパートの重みは RAM に置いたまま、GPU は加速効果の高い部分を担当します。
現行の GLM-5.3-Flash 実装には、CPU と GPU に関して以下の要件もあります。
はい。十分なシステム RAM と対応 CPU があれば可能です。公式チュートリアルには --kt-num-gpu-experts 0 を設定する単一 GPU 構成があり、MoE エキスパートは CPU 側で処理されます。
本稿では RTX PRO 6000 を 2 枚使用していますが、これは厳密な必須条件ではありません。2 枚目の GPU は、最小構成を攻めて調整するのではなく、比較的新しい KTransformers 実装を試す際の余裕(VRAM と検証のしやすさ)を確保するためです。
Python 3.11 のクリーンな環境を作成し、SGLang サポート付きで KTransformers をインストールします。
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
KTransformers、KT-Kernel、SGLang、CUDA が正しく認識されているか確認します。
kt version次のような出力が表示されるはずです。
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
これで KTransformers のランタイムと SGLang バックエンドがインストールされ、使用準備が整っていることが確認できます。
サーバーを起動する前に、Hugging Face から公式の GLM-5.3-Flash チェックポイントをダウンロードします。
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
チェックポイントは約 306 GiB あるため、帯域によってはダウンロードに時間がかかります。
続いて、KTransformers にローカルのモデルパスを指定します。
export MODEL_PATH=/workspace/GLM-5.3-Flashここでは 2 枚の RTX PRO 6000 を使い、2-way のテンソル並列で GLM-5.3-Flash を起動します。モデルは最大 1M トークンのコンテキストに対応し、公式の例では検証済みの 501,025 トークン構成を使用しています。初回は動作検証を優先して、メモリ使用量が読みやすい 32K のコンテキストで開始します。
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45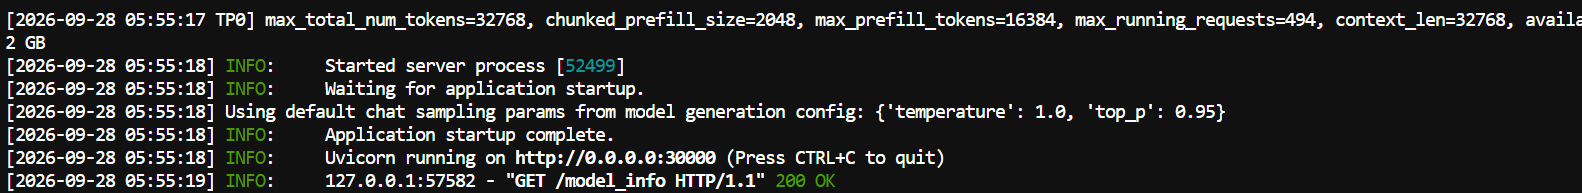
この構成では、ポート 30000 で OpenAI 互換の SGLang サーバーとしてモデルを公開します。--tp-size 2 で 2 枚の GPU を使用し、KTransformers は MoE の一部を CPU に残しつつ、選択したエキスパートを GPU に配置します。
設定は初回実行向けにあえて保守的です。32K コンテキスト、GPU 静的使用率 85%、GPU エキスパート 14、CPU 推論スレッド 64。サーバーの安定が確認できたら、コンテキストを広げたり、GPU エキスパートを増やしたり、メモリ設定を調整してスループット向上を狙ってください。
上記の大半は標準的な SGLang のオプションです。以下が、KTransformers が CPU/GPU 間でワークロードを分割する方法を制御するフラグです。
| Flag | Value | What it does |
|---|---|---|
--kt-method |
FP8 |
エキスパート重みの精度を設定します。GLM-5.3-Flash のネイティブ FP8 チェックポイントに合わせています。 |
--kt-cpuinfer |
64 |
エキスパート計算に使用する CPU スレッド数です。 |
--kt-threadpool-count |
2 |
CPU スレッドプールの数です。通常は NUMA ノード数に合わせます。 |
--kt-num-gpu-experts |
14 |
各 MoE レイヤーで GPU に配置するエキスパート数です。 |
--kt-expert-placement-strategy |
uniform |
GPU エキスパートの選定方法です。他に frequency、front-loading、random があります。 |
--kt-gpu-prefill-token-threshold |
2048 |
この長さを超えるプロンプトでは、プレフィルが GPU 側の layerwise パスに切り替わります。 |
サーバーが起動したら、KTransformers がGPU の VRAM とシステム RAMをどのように使っているかを確認し、GPU 常駐エキスパート数を変えてリソース使用と性能の変化を見てみます。
RunPod では、free -h はコンテナではなくホスト全体の RAM を示す場合があり、誤解を招きます。GPU メモリとコンテナメモリを個別に監視するのがよいでしょう。
新しいターミナルを開いて GPU を監視します。
watch -n 1 nvidia-smi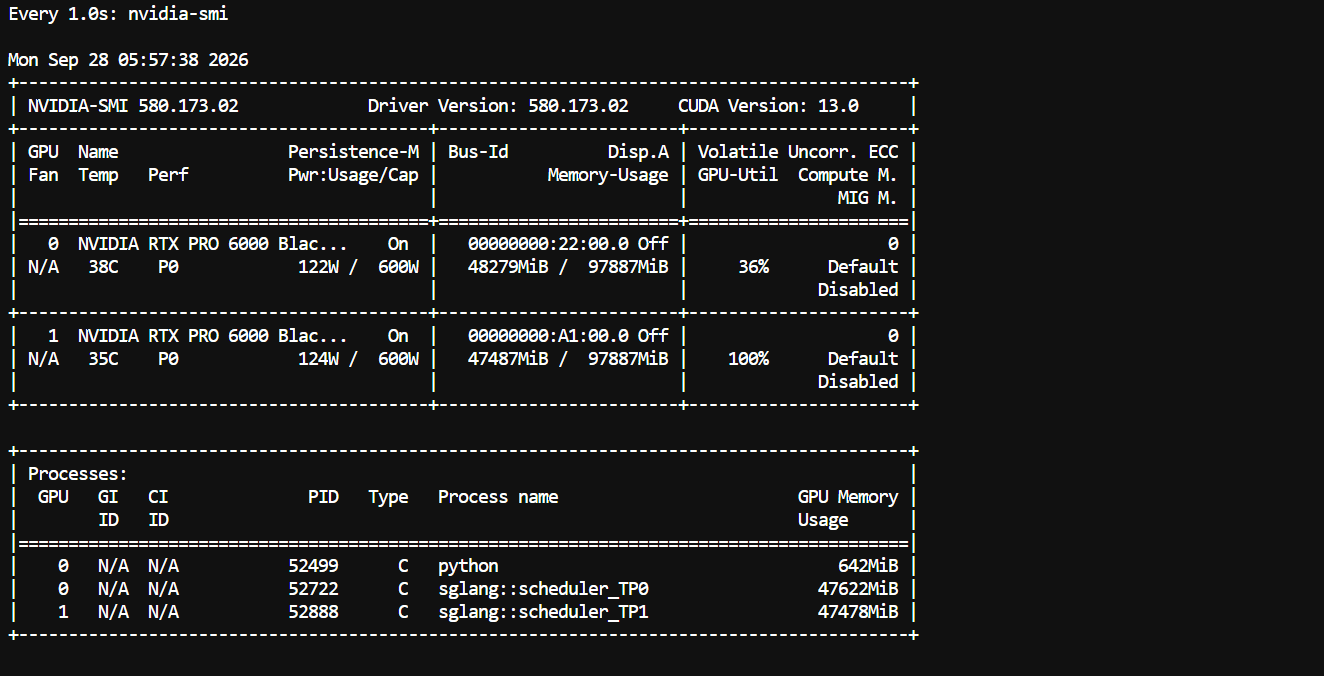
現在の構成では、モデルをフルで読み込んでも GPU あたり約 48 GB 程度で、大きな余りが見られます。これは、より多くのエキスパートを GPU に配置できる余地があるか、十分な RAM があれば単一 GPU 構成を試せる可能性を示唆します。
コンテナ RAM は cgroup のメモリカウンタを直接参照します。
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'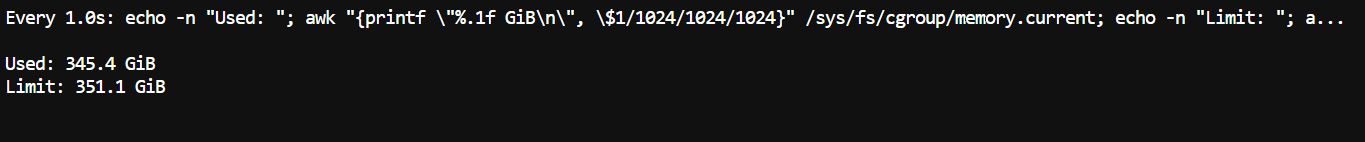
利用可能なシステム RAM の大部分が、モデル重みと CPU 側エキスパートで占められているはずです。これは想定どおりで、KTransformers は多くの MoE エキスパートを VRAM ではなく RAM に留める設計だからです。
--kt-num-gpu-experts を調整次に、--kt-num-gpu-experts の値を変えてサーバーを再起動します。例えば以下を比較します。
0
10
20
--kt-num-gpu-experts は、各 MoE レイヤーあたり GPU に配置するエキスパート数を制御します。0 の場合、エキスパート計算は CPU 側に留まり、値を増やすほど多くのエキスパートが GPU メモリへ移ります。
各構成で、GPU の VRAM 使用量、コンテナ RAM 使用量、毎秒トークン数、最初のトークンまでの時間を比較してください。一般に、GPU エキスパートを増やすと VRAM 消費は増えますが、CPU 側のエキスパート実行が減ることで、十分な VRAM がある場合は推論性能の向上が期待できます。
公式チュートリアルの注意点をひとつ。GLM-5.3-Flash で Layerwise Prefill が有効なとき、現行実装では GPU 常駐エキスパート数を 0 に正規化する挙動があります。実行間で VRAM 使用量がほとんど変わらない場合は、その可能性が高いです。
この実験から見える KTransformers の利点は、CPU RAM と GPU VRAM を同一の推論システム内で調整可能な資源として扱える点です。MoE 全体を GPU に載せる要件に縛られず、メモリ配置と速度のトレードオフが取れます。
サーバーが起動していれば、SGLang の OpenAI 互換 API 経由でモデルの登録と実際のリクエスト送信を確認できます。
まず、モデルが登録済みか確認します。
curl http://localhost:30000/v1/models次にテストプロンプトを送ります。
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'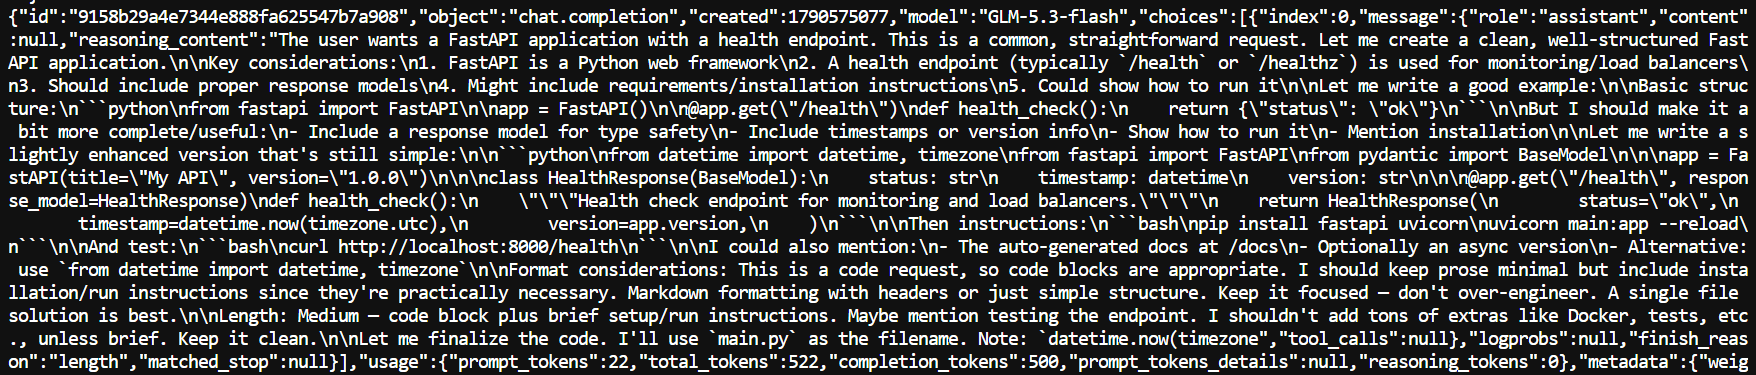
正しく動作していれば、生成コードや使用状況統計を含む通常のチャット補完レスポンスが返ってきます。
Pi は軽量なコーディングエージェントで、OpenAI 互換の任意のモデルをバックエンドとして利用できます。これにより、GLM-5.3-Flash を単なるプロンプト応答にとどめず、コーディング作業に直接使えます。
次のインストールスクリプトで Pi を導入します。
curl -fsSL https://pi.dev/install.sh | sh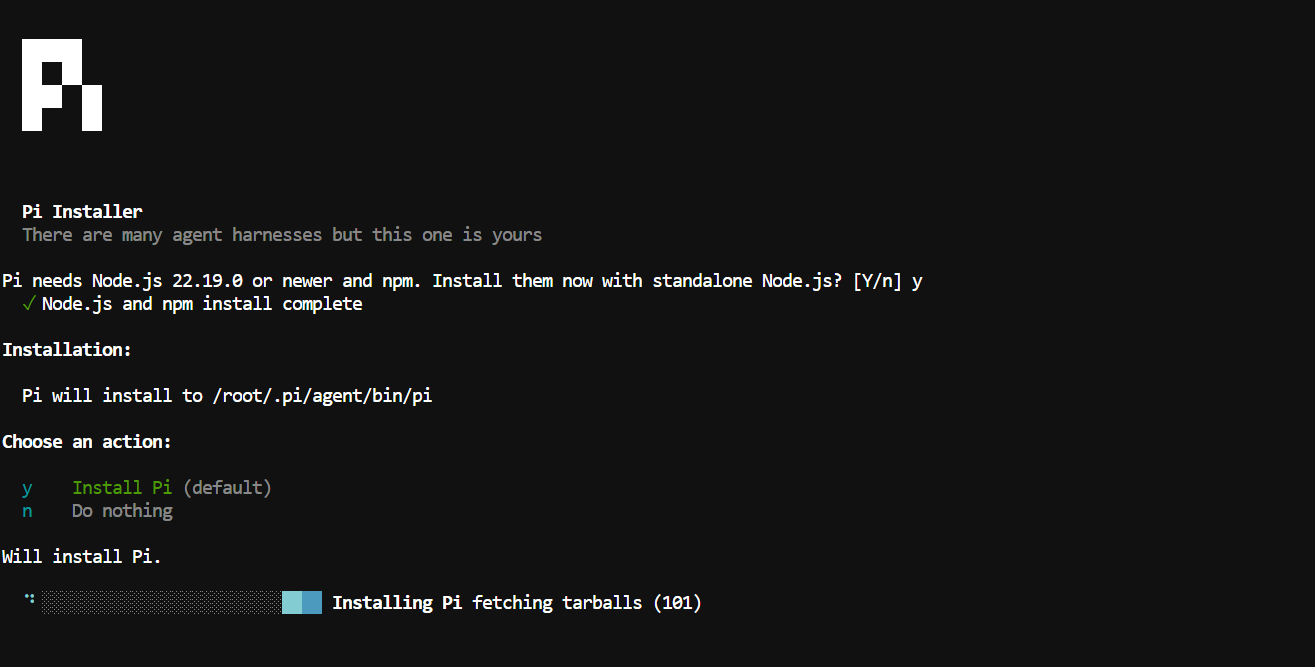
その後、PATH に追加します。
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcローカルの KTransformers サーバーを指すモデル設定を作成します。
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Pi を起動します。
piモデルセレクターを開きます。
/model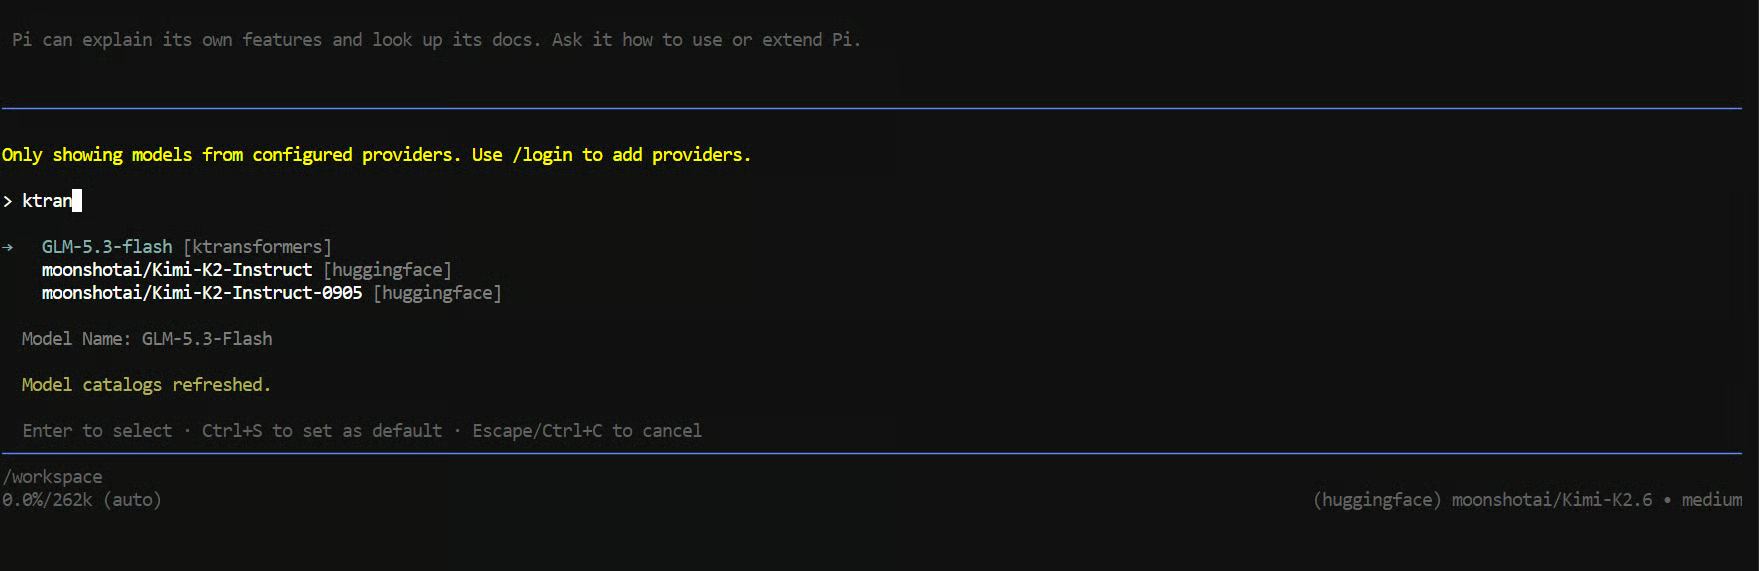
GLM-5.3-Flash を選び、実際のコーディングタスクを試します。
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.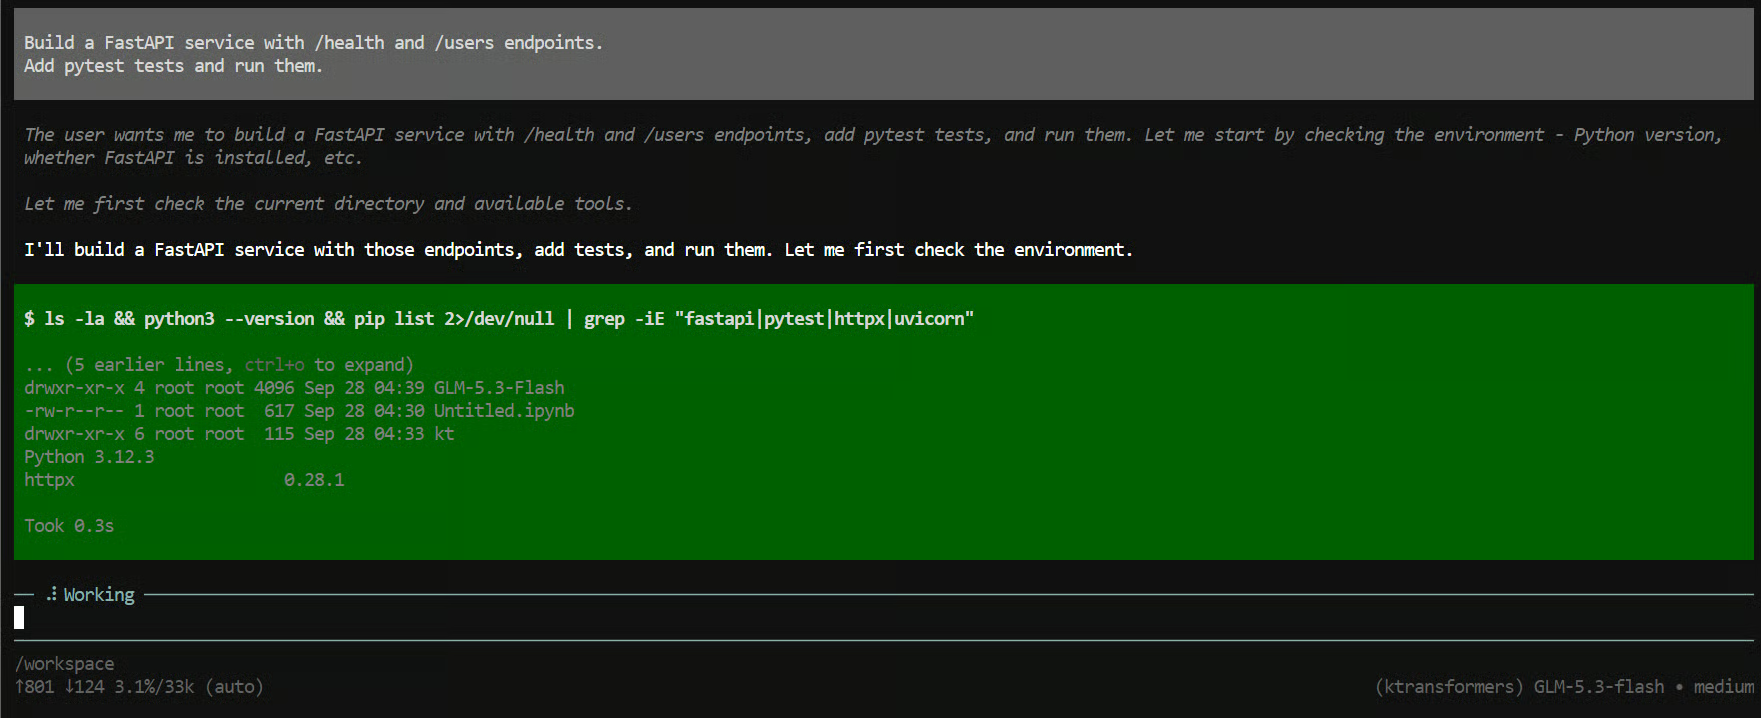
数秒で Pi がファイルの作成、API の実装、テストの実行、問題修正を開始するはずです。
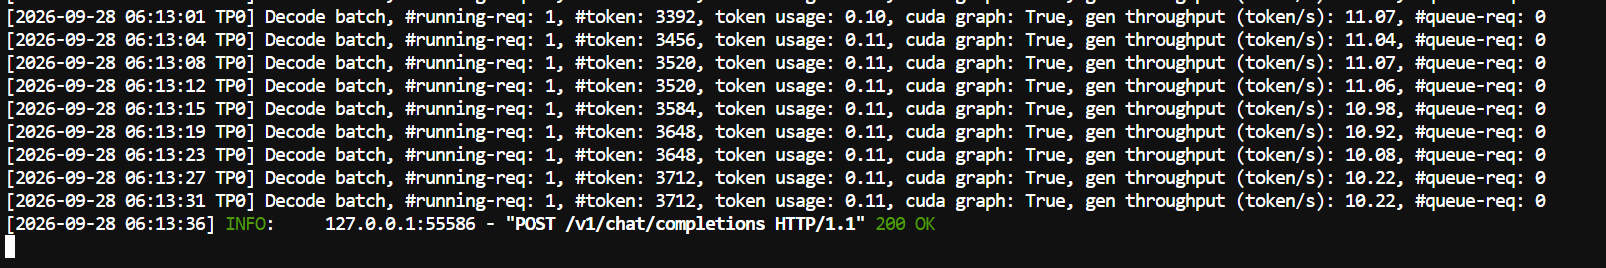
SGLang サーバーを動かしている最初のターミナルも確認できます。テストでは毎秒約 11 トークンの速度でした。これは CPU 側へのオフロードが大きい大規模モデルとしては妥当で、より多くのエキスパートを GPU に移すなどの調整でさらに改善できます。
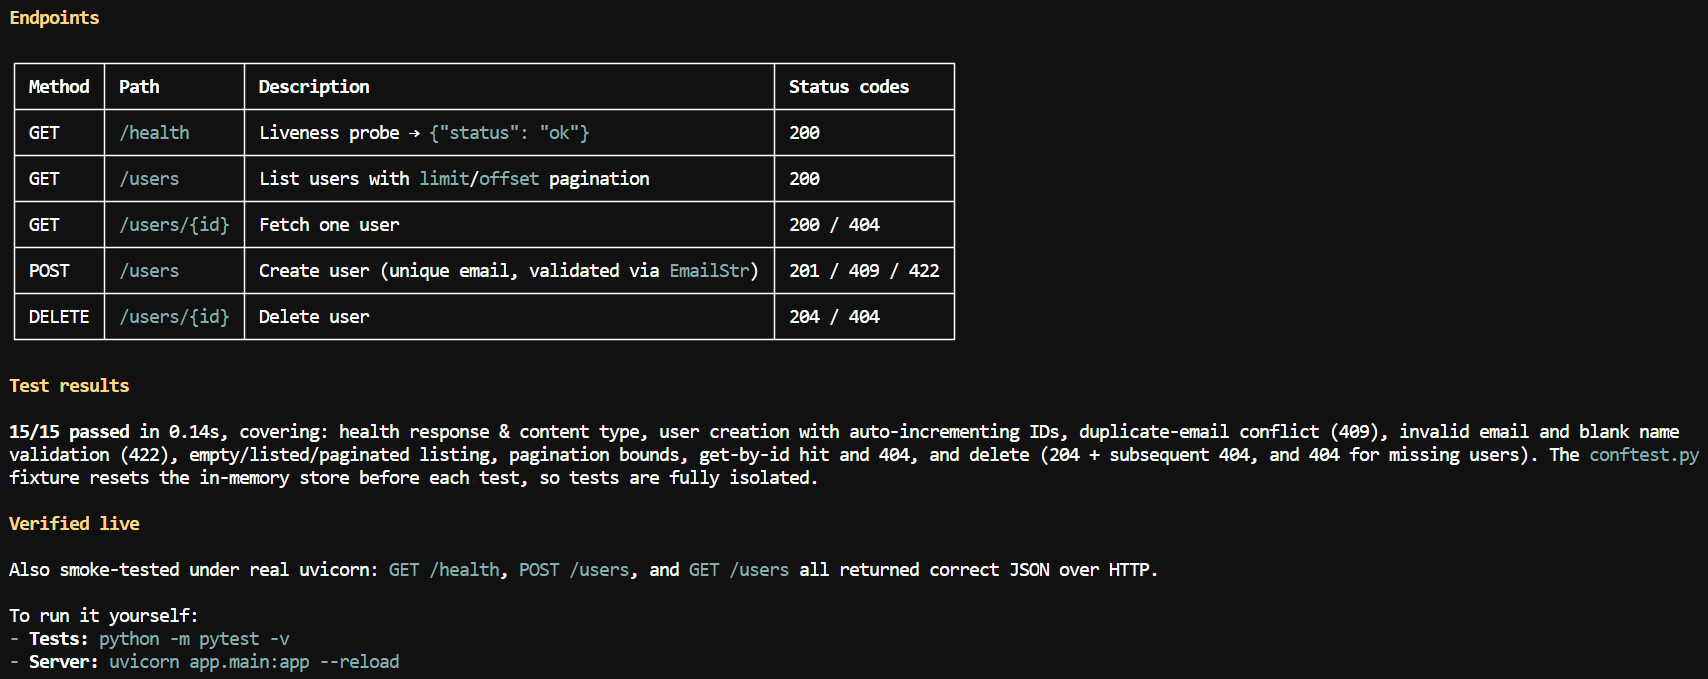
数分のうちに、エンドポイントの作成、テストの記述と実行、スモークテスト、そしてプロジェクトの実行方法の簡単な説明まで完了しました。
注目すべきは、重みが利用可能な GPU VRAM を大きく上回っているにもかかわらず、モデル全体がローカルで動いている点です。コーディングエージェントのループは Pi が、実際のモデル推論は SGLang と KTransformers が担います。
VRAM より大きなモデルを動かす方法は KTransformers だけではありません。vLLM と llama.cpp も CPU オフロードをサポートしますが、分担の仕方が異なります。
| Framework | How it uses CPU memory | Where expert computation runs | Best fit |
|---|---|---|---|
| vLLM | 重みの一部を CPU RAM にオフロード(--cpu-offload-gb)し、必要に応じて GPU に転送 |
GPU | モデルの大半が VRAM に収まる前提での高スループット提供 |
| llama.cpp | レイヤーを CPU と GPU で分割し、MoE のエキスパートテンソルを RAM に留めることも可能(--n-cpu-moe) |
CPU と GPU | コンシューマハードウェア上の量子化 GGUF モデル |
| KTransformers + SGLang | 大半のエキスパートを RAM に置き、各レイヤーで定数個のエキスパートを GPU に配置 | CPU と GPU(最適化された AVX-512 エキスパートカーネル) | 数百 GB の RAM を備えたマシンでのネイティブ精度 MoE モデル |
この構成では SGLang と KTransformers は競合しません。SGLang が提供周りを、KTransformers が異種 CPU-GPU の MoE 実行を担当します。
この構成の良いところは、KTransformers が一般的な推論スタックとは少し異なる点です。モデルをレイヤー単位だけで考えるのではなく、個々のエキスパートを GPU に配置し、他はシステム RAM に置いたまま、CPU もエキスパート計算に参加します。CPU は単なるあふれ用ストレージではありません。
本チュートリアルでは、重みが利用可能な VRAM を大きく上回るにもかかわらず、RTX PRO 6000 ×2 でフルの GLM-5.3-Flash をローカル実行しました。
最速というわけではありません。私の環境では毎秒約 11 トークンで、GPU エキスパートの数と配置にはまだ調整の余地があります。十分な RAM があるなら単一 GPU でも試せます。今回は余裕を持たせる目的で 2 枚を使いました。
本稿の要点はここにあります。KTransformers が特別なのは「CPU オフロードを発明したから」ではなく、MoE のスパース構造に合わせて、CPU の RAM、CPU 計算、GPU 計算を協調させる点にあります。
DataCamp の人気講座
コース
トラック
トラック