Corso
Modelli Transformer con PyTorch
2 ore
9.2K
KTransformers è un framework di inferenza open source che consente a CPU e GPU di eseguire attivamente esperti diversi durante l'inferenza, così puoi eseguire modelli Mixture-of-Experts (MoE) molto più grandi della memoria della tua GPU. Framework come vLLM possono anche scaricare i pesi nella memoria della CPU, ma KTransformers è costruito specificamente attorno alla struttura sparsa dei modelli MoE.
In questo tutorial useremo KTransformers e SGLang per eseguire GLM-5.3-Flash, un modello da 320 miliardi di parametri i cui pesi non entrano in 192 GB di VRAM. Controlleremo l'utilizzo di memoria di CPU e GPU, faremo esperimenti con il posizionamento degli esperti, testeremo l'API compatibile con OpenAI e collegheremo il modello a Pi come agente locale per il coding.
L'idea principale è semplice: invece di trattare la memoria della CPU come spazio di overflow, KTransformers usa sia il calcolo su CPU che su GPU durante l'inferenza.
KTransformers è un framework di inferenza open source per eseguire modelli linguistici molto grandi usando una combinazione di VRAM della GPU e RAM della CPU. In genere, servire un modello grande richiede il caricamento della maggior parte dei suoi pesi nella memoria della GPU, che diventa rapidamente costoso per un modello delle dimensioni di GLM-5.3-Flash.
KTransformers adotta un approccio diverso: mantiene molti pesi degli esperti MoE nella memoria di sistema e riserva la memoria della GPU alle parti dell'inferenza che traggono maggior beneficio dall'accelerazione su GPU.
Questo funziona bene per i modelli MoE perché non ogni esperto viene usato per ogni token. GLM-5.3-Flash, ad esempio, ha 288 esperti instradati, ma il suo router ne seleziona solo 8 (più 1 esperto condiviso) per ogni token. KTransformers può quindi distribuire il calcolo degli esperti tra CPU e GPU:
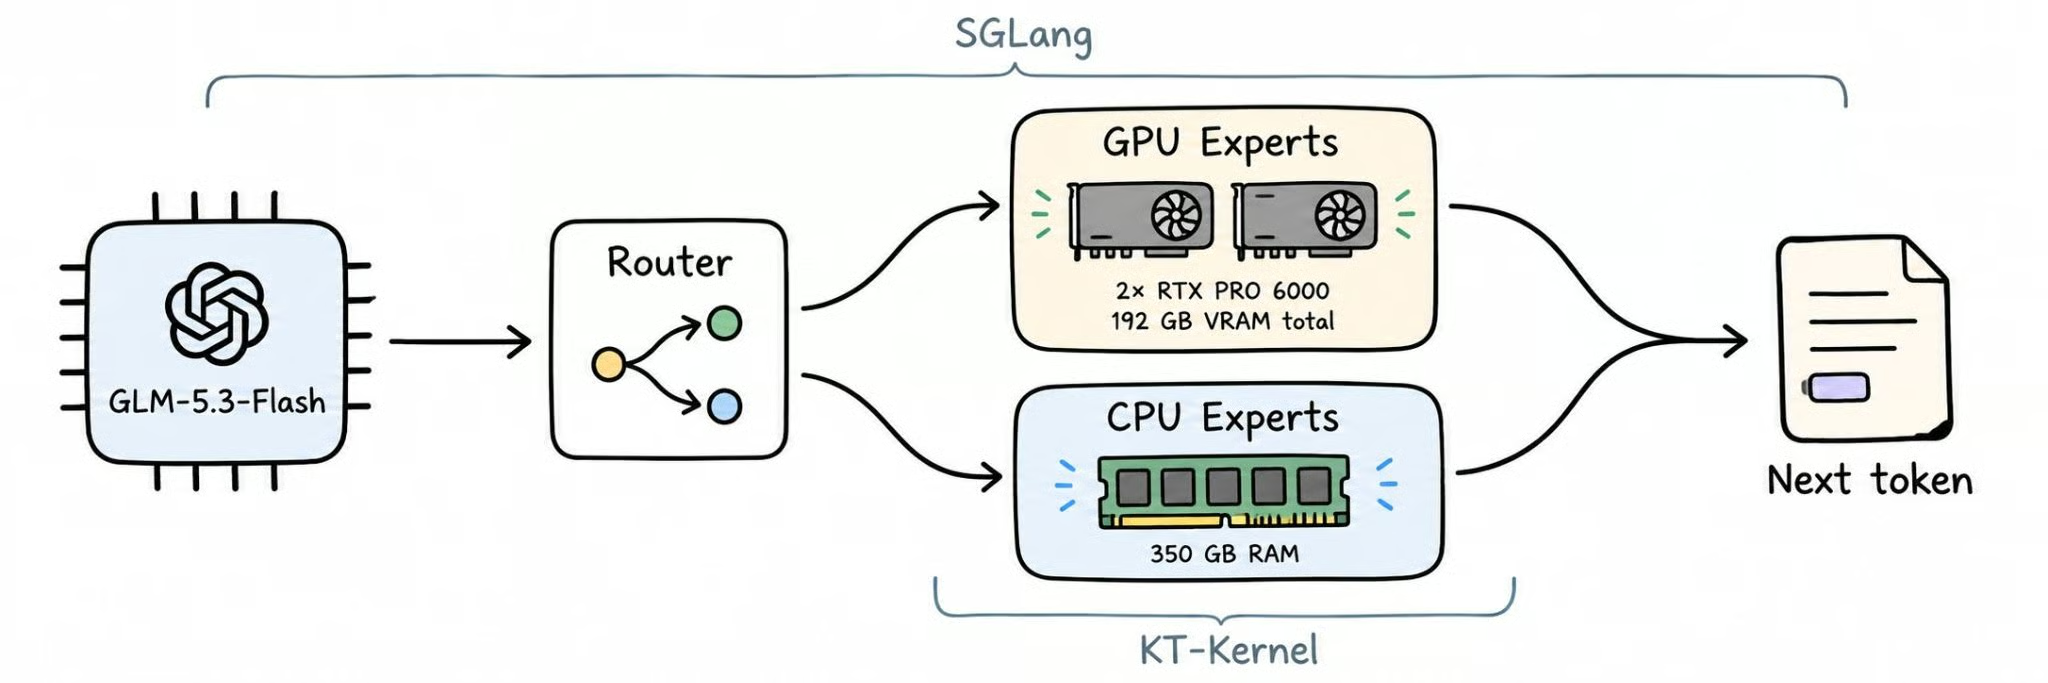
L'attuale stack di KTransformers integra KT-Kernel con SGLang per l'inferenza eterogenea CPU-GPU. Ogni componente gestisce un compito diverso:
KTransformers supporta anche la modifica del posizionamento degli esperti in base ai pattern di carico, come descritto nel suo tutorial sullo scheduling degli esperti.
In altre parole, KTransformers tratta memoria CPU e memoria GPU come un sistema d'inferenza condiviso invece di richiedere che l'intero modello entri nella VRAM della GPU. È questo che consente di eseguire modelli MoE molto grandi su hardware con molta meno memoria GPU di quella normalmente necessaria.
GLM-5.3-Flash è il modello MoE open-weight e nativamente multimodale di Z.ai, rilasciato con licenza MIT nell'agosto 2026. Nonostante il nome "Flash", è un modello grande: 320 miliardi di parametri totali, con circa 18 miliardi attivi per token.
Queste sono le specifiche che contano per l'inferenza locale:
zai-org/GLM-5.3-Flash)KTransformers legge direttamente i pesi FP8 ufficiali, quindi non c'è conversione o step aggiuntivo di quantizzazione. Per benchmark e una panoramica completa del modello, vedi la nostra guida a GLM-5.3-Flash.
Per GLM-5.3-Flash, la questione hardware riguarda soprattutto la RAM di sistema. Il tutorial ufficiale KTransformers per GLM-5.3-Flash consiglia di riservare almeno 350 GB di memoria di sistema disponibile.
Per questo tutorial, usiamo un'istanza RunPod con approssimativamente:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11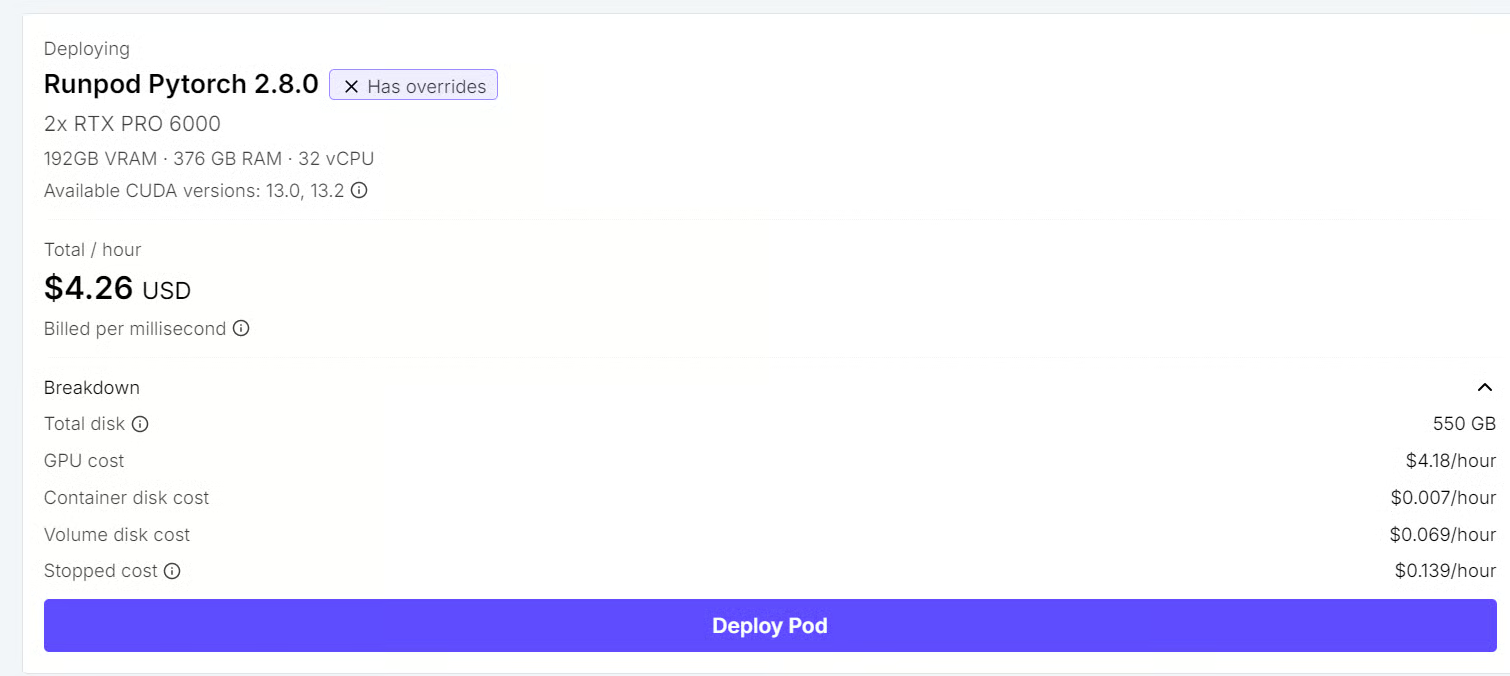
Il checkpoint FP8 ufficiale di GLM-5.3-Flash è di circa 306 GiB (circa 329 GB), mentre le nostre due GPU forniscono in totale 192 GB di VRAM. L'intero modello quindi non può semplicemente essere caricato nella memoria GPU.
Invece, KTransformers mantiene una grande parte dei pesi MoE nella RAM di sistema e sposta sulle GPU il calcolo più utile. La raccomandazione di 350 GB lascia spazio sufficiente per i pesi del modello più l'overhead di runtime.
In questo setup, avere più memoria GPU non elimina la necessità di RAM. La memoria della CPU è una parte intenzionale del design di inferenza eterogenea di KTransformers: i pesi degli esperti restano in RAM mentre la GPU gestisce le parti del modello che beneficiano di più dell'accelerazione.
L'implementazione attuale di GLM-5.3-Flash ha anche requisiti specifici per CPU e GPU:
Sì, a patto di avere sufficiente RAM di sistema e una CPU supportata. Il tutorial ufficiale include una configurazione a singola GPU che imposta --kt-num-gpu-experts 0, così gli esperti MoE vengono gestiti lato CPU.
Qui usiamo due RTX PRO 6000, ma non è un requisito minimo rigido. La seconda GPU ci offre più VRAM e margine extra mentre sperimentiamo con un'implementazione KTransformers relativamente nuova, invece di ottimizzare il setup attorno alla configurazione hardware più piccola che possa far girare il modello.
Crea un ambiente pulito Python 3.11 e installa KTransformers con supporto SGLang:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Verifica che KTransformers, KT-Kernel, SGLang e CUDA vengano rilevati correttamente:
kt versionDovresti vedere un output simile a:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Questo conferma che il runtime di KTransformers e il suo backend SGLang sono installati e pronti all'uso.
Prima di avviare il server, scarica il checkpoint ufficiale di GLM-5.3-Flash da Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Il checkpoint è di circa 306 GiB, quindi il download può richiedere tempo a seconda della tua banda.
Poi punta KTransformers al percorso locale del modello:
export MODEL_PATH=/workspace/GLM-5.3-FlashOra avvia GLM-5.3-Flash con parallelismo tensoriale a due vie, usando entrambe le RTX PRO 6000. Il modello supporta fino a 1M token di contesto e gli esempi ufficiali usano una configurazione validata da 501.025 token. Iniziamo invece con una finestra di contesto da 32K, per mantenere prevedibile l'uso di memoria durante i test.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45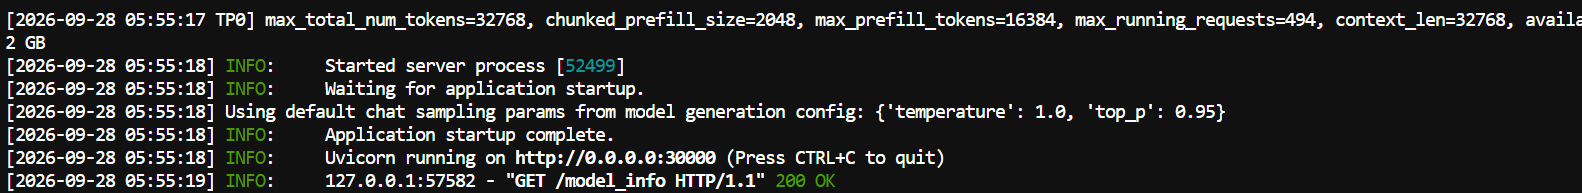
Questa configurazione espone il modello tramite un server SGLang compatibile con OpenAI sulla porta 30000. Le due GPU sono usate con --tp-size 2, mentre KTransformers mantiene parte del carico MoE sulla CPU e colloca alcuni esperti sulle GPU.
Le impostazioni qui sono volutamente conservative per la prima esecuzione: contesto 32K, utilizzo statico della memoria GPU all'85%, 14 esperti su GPU e 64 thread di inferenza CPU. Una volta che il server è stabile, puoi sperimentare con una finestra di contesto più grande, più esperti su GPU o impostazioni di memoria diverse per migliorare il throughput.
La maggior parte dei flag sopra sono opzioni standard di SGLang. Questi sono quelli che controllano come KTransformers suddivide il lavoro tra CPU e GPU:
| Flag | Valore | Cosa fa |
|---|---|---|
--kt-method |
FP8 |
Imposta la precisione dei pesi degli esperti, in linea con il checkpoint FP8 nativo di GLM-5.3-Flash. |
--kt-cpuinfer |
64 |
Numero di thread CPU usati per il calcolo degli esperti. |
--kt-threadpool-count |
2 |
Numero di pool di thread CPU, di solito allineato al numero di nodi NUMA. |
--kt-num-gpu-experts |
14 |
Numero di esperti per layer MoE posizionati sulla GPU. |
--kt-expert-placement-strategy |
uniform |
Come vengono scelti gli esperti su GPU. Altre opzioni includono frequency, front-loading e random. |
--kt-gpu-prefill-token-threshold |
2048 |
Lunghezza del prompt oltre la quale il prefill passa al percorso layerwise lato GPU. |
Ora che il server è in esecuzione, possiamo verificare come KTransformers stia usando VRAM della GPU e RAM di sistema, quindi modificare il numero di esperti residenti su GPU per vedere come cambiano uso delle risorse e prestazioni.
Su RunPod, free -h può essere fuorviante perché un container può vedere la RAM totale della macchina host invece della sola memoria disponibile per il pod. È meglio monitorare memoria GPU e memoria del container separatamente.
Apri un nuovo terminale e monitora l'uso della GPU:
watch -n 1 nvidia-smi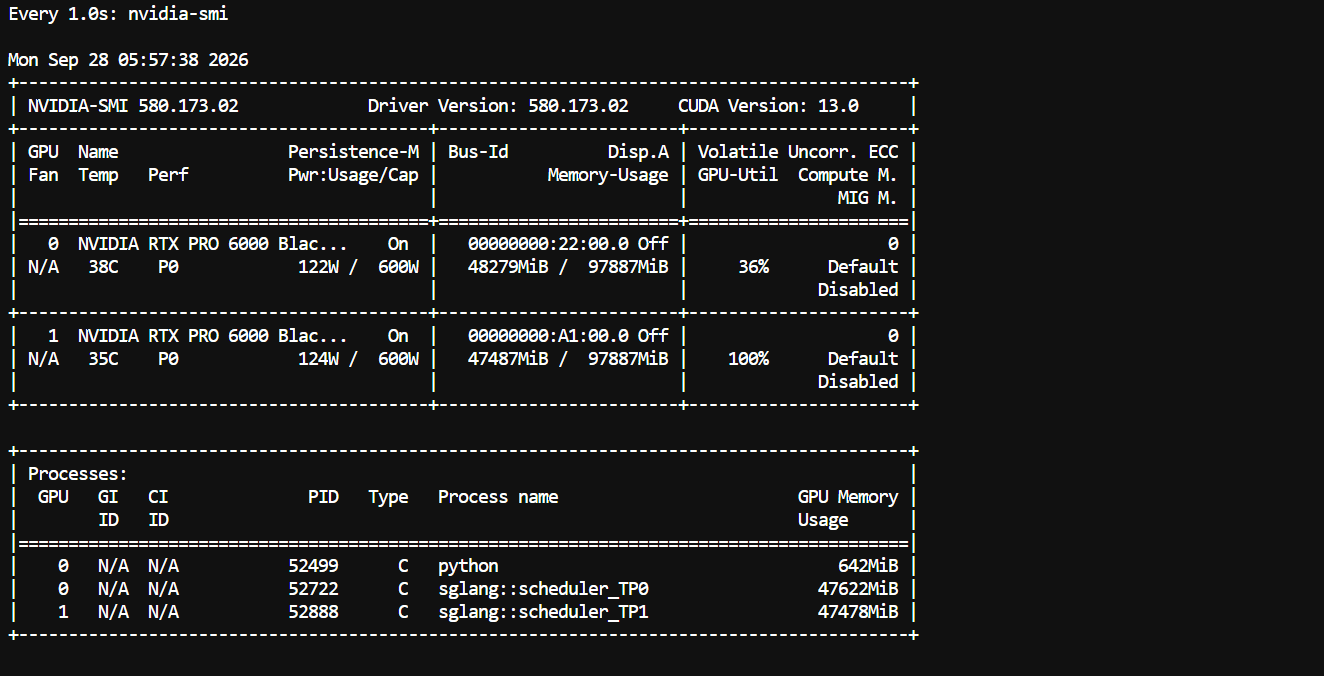
Con la configurazione attuale, il modello a pieno carico usa circa 48 GB per GPU, lasciando una grande quantità di VRAM inutilizzata. Questo suggerisce che c'è margine per posizionare più esperti sulle GPU o testare una configurazione a singola GPU con RAM di sistema sufficiente.
Per la RAM del container, leggi direttamente i contatori di memoria del cgroup:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'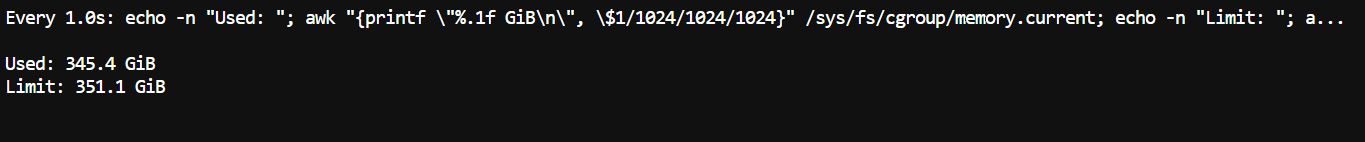
Dovresti vedere che una grande porzione della RAM di sistema disponibile è occupata dai pesi del modello e dagli esperti lato CPU. È previsto: KTransformers mantiene intenzionalmente molti esperti MoE in RAM invece di richiedere che risiedano tutti in VRAM.
--kt-num-gpu-expertsQuindi, riavvia il server con valori diversi di --kt-num-gpu-experts. Ad esempio, confronta:
0
10
20
--kt-num-gpu-experts controlla quanti esperti per layer MoE vengono posizionati sulla GPU. Con 0, il calcolo degli esperti resta lato CPU; aumentando il valore, più esperti vengono spostati nella memoria GPU.
Per ogni configurazione, confronta uso della VRAM GPU, uso della RAM del container, token al secondo e tempo al primo token. In generale, più esperti su GPU consumano più VRAM ma riducono l'esecuzione degli esperti lato CPU, il che può migliorare le prestazioni di inferenza quando c'è VRAM sufficiente.
Una nota dal tutorial ufficiale: quando Layerwise Prefill è abilitato per GLM-5.3-Flash, l'implementazione attuale normalizza il numero di esperti residenti su GPU a zero. Se l'uso di VRAM cambia a malapena tra le esecuzioni, questa è la probabile ragione.
Questo esperimento mostra il vantaggio chiave di KTransformers: RAM della CPU e VRAM della GPU diventano parti regolabili dello stesso sistema di inferenza, così puoi scambiare posizionamento della memoria con velocità invece di richiedere che l'intero modello MoE stia sulle GPU.
Con il server in esecuzione, possiamo ora confermare che il modello è disponibile e inviare una richiesta reale tramite l'API compatibile con OpenAI di SGLang.
Per prima cosa, verifica che il modello sia registrato:
curl http://localhost:30000/v1/modelsPoi invia un prompt di test:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'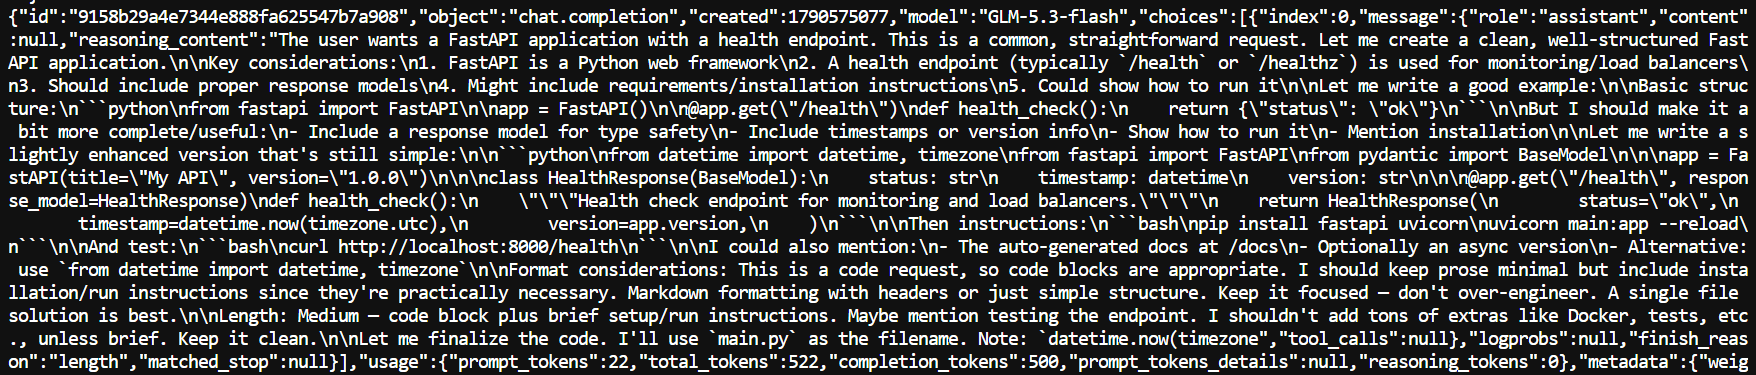
Se il setup funziona correttamente, il server restituisce una normale risposta di completamento chat contenente codice generato e statistiche d'uso.
Pi è un agente di coding leggero che può usare qualsiasi modello compatibile con OpenAI come backend, il che permette a GLM-5.3-Flash di lavorare direttamente su task di coding invece di limitarsi a rispondere ai prompt.
Installa Pi con il suo script di installazione:
curl -fsSL https://pi.dev/install.sh | sh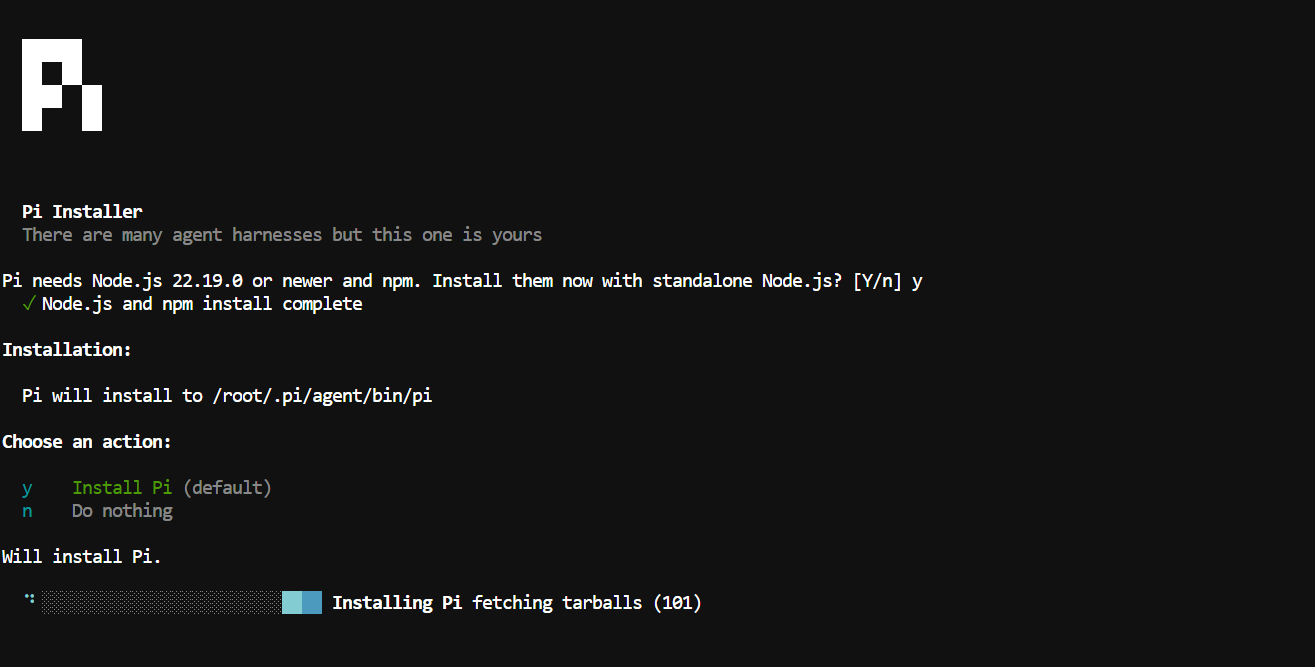
Poi aggiungi Pi al tuo PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcCrea una configurazione del modello che punti Pi al server KTransformers locale:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Avvia Pi:
piPoi apri il selettore del modello:
/model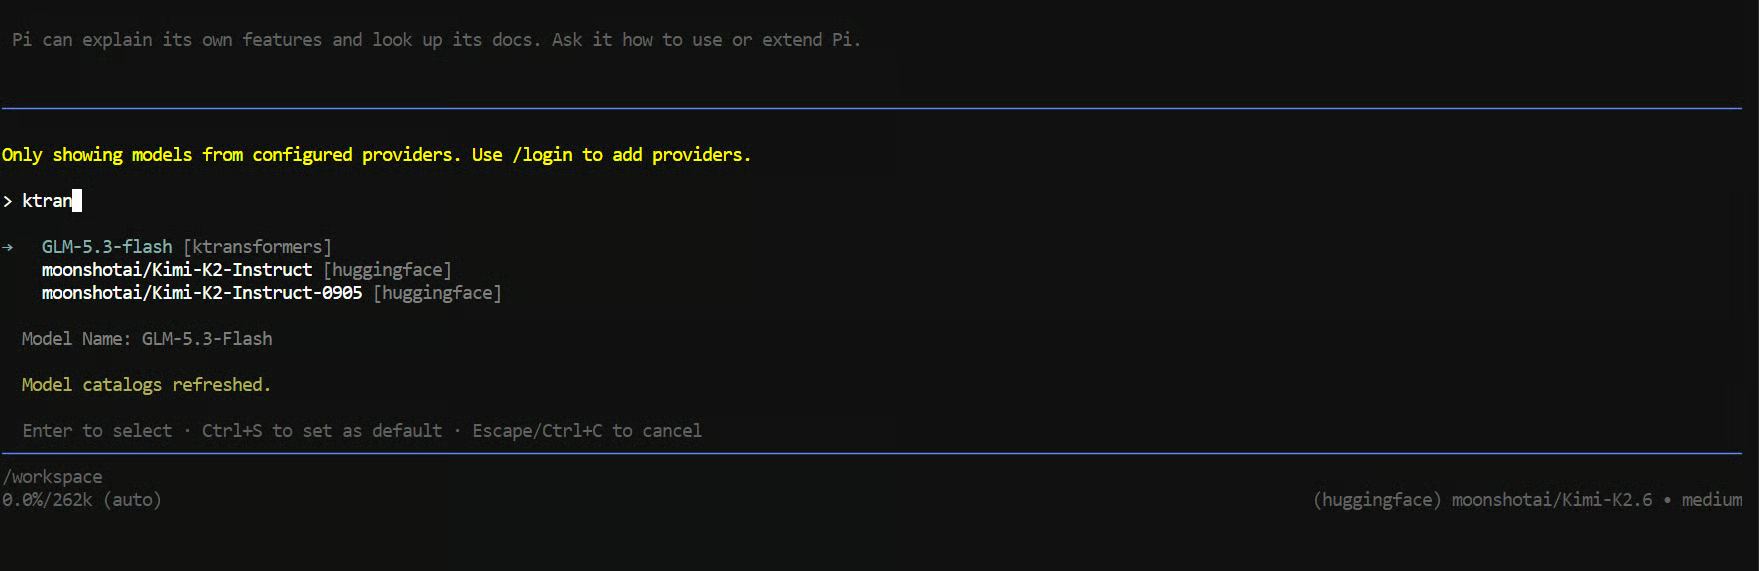
Scegli GLM-5.3-Flash e prova un task di coding reale:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.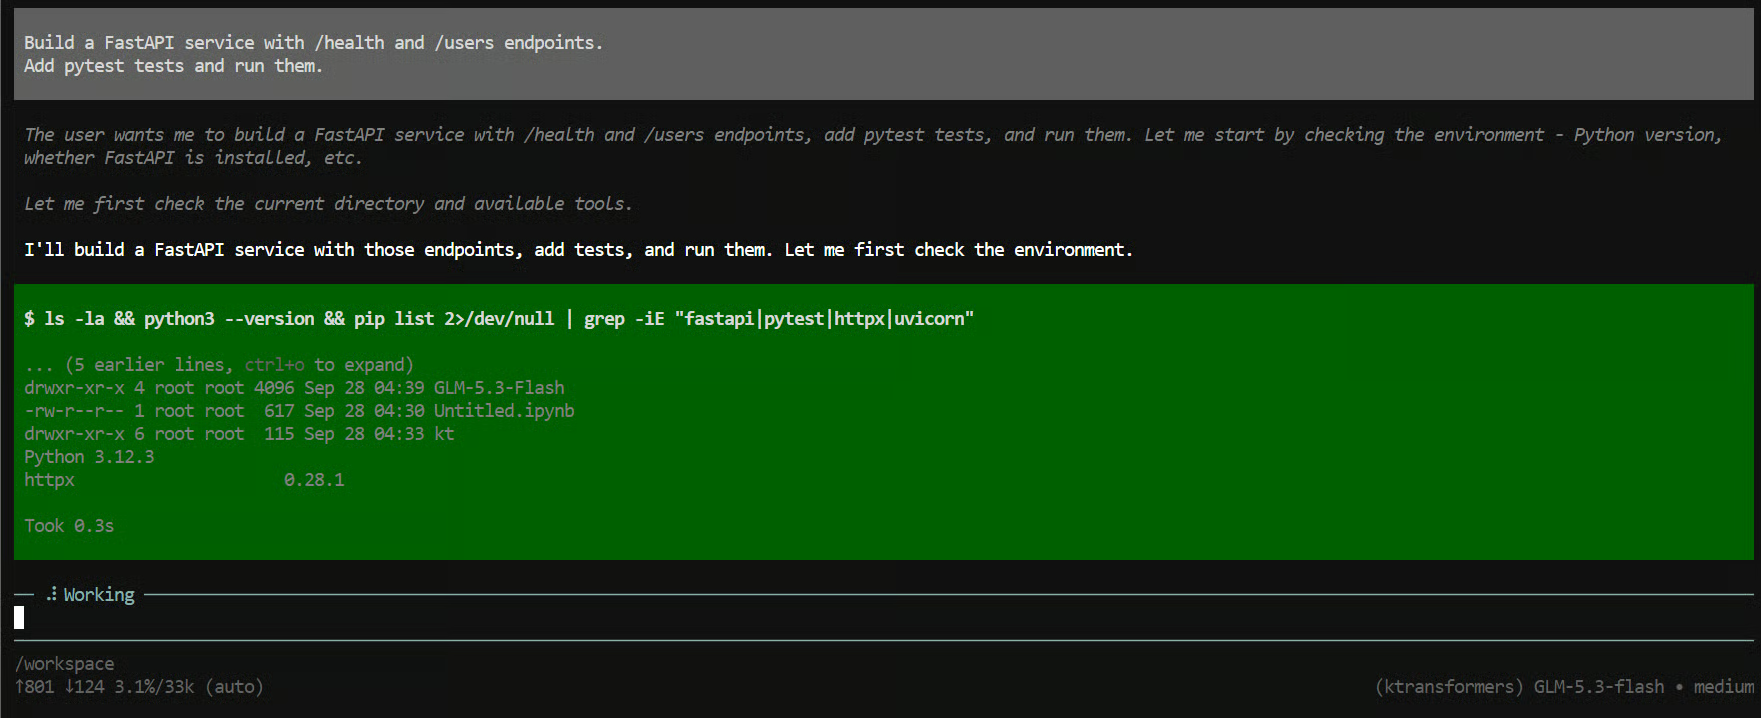
Nel giro di pochi secondi, Pi dovrebbe iniziare a creare file, scrivere l'API, eseguire i test e correggere i problemi mentre porta avanti il task.
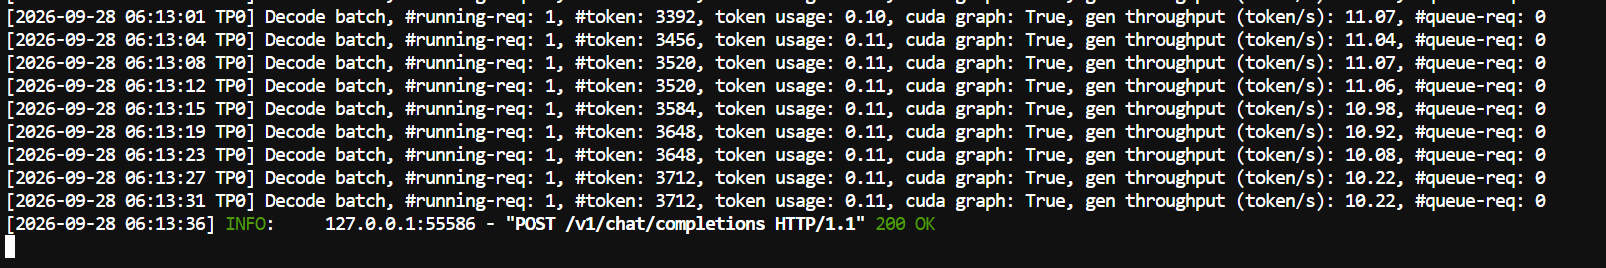
Puoi anche osservare il primo terminale, dove gira il server SGLang. Nel nostro test, la velocità di generazione era di circa 11 token al secondo. È ragionevole per un modello di queste dimensioni con offloading su CPU consistente, e il setup può essere ulteriormente ottimizzato spostando più esperti sulle GPU.
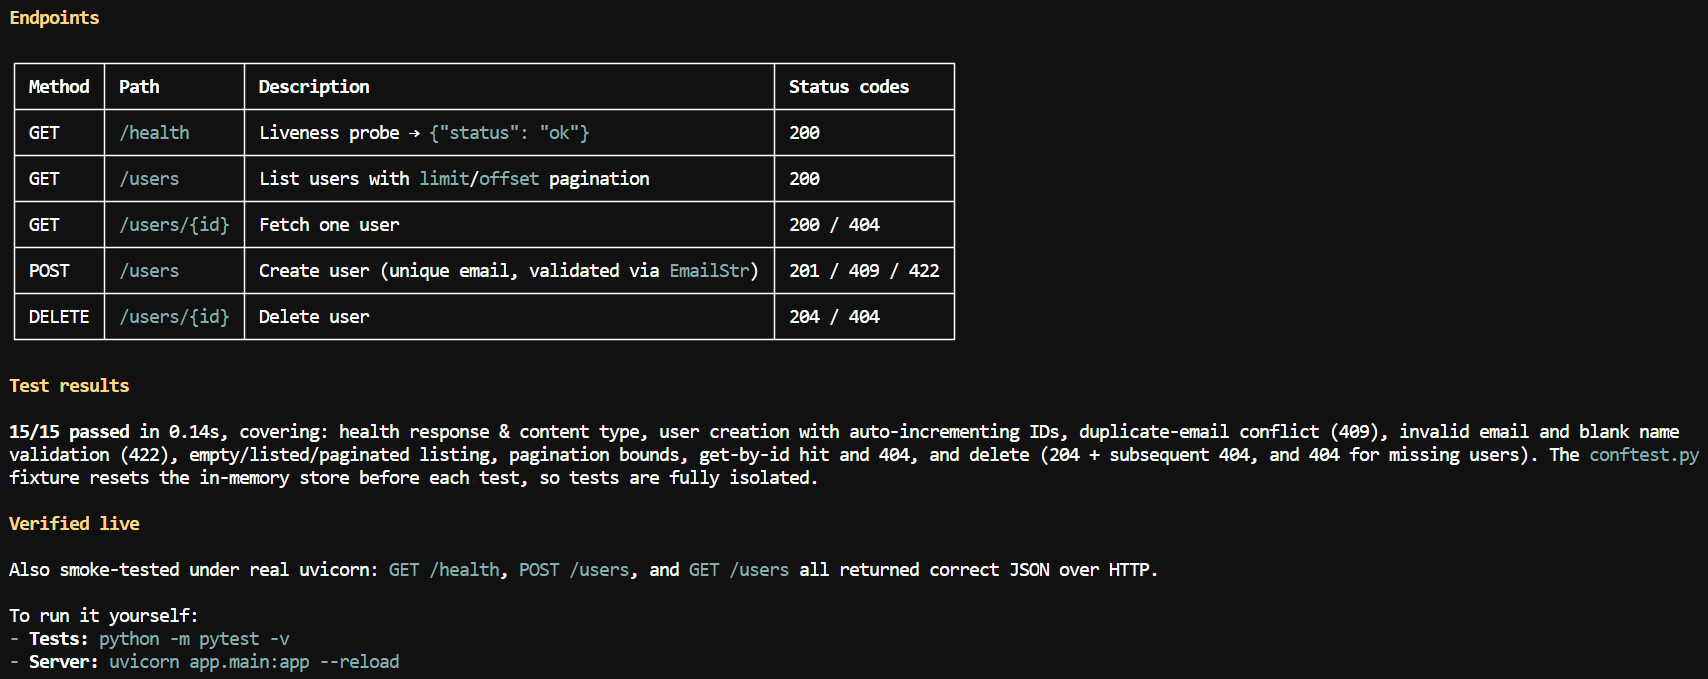
Nel giro di pochi minuti, il modello ha creato gli endpoint, scritto ed eseguito i test, effettuato uno smoke test e prodotto un breve riepilogo su come eseguire il progetto.
La parte interessante è che l'intero modello sta girando in locale anche se i suoi pesi sono molto più grandi della VRAM GPU disponibile. Pi gestisce il loop dell'agente di coding, mentre SGLang e KTransformers gestiscono l'inferenza effettiva del modello.
KTransformers non è l'unico modo per eseguire un modello più grande della tua VRAM. vLLM e llama.cpp supportano entrambi l'offloading su CPU, ma suddividono il lavoro in modo diverso:
| Framework | Come usa la memoria della CPU | Dove gira il calcolo degli esperti | Uso ideale |
|---|---|---|---|
| vLLM | Scarica parte dei pesi nella RAM della CPU (--cpu-offload-gb) e li trasferisce alla GPU quando servono |
GPU | Servizio ad alto throughput quando il modello entra per lo più in VRAM |
| llama.cpp | Divide i layer tra CPU e GPU, e può mantenere i tensori degli esperti MoE in RAM (--n-cpu-moe) |
CPU e GPU | Modelli GGUF quantizzati su hardware consumer |
| KTransformers + SGLang | Mantiene la maggior parte degli esperti in RAM e colloca un numero definito di esperti per layer sulla GPU | CPU e GPU, con kernel degli esperti AVX-512 ottimizzati | Modelli MoE a precisione nativa su macchine con centinaia di GB di RAM |
In questo setup SGLang e KTransformers non competono. SGLang gestisce il serving, mentre KTransformers gestisce l'esecuzione MoE eterogenea CPU-GPU.
Quello che mi è piaciuto di più di questo setup è che KTransformers fa qualcosa di un po' diverso dallo stack di inferenza usuale. Invece di pensare solo in termini di layer del modello, posiziona singoli esperti sulla GPU mantenendone altri nella RAM di sistema, e la CPU partecipa davvero al calcolo degli esperti. La CPU non funge solo da spazio di overflow.
In questo tutorial, abbiamo eseguito in locale l'intero modello GLM-5.3-Flash su due RTX PRO 6000, anche se i suoi pesi sono molto più grandi della VRAM disponibile.
Non è il setup più veloce. OttenEvo circa 11 token al secondo, e c'è ancora molto margine per regolare numero e posizionamento degli esperti su GPU. Potresti anche sperimentare con una singola GPU se hai abbastanza RAM; qui ne ho usate due semplicemente per dare più margine al setup.
Per me, questo è il punto principale della guida: KTransformers non è speciale perché ha inventato l'offloading su CPU. È speciale perché fa lavorare insieme RAM della CPU, calcolo su CPU e calcolo su GPU attorno alla struttura sparsa dei modelli MoE.
I migliori corsi DataCamp
Corso
Programma
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min