
Cursus
Transformermodels met PyTorch
2 uur
9.2K
KTransformers is een open-source inferentiekader waarmee de CPU en GPU actief verschillende experts uitvoeren tijdens inferentie, zodat je Mixture-of-Experts-modellen (MoE) kunt draaien die veel groter zijn dan het geheugen van je GPU. Frameworks zoals vLLM kunnen ook gewichten naar CPU-geheugen offloaden, maar KTransformers is specifiek gebouwd rondom de sparse structuur van MoE-modellen.
In deze tutorial gebruiken we KTransformers en SGLang om GLM-5.3-Flash te draaien, een model met 320 miljard parameters waarvan de gewichten niet passen in 192 GB VRAM. We monitoren CPU- en GPU-geheugengebruik, experimenteren met expertplaatsing, testen de OpenAI-compatibele API en koppelen het model aan Pi als lokale coding agent.
Het idee is eenvoudig: in plaats van CPU-geheugen te behandelen als overloopopslag, gebruikt KTransformers zowel CPU-compute als GPU-compute tijdens inferentie.
KTransformers is een open-source inferentiekader om zeer grote taalmodellen te draaien met een combinatie van GPU VRAM en CPU RAM. Normaal vereist het serven van een groot model dat het merendeel van de gewichten in GPU-geheugen wordt geladen, wat snel duur wordt voor een model zo groot als GLM-5.3-Flash.
KTransformers pakt het anders aan: het houdt veel MoE-expertgewichten in systeemgeheugen en reserveert GPU-geheugen voor de delen van de inferentie die het meest profiteren van GPU-versnelling.
Dit werkt goed voor MoE-modellen omdat niet elke expert voor elke token wordt gebruikt. GLM-5.3-Flash heeft bijvoorbeeld 288 gerouteerde experts, maar de router selecteert er slechts 8 (plus 1 gedeelde expert) per token. KTransformers kan daarom expertberekening over CPU en GPU verdelen:
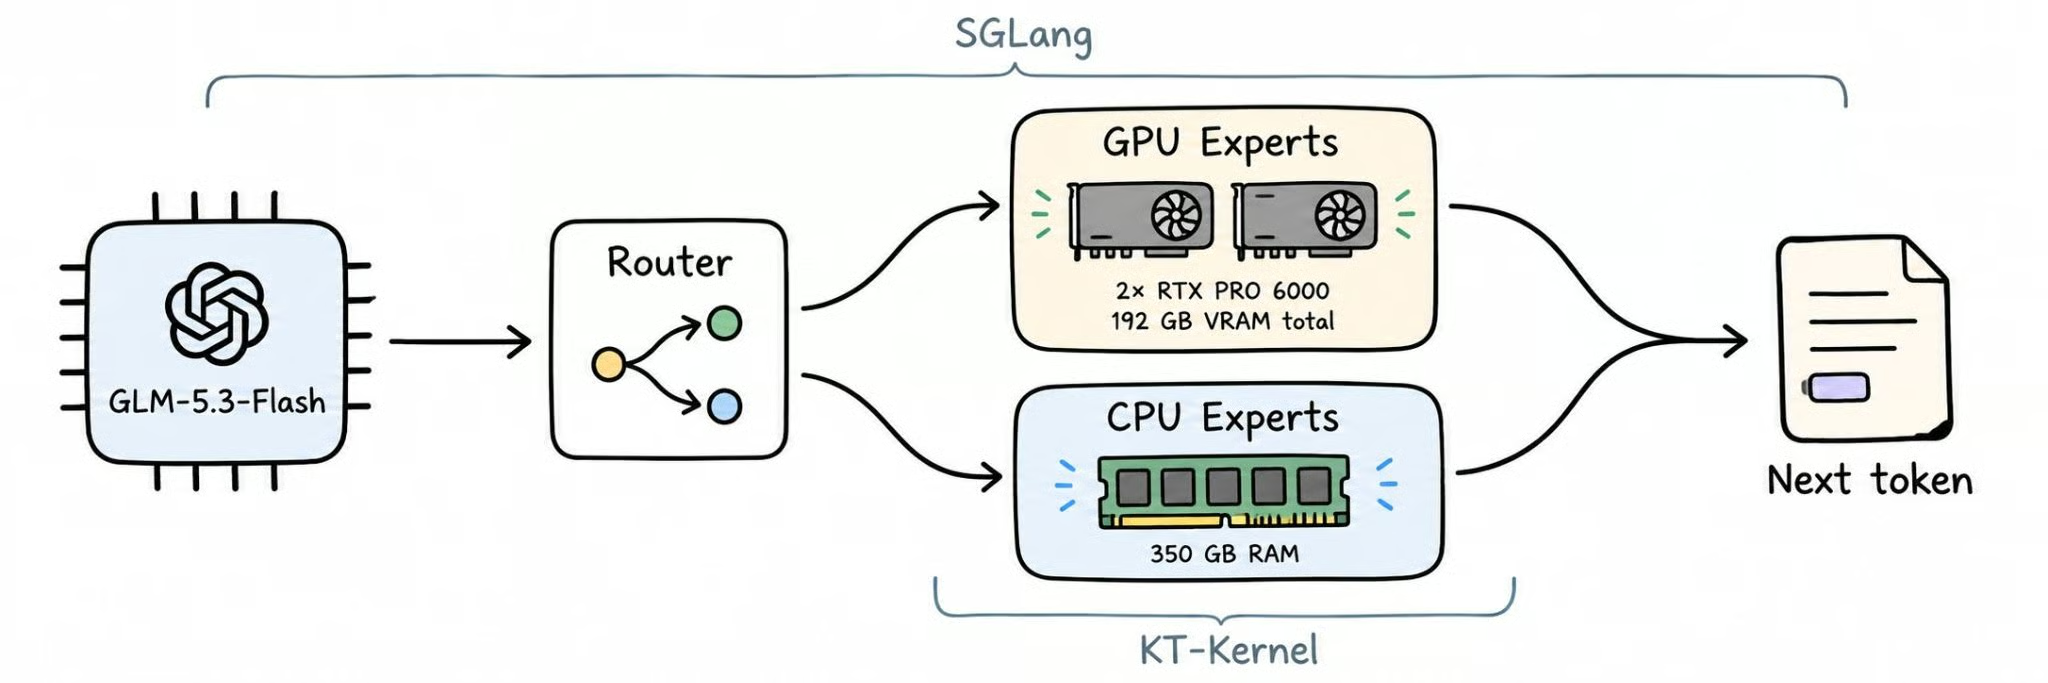
De huidige KTransformers-stack integreert KT-Kernel met SGLang voor heterogene CPU-GPU-inferentie. Elk onderdeel pakt een andere taak op:
KTransformers ondersteunt ook het wijzigen van expertplaatsing op basis van werkbelastingspatronen, zoals beschreven in de tutorial over expertplanning.
Met andere woorden, KTransformers behandelt CPU-geheugen en GPU-geheugen als één gedeeld inferentiesysteem in plaats van te eisen dat het hele model in GPU VRAM past. Dat maakt het mogelijk om zeer grote MoE-modellen te draaien op hardware met veel minder GPU-geheugen dan normaal nodig zou zijn.
GLM-5.3-Flash is Z.ai's open-weight, native multimodale MoE-model, uitgebracht onder de MIT-licentie in augustus 2026. Ondanks de naam "Flash" is het een groot model: in totaal 320B parameters, met ongeveer 18B actief per token.
Dit zijn de specificaties die ertoe doen voor lokale inferentie:
zai-org/GLM-5.3-Flash)KTransformers leest de officiële FP8-gewichten direct, dus er is geen conversie- of extra kwantisatiestap nodig. Voor benchmarks en een volledig modeloverzicht, zie onze GLM-5.3-Flash-gids.
Voor GLM-5.3-Flash draait de hardwarevraag vooral om systeem-RAM. De officiële KTransformers GLM-5.3-Flash-tutorial raadt aan om minstens 350 GB aan beschikbaar systeemgeheugen te reserveren.
Voor deze tutorial gebruiken we een RunPod-instance met ongeveer:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11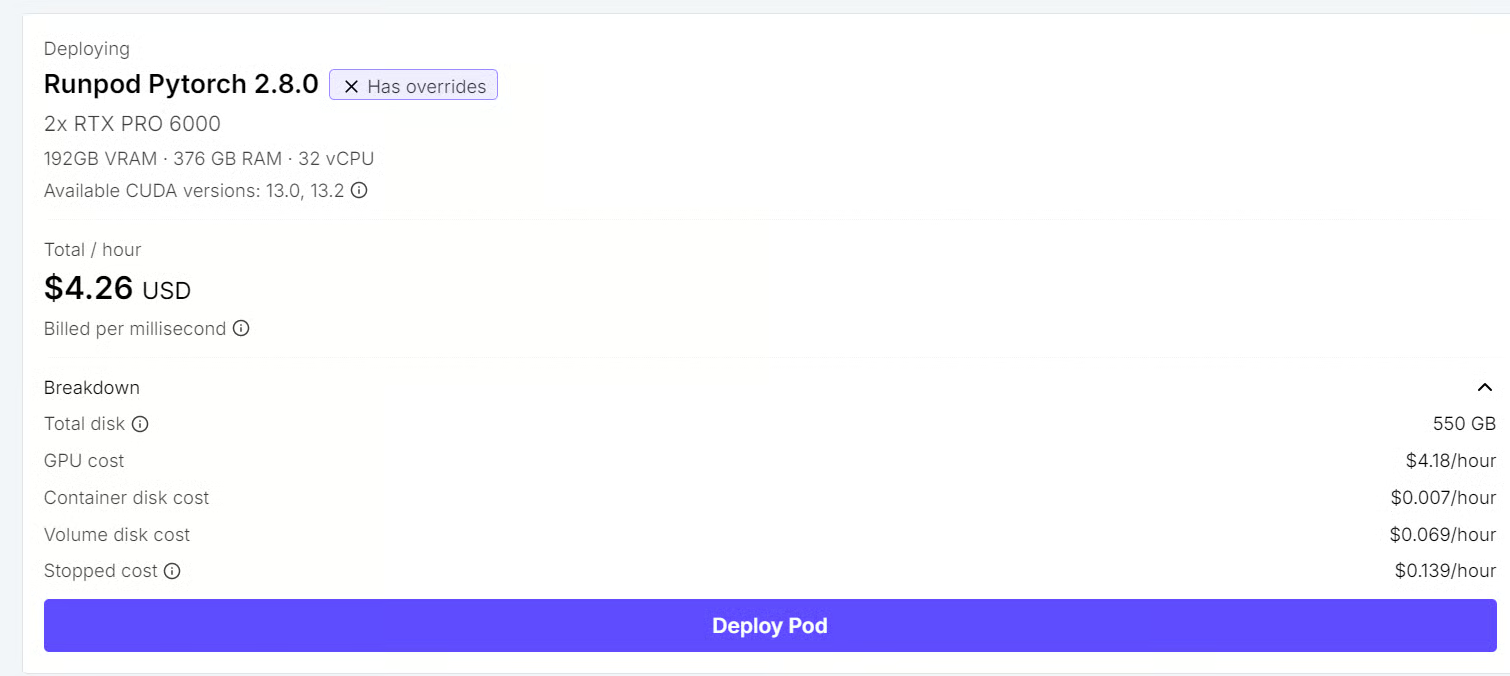
Het officiële FP8-checkpoint van GLM-5.3-Flash is ongeveer 306 GiB (ongeveer 329 GB), terwijl onze twee GPU's in totaal 192 GB VRAM leveren. Het volledige model kan dus niet simpelweg in GPU-geheugen worden geladen.
In plaats daarvan houdt KTransformers een groot deel van de MoE-gewichten in systeem-RAM en verplaatst het de meest nuttige berekeningen naar de GPU's. De aanbeveling van 350 GB laat genoeg ruimte voor de modelgewichten plus runtime-overhead.
Meer GPU-geheugen haalt in deze setup de noodzaak voor RAM niet weg. CPU-geheugen is een bewust onderdeel van KTransformers' heterogene inferentieontwerp: expertgewichten blijven in RAM terwijl de GPU de modelonderdelen afhandelt die het meest van versnelling profiteren.
De huidige GLM-5.3-Flash-implementatie heeft ook specifieke CPU- en GPU-vereisten:
Ja, mits je genoeg systeem-RAM en een ondersteunde CPU hebt. De officiële tutorial bevat een single-GPU-configuratie die --kt-num-gpu-experts 0 instelt, zodat de MoE-experts aan de CPU-kant worden afgehandeld.
We gebruiken hier twee RTX PRO 6000 GPU's, maar dat is geen strikte minimumeis. De tweede GPU geeft ons meer VRAM en extra speling tijdens het experimenteren met een relatief nieuwe KTransformers-implementatie, in plaats van de setup te finetunen rond de kleinste hardwareconfiguratie die het model net aan kan draaien.
Maak een schone Python 3.11-omgeving en installeer KTransformers met SGLang-ondersteuning:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Controleer of KTransformers, KT-Kernel, SGLang en CUDA correct worden gedetecteerd:
kt versionJe zou uitvoer moeten zien zoals:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Dit bevestigt dat de KTransformers-runtime en de SGLang-backend zijn geïnstalleerd en klaar voor gebruik.
Download het officiële GLM-5.3-Flash-checkpoint van Hugging Face voordat je de server start:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Het checkpoint is circa 306 GiB, dus de download kan even duren, afhankelijk van je bandbreedte.
Wijs KTransformers daarna naar het lokale modelpad:
export MODEL_PATH=/workspace/GLM-5.3-FlashStart GLM-5.3-Flash nu met two-way tensor-parallelisme, met beide RTX PRO 6000 GPU's. Het model ondersteunt tot 1M tokens context, en de officiële voorbeelden gebruiken een gevalideerde configuratie van 501.025 tokens. We beginnen in plaats daarvan met een contextvenster van 32K om het geheugengebruik voorspelbaar te houden tijdens het testen van de setup.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45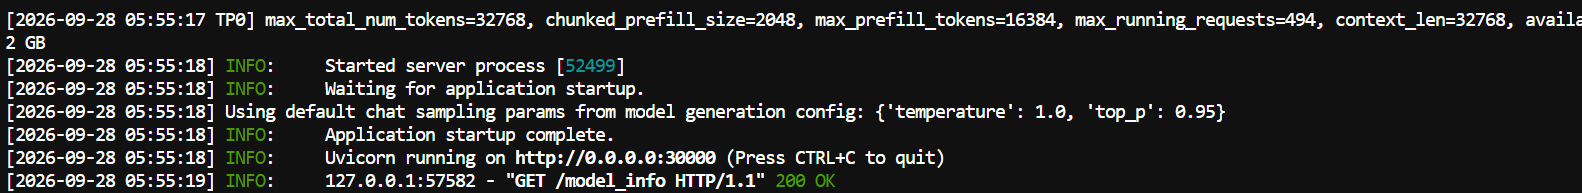
Deze configuratie stelt het model beschikbaar via een OpenAI-compatibele SGLang-server op poort 30000. De twee GPU's worden gebruikt met --tp-size 2, terwijl KTransformers een deel van de MoE-werkload op de CPU houdt en geselecteerde experts op de GPU's plaatst.
De instellingen hier zijn bewust conservatief voor de eerste run: 32K context, 85% statisch GPU-geheugengebruik, 14 GPU-experts en 64 CPU-inferentiedraden. Zodra de server stabiel is, kun je experimenteren met een groter contextvenster, meer GPU-experts of andere geheugeninstellingen om de throughput te verbeteren.
De meeste flags hierboven zijn standaard SGLang-opties. Dit zijn degenen die bepalen hoe KTransformers het werk verdeelt tussen CPU en GPU:
| Flag | Waarde | Wat het doet |
|---|---|---|
--kt-method |
FP8 |
Stelt de precisie van de expertgewichten in, passend bij GLM-5.3-Flash' native FP8-checkpoint. |
--kt-cpuinfer |
64 |
Aantal CPU-threads dat wordt gebruikt voor expertberekening. |
--kt-threadpool-count |
2 |
Aantal CPU-threadpools, meestal gelijk aan het aantal NUMA-nodes. |
--kt-num-gpu-experts |
14 |
Aantal experts per MoE-laag dat op de GPU wordt geplaatst. |
--kt-expert-placement-strategy |
uniform |
Hoe GPU-experts worden gekozen. Andere opties zijn frequency, front-loading en random. |
--kt-gpu-prefill-token-threshold |
2048 |
Promptlengte waarboven prefill overschakelt naar het GPU-zijdige layerwise-pad. |
Nu de server draait, kunnen we verifiëren hoe KTransformers GPU VRAM en systeem-RAM gebruikt, en vervolgens het aantal GPU-residente experts wijzigen om te zien hoe resourcegebruik en prestaties verschuiven.
Op RunPod kan free -h misleidend zijn omdat een container mogelijk het totale RAM van de hostmachine ziet in plaats van alleen het geheugen dat beschikbaar is voor de pod. Het is beter om GPU-geheugen en containermemory afzonderlijk te monitoren.
Open een nieuwe terminal en monitor GPU-gebruik:
watch -n 1 nvidia-smi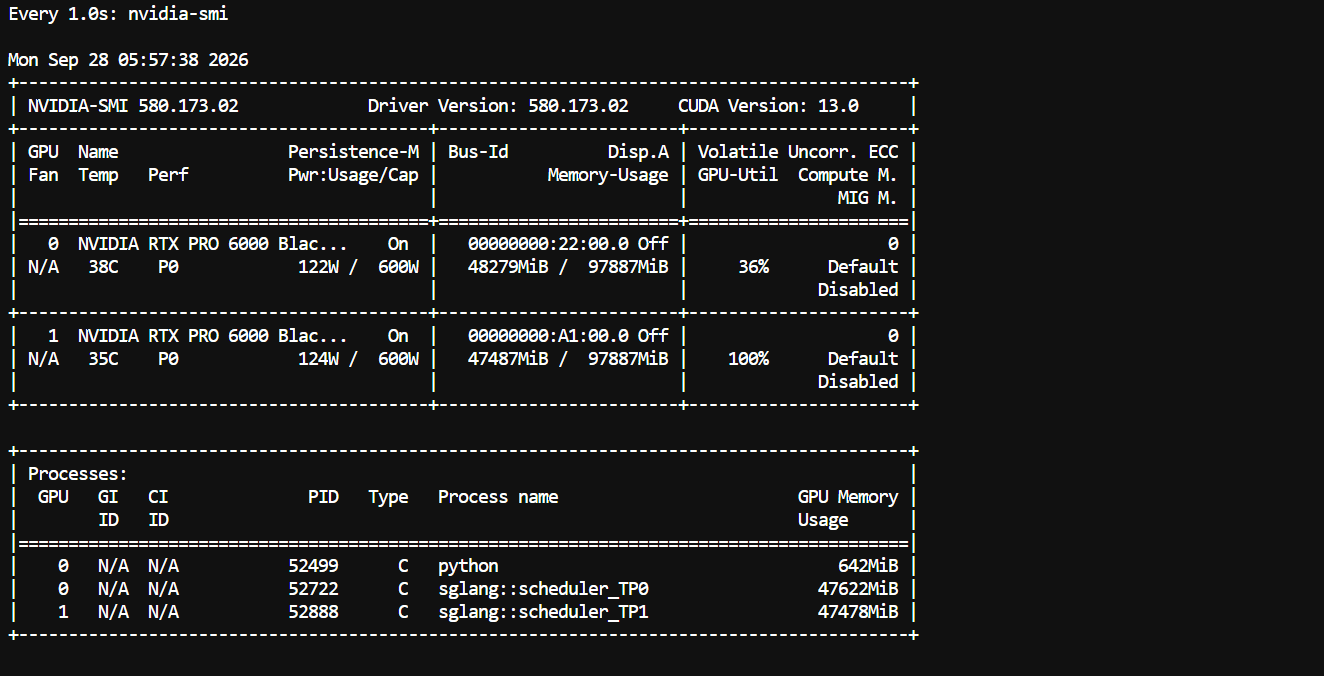
Met onze huidige configuratie gebruikt het volledig geladen model ruwweg 48 GB per GPU, waardoor een groot deel van de VRAM ongebruikt blijft. Dat suggereert dat er ruimte is om meer experts op de GPU's te plaatsen, of om een single-GPU-configuratie te testen met voldoende systeem-RAM.
Voor containermemory lees je de cgroup-geheugencounters direct uit:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'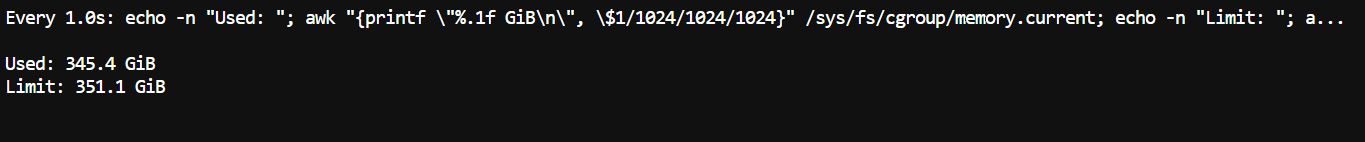
Je zou moeten zien dat een groot deel van het beschikbare systeem-RAM wordt ingenomen door modelgewichten en CPU-zijdige experts. Dit is verwacht: KTransformers houdt bewust veel MoE-experts in RAM in plaats van te eisen dat ze allemaal in VRAM wonen.
--kt-num-gpu-expertsStart vervolgens de server opnieuw met verschillende waarden voor --kt-num-gpu-experts. Vergelijk bijvoorbeeld:
0
10
20
--kt-num-gpu-experts bepaalt hoeveel experts per MoE-laag op de GPU worden geplaatst. Met 0 blijft expertberekening aan de CPU-kant; door de waarde te verhogen verplaats je meer experts naar het GPU-geheugen.
Vergelijk voor elke configuratie GPU-VRAM-gebruik, containermemory-gebruik, tokens per seconde en time to first token. In het algemeen verbruiken meer GPU-experts meer VRAM maar verminderen ze CPU-zijdige expertuitvoering, wat de inferentiesnelheid kan verbeteren wanneer voldoende VRAM beschikbaar is.
Een kanttekening uit de officiële tutorial: wanneer Layerwise Prefill is ingeschakeld voor GLM-5.3-Flash, normaliseert de huidige implementatie het aantal residente GPU-experts naar nul. Als VRAM-gebruik nauwelijks verandert tussen runs, is dit waarschijnlijk de reden.
Dit experiment laat het belangrijkste voordeel van KTransformers zien: CPU-RAM en GPU-VRAM worden afstelbare onderdelen van hetzelfde inferentiesysteem, zodat je geheugenplaatsing kunt afwegen tegen snelheid in plaats van te eisen dat het hele MoE-model op de GPU's past.
Met de server actief kunnen we nu bevestigen dat het model beschikbaar is en een echt verzoek sturen via de OpenAI-compatibele API van SGLang.
Controleer eerst of het model is geregistreerd:
curl http://localhost:30000/v1/modelsStuur vervolgens een testprompt:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'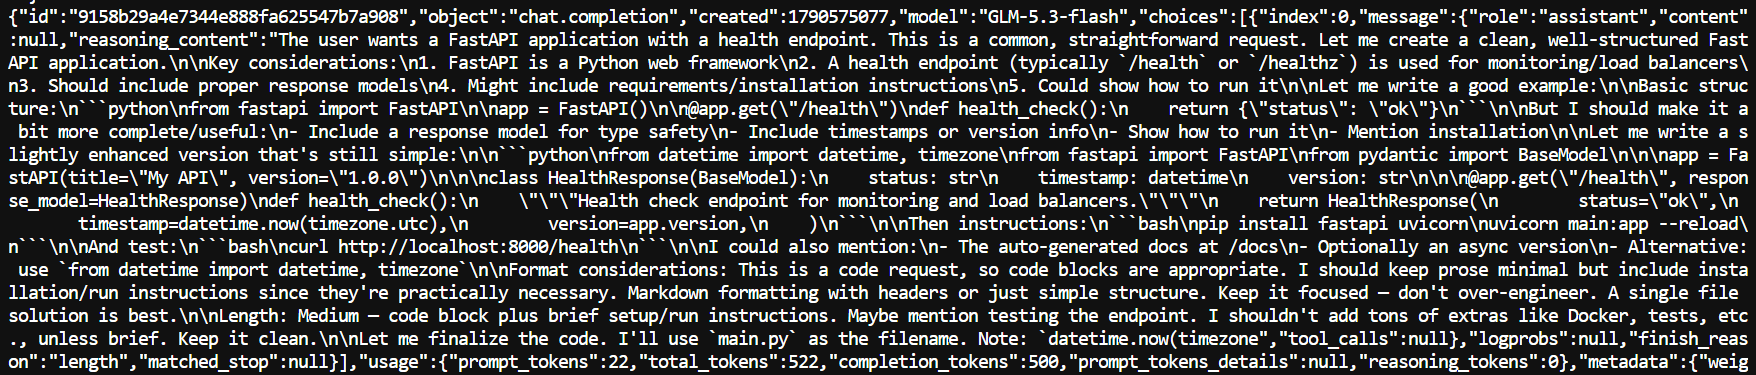
Als de setup correct werkt, geeft de server een normale chatcompletion-respons terug met gegenereerde code en gebruiksstatistieken.
Pi is een lichtgewicht coding agent die elke OpenAI-compatibele model-backend kan gebruiken, waardoor GLM-5.3-Flash direct aan codingtaken kan werken in plaats van alleen prompts te beantwoorden.
Installeer Pi met het installatiescript:
curl -fsSL https://pi.dev/install.sh | sh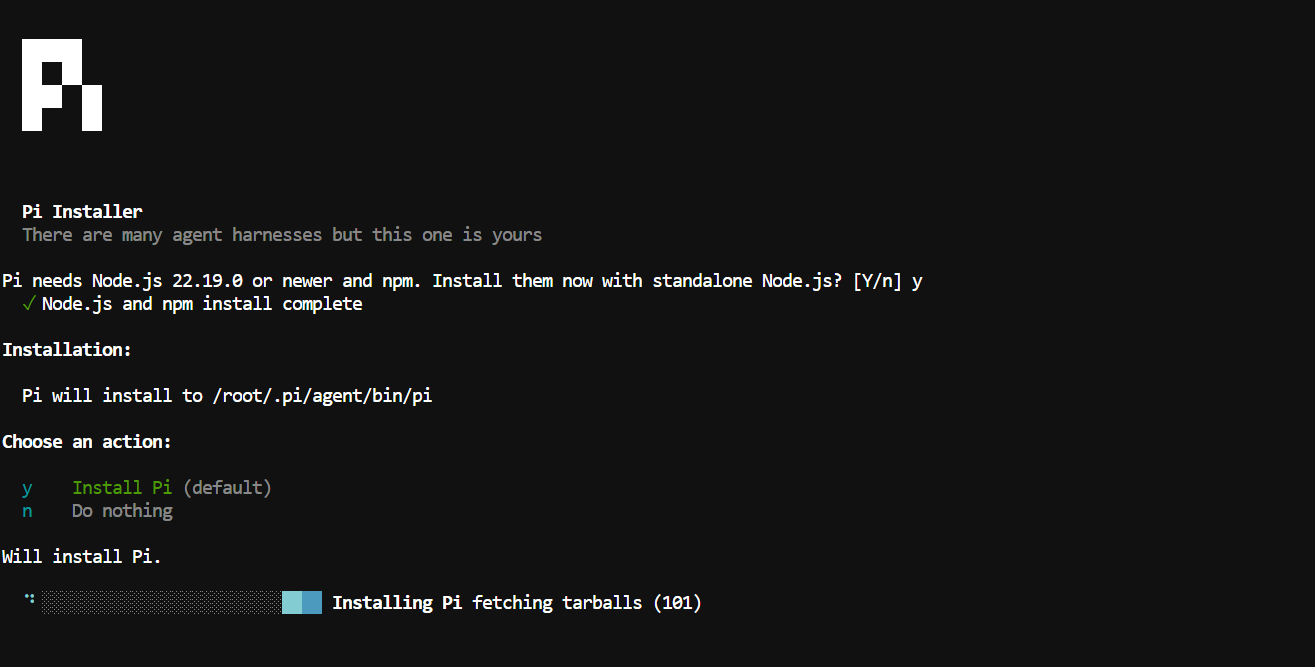
Voeg Pi daarna toe aan je PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcMaak een modelconfiguratie die Pi naar de lokale KTransformers-server wijst:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Start Pi:
piOpen vervolgens de modelkiezer:
/model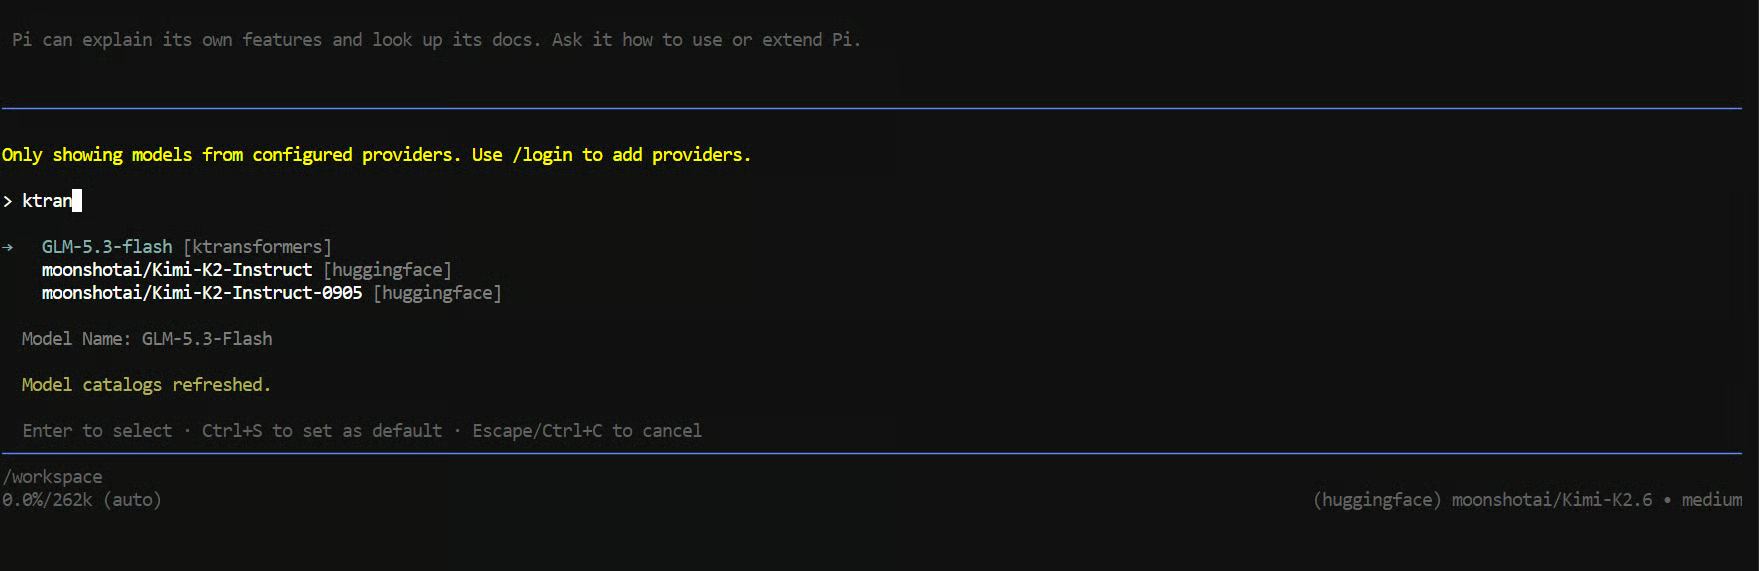
Kies GLM-5.3-Flash en probeer een echte codingtaak:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.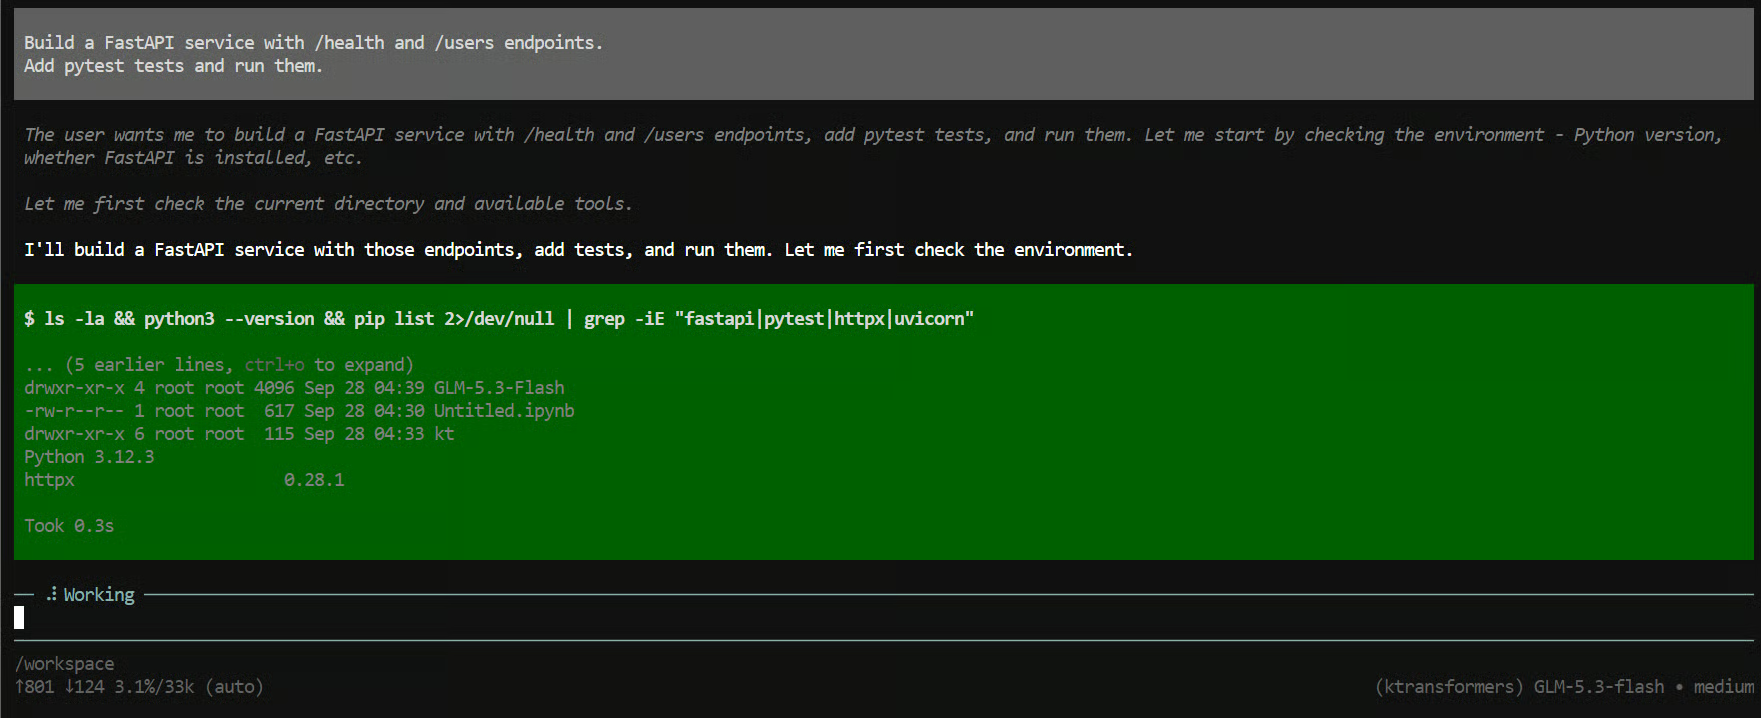
Binnen enkele seconden zou Pi bestanden moeten gaan aanmaken, de API schrijven, tests draaien en problemen oplossen terwijl het de taak doorloopt.
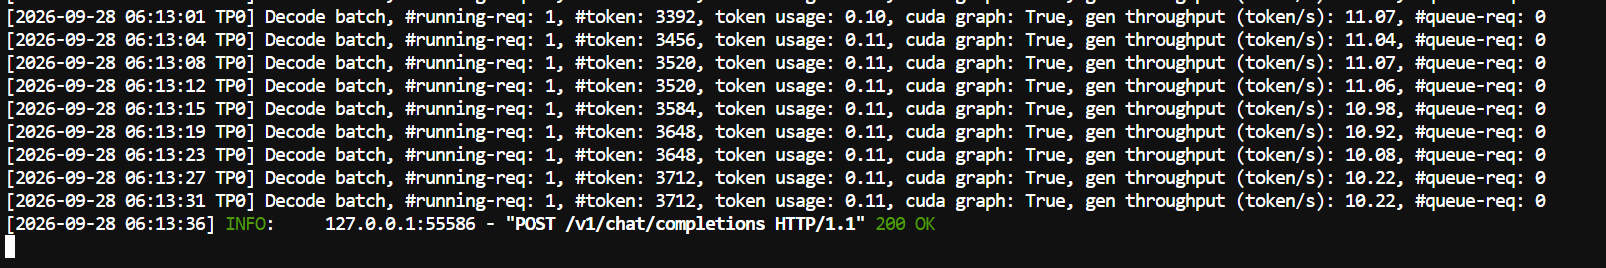
Je kunt ook het eerste terminalvenster bekijken, waar de SGLang-server draait. In onze test lag de genereersnelheid rond de 11 tokens per seconde. Dat is redelijk voor een model van deze grootte met substantiële CPU-offloading, en de setup kan verder worden getuned door meer experts naar de GPU's te verplaatsen.
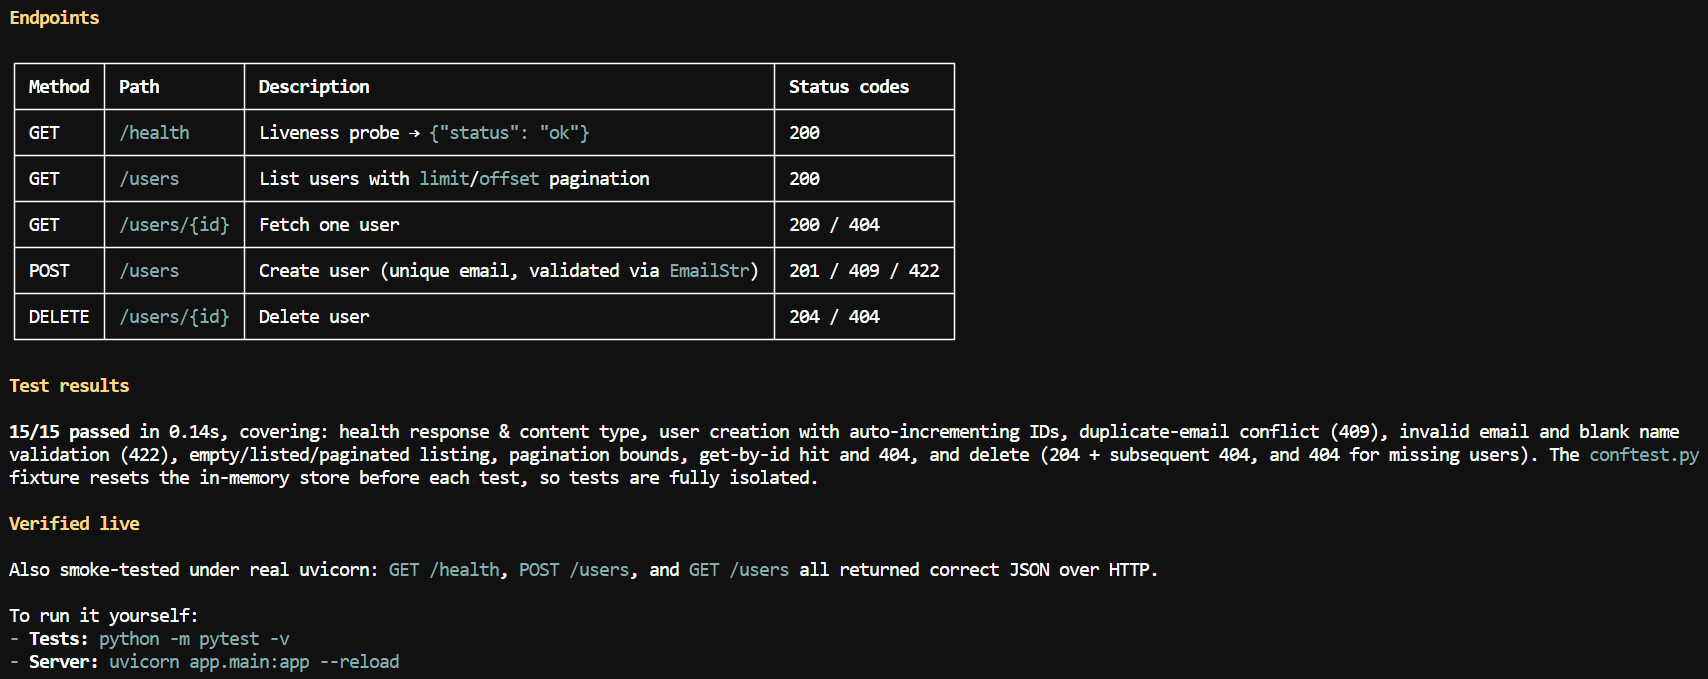
Binnen enkele minuten had het model de endpoints gemaakt, de tests geschreven en uitgevoerd, een smoke test gedaan en een korte samenvatting geproduceerd met uitleg om het project te draaien.
Het interessante is dat het volledige model lokaal draait, ook al zijn de gewichten veel groter dan de beschikbare GPU VRAM. Pi verzorgt de coding-agentloop, terwijl SGLang en KTransformers de daadwerkelijke modelinferentie afhandelen.
KTransformers is niet de enige manier om een model te draaien dat groter is dan je VRAM. vLLM en llama.cpp ondersteunen beide CPU-offloading, maar verdelen het werk anders:
| Framework | Hoe het CPU-geheugen gebruikt | Waar expertberekening draait | Beste toepassing |
|---|---|---|---|
| vLLM | Offloadt een deel van de gewichten naar CPU-RAM (--cpu-offload-gb) en zet ze over naar de GPU wanneer nodig |
GPU | Serving met hoge throughput wanneer het model grotendeels in VRAM past |
| llama.cpp | Splitst lagen tussen CPU en GPU, en kan MoE-experttensors in RAM houden (--n-cpu-moe) |
CPU en GPU | Gekwantiseerde GGUF-modellen op consumentenhardware |
| KTransformers + SGLang | Houdt de meeste experts in RAM en plaatst een vast aantal experts per laag op de GPU | CPU en GPU, met geoptimaliseerde AVX-512 expertkernen | Modellen met native precisie op machines met honderden GB RAM |
SGLang en KTransformers concurreren in deze setup niet. SGLang verzorgt de serving-kant, terwijl KTransformers de heterogene CPU-GPU MoE-uitvoering afhandelt.
Wat ik het leukst vond aan deze setup is dat KTransformers iets net even anders doet dan de gebruikelijke inferentiestack. In plaats van alleen in termen van modellagen te denken, plaatst het individuele experts op de GPU terwijl andere in systeem-RAM blijven, en de CPU neemt daadwerkelijk deel aan de expertberekening. De CPU fungeert niet alleen als overloopopslag.
In deze tutorial hebben we het volledige GLM-5.3-Flash-model lokaal gedraaid op twee RTX PRO 6000 GPU's, ook al zijn de gewichten veel groter dan de beschikbare VRAM.
Het is niet de snelste setup. Ik haalde rond de 11 tokens per seconde, en er is nog genoeg ruimte om het aantal en de plaatsing van GPU-experts te tunen. Je kunt ook experimenteren met een enkele GPU als je genoeg RAM hebt; ik gebruikte er hier twee om de setup simpelweg wat meer speling te geven.
Voor mij is dat de belangrijkste les uit deze gids: KTransformers is niet bijzonder omdat het CPU-offloading heeft uitgevonden. Het is bijzonder omdat het CPU-RAM, CPU-compute en GPU-compute laat samenwerken rondom de sparse structuur van MoE-modellen.
Topcursussen op DataCamp
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

