
Khóa học
Các mô hình Transformer với PyTorch
2 giờ
9.2K
KTransformers là một framework suy luận mã nguồn mở cho phép CPU và GPU cùng chủ động thực thi các expert khác nhau trong quá trình suy luận, nhờ đó bạn có thể chạy các mô hình Mixture-of-Experts (MoE) lớn hơn rất nhiều so với bộ nhớ GPU. Các framework như vLLM cũng có thể offload trọng số sang bộ nhớ CPU, nhưng KTransformers được xây dựng chuyên biệt cho cấu trúc thưa của mô hình MoE.
Trong hướng dẫn này, chúng ta sẽ dùng KTransformers và SGLang để chạy GLM-5.3-Flash, một mô hình 320 tỷ tham số với trọng số không thể vừa trong 192 GB VRAM. Chúng ta sẽ theo dõi mức sử dụng bộ nhớ CPU và GPU, thử nghiệm cách đặt expert, kiểm thử API tương thích OpenAI và kết nối mô hình với Pi làm agent lập trình cục bộ.
Ý tưởng chính rất đơn giản: thay vì coi bộ nhớ CPU là kho lưu trữ tràn, KTransformers sử dụng cả năng lực tính toán của CPU và GPU trong quá trình suy luận.
KTransformers là một framework suy luận mã nguồn mở để chạy các mô hình ngôn ngữ rất lớn bằng cách kết hợp VRAM GPU và RAM CPU. Thông thường, phục vụ một mô hình lớn đòi hỏi tải phần lớn trọng số vào bộ nhớ GPU, điều này trở nên tốn kém rất nhanh với một mô hình cỡ GLM-5.3-Flash.
KTransformers áp dụng một cách tiếp cận khác: giữ nhiều trọng số expert của MoE trong bộ nhớ hệ thống và dành bộ nhớ GPU cho những phần suy luận hưởng lợi nhiều nhất từ tăng tốc GPU.
Điều này phù hợp với mô hình MoE vì không phải expert nào cũng được dùng cho mọi token. Ví dụ, GLM-5.3-Flash có 288 expert được định tuyến, nhưng bộ định tuyến của nó chỉ chọn 8 expert (cộng 1 expert dùng chung) cho mỗi token. Vì vậy KTransformers có thể phân phối tính toán expert giữa CPU và GPU:
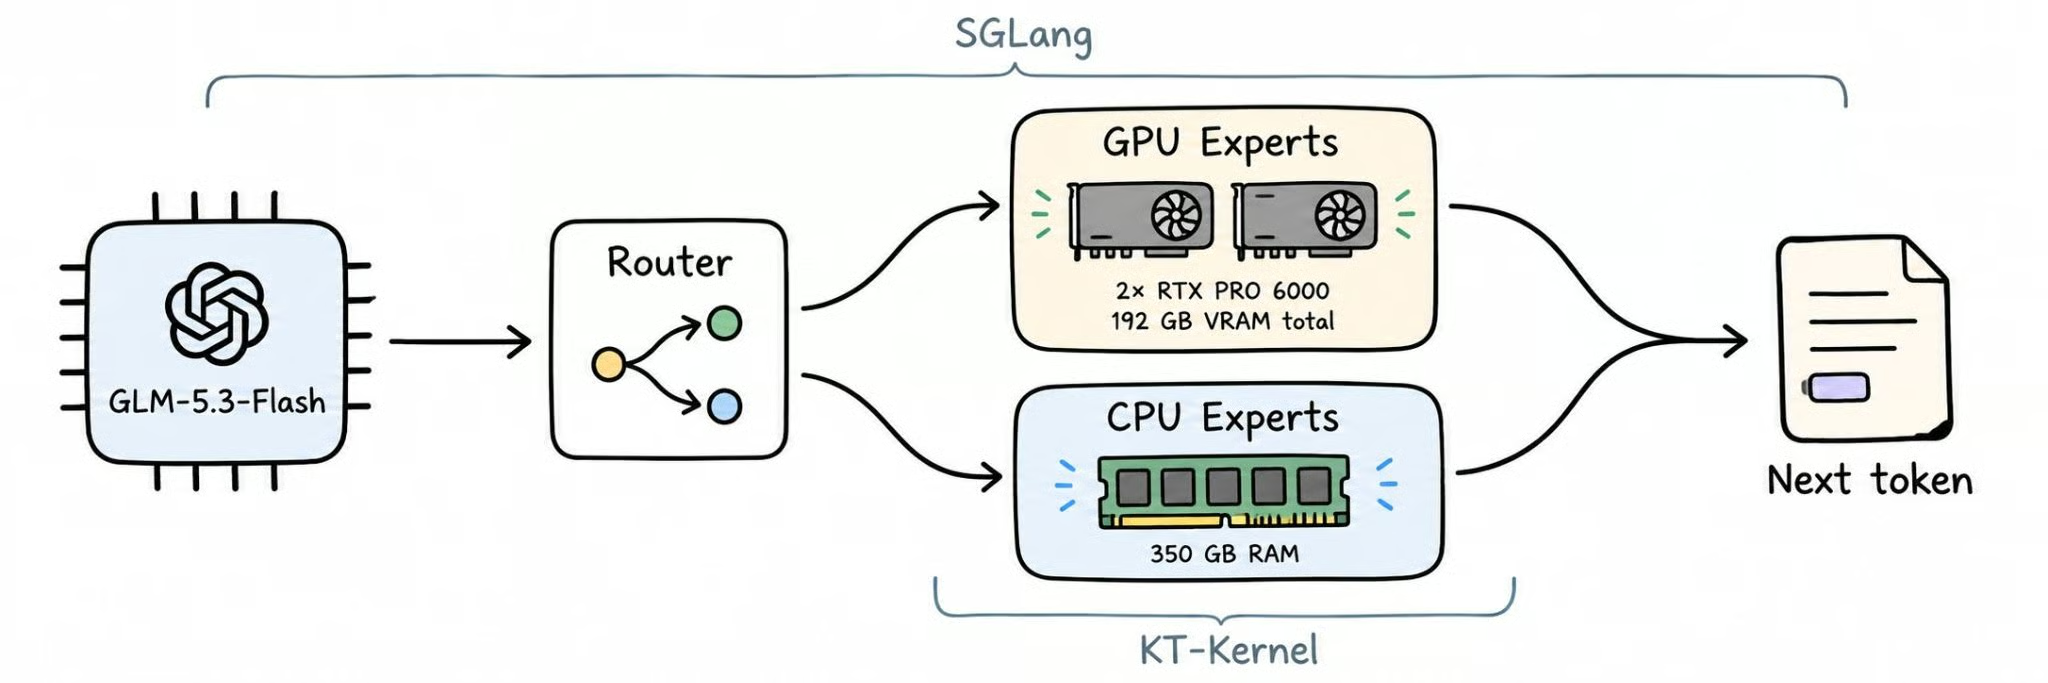
Ngăn xếp KTransformers hiện tại tích hợp KT-Kernel với SGLang cho suy luận dị thể CPU-GPU. Mỗi thành phần đảm nhiệm một vai trò khác nhau:
KTransformers cũng hỗ trợ thay đổi vị trí expert dựa trên mẫu tải công việc, như mô tả trong hướng dẫn lập lịch expert.
Nói cách khác, KTransformers coi bộ nhớ CPU và bộ nhớ GPU như một hệ thống suy luận chung thay vì yêu cầu toàn bộ mô hình phải nằm trong VRAM GPU. Đó là điều cho phép các mô hình MoE rất lớn chạy trên phần cứng có ít bộ nhớ GPU hơn nhiều so với nhu cầu thông thường.
GLM-5.3-Flash là mô hình MoE open-weight, đa phương thức gốc của Z.ai, phát hành theo giấy phép MIT vào tháng 8/2026. Dù tên là "Flash", đây là một mô hình lớn: tổng 320B tham số, với khoảng 18B tham số hoạt động mỗi token.
Thông số quan trọng cho suy luận cục bộ:
zai-org/GLM-5.3-Flash)KTransformers đọc trực tiếp trọng số FP8 chính thức, nên không cần bước chuyển đổi hay lượng tử hóa bổ sung. Để xem benchmark và tổng quan đầy đủ về mô hình, hãy xem hướng dẫn GLM-5.3-Flash của chúng tôi.
Với GLM-5.3-Flash, câu hỏi về phần cứng chủ yếu xoay quanh RAM hệ thống. Hướng dẫn KTransformers chính thức cho GLM-5.3-Flash khuyến nghị dành tối thiểu 350 GB bộ nhớ hệ thống sẵn có.
Trong hướng dẫn này, chúng tôi dùng một phiên bản RunPod với cấu hình xấp xỉ:
GPU:         2× RTX PRO 6000
VRAM:        96 GB mỗi chiếc
Tổng VRAM:   192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11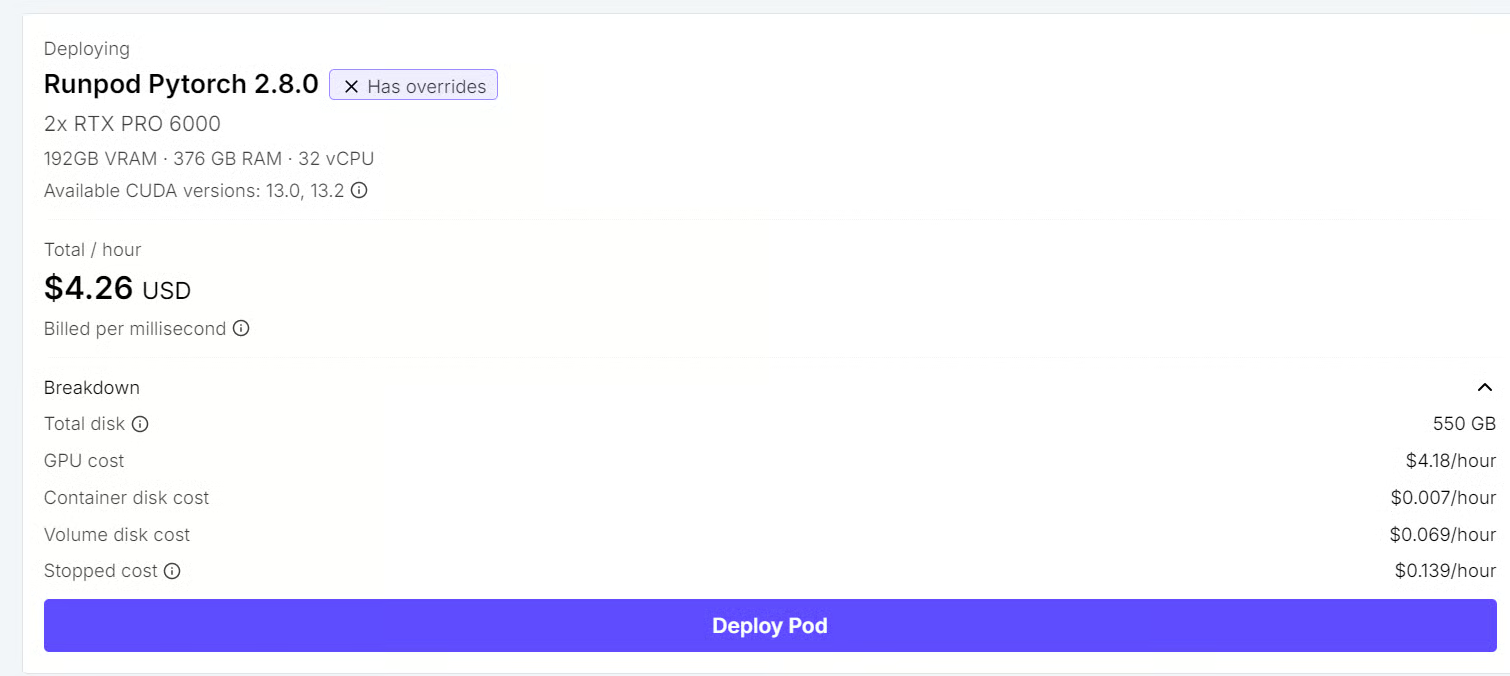
Checkpoint FP8 chính thức của GLM-5.3-Flash khoảng 306 GiB (khoảng 329 GB), trong khi hai GPU của chúng tôi cung cấp tổng cộng 192 GB VRAM. Vì vậy, không thể chỉ đơn giản tải toàn bộ mô hình vào bộ nhớ GPU.
Thay vào đó, KTransformers giữ một phần lớn trọng số MoE trong RAM hệ thống và chuyển các phép tính hữu ích nhất sang GPU. Khuyến nghị 350 GB để chừa đủ chỗ cho trọng số mô hình cộng với chi phí runtime.
Nhiều bộ nhớ GPU hơn không loại bỏ nhu cầu về RAM trong thiết lập này. Bộ nhớ CPU là một phần có chủ đích trong thiết kế suy luận dị thể của KTransformers: trọng số expert nằm trong RAM trong khi GPU xử lý những phần của mô hình hưởng lợi nhiều nhất từ tăng tốc.
Triển khai GLM-5.3-Flash hiện tại cũng có yêu cầu cụ thể về CPU và GPU:
Có, miễn là bạn có đủ RAM hệ thống và CPU được hỗ trợ. Hướng dẫn chính thức bao gồm cấu hình một GPU đặt --kt-num-gpu-experts 0, để các expert MoE được xử lý phía CPU.
Chúng tôi dùng hai GPU RTX PRO 6000 ở đây, nhưng đó không phải yêu cầu tối thiểu cứng. GPU thứ hai cho chúng tôi thêm VRAM và khoảng đệm khi thử nghiệm với một triển khai KTransformers còn khá mới, thay vì tối ưu hóa cho cấu hình phần cứng nhỏ nhất có thể chạy mô hình.
Tạo một môi trường Python 3.11 sạch và cài KTransformers với hỗ trợ SGLang:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Kiểm tra KTransformers, KT-Kernel, SGLang và CUDA được nhận diện đúng:
kt versionBạn sẽ thấy kết quả giống như:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Điều này xác nhận runtime KTransformers và backend SGLang đã được cài đặt và sẵn sàng sử dụng.
Trước khi khởi động máy chủ, tải checkpoint GLM-5.3-Flash chính thức từ Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Checkpoint khoảng 306 GiB, nên thời gian tải sẽ phụ thuộc vào băng thông của bạn.
Sau đó trỏ KTransformers đến đường dẫn mô hình cục bộ:
export MODEL_PATH=/workspace/GLM-5.3-FlashBây giờ khởi chạy GLM-5.3-Flash với song song tensor hai chiều, sử dụng cả hai GPU RTX PRO 6000. Mô hình hỗ trợ tối đa 1M token ngữ cảnh, và ví dụ chính thức dùng cấu hình đã kiểm chứng 501.025 token. Thay vào đó, chúng tôi bắt đầu với cửa sổ 32K để giữ mức sử dụng bộ nhớ dễ dự đoán khi thử nghiệm.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45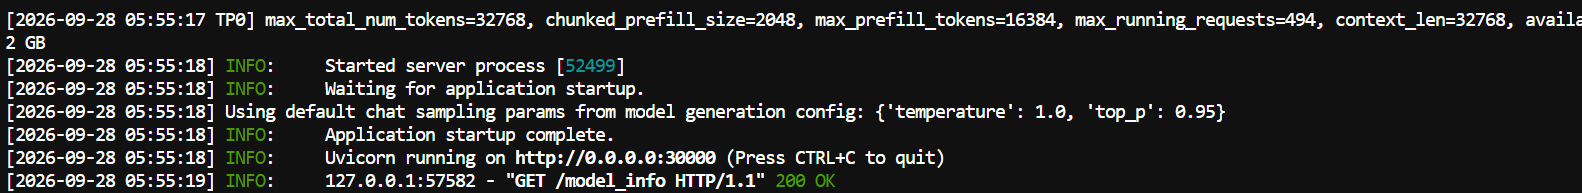
Cấu hình này cung cấp mô hình qua một máy chủ SGLang tương thích OpenAI trên cổng 30000. Hai GPU được dùng với --tp-size 2, trong khi KTransformers giữ một phần khối lượng MoE trên CPU và đặt các expert được chọn lên GPU.
Các thiết lập ở đây được cố ý thận trọng cho lần chạy đầu: ngữ cảnh 32K, 85% bộ nhớ GPU tĩnh, 14 expert trên GPU và 64 luồng suy luận CPU. Khi máy chủ ổn định, bạn có thể thử tăng cửa sổ ngữ cảnh, tăng số expert trên GPU hoặc điều chỉnh bộ nhớ để cải thiện thông lượng.
Phần lớn cờ trên là tùy chọn tiêu chuẩn của SGLang. Đây là những cờ điều khiển cách KTransformers chia việc giữa CPU và GPU:
| Cờ | Giá trị | Chức năng |
|---|---|---|
--kt-method |
FP8 |
Đặt độ chính xác của trọng số expert, khớp với checkpoint FP8 gốc của GLM-5.3-Flash. |
--kt-cpuinfer |
64 |
Số luồng CPU dùng cho tính toán expert. |
--kt-threadpool-count |
2 |
Số lượng thread pool CPU, thường khớp với số node NUMA. |
--kt-num-gpu-experts |
14 |
Số expert mỗi tầng MoE được đặt trên GPU. |
--kt-expert-placement-strategy |
uniform |
Cách chọn expert trên GPU. Tùy chọn khác gồm frequency, front-loading và random. |
--kt-gpu-prefill-token-threshold |
2048 |
Độ dài prompt mà trên đó prefill chuyển sang đường đi theo tầng phía GPU. |
Khi máy chủ đang chạy, chúng ta có thể xác minh cách KTransformers sử dụng VRAM GPU và RAM hệ thống, sau đó thay đổi số lượng expert cư trú trên GPU để xem cách sử dụng tài nguyên và hiệu năng thay đổi.
Trên RunPod, free -h có thể gây hiểu nhầm vì container có thể thấy tổng RAM của máy chủ thay vì chỉ bộ nhớ khả dụng cho pod. Tốt hơn là theo dõi bộ nhớ GPU và bộ nhớ container riêng biệt.
Mở một terminal mới và theo dõi GPU:
watch -n 1 nvidia-smi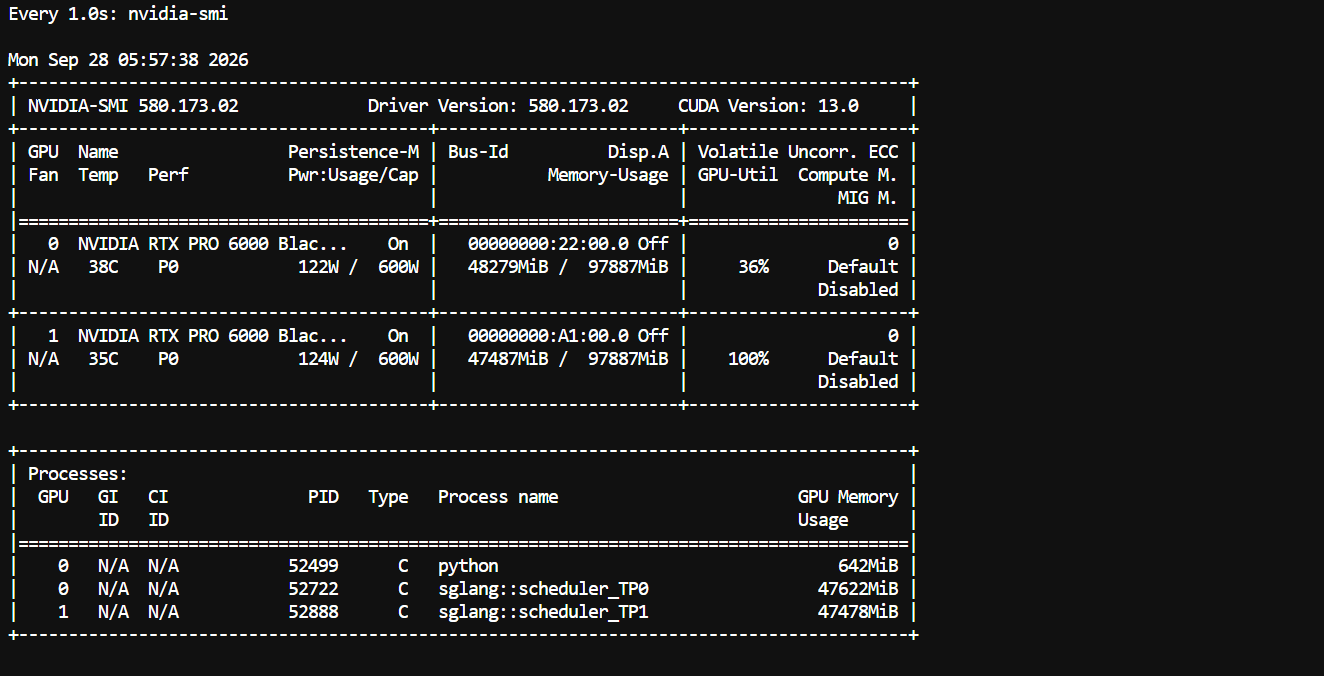
Với cấu hình hiện tại, mô hình khi tải đầy dùng khoảng 48 GB mỗi GPU, để lại nhiều VRAM chưa dùng. Điều này cho thấy có thể đặt thêm expert lên GPU, hoặc thử cấu hình một GPU nếu có đủ RAM hệ thống.
Với RAM container, đọc trực tiếp các bộ đếm bộ nhớ cgroup:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'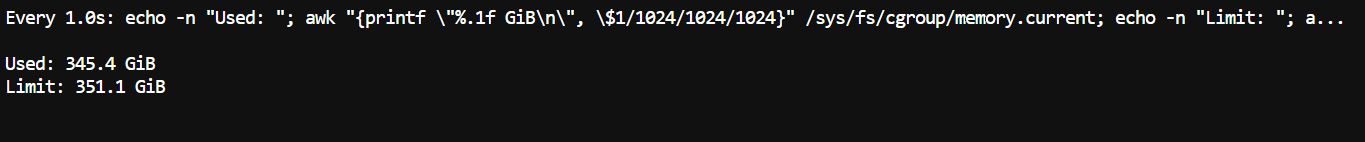
Bạn sẽ thấy một phần lớn RAM hệ thống khả dụng bị chiếm bởi trọng số mô hình và các expert phía CPU. Điều này là bình thường: KTransformers cố ý giữ nhiều expert MoE trong RAM thay vì yêu cầu tất cả phải ở VRAM.
--kt-num-gpu-expertsTiếp theo, khởi động lại máy chủ với các giá trị khác nhau cho --kt-num-gpu-experts. Ví dụ, so sánh:
0
10
20
--kt-num-gpu-experts điều khiển số expert mỗi tầng MoE được đặt trên GPU. Với 0, tính toán expert ở lại phía CPU; tăng giá trị sẽ chuyển thêm expert vào bộ nhớ GPU.
Với mỗi cấu hình, so sánh mức sử dụng VRAM GPU, mức sử dụng RAM container, số token mỗi giây và thời gian đến token đầu tiên. Nói chung, nhiều expert trên GPU sẽ tiêu thụ thêm VRAM nhưng giảm tính toán expert phía CPU, từ đó có thể cải thiện hiệu năng suy luận khi có đủ VRAM.
Một lưu ý từ hướng dẫn chính thức: khi Layerwise Prefill được bật cho GLM-5.3-Flash, triển khai hiện tại chuẩn hóa số expert cư trú trên GPU về 0. Nếu mức sử dụng VRAM hầu như không thay đổi giữa các lần chạy, đây có thể là nguyên nhân.
Thử nghiệm này cho thấy lợi thế chính của KTransformers: RAM CPU và VRAM GPU trở thành các phần có thể tinh chỉnh của cùng một hệ thống suy luận, nhờ đó bạn có thể đánh đổi vị trí bộ nhớ và tốc độ thay vì buộc toàn bộ mô hình MoE phải nằm trên GPU.
Khi máy chủ đang chạy, chúng ta có thể xác nhận mô hình đã sẵn sàng và gửi một yêu cầu thực qua API tương thích OpenAI của SGLang.
Trước hết, kiểm tra mô hình đã được đăng ký:
curl http://localhost:30000/v1/modelsTiếp theo, gửi một prompt thử nghiệm:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'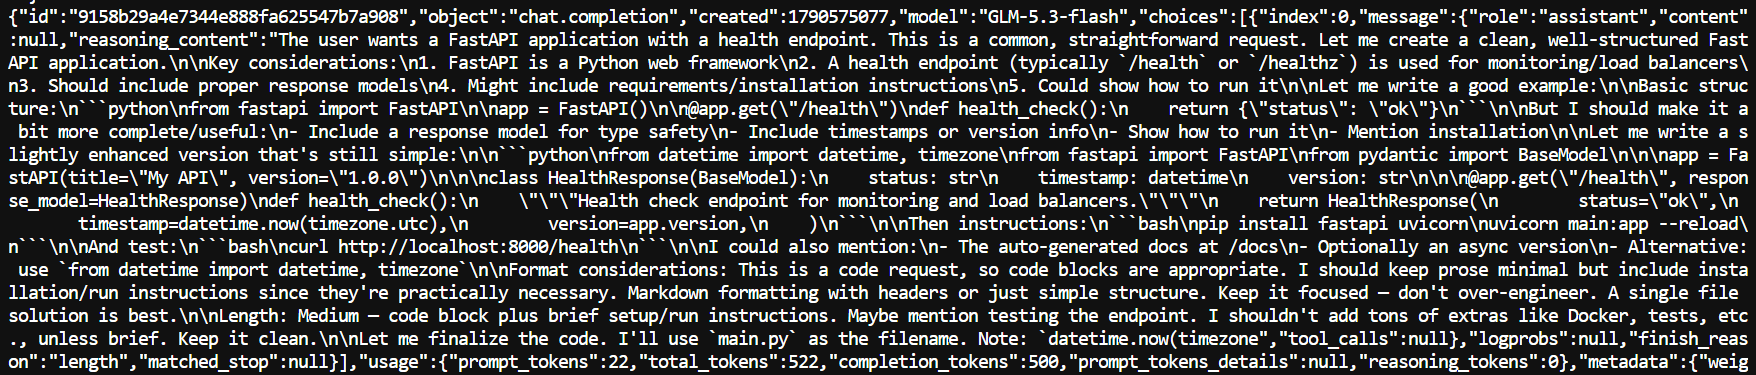
Nếu thiết lập hoạt động đúng, máy chủ sẽ trả về phản hồi chat completion thông thường chứa mã sinh ra và thống kê sử dụng.
Pi là một agent lập trình gọn nhẹ có thể dùng bất kỳ mô hình tương thích OpenAI nào làm backend, cho phép GLM-5.3-Flash trực tiếp xử lý tác vụ lập trình thay vì chỉ trả lời prompt.
Cài Pi bằng script cài đặt:
curl -fsSL https://pi.dev/install.sh | sh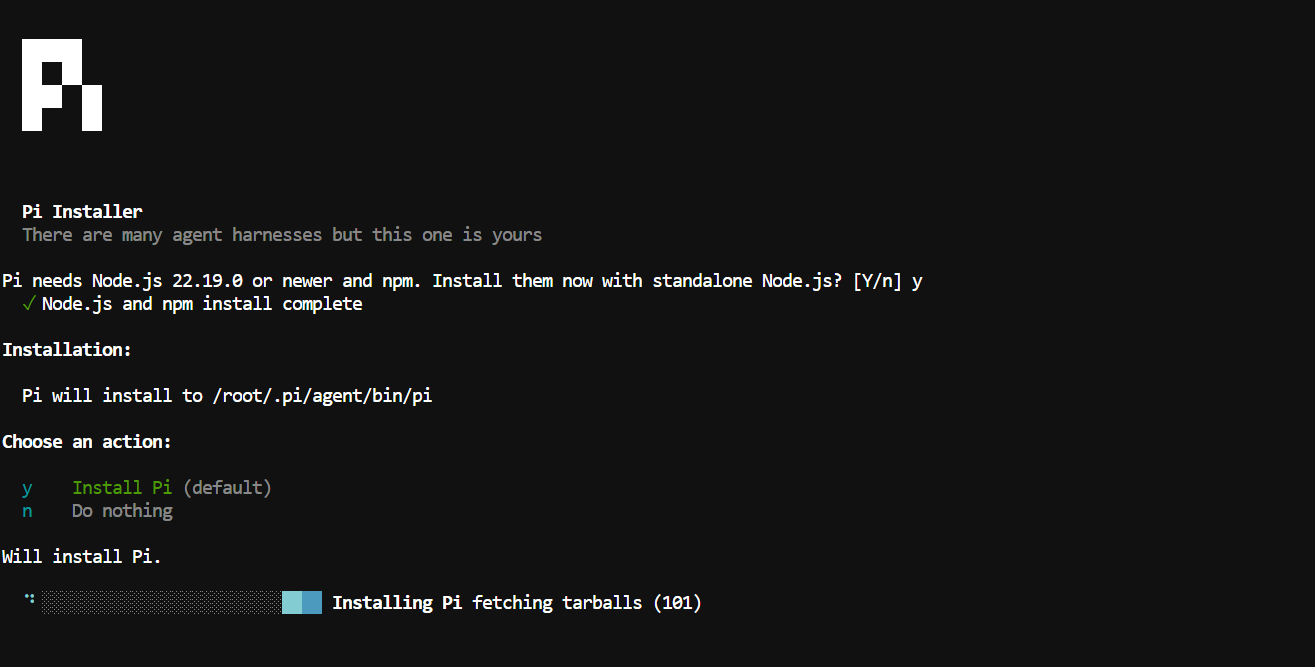
Sau đó thêm Pi vào PATH của bạn:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcTạo cấu hình mô hình để trỏ Pi tới máy chủ KTransformers cục bộ:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Khởi động Pi:
piSau đó mở bộ chọn mô hình:
/model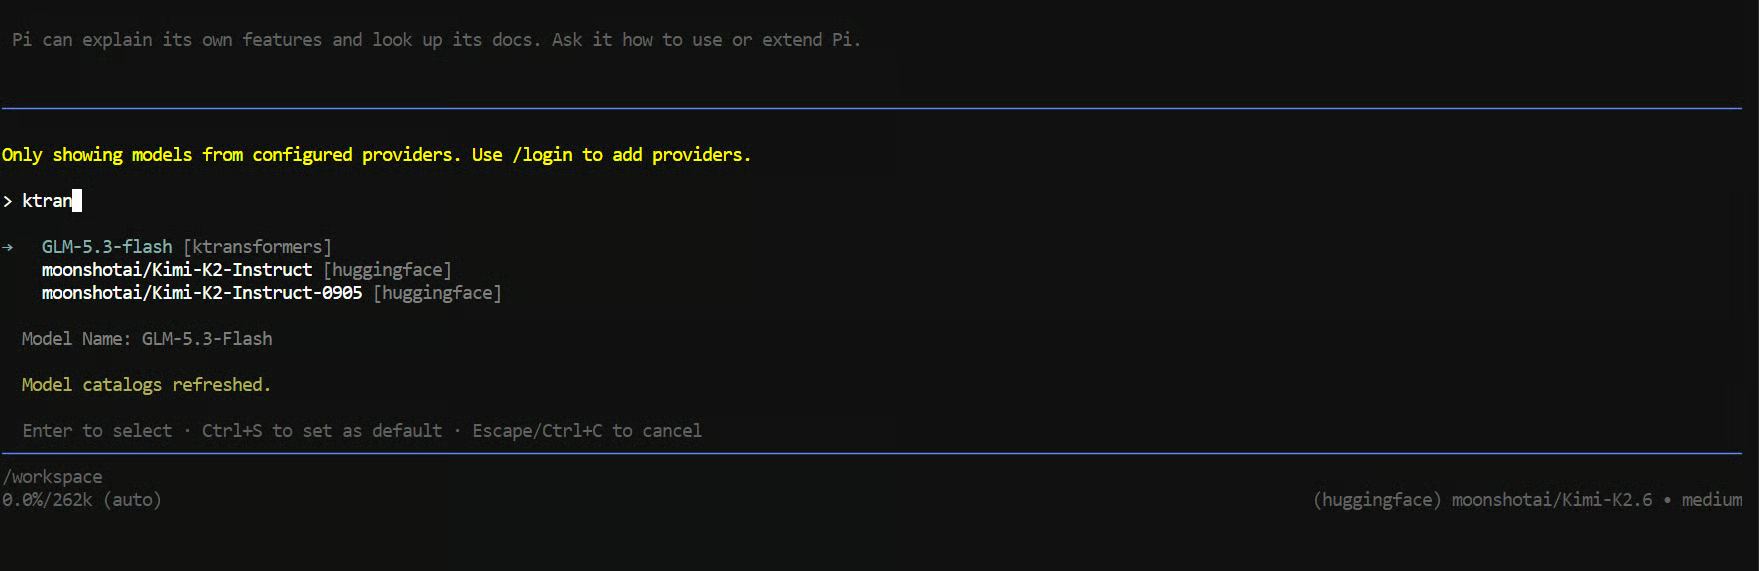
Chọn GLM-5.3-Flash và thử một tác vụ lập trình thực tế:
Xây dựng dịch vụ FastAPI với các endpoint /health và /users.
Thêm kiểm thử pytest và chạy chúng.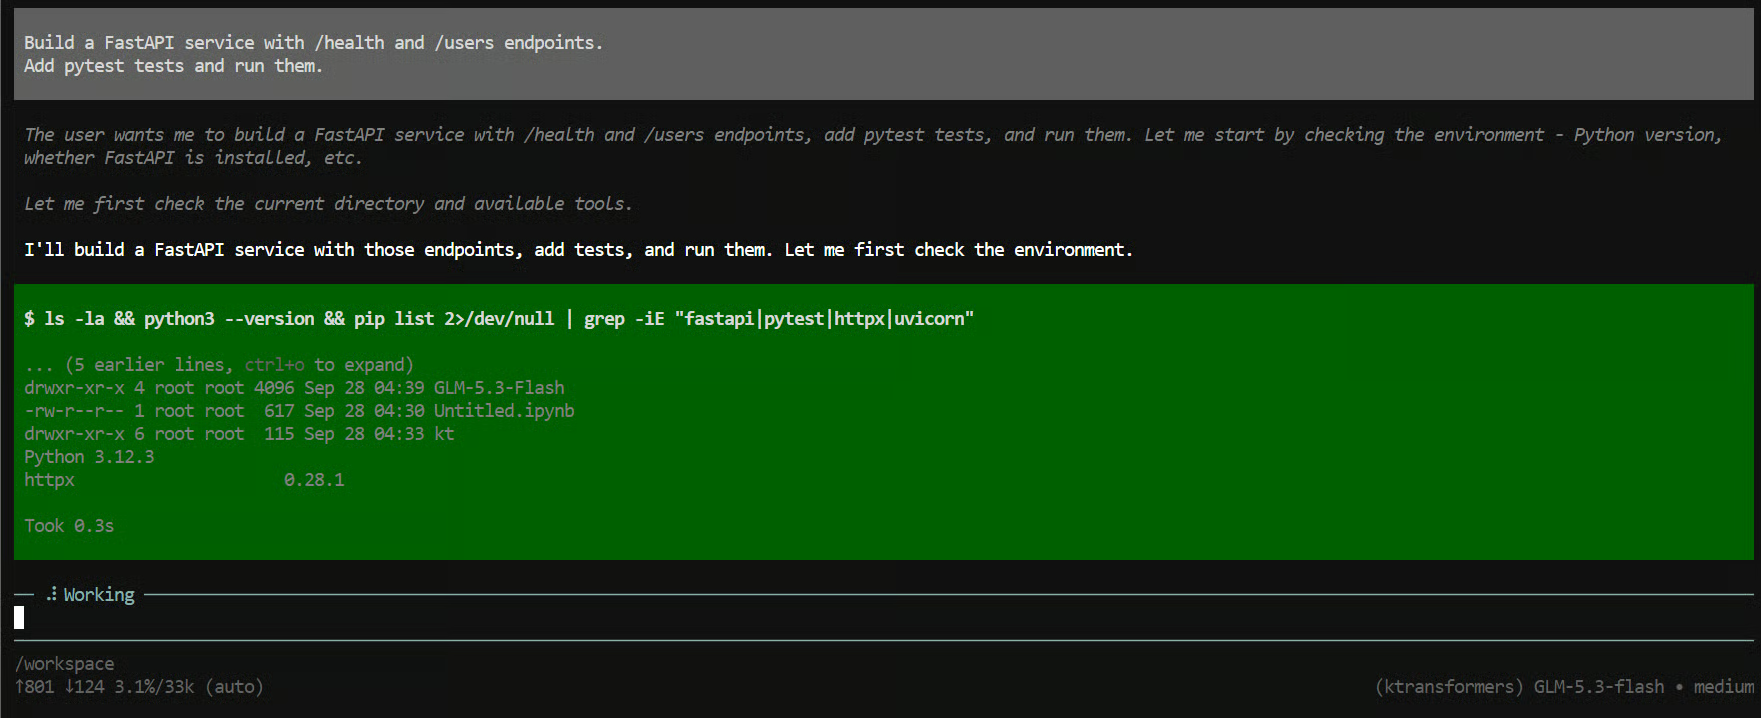
Trong vài giây, Pi sẽ bắt đầu tạo tệp, viết API, chạy kiểm thử và sửa lỗi khi xử lý tác vụ.
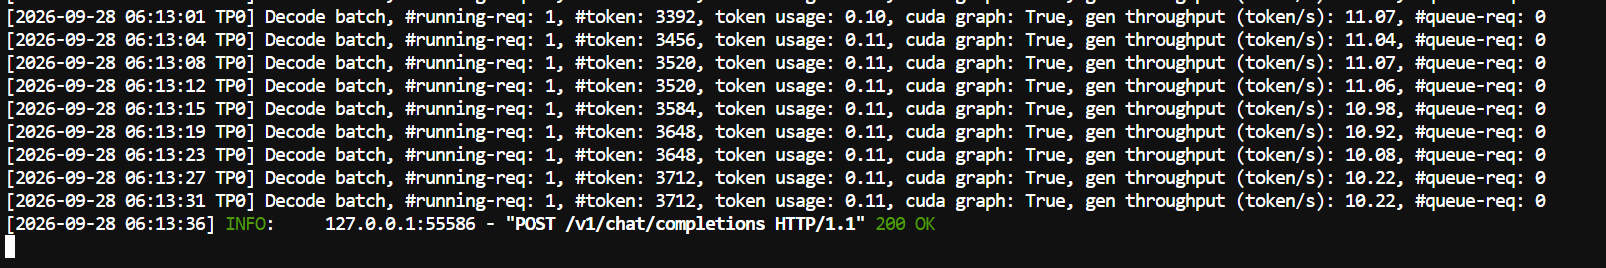
Bạn cũng có thể theo dõi terminal đầu tiên, nơi máy chủ SGLang đang chạy. Trong thử nghiệm của chúng tôi, tốc độ sinh khoảng 11 token mỗi giây. Đây là mức hợp lý với một mô hình cỡ này khi offload đáng kể sang CPU, và có thể tiếp tục tinh chỉnh bằng cách chuyển thêm expert lên GPU.
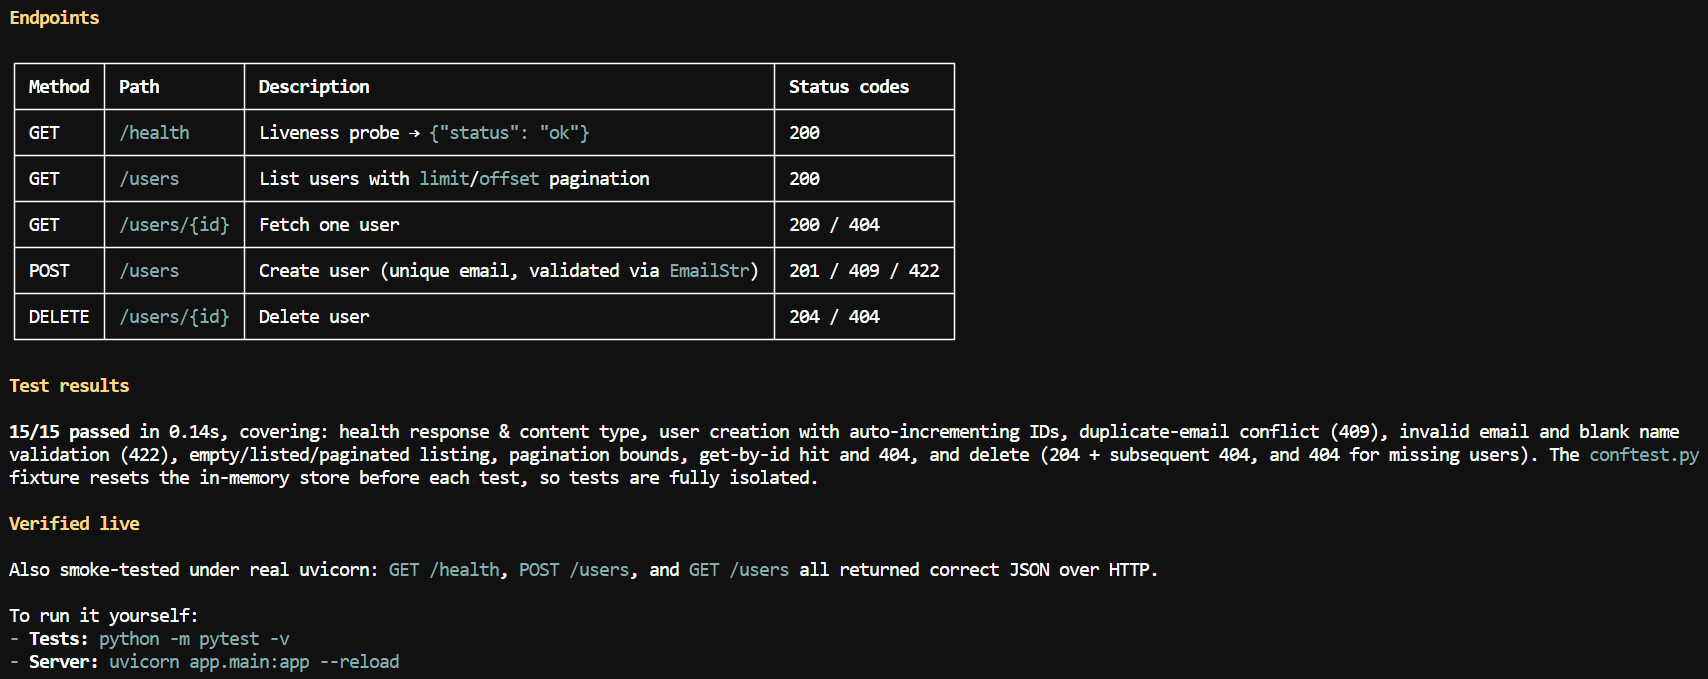
Trong vài phút, mô hình đã tạo các endpoint, viết và chạy kiểm thử, thực hiện smoke test và tạo một tóm tắt ngắn giải thích cách chạy dự án.
Điều thú vị là toàn bộ mô hình chạy cục bộ dù trọng số của nó lớn hơn nhiều so với VRAM GPU sẵn có. Pi đảm nhận vòng lặp agent lập trình, còn SGLang và KTransformers đảm nhận phần suy luận mô hình thực tế.
KTransformers không phải cách duy nhất để chạy mô hình lớn hơn VRAM của bạn. vLLM và llama.cpp đều hỗ trợ offload sang CPU, nhưng họ chia việc theo cách khác:
| Framework | Cách dùng bộ nhớ CPU | Nơi chạy tính toán expert | Phù hợp nhất cho |
|---|---|---|---|
| vLLM | Offload một phần trọng số sang RAM CPU (--cpu-offload-gb) và chuyển chúng lên GPU khi cần |
GPU | Phục vụ thông lượng cao khi mô hình phần lớn vừa VRAM |
| llama.cpp | Chia lớp giữa CPU và GPU, và có thể giữ tensor expert MoE trong RAM (--n-cpu-moe) |
CPU và GPU | Mô hình GGUF đã lượng tử trên phần cứng phổ thông |
| KTransformers + SGLang | Giữ hầu hết expert trong RAM và đặt một số expert mỗi tầng lên GPU | CPU và GPU, với kernel expert AVX-512 tối ưu hóa | Mô hình MoE độ chính xác gốc trên máy có hàng trăm GB RAM |
SGLang và KTransformers không cạnh tranh trong thiết lập này. SGLang xử lý phần phục vụ, còn KTransformers xử lý thực thi MoE dị thể CPU-GPU.
Điều tôi thích nhất ở thiết lập này là KTransformers làm khác một chút so với ngăn xếp suy luận thường thấy. Thay vì chỉ nghĩ theo tầng mô hình, nó đặt từng expert lên GPU trong khi giữ những expert khác trong RAM hệ thống, và CPU thực sự tham gia tính toán expert. CPU không chỉ đóng vai trò kho lưu trữ tràn.
Trong hướng dẫn này, chúng ta đã chạy toàn bộ mô hình GLM-5.3-Flash cục bộ trên hai GPU RTX PRO 6000, dù trọng số của nó lớn hơn nhiều so với VRAM sẵn có.
Đây không phải thiết lập nhanh nhất. Tôi đạt khoảng 11 token mỗi giây, và vẫn còn nhiều không gian để tinh chỉnh số lượng và vị trí expert trên GPU. Bạn cũng có thể thử với một GPU nếu có đủ RAM; tôi dùng hai GPU ở đây đơn giản để có thêm khoảng đệm.
Với tôi, đó là điểm mấu chốt của hướng dẫn này: KTransformers không đặc biệt vì phát minh ra offload CPU. Nó đặc biệt vì làm cho RAM CPU, tính toán CPU và tính toán GPU phối hợp với nhau dựa trên cấu trúc thưa của mô hình MoE.
Khóa học nổi bật trên DataCamp
Khóa học
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
