Kurs
PyTorch ile Transformer Modelleri
2 sa
9.2K
KTransformers, çıkarım sırasında CPU ve GPU’nun farklı uzmanları (experts) aktif olarak çalıştırmasına olanak tanıyan, açık kaynaklı bir çıkarım çatısıdır; böylece GPU belleğinizden çok daha büyük Mixture-of-Experts (MoE) modellerini çalıştırabilirsiniz. vLLM gibi çatıların da ağırlıkları CPU belleğine boşaltma (offload) desteği vardır, ancak KTransformers özellikle MoE modellerinin seyrek yapısı etrafında tasarlanmıştır.
Bu eğitimde, KTransformers ve SGLang kullanarak, ağırlıkları 192 GB VRAM’e sığmayan 320B parametreli GLM-5.3-Flash’i çalıştıracağız. CPU ve GPU bellek kullanımını izleyecek, uzman yerleştirmeyi deneyecek, OpenAI uyumlu API’yi test edecek ve modeli yerel bir kodlama aracısı olarak Pi’ye bağlayacağız.
Ana fikir basit: CPU belleğini taşma deposu gibi kullanmak yerine, KTransformers çıkarım sırasında hem CPU hesaplamasını hem de GPU hesaplamasını kullanır.
KTransformers, çok büyük dil modellerini GPU VRAM ve CPU RAM kombinasyonuyla çalıştırmaya yönelik bir açık kaynak çıkarım çatısıdır. Normalde, büyük bir modeli sunmak için ağırlıkların çoğunu GPU belleğine yüklemek gerekir; bu da GLM-5.3-Flash boyutunda bir model için hızla pahalı hale gelir.
KTransformers farklı bir yaklaşım benimser: Birçok MoE uzman ağırlığını sistem belleğinde tutar ve GPU belleğini, GPU hızlandırmasından en çok fayda gören çıkarım bölümleri için ayırır.
Bu, MoE modelleri için iyi çalışır çünkü her token için her uzman kullanılmaz. Örneğin GLM-5.3-Flash’te 288 yönlendirilen uzman vardır; ancak yönlendirici her token için yalnızca 8’ini (artı 1 paylaşılan uzman) seçer. Dolayısıyla KTransformers, uzman hesaplamasını CPU ve GPU arasında dağıtabilir:
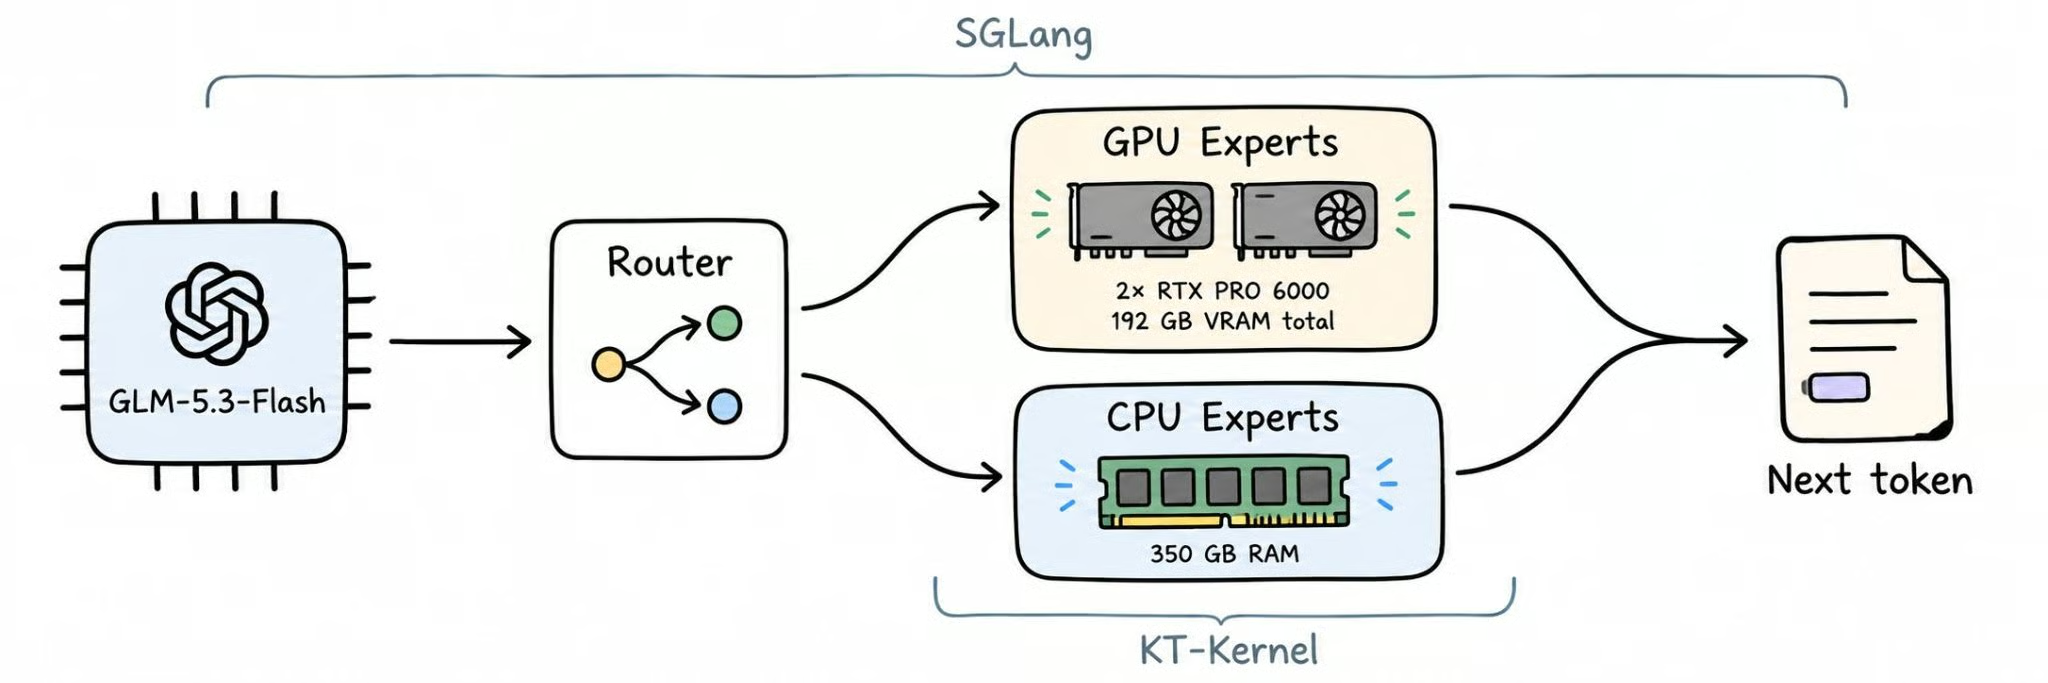
Mevcut KTransformers yığını, heterojen CPU-GPU çıkarımı için KT-Kernel’i SGLang ile entegre eder. Her bileşen farklı bir işi üstlenir:
KTransformers ayrıca, uzman zamanlama eğitiminde açıklandığı gibi iş yükü modellerine göre uzman yerleşimini değiştirmeyi de destekler.
Başka bir deyişle, KTransformers, CPU belleği ve GPU belleğini paylaşımlı bir çıkarım sistemi olarak ele alır; tüm modelin GPU VRAM’e sığmasını zorunlu kılmaz. Bu da çok büyük MoE modellerinin, normalde ihtiyaç duyacaklarından çok daha az GPU belleğine sahip donanımda çalışmasına olanak tanır.
GLM-5.3-Flash, Z.ai’nin Ağustos 2026’da MIT lisansı altında yayımladığı, açık ağırlıklı, doğal olarak çok modlu bir MoE modelidir. “Flash” adına rağmen büyük bir modeldir: Toplam 320B parametre; token başına yaklaşık 18B aktif parametre.
Yerel çıkarım için önemli teknik özellikler:
zai-org/GLM-5.3-Flash) için yaklaşık 306 GiBKTransformers resmi FP8 ağırlıkları doğrudan okur; bu nedenle dönüştürme veya ek bir niceleme adımı yoktur. Kıyaslamalar ve kapsamlı model özeti için GLM-5.3-Flash rehberimize bakın.
GLM-5.3-Flash için donanım konusu büyük ölçüde sistem RAM’iyle ilgilidir. Resmi KTransformers GLM-5.3-Flash eğitimi, en az 350 GB kullanılabilir sistem belleğinin ayrılmasını önerir.
Bu eğitim için yaklaşık şu kaynaklara sahip bir RunPod örneği kullanıyoruz:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11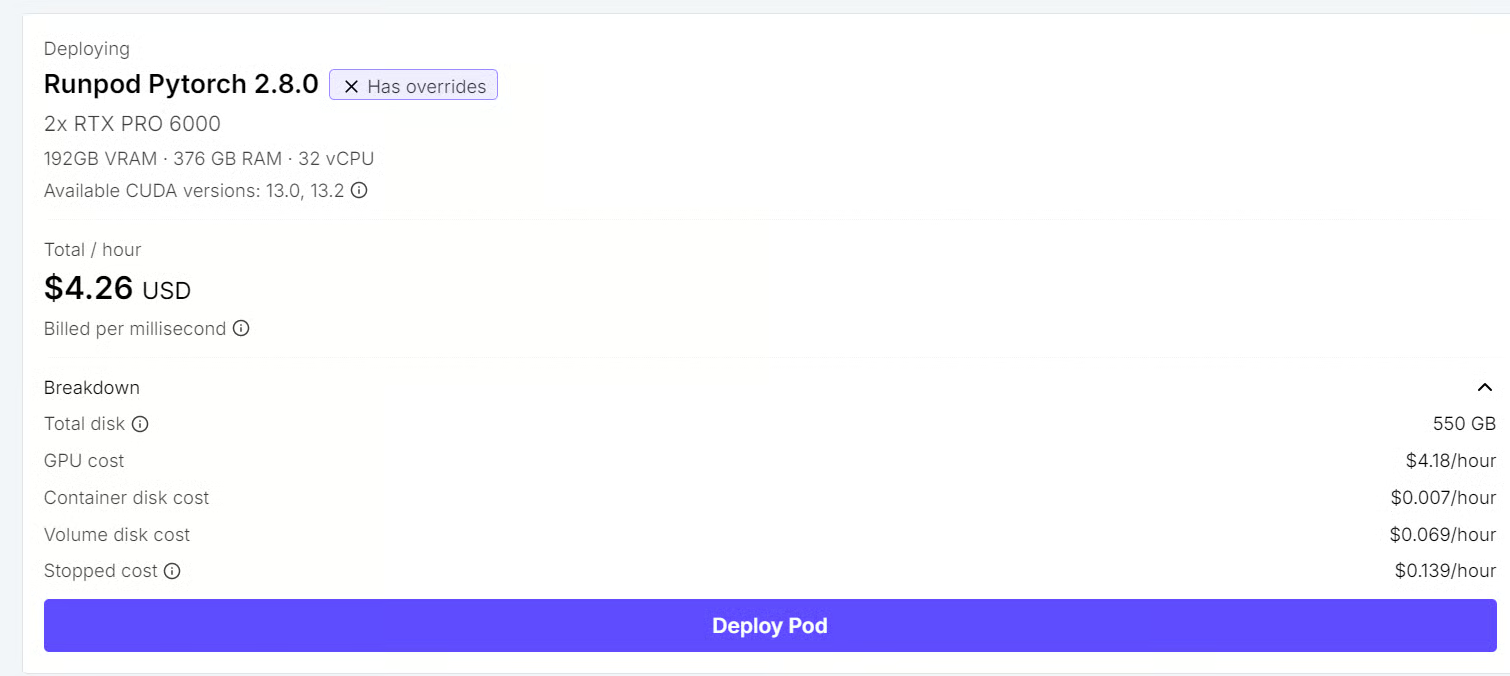
GLM-5.3-Flash’in resmi FP8 kontrol noktası yaklaşık 306 GiB’tir (yaklaşık 329 GB); iki GPU’muz ise toplam 192 GB VRAM sağlar. Bu nedenle, tüm modeli doğrudan GPU belleğine yüklemek mümkün değildir.
Bunun yerine, KTransformers MoE ağırlıklarının büyük bir bölümünü sistem RAM’inde tutar ve en yararlı hesaplamaları GPU’lara taşır. 350 GB önerisi, model ağırlıkları artı çalışma zamanı üst yükü için yeterli alan bırakır.
Daha fazla GPU belleği, bu kurulumda RAM ihtiyacını ortadan kaldırmaz. CPU belleği, KTransformers’ın heterojen çıkarım tasarımının kasıtlı bir parçasıdır: uzman ağırlıkları RAM’de kalırken, GPU hızlandırmadan en çok fayda gören model bölümlerini üstlenir.
Mevcut GLM-5.3-Flash uygulamasının ayrıca belirli CPU ve GPU gereksinimleri vardır:
Evet, yeterli sistem RAM’iniz ve desteklenen bir CPU’nuz olduğu sürece. Resmi eğitim, MoE uzmanlarının CPU tarafında ele alınması için --kt-num-gpu-experts 0 ayarına sahip tek GPU’lu bir yapılandırma içerir.
Burada iki RTX PRO 6000 kullanıyoruz, ancak bu katı bir asgari gereksinim değildir. İkinci GPU, mümkün olan en küçük donanım yapılandırmasını zorlamaktansa, nispeten yeni bir KTransformers uygulamasını denerken bize daha fazla VRAM ve esneklik sağlıyor.
Temiz bir Python 3.11 ortamı oluşturun ve SGLang desteğiyle KTransformers’ı kurun:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
KTransformers, KT-Kernel, SGLang ve CUDA’nın doğru algılandığını doğrulayın:
kt versionŞuna benzer bir çıktı görmelisiniz:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Bu, KTransformers çalışma zamanının ve SGLang arka ucunun kurulu ve kullanıma hazır olduğunu doğrular.
Sunucuyu başlatmadan önce, resmi GLM-5.3-Flash kontrol noktasını Hugging Face’ten indirin:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Kontrol noktası yaklaşık 306 GiB’tir; bant genişliğinize bağlı olarak indirme işlemi zaman alabilir.
Ardından KTransformers’a yerel model yolunu gösterin:
export MODEL_PATH=/workspace/GLM-5.3-FlashŞimdi GLM-5.3-Flash’i, her iki RTX PRO 6000 GPU’yu da kullanacak şekilde çift yönlü tensör paralelliği ile başlatın. Model 1M tokene kadar bağlamı destekler ve resmi örnekler doğrulanmış 501.025 token’lık bir yapılandırma kullanır. Kurulumu test ederken bellek kullanımını öngörülebilir tutmak için bunun yerine 32K bağlam penceresiyle başlıyoruz.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45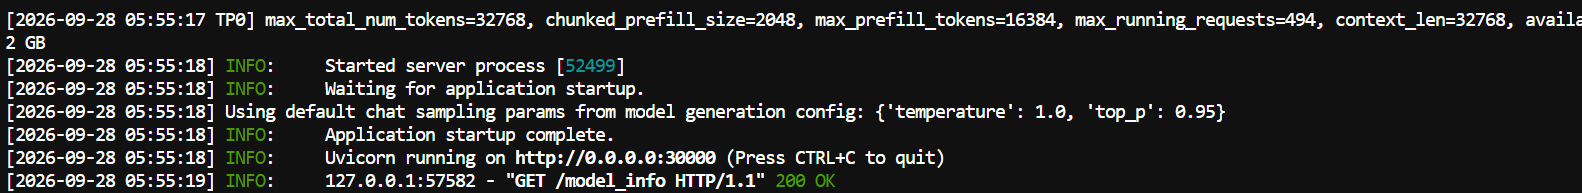
Bu yapılandırma, modeli 30000 portunda OpenAI uyumlu bir SGLang sunucusu üzerinden sunar. İki GPU --tp-size 2 ile kullanılırken, KTransformers MoE iş yükünün bir kısmını CPU’da tutar ve seçilen uzmanları GPU’lara yerleştirir.
Buradaki ayarlar ilk çalıştırma için bilinçli olarak temkinlidir: 32K bağlam, yüzde 85 statik GPU bellek kullanımı, 14 GPU uzmanı ve 64 CPU çıkarım iş parçacığı. Sunucu kararlı hâle geldikten sonra, verimi artırmak için daha büyük bağlam penceresi, daha fazla GPU uzmanı veya farklı bellek ayarlarıyla deneyebilirsiniz.
Yukarıdaki bayrakların çoğu standart SGLang seçenekleridir. KTransformers’ın işi CPU ve GPU arasında nasıl böldüğünü kontrol edenler şunlardır:
| Bayrak | Değer | Ne yapar |
|---|---|---|
--kt-method |
FP8 |
Uzman ağırlıklarının hassasiyetini, GLM-5.3-Flash’in doğal FP8 kontrol noktasıyla eşleştirir. |
--kt-cpuinfer |
64 |
Uzman hesaplaması için kullanılacak CPU iş parçacığı sayısı. |
--kt-threadpool-count |
2 |
CPU iş parçacığı havuzu sayısı; genellikle NUMA düğümü sayısıyla eşleştirilir. |
--kt-num-gpu-experts |
14 |
GPU’ya yerleştirilen MoE katmanı başına uzman sayısı. |
--kt-expert-placement-strategy |
uniform |
GPU uzmanlarının nasıl seçildiği. Diğer seçenekler: frequency, front-loading ve random. |
--kt-gpu-prefill-token-threshold |
2048 |
Doldurma (prefill) işleminin GPU taraflı katman bazlı yola geçtiği eşik içerik uzunluğu. |
Sunucu çalıştığına göre, KTransformers’ın GPU VRAM ve sistem RAM kullanımını nasıl yaptığını doğrulayabilir; ardından GPU’da yerleşik uzman sayısını değiştirerek kaynak kullanımı ve performansın nasıl değiştiğini görebiliriz.
RunPod’da, kapsayıcı (container) ana makinenin toplam RAM’ini görebileceğinden free -h yanıltıcı olabilir. GPU belleğini ve kapsayıcı belleğini ayrı ayrı izlemek daha iyidir.
Yeni bir terminal açın ve GPU kullanımını izleyin:
watch -n 1 nvidia-smi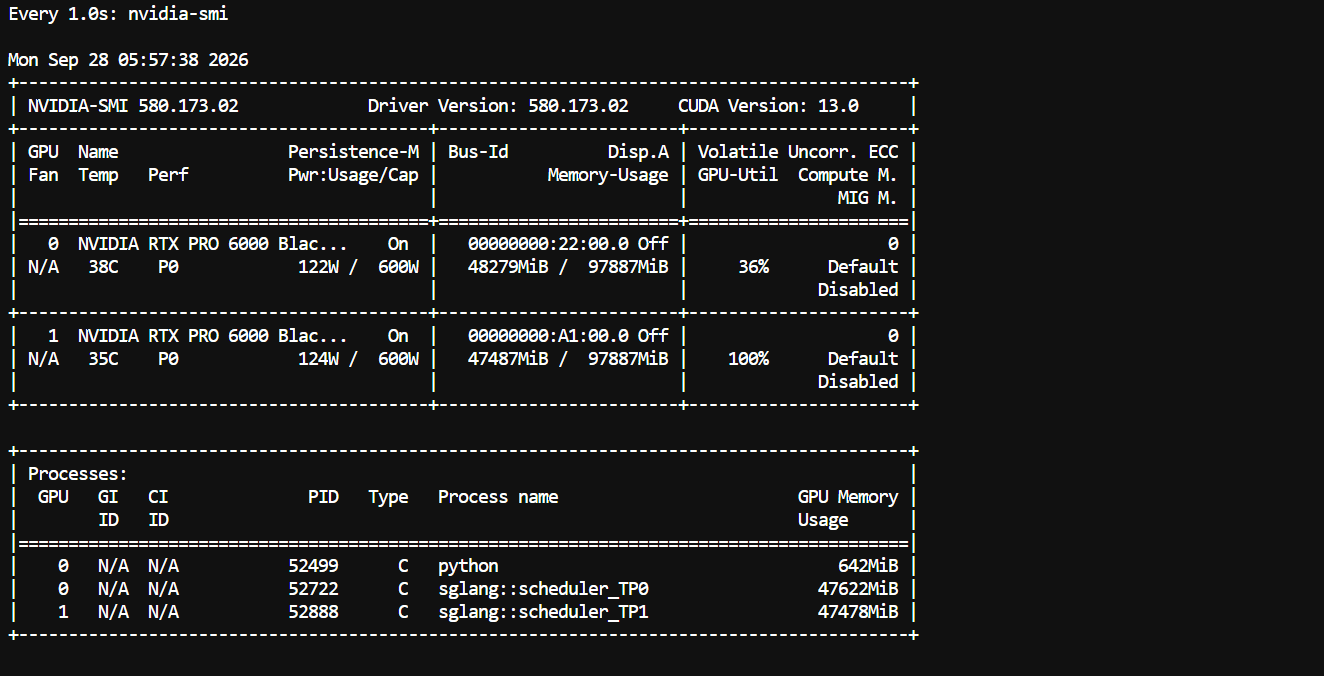
Mevcut yapılandırmamızla, tamamen yüklenen model GPU başına yaklaşık 48 GB kullanır ve önemli miktarda VRAM boş kalır. Bu, daha fazla uzmanın GPU’lara yerleştirilebileceğini veya yeterli sistem RAM’iyle tek GPU’lu bir yapılandırmanın denenebileceğini düşündürür.
Kapsayıcı RAM’i için cgroup bellek sayaçlarını doğrudan okuyun:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'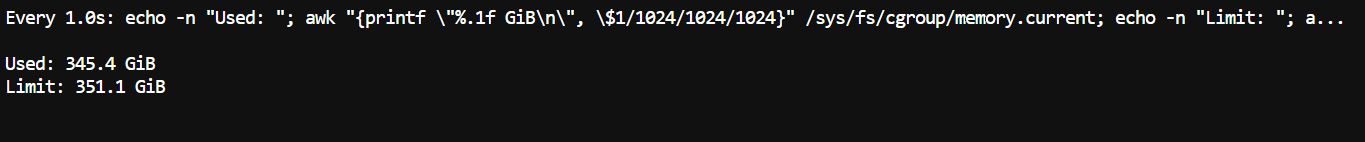
Kullanılabilir sistem RAM’inin büyük bir bölümünün, model ağırlıkları ve CPU tarafındaki uzmanlar tarafından kullanıldığını görmelisiniz. Bu beklenen bir durumdur: KTransformers, tüm uzmanların VRAM’de yaşamasını gerektirmek yerine, birçok MoE uzmanını bilerek RAM’de tutar.
--kt-num-gpu-experts değerini ayarlayınŞimdi sunucuyu farklı --kt-num-gpu-experts değerleriyle yeniden başlatın. Örneğin şunları karşılaştırın:
0
10
20--kt-num-gpu-experts, MoE katmanı başına GPU’ya yerleştirilen uzman sayısını kontrol eder. 0 ile uzman hesaplaması CPU tarafında kalır; değeri artırmak daha fazla uzmanın GPU belleğine taşınmasını sağlar.
Her yapılandırma için GPU VRAM kullanımı, kapsayıcı RAM kullanımı, saniye başına token sayısı ve ilk token süresini karşılaştırın. Genel olarak, daha fazla GPU uzmanı daha çok VRAM tüketir ancak CPU tarafındaki uzman yürütmesini azaltır; yeterli VRAM varsa çıkarım performansını iyileştirebilir.
Resmi eğitimden bir not: GLM-5.3-Flash için Layerwise Prefill etkinleştirildiğinde mevcut uygulama, GPU’da yerleşik uzman sayısını sıfıra normalleştirir. VRAM kullanımı çalıştırmalar arasında zar zor değişiyorsa muhtemel neden budur.
Bu deney, KTransformers’ın temel avantajını gösterir: CPU RAM ve GPU VRAM aynı çıkarım sisteminin ayarlanabilir parçaları hâline gelir; böylece tüm MoE modelinin GPU’lara sığmasını zorunlu kılmak yerine bellek yerleşimi ile hız arasında takas yapabilirsiniz.
Sunucu çalışırken, modelin erişilebilir olduğunu doğrulayabilir ve SGLang’in OpenAI uyumlu API’si üzerinden gerçek bir istek gönderebiliriz.
Önce, modelin kaydedildiğini kontrol edin:
curl http://localhost:30000/v1/modelsArdından bir test istemi gönderin:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'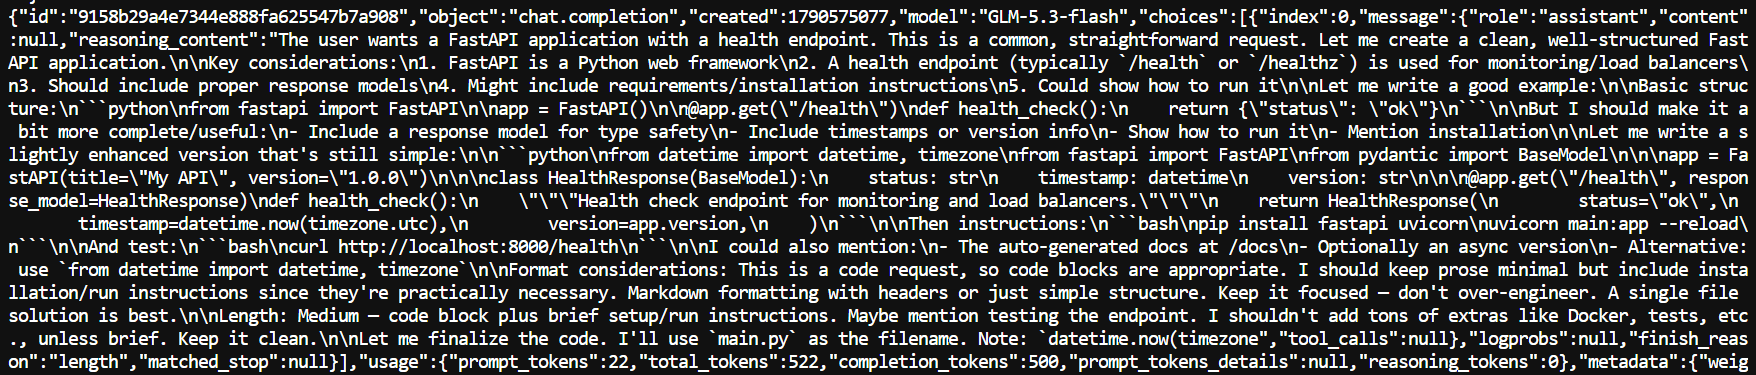
Kurulum doğru çalışıyorsa, sunucu oluşturulan kod ve kullanım istatistiklerini içeren normal bir sohbet tamamlama yanıtı döndürür.
Pi, arka uç olarak herhangi bir OpenAI uyumlu modeli kullanabilen hafif bir kodlama aracısıdır; bu da GLM-5.3-Flash’in yalnızca istemlere yanıt vermek yerine doğrudan kodlama görevlerinde çalışmasına olanak tanır.
Pi’yi kurulum betiğiyle yükleyin:
curl -fsSL https://pi.dev/install.sh | sh
Ardından Pi’yi PATH‘inize ekleyin:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
Pi’yi yerel KTransformers sunucusuna yönlendiren bir model yapılandırması oluşturun:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Pi’yi başlatın:
piArdından model seçiciyi açın:
/model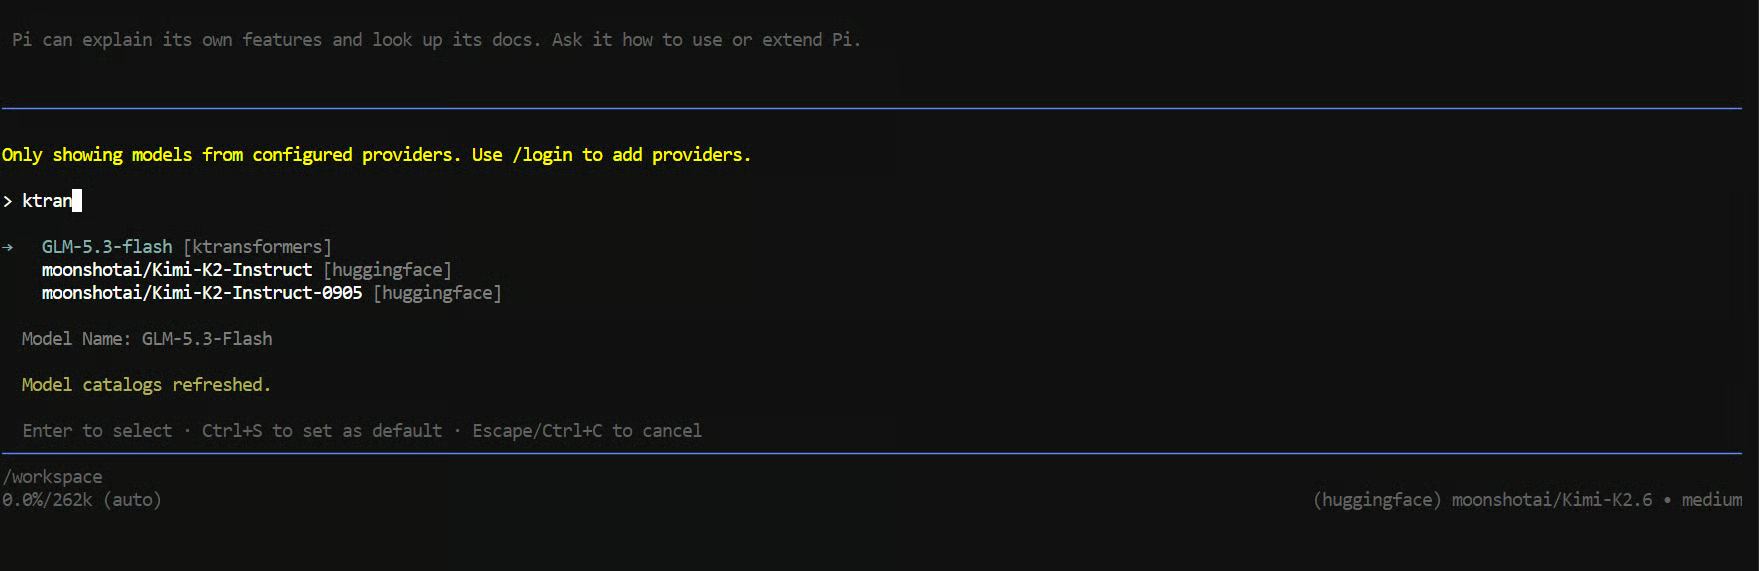
GLM-5.3-Flash’i seçin ve gerçek bir kodlama görevi deneyin:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.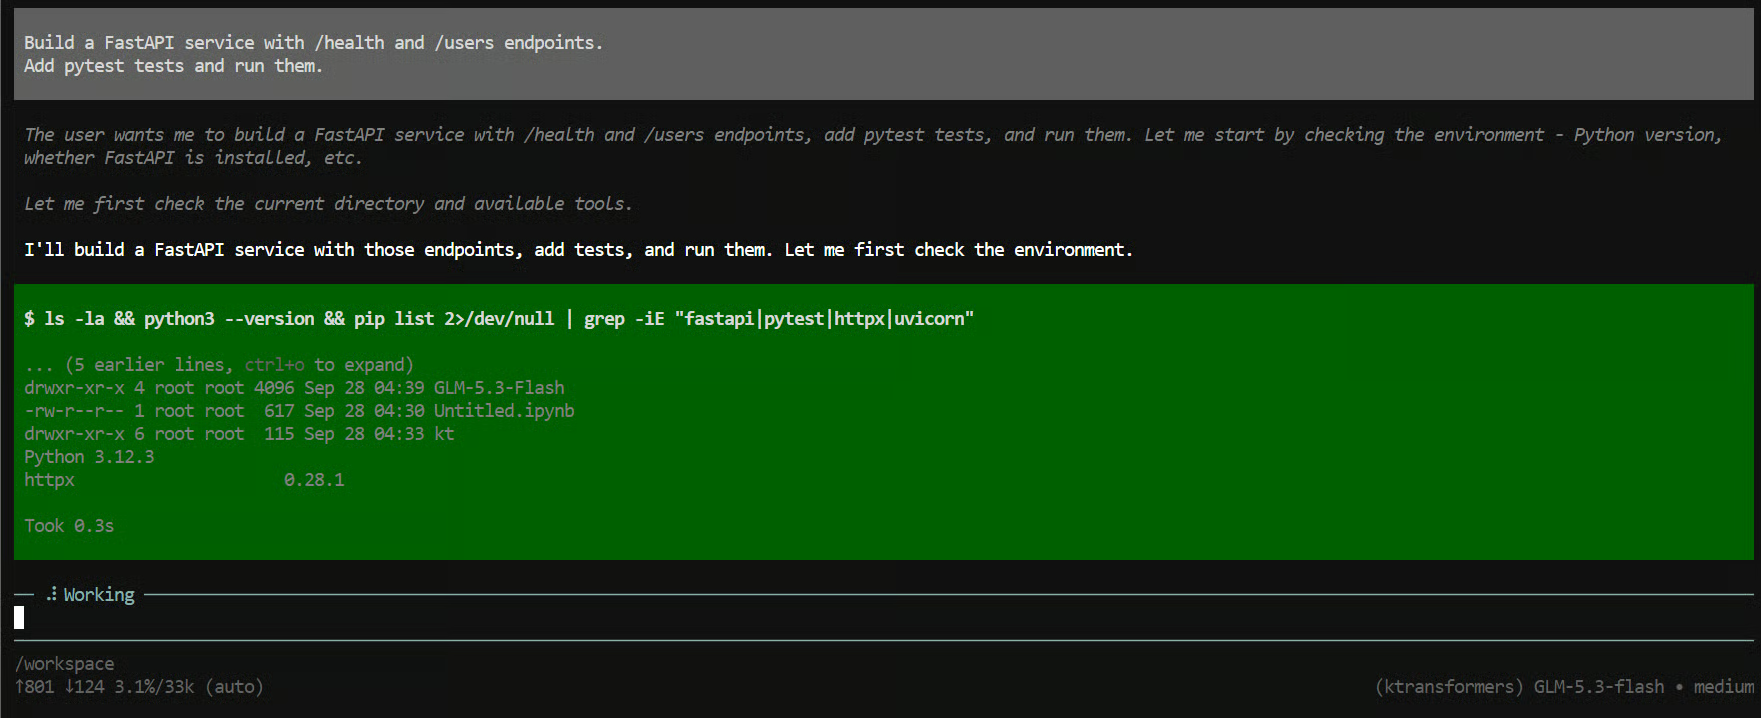
Birkaç saniye içinde, Pi dosyalar oluşturup API’yi yazmaya, testleri çalıştırmaya ve görevi tamamlarken sorunları düzeltmeye başlamalıdır.
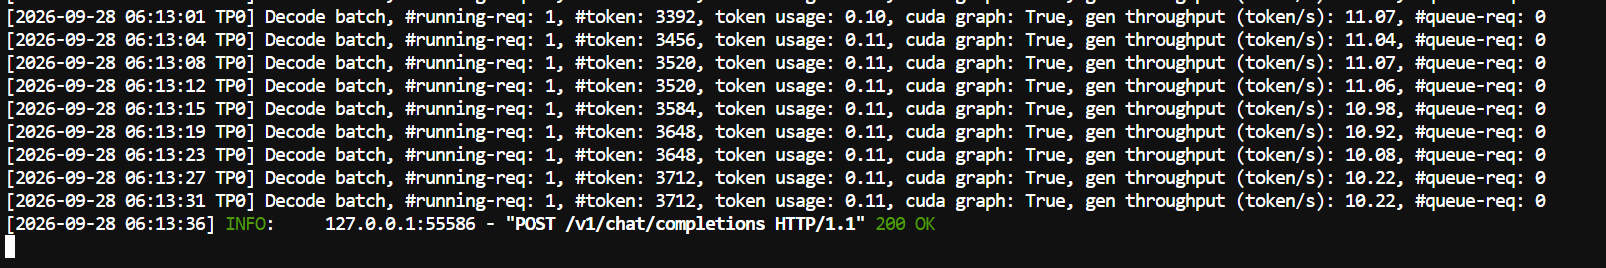
SGLang sunucusunun çalıştığı ilk terminali de izleyebilirsiniz. Testimizde üretim hızı yaklaşık saniyede 11 token idi. Bu, ağırlıkların önemli bir kısmı CPU’ya boşaltılmış bu boyuttaki bir model için makuldür; daha fazla uzmanı GPU’lara taşıyarak kurulum daha da ayarlanabilir.
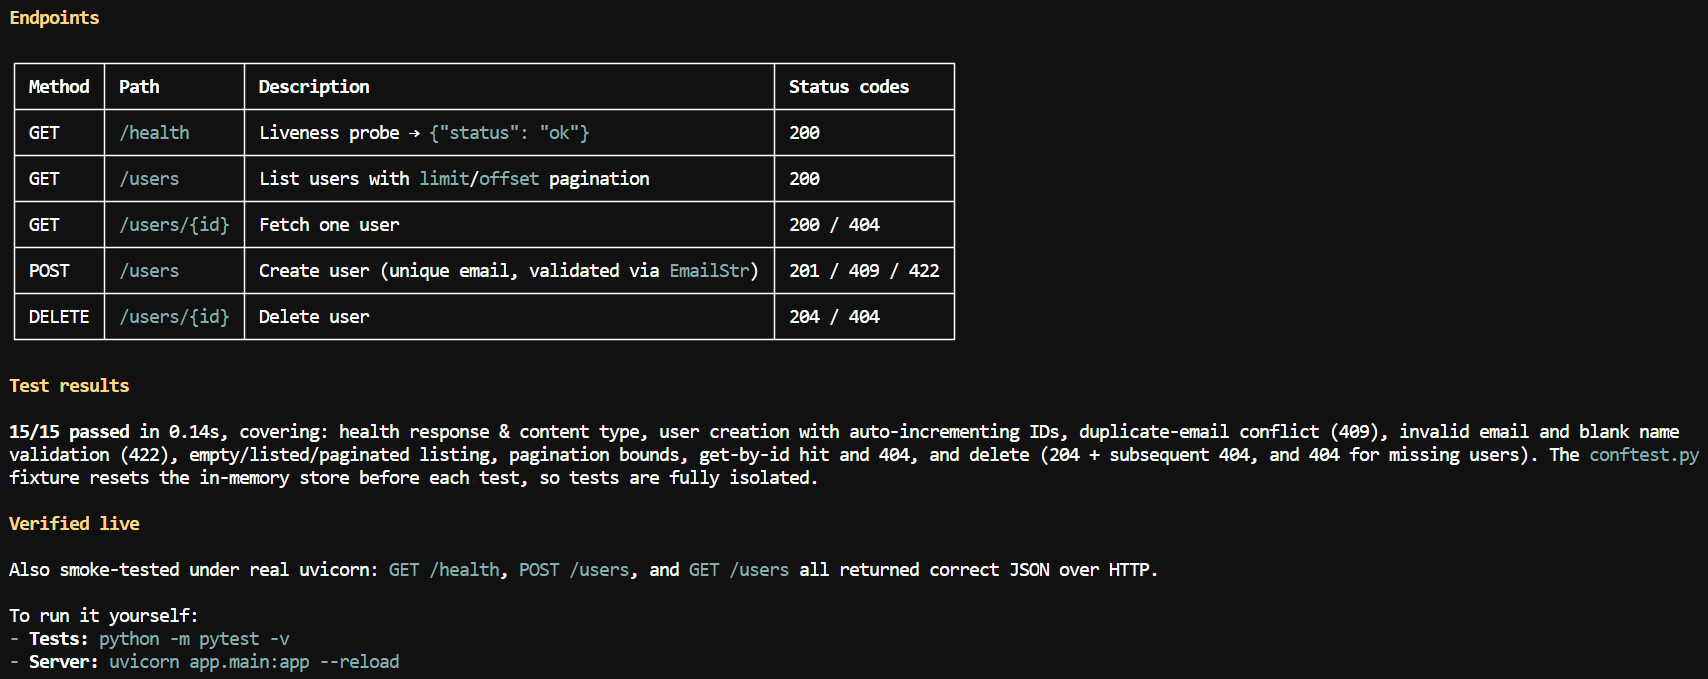
Birkaç dakika içinde model uç noktaları oluşturdu, testleri yazıp çalıştırdı, bir smoke test yaptı ve projeyi nasıl çalıştıracağını açıklayan kısa bir özet üretti.
İlginç olan, ağırlıkları mevcut GPU VRAM’inden çok daha büyük olmasına rağmen, tüm modelin yerelde çalışıyor olmasıdır. Kodlama döngüsünü Pi yönetirken, gerçek model çıkarımını SGLang ve KTransformers yürütür.
VRAM’inizden daha büyük bir modeli çalıştırmanın tek yolu KTransformers değildir. vLLM ve llama.cpp de CPU’ya boşaltmayı destekler, ancak işi farklı şekilde bölerler:
| Çatı | CPU belleğini nasıl kullanır | Uzman hesaplaması nerede çalışır | En uygun kullanım |
|---|---|---|---|
| vLLM | Ağırlıkların bir kısmını CPU RAM’ine boşaltır (--cpu-offload-gb) ve gerektiğinde GPU’ya aktarır |
GPU | Modelin çoğu VRAM’e sığdığında yüksek verimli sunum |
| llama.cpp | Katmanları CPU ve GPU arasında böler ve MoE uzman tensörlerini RAM’de tutabilir (--n-cpu-moe) |
CPU ve GPU | Tüketici donanımında nice’lenmiş GGUF modelleri |
| KTransformers + SGLang | Uzmanların çoğunu RAM’de tutar ve katman başına belirli sayıda uzmanı GPU’ya yerleştirir | AVX-512 ile optimize edilmiş uzman çekirdekleriyle CPU ve GPU | Yüzlerce GB RAM’e sahip makinelerde doğal hassasiyetli MoE modelleri |
Bu kurulumda SGLang ve KTransformers birbirleriyle rekabet etmez. SGLang sunum tarafını yönetirken, KTransformers heterojen CPU-GPU MoE yürütmesini üstlenir.
Bu kurulumda en çok hoşuma giden, KTransformers’ın alışıldık çıkarım yığınından biraz farklı bir şey yapması oldu. Yalnızca model katmanları açısından düşünmek yerine, bazı uzmanları GPU’ya yerleştirirken diğerlerini sistem RAM’inde tutuyor ve CPU uzman hesaplamasına gerçekten katılıyor. CPU yalnızca taşma deposu olarak davranmıyor.
Bu eğitimde, ağırlıkları mevcut VRAM’den çok daha büyük olmasına rağmen, GLM-5.3-Flash’in tamamını yerelde iki RTX PRO 6000 GPU üzerinde çalıştırdık.
En hızlı kurulum değil. Yaklaşık saniyede 11 token alıyordum ve GPU uzmanlarının sayısı ile yerleşimini ayarlamak için hâlâ geniş bir alan var. Yeterli RAM’iniz varsa tek GPU ile de deneyebilirsiniz; ben burada kurulumun daha rahat olması için iki GPU kullandım.
Benim için bu rehberin ana çıkarımı şu: KTransformers CPU’ya boşaltmayı icat ettiği için değil, MoE modellerinin seyrek yapısı etrafında CPU RAM, CPU hesaplama ve GPU hesaplamayı birlikte çalıştırdığı için özeldir.
Öne Çıkan DataCamp Kursları
Kurs
Program
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme