Курс
Трансформерные модели с PyTorch
2 ч
9.2K
KTransformers — это фреймворк для инференса с открытым исходным кодом, который позволяет CPU и GPU активно выполнять разных экспертов во время инференса, так что вы можете запускать модели Mixture-of-Experts (MoE), значительно превышающие объём памяти вашего GPU. Такие фреймворки, как vLLM, тоже могут выгружать веса в память CPU, но KTransformers изначально спроектирован вокруг разреженной структуры MoE-моделей.
В этом руководстве мы используем KTransformers и SGLang, чтобы запустить GLM-5.3-Flash — модель на 320 млрд параметров, чьи веса не помещаются в 192 ГБ VRAM. Мы проследим за использованием памяти CPU и GPU, поэкспериментируем с размещением экспертов, проверим совместимый с OpenAI API и подключим модель к Pi в роли локального код-агента.
Главная идея проста: вместо того чтобы рассматривать память CPU как «переполнение», KTransformers использует и вычисления на CPU, и вычисления на GPU во время инференса.
KTransformers — это фреймворк инференса с открытым кодом для запуска очень больших языковых моделей с использованием комбинации VRAM GPU и RAM CPU. Обычно для обслуживания крупной модели приходится загружать большинство её весов в память GPU, что быстро становится дорого для модели масштаба GLM-5.3-Flash.
KTransformers предлагает другой подход: он хранит многие веса экспертов MoE в системной памяти и резервирует память GPU для тех частей инференса, которые сильнее выигрывают от ускорения на GPU.
Это хорошо работает для MoE-моделей, потому что не каждый эксперт используется для каждого токена. У GLM-5.3-Flash, например, 288 маршрутизируемых экспертов, но роутер выбирает только 8 из них (плюс 1 общий эксперт) для каждого токена. Поэтому KTransformers может распределять вычисления экспертов между CPU и GPU:
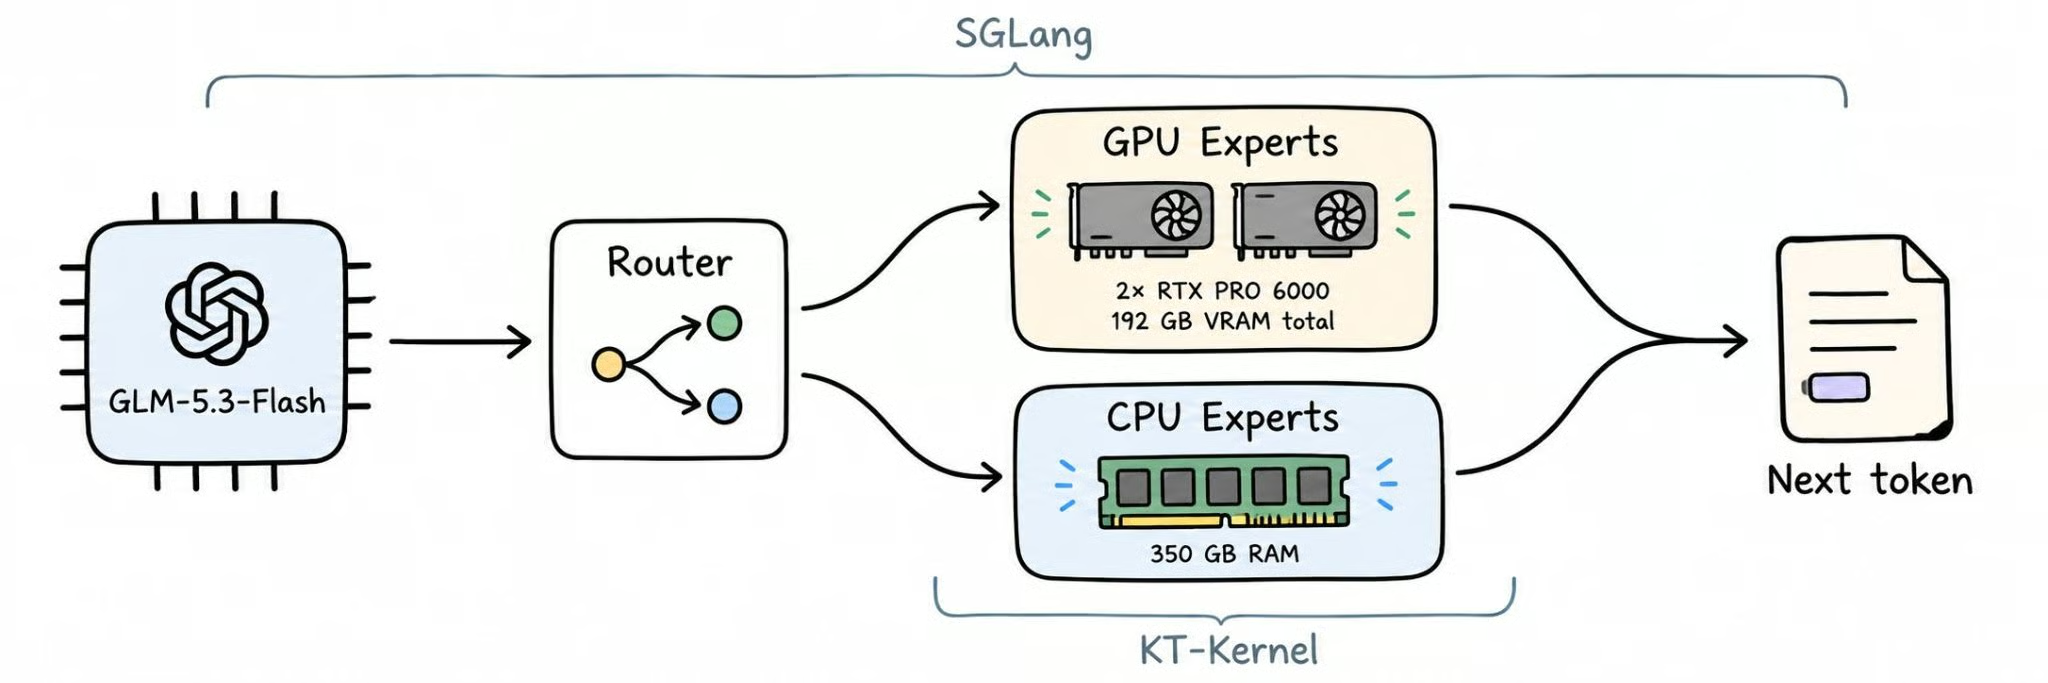
Текущий стек KTransformers интегрирует KT-Kernel с SGLang для гетерогенного инференса на CPU и GPU. Каждый компонент отвечает за свою часть:
KTransformers также поддерживает изменение размещения экспертов в зависимости от профиля нагрузки, как описано в его руководстве по планированию экспертов.
Иными словами, KTransformers рассматривает память CPU и память GPU как единую систему инференса вместо того, чтобы требовать полного размещения модели в VRAM. Это и позволяет запускать очень большие MoE-модели на оборудовании с куда меньшим объёмом GPU-памяти, чем обычно требуется.
GLM-5.3-Flash — открытая мультимодальная MoE-модель от Z.ai, выпущенная под лицензией MIT в августе 2026 года. Несмотря на название «Flash», это крупная модель: всего 320 млрд параметров, из них около 18 млрд активны на токен.
Характеристики, важные для локального инференса:
zai-org/GLM-5.3-Flash)KTransformers читает официальные FP8-веса напрямую, так что конвертация или дополнительная квантизация не требуются. За бенчмарками и полным обзором модели обращайтесь к нашему гайду по GLM-5.3-Flash.
Для GLM-5.3-Flash вопрос оборудования в основном упирается в объём системной RAM. В официальном руководстве KTransformers по GLM-5.3-Flash рекомендуется резервировать не менее 350 ГБ доступной системной памяти.
В этом руководстве мы используем инстанс RunPod со следующими параметрами примерно:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11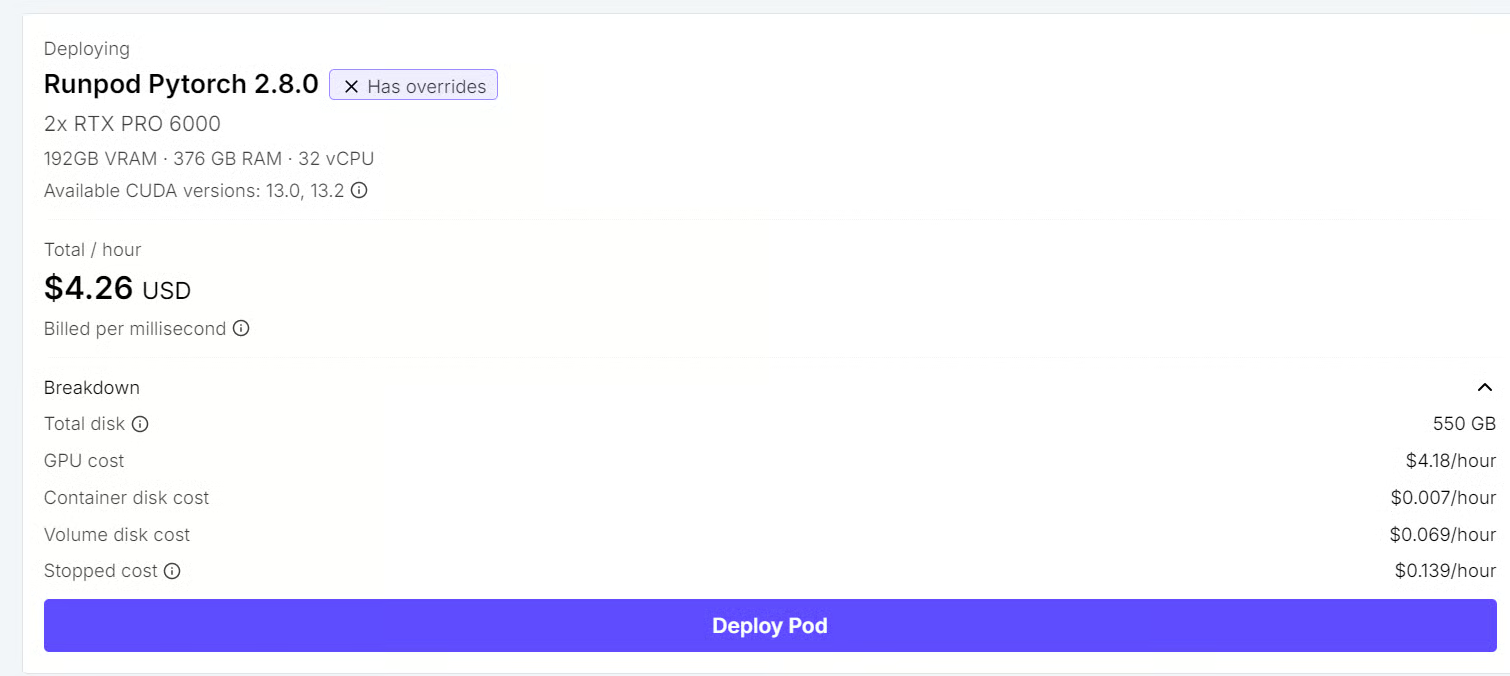
Официальный FP8-чекпойнт GLM-5.3-Flash занимает примерно 306 GiB (около 329 ГБ), тогда как наши две GPU вместе дают 192 ГБ VRAM. Полная модель, следовательно, не может быть просто загружена целиком в память GPU.
Вместо этого KTransformers держит значительную часть весов MoE в системной RAM и переносит на GPU наиболее полезные вычисления. Рекомендация в 350 ГБ оставляет достаточно места и под веса модели, и под накладные расходы на рантайм.
Больше памяти GPU не отменяет необходимость RAM в этой схеме. Память CPU — осознанная часть гетерогенного дизайна инференса KTransformers: веса экспертов остаются в RAM, а GPU обрабатывает части модели, которые сильнее выигрывают от ускорения.
Текущая реализация GLM-5.3-Flash также предъявляет требования к CPU и GPU:
Да, при наличии достаточной системной RAM и поддерживаемого CPU. В официальном руководстве есть конфигурация для одного GPU с параметром --kt-num-gpu-experts 0, при котором эксперты MoE обрабатываются на стороне CPU.
Мы используем здесь два RTX PRO 6000, но это не жёсткое минимальное требование. Второй GPU даёт больше VRAM и запас при экспериментах с относительно новой реализацией KTransformers, а не тонкую подгонку под наименьшую возможную конфигурацию, способную запустить модель.
Создайте чистое окружение Python 3.11 и установите KTransformers с поддержкой SGLang:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Проверьте, что KTransformers, KT-Kernel, SGLang и CUDA определяются корректно:
kt versionВы должны увидеть примерно такой вывод:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Это подтверждает, что рантайм KTransformers и его бэкенд SGLang установлены и готовы к использованию.
Перед запуском сервера скачайте официальный чекпойнт GLM-5.3-Flash с Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Чекпойнт весит около 306 GiB, так что загрузка может занять время в зависимости от пропускной способности сети.
Затем укажите KTransformers локальный путь к модели:
export MODEL_PATH=/workspace/GLM-5.3-FlashТеперь запустите GLM-5.3-Flash с тензорным параллелизмом по двум направлениям, используя обе RTX PRO 6000. Модель поддерживает до 1 млн токенов контекста, а в официальных примерах используется проверенная конфигурация на 501 025 токенов. Мы начнём с окна контекста 32K, чтобы сохранить предсказуемое использование памяти на этапе тестирования.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45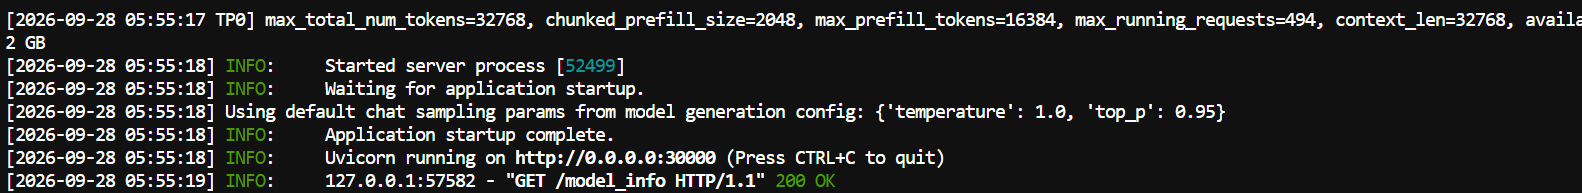
Эта конфигурация публикует модель через совместимый с OpenAI сервер SGLang на порту 30000. Два GPU используются с параметром --tp-size 2, тогда как KTransformers оставляет часть нагрузки MoE на CPU и размещает выбранных экспертов на GPU.
Настройки здесь намеренно консервативны для первого запуска: контекст 32K, 85% статического использования памяти GPU, 14 экспертов на GPU и 64 CPU-потока для инференса. После стабилизации сервера можно поэкспериментировать с большим окном контекста, большим числом экспертов на GPU или другими настройками памяти для увеличения пропускной способности.
Большинство флагов выше — стандартные параметры SGLang. Вот те, что управляют тем, как KTransformers делит работу между CPU и GPU:
| Флаг | Значение | Что делает |
|---|---|---|
--kt-method |
FP8 |
Задаёт точность весов экспертов, соответствующую родному FP8-чекпойнту GLM-5.3-Flash. |
--kt-cpuinfer |
64 |
Количество CPU-потоков для вычислений экспертов. |
--kt-threadpool-count |
2 |
Число пулов потоков на CPU, обычно соответствует количеству NUMA-узлов. |
--kt-num-gpu-experts |
14 |
Количество экспертов на слой MoE, размещаемых на GPU. |
--kt-expert-placement-strategy |
uniform |
Как выбираются GPU-эксперты. Другие варианты: frequency, front-loading и random. |
--kt-gpu-prefill-token-threshold |
2048 |
Длина промпта, после которой префилл переключается на послойный путь на стороне GPU. |
Теперь, когда сервер работает, можно проверить, как KTransformers использует VRAM GPU и системную RAM, а затем изменить число экспертов на GPU и посмотреть, как меняются использование ресурсов и производительность.
На RunPod команда free -h может вводить в заблуждение, потому что контейнер может видеть общую RAM хоста, а не только память, доступную поду. Лучше мониторить память GPU и память контейнера отдельно.
Откройте новый терминал и наблюдайте за использованием GPU:
watch -n 1 nvidia-smi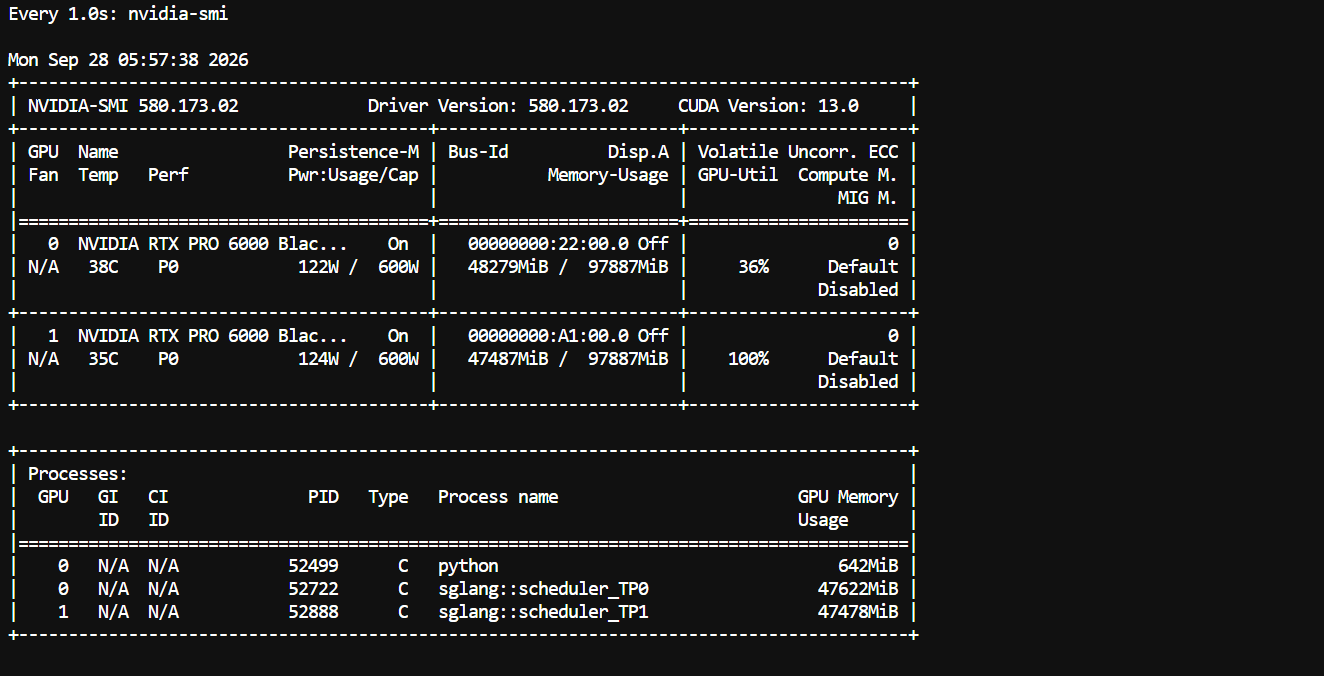
С текущей конфигурацией полностью загруженная модель использует примерно 48 ГБ на каждый GPU, оставляя значительный запас VRAM. Это намекает на возможность разместить больше экспертов на GPU или протестировать конфигурацию с одним GPU при достаточном объёме системной RAM.
Для RAM контейнера читайте счётчики памяти cgroup напрямую:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'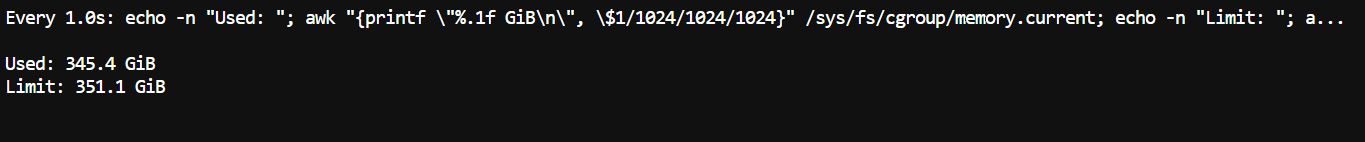
Вы увидите, что значительная часть доступной системной RAM занята весами модели и экспертами на стороне CPU. Это ожидаемо: KTransformers намеренно держит многих экспертов MoE в RAM, вместо того чтобы требовать их размещения в VRAM.
--kt-num-gpu-expertsДалее перезапустите сервер с разными значениями --kt-num-gpu-experts. Например, сравните:
0
10
20
--kt-num-gpu-experts управляет тем, сколько экспертов на слой MoE размещается на GPU. При значении 0 вычисления экспертов остаются на стороне CPU; увеличение значения переносит больше экспертов в память GPU.
Для каждой конфигурации сравните использование VRAM GPU, использование RAM контейнера, токенов в секунду и время до первого токена. В целом, большее число экспертов на GPU потребляет больше VRAM, но уменьшает объём вычислений экспертов на CPU, что может повысить производительность инференса при наличии достаточного объёма VRAM.
Одна оговорка из официального руководства: при включённом Layerwise Prefill для GLM-5.3-Flash текущая реализация нормализует число резидентных экспертов на GPU к нулю. Если использование VRAM почти не меняется между запусками, вероятно, дело в этом.
Этот эксперимент показывает ключевое преимущество KTransformers: RAM CPU и VRAM GPU становятся настраиваемыми частями одной системы инференса, так что вы можете менять размещение памяти ради скорости, а не требовать полного размещения всей MoE-модели на GPU.
Когда сервер запущен, можно убедиться, что модель доступна, и отправить реальный запрос через совместимый с OpenAI API SGLang.
Сначала проверьте, что модель зарегистрирована:
curl http://localhost:30000/v1/modelsЗатем отправьте тестовый промпт:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'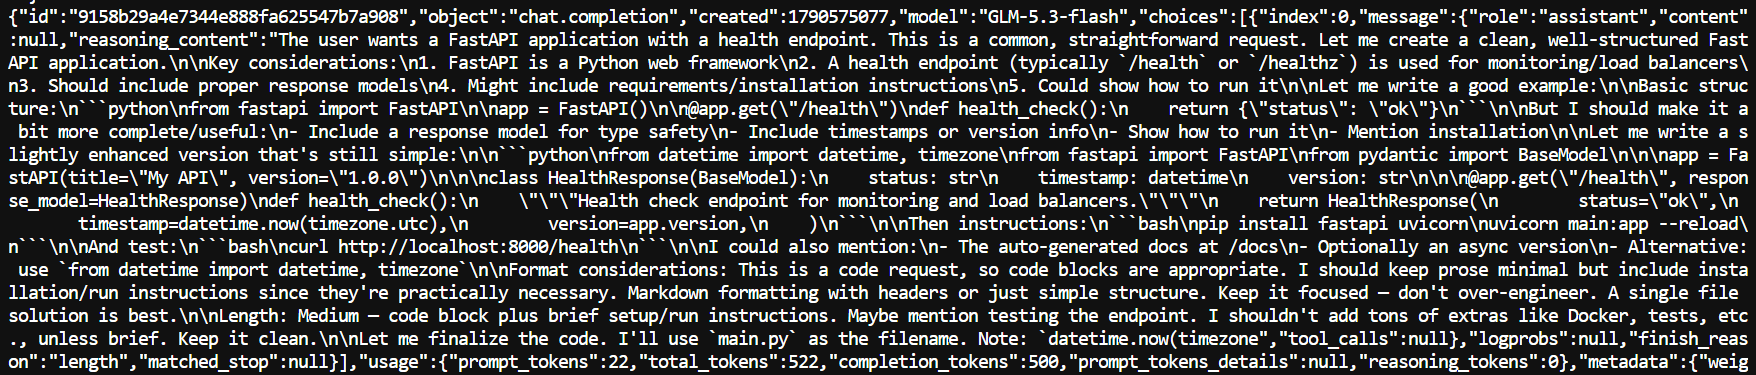
Если всё настроено верно, сервер вернёт обычный ответ chat completion с сгенерированным кодом и статистикой использования.
Pi — это лёгкий код-агент, который может использовать любую модель с совместимым с OpenAI API в качестве бэкенда, что позволяет GLM-5.3-Flash напрямую выполнять задания по программированию, а не только отвечать на промпты.
Установите Pi через его скрипт установки:
curl -fsSL https://pi.dev/install.sh | sh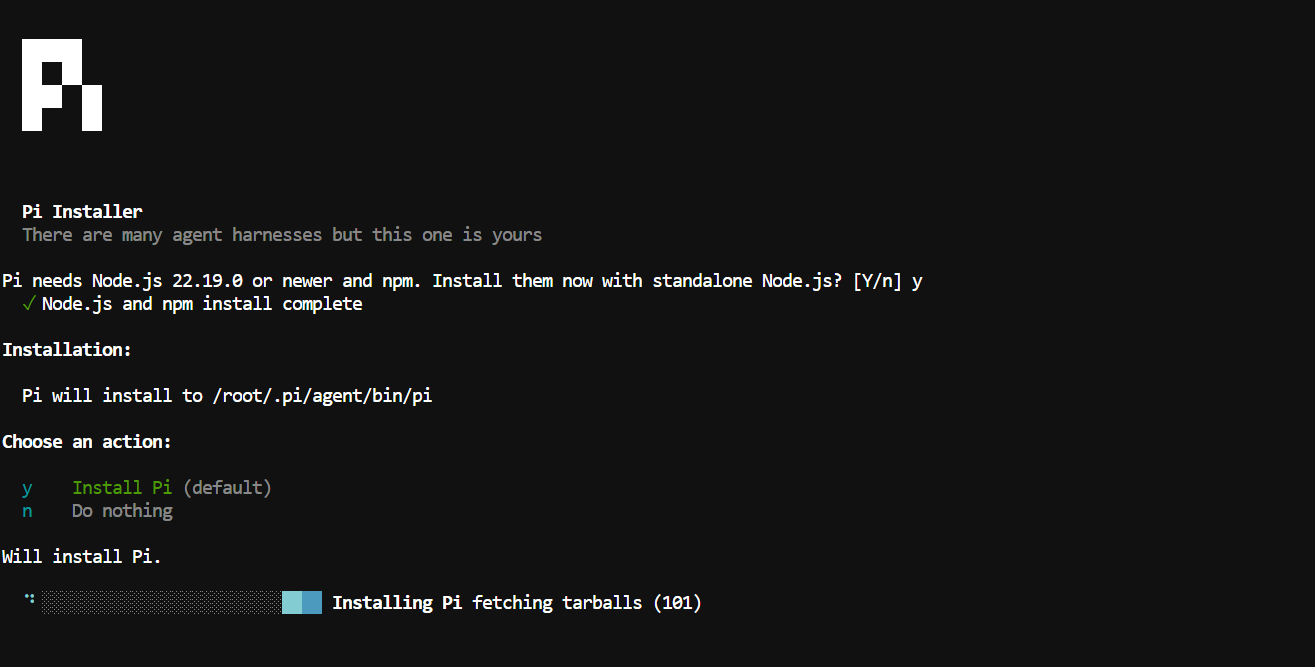
Затем добавьте Pi в PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcСоздайте конфигурацию модели, которая направляет Pi на локальный сервер KTransformers:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Запустите Pi:
piЗатем откройте селектор модели:
/model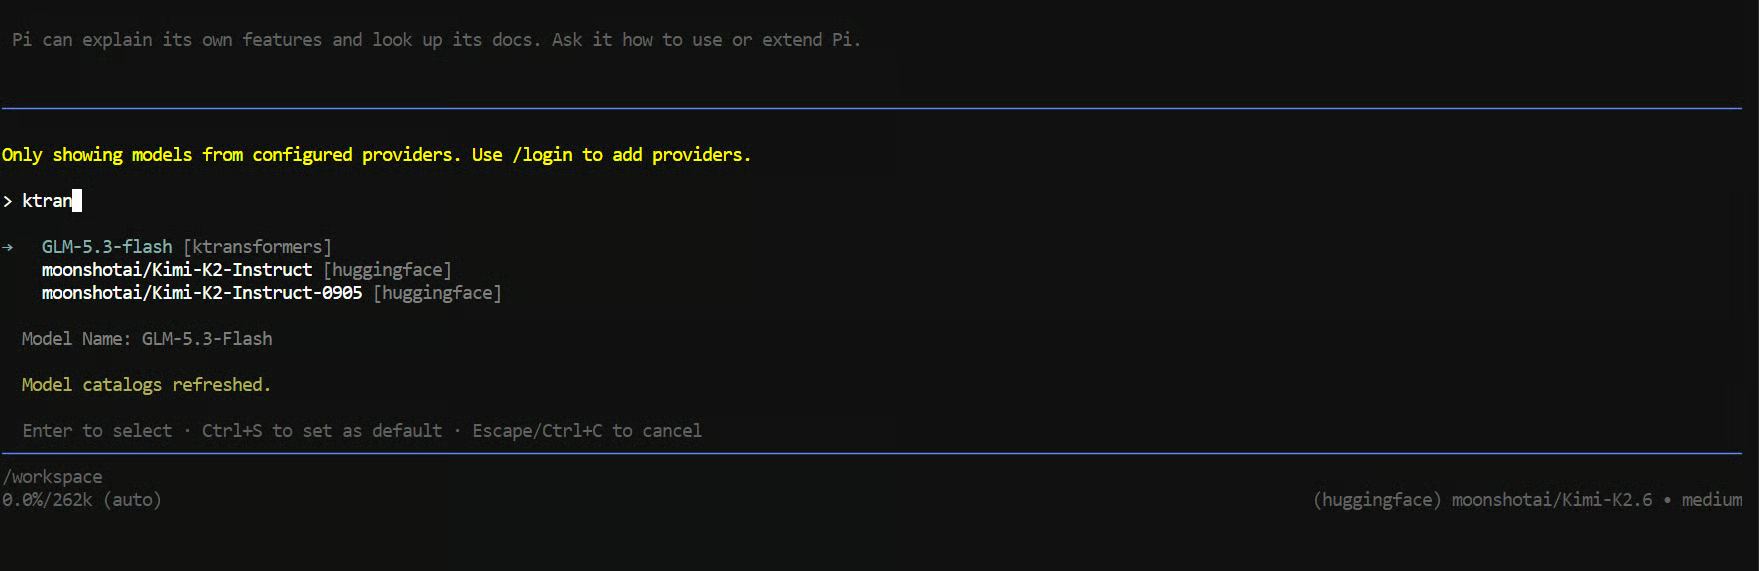
Выберите GLM-5.3-Flash и попробуйте реальную задачу по программированию:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.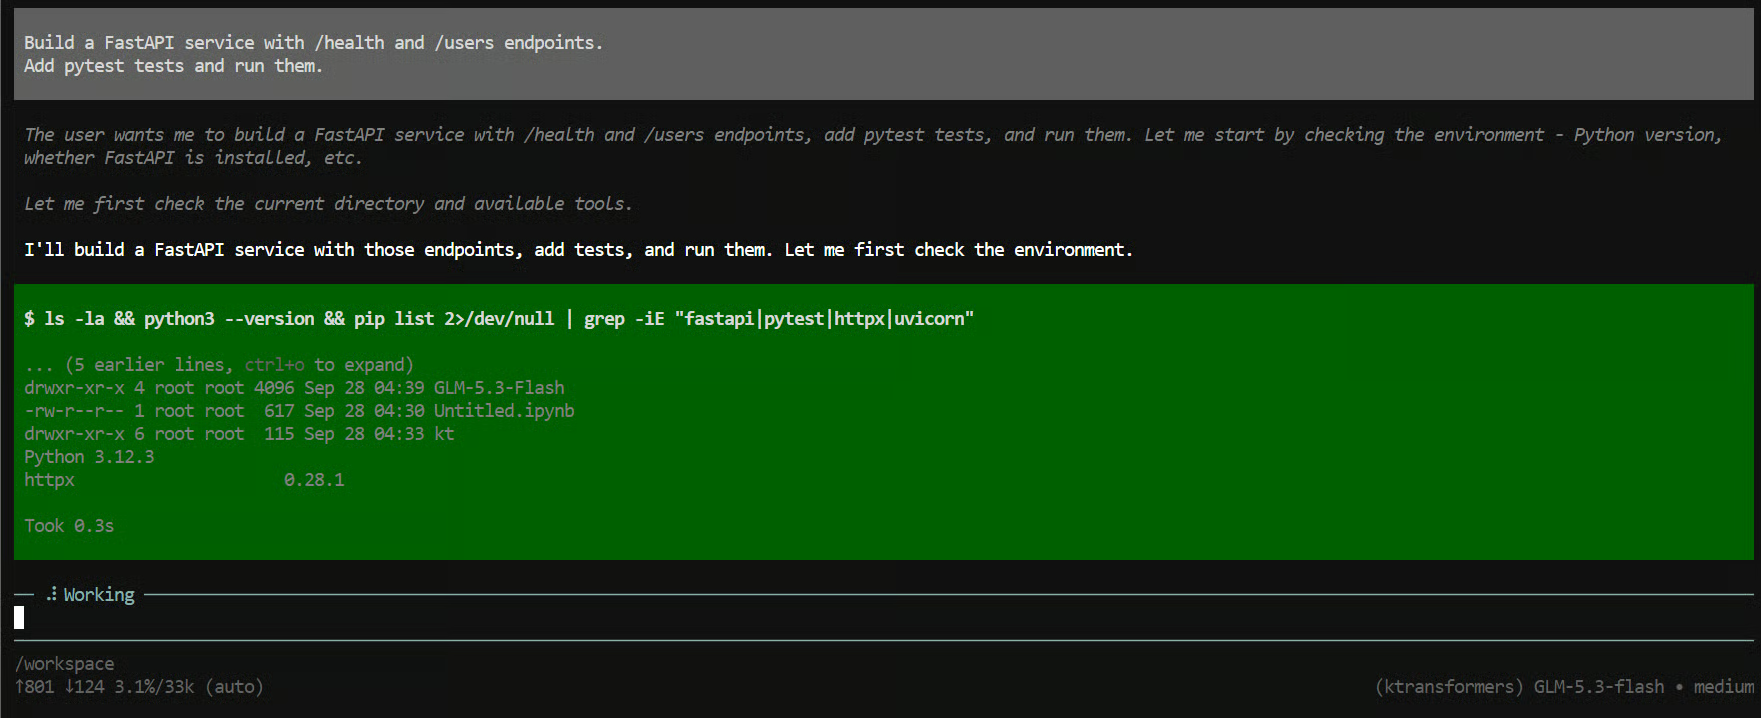
Через несколько секунд Pi начнёт создавать файлы, писать API, запускать тесты и исправлять проблемы по мере выполнения задачи.
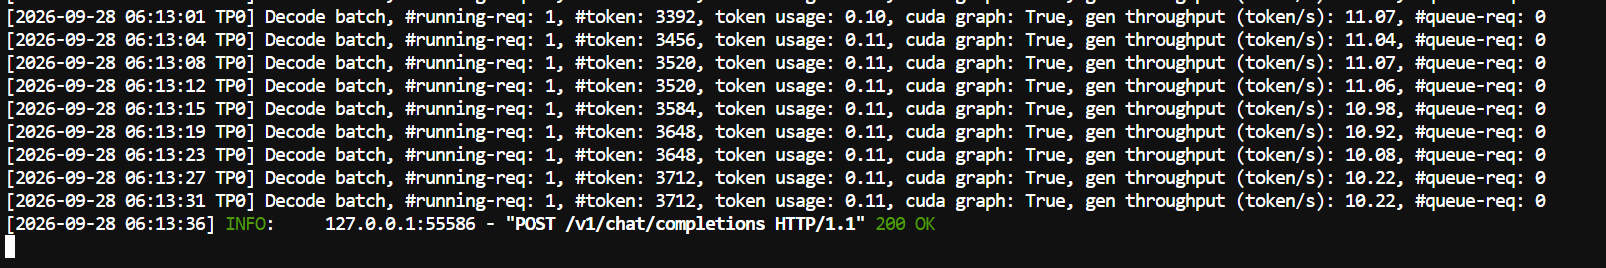
Можно также наблюдать первый терминал, где работает сервер SGLang. В нашем тесте скорость генерации составляла около 11 токенов в секунду. Это разумно для модели такого размера с существенной выгрузкой на CPU, а производительность можно дальше настроить, перенеся больше экспертов на GPU.
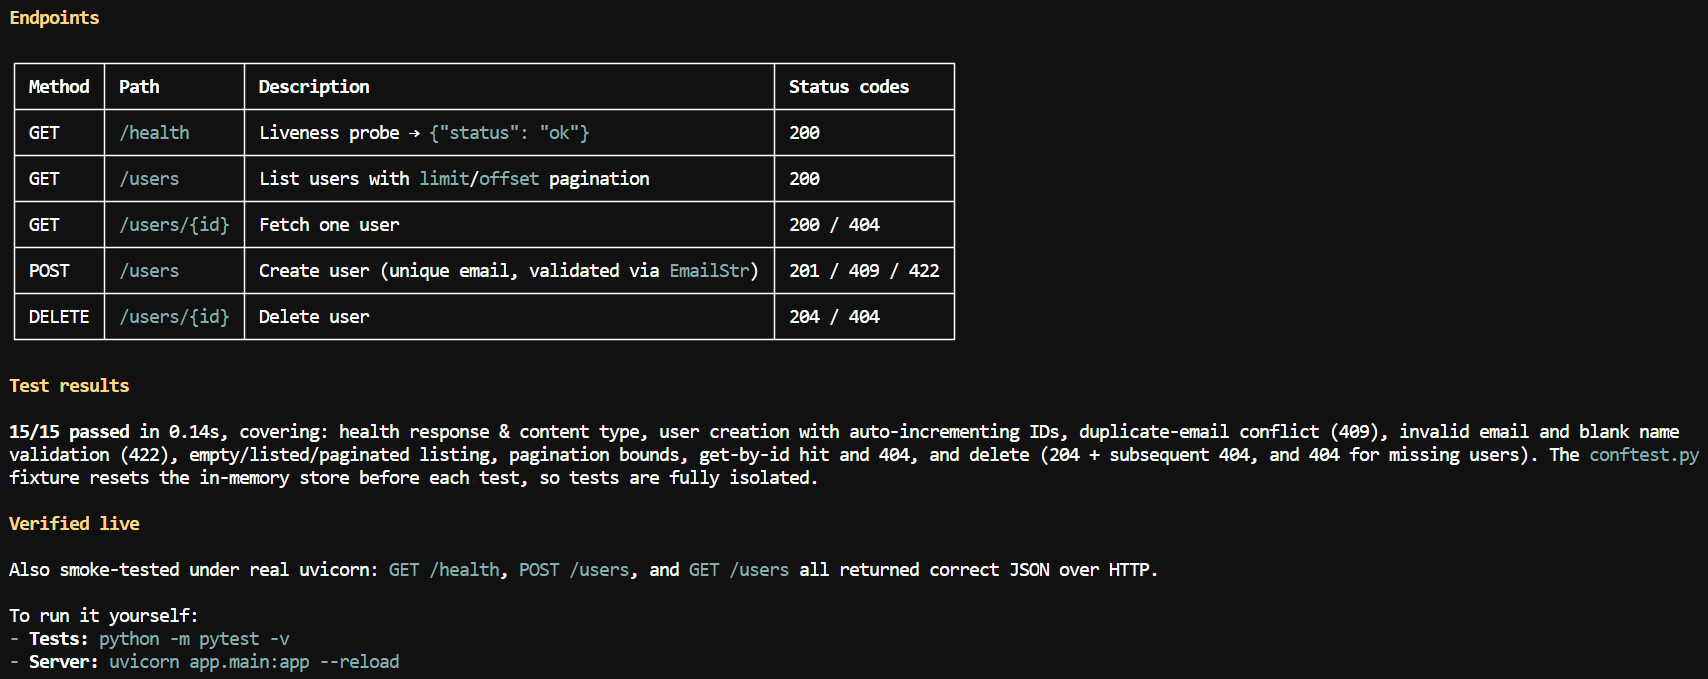
Через несколько минут модель создала эндпоинты, написала и выполнила тесты, провела smoke-тест и подготовила краткое описание того, как запустить проект.
Интересно то, что полная модель работает локально, хотя её веса намного больше доступной VRAM GPU. Pi управляет циклом код-агента, а SGLang и KTransformers обеспечивают собственно инференс модели.
KTransformers — не единственный способ запустить модель, превышающую вашу VRAM. И vLLM, и llama.cpp поддерживают выгрузку на CPU, но распределяют работу по-разному:
| Фреймворк | Как использует память CPU | Где выполняются эксперты | Лучшее применение |
|---|---|---|---|
| vLLM | Выгружает часть весов в RAM CPU (--cpu-offload-gb) и переносит их на GPU по мере необходимости |
GPU | Высокопроизводительный сервинг, когда модель в основном помещается в VRAM |
| llama.cpp | Делит слои между CPU и GPU и может держать тензоры экспертов MoE в RAM (--n-cpu-moe) |
CPU и GPU | Квантизированные модели GGUF на потребительском «железе» |
| KTransformers + SGLang | Держит большинство экспертов в RAM и размещает заданное число экспертов на слой на GPU | CPU и GPU, с оптимизированными ядрами экспертов AVX-512 | Модели MoE в родной точности на машинах со стами гигабайт RAM |
В этой связке SGLang и KTransformers не конкурируют. SGLang отвечает за сервинг, а KTransformers — за гетерогенное выполнение MoE на CPU и GPU.
Больше всего в этой схеме понравилось то, что KTransformers делает нечто отличающееся от привычного стека инференса. Вместо мышления только слоями модели он размещает отдельных экспертов на GPU, удерживая других в системной RAM, и CPU реально участвует в вычислениях экспертов. CPU — это не просто «переполнение».
В этом руководстве мы локально запустили полную модель GLM-5.3-Flash на двух RTX PRO 6000, хотя её веса намного превышают доступную VRAM.
Это не самая быстрая конфигурация. Скорость была около 11 токенов в секунду, и остаётся большой простор для настройки числа и размещения экспертов на GPU. Можно поэкспериментировать и с одним GPU при достаточной RAM; два мы использовали здесь скорее для запаса прочности.
Для меня главный вывод таков: KTransformers особенный не потому, что изобрёл выгрузку на CPU. Он особенный тем, что заставляет RAM CPU, вычисления на CPU и вычисления на GPU работать вместе вокруг разреженной структуры MoE-моделей.
Лучшие курсы DataCamp
Курс
Трек
Трек