คอร์ส
Transformer Models ด้วย PyTorch
2 ชม.
9.2K
KTransformers เป็นเฟรมเวิร์กอินเฟอเรนซ์แบบโอเพ่นซอร์สที่ทำให้ CPU และ GPU ทำงานรันผู้เชี่ยวชาญ (experts) คนละส่วนพร้อมกันระหว่างอินเฟอเรนซ์ได้ จึงสามารถรันโมเดลแบบ Mixture-of-Experts (MoE) ที่มีขนาดใหญ่เกินกว่าหน่วยความจำของ GPU จะรองรับได้ เฟรมเวิร์กอย่าง vLLM ก็สามารถออฟโหลดเวทไปไว้ในหน่วยความจำของ CPU ได้เช่นกัน แต่ KTransformers ถูกออกแบบมาโดยเฉพาะสำหรับโครงสร้างแบบสparse ของโมเดล MoE
ในบทเรียนนี้ จะใช้ KTransformers และ SGLang เพื่อรัน GLM-5.3-Flash โมเดลพารามิเตอร์ 320B ซึ่งเวทมีขนาดใหญ่กว่าที่ 192 GB ของ VRAM จะบรรจุได้ จะติดตามการใช้งานหน่วยความจำของ CPU และ GPU ทดลองการวางตำแหน่งของ experts ทดสอบ API ที่เข้ากันได้กับ OpenAI และเชื่อมโมเดลเข้ากับ Pi ให้ทำงานเป็นเอเจนต์โค้ดดิ้งแบบโลคัล
แนวคิดหลักเรียบง่าย: แทนที่จะใช้หน่วยความจำของ CPU เป็นพื้นที่เก็บล้น KTransformers ใช้ทั้ง พลังประมวลผลของ CPU และ GPU ระหว่างอินเฟอเรนซ์
KTransformers คือ เฟรมเวิร์กอินเฟอเรนซ์แบบโอเพ่นซอร์ส สำหรับรันโมเดลภาษาขนาดใหญ่มากโดยใช้การผสมผสานระหว่าง VRAM ของ GPU และ RAM ของ CPU โดยทั่วไป การเสิร์ฟโมเดลขนาดใหญ่ต้องโหลดเวทส่วนใหญ่เข้าไปไว้ในหน่วยความจำของ GPU ซึ่งมีค่าใช้จ่ายสูงมากสำหรับโมเดลขนาด GLM-5.3-Flash
KTransformers เลือกแนวทางต่างออกไป: เก็บเวทของ MoE experts จำนวนมากไว้ในหน่วยความจำระบบ และสงวนหน่วยความจำของ GPU สำหรับส่วนของอินเฟอเรนซ์ที่ได้ประโยชน์มากที่สุดจากการเร่งความเร็วด้วย GPU
วิธีนี้เหมาะกับโมเดล MoE เพราะไม่ใช่ทุก expert จะถูกใช้กับทุกโทเค็น ตัวอย่างเช่น GLM-5.3-Flash มี experts ที่ถูก route 288 ตัว แต่ตัว router จะเลือกเพียง 8 ตัว (บวก 1 shared expert) ต่อโทเค็น ดังนั้น KTransformers จึงสามารถกระจายการคำนวณของ experts ระหว่าง CPU และ GPU ได้:
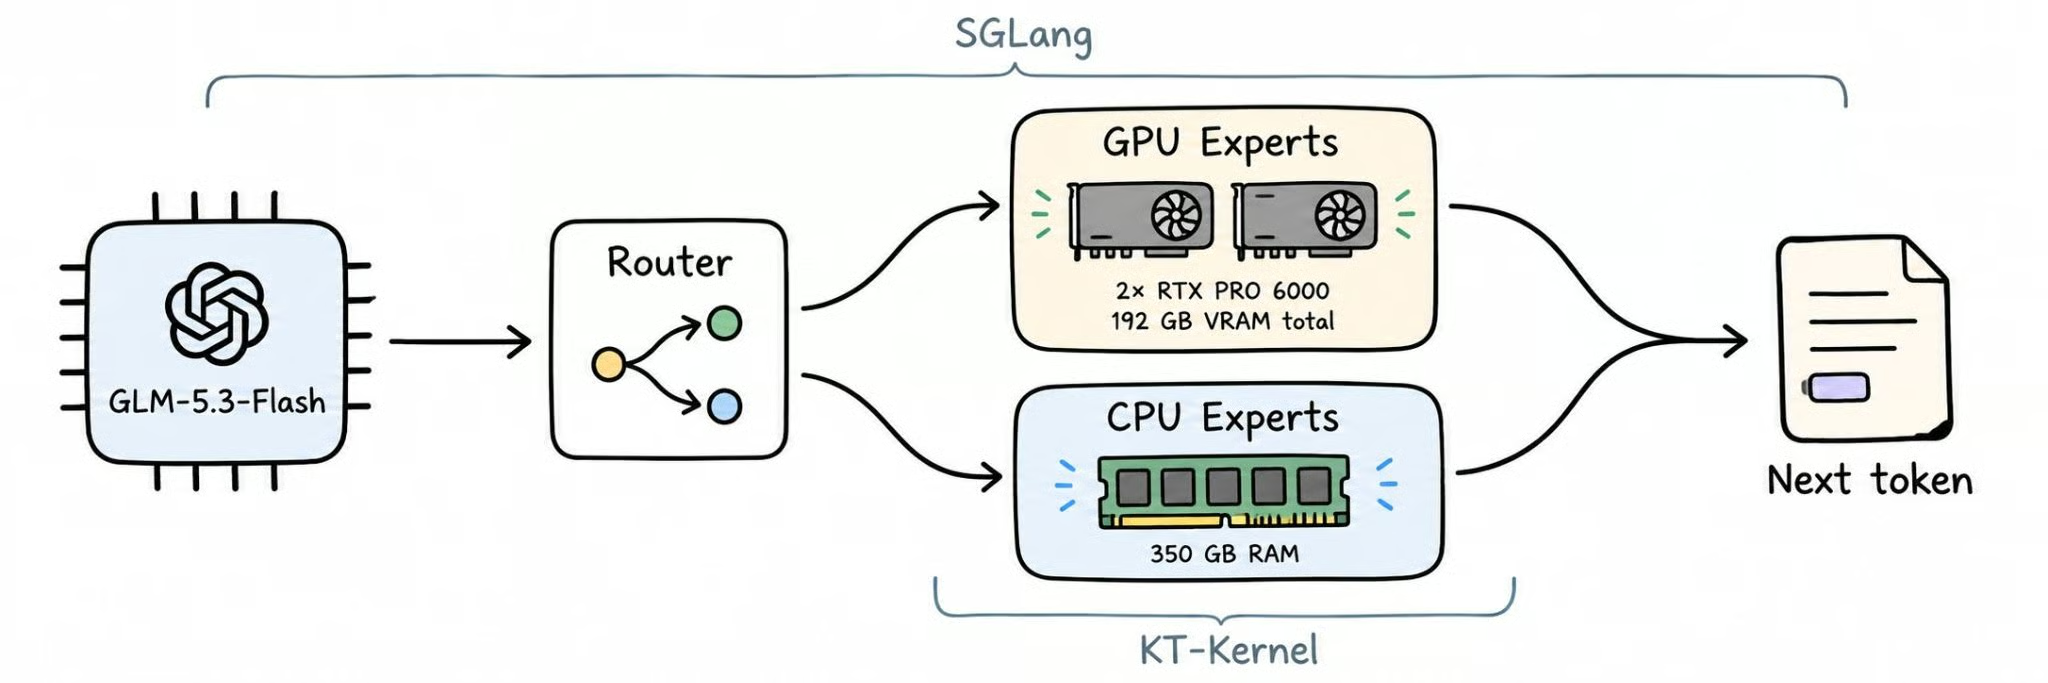
สแตกปัจจุบันของ KTransformers ผสาน KT-Kernel เข้ากับ SGLang เพื่อทำอินเฟอเรนซ์แบบผสมผสาน CPU-GPU โดยแต่ละคอมโพเนนต์รับผิดชอบงานต่างกัน:
KTransformers ยังรองรับการเปลี่ยนตำแหน่งของ experts ตามรูปแบบเวิร์กโหลด ตามที่อธิบายใน บทเรียนการจัดตารางผู้เชี่ยวชาญ
กล่าวอีกนัยหนึ่ง KTransformers มองว่า หน่วยความจำของ CPU และ GPU เป็นระบบอินเฟอเรนซ์ร่วมกัน แทนที่จะบังคับให้โมเดลทั้งตัวต้องใส่ลงใน VRAM ของ GPU นี่คือสิ่งที่ทำให้โมเดล MoE ขนาดใหญ่มากสามารถรันบนฮาร์ดแวร์ที่มีหน่วยความจำ GPU น้อยกว่าปกติ
GLM-5.3-Flash คือโมเดล MoE แบบเปิดเวทและมัลติโหมดโดยกำเนิดของ Z.ai เผยแพร่ภายใต้สัญญาอนุญาต MIT ในเดือนสิงหาคม 2026 แม้จะใช้ชื่อว่า "Flash" แต่ก็เป็นโมเดลขนาดใหญ่: พารามิเตอร์รวม 320B โดยมีพารามิเตอร์ที่ทำงานต่อโทเค็นราว 18B
สเปกที่สำคัญสำหรับการรันแบบโลคัลมีดังนี้:
zai-org/GLM-5.3-Flash)KTransformers อ่านเวท FP8 อย่างเป็นทางการได้โดยตรง จึงไม่ต้องแปลงหรือทำควอนไทซ์เพิ่มเติม สำหรับ benchmark และภาพรวมโมเดลแบบเต็ม โปรดดู คู่มือ GLM-5.3-Flash
สำหรับ GLM-5.3-Flash คำถามเรื่องฮาร์ดแวร์ส่วนใหญ่เกี่ยวข้องกับ RAM ของระบบ บทเรียนทางการของ KTransformers สำหรับ GLM-5.3-Flash แนะนำให้สำรองหน่วยความจำระบบที่พร้อมใช้อย่างน้อย 350 GB
สำหรับบทเรียนนี้ ใช้ RunPod อินสแตนซ์ที่มีประมาณ:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11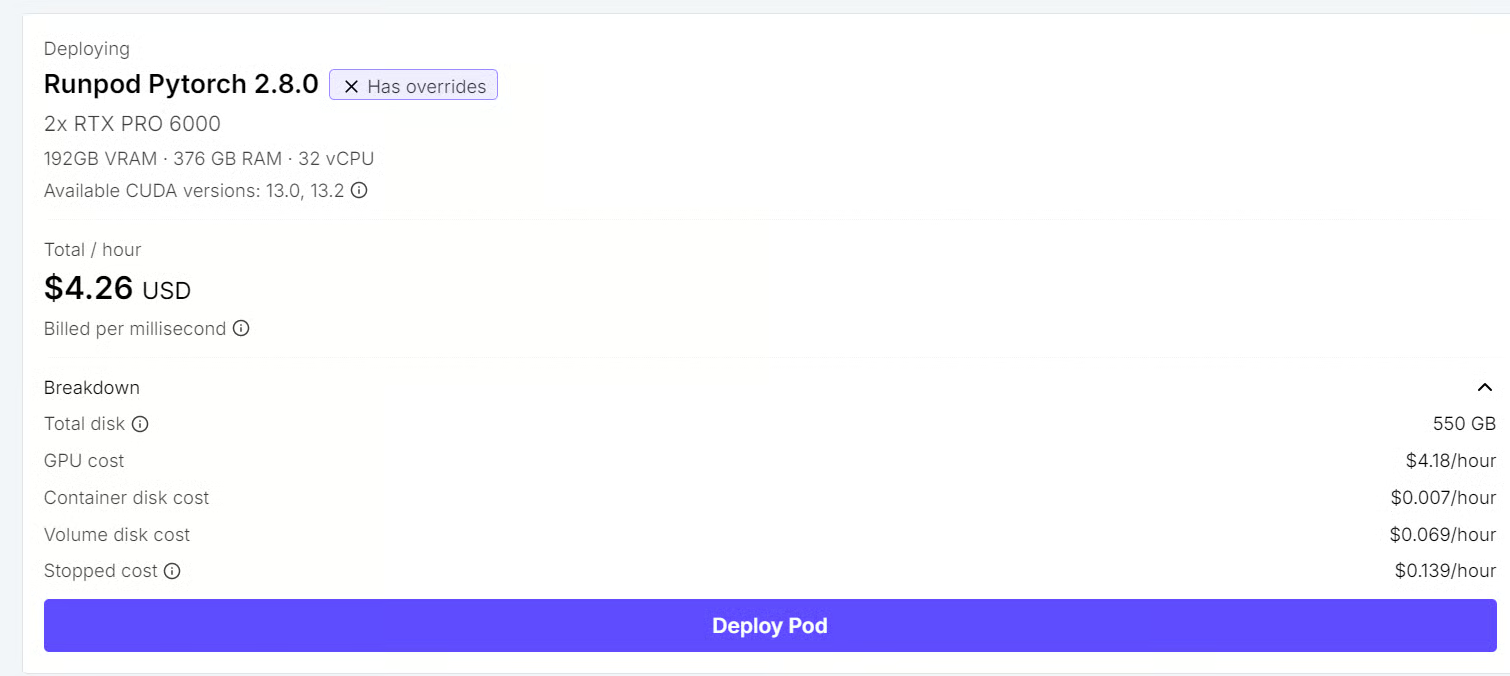
เช็คพอยต์ FP8 อย่างเป็นทางการของ GLM-5.3-Flash มีขนาดประมาณ 306 GiB (ราว 329 GB) ขณะที่ GPU สองใบของเรามี VRAM รวม 192 GB ดังนั้นโมเดลเต็มจึงไม่สามารถโหลดใส่หน่วยความจำ GPU ได้ทั้งหมด
แทนที่จะเป็นเช่นนั้น KTransformers เก็บเวทของ MoE ส่วนใหญ่ไว้ใน RAM ของระบบ และย้ายงานคำนวณที่มีประโยชน์ที่สุดไปให้ GPU คำแนะนำ 350 GB จึงเผื่อพื้นที่สำหรับเวทของโมเดลบวกโอเวอร์เฮดของรันไทม์
การมีหน่วยความจำ GPU มากขึ้นไม่ได้ตัดความจำเป็นของ RAM ในการตั้งค่านี้ หน่วยความจำของ CPU เป็นองค์ประกอบโดยตั้งใจของการออกแบบอินเฟอเรนซ์แบบผสมผสานของ KTransformers: เวทของ experts อยู่ใน RAM ขณะที่ GPU จัดการส่วนของโมเดลที่ได้ประโยชน์สูงสุดจากการเร่ง
การใช้งาน GLM-5.3-Flash ปัจจุบันยังมีข้อกำหนดเฉพาะของ CPU และ GPU ดังนี้:
ได้ หากมี RAM ของระบบเพียงพอและ CPU ที่รองรับ คู่มืออย่างเป็นทางการมีคอนฟิกแบบ GPU เดียวที่ตั้งค่า --kt-num-gpu-experts 0 เพื่อให้ MoE experts ถูกจัดการฝั่ง CPU
ที่นี่เราใช้ RTX PRO 6000 สองใบ แต่ไม่ได้เป็นข้อกำหนดขั้นต่ำที่เคร่งครัด GPU ใบที่สองช่วยเพิ่ม VRAM และพื้นที่ขยับขยายระหว่างทดลองกับการใช้งาน KTransformers ที่ค่อนข้างใหม่ แทนที่จะจูนการตั้งค่าให้พอดีกับฮาร์ดแวร์ที่เล็กที่สุดที่พอจะรันโมเดลได้
สร้างสภาพแวดล้อม Python 3.11 ที่สะอาด และติดตั้ง KTransformers พร้อมการรองรับ SGLang:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
ตรวจสอบว่า KTransformers, KT-Kernel, SGLang และ CUDA ถูกตรวจจับอย่างถูกต้อง:
kt versionควรเห็นผลลัพธ์คล้ายกับนี้:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
นี่เป็นการยืนยันว่ารันไทม์ของ KTransformers และแบ็กเอนด์ SGLang ติดตั้งและพร้อมใช้งานแล้ว
ก่อนเริ่มเซิร์ฟเวอร์ ให้ดาวน์โหลดเช็คพอยต์ GLM-5.3-Flash อย่างเป็นทางการจาก Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
เช็คพอยต์มีขนาดราว 306 GiB การดาวน์โหลดจึงอาจใช้เวลาตามแบนด์วิดท์
จากนั้นชี้ KTransformers ไปยังพาธโมเดลแบบโลคัล:
export MODEL_PATH=/workspace/GLM-5.3-Flashตอนนี้เปิดรัน GLM-5.3-Flash ด้วยเทนเซอร์พาราลเลลิซึมสองทาง ใช้ GPU RTX PRO 6000 ทั้งสองใบ โมเดลรองรับบริบทได้สูงสุด 1M โทเค็น และตัวอย่างทางการใช้คอนฟิกที่ยืนยันแล้วที่ 501,025 โทเค็น เราจะเริ่มด้วยหน้าต่างบริบท 32K เพื่อให้การใช้หน่วยความจำคาดการณ์ได้ระหว่างทดสอบการตั้งค่า
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45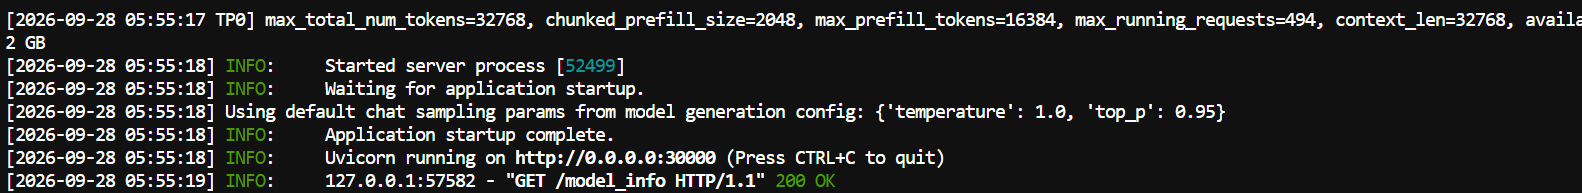
คอนฟิกนี้เปิดให้เข้าถึงโมเดลผ่านเซิร์ฟเวอร์ SGLang ที่เข้ากันได้กับ OpenAI บนพอร์ต 30000 ใช้ GPU ทั้งสองใบด้วย --tp-size 2 ขณะที่ KTransformers เก็บส่วนงาน MoE บางส่วนไว้ฝั่ง CPU และวาง experts ที่คัดเลือกบน GPU
การตั้งค่าที่นี่ตั้งใจให้ระมัดระวังสำหรับการรันครั้งแรก: บริบท 32K ใช้หน่วยความจำ GPU แบบสแตติก 85% มี GPU experts 14 ตัว และเธรดอินเฟอเรนซ์ CPU 64 เธรด เมื่อเซิร์ฟเวอร์เสถียรแล้ว จึงค่อยทดลองขยายหน้าต่างบริบท เพิ่มจำนวน GPU experts หรือปรับการตั้งค่าหน่วยความจำเพื่อเพิ่ม throughput
แฟลกส่วนใหญ่ด้านบนเป็นออปชันมาตรฐานของ SGLang ต่อไปนี้คือแฟลกที่ควบคุมว่า KTransformers แบ่งงานระหว่าง CPU และ GPU อย่างไร:
| Flag | Value | หน้าที่ |
|---|---|---|
--kt-method |
FP8 |
กำหนดความแม่นยำของเวทของ experts ให้ตรงกับเช็คพอยต์ FP8 แบบเนทีฟของ GLM-5.3-Flash |
--kt-cpuinfer |
64 |
จำนวนเธรด CPU ที่ใช้คำนวณผู้เชี่ยวชาญ |
--kt-threadpool-count |
2 |
จำนวนพูลเธรดของ CPU โดยทั่วไปจะตั้งให้สอดคล้องกับจำนวนโหนด NUMA |
--kt-num-gpu-experts |
14 |
จำนวน experts ต่อเลเยอร์ MoE ที่วางไว้บน GPU |
--kt-expert-placement-strategy |
uniform |
วิธีเลือก GPU experts ตัวเลือกอื่นได้แก่ frequency, front-loading และ random |
--kt-gpu-prefill-token-threshold |
2048 |
ความยาวพรอมป์ตที่เมื่อเกินค่านี้ prefill จะสลับไปยังเส้นทางแบบ layerwise ฝั่ง GPU |
เมื่อเซิร์ฟเวอร์ทำงานแล้ว สามารถตรวจสอบได้ว่า KTransformers ใช้ VRAM ของ GPU และ RAM ของระบบ อย่างไร จากนั้นลองเปลี่ยนจำนวน experts ที่อยู่บน GPU เพื่อดูว่าการใช้ทรัพยากรและประสิทธิภาพเปลี่ยนไปอย่างไร
บน RunPod คำสั่ง free -h อาจทำให้เข้าใจผิดได้ เพราะคอนเทนเนอร์อาจเห็น RAM รวมของเครื่องโฮสต์แทนที่จะเป็นหน่วยความจำที่มีให้กับพ็อด ควรติดตาม หน่วยความจำ GPU และหน่วยความจำคอนเทนเนอร์แยกกัน จะดีกว่า
เปิดเทอร์มินัลใหม่และติดตามการใช้ GPU:
watch -n 1 nvidia-smi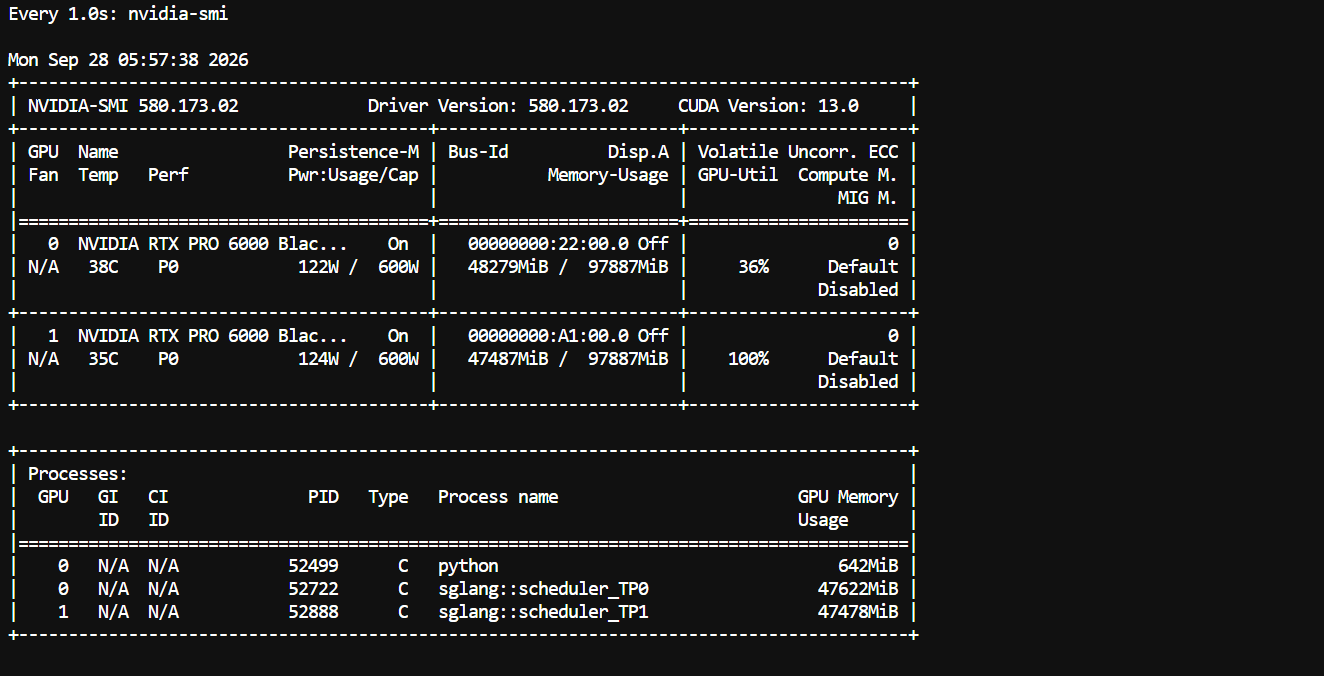
ด้วยคอนฟิกปัจจุบัน โมเดลที่โหลดเต็มใช้พื้นที่ประมาณ 48 GB ต่อ GPU ทำให้ยังมี VRAM เหลือจำนวนมาก ซึ่งบ่งชี้ว่ายังมีพื้นที่สำหรับวาง experts เพิ่มบน GPU หรือทดสอบคอนฟิกแบบ GPU เดียวโดยมี RAM ของระบบเพียงพอ
สำหรับ RAM ของคอนเทนเนอร์ ให้อ่านตัวนับหน่วยความจำของ cgroup โดยตรง:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'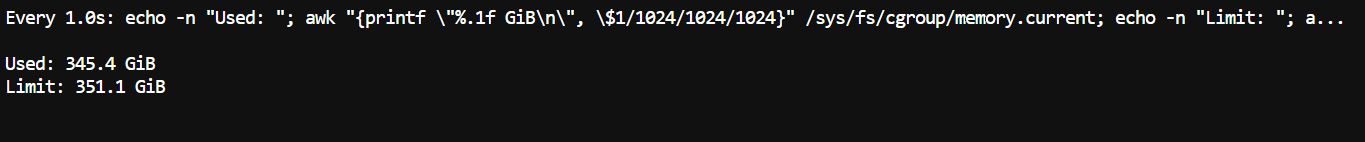
ควรเห็นว่า RAM ของระบบส่วนใหญ่ถูกใช้งานโดยเวทของโมเดลและ experts ฝั่ง CPU ซึ่งเป็นเรื่องปกติ: KTransformers ตั้งใจเก็บ MoE experts จำนวนมากไว้ใน RAM แทนที่จะบังคับให้ทั้งหมดอยู่ใน VRAM
--kt-num-gpu-expertsต่อไป ให้รีสตาร์ทเซิร์ฟเวอร์พร้อมค่าต่างๆ ของ --kt-num-gpu-experts ตัวอย่างเช่น เปรียบเทียบ:
0
10
20
--kt-num-gpu-experts ควบคุมจำนวน experts ต่อเลเยอร์ MoE ที่วางไว้บน GPU หากตั้ง 0 การคำนวณของ experts จะคงอยู่ฝั่ง CPU; เมื่อเพิ่มค่านี้ จะย้าย experts มากขึ้นเข้าสู่หน่วยความจำ GPU
สำหรับแต่ละคอนฟิก ให้เปรียบเทียบ การใช้ VRAM ของ GPU การใช้ RAM ของคอนเทนเนอร์ จำนวนโทเค็นต่อวินาที และเวลาได้โทเค็นแรก โดยหลักการแล้ว การมี GPU experts มากขึ้นจะใช้ VRAM เพิ่มขึ้น แต่ลดการคำนวณของ experts ฝั่ง CPU ซึ่งสามารถปรับปรุงประสิทธิภาพอินเฟอเรนซ์ได้เมื่อมี VRAM เพียงพอ
ข้อควรระวังจากบทเรียนทางการ: เมื่อเปิดใช้ Layerwise Prefill สำหรับ GLM-5.3-Flash การใช้งานปัจจุบันจะปรับจำนวน GPU experts ที่พำนักให้เป็นศูนย์ หากการใช้ VRAM แทบไม่เปลี่ยนระหว่างการรัน เหตุผลน่าจะเป็นข้อนี้
การทดลองนี้แสดงให้เห็นข้อได้เปรียบสำคัญของ KTransformers: RAM ของ CPU และ VRAM ของ GPU กลายเป็นส่วนประกอบที่ปรับแต่งได้ของระบบอินเฟอเรนซ์เดียวกัน จึงสามารถแลกตำแหน่งหน่วยความจำกับความเร็วได้ แทนที่จะบังคับให้โมเดล MoE ทั้งตัวต้องอยู่บน GPU
เมื่อเซิร์ฟเวอร์ทำงานแล้ว สามารถยืนยันความพร้อมของโมเดลและส่งคำขอจริงผ่าน API ของ SGLang ที่เข้ากันได้กับ OpenAI
ก่อนอื่นตรวจสอบว่าโมเดลถูกลงทะเบียนแล้ว:
curl http://localhost:30000/v1/modelsจากนั้นส่งพรอมป์ตทดสอบ:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'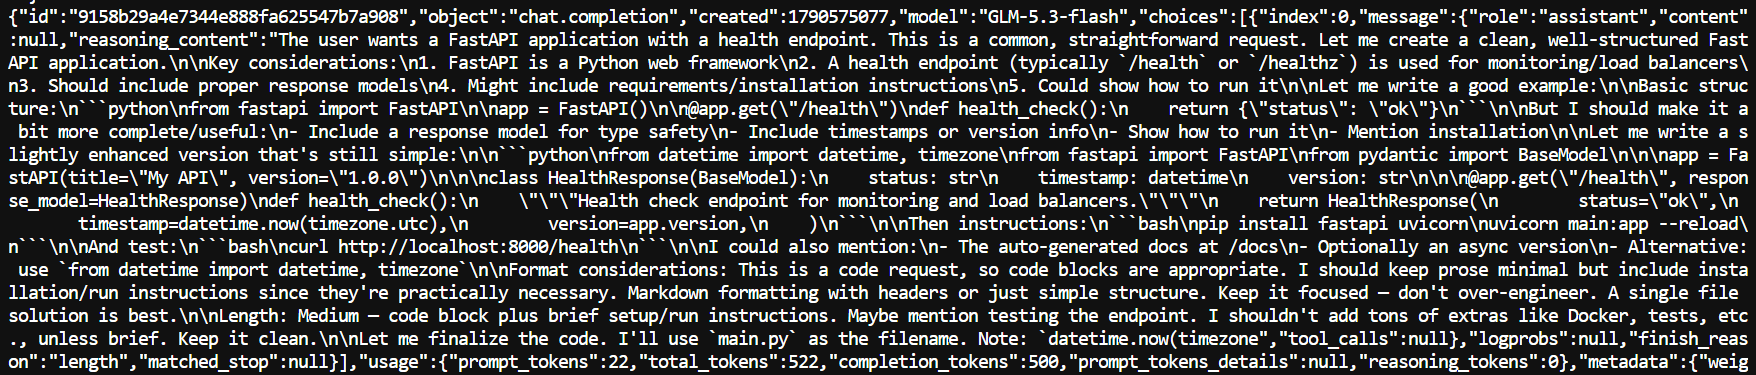
หากตั้งค่าถูกต้อง เซิร์ฟเวอร์จะส่งคืนการตอบกลับแบบ chat completion ปกติที่มีโค้ดที่สร้างขึ้นและสถิติการใช้งาน
Pi เป็นเอเจนต์โค้ดดิ้งที่เบาและสามารถใช้โมเดลใดๆ ที่เข้ากันได้กับ OpenAI เป็นแบ็กเอนด์ได้ ทำให้ GLM-5.3-Flash ทำงานบนงานโค้ดดิ้งโดยตรง แทนที่จะเพียงตอบพรอมป์ต
ติดตั้ง Pi ด้วยสคริปต์ติดตั้ง:
curl -fsSL https://pi.dev/install.sh | sh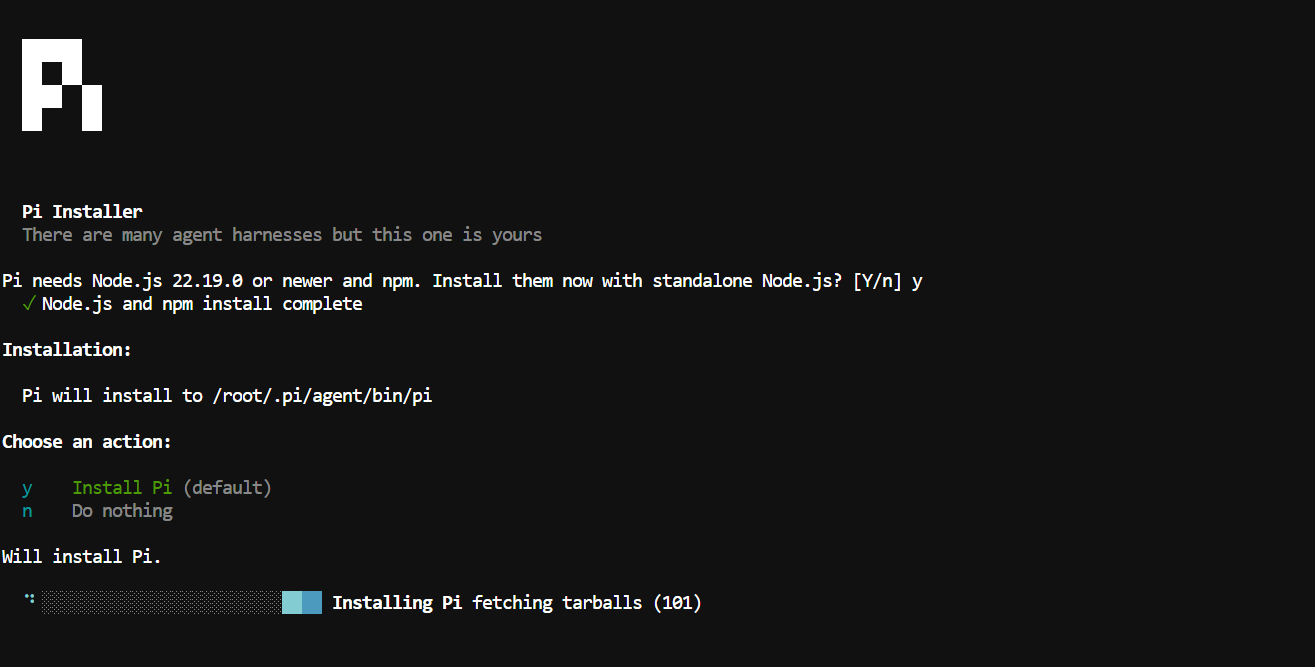
จากนั้นเพิ่ม Pi ลงใน PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcสร้างคอนฟิกโมเดลเพื่อชี้ Pi ไปยังเซิร์ฟเวอร์ KTransformers แบบโลคัล:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
เริ่มต้น Pi:
piจากนั้นเปิดตัวเลือกโมเดล:
/model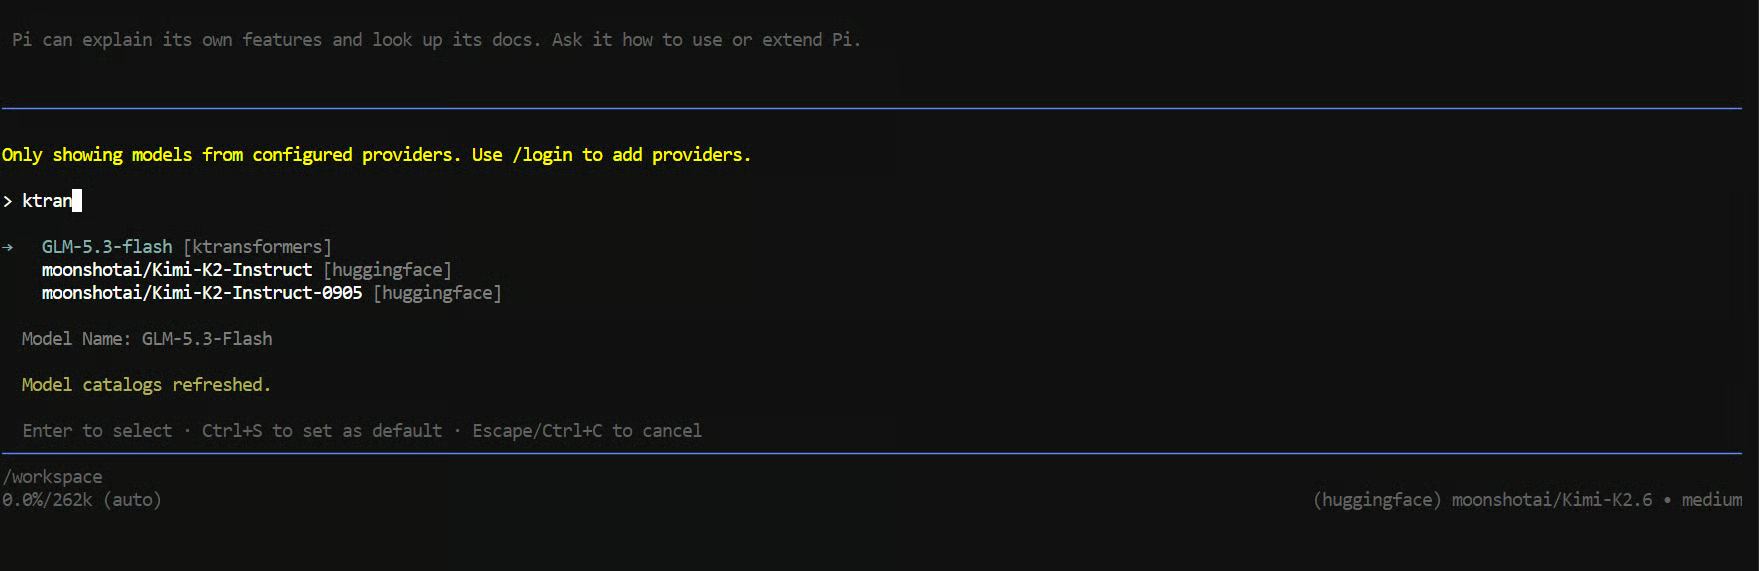
เลือก GLM-5.3-Flash และลองงานโค้ดดิ้งจริง:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.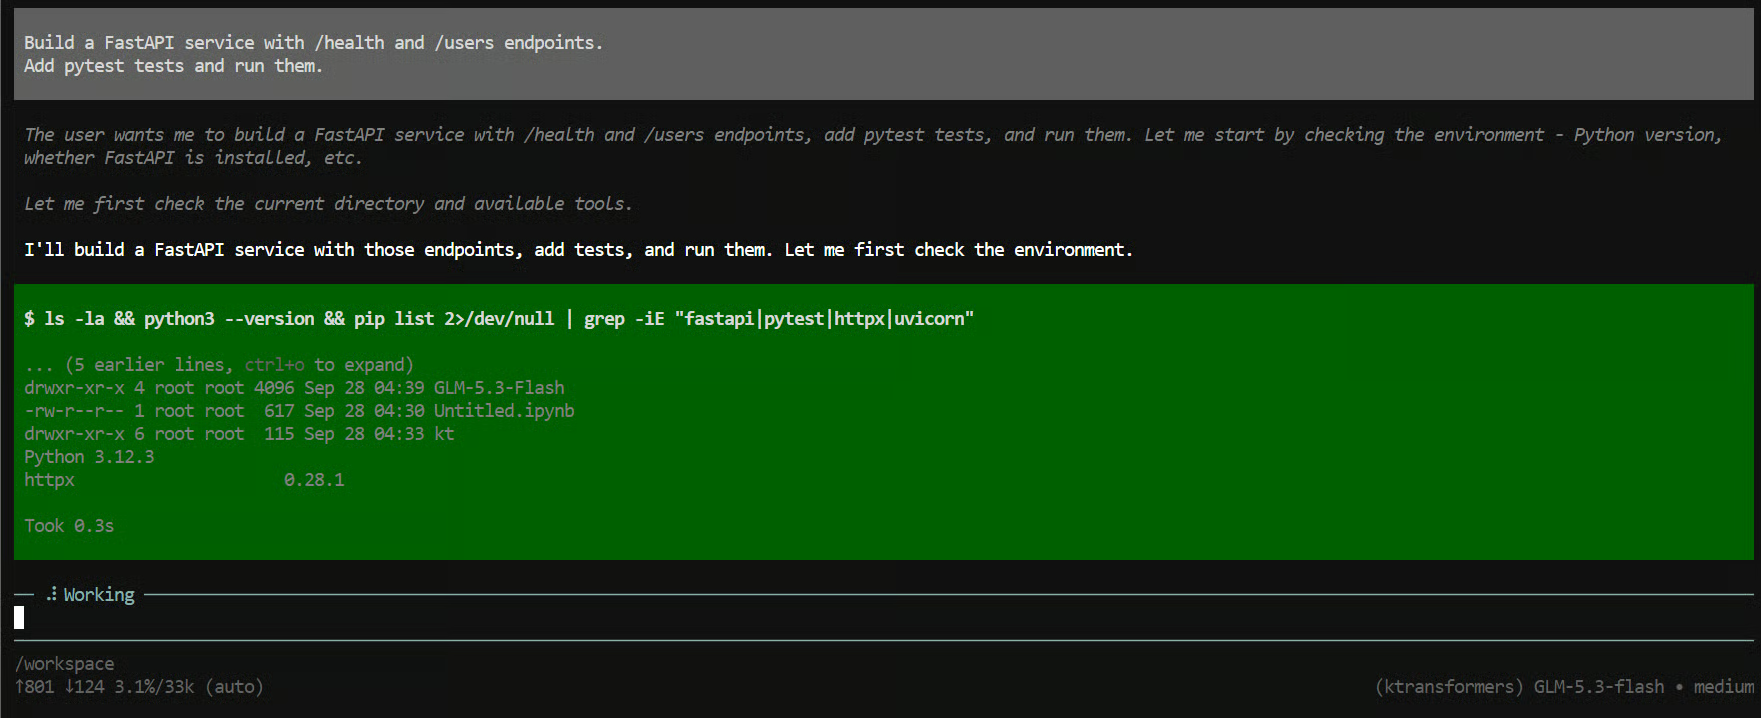
ภายในไม่กี่วินาที Pi จะเริ่มสร้างไฟล์ เขียน API รันทดสอบ และแก้ปัญหาไปเรื่อยๆ ระหว่างทำงานให้เสร็จ
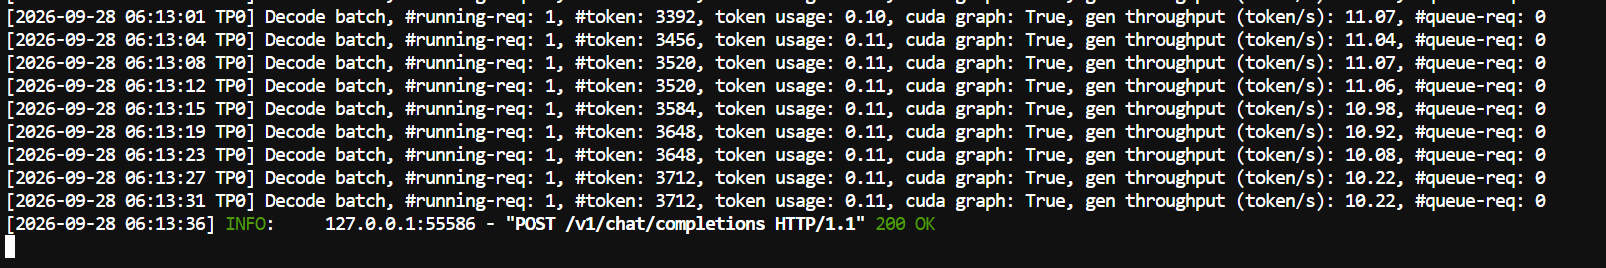
ยังสามารถดูที่เทอร์มินัลแรกซึ่งรันเซิร์ฟเวอร์ SGLang ในการทดสอบ ความเร็วการสร้างอยู่ที่ประมาณ 11 โทเค็นต่อวินาที ถือว่าเหมาะสมสำหรับโมเดลขนาดนี้ที่มีการออฟโหลดไปยัง CPU มาก และยังสามารถปรับแต่งเพิ่มเติมได้โดยย้าย experts เพิ่มขึ้นสู่ GPU
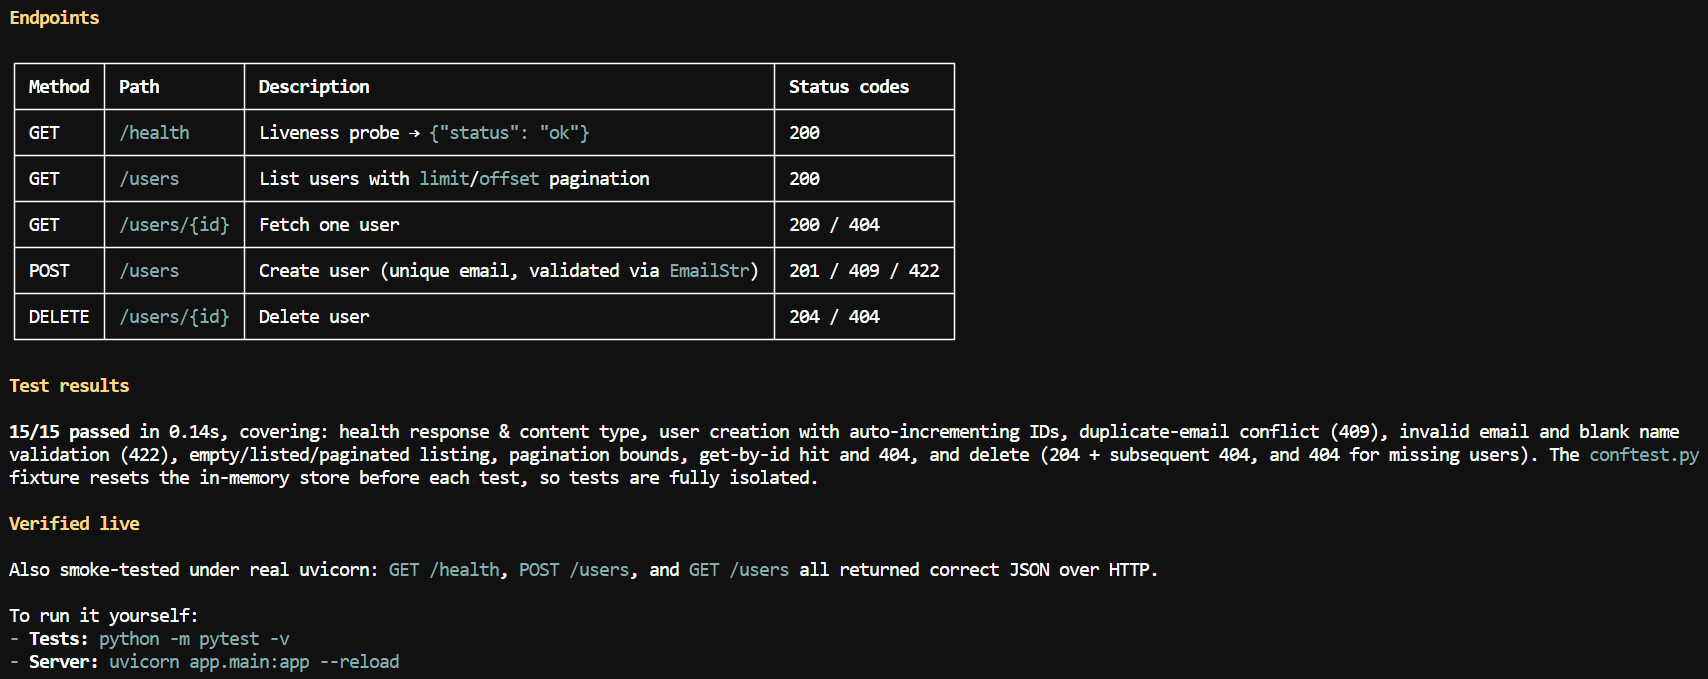
ภายในไม่กี่นาที โมเดลได้สร้างเอ็นด์พอยต์ เขียนและรันทดสอบ ทำ smoke test และสรุปขั้นตอนการรันโปรเจกต์แบบย่อ
ที่น่าสนใจคือ โมเดลเต็มกำลังรันบนเครื่องโลคัล แม้เวทจะมีขนาดใหญ่กว่า VRAM ของ GPU ที่มีอยู่มาก Pi จัดการลูปของเอเจนต์โค้ดดิ้ง ขณะที่ SGLang และ KTransformers จัดการอินเฟอเรนซ์ของโมเดลจริง
KTransformers ไม่ใช่วิธีเดียวที่จะรันโมเดลที่ใหญ่กว่า VRAM ของคุณ vLLM และ llama.cpp ต่างก็รองรับการออฟโหลดไปยัง CPU แต่แบ่งงานต่างกัน:
| Framework | การใช้หน่วยความจำ CPU | ตำแหน่งคำนวณของ experts | เหมาะกับ |
|---|---|---|---|
| vLLM | ออฟโหลดเวทบางส่วนไปยัง RAM ของ CPU (--cpu-offload-gb) และถ่ายกลับไป GPU เมื่อจำเป็น |
GPU | การเสิร์ฟที่ throughput สูงเมื่อโมเดลเกือบใส่ใน VRAM |
| llama.cpp | แบ่งเลเยอร์ระหว่าง CPU และ GPU และสามารถเก็บเทนเซอร์ MoE experts ไว้ใน RAM (--n-cpu-moe) |
CPU และ GPU | โมเดล GGUF ที่ทำควอนไทซ์บนฮาร์ดแวร์คอนซูเมอร์ |
| KTransformers + SGLang | เก็บ experts ส่วนใหญ่ไว้ใน RAM และวางจำนวน experts ต่อเลเยอร์ไว้บน GPU ตามที่กำหนด | CPU และ GPU พร้อมเคอร์เนล expert แบบ AVX-512 ที่ปรับแต่ง | โมเดล MoE ความแม่นยำเนทีฟบนเครื่องที่มี RAM หลายร้อย GB |
SGLang และ KTransformers ไม่ได้แข่งกันในโครงแบบนี้ SGLang จัดการฝั่งเสิร์ฟ ขณะที่ KTransformers จัดการการรัน MoE แบบผสมผสาน CPU-GPU
สิ่งที่ชอบที่สุดเกี่ยวกับชุดนี้คือ KTransformers ทำสิ่งที่แตกต่างเล็กน้อยจากสแตกอินเฟอเรนซ์ทั่วไป แทนที่จะคิดแค่ในมุมของเลเยอร์โมเดล มันวาง experts รายตัวบน GPU ขณะที่เก็บรายอื่นไว้ใน RAM ของระบบ และ CPU เองก็เข้ามามีบทบาทในการคำนวณของ experts ไม่ได้เป็นเพียงที่เก็บล้นเท่านั้น
ในบทเรียนนี้ เรารันโมเดล GLM-5.3-Flash แบบเต็มบน GPU RTX PRO 6000 สองใบ แม้เวทของมันจะใหญ่กว่าหน่วยความจำ VRAM ที่มีอยู่มาก
มันไม่ใช่ชุดที่เร็วที่สุด ความเร็วที่ได้อยู่ราว 11 โทเค็นต่อวินาที และยังมีพื้นที่ให้ปรับจูนจำนวนและตำแหน่งของ GPU experts อีกมาก อาจลองใช้ GPU ใบเดียวถ้ามี RAM เพียงพอ; ที่นี่ใช้สองใบเพื่อให้มีพื้นที่เผื่อระหว่างทดลอง
สำหรับเรา นี่คือสาระสำคัญของคู่มือนี้: KTransformers ไม่ได้พิเศษเพราะคิดค้นการออฟโหลดไปยัง CPU แต่พิเศษเพราะทำให้ RAM ของ CPU, การคำนวณบน CPU และการคำนวณบน GPU ทำงานร่วมกันได้รอบโครงสร้างสparse ของโมเดล MoE
คอร์สยอดนิยมบน DataCamp
คอร์ส
แทร็ก
แทร็ก