Curs
Modele Transformer cu PyTorch
2 ore
9.2K
KTransformers este un framework open-source pentru inferență care permite CPU-ului și GPU-ului să execute activ experți diferiți în timpul inferenței, astfel încât poți rula modele Mixture-of-Experts (MoE) mult mai mari decât memoria GPU-ului tău. Framework-uri precum vLLM pot, de asemenea, să transfere greutăți în memoria CPU, dar KTransformers este construit special în jurul structurii sparse a modelelor MoE.
În acest tutorial, vom folosi KTransformers și SGLang pentru a rula GLM-5.3-Flash, un model cu 320B de parametri ale cărui greutăți nu încap în 192 GB de VRAM. Vom monitoriza utilizarea memoriei CPU și GPU, vom experimenta cu plasarea experților, vom testa API-ul compatibil cu OpenAI și vom conecta modelul la Pi ca agent local pentru programare.
Ideea principală este simplă: în loc să trateze memoria CPU ca pe un spațiu de overflow, KTransformers folosește atât computația pe CPU, cât și pe GPU în timpul inferenței.
KTransformers este un framework open-source pentru inferență care rulează modele lingvistice foarte mari folosind o combinație de VRAM GPU și RAM CPU. În mod normal, servirea unui model mare necesită încărcarea majorității greutăților în memoria GPU, ceea ce devine rapid costisitor pentru un model de dimensiunea GLM-5.3-Flash.
KTransformers abordează diferit problema: păstrează multe dintre greutățile experților MoE în memoria sistemului și rezervă memoria GPU pentru părțile inferenței care beneficiază cel mai mult de accelerarea GPU.
Acest lucru funcționează bine pentru modelele MoE deoarece nu fiecare expert este folosit pentru fiecare token. GLM-5.3-Flash, de exemplu, are 288 de experți rutați, dar routerul selectează doar 8 dintre ei (plus 1 expert partajat) pentru fiecare token. Prin urmare, KTransformers poate distribui calculul experților între CPU și GPU:
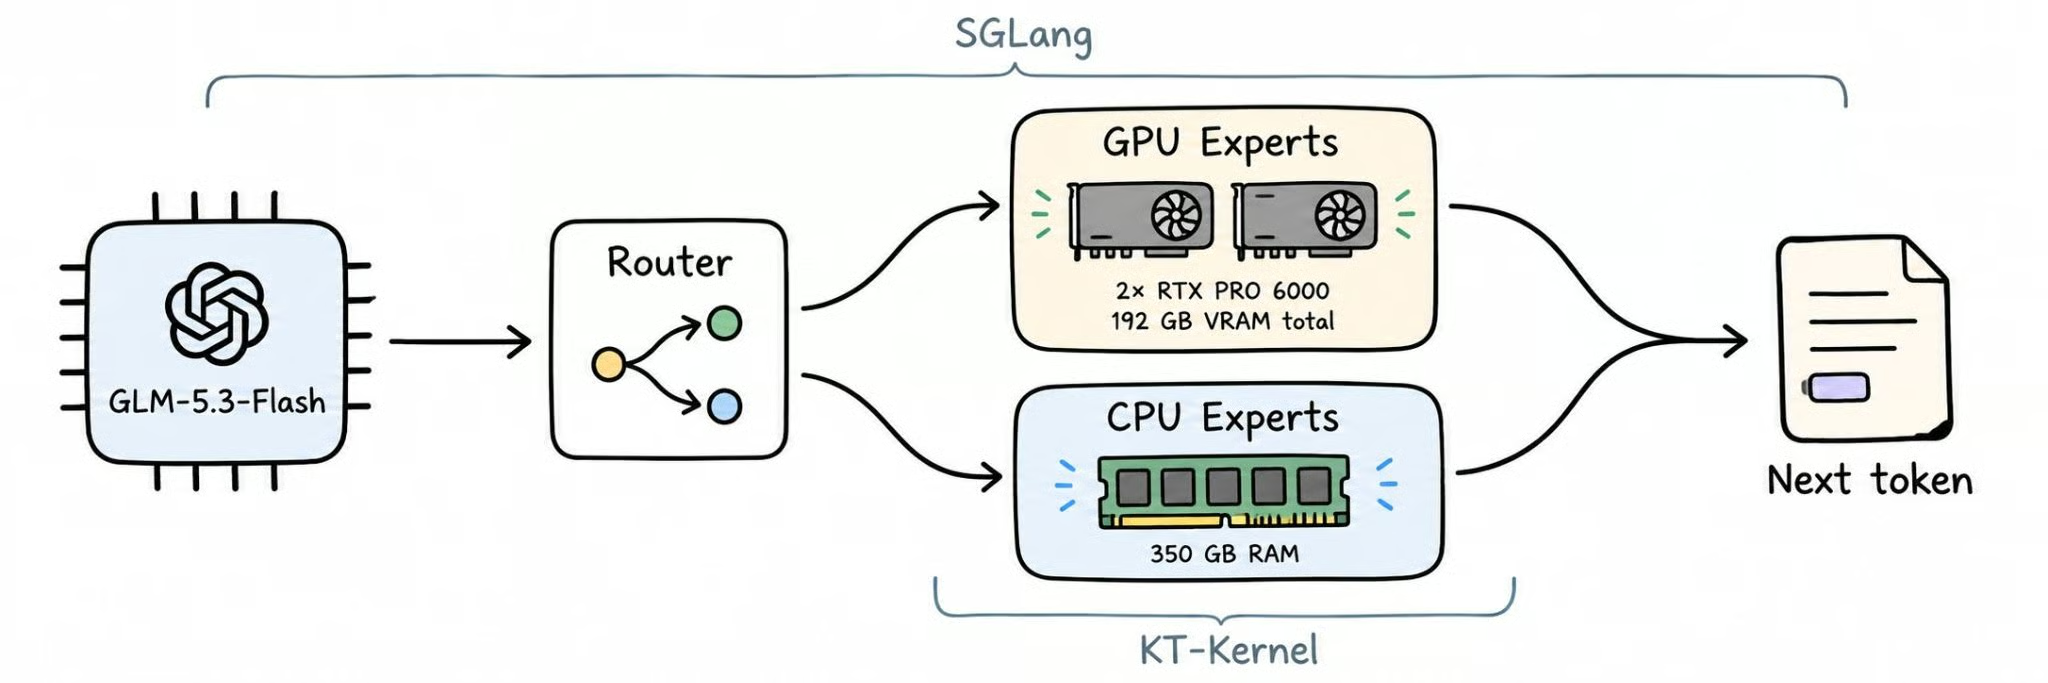
Stack-ul KTransformers actual integrează KT-Kernel cu SGLang pentru inferență eterogenă CPU-GPU. Fiecare componentă are un rol diferit:
KTransformers suportă, de asemenea, schimbarea plasării experților în funcție de tiparele de încărcare, așa cum este descris în tutorialul despre programarea experților.
Cu alte cuvinte, KTransformers tratează memoria CPU și memoria GPU ca pe un sistem comun de inferență în loc să ceară ca întregul model să încapă în VRAM-ul GPU. Asta permite rularea modelelor MoE foarte mari pe hardware cu mult mai puțină memorie GPU decât ar fi necesar în mod obișnuit.
GLM-5.3-Flash este modelul MoE open-weight, nativ multimodal al Z.ai, lansat sub licența MIT în august 2026. În ciuda numelui „Flash”, este un model mare: 320B de parametri în total, cu aproximativ 18B activi per token.
Acestea sunt specificațiile relevante pentru inferență locală:
zai-org/GLM-5.3-Flash)KTransformers citește direct greutățile FP8 oficiale, deci nu există un pas suplimentar de conversie sau cuantizare. Pentru benchmark-uri și o prezentare completă a modelului, vezi ghidul GLM-5.3-Flash.
Pentru GLM-5.3-Flash, întrebarea hardware ține în principal de RAM-ul sistemului. Tutorialul oficial KTransformers pentru GLM-5.3-Flash recomandă rezervarea a cel puțin 350 GB de memorie de sistem disponibilă.
Pentru acest tutorial, folosim o instanță RunPod cu aproximativ:
GPU:         2× RTX PRO 6000
VRAM:        96 GB each
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11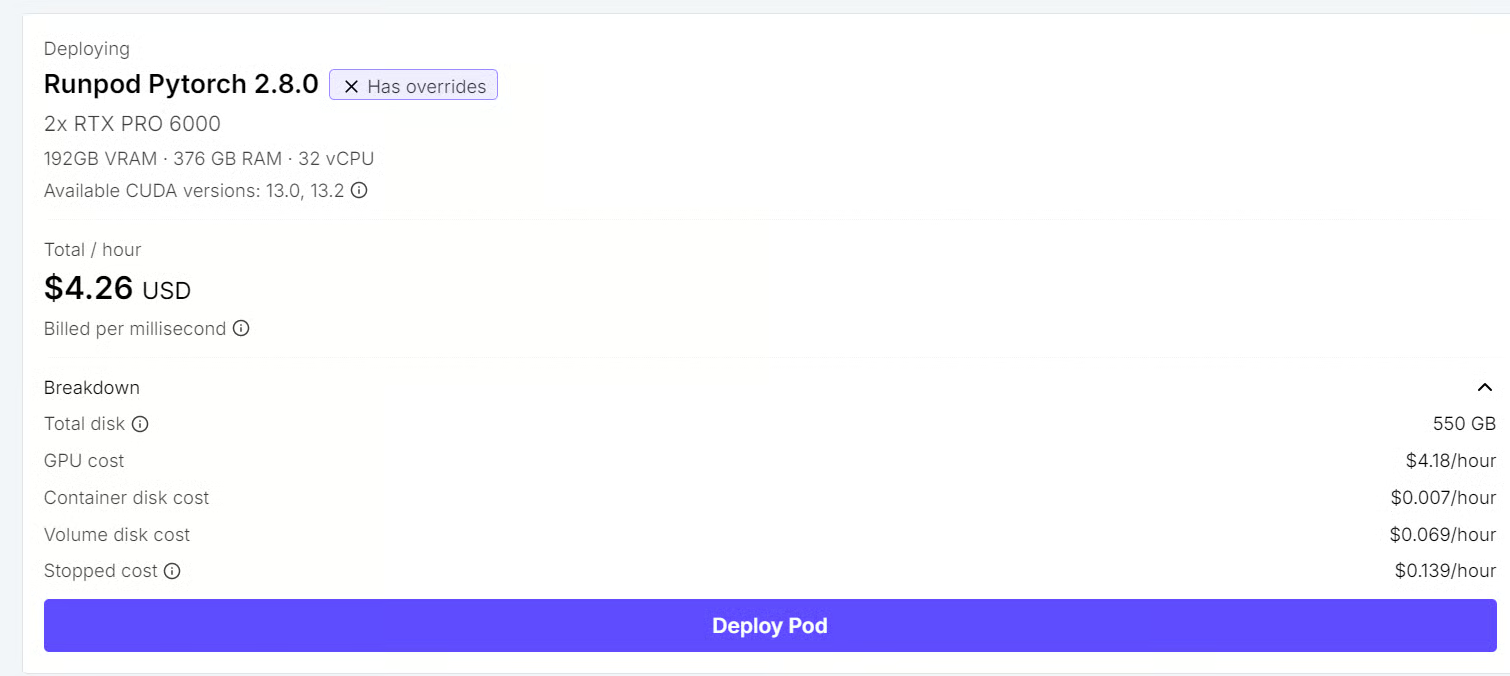
Checkpoint-ul oficial FP8 pentru GLM-5.3-Flash are aproximativ 306 GiB (circa 329 GB), în timp ce cele două GPU-uri oferă în total 192 GB de VRAM. Prin urmare, modelul complet nu poate fi pur și simplu încărcat în memoria GPU.
În schimb, KTransformers păstrează o parte mare din greutățile MoE în RAM-ul sistemului și mută pe GPU cea mai utilă parte a calculelor. Recomandarea de 350 GB lasă suficient spațiu pentru greutățile modelului plus overhead-ul de runtime.
Mai multă memorie GPU nu elimină nevoia de RAM în această configurație. Memoria CPU este o parte intenționată a designului de inferență eterogenă al KTransformers: greutățile experților rămân în RAM, în timp ce GPU-ul se ocupă de părțile modelului care beneficiază cel mai mult de accelerare.
Implementarea actuală GLM-5.3-Flash are, de asemenea, cerințe specifice pentru CPU și GPU:
Da, cu condiția să ai suficientă memorie de sistem și un CPU compatibil. Tutorialul oficial include o configurație cu un singur GPU care setează --kt-num-gpu-experts 0, astfel încât experții MoE sunt gestionați pe partea de CPU.
Aici folosim două GPU-uri RTX PRO 6000, dar acesta nu este un minim strict. Al doilea GPU ne oferă mai mult VRAM și spațiu de manevră în timp ce experimentăm cu o implementare KTransformers relativ nouă, în loc să optimizăm configurația strict în jurul celui mai mic hardware posibil care poate rula modelul.
Creează un mediu Python 3.11 curat și instalează KTransformers cu suport SGLang:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Verifică faptul că KTransformers, KT-Kernel, SGLang și CUDA sunt detectate corect:
kt versionAr trebui să vezi un output similar cu:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Acest lucru confirmă că runtime-ul KTransformers și backend-ul său SGLang sunt instalate și gata de utilizare.
Înainte de a porni serverul, descarcă checkpoint-ul oficial GLM-5.3-Flash de pe Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
Checkpoint-ul are în jur de 306 GiB, așa că descărcarea poate dura în funcție de lățimea ta de bandă.
Apoi indică KTransformers calea locală a modelului:
export MODEL_PATH=/workspace/GLM-5.3-FlashAcum pornește GLM-5.3-Flash cu paralelism tensorial pe două direcții, folosind ambele GPU-uri RTX PRO 6000. Modelul suportă până la 1M de tokeni de context, iar exemplele oficiale folosesc o configurație validată de 501.025 tokeni. Noi începem cu o fereastră de context de 32K, pentru a menține utilizarea memoriei predictibilă în timp ce testăm setarea.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45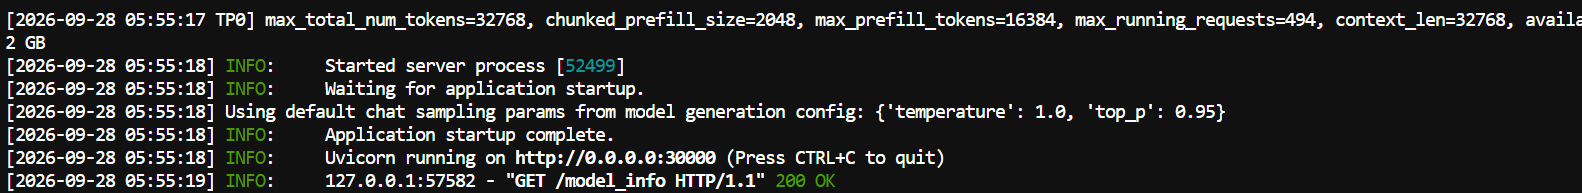
Această configurație expune modelul printr-un server SGLang compatibil cu OpenAI pe portul 30000. Cele două GPU-uri sunt folosite cu --tp-size 2, în timp ce KTransformers păstrează o parte din sarcina MoE pe CPU și plasează anumiți experți pe GPU-uri.
Setările sunt intenționat conservatoare pentru prima rulare: context 32K, 85% utilizare statică a memoriei GPU, 14 experți pe GPU și 64 de thread-uri de inferență pe CPU. După ce serverul e stabil, poți experimenta cu o fereastră de context mai mare, mai mulți experți pe GPU sau setări diferite de memorie pentru a îmbunătăți throughput-ul.
Majoritatea flag-urilor de mai sus sunt opțiuni standard SGLang. Acestea controlează modul în care KTransformers împarte munca între CPU și GPU:
| Flag | Valoare | Ce face |
|---|---|---|
--kt-method |
FP8 |
Setează precizia greutăților experților, potrivind checkpoint-ul FP8 nativ al GLM-5.3-Flash. |
--kt-cpuinfer |
64 |
Numărul de thread-uri CPU folosite pentru calculul experților. |
--kt-threadpool-count |
2 |
Numărul de thread pool-uri pe CPU, de obicei egal cu numărul de noduri NUMA. |
--kt-num-gpu-experts |
14 |
Numărul de experți per strat MoE plasați pe GPU. |
--kt-expert-placement-strategy |
uniform |
Modul în care sunt aleși experții pe GPU. Alte opțiuni includ frequency, front-loading și random. |
--kt-gpu-prefill-token-threshold |
2048 |
Lungimea promptului peste care prefill trece pe calea layerwise pe GPU. |
Acum că serverul rulează, putem verifica cum folosește KTransformers VRAM-ul GPU și RAM-ul sistemului, apoi să schimbăm numărul experților rezidenți pe GPU pentru a vedea cum se modifică utilizarea resurselor și performanța.
Pe RunPod, free -h poate fi înșelător deoarece un container poate vedea RAM-ul total al mașinii gazdă, nu doar memoria disponibilă pentru pod. Este mai bine să monitorizezi memoria GPU și memoria containerului separat.
Deschide un nou terminal și monitorizează utilizarea GPU-ului:
watch -n 1 nvidia-smi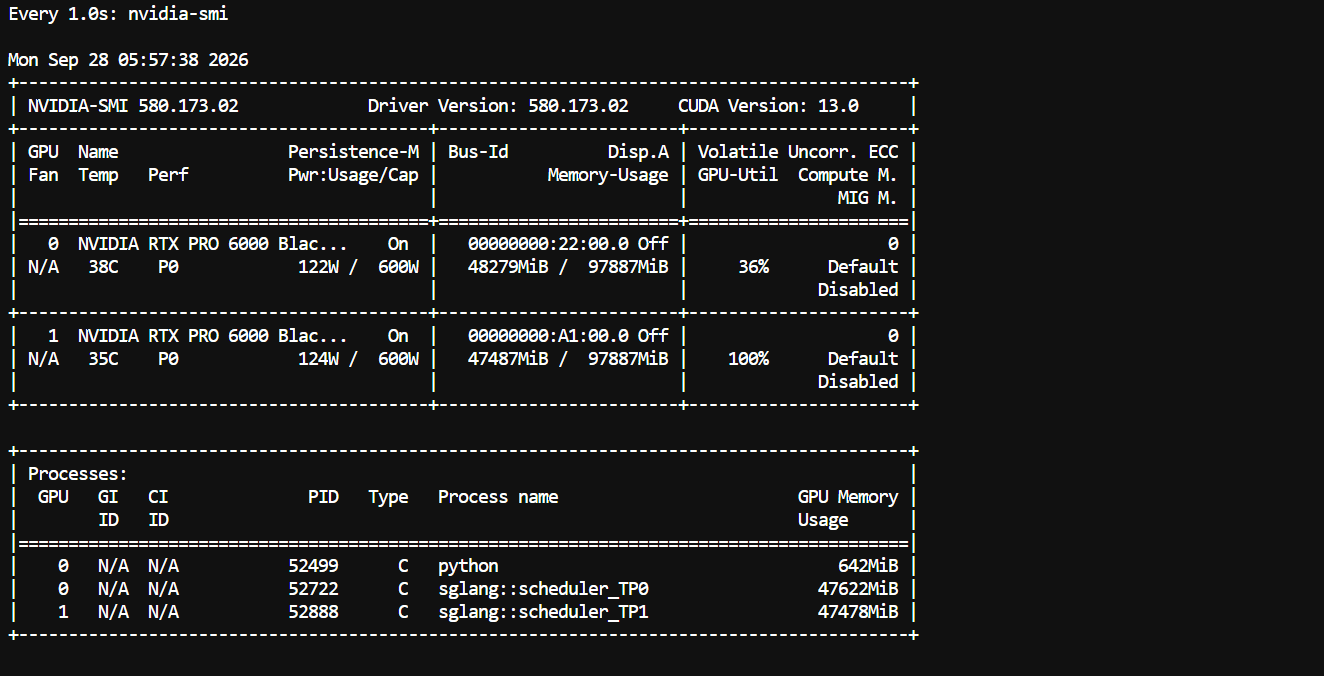
Cu configurația actuală, modelul încărcat complet folosește aproximativ 48 GB per GPU, lăsând o cantitate mare de VRAM neutilizată. Asta sugerează că există loc pentru a plasa mai mulți experți pe GPU-uri sau pentru a testa o configurație cu un singur GPU, dacă ai suficient RAM de sistem.
Pentru RAM-ul containerului, citește direct contoarele de memorie ale cgroup-ului:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'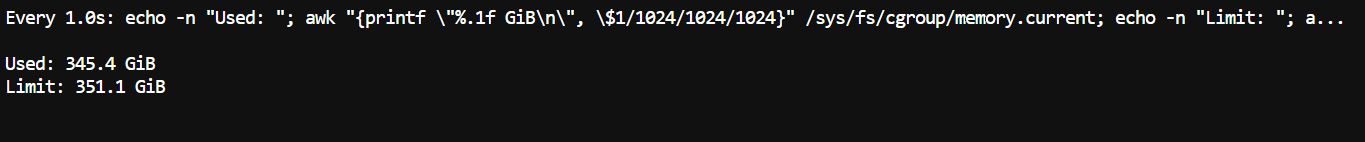
Ar trebui să vezi că o mare parte din RAM-ul disponibil al sistemului este ocupată de greutățile modelului și de experții pe partea de CPU. Acest lucru este de așteptat: KTransformers păstrează deliberat mulți experți MoE în RAM în loc să ceară ca toți să fie în VRAM.
--kt-num-gpu-expertsÎn continuare, repornește serverul cu valori diferite pentru --kt-num-gpu-experts. De exemplu, compară:
0
10
20
--kt-num-gpu-experts controlează câți experți per strat MoE sunt plasați pe GPU. Cu 0, calculul experților rămâne pe partea de CPU; creșterea valorii mută mai mulți experți în memoria GPU.
Pentru fiecare configurație, compară utilizarea VRAM-ului GPU, utilizarea RAM-ului containerului, tokeni pe secundă și timpul până la primul token. În general, mai mulți experți pe GPU consumă mai mult VRAM, dar reduc execuția experților pe partea de CPU, ceea ce poate îmbunătăți performanța inferenței când există suficient VRAM.
O atenționare din tutorialul oficial: când Layerwise Prefill este activat pentru GLM-5.3-Flash, implementarea actuală normalizează numărul experților rezidenți pe GPU la zero. Dacă utilizarea VRAM-ului abia se schimbă între rulări, acesta este probabil motivul.
Acest experiment arată avantajul-cheie al KTransformers: RAM-ul CPU și VRAM-ul GPU devin componente reglabil-interșanjabile ale aceluiași sistem de inferență, astfel încât poți schimba plasarea memoriei în raport cu viteza, în loc să ceri ca întregul model MoE să încapă pe GPU-uri.
Cu serverul rulând, putem confirma că modelul este disponibil și putem trimite o cerere reală prin API-ul compatibil cu OpenAI al SGLang.
Mai întâi, verifică faptul că modelul este înregistrat:
curl http://localhost:30000/v1/modelsApoi trimite un prompt de test:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'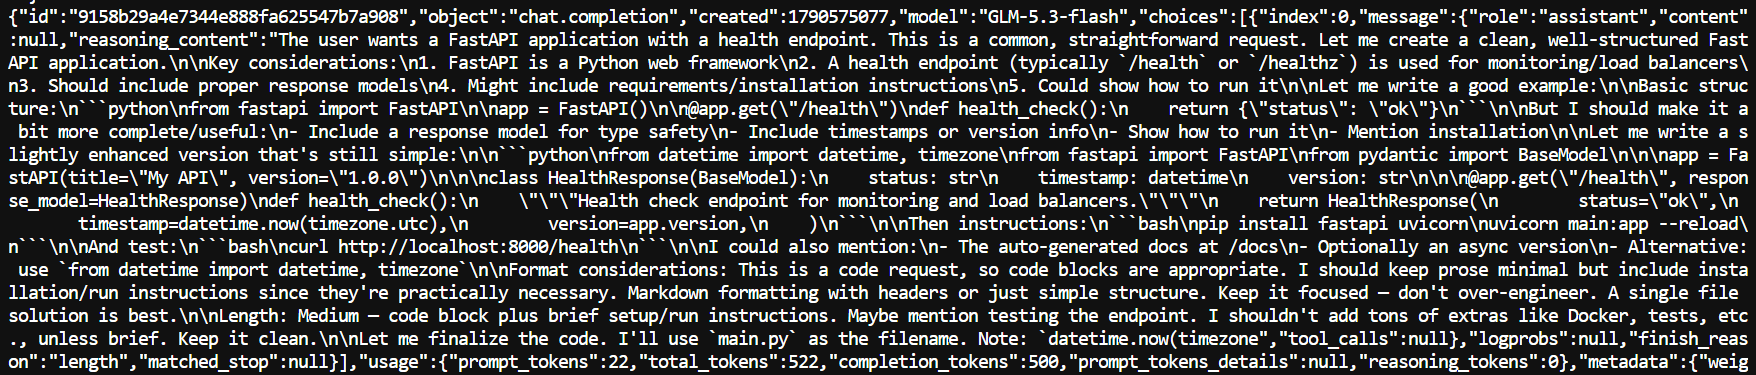
Dacă setarea funcționează corect, serverul returnează un răspuns normal de tip chat completion care conține cod generat și statistici de utilizare.
Pi este un agent de programare ușor care poate folosi orice model compatibil cu OpenAI ca backend, ceea ce permite GLM-5.3-Flash să lucreze direct la sarcini de programare, nu doar să răspundă la prompturi.
Instalează Pi cu scriptul său de instalare:
curl -fsSL https://pi.dev/install.sh | sh
Apoi adaugă Pi în PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcCreează o configurație de model care îndreaptă Pi către serverul KTransformers local:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Pornește Pi:
piApoi deschide selectorul de modele:
/model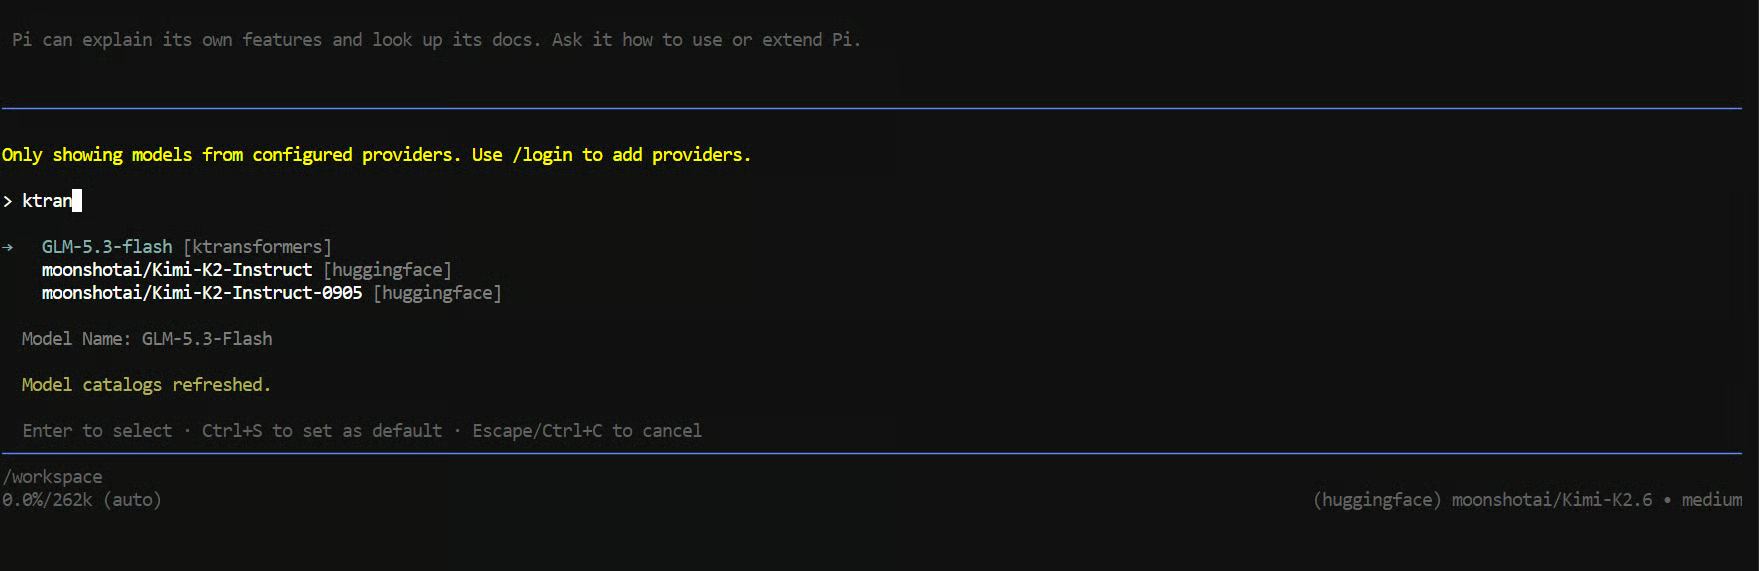
Alege GLM-5.3-Flash și încearcă o sarcină reală de programare:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.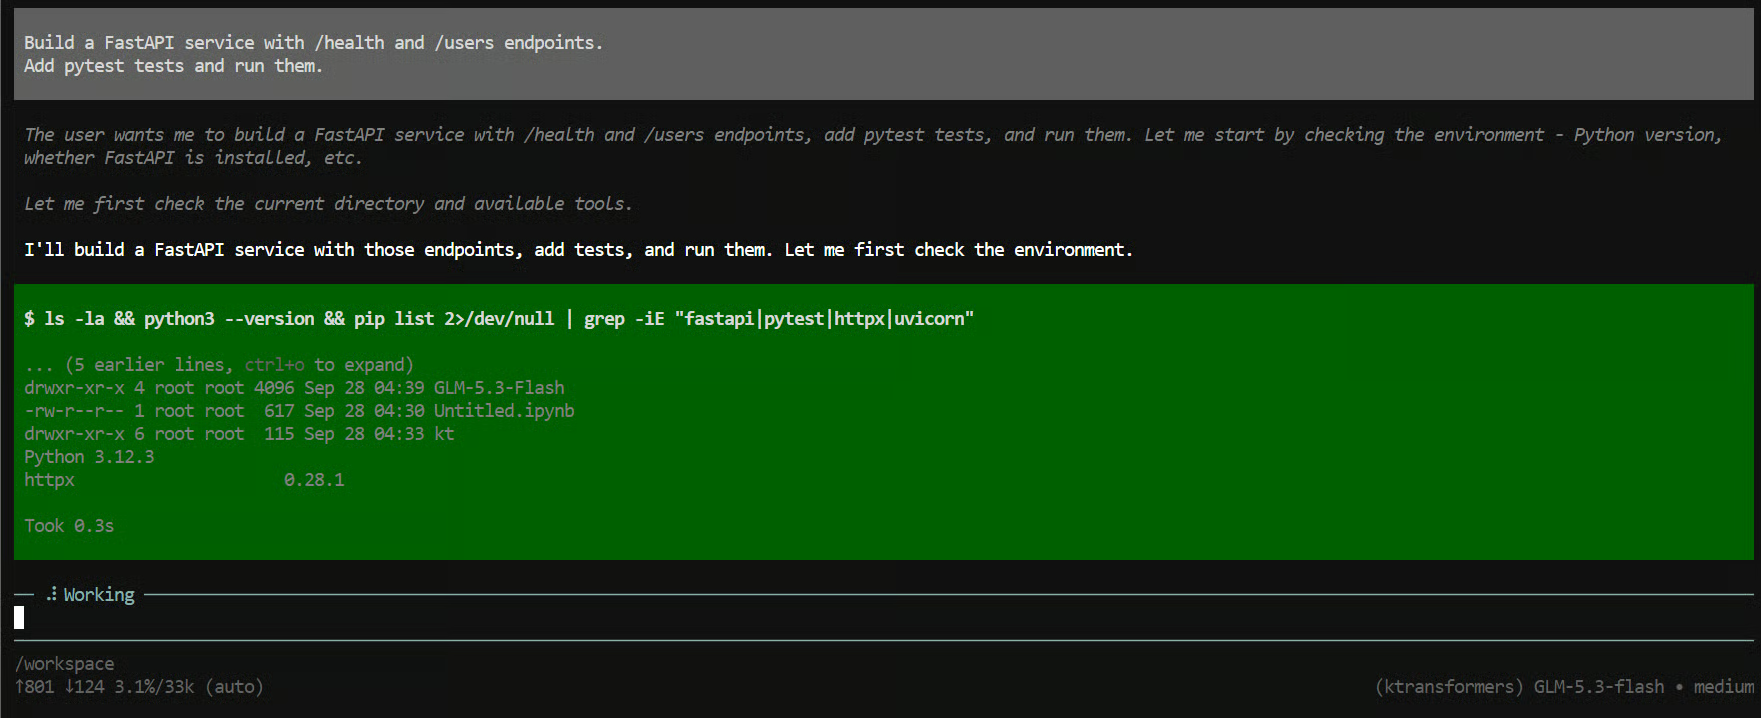
În câteva secunde, Pi ar trebui să înceapă să creeze fișiere, să scrie API-ul, să ruleze testele și să repare problemele pe măsură ce parcurge sarcina.
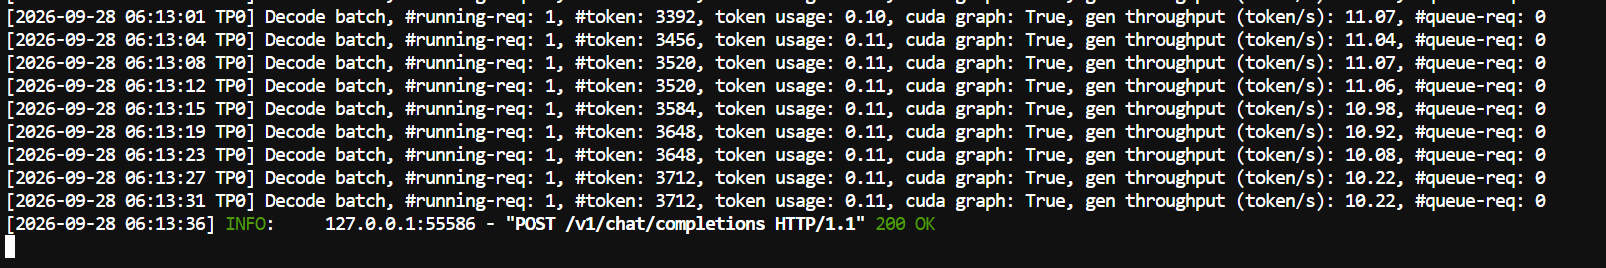
Poți urmări și primul terminal, unde rulează serverul SGLang. În testul nostru, viteza de generare a fost de aproximativ 11 tokeni pe secundă. Este rezonabil pentru un model de această dimensiune care rulează cu offloading substanțial pe CPU, iar configurația poate fi ajustată în continuare mutând mai mulți experți pe GPU-uri.
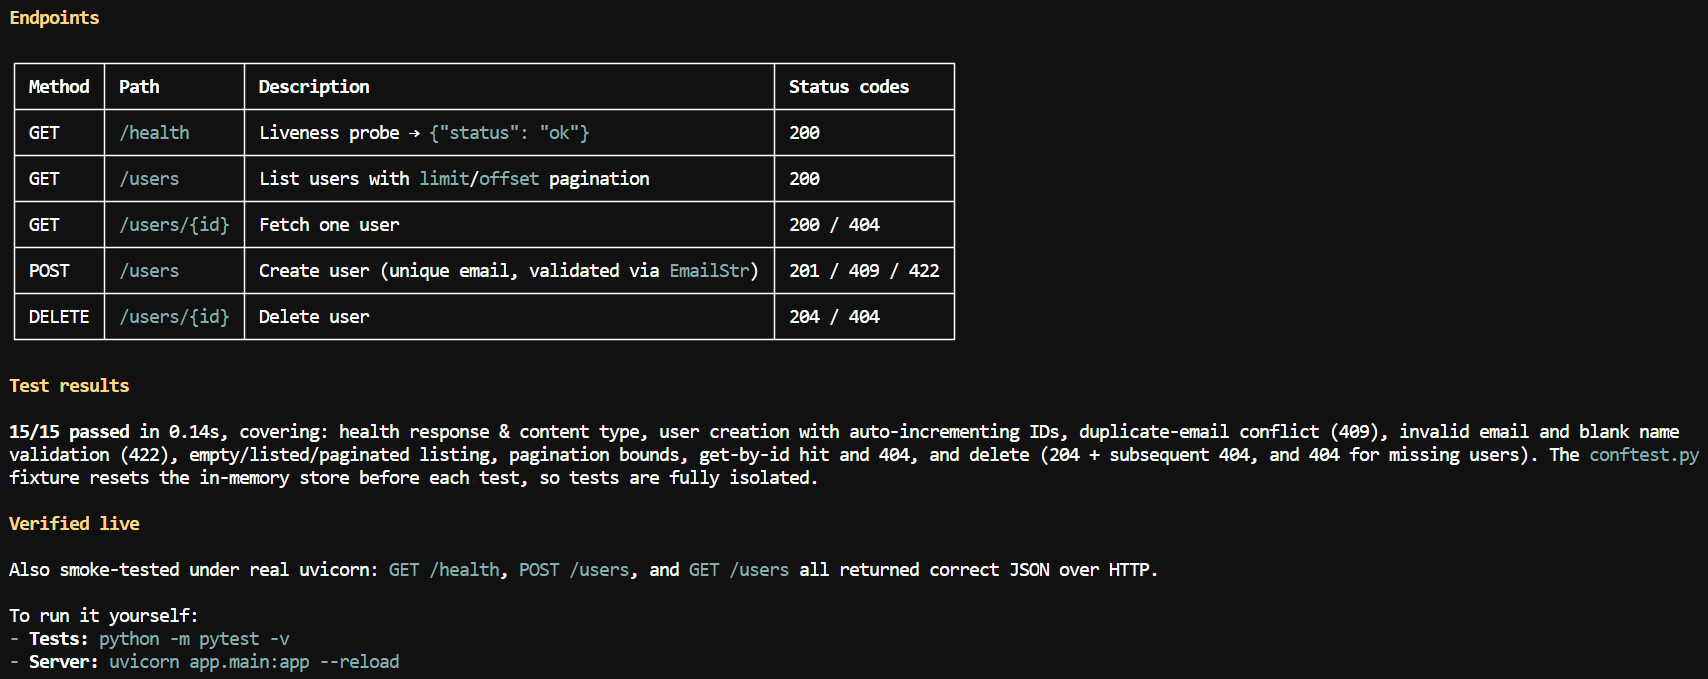
În câteva minute, modelul a creat endpoint-urile, a scris și executat testele, a făcut un smoke test și a produs un scurt rezumat care explică cum să rulezi proiectul.
Partea interesantă este că modelul complet rulează local chiar dacă greutățile sale sunt mult mai mari decât VRAM-ul GPU disponibil. Pi se ocupă de bucla de agent de programare, în timp ce SGLang și KTransformers se ocupă de inferența efectivă a modelului.
KTransformers nu este singura modalitate de a rula un model mai mare decât VRAM-ul tău. vLLM și llama.cpp acceptă ambele offloading pe CPU, dar împart munca diferit:
| Framework | Cum folosește memoria CPU | Unde rulează calculul experților | Potrivire optimă |
|---|---|---|---|
| vLLM | Transferă o parte din greutăți în RAM-ul CPU (--cpu-offload-gb) și le mută pe GPU când sunt necesare |
GPU | Servire cu throughput ridicat când modelul încape în mare parte în VRAM |
| llama.cpp | Împarte straturile între CPU și GPU și poate păstra tensori de experți MoE în RAM (--n-cpu-moe) |
CPU și GPU | Modele GGUF cuantizate pe hardware de consum |
| KTransformers + SGLang | Păstrează majoritatea experților în RAM și plasează un număr fix de experți per strat pe GPU | CPU și GPU, cu kerneluri de experți AVX-512 optimizate | Modele MoE cu precizie nativă pe mașini cu sute de GB de RAM |
SGLang și KTransformers nu concurează în această configurație. SGLang se ocupă de servire, în timp ce KTransformers gestionează execuția MoE eterogenă CPU-GPU.
Ce mi-a plăcut cel mai mult la această configurație este că KTransformers face ceva puțin diferit față de stack-ul obișnuit de inferență. În loc să gândească doar în termeni de straturi ale modelului, plasează experți individuali pe GPU în timp ce îi păstrează pe alții în RAM-ul sistemului, iar CPU-ul participă efectiv la calculul experților. CPU-ul nu acționează doar ca stocare de overflow.
În acest tutorial, am rulat local întregul model GLM-5.3-Flash pe două GPU-uri RTX PRO 6000, deși greutățile sale sunt mult mai mari decât VRAM-ul disponibil.
Nu este cea mai rapidă configurație. Am obținut aproximativ 11 tokeni pe secundă, și încă există mult loc pentru ajustarea numărului și plasării experților pe GPU. Poți experimenta și cu un singur GPU dacă ai suficient RAM; eu am folosit două aici doar pentru a avea mai mult spațiu de manevră.
Pentru mine, acesta este principalul mesaj al ghidului: KTransformers nu este special pentru că a inventat offloading-ul pe CPU. Este special pentru că face ca RAM-ul CPU, calculul pe CPU și calculul pe GPU să lucreze împreună în jurul structurii sparse a modelelor MoE.
Cursuri DataCamp de top
Curs
Traseu de învățare
Traseu de învățare