
Curso
Modelos Transformer com PyTorch
2 h
9.2K
KTransformers é um framework de inferência open source que permite que a CPU e a GPU executem ativamente especialistas diferentes durante a inferência, assim você consegue rodar modelos Mixture-of-Experts (MoE) muito maiores do que a memória da sua GPU. Frameworks como o vLLM também conseguem descarregar pesos para a memória da CPU, mas o KTransformers foi projetado especificamente em torno da estrutura esparsa de modelos MoE.
Neste tutorial, vamos usar KTransformers e SGLang para rodar o GLM-5.3-Flash, um modelo com 320 bilhões de parâmetros cujos pesos não cabem em 192 GB de VRAM. Vamos monitorar o uso de memória da CPU e da GPU, experimentar a alocação de especialistas, testar a API compatível com OpenAI e conectar o modelo ao Pi como um agente local de coding.
A ideia central é simples: em vez de tratar a memória da CPU como um “estouro” de armazenamento, o KTransformers usa tanto o compute da CPU quanto o da GPU durante a inferência.
O KTransformers é um framework de inferência open source para rodar LLMs muito grandes usando uma combinação de VRAM da GPU e RAM da CPU. Normalmente, servir um modelo grande exige carregar a maior parte dos pesos na memória da GPU, o que fica caro muito rápido em um modelo do tamanho do GLM-5.3-Flash.
O KTransformers adota outra estratégia: mantém muitos pesos de especialistas MoE na memória do sistema e reserva a memória da GPU para as partes da inferência que mais se beneficiam da aceleração na GPU.
Isso funciona bem para modelos MoE porque nem todo especialista é usado em todo token. O GLM-5.3-Flash, por exemplo, tem 288 especialistas roteados, mas o roteador seleciona apenas 8 deles (mais 1 especialista compartilhado) para cada token. Assim, o KTransformers pode distribuir a computação dos especialistas entre CPU e GPU:
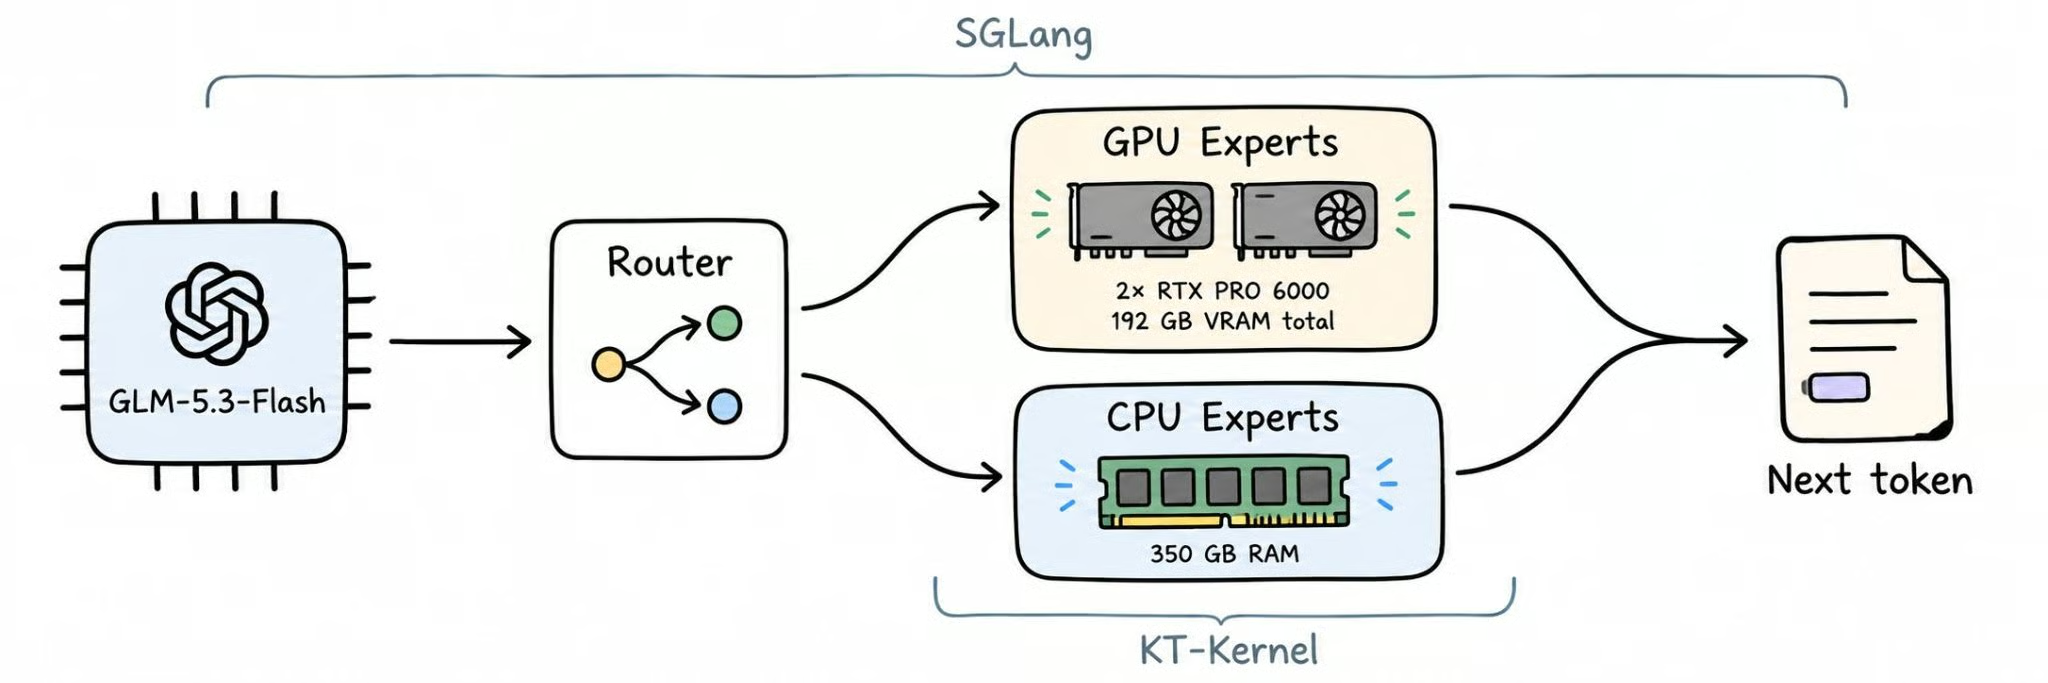
A pilha atual do KTransformers integra o KT-Kernel com o SGLang para inferência heterogênea CPU-GPU. Cada componente cuida de uma parte:
O KTransformers também permite mudar a alocação de especialistas com base nos padrões de workload, como descrito no tutorial de agendamento de especialistas.
Em outras palavras, o KTransformers trata a memória da CPU e a memória da GPU como um sistema de inferência compartilhado, em vez de exigir que o modelo inteiro caiba na VRAM da GPU. É isso que permite rodar modelos MoE enormes em hardware com muito menos memória de GPU do que seria necessário normalmente.
GLM-5.3-Flash é o modelo MoE multimodal nativo e de pesos abertos da Z.ai, lançado sob a licença MIT em agosto de 2026. Apesar do nome “Flash”, é um modelo grande: 320B parâmetros no total, com cerca de 18B ativos por token.
Veja as especificações que importam para inferência local:
zai-org/GLM-5.3-Flash)O KTransformers lê diretamente os pesos oficiais em FP8, então não há conversão nem etapa extra de quantização. Para benchmarks e uma visão geral completa do modelo, veja nosso guia do GLM-5.3-Flash.
Para o GLM-5.3-Flash, a questão de hardware é principalmente sobre a RAM do sistema. O tutorial oficial do KTransformers para GLM-5.3-Flash recomenda reservar pelo menos 350 GB de memória do sistema disponível.
Para este tutorial, usamos uma instância RunPod com aproximadamente:
GPU:         2× RTX PRO 6000
VRAM:        96 GB cada
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11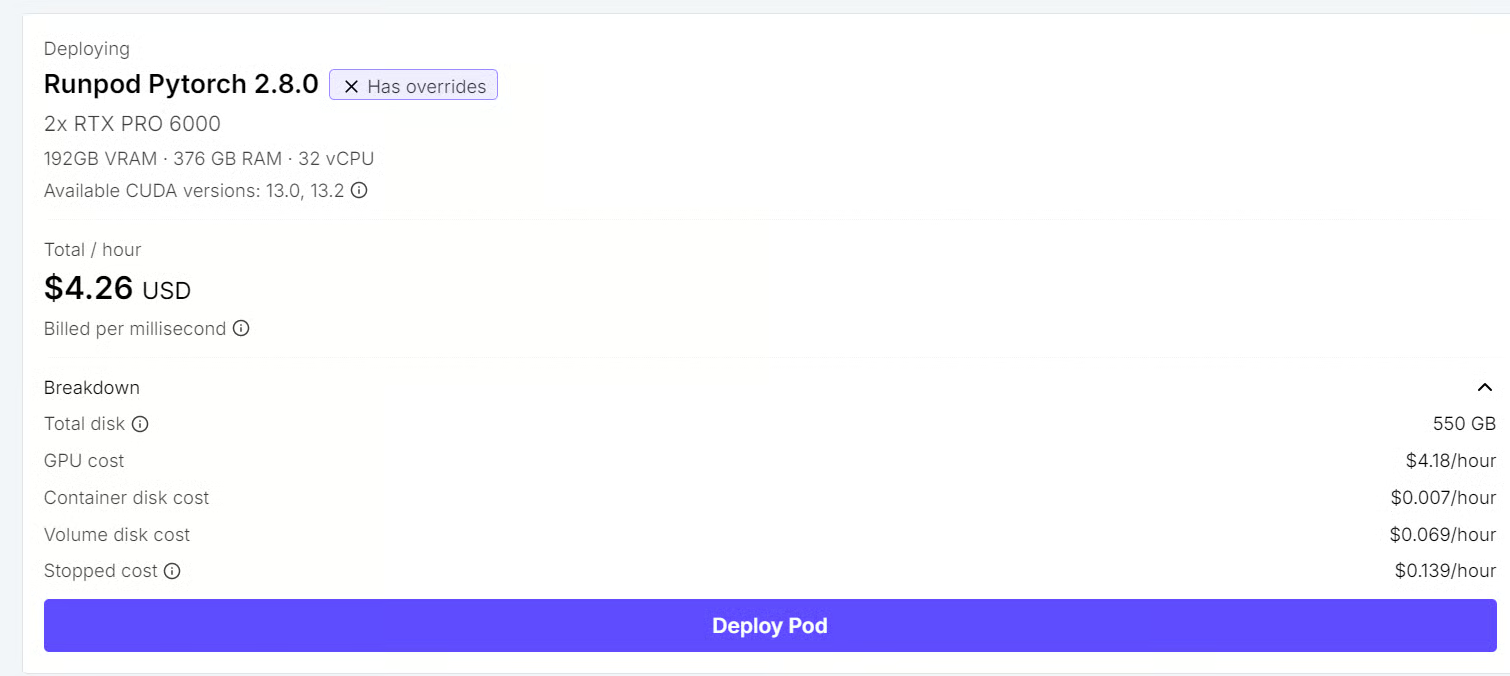
O checkpoint oficial em FP8 do GLM-5.3-Flash tem aproximadamente 306 GiB (cerca de 329 GB), enquanto nossas duas GPUs somam 192 GB de VRAM. Portanto, o modelo completo não pode simplesmente ser carregado inteiramente na memória da GPU.
Em vez disso, o KTransformers mantém uma grande parte dos pesos MoE na RAM do sistema e move a computação mais útil para as GPUs. A recomendação de 350 GB deixa espaço suficiente para os pesos do modelo mais a sobrecarga de runtime.
Mais memória de GPU não elimina a necessidade de RAM nesse setup. A memória da CPU é parte intencional do design de inferência heterogênea do KTransformers: pesos de especialistas permanecem na RAM enquanto a GPU cuida das partes do modelo que mais se beneficiam da aceleração.
A implementação atual do GLM-5.3-Flash também tem requisitos específicos de CPU e GPU:
Sim, desde que você tenha RAM de sistema suficiente e uma CPU compatível. O tutorial oficial inclui uma configuração de uma única GPU com --kt-num-gpu-experts 0, então os especialistas MoE ficam do lado da CPU.
Aqui usamos duas RTX PRO 6000, mas isso não é um requisito mínimo rígido. A segunda GPU nos dá mais VRAM e folga extra ao experimentar uma implementação relativamente nova do KTransformers, em vez de ajustar o setup ao hardware mínimo que consegue rodar o modelo.
Crie um ambiente limpo de Python 3.11 e instale o KTransformers com suporte ao SGLang:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Verifique se KTransformers, KT-Kernel, SGLang e CUDA foram detectados corretamente:
kt versionVocê deve ver algo como:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Isso confirma que o runtime do KTransformers e seu backend SGLang estão instalados e prontos para uso.
Antes de iniciar o servidor, baixe o checkpoint oficial do GLM-5.3-Flash no Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
O checkpoint tem cerca de 306 GiB, então o download pode demorar dependendo da sua banda.
Depois, aponte o KTransformers para o caminho local do modelo:
export MODEL_PATH=/workspace/GLM-5.3-FlashAgora inicie o GLM-5.3-Flash com paralelismo de tensor em duas vias, usando as duas GPUs RTX PRO 6000. O modelo suporta até 1M de tokens de contexto, e os exemplos oficiais usam uma configuração validada de 501.025 tokens. Vamos começar com uma janela de contexto de 32K para manter o uso de memória previsível enquanto testamos o setup.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45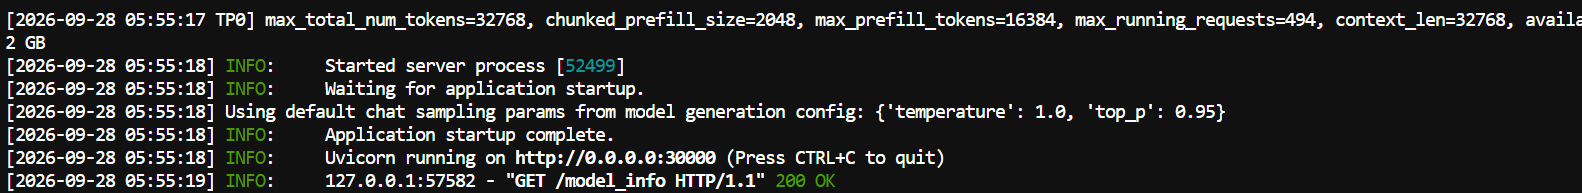
Essa configuração expõe o modelo por meio de um servidor SGLang compatível com a API da OpenAI na porta 30000. As duas GPUs são usadas com --tp-size 2, enquanto o KTransformers mantém parte da carga MoE na CPU e coloca especialistas selecionados nas GPUs.
As opções aqui são propositalmente conservadoras para a primeira execução: contexto de 32K, 85% de uso estático da memória da GPU, 14 especialistas na GPU e 64 threads de inferência na CPU. Depois que o servidor estiver estável, você pode experimentar uma janela de contexto maior, mais especialistas na GPU ou configurações de memória diferentes para melhorar o throughput.
A maioria das flags acima são opções padrão do SGLang. Estas são as que controlam como o KTransformers divide o trabalho entre CPU e GPU:
| Flag | Valor | O que faz |
|---|---|---|
--kt-method |
FP8 |
Define a precisão dos pesos dos especialistas, alinhando com o checkpoint nativo em FP8 do GLM-5.3-Flash. |
--kt-cpuinfer |
64 |
Número de threads de CPU usados para a computação dos especialistas. |
--kt-threadpool-count |
2 |
Número de pools de threads na CPU, geralmente correspondente à quantidade de nós NUMA. |
--kt-num-gpu-experts |
14 |
Número de especialistas por camada MoE alocados na GPU. |
--kt-expert-placement-strategy |
uniform |
Como os especialistas na GPU são escolhidos. Outras opções incluem frequency, front-loading e random. |
--kt-gpu-prefill-token-threshold |
2048 |
Tamanho do prompt a partir do qual o prefill muda para o caminho por camada do lado da GPU. |
Agora que o servidor está rodando, podemos verificar como o KTransformers está usando a VRAM da GPU e a RAM do sistema, e então mudar a quantidade de especialistas residentes na GPU para ver como o uso de recursos e o desempenho variam.
No RunPod, o free -h pode ser enganoso porque um container pode enxergar a RAM total da máquina host em vez de apenas a memória disponível para o pod. É melhor monitorar a memória da GPU e a memória do container separadamente.
Abra um novo terminal e monitore o uso da GPU:
watch -n 1 nvidia-smi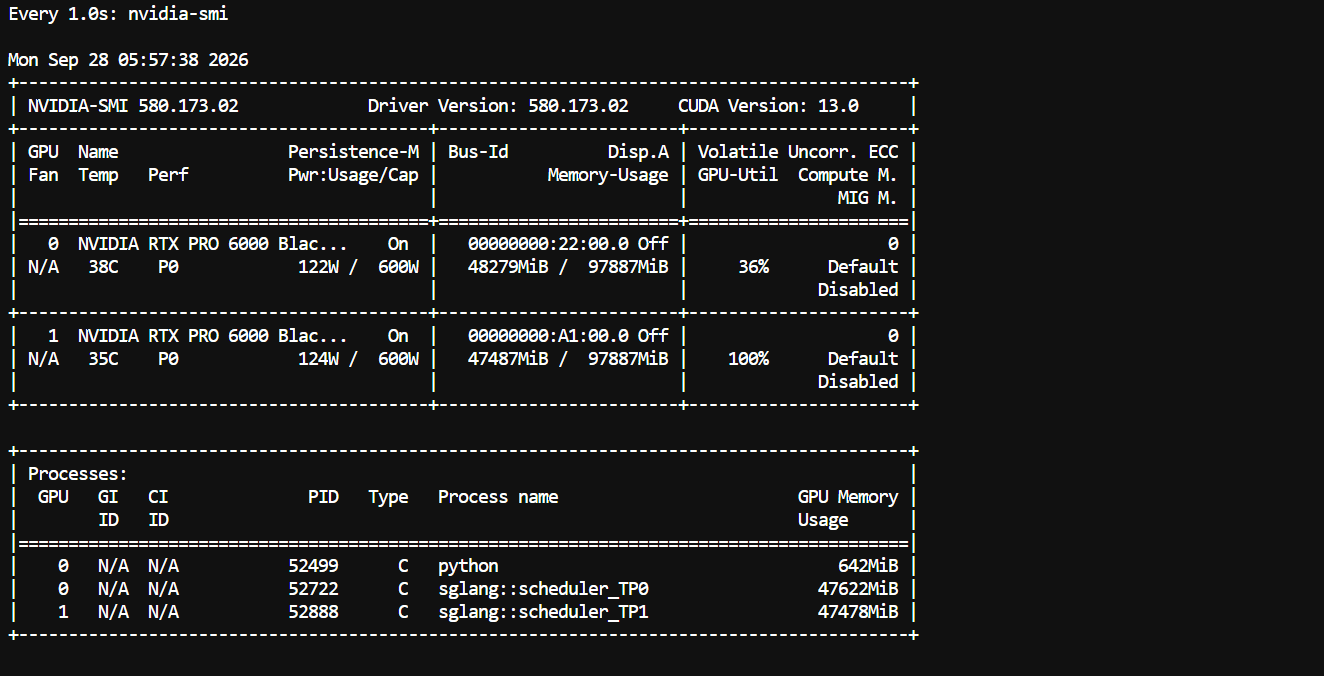
Com a configuração atual, o modelo totalmente carregado usa cerca de 48 GB por GPU, deixando bastante VRAM livre. Isso sugere que há espaço para colocar mais especialistas nas GPUs ou testar uma configuração com uma única GPU, desde que haja RAM suficiente.
Para a RAM do container, leia diretamente os contadores de memória do cgroup:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'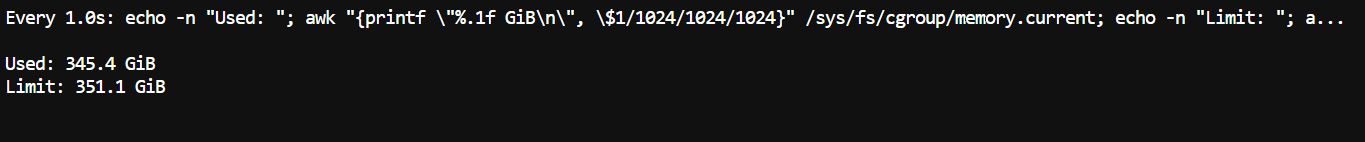
Você deve notar que uma grande parte da RAM disponível está ocupada pelos pesos do modelo e pelos especialistas do lado da CPU. Isso é esperado: o KTransformers deliberadamente mantém muitos especialistas MoE na RAM em vez de exigir que todos fiquem na VRAM.
--kt-num-gpu-expertsEm seguida, reinicie o servidor com valores diferentes para --kt-num-gpu-experts. Por exemplo, compare:
0
10
20
O --kt-num-gpu-experts controla quantos especialistas por camada MoE são alocados na GPU. Com 0, a computação dos especialistas fica no lado da CPU; ao aumentar o valor, mais especialistas vão para a memória da GPU.
Para cada configuração, compare uso de VRAM da GPU, uso de RAM do container, tokens por segundo e tempo até o primeiro token. Em geral, mais especialistas na GPU consomem mais VRAM, mas reduzem a execução de especialistas na CPU, o que pode melhorar a performance de inferência quando há VRAM suficiente.
Um cuidado do tutorial oficial: quando o Layerwise Prefill está habilitado para o GLM-5.3-Flash, a implementação atual normaliza a contagem de especialistas residentes na GPU para zero. Se o uso de VRAM quase não mudar entre execuções, provavelmente é por isso.
Este experimento mostra a principal vantagem do KTransformers: a RAM da CPU e a VRAM da GPU viram partes ajustáveis do mesmo sistema de inferência, então você pode trocar alocação de memória por velocidade, em vez de exigir que o modelo MoE inteiro caiba nas GPUs.
Com o servidor rodando, podemos confirmar que o modelo está disponível e enviar uma requisição real pela API compatível com OpenAI do SGLang.
Primeiro, verifique se o modelo está registrado:
curl http://localhost:30000/v1/modelsDepois, envie um prompt de teste:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'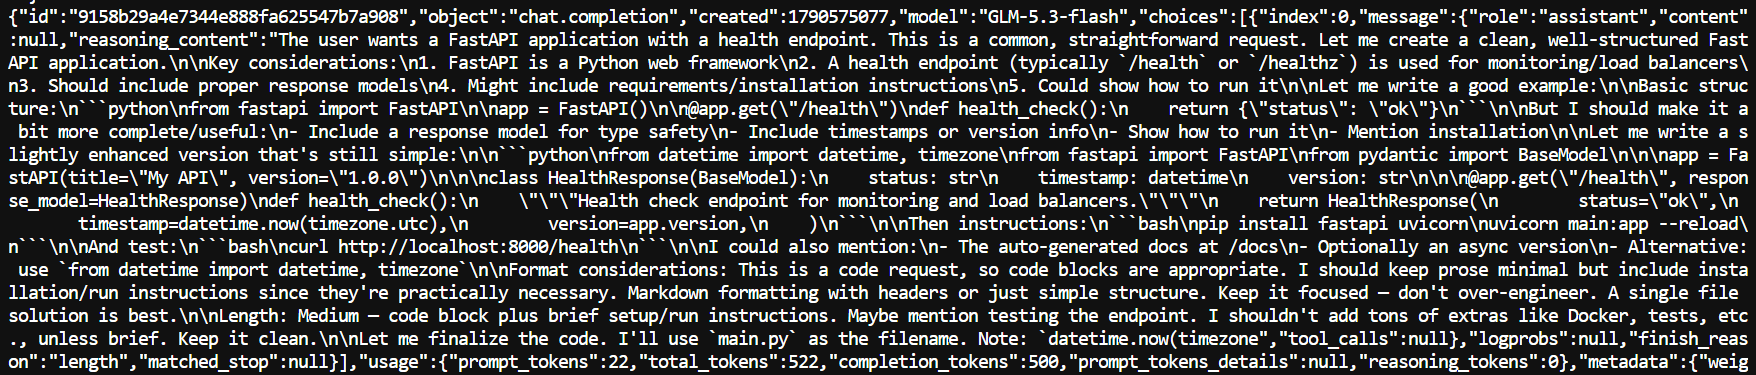
Se o setup estiver correto, o servidor retorna uma resposta normal de chat completion com código gerado e estatísticas de uso.
O Pi é um agente de coding leve que pode usar qualquer modelo compatível com a API da OpenAI como backend, o que permite que o GLM-5.3-Flash trabalhe diretamente em tarefas de coding, e não apenas responda prompts.
Instale o Pi com o script de instalação:
curl -fsSL https://pi.dev/install.sh | sh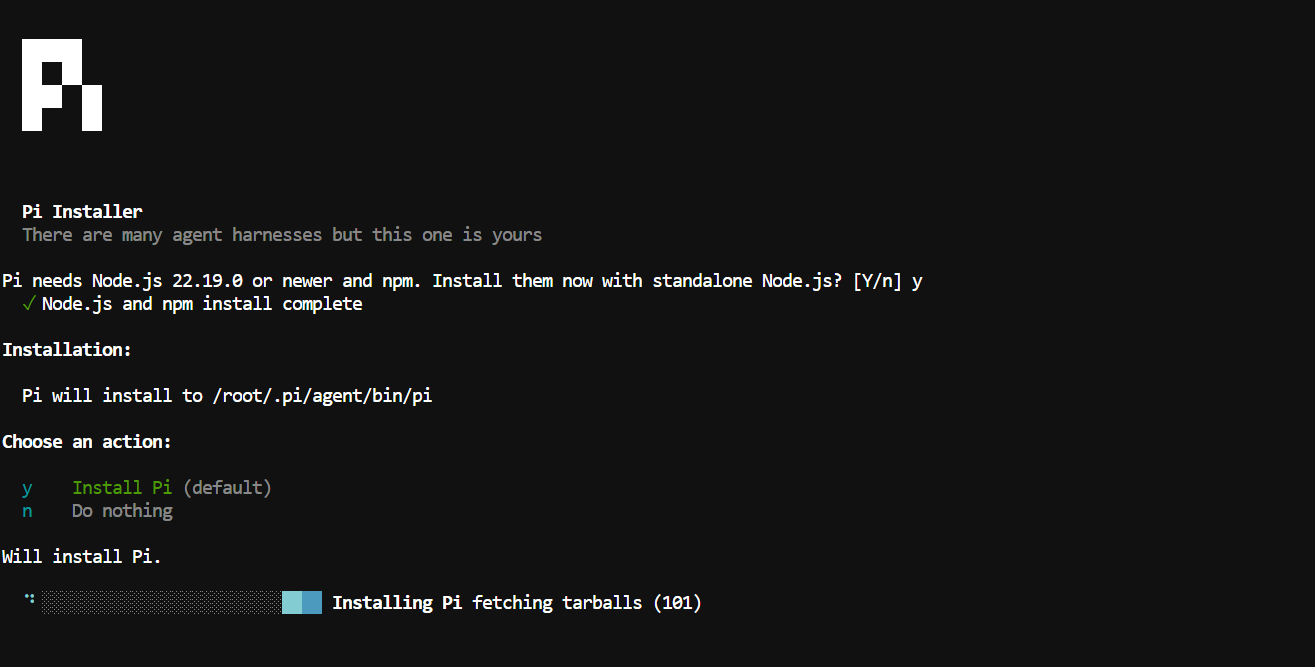
Depois, adicione o Pi ao seu PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcCrie uma configuração de modelo que aponte o Pi para o servidor local do KTransformers:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Inicie o Pi:
piDepois abra o seletor de modelos:
/model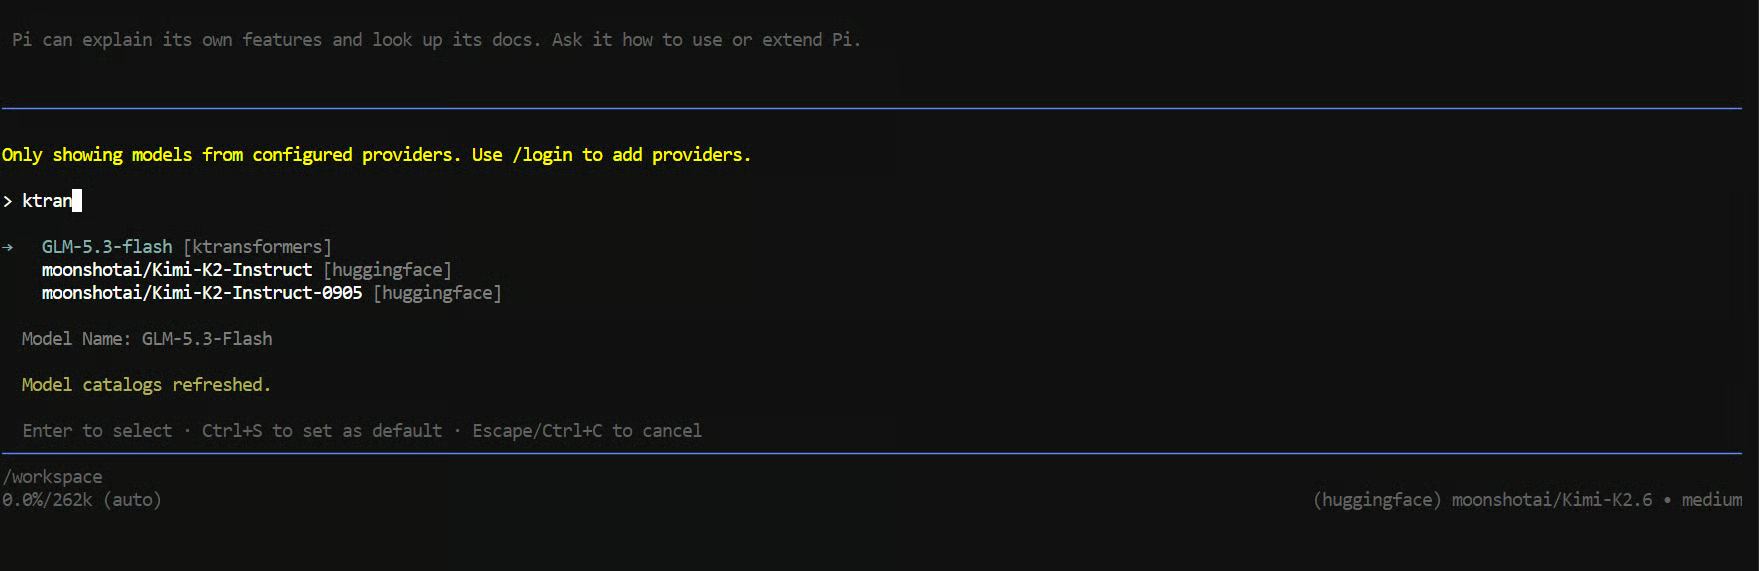
Escolha o GLM-5.3-Flash e tente uma tarefa real de coding:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.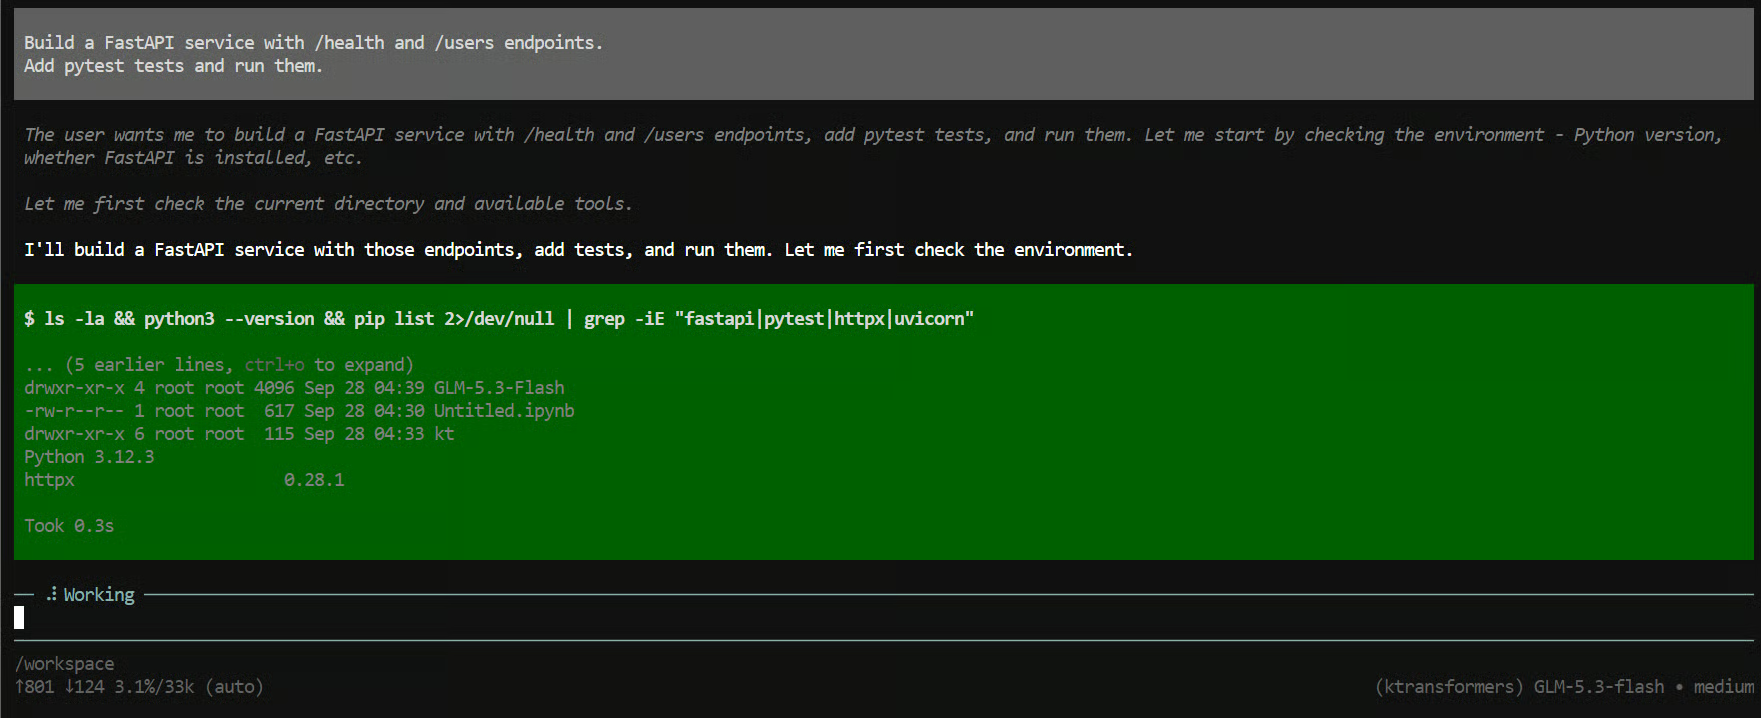
Em poucos segundos, o Pi deve começar a criar arquivos, escrever a API, rodar testes e corrigir problemas enquanto executa a tarefa.
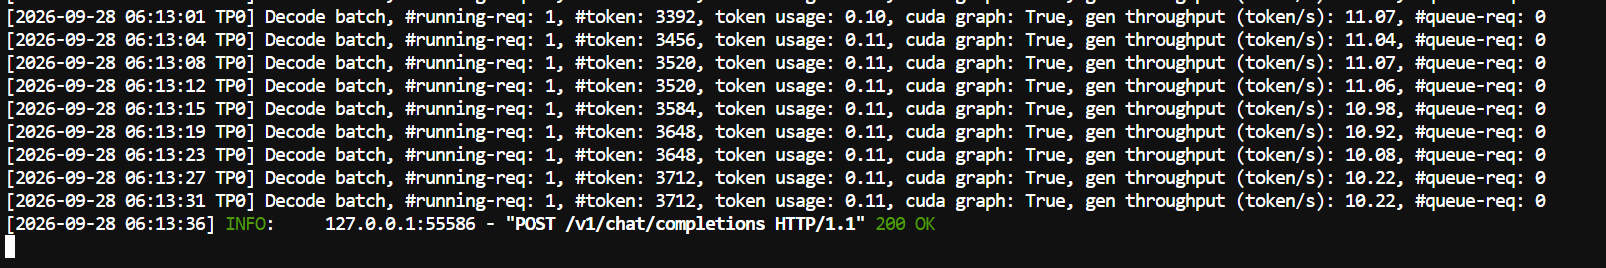
Você também pode acompanhar o primeiro terminal, onde o servidor SGLang está rodando. No nosso teste, a velocidade de geração ficou em torno de 11 tokens por segundo. Isso é razoável para um modelo desse porte com bastante offloading para a CPU, e o setup ainda pode ser ajustado movendo mais especialistas para as GPUs.
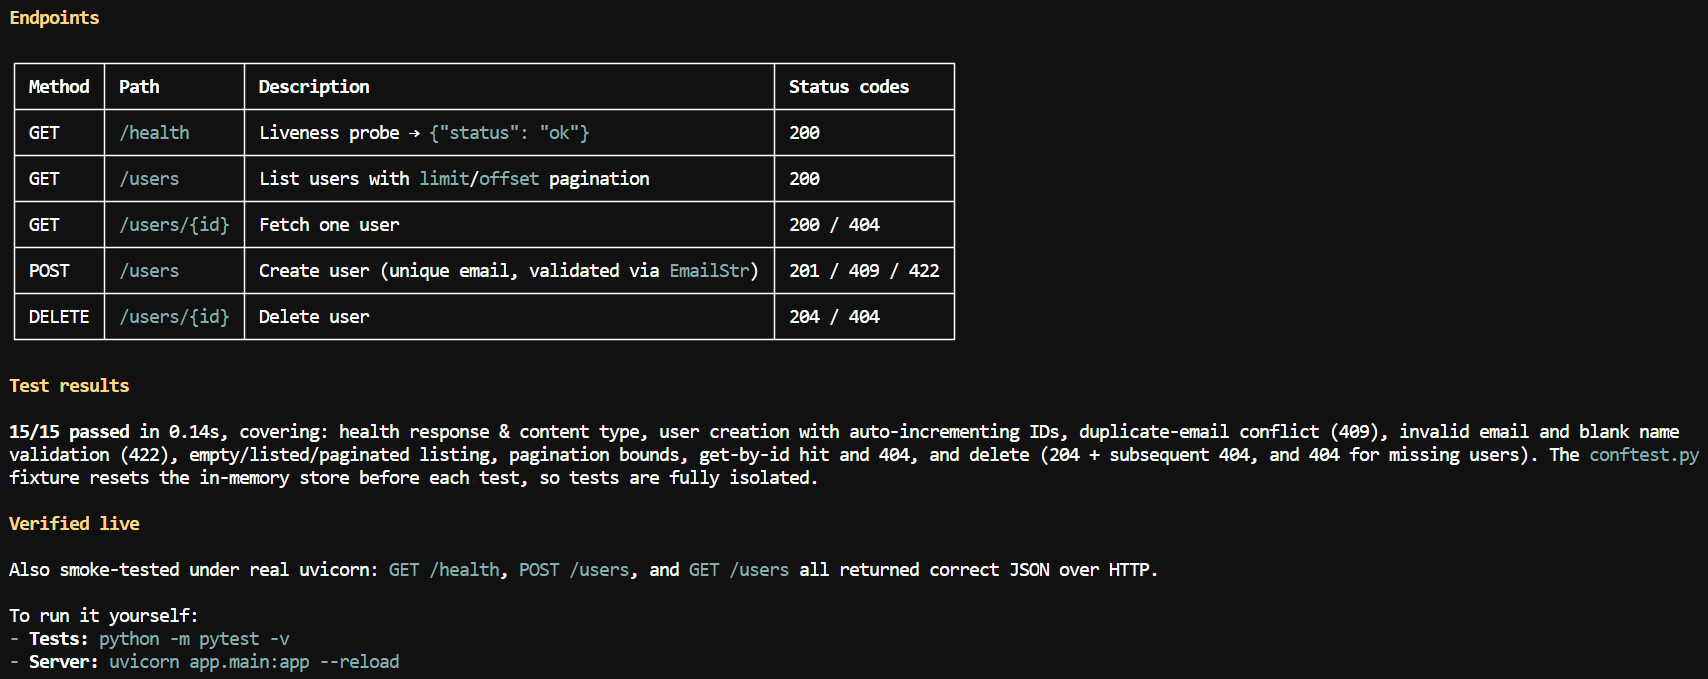
Em poucos minutos, o modelo criou os endpoints, escreveu e executou os testes, fez um smoke test e gerou um breve resumo explicando como rodar o projeto.
O interessante é que o modelo completo está rodando localmente mesmo com pesos muito maiores do que a VRAM disponível. O Pi cuida do loop de agente de coding, enquanto o SGLang e o KTransformers cuidam da inferência do modelo.
O KTransformers não é a única forma de rodar um modelo maior que a sua VRAM. vLLM e llama.cpp também suportam offloading para CPU, mas dividem o trabalho de forma diferente:
| Framework | Como usa a memória da CPU | Onde roda a computação de especialistas | Melhor encaixe |
|---|---|---|---|
| vLLM | Descarrega parte dos pesos para a RAM da CPU (--cpu-offload-gb) e transfere para a GPU quando necessário |
GPU | Serving de alto throughput quando o modelo quase cabe na VRAM |
| llama.cpp | Divide camadas entre CPU e GPU e pode manter tensores de especialistas MoE na RAM (--n-cpu-moe) |
CPU e GPU | Modelos GGUF quantizados em hardware de consumo |
| KTransformers + SGLang | Mantém a maioria dos especialistas na RAM e coloca um número definido de especialistas por camada na GPU | CPU e GPU, com kernels de especialistas AVX-512 otimizados | Modelos MoE em precisão nativa em máquinas com centenas de GB de RAM |
Nesse setup, SGLang e KTransformers não competem. O SGLang cuida do serving, enquanto o KTransformers cuida da execução MoE heterogênea CPU-GPU.
O que eu mais gostei nesse setup é que o KTransformers faz algo um pouco diferente do stack de inferência tradicional. Em vez de pensar apenas em camadas do modelo, ele coloca especialistas individuais na GPU enquanto mantém outros na RAM do sistema, e a CPU realmente participa da computação dos especialistas. A CPU não atua apenas como armazenamento de overflow.
Neste tutorial, rodamos localmente o modelo completo GLM-5.3-Flash em duas RTX PRO 6000, mesmo com pesos bem maiores do que a VRAM disponível.
Não é o setup mais rápido. Eu estava obtendo cerca de 11 tokens por segundo, e ainda há bastante espaço para ajustar a quantidade e a alocação de especialistas na GPU. Você também pode experimentar com uma única GPU se tiver RAM suficiente; usei duas aqui para ter mais folga.
Para mim, esse é o principal insight deste guia: o KTransformers não é especial por ter inventado o offloading para CPU. Ele é especial porque faz a RAM da CPU, o compute da CPU e o compute da GPU trabalharem juntos em torno da estrutura esparsa dos modelos MoE.
Principais cursos da DataCamp
Curso
Programa
Programa