Curso
Modelos Transformer con PyTorch
2 h
9.2K
KTransformers es un framework de inferencia open source que permite que la CPU y la GPU ejecuten expertos distintos de forma activa durante la inferencia, de modo que puedas ejecutar modelos Mixture-of-Experts (MoE) mucho más grandes que la memoria de tu GPU. Frameworks como vLLM también pueden descargar pesos a la memoria de la CPU, pero KTransformers está diseñado específicamente en torno a la estructura dispersa de los modelos MoE.
En este tutorial, usaremos KTransformers y SGLang para ejecutar GLM-5.3-Flash, un modelo de 320B parámetros cuyos pesos no caben en 192 GB de VRAM. Vigilaremos el uso de memoria de CPU y GPU, probaremos la colocación de expertos, testaremos la API compatible con OpenAI y conectaremos el modelo con Pi como agente local de programación.
La idea principal es sencilla: en lugar de tratar la memoria de la CPU como almacenamiento de desbordamiento, KTransformers usa tanto el cálculo en CPU como en GPU durante la inferencia.
KTransformers es un framework de inferencia open source para ejecutar modelos de lenguaje muy grandes combinando VRAM de GPU y RAM de CPU. Normalmente, servir un modelo grande exige cargar la mayoría de sus pesos en la memoria de la GPU, lo que se encarece rápidamente con un modelo del tamaño de GLM-5.3-Flash.
KTransformers adopta otro enfoque: mantiene muchos pesos de expertos MoE en la memoria del sistema y reserva la memoria de la GPU para las partes de la inferencia que más se benefician de la aceleración por GPU.
Esto encaja bien con los modelos MoE porque no todos los expertos se usan en cada token. GLM-5.3-Flash, por ejemplo, tiene 288 expertos enrutados, pero su router selecciona solo 8 de ellos (más 1 experto compartido) para cada token. Por tanto, KTransformers puede distribuir el cálculo de expertos entre la CPU y la GPU:
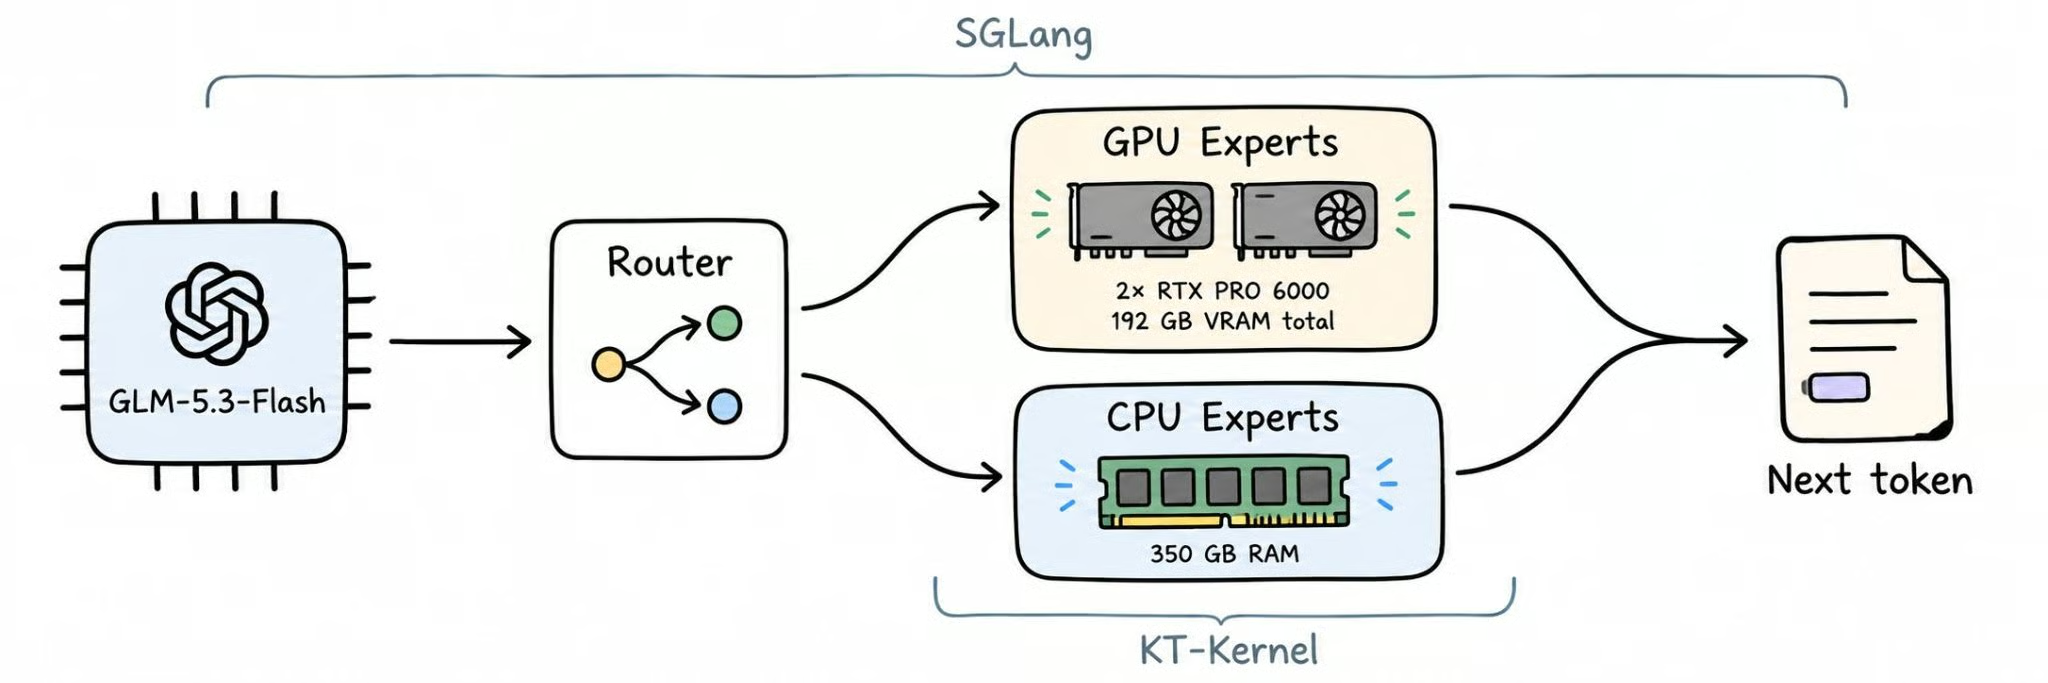
La pila actual de KTransformers integra KT-Kernel con SGLang para la inferencia heterogénea CPU-GPU. Cada componente se encarga de una parte distinta:
KTransformers también permite cambiar la colocación de expertos según los patrones de carga, como se describe en su tutorial de planificación de expertos.
En otras palabras, KTransformers trata la memoria de CPU y la memoria de GPU como un sistema de inferencia compartido en lugar de exigir que todo el modelo quepa en la VRAM de la GPU. Eso es lo que permite ejecutar modelos MoE muy grandes en hardware con mucha menos memoria de GPU de la que normalmente necesitarían.
GLM-5.3-Flash es el modelo MoE multimodal nativo y de pesos abiertos de Z.ai, publicado bajo licencia MIT en agosto de 2026. A pesar del nombre "Flash", es un modelo grande: 320B parámetros en total, con unos 18B activos por token.
Estas son las especificaciones que importan para la inferencia en local:
zai-org/GLM-5.3-Flash)KTransformers lee directamente los pesos oficiales en FP8, así que no hay paso de conversión ni cuantización adicional. Para benchmarks y una descripción completa del modelo, consulta nuestra guía de GLM-5.3-Flash.
Para GLM-5.3-Flash, la cuestión de hardware se centra sobre todo en la RAM del sistema. El tutorial oficial de KTransformers para GLM-5.3-Flash recomienda reservar al menos 350 GB de memoria del sistema disponible.
Para este tutorial, usamos una instancia de RunPod con aproximadamente:
GPU:         2× RTX PRO 6000
VRAM:        96 GB cada una
Total VRAM:  192 GB

System RAM:  350 GB+
Storage:     500 GB+
Python:      3.11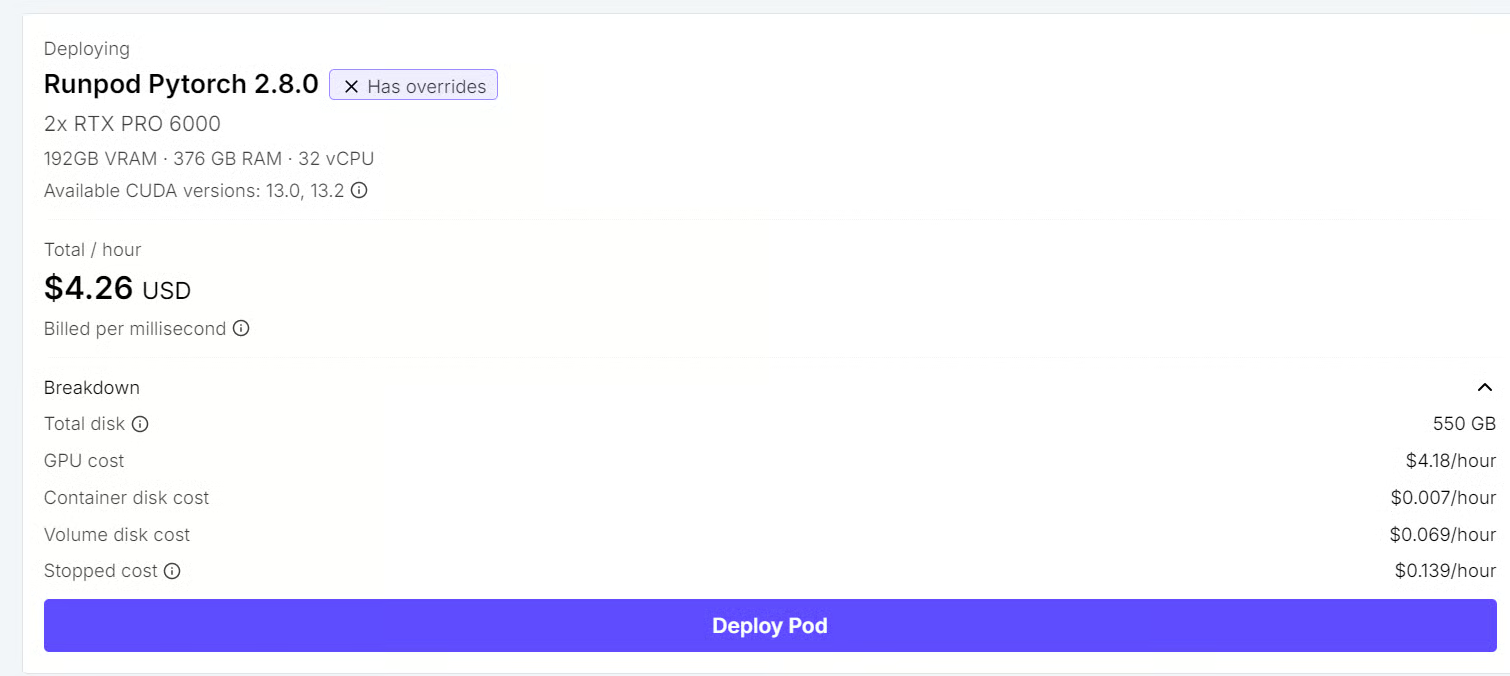
El checkpoint oficial en FP8 de GLM-5.3-Flash ocupa aproximadamente 306 GiB (unos 329 GB), mientras que nuestras dos GPUs aportan 192 GB de VRAM en total. Por tanto, el modelo completo no puede cargarse simplemente en la memoria de la GPU.
En su lugar, KTransformers mantiene una gran parte de los pesos MoE en la RAM del sistema y mueve el cómputo más útil a las GPUs. La recomendación de 350 GB deja margen suficiente para los pesos del modelo y la sobrecarga de ejecución.
Disponer de más memoria de GPU no elimina la necesidad de RAM en esta configuración. La memoria de la CPU forma parte intencional del diseño de inferencia heterogénea de KTransformers: los pesos de expertos permanecen en RAM mientras la GPU se ocupa de las partes del modelo que más se benefician de la aceleración.
La implementación actual de GLM-5.3-Flash también tiene requisitos específicos para CPU y GPU:
Sí, siempre que cuentes con suficiente RAM del sistema y una CPU compatible. El tutorial oficial incluye una configuración de una sola GPU que establece --kt-num-gpu-experts 0, por lo que los expertos MoE se gestionan en la CPU.
Aquí usamos dos RTX PRO 6000, pero no es un requisito mínimo estricto. La segunda GPU nos da más VRAM y margen adicional mientras experimentamos con una implementación de KTransformers relativamente nueva, en lugar de ajustar la configuración al mínimo hardware posible que pueda ejecutar el modelo.
Crea un entorno limpio de Python 3.11 e instala KTransformers con soporte para SGLang:
python3.11 -m venv /workspace/kt
source /workspace/kt/bin/activate

pip install --upgrade pip
pip install "ktransformers[sglang]"
Comprueba que KTransformers, KT-Kernel, SGLang y CUDA se detectan correctamente:
kt versionDeberías ver una salida similar a:
KTransformers CLI v0.7.0.post4

Python      3.11.13
Platform    Linux 6.8.0-136-generic
CUDA        13.0

Packages:
kt-kernel   0.7.0.post4
sglang-kt   0.7.0.post4
Esto confirma que el runtime de KTransformers y su backend SGLang están instalados y listos para usar.
Antes de iniciar el servidor, descarga el checkpoint oficial de GLM-5.3-Flash desde Hugging Face:
hf download zai-org/GLM-5.3-Flash \
  --local-dir /workspace/GLM-5.3-Flash
El checkpoint ronda los 306 GiB, así que la descarga puede llevar tiempo según tu ancho de banda.
Después, indica a KTransformers la ruta local del modelo:
export MODEL_PATH=/workspace/GLM-5.3-FlashAhora lanza GLM-5.3-Flash con paralelismo tensorial en dos vías, usando ambas RTX PRO 6000. El modelo admite hasta 1M tokens de contexto, y los ejemplos oficiales usan una configuración validada de 501.025 tokens. Empezamos con una ventana de contexto de 32K para mantener un uso de memoria predecible mientras probamos la configuración.
CUDA_VISIBLE_DEVICES=0,1 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --kt-weight-path "$MODEL_PATH" \
  --served-model-name GLM-5.3-flash \
  --host 0.0.0.0 \
  --port 30000 \
  --tp-size 2 \
  --context-length 32768 \
  --max-total-tokens 32768 \
  --mem-fraction-static 0.85 \
  --chunked-prefill-size 2048 \
  --kt-method FP8 \
  --kt-cpuinfer 64 \
  --kt-threadpool-count 2 \
  --kt-num-gpu-experts 14 \
  --kt-gpu-prefill-token-threshold 2048 \
  --kt-expert-placement-strategy uniform \
  --cuda-graph-bs 1 2 4 \
  --enable-p2p-check \
  --tool-call-parser glm47 \
  --reasoning-parser glm45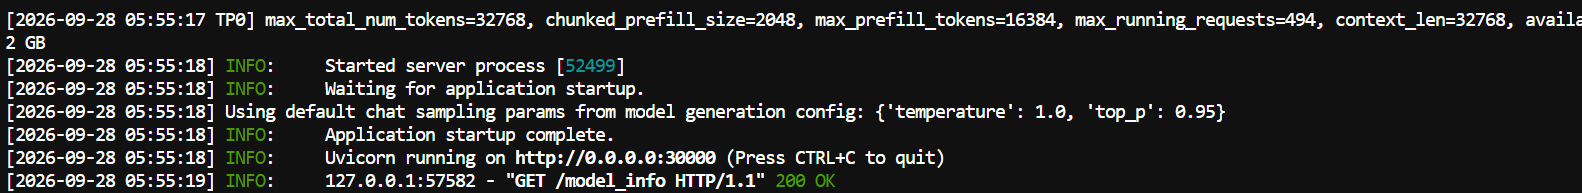
Esta configuración expone el modelo a través de un servidor SGLang compatible con OpenAI en el puerto 30000. Las dos GPUs se usan con --tp-size 2, mientras KTransformers mantiene parte de la carga MoE en la CPU y coloca expertos seleccionados en las GPUs.
Los ajustes aquí son deliberadamente conservadores para la primera ejecución: contexto de 32K, 85% de uso estático de memoria de GPU, 14 expertos en GPU y 64 hilos de inferencia en CPU. Una vez que el servidor esté estable, puedes probar una ventana de contexto mayor, más expertos en GPU u otros ajustes de memoria para mejorar el rendimiento.
La mayoría de flags anteriores son opciones estándar de SGLang. Estos son los que controlan cómo KTransformers reparte el trabajo entre CPU y GPU:
| Flag | Valor | Qué hace |
|---|---|---|
--kt-method |
FP8 |
Define la precisión de los pesos de expertos, alineada con el checkpoint nativo en FP8 de GLM-5.3-Flash. |
--kt-cpuinfer |
64 |
Número de hilos de CPU usados para el cálculo de expertos. |
--kt-threadpool-count |
2 |
Número de pools de hilos en CPU, normalmente alineado con el número de nodos NUMA. |
--kt-num-gpu-experts |
14 |
Número de expertos por capa MoE que se colocan en la GPU. |
--kt-expert-placement-strategy |
uniform |
Cómo se eligen los expertos en GPU. Otras opciones incluyen frequency, front-loading y random. |
--kt-gpu-prefill-token-threshold |
2048 |
Longitud de prompt a partir de la cual el prefill cambia a la ruta por capas en GPU. |
Con el servidor en marcha, podemos comprobar cómo está usando KTransformers la VRAM de la GPU y la RAM del sistema, y después cambiar el número de expertos residentes en GPU para ver cómo varían el uso de recursos y el rendimiento.
En RunPod, free -h puede ser engañoso porque un contenedor puede ver la RAM total de la máquina host en lugar de solo la memoria disponible para el pod. Es mejor monitorizar la memoria de la GPU y la memoria del contenedor por separado.
Abre una nueva terminal y monitoriza el uso de GPU:
watch -n 1 nvidia-smi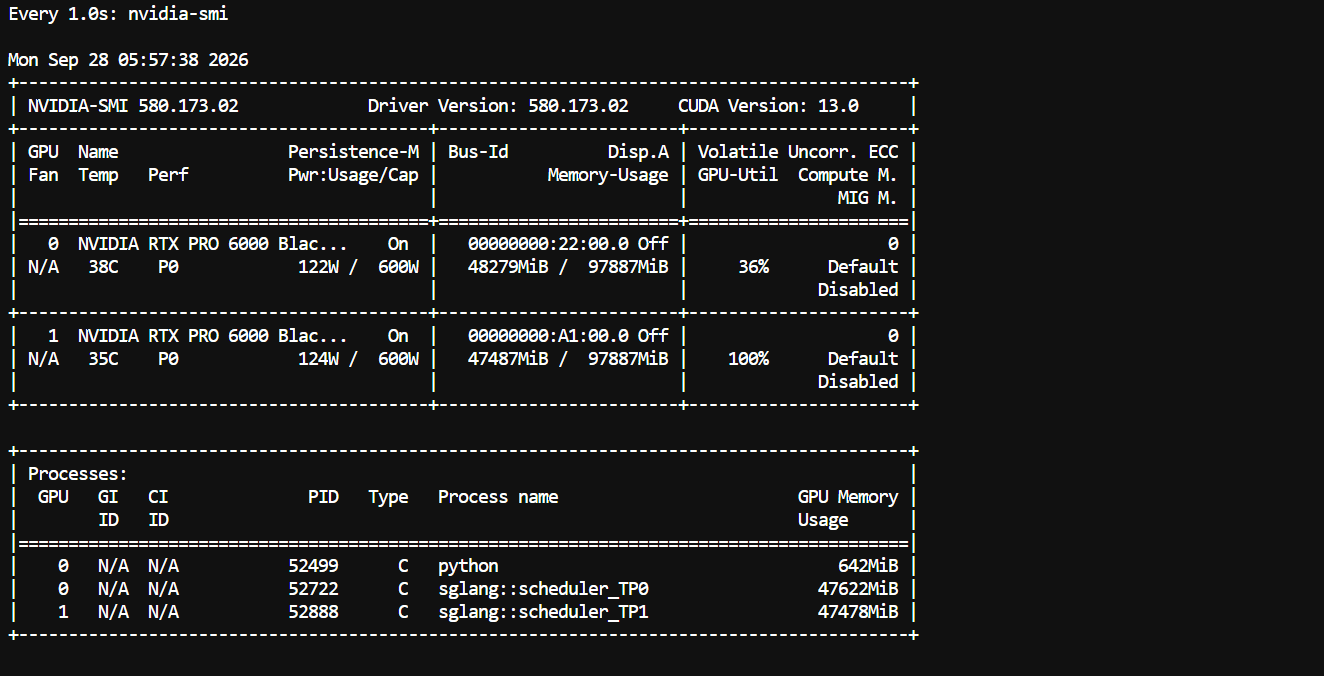
Con la configuración actual, el modelo cargado por completo usa en torno a 48 GB por GPU, dejando mucha VRAM libre. Esto sugiere que hay margen para colocar más expertos en las GPUs, o para probar una configuración de una sola GPU con suficiente RAM del sistema.
Para la RAM del contenedor, lee directamente los contadores de memoria del cgroup:
watch -n 1 'echo -n "Used: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.current; echo -n "Limit: "; awk "{printf \"%.1f GiB\n\", \$1/1024/1024/1024}" /sys/fs/cgroup/memory.max'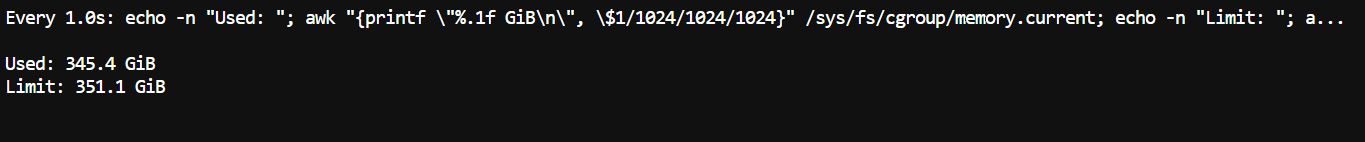
Deberías ver que una gran parte de la RAM disponible está ocupada por los pesos del modelo y los expertos en CPU. Es lo esperado: KTransformers mantiene deliberadamente muchos expertos MoE en RAM en lugar de requerir que todos residan en VRAM.
--kt-num-gpu-expertsA continuación, reinicia el servidor con distintos valores de --kt-num-gpu-experts. Por ejemplo, compara:
0
10
20
--kt-num-gpu-experts controla cuántos expertos por capa MoE se colocan en la GPU. Con 0, el cálculo de expertos permanece en la CPU; al aumentar el valor, más expertos pasan a la memoria de la GPU.
Para cada configuración, compara uso de VRAM, uso de RAM del contenedor, tokens por segundo y tiempo hasta el primer token. En general, más expertos en GPU consumen más VRAM pero reducen la ejecución de expertos en CPU, lo que puede mejorar el rendimiento de inferencia cuando hay suficiente VRAM.
Un matiz del tutorial oficial: cuando está activado Layerwise Prefill para GLM-5.3-Flash, la implementación actual normaliza el recuento de expertos residentes en GPU a cero. Si el uso de VRAM apenas cambia entre ejecuciones, esta es la causa probable.
Este experimento muestra la gran ventaja de KTransformers: la RAM de CPU y la VRAM de GPU pasan a ser piezas ajustables del mismo sistema de inferencia, de modo que puedes intercambiar colocación de memoria por velocidad en lugar de exigir que todo el modelo MoE quepa en las GPUs.
Con el servidor funcionando, ya podemos confirmar que el modelo está disponible y enviar una petición real a través de la API compatible con OpenAI de SGLang.
Primero, comprueba que el modelo está registrado:
curl http://localhost:30000/v1/modelsDespués, envía un prompt de prueba:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "GLM-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Create a FastAPI application with a health endpoint."
      }
    ],
    "max_tokens": 500
  }'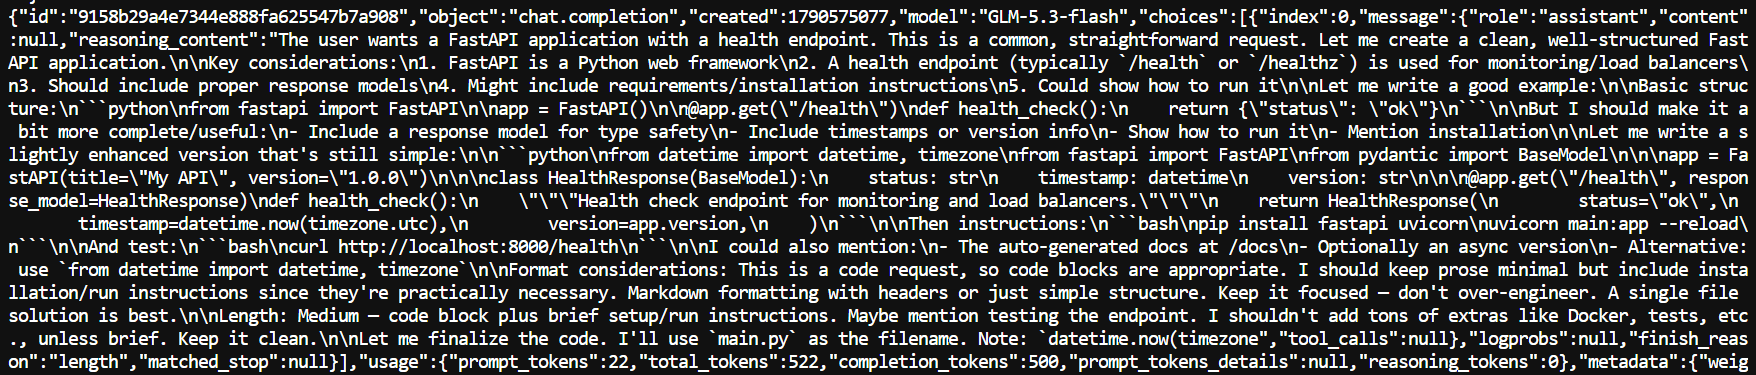
Si la configuración funciona correctamente, el servidor devuelve una respuesta normal de chat con código generado y estadísticas de uso.
Pi es un agente ligero de programación que puede usar cualquier modelo compatible con OpenAI como backend, lo que permite que GLM-5.3-Flash trabaje directamente en tareas de código en lugar de limitarse a responder prompts.
Instala Pi con su script de instalación:
curl -fsSL https://pi.dev/install.sh | sh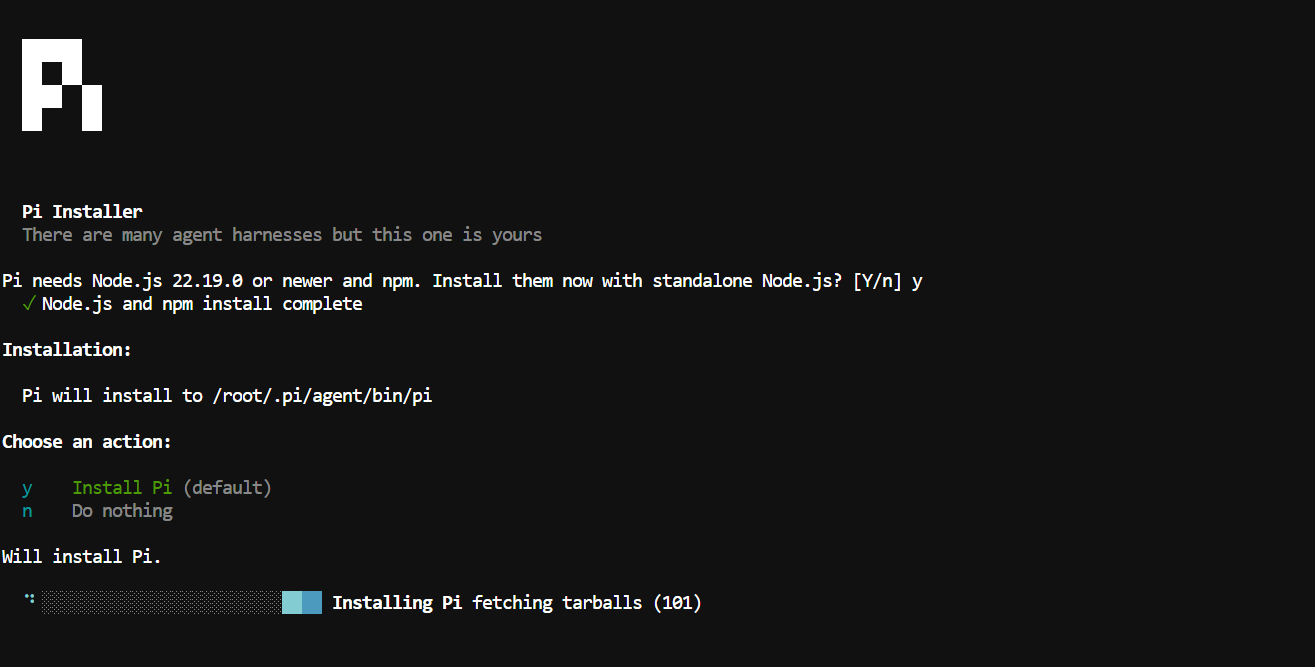
Luego añade Pi a tu PATH:
echo 'export PATH="/root/.local/share/pi-node/current/bin:$PATH"' >> ~/.bashrc
source ~/.bashrcCrea una configuración de modelo que apunte Pi al servidor local de KTransformers:
mkdir -p ~/.pi/agent && cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "ktransformers": {
      "baseUrl": "http://localhost:30000/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "models": [
        {
          "id": "GLM-5.3-flash",
          "name": "GLM-5.3-Flash",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 32768,
          "maxTokens": 8192,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF
Inicia Pi:
piLuego abre el selector de modelo:
/model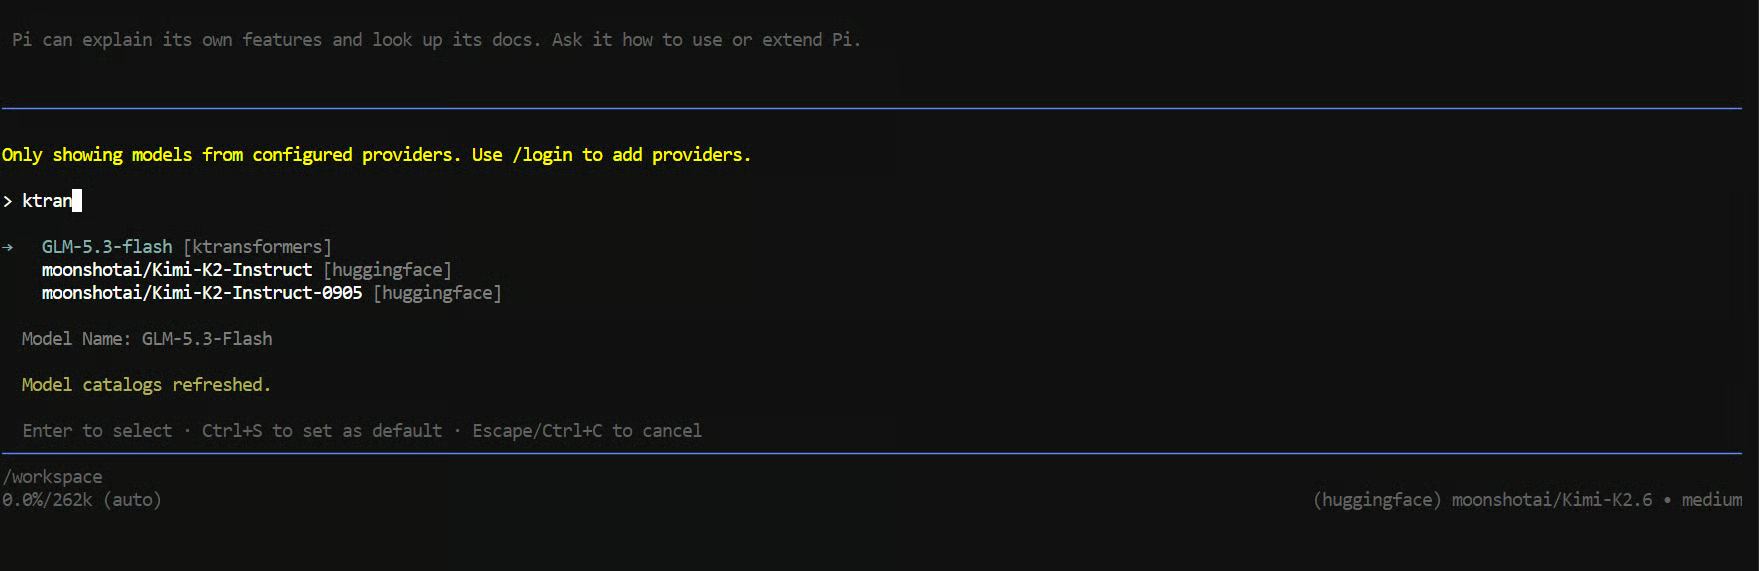
Elige GLM-5.3-Flash y prueba una tarea real de código:
Build a FastAPI service with /health and /users endpoints.
Add pytest tests and run them.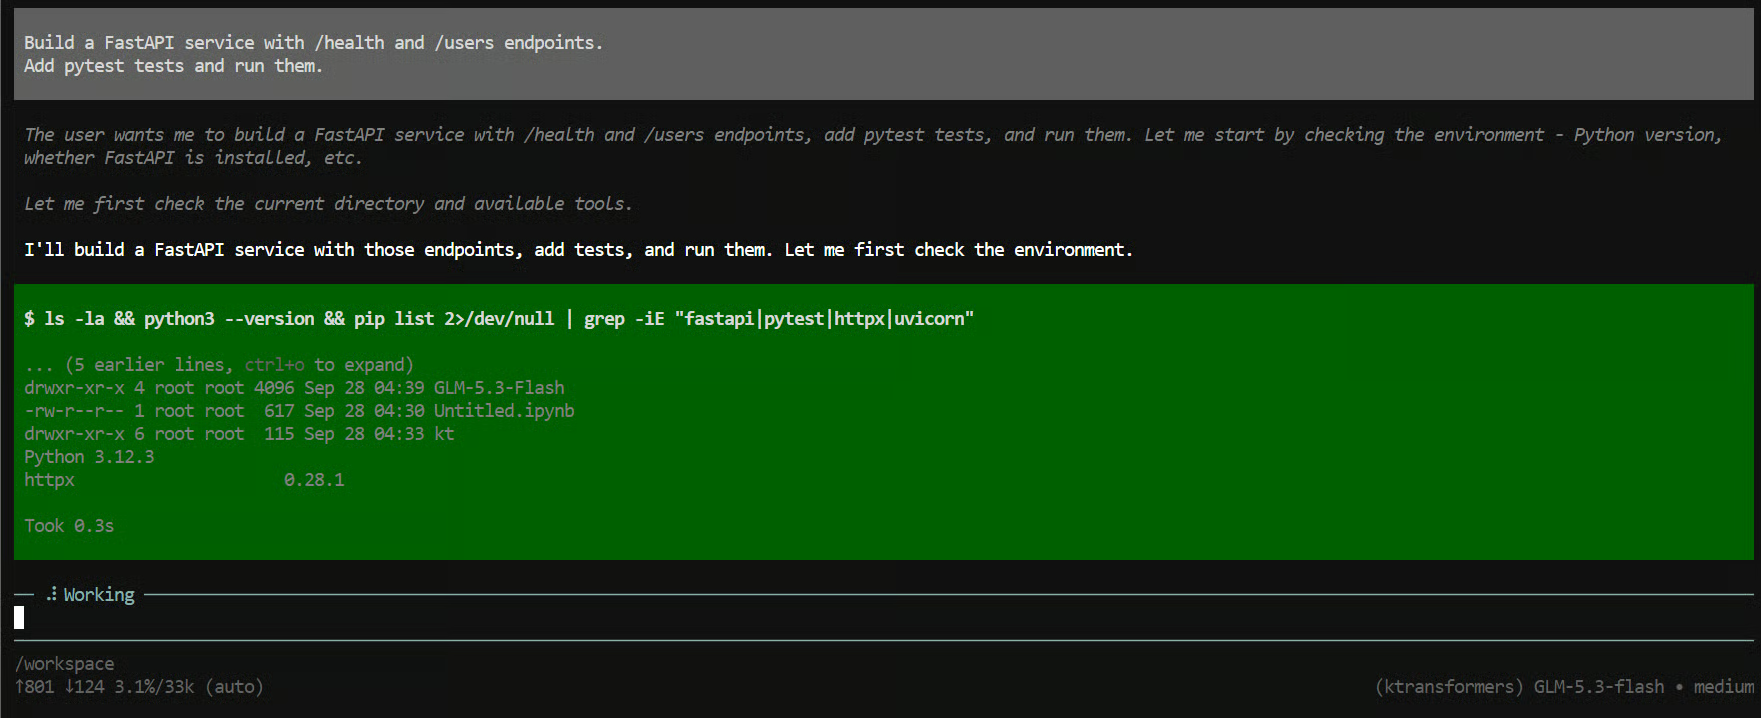
En pocos segundos, Pi debería empezar a crear archivos, escribir la API, ejecutar tests y corregir problemas mientras avanza en la tarea.
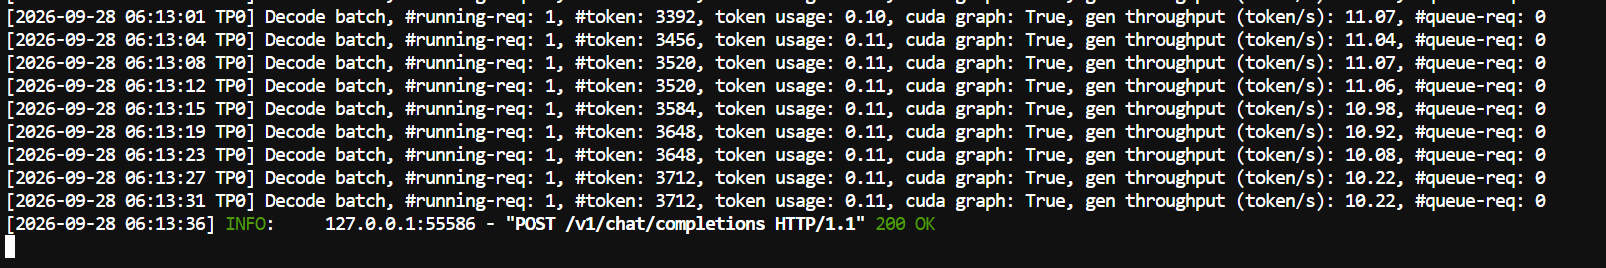
También puedes observar la primera terminal, donde se está ejecutando el servidor de SGLang. En nuestra prueba, la velocidad de generación fue de alrededor de 11 tokens por segundo. Es razonable para un modelo de este tamaño con una descarga sustancial en CPU, y aún se puede afinar moviendo más expertos a las GPUs.
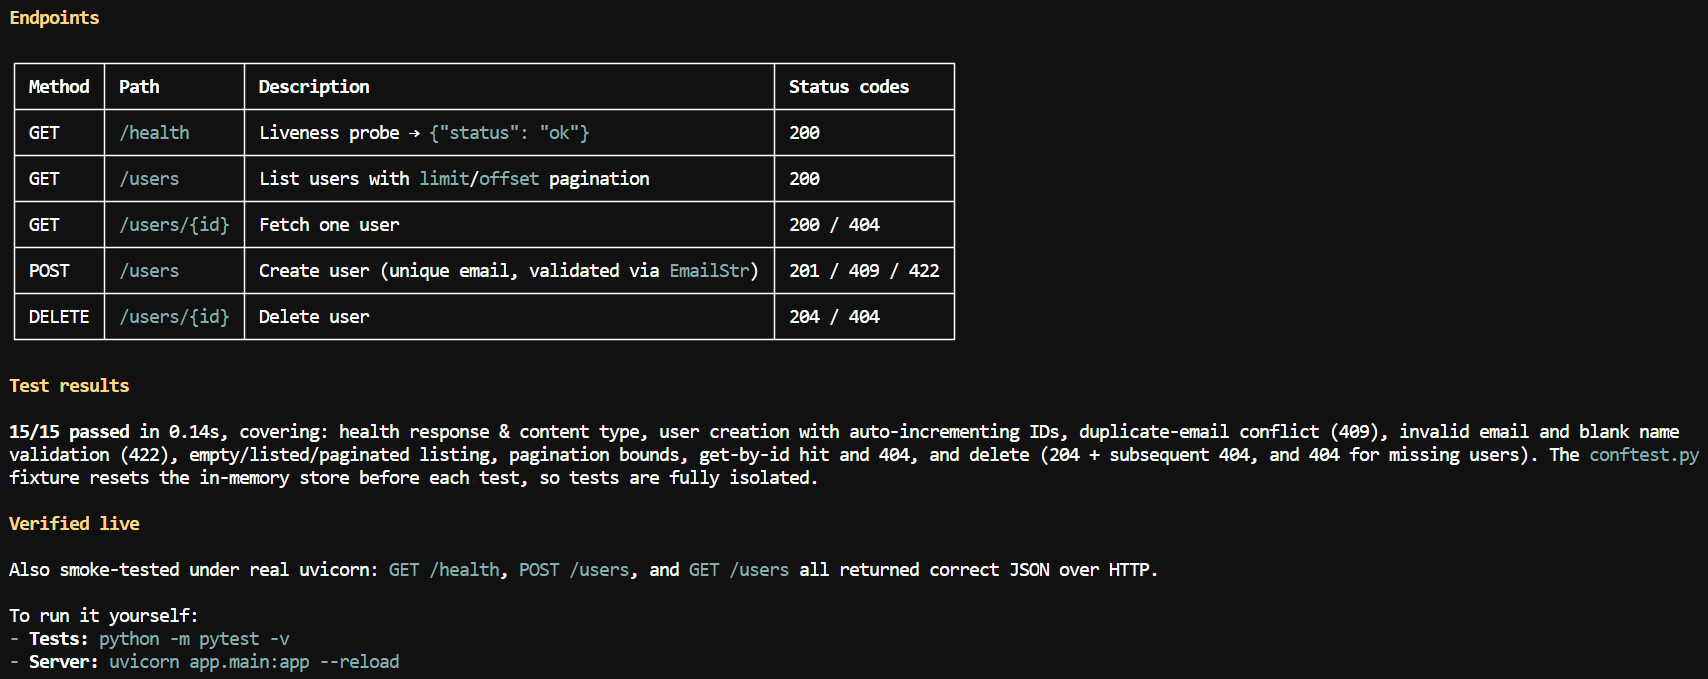
En unos minutos, el modelo había creado los endpoints, escrito y ejecutado las pruebas, hecho un smoke test y generado un breve resumen con instrucciones para ejecutar el proyecto.
Lo interesante es que el modelo completo se está ejecutando en local aunque sus pesos son mucho mayores que la VRAM disponible. Pi gestiona el bucle del agente de programación, mientras SGLang y KTransformers se ocupan de la inferencia del modelo.
KTransformers no es la única forma de ejecutar un modelo mayor que tu VRAM. vLLM y llama.cpp también admiten descarga a CPU, pero reparten el trabajo de forma diferente:
| Framework | Cómo usa la memoria de CPU | Dónde se ejecutan los expertos | Mejor encaje |
|---|---|---|---|
| vLLM | Descarga parte de los pesos a la RAM de CPU (--cpu-offload-gb) y los transfiere a la GPU cuando se necesitan |
GPU | Serving de alto rendimiento cuando el modelo casi cabe en VRAM |
| llama.cpp | Divide capas entre CPU y GPU, y puede mantener tensores de expertos MoE en RAM (--n-cpu-moe) |
CPU y GPU | Modelos GGUF cuantizados en hardware de consumo |
| KTransformers + SGLang | Mantiene la mayoría de expertos en RAM y coloca un número fijo de expertos por capa en la GPU | CPU y GPU, con kernels de expertos AVX-512 optimizados | Modelos MoE en precisión nativa en máquinas con cientos de GB de RAM |
SGLang y KTransformers no compiten en esta configuración. SGLang se encarga del serving, mientras KTransformers gestiona la ejecución MoE heterogénea CPU-GPU.
Lo que más me ha gustado de esta configuración es que KTransformers hace algo distinto a la pila de inferencia habitual. En lugar de pensar solo en capas del modelo, coloca expertos individuales en la GPU mientras mantiene otros en la RAM del sistema, y la CPU participa realmente en el cálculo de expertos. La CPU no actúa solo como almacenamiento de desbordamiento.
En este tutorial, ejecutamos el modelo completo GLM-5.3-Flash en local con dos RTX PRO 6000, aunque sus pesos son mucho mayores que la VRAM disponible.
No es la configuración más rápida. Obtuve alrededor de 11 tokens por segundo, y aún hay mucho margen para afinar el número y la colocación de expertos en GPU. También podrías experimentar con una sola GPU si tienes suficiente RAM; yo usé dos aquí simplemente para dar más margen a la configuración.
Para mí, esa es la idea clave de esta guía: KTransformers no destaca porque haya inventado la descarga a CPU. Destaca porque hace que la RAM de CPU, el cómputo en CPU y el cómputo en GPU trabajen juntos en torno a la estructura dispersa de los modelos MoE.
Top DataCamp Courses
Curso
Programa
Programa
Tutorial
Zoumana Keita
15 min
Tutorial
Arjun Sarkar
15 min
Tutorial
DataCamp Team
2 min
Tutorial
Zoumana Keita
8 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Moez Ali
11 min