Toen ChatGPT in november 2022 werd gelanceerd en in slechts twee maanden honderd miljoen gebruikers aantrok, zette ik het eerlijk gezegd weg als een overhypte chatbot. Die inschatting is slecht oud geworden. Tegenwoordig vertrouw ik (en bijna iedereen met wie ik werk) dagelijks op AI-codingtools, en de discussies uit 2023 over of een bot een fatsoenlijke e-mail kan schrijven voelen compleet gedateerd. Dus wat is de toekomst van AI?
De sector is voorbij die eerste vragen en opereert nu op een totaal andere schaal. Anthropic passeerde onlangs $7 miljard aan terugkerende omzet, en techreuzen pompen geld in datacenters op niveaus die vijf jaar geleden absurd hadden geleken. De vraag die er nu toe doet is dan ook niet meer óf AI werkt, maar wat er gebeurt wanneer het niet meer op prompts wacht en zelf gaat bepalen wat de volgende stap is.
Dit artikel gaat in op waar de technologie naartoe lijkt te gaan. Ik kijk naar agentische AI, het verhitte debat over de AGI-tijdlijn, en de opkomst van kleinere modellen die je lokaal kunt draaien. We bekijken ook verschuivingen op de arbeidsmarkt, codingtools, toepassingen in de zorg en de stand van regelgeving. Laten we erin duiken!
Als je nog niet bekend bent met sommige AI-concepten, raad ik onze AI Fundamentals skill track aan, die alle basisbeginselen behandelt die je moet kennen.
Van generatieve naar agentische AI
Het heen-en-weer van de chatbot maakt plaats voor een autonomere aanpak. In dit deel lees je hoe die verschuiving er in de praktijk uitziet, waar de echte implementatie-uitdagingen liggen en waarom de meeste organisaties nog steeds worstelen om agenten in productie te krijgen.
De opkomst van autonome agenten
De afgelopen jaren volgden AI-tools een voorspelbaar ritme. Jij prompt, het antwoordt. De mens stuurde, AI reed mee. Die dynamiek verschuift: agentische AI-systemen beantwoorden niet alleen vragen; ze formuleren plannen om doelen te bereiken.
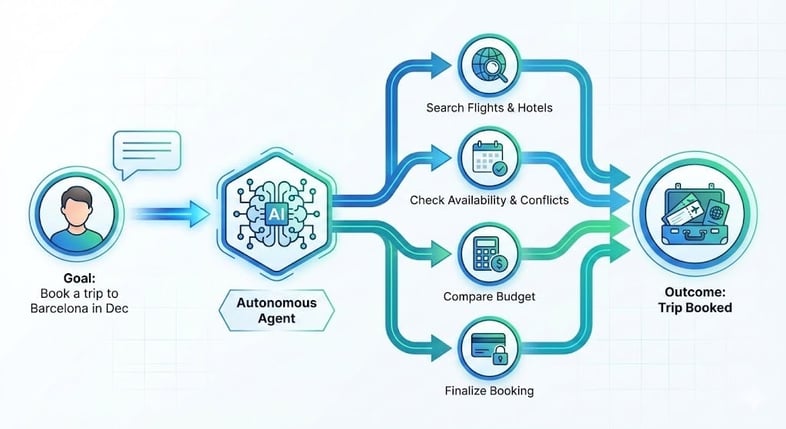
Stel, je wilt in december een reis naar Barcelona boeken. In plaats van een lijst met hotels te geven die je zelf moet uitzoeken, zou een agent het volgende doen:
- Zoeken naar opties
- Filteren op jouw voorkeuren
- Prijzen toetsen aan je budget
- Je agenda checken op conflicten
- De boeking afronden
Jij beschrijft het gewenste eindresultaat—het systeem regelt de stappen om je daar te krijgen.
De zakelijke honger hiernaar is enorm. Deloitte voorspelt dat 75% van de bedrijven tegen eind 2026 in agentische AI zal investeren. De realiteit blijft echter achter bij de visie. Een UiPath-enquête van medio 2025 wees uit dat, hoewel de interesse groot is, slechts 30% van de agent-implementaties daadwerkelijk de productiefase haalt.
De kloof dichten met MCP
Waardoor ontstaat die kloof? Vooral integratie. Toen onderzoekers bedrijven vroegen wat hen blokkeerde, wees 46% op het verbinden van AI-agenten met bestaande systemen. Een agent schrijven die code kan opstellen is één uitdaging. Hem betrouwbaar laten werken met je CRM, je ticketingsysteem, je interne API’s—zonder dingen stuk te maken of nieuwe problemen te creëren—blijkt een totaal andere uitdaging.
Om dit op te lossen, schaart de sector zich achter open standaarden zoals Anthropic’s Model Context Protocol (MCP) en OpenAI’s AGENTS.md-specificatie, die beide mikken op neutraal beheer van open infrastructuur en zijn ingebracht bij de Agentic AI Foundation.
Vooral MCP wint veel terrein. Zie het als “USB‑C voor AI”—een standaardconnector waardoor agenten eenvoudig met verschillende tools en platforms kunnen praten. Om er een paar te noemen: het biedt integratie met Claude, Cursor, Microsoft Copilot, VSCode, Gemini en ChatGPT.
Wil je verder dan demo’s? Bekijk dan onze cursussen over agentische AI voor de concepten en Designing Agentic Systems with LangChain voor de praktijk.
Is Artificial General Intelligence (AGI) nabij?
De tijdlijn naar Artificial General Intelligence (AGI)—AI-systemen die op menselijk niveau taken kunnen uitvoeren over domeinen heen—hangt volledig af van wie je het vraagt.
De CEO’s van grote AI-labs zijn agressief: Dario Amodei van Anthropic noemde 2026–2027 voor systemen die Nobelprijswinnaars evenaren over velden heen (“een land vol genieën in een datacenter”). Ook Sam Altman en Demis Hassabis wijzen op de komende 3–5 jaar.
Belangrijk om te noteren: deze bedrijven zijn afhankelijk van investeerdersenthousiasme om dure research te financieren, dus optimistische tijdlijnen dienen een strategisch doel.
Sceptici zijn koeler. Gary Marcus noemt de afgelopen maanden “vernietigend” voor AGI-optimisme, en voormalig OpenAI-onderzoeker Andrej Karpathy plaatst AGI op z’n minst een decennium weg. Een brede enquête uit 2023 onder onderzoekers schatte de mediane aankomstdatum nog verder, op 2047.
Uiteindelijk biedt Stanford’s HAI het nuttigste kader: we bewegen van “evangeliseren naar evalueren”. De belangrijkste vraag is niet wanneer AGI arriveert, maar hoe goed huidige systemen specifieke taken vandaag aankunnen versus waar ze nog menselijke controle nodig hebben.
Opkomende AI-technologieën voorbij LLM’s
Niet alles wat interessant is in AI draait om grotere modellen. Kleinere modellen, quantumcomputing en digital twins veranderen wat er mogelijk is aan de randen van het veld.
Small Language Models (SML’s) en edge AI
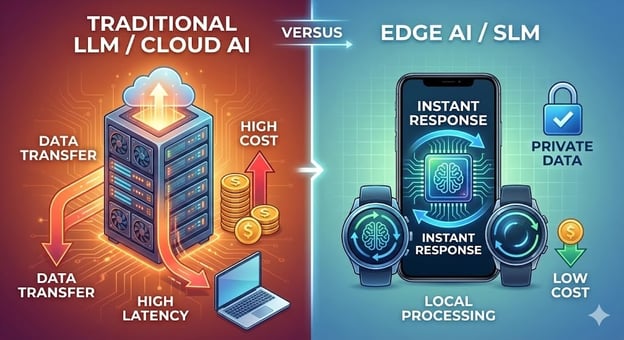
Terwijl iedereen het heeft over steeds grotere modellen, gaan er flinke investeringen naar kleinere. Gartner voorspelt dat organisaties Small Language Models (SML’s)—taakspecifieke modellen—drie keer zo vaak zullen inzetten als generieke grote modellen tegen 2027.
De redenen zijn praktisch:
- Kosten: Het draaien van enorme modellen is duur. OpenAI gaf naar verluidt in het begin van 2025 bijna het dubbele van zijn omzet uit aan inference. SLM’s drukken deze kosten flink.
- Privacy: On-device modellen houden data lokaal, een vereiste in zorg en financiën. Daardoor zal de SLM-markt naar verwachting groeien van $930 miljoen in 2025 naar $5,45 miljard in 2032.
- Snelheid: Lokale inference elimineert netwerklatentie. Voor kwaliteitscontrole in de maakindustrie of fraudedetectie in het bankwezen tellen milliseconden. De cloud kan dat niet altijd leveren.
NVIDIA-onderzoekers stellen dat de volgende sprong in AI niet de omvang is, maar specialisatie. Omdat taken als e-mailparsing of SQL-queries geen encyclopedische kennis vereisen, ziet de toekomstige architectuur eruit als modelvloten: meerdere gespecialiseerde modellen die samenwerken in plaats van één enorme generalist.
Google, Mistral, Microsoft en Alibaba zetten hier hard op in. Google AI Edge ondersteunt meer dan een dozijn modellen, waaronder Gemma 3n, hun eerste multimodale on-device model.
De aanpak van SLM’s en LLM’s vergeleken
De volgende tabel vergelijkt de twee aanpakken. Voor meer diepgang, lees ons artikel over SLM’s vs LLM’s.
|
Aspect
|
Large Language Models
|
Small Language Models
|
|
Waar ze draaien
|
Cloudservers
|
Apparaten, edge, lokale servers
|
|
Kosten per request
|
Hoger ($0,01–0,10)
|
Fracties van een cent
|
|
Responstijd
|
Netwerkafhankelijk (100–500 ms)
|
Onder 50 ms
|
|
Dataverwerking
|
Verlaat het apparaat
|
Blijft lokaal
|
|
Maatwerk
|
Resource-intensief
|
Toegankelijker
|
|
Beste voor
|
Complex redeneren, creatief werk, brede kennis
|
Specifieke taken, betrouwbaarheid, snelheid
|
|
Energieverbruik
|
Aanzienlijk
|
Bescheiden
|
Grote modellen worden niet irrelevant. Complexe problemen profiteren nog steeds van hun kracht. De toekomst zal waarschijnlijk beide omvatten, met interessante vragen over wanneer je welke inzet.
De convergentie van quantumcomputing en AI
Quantumcomputing is al decennia “vijf jaar weg”, maar eind 2025 is er iets verschoven en dat verdient aandacht.
Google toonde een 13.000x versnelling ten opzichte van de Frontier-supercomputer met 65 qubits voor fysicasimulaties. IBM mikt op quantum advantage in 2026, en onderzoekers gebruiken neurale netwerken om qubitfouten in realtime te voorspellen en te corrigeren.
Het veld verschoof van theoretische belofte naar een engineeringprobleem.
De term die terrein wint is “quantum utility”. Het gaat niet om volledig quantumvoordeel over alle problemen, maar om quantumssystemen die specifieke problemen sneller of goedkoper oplossen dan klassieke alternatieven. De beoogde problemen zijn wiskundig zwaar, met zoveel variabelen dat klassieke computers vastlopen:
- Optimalisatie van batterijchemie
- Screening van geneesmiddelcombinaties
- Risicomodellering van portefeuilles
Onderzoekers van JPMorgan Chase behaalden onlangs een mijlpaal met een quantum streaming-algoritme dat grote datasets verwerkt met een exponentieel ruimtevoordeel. Dat is geen persbericht. Dat is peer-reviewed werk met meetbare resultaten.
Dat gezegd hebbende, de bandbreedte in voorspellingen is hier groot.
Manifold Markets, dat meer dan 100 quantumgerelateerde voorspellingen volgt, laat brede scepsis zien dat quantumcomputers klassieke systemen in 2026 zullen overtreffen in cryptografie of complexe biologische simulaties. De meeste waarnemers verwachten incrementele engineeringvooruitgang, geen doorbraak naar quantumvoordeel.
Maar dezelfde markten tonen sterk vertrouwen dat bruikbare fouttolerante quantumcomputers binnen het decennium arriveren.
Wat betekent dit praktisch?
Praktisch gezien is de zelfstandige quantumcomputer een mythe. De industriestandaard is nu “heterogeneous compute”: hybride architecturen waarbij quantumprocessors in high‑performance centra naast GPU-clusters staan, met AI-systemen die de workflow beheren.
Voor data scientists in R&D-sectoren creëert dit een nieuwe vaardigheidseis. Quantumcloud-API’s van IBM, Google, Amazon Braket en Microsoft Azure Quantum laten je quantumsubroutines draaien zonder hardware te bezitten. De leercurve is niet triviaal, maar veel toegankelijker dan je eigen quantumlab bouwen.
De verschuiving in focus is subtiel maar belangrijk. Waar klassieke data science gefixeerd is op “big data”, draait quantumcomputing om “complexe optimalisatie”. Het pakt problemen aan met combinatorische explosies, zoals moleculaire modellering, logistiek of financieel risico met duizenden gecorreleerde factoren. Voor deze gebieden verschuiven quantumtools van theoretisch naar relevant.
Digital twins en simulatie
Digital twins bewegen van modewoord naar werkende infrastructuur. Het idee is eenvoudig: bouw een levendige virtuele kopie van een fysiek systeem (een productielijn, een magazijnnetwerk, een stroomnet, een stadswijk) en houd die gesynchroniseerd met de echte via sensoren, logs en operationele data. Vervolgens gebruik je de twin om beslissingen te stresstesten voordat je de realiteit aanraakt.
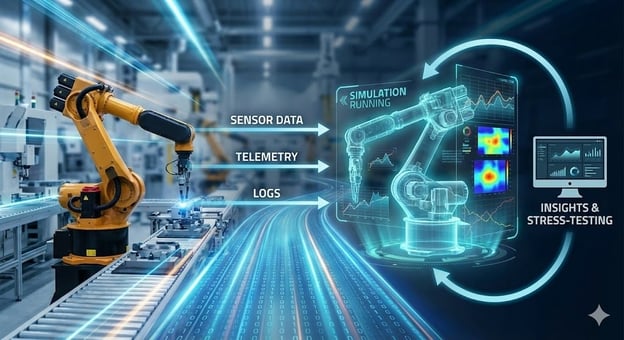
Fabrieken zijn de duidelijkste vroege case. Een moderne fabriek produceert al de data die een twin nodig heeft: PLC-signalen, machinetelemetrie, onderhoudshistorie, werkorders, kwaliteitsmetingen, voorraadbewegingen. AI zet die vloed om in een model dat je kunt bevragen. Niet alleen dashboards, maar ook tegenfeiten. Je kunt vragen beantwoorden als:
- Wat als een pers zes uur uitvalt op dinsdagochtend?
- Wat als we leverancier B vervangen door C voor dit onderdeel, met een iets ander defectprofiel?
- Wat als we het rooster wijzigen zodat de ervaren operators zich op de laatste twee stations concentreren?
De waarde zit niet in het voorspellen van de verstoring. Het is het in kaart brengen van de neveneffecten—gemiste vensters, voorraadgaten, kosten van omleiding—zodat je oplossingen vooraf kunt doorrekenen in plaats van om 3 uur ’s nachts te improviseren.
De enabling shift is dat AI de kosten van het bouwen en onderhouden van deze modellen verlaagt. Moderne ML-modellen leren gedrag direct van live data, detecteren drift en houden de twin uitgelijnd terwijl het echte systeem verandert.
Kleine, gespecialiseerde modellen passen hier ook goed: één model voor anomaliedetectie op een turbine, een ander voor roosteroptimalisatie, weer een ander voor vraagvoorspelling—allemaal voedend in dezelfde gesimuleerde omgeving.
Wil je een scherper beeld van wat er komt, lees dan 9 Open-Source LLM’s voor 2026 om modellen zonder vendors te draaien en te fine-tunen, en Top 13 AI-conferenties voor 2026, waar de echte implementatiegesprekken zullen plaatsvinden.
De toekomst van AI in werk
Koppen over AI die banen overneemt missen vaak de nuance in de echte data. Het beeld dat uit onderzoek naar voren komt is rommeliger, geleidelijker en waarschijnlijk minder dramatisch dan optimisten of pessimisten suggereren.
Gaat AI banen vervangen?
De cijfers verdienen meer nuance dan koppen doorgaans bieden.
Het World Economic Forum ondervroeg meer dan 1.000 toonaangevende werkgevers voor hun Future of Jobs Report 2025. Zij voorspelden 170 miljoen nieuwe rollen en 92 miljoen verdrongen banen tussen 2025 en 2030, een nettogroei van 78 miljoen banen.
Hoewel dit netto positief is, is de verdeling cruciaal. In een studie uit november 2025 schatten onderzoekers van MIT en Boston University dat AI tegen 2026 ongeveer twee miljoen productiemedewerkers zal vervangen.
Het onderscheid dat je moet maken, is tussen taken en functies. AI automatiseert vaker specifieke activiteiten binnen banen dan dat het hele functies in één keer elimineert. Je accountant gaat nergens heen, maar de uren besteed aan datainvoer en reconciliatie krimpen.
MIT-onderzoek uit 2025 schatte dat momenteel automatiseerbare taken ongeveer 11,7% van de activiteiten van de Amerikaanse beroepsbevolking beslaan, wat neerkomt op zo’n $1,2 biljoen aan lonen. Dat betekent niet dat 11,7% van de werknemers hun baan verliest, maar wel dat aanzienlijke delen van wat zij doen nu als software kunnen draaien.
Banen die meer onder druk staan, zijn onder meer:
- Klantenservice, vooral tekstgebaseerde support
- Datainvoer en -verwerking
- Administratief werk met voorspelbare patronen
- Sommige functies van retailkassiers
- Routine juridisch onderzoek en taken van paralegals
Banen met de volgende kenmerken staan minder onder druk:
- Mensen aansturen
- Gespecialiseerd oordeel
- Ambigue situaties
- Fysieke aanwezigheid in onvoorspelbare omgevingen
Deze patronen gelden onder andere voor de zorg, vaktechnische beroepen, creatief werk en strategische besluitvorming.
Opkomende carrièrepaden
Er ontstaan nieuwe functiecategorieën, waarvan sommige vijf jaar geleden niet bestonden:
- AI Systems Architect ontwerpt hoe AI-componenten binnen organisaties passen. Je combineert technische bagage met kennis van bedrijfsprocessen.
- Prompt Engineer werd een echte functietitel, al evolueert die richting wat men een AI-samenwerkingsspecialist noemt. Begrijpen hoe je effectief met deze systemen samenwerkt, niet alleen slimme inputs schrijven.
- AI Ethics and Compliance Manager dekt regelgeving en auditing. Organisaties hebben mensen nodig die zowel de technische mogelijkheden als het juridische landschap begrijpen om risico’s rond AI-systemen te beperken.
- AI Trainer en Data Curator beheert feedbacklussen, annotatie van randgevallen en kwaliteitscontrole van trainingsdata.
Het patroon dat ik zie: domeinexpertise gecombineerd met AI-vaardigheid creëert waarde. Een verpleegkundige die AI-diagnosetools begrijpt, levert betere uitkomsten dan iemand die ze mijdt. Een advocaat die AI gebruikt voor onderzoek en de grenzen kent, werkt sneller zonder kwaliteitsverlies.
Werkgeversenquêtes rangschikken analytisch denken steevast als de meest gevraagde vaardigheid. Zeven op de tien bedrijven noemen het essentieel. Daarna volgen veerkracht, aanpassingsvermogen en leiderschap.
Sectorspecifieke veranderingen
Sommige vakgebieden adopteerden AI-tools sneller dan andere, en de resultaten variëren meer dan je zou denken. Coderen, zorg en financiën vertellen elk een ander verhaal over wat werkt, wat niet, en waar de verrassingen zitten.
Coderen en data science
Softwareontwikkeling adopteerde AI-tools sneller dan de meeste velden. De tools blijven evolueren.
Volgens de Stack Overflow-enquête 2025 gebruikt circa 85% van de developers eind 2025 regelmatig AI-tools. GitHub meldt dat 41% van de code die Copilot-gebruikers wereldwijd maken AI-assistentie omvat. We zijn voorbij autocomplete: huidige systemen begrijpen hele repositories en voeren wijzigingen door in meerdere bestanden.
Marktleiders zijn opgestaan: GitHub Copilot heeft zo’n 42% marktaandeel, met meer dan 20 miljoen gebruikers en een aanwezigheid bij 90% van de Fortune 100. Cursor kwam uit het niets naar 18% marktaandeel in achttien maanden. Ze draaien naar verluidt $500 miljoen aan terugkerende omzet.
AI-tools blinken uit in bepaalde soorten programmeerwerk:
- Boilerplate, repetitieve patronen
- Onbekende API’s verkennen
- Legacycode ontcijferen
Toch is de kloof tussen perceptie en realiteit relevant.
In een METR-studie van juli 2025 gebruikten ervaren developers tools als Cursor Pro en Claude 3.5 Sonnet. Die developers rondden taken 19% trager af dan zonder AI-hulp—terwijl ze dachten 20% sneller te werken.
De les: productiviteitswinst hangt van de context af. AI-tools kunnen je zelfs vertragen wanneer het werk niet aansluit op hun sterke punten en jij het systeem beter begrijpt dan de AI.
De richting gaat nu naar meer autonome capaciteiten. GitHub’s Project Padawan vertegenwoordigt een model waarin developers issues toewijzen aan AI-systemen, de AI implementeert en mensen reviewen. De verschuiving gaat van AI die code voorstelt naar AI die features afrondt.
Voor data science geldt: minder tijd aan voorbereiding en meer aan interpretatie. AI kan SQL-queries en datacleaning overnemen. Zo krijgen data scientists tijd om de juiste vragen te stellen en de resultaten te duiden.
Zorg
AI in de zorg zit in complex terrein. Echte potentie, maar voorzichtige uitrol—wat gezien de inzet waarschijnlijk terecht is.
Door AI ondersteunde geneesmiddelenontwikkeling versnelt. AlphaFold en soortgelijke tools voorspellen eiwitstructuren in uren in plaats van jaren. Screening van combinaties gebeurt op eerder onpraktische schaal. Sommige schattingen suggereren dat AI de ontwikkeling van medicijnen met vier à vijf jaar per medicijn kan inkorten.
Diagnostiek is ook in specifieke domeinen verbeterd, met radiologie, pathologie en oftalmologie het verst. AI die getraind is op medische beeldvorming kan patronen vinden die menselijke reviewers missen.
Volgens McKinsey breidde de Mayo Clinic haar radiologieteam sinds 2016 met meer dan 50% uit terwijl ze honderden AI-modellen uitrolde. Die combinatie is opvallend: AI versterkte het werk in plaats van mensen te vervangen.
Voorzichtigheid is echter logisch. Beslissingen in de zorg hebben consequenties die socialmedia-aanbevelingen niet hebben: verkeerde diagnoses kunnen patiënten schaden. De wetenschappelijke en medische eis om te begrijpen hoe modellen tot conclusies komen—niet alleen of ze accuraat zijn—creëert echte beperkingen.
De realiteit op korte termijn is AI als diagnostische assistent. Systemen kunnen mogelijke problemen markeren, tests voorstellen en dingen opvangen die in drukke omgevingen kunnen ontsnappen. Maar uiteindelijk nemen artsen de eindbeslissingen en onderhouden ze de patiëntrelatie.
Remote monitoring versnelt doordat small language models direct op wearables draaien. Door data lokaal op het apparaat te verwerken, minimaliseren deze systemen de latentie en waarborgen ze privacy, waarbij AI alleen specifieke afwijkingen voor menselijke review markeert.
Financiën
Financiële diensten waren vroege AI-adopters en beheersten jaren geleden al razendsnelle fraudedetectie, maar agentische capaciteiten duwen de sector nieuw terrein in.
Terwijl gevestigde tools fraude en routinevragen in de klantenservice afhandelen, ligt de actieve frontier nu bij hyperpersonalisatie. Nieuwe systemen kunnen individuele risicotolerantie en financiële doelen analyseren om geavanceerde vermogensstrategieën aan een veel breder publiek te bieden.
Deze vooruitgang gaat echter gepaard met een waarschuwing: toezichthouders onderzoeken deze modellen steeds intensiever om te waarborgen dat historische bias in leningdata niet wordt gereproduceerd door de algoritmen.
AI-uitdagingen en regelgeving
Technische beperkingen en beleidslacunes creëren echte grenzen aan wat AI verantwoord kan doen. Het blackboxprobleem, gegenereerde desinformatie en een gefragmenteerd regelgevingslandschap bepalen allemaal wat daadwerkelijk inzetbaar is versus wat theoretisch mogelijk is.
Technische en sociale kwesties
Het blackboxprobleem is niet opgelost. Als modellen beslissingen nemen, blijft begrijpen waarom lastig. Dat is problematisch wanneer beslissingen leningen, werk en medische zorg raken.
Onderzoek focust op interpretability. De Stanford HAI-faculteit verwacht in 2026 meer aandacht voor wat zij “archeologie van high‑performing neural nets” noemen. Technieken zoals sparse autoencoders helpen identificeren welke trainingsfeatures gedrag daadwerkelijk aansturen.
Gegenereerde content veroorzaakt extra problemen: deepfakes en AI-geproduceerde desinformatie worden met de dag lastiger te detecteren. Sommige schattingen suggereren dat AI‑gegenereerde artikelen online qua volume al menselijk geschreven content overtreffen.
Model collapse kan een gevolg zijn en baart onderzoekers zorgen. Als modellen steeds meer trainen op AI‑gegenereerde content, die een groeiend deel van beschikbare data vormt, kan de kwaliteit achteruitgaan. Modellen consumeren hun eigen outputs op manieren die fouten versterken.
Regelgevingslandschap
Rechtsgebieden kiezen verschillende aanpakken.
De EU AI Act is momenteel het meest allesomvattende AI‑regelboek. Het is opgebouwd rond een risicoladder: hoe hoger het risico, hoe zwaarder de verplichtingen. Systemen die worden gebruikt voor beslissingen rond werk en krediet vallen in de “hoog risico”-categorie, met strengere eisen rond documentatie, controls en toezicht.
De verordening trad op 1 augustus 2024 in werking, maar de meeste verplichtingen worden gefaseerd ingevoerd in de jaren daarna.
Energie verschijnt op een smaller, praktischer vlak: aanbieders van general‑purpose AI‑modellen moeten mogelijk het energieverbruik documenteren (of schattingen geven afgeleid van compute wanneer exacte meting niet haalbaar is). Los van de AI Act worden EU-rapportageverplichtingen voor datacenters en energie-efficiëntie aangescherpt, wat ertoe doet omdat AI‑workloads een belangrijke nieuwe driver van elektriciteitsvraag zijn.
In de praktijk stuurt dit teams naar een “goed-genoeg”-architectuur die efficiëntie boven pure rekenkracht stelt. Door kleinere modellen te gebruiken en inference aan de edge te draaien, kunnen ontwikkelaars minder tokens door dure clouds sturen en zo rekenkosten, stroomverbruik en datatransport verlagen.
In de VS is de situatie veel onzekerder. Federale wetgeving zit op slot, en met het mislukken van pogingen in 2025 om staatsregels te overrulen, versplintert het regelgevingsklimaat. Bouwers krijgen in 2026 dus te maken met een bewegend doelwit van state‑by‑state compliance in plaats van een eenduidig federaal kader.
Voorbereiden op de toekomst van AI
Wat helpt nu echt om professioneel relevant te blijven? Ter voorbereiding raad ik aan om AI-gerelateerde concepten te bestuderen, technische skills te ontwikkelen en praktijkervaring op te doen.
Data- en AI-geletterdheid
Datageletterdheid is niet langer optioneel. Je hoeft geen data scientist te zijn, maar je moet wel begrijpen hoe data stroomt, wat het betrouwbaar maakt en hoe je modeluitvoer interpreteert.
Heb je een gestructureerde basis nodig, dan dekt de Data Literacy Professional skill track alle essentials en biedt je een certificering om te tonen wat je hebt geleerd. Voor een meer AI-georiënteerde theoretische start raad ik aan je in te schrijven voor de AI Fundamentals skill track.
Technische skills
Basis technische skills blijven het onderscheid maken. AI-tools maken coderen toegankelijker, maar je moet de logica begrijpen om de output te verifiëren. Python en SQL zijn hier de “daily drivers”.
Een solide aanpak is: leer eerst de taal, dan de AI‑laag. Begin met Introduction to Python om de syntaxis te snappen. Ga daarna verder met Generative AI Concepts om te begrijpen hoe moderne assistenten zich gedragen—en waar ze falen.
Domeinexpertise en agenten
De grootste verschuiving is van chatbots naar agenten. Alleen prompten wordt een commodity. Waarde zit in het ontwerpen van workflows die integreren met systemen in de echte wereld.
Domeinexpertise behoudt waarde. AI‑tools goed kennen, gecombineerd met diepe vakkennis, levert meer op dan elk afzonderlijk. De snelste manier om die combinatie concreet te maken is één domeinworkflow kiezen en leren hoe agenten daarop inpluggen.
Om deze architectuur te begrijpen, schrijf je in voor onze AI Agent Fundamentals skill track voor het mentale model. Heb je het theoretische deel gehad, volg dan de Designing Agentic Systems with LangChain-cursus om hands-on ervaring op te doen met het bouwen van een werkend systeem end‑to‑end. Zien waar deze agenten breken is net zo waardevol als zien waar ze werken.
Omgaan met onzekerheid
Tot slot: kweek comfort met onzekerheid. Uitvoer van AI‑modellen is probabilistisch, dus soms fout. Begrip van faalmodi is cruciaal voor iedereen die klantgerichte tools bouwt. Je moet bekend zijn met concepten als model collapse (hoe synthetische data modellen degradeert) en de mechanismen achter deepfakes.
Om gelijke tred te houden met de industrie in plaats van de hypecyclus, volg je de doeners. De Top 13 AI-conferenties voor 2026-lijst is een goede plek om te zien waar engineers ervaringen uitwisselen over wat echt werkt in productie.
Conclusie
Stanford-faculteit karakteriseerde het huidige moment onlangs als een verschuiving van “evangeliseren naar evalueren”. Dat vangt de realiteit perfect. We gaan voorbij de vraag óf AI ertoe doet naar de weerbarstige details van waar het helpt en hoe je het verantwoord inzet.
Hoewel AGI-tijdlijnen speculatief blijven en het regelgevingslandschap verschuift, is de praktische richting duidelijk: agentische AI zal bedrijfsworkflows binnentrekken, en kleine modellen zullen routinetaken afhandelen. Het terugkerende thema is augmentatie, geen vervanging. De interessantste toekomst is niet die waarin AI alles doet, maar die waarin mensen systemen ontwerpen die hun eigen expertise versterken.
De beste strategie nu is eenvoudig: werk met de tools, blijf gezond sceptisch over zowel hype als doem, en zie leren als een continu proces. De veranderingen gebeuren toch wel, dus je kunt maar beter zelf achter het stuur zitten!


Toen ChatGPT in november 2022 werd gelanceerd en in slechts twee maanden honderd miljoen gebruikers aantrok, zette ik het eerlijk gezegd weg als een overhypte chatbot. Die inschatting is slecht oud geworden. Tegenwoordig vertrouw ik (en bijna iedereen met wie ik werk) dagelijks op AI-codingtools, en de discussies uit 2023 over of een bot een fatsoenlijke e-mail kan schrijven voelen compleet gedateerd. Dus wat is de toekomst van AI?
De sector is voorbij die eerste vragen en opereert nu op een totaal andere schaal. Anthropic passeerde onlangs $7 miljard aan terugkerende omzet, en techreuzen pompen geld in datacenters op niveaus die vijf jaar geleden absurd hadden geleken. De vraag die er nu toe doet is dan ook niet meer óf AI werkt, maar wat er gebeurt wanneer het niet meer op prompts wacht en zelf gaat bepalen wat de volgende stap is.
Dit artikel gaat in op waar de technologie naartoe lijkt te gaan. Ik kijk naar agentische AI, het verhitte debat over de AGI-tijdlijn, en de opkomst van kleinere modellen die je lokaal kunt draaien. We bekijken ook verschuivingen op de arbeidsmarkt, codingtools, toepassingen in de zorg en de stand van regelgeving. Laten we erin duiken!
Als je nog niet bekend bent met sommige AI-concepten, raad ik onze AI Fundamentals skill track aan, die alle basisbeginselen behandelt die je moet kennen.
Van generatieve naar agentische AI
Het heen-en-weer van de chatbot maakt plaats voor een autonomere aanpak. In dit deel lees je hoe die verschuiving er in de praktijk uitziet, waar de echte implementatie-uitdagingen liggen en waarom de meeste organisaties nog steeds worstelen om agenten in productie te krijgen.
De opkomst van autonome agenten
De afgelopen jaren volgden AI-tools een voorspelbaar ritme. Jij prompt, het antwoordt. De mens stuurde, AI reed mee. Die dynamiek verschuift: agentische AI-systemen beantwoorden niet alleen vragen; ze formuleren plannen om doelen te bereiken.
Stel, je wilt in december een reis naar Barcelona boeken. In plaats van een lijst met hotels te geven die je zelf moet uitzoeken, zou een agent het volgende doen:
Jij beschrijft het gewenste eindresultaat—het systeem regelt de stappen om je daar te krijgen.
De zakelijke honger hiernaar is enorm. Deloitte voorspelt dat 75% van de bedrijven tegen eind 2026 in agentische AI zal investeren. De realiteit blijft echter achter bij de visie. Een UiPath-enquête van medio 2025 wees uit dat, hoewel de interesse groot is, slechts 30% van de agent-implementaties daadwerkelijk de productiefase haalt.
De kloof dichten met MCP
Waardoor ontstaat die kloof? Vooral integratie. Toen onderzoekers bedrijven vroegen wat hen blokkeerde, wees 46% op het verbinden van AI-agenten met bestaande systemen. Een agent schrijven die code kan opstellen is één uitdaging. Hem betrouwbaar laten werken met je CRM, je ticketingsysteem, je interne API’s—zonder dingen stuk te maken of nieuwe problemen te creëren—blijkt een totaal andere uitdaging.
Om dit op te lossen, schaart de sector zich achter open standaarden zoals Anthropic’s Model Context Protocol (MCP) en OpenAI’s AGENTS.md-specificatie, die beide mikken op neutraal beheer van open infrastructuur en zijn ingebracht bij de Agentic AI Foundation.
Vooral MCP wint veel terrein. Zie het als “USB‑C voor AI”—een standaardconnector waardoor agenten eenvoudig met verschillende tools en platforms kunnen praten. Om er een paar te noemen: het biedt integratie met Claude, Cursor, Microsoft Copilot, VSCode, Gemini en ChatGPT.
Wil je verder dan demo’s? Bekijk dan onze cursussen over agentische AI voor de concepten en Designing Agentic Systems with LangChain voor de praktijk.
Is Artificial General Intelligence (AGI) nabij?
De tijdlijn naar Artificial General Intelligence (AGI)—AI-systemen die op menselijk niveau taken kunnen uitvoeren over domeinen heen—hangt volledig af van wie je het vraagt.
De CEO’s van grote AI-labs zijn agressief: Dario Amodei van Anthropic noemde 2026–2027 voor systemen die Nobelprijswinnaars evenaren over velden heen (“een land vol genieën in een datacenter”). Ook Sam Altman en Demis Hassabis wijzen op de komende 3–5 jaar.
Belangrijk om te noteren: deze bedrijven zijn afhankelijk van investeerdersenthousiasme om dure research te financieren, dus optimistische tijdlijnen dienen een strategisch doel.
Sceptici zijn koeler. Gary Marcus noemt de afgelopen maanden “vernietigend” voor AGI-optimisme, en voormalig OpenAI-onderzoeker Andrej Karpathy plaatst AGI op z’n minst een decennium weg. Een brede enquête uit 2023 onder onderzoekers schatte de mediane aankomstdatum nog verder, op 2047.
Uiteindelijk biedt Stanford’s HAI het nuttigste kader: we bewegen van “evangeliseren naar evalueren”. De belangrijkste vraag is niet wanneer AGI arriveert, maar hoe goed huidige systemen specifieke taken vandaag aankunnen versus waar ze nog menselijke controle nodig hebben.
Opkomende AI-technologieën voorbij LLM’s
Niet alles wat interessant is in AI draait om grotere modellen. Kleinere modellen, quantumcomputing en digital twins veranderen wat er mogelijk is aan de randen van het veld.
Small Language Models (SML’s) en edge AI
Terwijl iedereen het heeft over steeds grotere modellen, gaan er flinke investeringen naar kleinere. Gartner voorspelt dat organisaties Small Language Models (SML’s)—taakspecifieke modellen—drie keer zo vaak zullen inzetten als generieke grote modellen tegen 2027.
De redenen zijn praktisch:
NVIDIA-onderzoekers stellen dat de volgende sprong in AI niet de omvang is, maar specialisatie. Omdat taken als e-mailparsing of SQL-queries geen encyclopedische kennis vereisen, ziet de toekomstige architectuur eruit als modelvloten: meerdere gespecialiseerde modellen die samenwerken in plaats van één enorme generalist.
Google, Mistral, Microsoft en Alibaba zetten hier hard op in. Google AI Edge ondersteunt meer dan een dozijn modellen, waaronder Gemma 3n, hun eerste multimodale on-device model.
De aanpak van SLM’s en LLM’s vergeleken
De volgende tabel vergelijkt de twee aanpakken. Voor meer diepgang, lees ons artikel over SLM’s vs LLM’s.
Aspect
Large Language Models
Small Language Models
Waar ze draaien
Cloudservers
Apparaten, edge, lokale servers
Kosten per request
Hoger ($0,01–0,10)
Fracties van een cent
Responstijd
Netwerkafhankelijk (100–500 ms)
Onder 50 ms
Dataverwerking
Verlaat het apparaat
Blijft lokaal
Maatwerk
Resource-intensief
Toegankelijker
Beste voor
Complex redeneren, creatief werk, brede kennis
Specifieke taken, betrouwbaarheid, snelheid
Energieverbruik
Aanzienlijk
Bescheiden
Grote modellen worden niet irrelevant. Complexe problemen profiteren nog steeds van hun kracht. De toekomst zal waarschijnlijk beide omvatten, met interessante vragen over wanneer je welke inzet.
De convergentie van quantumcomputing en AI
Quantumcomputing is al decennia “vijf jaar weg”, maar eind 2025 is er iets verschoven en dat verdient aandacht.
Google toonde een 13.000x versnelling ten opzichte van de Frontier-supercomputer met 65 qubits voor fysicasimulaties. IBM mikt op quantum advantage in 2026, en onderzoekers gebruiken neurale netwerken om qubitfouten in realtime te voorspellen en te corrigeren.
Het veld verschoof van theoretische belofte naar een engineeringprobleem.
De term die terrein wint is “quantum utility”. Het gaat niet om volledig quantumvoordeel over alle problemen, maar om quantumssystemen die specifieke problemen sneller of goedkoper oplossen dan klassieke alternatieven. De beoogde problemen zijn wiskundig zwaar, met zoveel variabelen dat klassieke computers vastlopen:
Onderzoekers van JPMorgan Chase behaalden onlangs een mijlpaal met een quantum streaming-algoritme dat grote datasets verwerkt met een exponentieel ruimtevoordeel. Dat is geen persbericht. Dat is peer-reviewed werk met meetbare resultaten.
Dat gezegd hebbende, de bandbreedte in voorspellingen is hier groot.
Manifold Markets, dat meer dan 100 quantumgerelateerde voorspellingen volgt, laat brede scepsis zien dat quantumcomputers klassieke systemen in 2026 zullen overtreffen in cryptografie of complexe biologische simulaties. De meeste waarnemers verwachten incrementele engineeringvooruitgang, geen doorbraak naar quantumvoordeel.
Maar dezelfde markten tonen sterk vertrouwen dat bruikbare fouttolerante quantumcomputers binnen het decennium arriveren.
Wat betekent dit praktisch?
Praktisch gezien is de zelfstandige quantumcomputer een mythe. De industriestandaard is nu “heterogeneous compute”: hybride architecturen waarbij quantumprocessors in high‑performance centra naast GPU-clusters staan, met AI-systemen die de workflow beheren.
Voor data scientists in R&D-sectoren creëert dit een nieuwe vaardigheidseis. Quantumcloud-API’s van IBM, Google, Amazon Braket en Microsoft Azure Quantum laten je quantumsubroutines draaien zonder hardware te bezitten. De leercurve is niet triviaal, maar veel toegankelijker dan je eigen quantumlab bouwen.
De verschuiving in focus is subtiel maar belangrijk. Waar klassieke data science gefixeerd is op “big data”, draait quantumcomputing om “complexe optimalisatie”. Het pakt problemen aan met combinatorische explosies, zoals moleculaire modellering, logistiek of financieel risico met duizenden gecorreleerde factoren. Voor deze gebieden verschuiven quantumtools van theoretisch naar relevant.
Digital twins en simulatie
Digital twins bewegen van modewoord naar werkende infrastructuur. Het idee is eenvoudig: bouw een levendige virtuele kopie van een fysiek systeem (een productielijn, een magazijnnetwerk, een stroomnet, een stadswijk) en houd die gesynchroniseerd met de echte via sensoren, logs en operationele data. Vervolgens gebruik je de twin om beslissingen te stresstesten voordat je de realiteit aanraakt.
Fabrieken zijn de duidelijkste vroege case. Een moderne fabriek produceert al de data die een twin nodig heeft: PLC-signalen, machinetelemetrie, onderhoudshistorie, werkorders, kwaliteitsmetingen, voorraadbewegingen. AI zet die vloed om in een model dat je kunt bevragen. Niet alleen dashboards, maar ook tegenfeiten. Je kunt vragen beantwoorden als:
De waarde zit niet in het voorspellen van de verstoring. Het is het in kaart brengen van de neveneffecten—gemiste vensters, voorraadgaten, kosten van omleiding—zodat je oplossingen vooraf kunt doorrekenen in plaats van om 3 uur ’s nachts te improviseren.
De enabling shift is dat AI de kosten van het bouwen en onderhouden van deze modellen verlaagt. Moderne ML-modellen leren gedrag direct van live data, detecteren drift en houden de twin uitgelijnd terwijl het echte systeem verandert.
Kleine, gespecialiseerde modellen passen hier ook goed: één model voor anomaliedetectie op een turbine, een ander voor roosteroptimalisatie, weer een ander voor vraagvoorspelling—allemaal voedend in dezelfde gesimuleerde omgeving.
Wil je een scherper beeld van wat er komt, lees dan 9 Open-Source LLM’s voor 2026 om modellen zonder vendors te draaien en te fine-tunen, en Top 13 AI-conferenties voor 2026, waar de echte implementatiegesprekken zullen plaatsvinden.
De toekomst van AI in werk
Koppen over AI die banen overneemt missen vaak de nuance in de echte data. Het beeld dat uit onderzoek naar voren komt is rommeliger, geleidelijker en waarschijnlijk minder dramatisch dan optimisten of pessimisten suggereren.
Gaat AI banen vervangen?
De cijfers verdienen meer nuance dan koppen doorgaans bieden.
Het World Economic Forum ondervroeg meer dan 1.000 toonaangevende werkgevers voor hun Future of Jobs Report 2025. Zij voorspelden 170 miljoen nieuwe rollen en 92 miljoen verdrongen banen tussen 2025 en 2030, een nettogroei van 78 miljoen banen.
Hoewel dit netto positief is, is de verdeling cruciaal. In een studie uit november 2025 schatten onderzoekers van MIT en Boston University dat AI tegen 2026 ongeveer twee miljoen productiemedewerkers zal vervangen.
Het onderscheid dat je moet maken, is tussen taken en functies. AI automatiseert vaker specifieke activiteiten binnen banen dan dat het hele functies in één keer elimineert. Je accountant gaat nergens heen, maar de uren besteed aan datainvoer en reconciliatie krimpen.
MIT-onderzoek uit 2025 schatte dat momenteel automatiseerbare taken ongeveer 11,7% van de activiteiten van de Amerikaanse beroepsbevolking beslaan, wat neerkomt op zo’n $1,2 biljoen aan lonen. Dat betekent niet dat 11,7% van de werknemers hun baan verliest, maar wel dat aanzienlijke delen van wat zij doen nu als software kunnen draaien.
Banen die meer onder druk staan, zijn onder meer:
Banen met de volgende kenmerken staan minder onder druk:
Deze patronen gelden onder andere voor de zorg, vaktechnische beroepen, creatief werk en strategische besluitvorming.
Opkomende carrièrepaden
Er ontstaan nieuwe functiecategorieën, waarvan sommige vijf jaar geleden niet bestonden:
Het patroon dat ik zie: domeinexpertise gecombineerd met AI-vaardigheid creëert waarde. Een verpleegkundige die AI-diagnosetools begrijpt, levert betere uitkomsten dan iemand die ze mijdt. Een advocaat die AI gebruikt voor onderzoek en de grenzen kent, werkt sneller zonder kwaliteitsverlies.
Werkgeversenquêtes rangschikken analytisch denken steevast als de meest gevraagde vaardigheid. Zeven op de tien bedrijven noemen het essentieel. Daarna volgen veerkracht, aanpassingsvermogen en leiderschap.
Sectorspecifieke veranderingen
Sommige vakgebieden adopteerden AI-tools sneller dan andere, en de resultaten variëren meer dan je zou denken. Coderen, zorg en financiën vertellen elk een ander verhaal over wat werkt, wat niet, en waar de verrassingen zitten.
Coderen en data science
Softwareontwikkeling adopteerde AI-tools sneller dan de meeste velden. De tools blijven evolueren.
Volgens de Stack Overflow-enquête 2025 gebruikt circa 85% van de developers eind 2025 regelmatig AI-tools. GitHub meldt dat 41% van de code die Copilot-gebruikers wereldwijd maken AI-assistentie omvat. We zijn voorbij autocomplete: huidige systemen begrijpen hele repositories en voeren wijzigingen door in meerdere bestanden.
Marktleiders zijn opgestaan: GitHub Copilot heeft zo’n 42% marktaandeel, met meer dan 20 miljoen gebruikers en een aanwezigheid bij 90% van de Fortune 100. Cursor kwam uit het niets naar 18% marktaandeel in achttien maanden. Ze draaien naar verluidt $500 miljoen aan terugkerende omzet.
AI-tools blinken uit in bepaalde soorten programmeerwerk:
Toch is de kloof tussen perceptie en realiteit relevant.
In een METR-studie van juli 2025 gebruikten ervaren developers tools als Cursor Pro en Claude 3.5 Sonnet. Die developers rondden taken 19% trager af dan zonder AI-hulp—terwijl ze dachten 20% sneller te werken.
De les: productiviteitswinst hangt van de context af. AI-tools kunnen je zelfs vertragen wanneer het werk niet aansluit op hun sterke punten en jij het systeem beter begrijpt dan de AI.
De richting gaat nu naar meer autonome capaciteiten. GitHub’s Project Padawan vertegenwoordigt een model waarin developers issues toewijzen aan AI-systemen, de AI implementeert en mensen reviewen. De verschuiving gaat van AI die code voorstelt naar AI die features afrondt.
Voor data science geldt: minder tijd aan voorbereiding en meer aan interpretatie. AI kan SQL-queries en datacleaning overnemen. Zo krijgen data scientists tijd om de juiste vragen te stellen en de resultaten te duiden.
Zorg
AI in de zorg zit in complex terrein. Echte potentie, maar voorzichtige uitrol—wat gezien de inzet waarschijnlijk terecht is.
Door AI ondersteunde geneesmiddelenontwikkeling versnelt. AlphaFold en soortgelijke tools voorspellen eiwitstructuren in uren in plaats van jaren. Screening van combinaties gebeurt op eerder onpraktische schaal. Sommige schattingen suggereren dat AI de ontwikkeling van medicijnen met vier à vijf jaar per medicijn kan inkorten.
Diagnostiek is ook in specifieke domeinen verbeterd, met radiologie, pathologie en oftalmologie het verst. AI die getraind is op medische beeldvorming kan patronen vinden die menselijke reviewers missen.
Volgens McKinsey breidde de Mayo Clinic haar radiologieteam sinds 2016 met meer dan 50% uit terwijl ze honderden AI-modellen uitrolde. Die combinatie is opvallend: AI versterkte het werk in plaats van mensen te vervangen.
Voorzichtigheid is echter logisch. Beslissingen in de zorg hebben consequenties die socialmedia-aanbevelingen niet hebben: verkeerde diagnoses kunnen patiënten schaden. De wetenschappelijke en medische eis om te begrijpen hoe modellen tot conclusies komen—niet alleen of ze accuraat zijn—creëert echte beperkingen.
De realiteit op korte termijn is AI als diagnostische assistent. Systemen kunnen mogelijke problemen markeren, tests voorstellen en dingen opvangen die in drukke omgevingen kunnen ontsnappen. Maar uiteindelijk nemen artsen de eindbeslissingen en onderhouden ze de patiëntrelatie.
Remote monitoring versnelt doordat small language models direct op wearables draaien. Door data lokaal op het apparaat te verwerken, minimaliseren deze systemen de latentie en waarborgen ze privacy, waarbij AI alleen specifieke afwijkingen voor menselijke review markeert.
Financiën
Financiële diensten waren vroege AI-adopters en beheersten jaren geleden al razendsnelle fraudedetectie, maar agentische capaciteiten duwen de sector nieuw terrein in.
Terwijl gevestigde tools fraude en routinevragen in de klantenservice afhandelen, ligt de actieve frontier nu bij hyperpersonalisatie. Nieuwe systemen kunnen individuele risicotolerantie en financiële doelen analyseren om geavanceerde vermogensstrategieën aan een veel breder publiek te bieden.
Deze vooruitgang gaat echter gepaard met een waarschuwing: toezichthouders onderzoeken deze modellen steeds intensiever om te waarborgen dat historische bias in leningdata niet wordt gereproduceerd door de algoritmen.
AI-uitdagingen en regelgeving
Technische beperkingen en beleidslacunes creëren echte grenzen aan wat AI verantwoord kan doen. Het blackboxprobleem, gegenereerde desinformatie en een gefragmenteerd regelgevingslandschap bepalen allemaal wat daadwerkelijk inzetbaar is versus wat theoretisch mogelijk is.
Technische en sociale kwesties
Het blackboxprobleem is niet opgelost. Als modellen beslissingen nemen, blijft begrijpen waarom lastig. Dat is problematisch wanneer beslissingen leningen, werk en medische zorg raken.
Onderzoek focust op interpretability. De Stanford HAI-faculteit verwacht in 2026 meer aandacht voor wat zij “archeologie van high‑performing neural nets” noemen. Technieken zoals sparse autoencoders helpen identificeren welke trainingsfeatures gedrag daadwerkelijk aansturen.
Gegenereerde content veroorzaakt extra problemen: deepfakes en AI-geproduceerde desinformatie worden met de dag lastiger te detecteren. Sommige schattingen suggereren dat AI‑gegenereerde artikelen online qua volume al menselijk geschreven content overtreffen.
Model collapse kan een gevolg zijn en baart onderzoekers zorgen. Als modellen steeds meer trainen op AI‑gegenereerde content, die een groeiend deel van beschikbare data vormt, kan de kwaliteit achteruitgaan. Modellen consumeren hun eigen outputs op manieren die fouten versterken.
Regelgevingslandschap
Rechtsgebieden kiezen verschillende aanpakken.
De EU AI Act is momenteel het meest allesomvattende AI‑regelboek. Het is opgebouwd rond een risicoladder: hoe hoger het risico, hoe zwaarder de verplichtingen. Systemen die worden gebruikt voor beslissingen rond werk en krediet vallen in de “hoog risico”-categorie, met strengere eisen rond documentatie, controls en toezicht.
De verordening trad op 1 augustus 2024 in werking, maar de meeste verplichtingen worden gefaseerd ingevoerd in de jaren daarna.
Energie verschijnt op een smaller, praktischer vlak: aanbieders van general‑purpose AI‑modellen moeten mogelijk het energieverbruik documenteren (of schattingen geven afgeleid van compute wanneer exacte meting niet haalbaar is). Los van de AI Act worden EU-rapportageverplichtingen voor datacenters en energie-efficiëntie aangescherpt, wat ertoe doet omdat AI‑workloads een belangrijke nieuwe driver van elektriciteitsvraag zijn.
In de praktijk stuurt dit teams naar een “goed-genoeg”-architectuur die efficiëntie boven pure rekenkracht stelt. Door kleinere modellen te gebruiken en inference aan de edge te draaien, kunnen ontwikkelaars minder tokens door dure clouds sturen en zo rekenkosten, stroomverbruik en datatransport verlagen.
In de VS is de situatie veel onzekerder. Federale wetgeving zit op slot, en met het mislukken van pogingen in 2025 om staatsregels te overrulen, versplintert het regelgevingsklimaat. Bouwers krijgen in 2026 dus te maken met een bewegend doelwit van state‑by‑state compliance in plaats van een eenduidig federaal kader.
Voorbereiden op de toekomst van AI
Wat helpt nu echt om professioneel relevant te blijven? Ter voorbereiding raad ik aan om AI-gerelateerde concepten te bestuderen, technische skills te ontwikkelen en praktijkervaring op te doen.
Data- en AI-geletterdheid
Datageletterdheid is niet langer optioneel. Je hoeft geen data scientist te zijn, maar je moet wel begrijpen hoe data stroomt, wat het betrouwbaar maakt en hoe je modeluitvoer interpreteert.
Heb je een gestructureerde basis nodig, dan dekt de Data Literacy Professional skill track alle essentials en biedt je een certificering om te tonen wat je hebt geleerd. Voor een meer AI-georiënteerde theoretische start raad ik aan je in te schrijven voor de AI Fundamentals skill track.
Technische skills
Basis technische skills blijven het onderscheid maken. AI-tools maken coderen toegankelijker, maar je moet de logica begrijpen om de output te verifiëren. Python en SQL zijn hier de “daily drivers”.
Een solide aanpak is: leer eerst de taal, dan de AI‑laag. Begin met Introduction to Python om de syntaxis te snappen. Ga daarna verder met Generative AI Concepts om te begrijpen hoe moderne assistenten zich gedragen—en waar ze falen.
Domeinexpertise en agenten
De grootste verschuiving is van chatbots naar agenten. Alleen prompten wordt een commodity. Waarde zit in het ontwerpen van workflows die integreren met systemen in de echte wereld.
Domeinexpertise behoudt waarde. AI‑tools goed kennen, gecombineerd met diepe vakkennis, levert meer op dan elk afzonderlijk. De snelste manier om die combinatie concreet te maken is één domeinworkflow kiezen en leren hoe agenten daarop inpluggen.
Om deze architectuur te begrijpen, schrijf je in voor onze AI Agent Fundamentals skill track voor het mentale model. Heb je het theoretische deel gehad, volg dan de Designing Agentic Systems with LangChain-cursus om hands-on ervaring op te doen met het bouwen van een werkend systeem end‑to‑end. Zien waar deze agenten breken is net zo waardevol als zien waar ze werken.
Omgaan met onzekerheid
Tot slot: kweek comfort met onzekerheid. Uitvoer van AI‑modellen is probabilistisch, dus soms fout. Begrip van faalmodi is cruciaal voor iedereen die klantgerichte tools bouwt. Je moet bekend zijn met concepten als model collapse (hoe synthetische data modellen degradeert) en de mechanismen achter deepfakes.
Om gelijke tred te houden met de industrie in plaats van de hypecyclus, volg je de doeners. De Top 13 AI-conferenties voor 2026-lijst is een goede plek om te zien waar engineers ervaringen uitwisselen over wat echt werkt in productie.
Conclusie
Stanford-faculteit karakteriseerde het huidige moment onlangs als een verschuiving van “evangeliseren naar evalueren”. Dat vangt de realiteit perfect. We gaan voorbij de vraag óf AI ertoe doet naar de weerbarstige details van waar het helpt en hoe je het verantwoord inzet.
Hoewel AGI-tijdlijnen speculatief blijven en het regelgevingslandschap verschuift, is de praktische richting duidelijk: agentische AI zal bedrijfsworkflows binnentrekken, en kleine modellen zullen routinetaken afhandelen. Het terugkerende thema is augmentatie, geen vervanging. De interessantste toekomst is niet die waarin AI alles doet, maar die waarin mensen systemen ontwerpen die hun eigen expertise versterken.
De beste strategie nu is eenvoudig: werk met de tools, blijf gezond sceptisch over zowel hype als doem, en zie leren als een continu proces. De veranderingen gebeuren toch wel, dus je kunt maar beter zelf achter het stuur zitten!