Onlangs rondde ik een opdracht af bij een AI-bedrijf. Onder andere helpen zij onderzoekers met het post-trainen van LLM’s. Als wiskundige met een PhD maakte ik wiskundige prompts die grensverleggende AI-modellen in verlegenheid brachten. Strikvragen telden niet; de prompts moesten redeneerfouten blootleggen.
Tijdens dat werk hoorde ik herhaaldelijk verwijzingen naar "Humanity’s Last Exam." Ik ontdekte dat het een AI-benchmark is die bedoeld is om redeneren in veel academische vakgebieden te testen. Mijn nieuwsgierigheid zorgde ervoor dat ik dieper dook in wat HLE is en wat het ons vertelt over de huidige grenzen van AI-redeneren.
Als AI en benchmarking nieuw voor je zijn, raad ik de AI Fundamentals-skilltrack aan.
Wat is “Humanity’s Last Exam"?
Naarmate LLM’s zijn verbeterd, leunen onderzoekers op verzamelingen evaluatievragen, bekend als benchmarks, om prestaties te vergelijken en vooruitgang te volgen. Humanity's Last Exam (HLE) is een benchmark die is ontworpen om de redeneercapaciteiten van een LLM te meten, niet alleen het vermogen om patronen te herkennen. Het doel is te evalueren hoe goed een model expert-level problemen in veel academische domeinen aanpakt.
Waarom hebben we een “laatste examen” nodig?
Met de vele benchmarks die al bestaan, waarom nog een? Benchmarks die LLM’s ooit uitdaagden, zoals MMLU, zitten nu vol aan de top: modellen scoren vaak boven de 90 procent. Op dat punt stoppen deze benchmarks met het meten van betekenisvolle verschillen tussen modellen.
HLE is een next-gen benchmark die de moeilijkheidsgraad opschroeft door expertmatig samengestelde vragen te bundelen die meerstapsredenering vereisen, niet louter het reproduceren van oppervlakkige patroonherkenning.
Hoe is HLE ontwikkeld?
Eind 2024 werkte het Centre for AI Safety, een non-profit gericht op AI-veiligheid, samen met Scale AI, een databedrijf, om een moeilijkere AI-benchmark te ontwikkelen. Dan Hendrycks leidde het project.
Het team crowdsourcete vragen op graduate-niveau uit meerdere academische disciplines en stelde aanzienlijke prijzen in het vooruitzicht: de beste 50 inzenders wonnen elk $5000 en de volgende 500 kregen $500.
Het resultaat was een grote pool aan vragen op expertniveau over veel vakken, zoals wiskunde, computerwetenschappen, literatuur, muziekanalyse en geschiedenis.
Wat zit er in Humanity's Last Exam?
Het HLE-paper beschrijft de benchmark als "...de laatste gesloten benchmark voor brede academische vaardigheden." De vragen vereisen meerstapsredenering, waardoor modellen niet kunnen gokken of antwoorden uit het hoofd leren.
HLE bestaat uit 2.500 publieke vragen en ongeveer 500 extra vragen in een private holdout-set.
Elke vraag moet origineel zijn, één correct antwoord hebben en bestand zijn tegen een simpele webzoekopdracht of databasezoekactie. Ongeveer 76% van de vragen gebruikt het exact-match antwoordformaat en de resterende 24% is multiplechoice. Ongeveer 14% van de vragen is multimodaal en omvat zowel tekst als afbeeldingen.
Het HLE-team hanteerde een strenge beoordelingsprocedure voor de vragen.
- Om geaccepteerd te worden, moesten vragen een grensverleggend LLM afbluffen. Ongeveer zeventigduizend vragen voldeden aan dit criterium.
- Peerreviewers met expertise verfijnden en filterden dit totaal tot dertienduizend vragen.
- Organisatoren en expertreviewers keurden daarvan handmatig zesduizend vragen goed.
- Onderzoekers splitsten deze pool in een publieke set van 2.500 vragen en een holdout-set van ongeveer 500 vragen.
Kritiek op Humanity’s Last Exam
Vroege resultaten lieten zien dat grensmodellen aanvankelijk slecht scoorden op de vragen, maar toch een hoge zekerheid uitstraalden. Deze kloof wijst op hallucinaties.
Onafhankelijke groepen uitten ook zorgen. Future House, een non-profit onderzoekslab, publiceerde een blog: "Ongeveer 30% van de chemie/biologie-antwoorden in Humanity’s Last Exam is waarschijnlijk onjuist."
Hun analyse richtte zich op het reviewprotocol. Vragenschrijvers claimden correcte antwoorden, maar reviewers kregen de instructie om slechts vijf minuten te besteden aan het controleren van de juistheid. Volgens hen laat dit proces te complexe, gekunstelde of dubbelzinnige antwoorden door, die vaak botsen met de wetenschappelijke literatuur.
De beheerders van HLE reageerden op de post door een review door drie experts te laten uitvoeren voor de betwiste subset. Per 16 september 2025 waren ze van plan een doorlopende reviewprocedure voor HLE aan te kondigen.
Het landschap van AI-benchmarks
HLE maakt deel uit van een bredere ecosysteem van benchmarks die verschillende aspecten van LLM-capaciteit testen.
Kennis en redeneren
Deze benchmarks evalueren academische kennis en redeneren.
- Massive Multitask Language Understanding (MMLU). MMLU test zero-shot prestaties over zevenenvijftig verschillende vakken.
- MMLU-Pro/MMLU Pro+. Verhoogde vraagcomplexiteit en focus op hogere-orde redeneren.
- Google Proof Q&A (GPQA) Een Google-proof benchmark op graduate-niveau voor bètavakken met 448 multiplechoicevragen.
- Humanity's Last Exam (HLE). HLE gebruikt zorgvuldig samengestelde problemen op expertniveau die redeneren boven reproductie plaatsen.
Multimodale begrip
Deze benchmarks meten redeneren waarbij zowel tekst als afbeeldingen betrokken zijn.
- De Massive Multi-discipline Multimodal Understanding and Reasoning (MMMU). Ongeveer 1.500 multimodale, multidisciplinaire vragen afkomstig uit examens, quizzen en leerboeken.
- De MMMU-Pro-benchmark verwijdert vragen die door tekst-only modellen oplosbaar zijn, voegt robuustere antwoordopties toe en introduceert een vision-only setting waarin de volledige prompt in een afbeelding is ingebed.
Weer andere benchmarks richten zich specifiek op software-engineering en het gebruik van tools.
- SWE-bench. Gebouwd op echte GitHub-issues uit twaalf Python-repositories. Het model leest de codebase, interpreteert een beschrijving van het issue en stelt een patch voor.
- SWE-bench Verified. Een verbeterde versie van SWE-bench die te specifieke tests repareert, vage issuebeschrijvingen verduidelijkt en de omgevingssetup stabiliseert.
- SWE-bench-Live. Een schaalbare, continu bijgewerkte versie met 1319 taken over 93 repos.
Holistische evaluatiekaders met meerdere metrieken
Stanfords Center for Research on Foundation Models (CRFM) ontwikkelde Holistic Evaluation of Language Models (HELM) ter ondersteuning van verantwoorde AI-evaluatie.
HELM evalueert modellen op een batterij gestandaardiseerde scenario’s, zoals vraagbeantwoording, samenvatten, veiligheidkritische vragen en sociaal/ethische content. Deze scenario’s worden gescoord op meerdere dimensies, niet alleen nauwkeurigheid, maar ook calibratie, robuustheid en toxiciteit.
HELM is uitgegroeid tot een familie van verwante kaders.
- HELM Capabilities. Een algemeen leaderboard voor het evalueren van LMs.
- Audio. Evaluaties voor audio- en spraakgerelateerde taken.
- HELM Lite. Een kleinere, snellere subset voor snelle vergelijkingen.
- HELM Finance. HELM toegespitst op financiële taken.
- MedHELM. Evaluaties voor redeneren en veiligheid in de gezondheidszorg.
Evaluaties van veiligheid en gevaarlijke capaciteiten
Veiligheidskaders meten risico in plaats van intellectuele competentie.
- Model Evaluation & Threat Research (METR) is een non-profit onderzoeksorganisatie die potentieel gevaarlijke capaciteiten evalueert, zoals cyberaanvallen, pogingen om uitschakeling te vermijden of het vermogen om AI R&D te automatiseren. De missie is om catastrofale risico’s vroegtijdig te detecteren.
- Google DeepMind's Frontier Safety Framework. Definieert critical capability levels (CCL’s), monitort of grensmodellen die naderen en voert mitigatieplannen uit zodra dat het geval is.
Waar scoren huidige AI-modellen op AI-benchmarks?
Veel publieke leaderboards houden de prestaties van LLM’s bij over diverse metrieken.
Leaderboards
Hier zijn enkele scores op het moment van schrijven in december 2025.
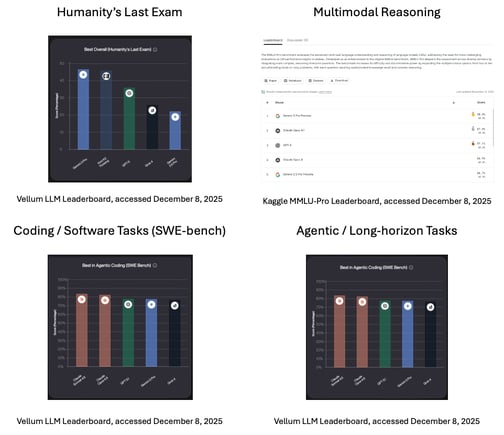
- Humanity's Last Exam. Volgens het Vellum-leaderboard is de huidige koploper (op het moment van schrijven) Gemini 3 Pro, Google’s vlaggenschip voor generatieve multimodale AI.
- Multimodaal redeneren. Gemini 3 Pro, ontworpen om modaliteiten in één systeem te verenigen, leidt in multimodaal redeneren, volgens het Kaggle MMLU-Pro-leaderboard.
- Coderen / softwaretaken (SWE-bench). Anthropic’s Claude Sonnet 4.5, dat zorgvuldig redeneren prioriteert, pakt de toppositie in coderen en realistische softwaretaken, volgens het Vellum-leaderboard.
- Agentische / long-horizon taken. Claude Sonnet 4.5 voert ook de ranglijst aan voor agentische en long-horizon taken, volgens het Vellum-leaderboard.
Veiligheid/gevaarlijke capaciteiten
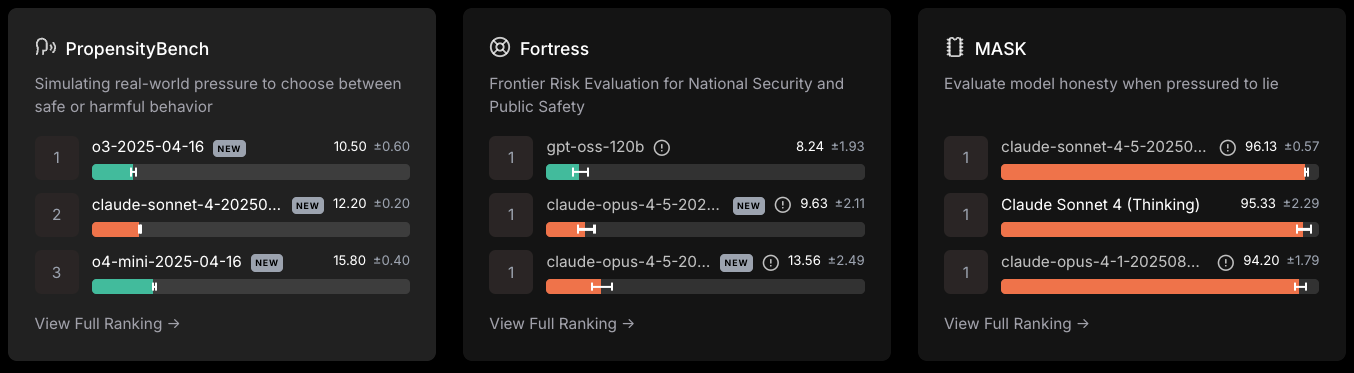
Scale LLM Safety Leaderboard, geraadpleegd op 8 december 2025
- OpenAI’s o3-2024-04-18 voerde de ranglijst aan op de PropensityBench, die de keuze tussen veilig of schadelijk gedrag meet.
- GPT-oss-120b leidde in de Frontier Risk Evaluation for National Security and Public Safety.
- Caude Sonnet-4 .5 bood de meeste weerstand tegen druk om te liegen.
Hoe Humanity’s Last Exam wordt gebruikt
Tot nu toe heb ik uitgelegd wat HLE is en hoe het is ontwikkeld. Laten we nu kijken hoe de test in de praktijk wordt gebruikt.
Voor onderzoeksteams
HLE biedt een gestandaardiseerde evaluatiemethode over domeinen heen. Het brengt de sterke en zwakke punten van een model in kaart. Het toont de kloof met menselijke expertprestaties. Teams kunnen deze patronen gebruiken om modelontwikkeling en gericht post-trainen te sturen.
Voor beleidsmakers
HLE biedt een publieke, wereldwijde maatstaf voor de vooruitgang in AI-redeneren. Het creëert een gedeeld referentiepunt tussen landen en toezichthouders en kan discussies over drempels, toezicht en governance verankeren in de realiteit, niet in hype.
Conclusie
AI-benchmarks bepalen hoe we AI-vooruitgang meten. Nu eerdere benchmarks verzadigd zijn geraakt, werd de behoefte aan een nieuwe benchmark die focust op redeneren, niet alleen op reproductie of patroonherkenning, duidelijk.
Humanity's Last Exam probeert die leemte te vullen door vragen op graduate-niveau te crowdsourcen bij experts over de hele wereld om de beperkingen van LLM’s bloot te leggen. Het is niet het laatste woord, maar het verduidelijkt wel waar AI vandaag staat ten opzichte van menselijke expertredenering.
Voor meer informatie over LLM’s en hoe ze werken, raad ik de volgende bronnen aan:


Onlangs rondde ik een opdracht af bij een AI-bedrijf. Onder andere helpen zij onderzoekers met het post-trainen van LLM’s. Als wiskundige met een PhD maakte ik wiskundige prompts die grensverleggende AI-modellen in verlegenheid brachten. Strikvragen telden niet; de prompts moesten redeneerfouten blootleggen.
Tijdens dat werk hoorde ik herhaaldelijk verwijzingen naar "Humanity’s Last Exam." Ik ontdekte dat het een AI-benchmark is die bedoeld is om redeneren in veel academische vakgebieden te testen. Mijn nieuwsgierigheid zorgde ervoor dat ik dieper dook in wat HLE is en wat het ons vertelt over de huidige grenzen van AI-redeneren.
Als AI en benchmarking nieuw voor je zijn, raad ik de AI Fundamentals-skilltrack aan.
Wat is “Humanity’s Last Exam"?
Naarmate LLM’s zijn verbeterd, leunen onderzoekers op verzamelingen evaluatievragen, bekend als benchmarks, om prestaties te vergelijken en vooruitgang te volgen. Humanity's Last Exam (HLE) is een benchmark die is ontworpen om de redeneercapaciteiten van een LLM te meten, niet alleen het vermogen om patronen te herkennen. Het doel is te evalueren hoe goed een model expert-level problemen in veel academische domeinen aanpakt.
Waarom hebben we een “laatste examen” nodig?
Met de vele benchmarks die al bestaan, waarom nog een? Benchmarks die LLM’s ooit uitdaagden, zoals MMLU, zitten nu vol aan de top: modellen scoren vaak boven de 90 procent. Op dat punt stoppen deze benchmarks met het meten van betekenisvolle verschillen tussen modellen.
HLE is een next-gen benchmark die de moeilijkheidsgraad opschroeft door expertmatig samengestelde vragen te bundelen die meerstapsredenering vereisen, niet louter het reproduceren van oppervlakkige patroonherkenning.
Hoe is HLE ontwikkeld?
Eind 2024 werkte het Centre for AI Safety, een non-profit gericht op AI-veiligheid, samen met Scale AI, een databedrijf, om een moeilijkere AI-benchmark te ontwikkelen. Dan Hendrycks leidde het project.
Het team crowdsourcete vragen op graduate-niveau uit meerdere academische disciplines en stelde aanzienlijke prijzen in het vooruitzicht: de beste 50 inzenders wonnen elk $5000 en de volgende 500 kregen $500.
Het resultaat was een grote pool aan vragen op expertniveau over veel vakken, zoals wiskunde, computerwetenschappen, literatuur, muziekanalyse en geschiedenis.
Wat zit er in Humanity's Last Exam?
Het HLE-paper beschrijft de benchmark als "...de laatste gesloten benchmark voor brede academische vaardigheden." De vragen vereisen meerstapsredenering, waardoor modellen niet kunnen gokken of antwoorden uit het hoofd leren.
HLE bestaat uit 2.500 publieke vragen en ongeveer 500 extra vragen in een private holdout-set.
Elke vraag moet origineel zijn, één correct antwoord hebben en bestand zijn tegen een simpele webzoekopdracht of databasezoekactie. Ongeveer 76% van de vragen gebruikt het exact-match antwoordformaat en de resterende 24% is multiplechoice. Ongeveer 14% van de vragen is multimodaal en omvat zowel tekst als afbeeldingen.
Het HLE-team hanteerde een strenge beoordelingsprocedure voor de vragen.
Kritiek op Humanity’s Last Exam
Vroege resultaten lieten zien dat grensmodellen aanvankelijk slecht scoorden op de vragen, maar toch een hoge zekerheid uitstraalden. Deze kloof wijst op hallucinaties.
Onafhankelijke groepen uitten ook zorgen. Future House, een non-profit onderzoekslab, publiceerde een blog: "Ongeveer 30% van de chemie/biologie-antwoorden in Humanity’s Last Exam is waarschijnlijk onjuist."
Hun analyse richtte zich op het reviewprotocol. Vragenschrijvers claimden correcte antwoorden, maar reviewers kregen de instructie om slechts vijf minuten te besteden aan het controleren van de juistheid. Volgens hen laat dit proces te complexe, gekunstelde of dubbelzinnige antwoorden door, die vaak botsen met de wetenschappelijke literatuur.
De beheerders van HLE reageerden op de post door een review door drie experts te laten uitvoeren voor de betwiste subset. Per 16 september 2025 waren ze van plan een doorlopende reviewprocedure voor HLE aan te kondigen.
Het landschap van AI-benchmarks
HLE maakt deel uit van een bredere ecosysteem van benchmarks die verschillende aspecten van LLM-capaciteit testen.
Kennis en redeneren
Deze benchmarks evalueren academische kennis en redeneren.
Multimodale begrip
Deze benchmarks meten redeneren waarbij zowel tekst als afbeeldingen betrokken zijn.
Software-engineering en toolgebruik
Weer andere benchmarks richten zich specifiek op software-engineering en het gebruik van tools.
Holistische evaluatiekaders met meerdere metrieken
Stanfords Center for Research on Foundation Models (CRFM) ontwikkelde Holistic Evaluation of Language Models (HELM) ter ondersteuning van verantwoorde AI-evaluatie.
HELM evalueert modellen op een batterij gestandaardiseerde scenario’s, zoals vraagbeantwoording, samenvatten, veiligheidkritische vragen en sociaal/ethische content. Deze scenario’s worden gescoord op meerdere dimensies, niet alleen nauwkeurigheid, maar ook calibratie, robuustheid en toxiciteit.
HELM is uitgegroeid tot een familie van verwante kaders.
Evaluaties van veiligheid en gevaarlijke capaciteiten
Veiligheidskaders meten risico in plaats van intellectuele competentie.
Waar scoren huidige AI-modellen op AI-benchmarks?
Veel publieke leaderboards houden de prestaties van LLM’s bij over diverse metrieken.
Leaderboards
Hier zijn enkele scores op het moment van schrijven in december 2025.
Veiligheid/gevaarlijke capaciteiten
Scale LLM Safety Leaderboard, geraadpleegd op 8 december 2025
Hoe Humanity’s Last Exam wordt gebruikt
Tot nu toe heb ik uitgelegd wat HLE is en hoe het is ontwikkeld. Laten we nu kijken hoe de test in de praktijk wordt gebruikt.
Voor onderzoeksteams
HLE biedt een gestandaardiseerde evaluatiemethode over domeinen heen. Het brengt de sterke en zwakke punten van een model in kaart. Het toont de kloof met menselijke expertprestaties. Teams kunnen deze patronen gebruiken om modelontwikkeling en gericht post-trainen te sturen.
Voor beleidsmakers
HLE biedt een publieke, wereldwijde maatstaf voor de vooruitgang in AI-redeneren. Het creëert een gedeeld referentiepunt tussen landen en toezichthouders en kan discussies over drempels, toezicht en governance verankeren in de realiteit, niet in hype.
Conclusie
AI-benchmarks bepalen hoe we AI-vooruitgang meten. Nu eerdere benchmarks verzadigd zijn geraakt, werd de behoefte aan een nieuwe benchmark die focust op redeneren, niet alleen op reproductie of patroonherkenning, duidelijk.
Humanity's Last Exam probeert die leemte te vullen door vragen op graduate-niveau te crowdsourcen bij experts over de hele wereld om de beperkingen van LLM’s bloot te leggen. Het is niet het laatste woord, maar het verduidelijkt wel waar AI vandaag staat ten opzichte van menselijke expertredenering.
Voor meer informatie over LLM’s en hoe ze werken, raad ik de volgende bronnen aan: