
{count, plural, one {Leerpad} other {Leerpaden}}
Associate Data Scientist in Python
{hours} uur
Het landschap van data science groeit snel, en er zijn veel tools beschikbaar om data scientists bij hun werk te helpen. In dit artikel bespreken we de top 10 data science-tools die je in 2026 kunt gebruiken. Deze tools helpen je bij het inladen, opschonen, verwerken, analyseren, visualiseren en modelleren van data. Daarnaast bieden sommige tools ook machinelearning-ecosystemen voor modeltracking, ontwikkeling, uitrol en monitoring.
Data science-tools zijn essentieel om data scientists en analisten te helpen waardevolle inzichten uit data te halen. Ze zijn nuttig voor het opschonen, manipuleren, visualiseren en modelleren van data.
Met de komst van ChatGPT worden steeds meer tools geïntegreerd met GPT-3.5- en GPT-4-modellen. De integratie van AI-ondersteunde tools maakt het nog eenvoudiger voor data scientists om data te analyseren en modellen te bouwen.
Zo hebben generatieve AI-mogelijkheden (PandasAI) hun weg gevonden naar eenvoudigere tools zoals pandas, waardoor gebruikers resultaten kunnen krijgen door prompts in natuurlijke taal te schrijven. Deze nieuwe tools worden echter nog niet op grote schaal gebruikt onder dataprofessionals.
Bovendien zijn data science-tools niet beperkt tot één functie. Ze bieden extra mogelijkheden om geavanceerde taken uit te voeren en bieden in sommige gevallen een volledig data science-ecosysteem. MLflow wordt bijvoorbeeld primair gebruikt voor modeltracking. Het kan echter ook worden gebruikt voor modelregistry, uitrol en inferentie.
De lijst met top 10-tools is gebaseerd op de volgende kernkenmerken:
In deze review verkennen we nieuwe en gevestigde tools die onmisbaar zijn geworden voor data scientists op de werkvloer. Deze tools delen een aantal gemeenschappelijke kenmerken: ze zijn gemakkelijk toegankelijk, gebruiksvriendelijk en bieden robuuste mogelijkheden voor data-analyse en machine learning.
Python wordt veel gebruikt voor data-analyse, verwerking en machine learning. De eenvoud en de grote ontwikkelaarscommunity maken het een populaire keuze.
pandas maakt het opschonen, manipuleren, analyseren en feature engineering van data in Python naadloos. Het is de meest gebruikte bibliotheek door dataprofessionals voor allerlei taken. Je kunt het tegenwoordig ook gebruiken voor datavisualisatie.
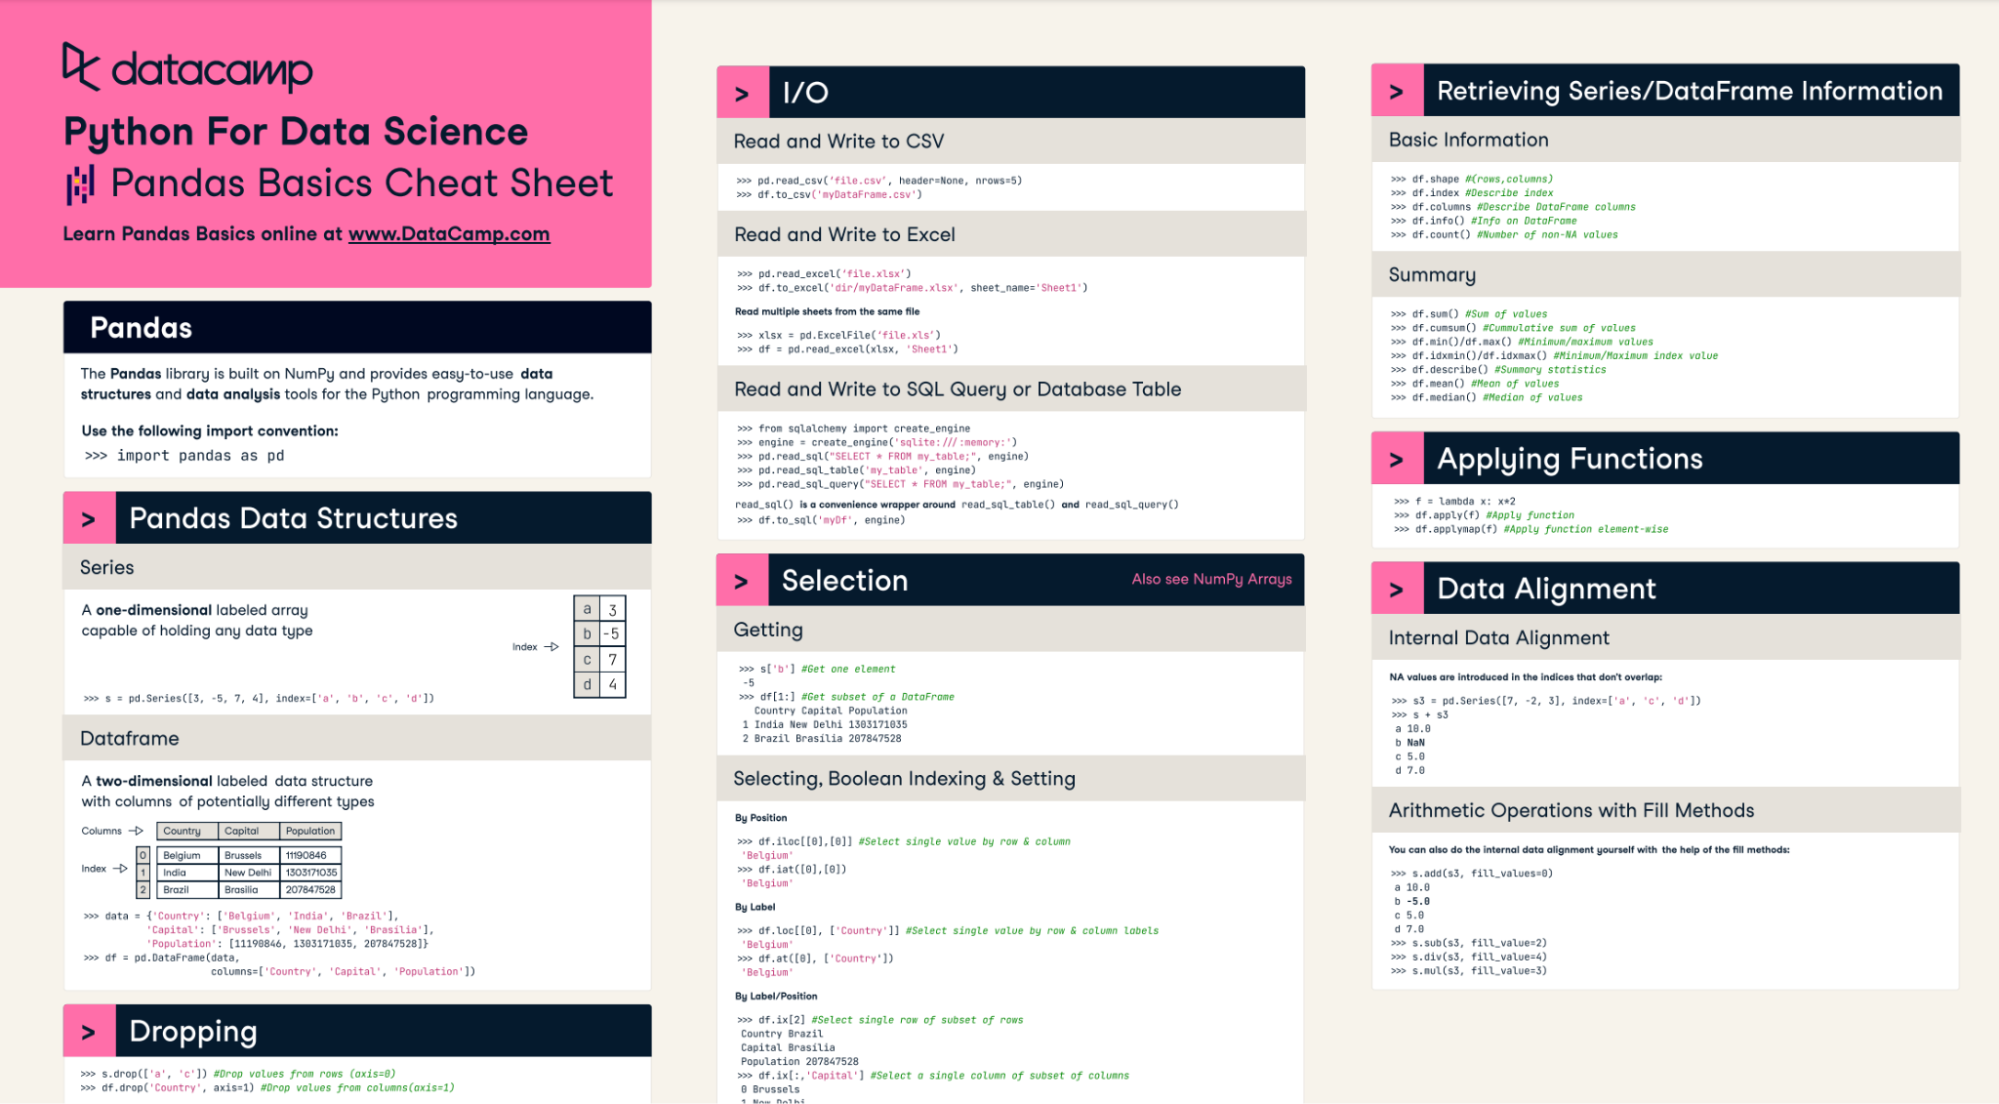
Onze pandas-cheatsheet helpt je deze data science-tool onder de knie te krijgen.
Seaborn is een krachtige datavisualisatiebibliotheek gebouwd boven op Matplotlib. Het wordt geleverd met een reeks mooie en doordachte standaardthema’s en is vooral handig in combinatie met pandas DataFrames. Met Seaborn maak je snel en eenvoudig heldere en expressieve visualisaties.
Scikit-learn is dé Python-bibliotheek voor machine learning. Deze bibliotheek biedt een consistente interface voor gangbare algoritmen, waaronder regressie, classificatie, clustering en dimensiereductie. Hij is geoptimaliseerd voor performance en wordt breed gebruikt door data scientists.
Open-sourceprojecten hebben een grote rol gespeeld in de vooruitgang van data science. Ze bieden een schat aan tools en resources die data scientists helpen efficiënter en effectiever te werken.
Jupyter Notebooks is een populaire open-source webapplicatie waarmee data scientists deelbare documenten kunnen maken die live code, visualisaties, vergelijkingen en tekstuele uitleg combineren. Ideaal voor verkennende analyse, samenwerking en rapportage.
Pytorch is een zeer flexibele en open-source machinelearningframework dat veel wordt gebruikt voor het ontwikkelen van neurale netwerkmodellen. Het biedt modulariteit en een enorme ecosysteem aan tools voor verschillende datatypes, zoals tekst, audio, beeld en tabeldata. Met GPU- en TPU-ondersteuning kun je je modeltraining tot wel 10x versnellen.
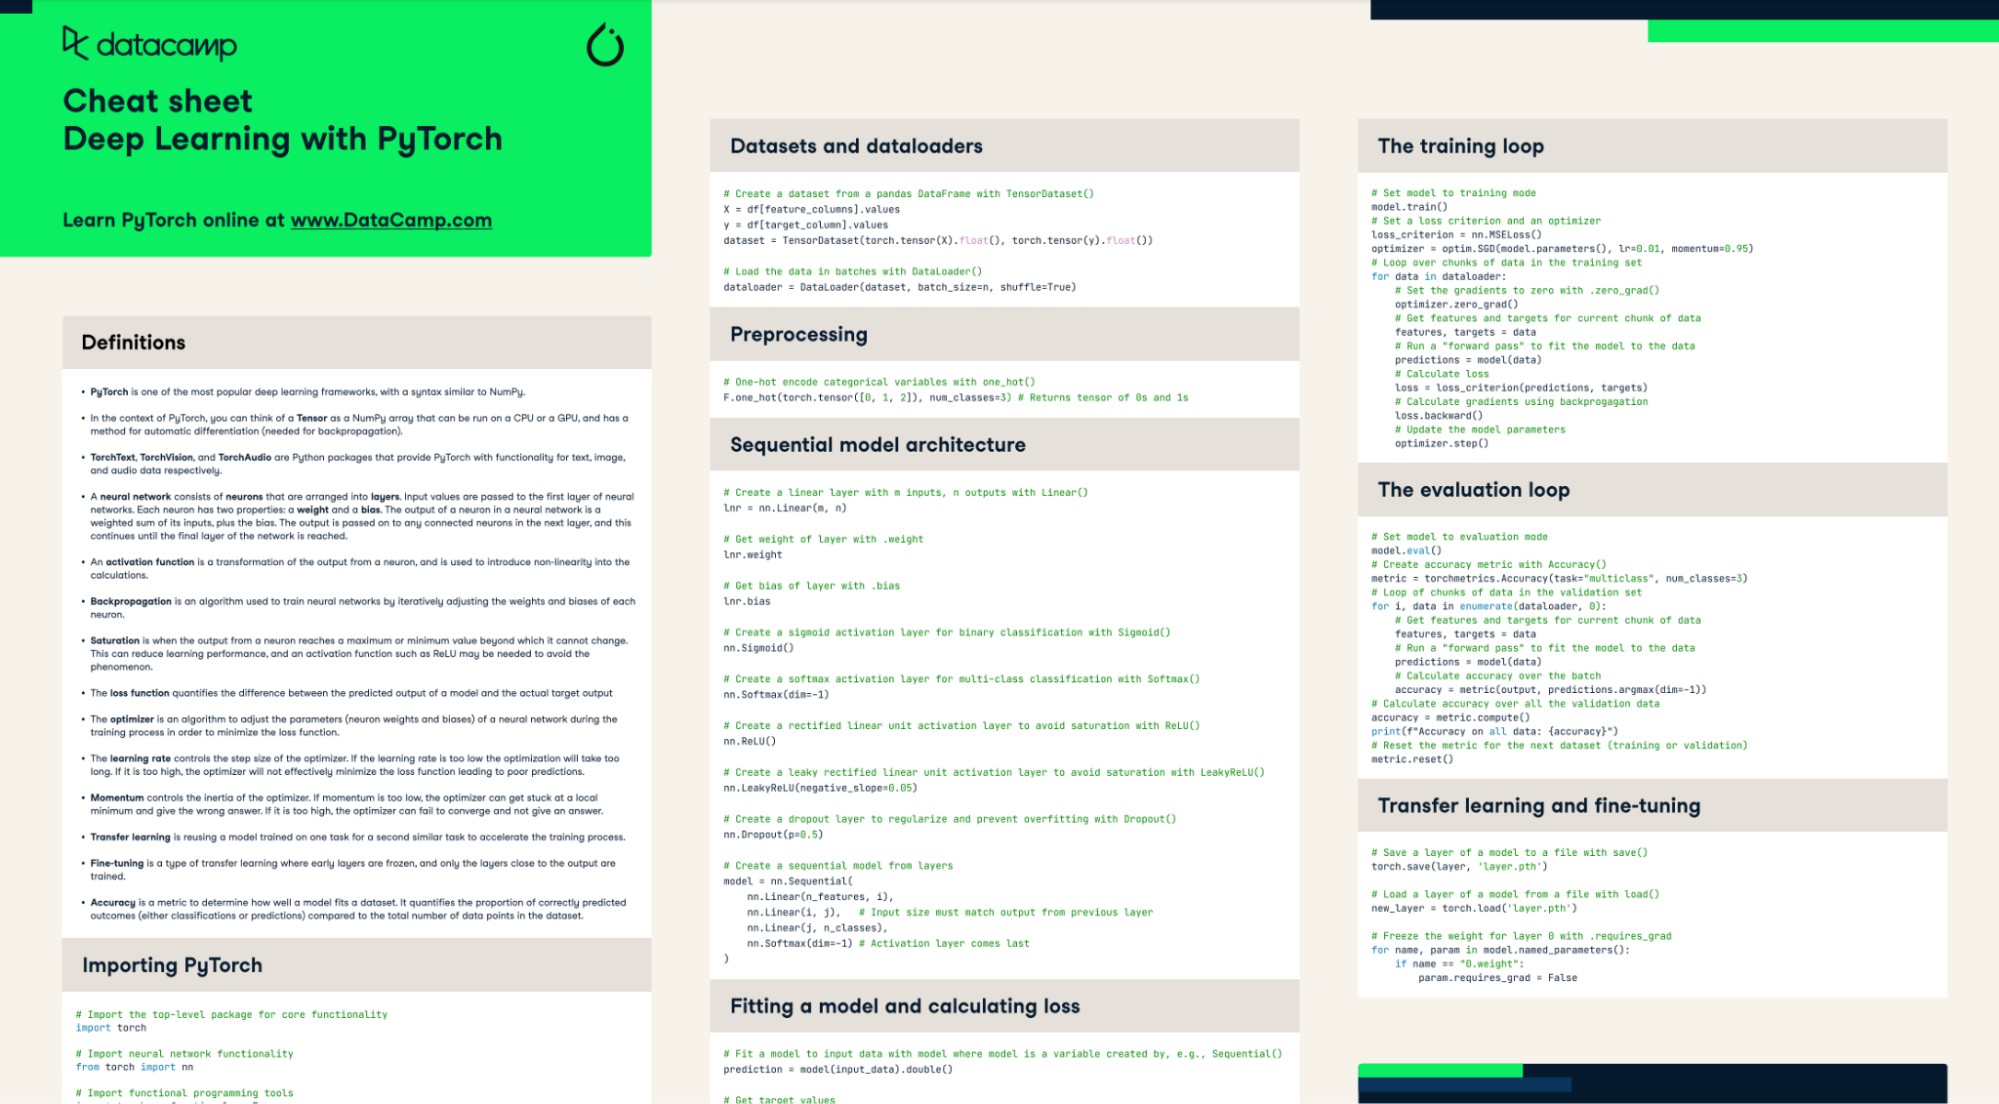
Beheers Pytorch met onze handige cheatsheet
MLFlow is een open-sourceplatform van Databricks voor het beheren van de end-to-end machinelearning-levenscyclus. Het houdt experimenten bij, verpakt modellen en rolt ze uit naar productie met behoud van reproduceerbaarheid. Het is ook compatibel met het tracken van LLM’s en ondersteunt zowel een command-line interface als een grafische gebruikersinterface. Daarnaast biedt het API’s voor Python, Java, R en REST.
Hugging Face is uitgegroeid tot een one-stopoplossing voor open-source machinelearning-ontwikkeling. Het biedt eenvoudig toegang tot datasets, state-of-the-art modellen en inferentie, waardoor het gemakkelijk is om je modellen te trainen, evalueren en uit te rollen met diverse tools in het Hugging Face-ecosysteem. Bovendien biedt het toegang tot high-end GPU’s en enterprise-oplossingen. Of je nu student, onderzoeker of professional in machine learning bent, dit is het enige platform dat je nodig hebt om topoplossingen voor je projecten te ontwikkelen.
Robuuste propriëtaire platforms bieden enterprise-schaal, one-click-setup en gebruiksgemak. Ze leveren ook support en beveiliging voor je data.
Tableau is een leider in business intelligence-software. Het maakt intuïtieve, interactieve datavisualisaties en dashboards mogelijk die op schaal inzichten uit data ontsluiten. Met Tableau kunnen gebruikers verbinding maken met allerlei databronnen, de data opschonen en voorbereiden voor analyse en vervolgens rijke visualisaties genereren zoals grafieken en kaarten. De software is ontworpen voor gebruiksgemak, waardoor niet-technische gebruikers met drag-and-drop eenvoudig rapporten en dashboards kunnen maken.
RapidMiner is een end-to-end geavanceerd analyticsplatform voor het bouwen van machinelearning- en datapijplijnen, met een visuele workflowdesigner om het proces te stroomlijnen. Van datapreparatie tot modeluitrol: RapidMiner biedt alle benodigde tools om elke stap van de ML-workflow te beheren. De visuele workflowdesigner vormt het hart van RapidMiner en stelt gebruikers in staat eenvoudig pijplijnen te maken, zonder code te schrijven.
Het afgelopen jaar zijn AI-tools essentieel geworden voor data-analyse. Ze worden gebruikt voor codegeneratie, validatie, het begrijpen van resultaten, rapportage en meer.
ChatGPT is een AI-gestuurde tool die je kan helpen bij uiteenlopende data science-taken. Het kan Python-code genereren en uitvoeren en ook complete analysarapporten opstellen. En dat is nog niet alles. ChatGPT beschikt over allerlei plugins die erg nuttig zijn voor onderzoek, experimenten, wiskunde, statistiek, automatisering en documentreview. Enkele opvallende functies zijn DALLE-3 (beeldgeneratie), Browser met Bing en ChatGPT Vision (beeldherkenning).
Raadpleeg de gids voor het gebruik van ChatGPT voor data science-projecten om te leren hoe je ChatGPT inzet en end-to-end data science-projecten bouwt.
Op zoek naar manieren om deze datatools toe te passen op real-life datasets? DataCamp helpt je op weg. Ze bieden zowel begeleide als onbewaakte projecten die je kunt laden in een AI-gestuurd notebook genaamd DataLab, zodat je direct aan de slag kunt met een project. De projectlijst van DataCamp is uitgebreid en beslaat uiteenlopende onderwerpen, waaronder dataverwerking, machine learning, data engineering, MLOps, LLM’s, NLP en meer.
Hier zijn links naar meer projecten die je helpen toonaangevende tools op je dataset toe te passen:
Er gebeuren spannende ontwikkelingen in de dynamische wereld van data science, waar innovatie de norm is. Deze blogpost gaf een uitgebreid overzicht van de top 10 data science-tools die aan populariteit winnen en naar verwachting in 2026 breder worden ingezet.
Python-bibliotheken zoals Pandas, Seaborn en Scikit-learn bieden robuuste mogelijkheden voor datapreparatie, analyse, visualisatie en modellering. Open-sourceplatformen zoals MLflow, Pytorch en Hugging Face versnellen experimenteren, ontwikkeling en uitrol. Propriëtaire oplossingen zoals Tableau en RapidMiner maken business intelligence op enterprise-schaal en end-to-end beheer van de machinelearning-levenscyclus mogelijk. En nieuwe AI-assistenten zoals ChatGPT genereren code en inzichten, wat de productiviteit een flinke boost geeft.
Wil je een vaardige data scientist worden en leren werken met deze tools? Schrijf je dan in voor de carrièreroute Data Scientist with Python. Dit programma rust je uit met de essentiële skills om uit te blinken als data scientist, van datamanipulatie tot machine learning.
Begin vandaag nog aan je data science-reis!
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

