डेटा साइंस का परिदृश्य तेज़ी से विकसित हो रहा है, और डेटा वैज्ञानिकों की मदद के लिए कई टूल उपलब्ध हैं। इस पोस्ट में, हम 2026 में उपयोग किए जा सकने वाले शीर्ष 10 डेटा साइंस टूल्स पर चर्चा करेंगे। ये टूल आपको डेटा इनजेस्ट करने, साफ करने, प्रोसेस करने, विश्लेषण करने, विज़ुअलाइज़ करने और मॉडलिंग करने में सहायता करेंगे। इसके अतिरिक्त, कुछ टूल मॉडल ट्रैकिंग, डेवलपमेंट, डिप्लॉयमेंट और मॉनिटरिंग के लिए मशीन लर्निंग इकोसिस्टम भी प्रदान करते हैं।
डेटा साइंस टूल्स की भूमिका
डेटा साइंस टूल्स, डेटा वैज्ञानिकों और विश्लेषकों को डेटा से मूल्यवान इनसाइट्स निकालने में अहम भूमिका निभाते हैं। ये टूल डेटा की सफाई, हेरफेर, विज़ुअलाइज़ेशन और मॉडलिंग के लिए उपयोगी होते हैं।
ChatGPT के आगमन के साथ, अधिकाधिक टूल GPT-3.5 और GPT-4 मॉडलों के साथ एकीकृत हो रहे हैं। AI-सपोर्टेड टूल्स का इंटीग्रेशन डेटा वैज्ञानिकों के लिए डेटा का विश्लेषण करना और मॉडल बनाना और भी आसान बना देता है।
उदाहरण के लिए, जेनरेटिव AI क्षमताएँ (PandasAI) pandas जैसे सरल टूल्स तक पहुँच गई हैं, जिससे उपयोगकर्ता प्राकृतिक भाषा में प्रॉम्प्ट लिखकर परिणाम प्राप्त कर सकते हैं। हालांकि, ये नए टूल्स अभी डेटा प्रोफेशनल्स के बीच व्यापक रूप से प्रचलित नहीं हुए हैं।
इसके अलावा, डेटा साइंस टूल्स केवल एक ही फ़ंक्शन तक सीमित नहीं होते। वे उन्नत कार्यों को करने की अतिरिक्त क्षमताएँ प्रदान करते हैं और कुछ मामलों में डेटा साइंस के लिए पूरा इकोसिस्टम भी देते हैं। उदाहरण के लिए, MLFlow मुख्य रूप से मॉडल ट्रैकिंग के लिए उपयोग होता है। हालांकि, इसे मॉडल रजिस्ट्री, डिप्लॉयमेंट और इन्फरेंस के लिए भी इस्तेमाल किया जा सकता है।
डेटा साइंस टूल्स चुनने के मानदंड
शीर्ष 10 टूल्स की सूची निम्नलिखित प्रमुख विशेषताओं पर आधारित है:
- लोकप्रियता और अपनाया जाना: बड़े उपयोगकर्ता आधार और समुदाय समर्थन वाले टूल्स के पास अधिक संसाधन और डाक्यूमेंटेशन होते हैं। लोकप्रिय ओपन-सोर्स टूल्स को सतत सुधारों का लाभ मिलता है।
- उपयोग में आसानी: व्यापक कोडिंग के बिना सहज वर्कफ़्लो तेज़ प्रोटोटाइपिंग और विश्लेषण सक्षम करते हैं।
- स्केलेबिलिटी: बड़े और जटिल डेटासेट संभालने की क्षमता।
- एंड-टू-एंड क्षमताएँ: डेटा तैयारी, विज़ुअलाइज़ेशन, मॉडलिंग, डिप्लॉयमेंट और इन्फरेंस जैसे विविध कार्यों को सपोर्ट करने वाले टूल्स।
- डेटा कनेक्टिविटी: SQL, NoSQL डेटाबेस, APIs, असंरचित डेटा आदि जैसे विविध स्रोतों और फ़ॉर्मैट से जुड़ने की लचीलापन।
- इंटरऑपरेबिलिटी: अन्य टूल्स के साथ निर्बाध रूप से इंटीग्रेट होना।
2026 के लिए शीर्ष डेटा साइंस टूल्स की व्यापक समीक्षा
इस समीक्षा में, हम नए और स्थापित टूल्स का अन्वेषण करेंगे जो कार्यस्थल पर डेटा वैज्ञानिकों के लिए आवश्यक बन गए हैं। इन टूल्स में कुछ सामान्य विशेषताएँ हैं—ये आसानी से सुलभ, उपयोगकर्ता-अनुकूल हैं और डेटा विश्लेषण व मशीन लर्निंग के लिए मजबूत क्षमताएँ प्रदान करते हैं।
डेटा साइंस के लिए Python-आधारित टूल्स
Python का व्यापक उपयोग डेटा विश्लेषण, प्रोसेसिंग और मशीन लर्निंग के लिए होता है। इसकी सरलता और बड़ा डेवलपर समुदाय इसे लोकप्रिय विकल्प बनाते हैं।
1. pandas
pandas Python में डेटा की सफाई, हेरफेर, विश्लेषण और फीचर इंजीनियरिंग को सहज बनाता है। यह हर तरह के कार्यों के लिए डेटा प्रोफेशनल्स द्वारा सबसे अधिक उपयोग की जाने वाली लाइब्रेरी है। अब आप इसे डेटा विज़ुअलाइज़ेशन के लिए भी इस्तेमाल कर सकते हैं।
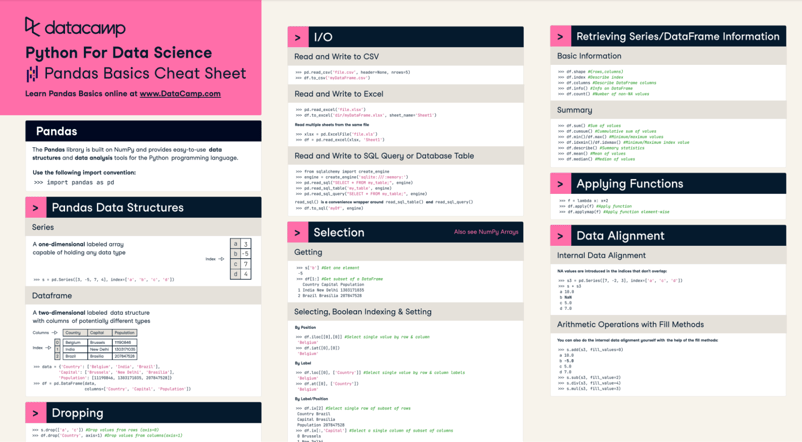
हमारी pandas चीट शीट इस डेटा साइंस टूल में आपको निपुण बनने में मदद कर सकती है।
2. Seaborn
Seaborn एक शक्तिशाली डेटा विज़ुअलाइज़ेशन लाइब्रेरी है जो Matplotlib के ऊपर निर्मित है। इसमें सुंदर और सुसंगत डिफ़ॉल्ट थीम्स की रेंज मिलती है और यह खास तौर पर pandas DataFrames के साथ काम करते समय उपयोगी है। Seaborn के साथ आप स्पष्ट और अभिव्यक्तिपूर्ण विज़ुअलाइज़ेशन जल्दी और आसानी से बना सकते हैं।
3. Scikit-learn
Scikit-learn मशीन लर्निंग के लिए प्रमुख Python लाइब्रेरी है। यह लाइब्रेरी सामान्य एल्गोरिदम—जैसे रिग्रेशन, क्लासिफिकेशन, क्लस्टरिंग, और डाइमेंशनलिटी रिडक्शन—के लिए एक सुसंगत इंटरफ़ेस प्रदान करती है। यह प्रदर्शन के लिए अनुकूलित है और डेटा वैज्ञानिकों द्वारा व्यापक रूप से उपयोग की जाती है।
ओपन-सोर्स डेटा साइंस टूल्स
ओपन-सोर्स प्रोजेक्ट्स ने डेटा साइंस के क्षेत्र को आगे बढ़ाने में महत्वपूर्ण भूमिका निभाई है। वे ऐसे टूल्स और संसाधनों का खज़ाना प्रदान करते हैं जो डेटा वैज्ञानिकों को अधिक कुशल और प्रभावी ढंग से काम करने में मदद करते हैं।
4. Jupyter Notebooks
Jupyter Notebooks एक लोकप्रिय ओपन-सोर्स वेब एप्लिकेशन है जो डेटा वैज्ञानिकों को लाइव कोड, विज़ुअलाइज़ेशन, समीकरण और टेक्स्ट व्याख्या को मिलाकर साझा करने योग्य डॉक्यूमेंट बनाने देता है। खोजपरक विश्लेषण, सहयोग और रिपोर्टिंग के लिए उत्कृष्ट।
5. Pytorch
Pytorch एक अत्यंत लचीला और ओपन-सोर्स मशीन लर्निंग फ्रेमवर्क है, जिसका व्यापक उपयोग न्यूरल नेटवर्क मॉडल विकसित करने में होता है। यह मॉड्युलैरिटी और टेक्स्ट, ऑडियो, विज़न और टैब्युलर डेटा जैसे विभिन्न प्रकार के डेटा को संभालने के लिए विशाल इकोसिस्टम प्रदान करता है। GPU और TPU सपोर्ट के साथ, आप अपने मॉडल प्रशिक्षण को 10X तक तेज कर सकते हैं।
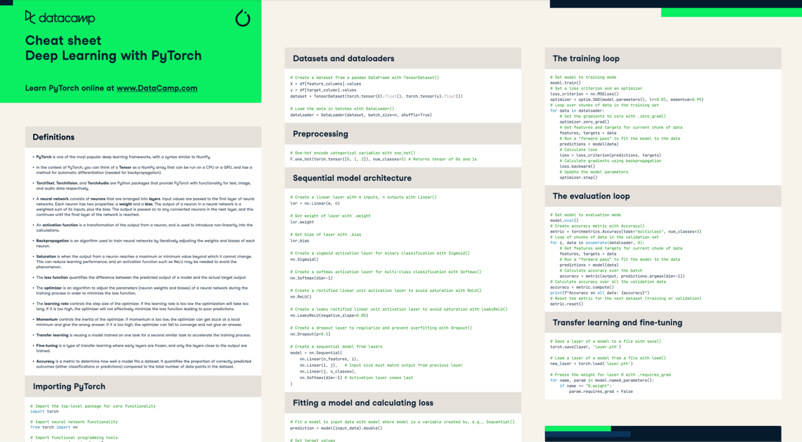
हमारी उपयोगी चीट शीट के साथ Pytorch में महारत हासिल करें
6. MLFlow
MLFlow Databricks का एक ओपन-सोर्स प्लेटफ़ॉर्म है जो एंड-टू-एंड मशीन लर्निंग लाइफसाइकल को मैनेज करने के लिए बनाया गया है। यह एक्सपेरिमेंट्स को ट्रैक करता है, मॉडलों को पैकेज करता है और प्रोडक्शन में डिप्लॉय करता है, साथ ही पुनरुत्पादनशीलता बनाए रखता है। यह LLMs को ट्रैक करने के लिए भी संगत है और कमांड लाइन इंटरफ़ेस तथा ग्राफिकल यूज़र इंटरफ़ेस—दोनों को सपोर्ट करता है। यह Python, Java, R और Rest के लिए API भी प्रदान करता है।
7. Hugging Face
Hugging Face ओपन-सोर्स मशीन लर्निंग डेवलपमेंट के लिए एक वन-स्टॉप समाधान बन गया है। यह डेटासेट्स, अत्याधुनिक मॉडलों और इन्फरेंस तक आसान पहुँच प्रदान करता है, जिससे Hugging Face इकोसिस्टम के विभिन्न टूल्स के साथ अपने मॉडलों को ट्रेन, इवैल्युएट और डिप्लॉय करना सुविधाजनक हो जाता है। साथ ही, यह हाई-एंड GPUs और एंटरप्राइज़ सोल्यूशंस तक पहुँच देता है। चाहे आप मशीन लर्निंग के विद्यार्थी हों, शोधकर्ता हों या प्रोफेशनल, अपने प्रोजेक्ट्स के लिए उच्च-स्तरीय समाधान विकसित करने हेतु आपको इसी प्लेटफ़ॉर्म की ज़रूरत होगी।
प्रोप्रायटरी डेटा साइंस टूल्स
मजबूत प्रोप्रायटरी प्लेटफ़ॉर्म एंटरप्राइज़-स्तरीय क्षमताएँ, वन-क्लिक सेटअप और उपयोग में आसानी प्रदान करते हैं। वे आपके डेटा के लिए सपोर्ट और सुरक्षा भी देते हैं।
8. Tableau
Tableau बिज़नेस इंटेलिजेंस सॉफ्टवेयर में अग्रणी है। यह सहज इंटरएक्टिव डेटा विज़ुअलाइज़ेशन और डैशबोर्ड सक्षम करता है जो बड़े पैमाने पर डेटा से इनसाइट्स निकालते हैं। Tableau के साथ उपयोगकर्ता विभिन्न प्रकार के डेटा स्रोतों से कनेक्ट कर सकते हैं, विश्लेषण के लिए डेटा को साफ और तैयार कर सकते हैं, और फिर चार्ट्स, ग्राफ़्स और मैप्स जैसे समृद्ध विज़ुअलाइज़ेशन जेनरेट कर सकते हैं। सॉफ्टवेयर उपयोग में आसान होने के लिए डिज़ाइन किया गया है, जिससे गैर-तकनीकी उपयोगकर्ता भी ड्रैग-एंड-ड्रॉप की सरलता से रिपोर्ट्स और डैशबोर्ड बना सकते हैं।
9. RapidMiner
RapidMiner एंड-टू-एंड एडवांस्ड एनालिटिक्स प्लेटफ़ॉर्म है जो मशीन लर्निंग और डेटा पाइपलाइन्स बनाने के लिए विज़ुअल वर्कफ़्लो डिज़ाइनर प्रदान करता है, जिससे प्रक्रिया सुगम होती है। डेटा तैयारी से लेकर मॉडल डिप्लॉयमेंट तक, RapidMiner ML वर्कफ़्लो के हर चरण को मैनेज करने के लिए आवश्यक टूल्स प्रदान करता है। RapidMiner के कोर में मौजूद विज़ुअल वर्कफ़्लो डिज़ाइनर उपयोगकर्ताओं को बिना कोड लिखे आसानी से पाइपलाइन्स बनाने में सक्षम बनाता है।
AI टूल्स
पिछले वर्ष में, AI टूल्स डेटा विश्लेषण के लिए अनिवार्य बन गए हैं। इनका उपयोग कोड जनरेशन, वैलिडेशन, परिणामों की समझ, रिपोर्ट जनरेशन और बहुत कुछ के लिए होता है।
10. ChatGPT
ChatGPT एक AI-संचालित टूल है जो विभिन्न डेटा साइंस कार्यों में आपकी सहायता कर सकता है। यह Python कोड जेनरेट करने और उसे निष्पादित करने की क्षमता प्रदान करता है, और यह पूर्ण विश्लेषण रिपोर्ट भी बना सकता है। लेकिन इतना ही नहीं। ChatGPT कई प्रकार के प्लगइन्स से लैस आता है जो रिसर्च, प्रयोग, गणित, सांख्यिकी, ऑटोमेशन और डॉक्यूमेंट रिव्यू के लिए अत्यंत उपयोगी हो सकते हैं। सबसे उल्लेखनीय विशेषताओं में DALLE-3 (इमेज जनरेशन), Browser with Bing, और ChatGPT Vision (इमेज रिकग्निशन) शामिल हैं।
आप डेटा साइंस प्रोजेक्ट्स के लिए ChatGPT उपयोग करने की गाइड देख सकते हैं, जिससे आप जानेंगे कि ChatGPT का उपयोग करके एंड-टू-एंड डेटा साइंस प्रोजेक्ट्स कैसे बनाएँ।
हैंड्स-ऑन प्रोजेक्ट्स और संसाधन
क्या आप इन डेटा टूल्स को वास्तविक-जीवन के डेटासेट्स पर लागू करने के तरीके खोज रहे हैं? DataCamp आपकी मदद के लिए तैयार है। वे गाइडेड और अनगाइडेड—दोनों तरह के प्रोजेक्ट्स प्रदान करते हैं जिन्हें DataLab नामक AI-संचालित नोटबुक पर लोड किया जा सकता है, जिससे आप तुरंत किसी प्रोजेक्ट पर काम शुरू कर सकते हैं। DataCamp की प्रोजेक्ट सूची विस्तृत है और इसमें डेटा प्रोसेसिंग, मशीन लर्निंग, डेटा इंजीनियरिंग, MLOps, LLMs, NLP, और बहुत कुछ सहित अनेक विषय शामिल हैं।
यहाँ और प्रोजेक्ट्स के लिंक दिए गए हैं जो आपको अपने डेटासेट पर अत्याधुनिक टूल्स लागू करने में मदद करेंगे:
निष्कर्ष
डेटा साइंस के गतिशील क्षेत्र में रोमांचक प्रगति हो रही है, जहाँ नवाचार सामान्य है। इस ब्लॉग पोस्ट ने शीर्ष 10 डेटा साइंस टूल्स का व्यापक अवलोकन प्रदान किया है जो लोकप्रिय हो रहे हैं और 2026 में अपनाए जाने की संभावना है।
Python-आधारित लाइब्रेरीज़ जैसे Pandas, Seaborn, और Scikit-learn डेटा तैयारी, विश्लेषण, विज़ुअलाइज़ेशन और मॉडलिंग के लिए मजबूत क्षमताएँ देती हैं। ओपन-सोर्स प्लेटफ़ॉर्म जैसे MLflow, Pytorch और Hugging Face प्रयोग, विकास और डिप्लॉयमेंट में तेजी लाते हैं। प्रोप्रायटरी समाधान जैसे Tableau और RapidMiner एंटरप्राइज़-स्तरीय बिज़नेस इंटेलिजेंस और एंड-टू-एंड मशीन लर्निंग लाइफसाइकल मैनेजमेंट सक्षम करते हैं। और ChatGPT जैसे नए AI असिस्टेंट्स कोड और इनसाइट्स जेनरेट कर उत्पादकता बढ़ाते हैं।
यदि आप एक कुशल डेटा वैज्ञानिक बनने और इन टूल्स का उपयोग करने में विशेषज्ञता हासिल करने की आकांक्षा रखते हैं, तो स्वयं को Data Scientist with Python करियर ट्रैक में नामांकित करें। यह प्रोग्राम आपको डेटा मैनिपुलेशन से लेकर मशीन लर्निंग तक, एक डेटा वैज्ञानिक के रूप में उत्कृष्टता प्राप्त करने के लिए आवश्यक कौशल से लैस करेगा।


डेटा साइंस का परिदृश्य तेज़ी से विकसित हो रहा है, और डेटा वैज्ञानिकों की मदद के लिए कई टूल उपलब्ध हैं। इस पोस्ट में, हम 2026 में उपयोग किए जा सकने वाले शीर्ष 10 डेटा साइंस टूल्स पर चर्चा करेंगे। ये टूल आपको डेटा इनजेस्ट करने, साफ करने, प्रोसेस करने, विश्लेषण करने, विज़ुअलाइज़ करने और मॉडलिंग करने में सहायता करेंगे। इसके अतिरिक्त, कुछ टूल मॉडल ट्रैकिंग, डेवलपमेंट, डिप्लॉयमेंट और मॉनिटरिंग के लिए मशीन लर्निंग इकोसिस्टम भी प्रदान करते हैं।
डेटा साइंस टूल्स की भूमिका
डेटा साइंस टूल्स, डेटा वैज्ञानिकों और विश्लेषकों को डेटा से मूल्यवान इनसाइट्स निकालने में अहम भूमिका निभाते हैं। ये टूल डेटा की सफाई, हेरफेर, विज़ुअलाइज़ेशन और मॉडलिंग के लिए उपयोगी होते हैं।
ChatGPT के आगमन के साथ, अधिकाधिक टूल GPT-3.5 और GPT-4 मॉडलों के साथ एकीकृत हो रहे हैं। AI-सपोर्टेड टूल्स का इंटीग्रेशन डेटा वैज्ञानिकों के लिए डेटा का विश्लेषण करना और मॉडल बनाना और भी आसान बना देता है।
उदाहरण के लिए, जेनरेटिव AI क्षमताएँ (PandasAI) pandas जैसे सरल टूल्स तक पहुँच गई हैं, जिससे उपयोगकर्ता प्राकृतिक भाषा में प्रॉम्प्ट लिखकर परिणाम प्राप्त कर सकते हैं। हालांकि, ये नए टूल्स अभी डेटा प्रोफेशनल्स के बीच व्यापक रूप से प्रचलित नहीं हुए हैं।
इसके अलावा, डेटा साइंस टूल्स केवल एक ही फ़ंक्शन तक सीमित नहीं होते। वे उन्नत कार्यों को करने की अतिरिक्त क्षमताएँ प्रदान करते हैं और कुछ मामलों में डेटा साइंस के लिए पूरा इकोसिस्टम भी देते हैं। उदाहरण के लिए, MLFlow मुख्य रूप से मॉडल ट्रैकिंग के लिए उपयोग होता है। हालांकि, इसे मॉडल रजिस्ट्री, डिप्लॉयमेंट और इन्फरेंस के लिए भी इस्तेमाल किया जा सकता है।
डेटा साइंस टूल्स चुनने के मानदंड
शीर्ष 10 टूल्स की सूची निम्नलिखित प्रमुख विशेषताओं पर आधारित है:
2026 के लिए शीर्ष डेटा साइंस टूल्स की व्यापक समीक्षा
इस समीक्षा में, हम नए और स्थापित टूल्स का अन्वेषण करेंगे जो कार्यस्थल पर डेटा वैज्ञानिकों के लिए आवश्यक बन गए हैं। इन टूल्स में कुछ सामान्य विशेषताएँ हैं—ये आसानी से सुलभ, उपयोगकर्ता-अनुकूल हैं और डेटा विश्लेषण व मशीन लर्निंग के लिए मजबूत क्षमताएँ प्रदान करते हैं।
डेटा साइंस के लिए Python-आधारित टूल्स
Python का व्यापक उपयोग डेटा विश्लेषण, प्रोसेसिंग और मशीन लर्निंग के लिए होता है। इसकी सरलता और बड़ा डेवलपर समुदाय इसे लोकप्रिय विकल्प बनाते हैं।
1. pandas
pandas Python में डेटा की सफाई, हेरफेर, विश्लेषण और फीचर इंजीनियरिंग को सहज बनाता है। यह हर तरह के कार्यों के लिए डेटा प्रोफेशनल्स द्वारा सबसे अधिक उपयोग की जाने वाली लाइब्रेरी है। अब आप इसे डेटा विज़ुअलाइज़ेशन के लिए भी इस्तेमाल कर सकते हैं।
हमारी pandas चीट शीट इस डेटा साइंस टूल में आपको निपुण बनने में मदद कर सकती है।
2. Seaborn
Seaborn एक शक्तिशाली डेटा विज़ुअलाइज़ेशन लाइब्रेरी है जो Matplotlib के ऊपर निर्मित है। इसमें सुंदर और सुसंगत डिफ़ॉल्ट थीम्स की रेंज मिलती है और यह खास तौर पर pandas DataFrames के साथ काम करते समय उपयोगी है। Seaborn के साथ आप स्पष्ट और अभिव्यक्तिपूर्ण विज़ुअलाइज़ेशन जल्दी और आसानी से बना सकते हैं।
3. Scikit-learn
Scikit-learn मशीन लर्निंग के लिए प्रमुख Python लाइब्रेरी है। यह लाइब्रेरी सामान्य एल्गोरिदम—जैसे रिग्रेशन, क्लासिफिकेशन, क्लस्टरिंग, और डाइमेंशनलिटी रिडक्शन—के लिए एक सुसंगत इंटरफ़ेस प्रदान करती है। यह प्रदर्शन के लिए अनुकूलित है और डेटा वैज्ञानिकों द्वारा व्यापक रूप से उपयोग की जाती है।
ओपन-सोर्स डेटा साइंस टूल्स
ओपन-सोर्स प्रोजेक्ट्स ने डेटा साइंस के क्षेत्र को आगे बढ़ाने में महत्वपूर्ण भूमिका निभाई है। वे ऐसे टूल्स और संसाधनों का खज़ाना प्रदान करते हैं जो डेटा वैज्ञानिकों को अधिक कुशल और प्रभावी ढंग से काम करने में मदद करते हैं।
4. Jupyter Notebooks
Jupyter Notebooks एक लोकप्रिय ओपन-सोर्स वेब एप्लिकेशन है जो डेटा वैज्ञानिकों को लाइव कोड, विज़ुअलाइज़ेशन, समीकरण और टेक्स्ट व्याख्या को मिलाकर साझा करने योग्य डॉक्यूमेंट बनाने देता है। खोजपरक विश्लेषण, सहयोग और रिपोर्टिंग के लिए उत्कृष्ट।
5. Pytorch
Pytorch एक अत्यंत लचीला और ओपन-सोर्स मशीन लर्निंग फ्रेमवर्क है, जिसका व्यापक उपयोग न्यूरल नेटवर्क मॉडल विकसित करने में होता है। यह मॉड्युलैरिटी और टेक्स्ट, ऑडियो, विज़न और टैब्युलर डेटा जैसे विभिन्न प्रकार के डेटा को संभालने के लिए विशाल इकोसिस्टम प्रदान करता है। GPU और TPU सपोर्ट के साथ, आप अपने मॉडल प्रशिक्षण को 10X तक तेज कर सकते हैं।
हमारी उपयोगी चीट शीट के साथ Pytorch में महारत हासिल करें
6. MLFlow
MLFlow Databricks का एक ओपन-सोर्स प्लेटफ़ॉर्म है जो एंड-टू-एंड मशीन लर्निंग लाइफसाइकल को मैनेज करने के लिए बनाया गया है। यह एक्सपेरिमेंट्स को ट्रैक करता है, मॉडलों को पैकेज करता है और प्रोडक्शन में डिप्लॉय करता है, साथ ही पुनरुत्पादनशीलता बनाए रखता है। यह LLMs को ट्रैक करने के लिए भी संगत है और कमांड लाइन इंटरफ़ेस तथा ग्राफिकल यूज़र इंटरफ़ेस—दोनों को सपोर्ट करता है। यह Python, Java, R और Rest के लिए API भी प्रदान करता है।
7. Hugging Face
Hugging Face ओपन-सोर्स मशीन लर्निंग डेवलपमेंट के लिए एक वन-स्टॉप समाधान बन गया है। यह डेटासेट्स, अत्याधुनिक मॉडलों और इन्फरेंस तक आसान पहुँच प्रदान करता है, जिससे Hugging Face इकोसिस्टम के विभिन्न टूल्स के साथ अपने मॉडलों को ट्रेन, इवैल्युएट और डिप्लॉय करना सुविधाजनक हो जाता है। साथ ही, यह हाई-एंड GPUs और एंटरप्राइज़ सोल्यूशंस तक पहुँच देता है। चाहे आप मशीन लर्निंग के विद्यार्थी हों, शोधकर्ता हों या प्रोफेशनल, अपने प्रोजेक्ट्स के लिए उच्च-स्तरीय समाधान विकसित करने हेतु आपको इसी प्लेटफ़ॉर्म की ज़रूरत होगी।
प्रोप्रायटरी डेटा साइंस टूल्स
मजबूत प्रोप्रायटरी प्लेटफ़ॉर्म एंटरप्राइज़-स्तरीय क्षमताएँ, वन-क्लिक सेटअप और उपयोग में आसानी प्रदान करते हैं। वे आपके डेटा के लिए सपोर्ट और सुरक्षा भी देते हैं।
8. Tableau
Tableau बिज़नेस इंटेलिजेंस सॉफ्टवेयर में अग्रणी है। यह सहज इंटरएक्टिव डेटा विज़ुअलाइज़ेशन और डैशबोर्ड सक्षम करता है जो बड़े पैमाने पर डेटा से इनसाइट्स निकालते हैं। Tableau के साथ उपयोगकर्ता विभिन्न प्रकार के डेटा स्रोतों से कनेक्ट कर सकते हैं, विश्लेषण के लिए डेटा को साफ और तैयार कर सकते हैं, और फिर चार्ट्स, ग्राफ़्स और मैप्स जैसे समृद्ध विज़ुअलाइज़ेशन जेनरेट कर सकते हैं। सॉफ्टवेयर उपयोग में आसान होने के लिए डिज़ाइन किया गया है, जिससे गैर-तकनीकी उपयोगकर्ता भी ड्रैग-एंड-ड्रॉप की सरलता से रिपोर्ट्स और डैशबोर्ड बना सकते हैं।
9. RapidMiner
RapidMiner एंड-टू-एंड एडवांस्ड एनालिटिक्स प्लेटफ़ॉर्म है जो मशीन लर्निंग और डेटा पाइपलाइन्स बनाने के लिए विज़ुअल वर्कफ़्लो डिज़ाइनर प्रदान करता है, जिससे प्रक्रिया सुगम होती है। डेटा तैयारी से लेकर मॉडल डिप्लॉयमेंट तक, RapidMiner ML वर्कफ़्लो के हर चरण को मैनेज करने के लिए आवश्यक टूल्स प्रदान करता है। RapidMiner के कोर में मौजूद विज़ुअल वर्कफ़्लो डिज़ाइनर उपयोगकर्ताओं को बिना कोड लिखे आसानी से पाइपलाइन्स बनाने में सक्षम बनाता है।
AI टूल्स
पिछले वर्ष में, AI टूल्स डेटा विश्लेषण के लिए अनिवार्य बन गए हैं। इनका उपयोग कोड जनरेशन, वैलिडेशन, परिणामों की समझ, रिपोर्ट जनरेशन और बहुत कुछ के लिए होता है।
10. ChatGPT
ChatGPT एक AI-संचालित टूल है जो विभिन्न डेटा साइंस कार्यों में आपकी सहायता कर सकता है। यह Python कोड जेनरेट करने और उसे निष्पादित करने की क्षमता प्रदान करता है, और यह पूर्ण विश्लेषण रिपोर्ट भी बना सकता है। लेकिन इतना ही नहीं। ChatGPT कई प्रकार के प्लगइन्स से लैस आता है जो रिसर्च, प्रयोग, गणित, सांख्यिकी, ऑटोमेशन और डॉक्यूमेंट रिव्यू के लिए अत्यंत उपयोगी हो सकते हैं। सबसे उल्लेखनीय विशेषताओं में DALLE-3 (इमेज जनरेशन), Browser with Bing, और ChatGPT Vision (इमेज रिकग्निशन) शामिल हैं।
आप डेटा साइंस प्रोजेक्ट्स के लिए ChatGPT उपयोग करने की गाइड देख सकते हैं, जिससे आप जानेंगे कि ChatGPT का उपयोग करके एंड-टू-एंड डेटा साइंस प्रोजेक्ट्स कैसे बनाएँ।
हैंड्स-ऑन प्रोजेक्ट्स और संसाधन
क्या आप इन डेटा टूल्स को वास्तविक-जीवन के डेटासेट्स पर लागू करने के तरीके खोज रहे हैं? DataCamp आपकी मदद के लिए तैयार है। वे गाइडेड और अनगाइडेड—दोनों तरह के प्रोजेक्ट्स प्रदान करते हैं जिन्हें DataLab नामक AI-संचालित नोटबुक पर लोड किया जा सकता है, जिससे आप तुरंत किसी प्रोजेक्ट पर काम शुरू कर सकते हैं। DataCamp की प्रोजेक्ट सूची विस्तृत है और इसमें डेटा प्रोसेसिंग, मशीन लर्निंग, डेटा इंजीनियरिंग, MLOps, LLMs, NLP, और बहुत कुछ सहित अनेक विषय शामिल हैं।
यहाँ और प्रोजेक्ट्स के लिंक दिए गए हैं जो आपको अपने डेटासेट पर अत्याधुनिक टूल्स लागू करने में मदद करेंगे:
निष्कर्ष
डेटा साइंस के गतिशील क्षेत्र में रोमांचक प्रगति हो रही है, जहाँ नवाचार सामान्य है। इस ब्लॉग पोस्ट ने शीर्ष 10 डेटा साइंस टूल्स का व्यापक अवलोकन प्रदान किया है जो लोकप्रिय हो रहे हैं और 2026 में अपनाए जाने की संभावना है।
Python-आधारित लाइब्रेरीज़ जैसे Pandas, Seaborn, और Scikit-learn डेटा तैयारी, विश्लेषण, विज़ुअलाइज़ेशन और मॉडलिंग के लिए मजबूत क्षमताएँ देती हैं। ओपन-सोर्स प्लेटफ़ॉर्म जैसे MLflow, Pytorch और Hugging Face प्रयोग, विकास और डिप्लॉयमेंट में तेजी लाते हैं। प्रोप्रायटरी समाधान जैसे Tableau और RapidMiner एंटरप्राइज़-स्तरीय बिज़नेस इंटेलिजेंस और एंड-टू-एंड मशीन लर्निंग लाइफसाइकल मैनेजमेंट सक्षम करते हैं। और ChatGPT जैसे नए AI असिस्टेंट्स कोड और इनसाइट्स जेनरेट कर उत्पादकता बढ़ाते हैं।
यदि आप एक कुशल डेटा वैज्ञानिक बनने और इन टूल्स का उपयोग करने में विशेषज्ञता हासिल करने की आकांक्षा रखते हैं, तो स्वयं को Data Scientist with Python करियर ट्रैक में नामांकित करें। यह प्रोग्राम आपको डेटा मैनिपुलेशन से लेकर मशीन लर्निंग तक, एक डेटा वैज्ञानिक के रूप में उत्कृष्टता प्राप्त करने के लिए आवश्यक कौशल से लैस करेगा।