

Lộ trình
Chuyên viên phân tích dữ liệu trong Python
90 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleBức tranh khoa học dữ liệu đang phát triển nhanh chóng, và có rất nhiều công cụ hỗ trợ các nhà khoa học dữ liệu trong công việc. Trong bài viết này, chúng tôi sẽ bàn về 10 công cụ khoa học dữ liệu hàng đầu mà bạn có thể sử dụng vào năm 2026. Những công cụ này sẽ giúp bạn nạp, làm sạch, xử lý, phân tích, trực quan hóa và mô hình hóa dữ liệu. Ngoài ra, một số công cụ còn cung cấp hệ sinh thái học máy để theo dõi mô hình, phát triển, triển khai và giám sát.
Các công cụ khoa học dữ liệu rất cần thiết để giúp nhà khoa học dữ liệu và nhà phân tích khai thác những insight giá trị từ dữ liệu. Chúng hữu ích cho việc làm sạch, thao tác, trực quan hóa và mô hình hóa dữ liệu.
Với sự ra đời của ChatGPT, ngày càng nhiều công cụ được tích hợp với các mô hình GPT-3.5 và GPT-4. Việc tích hợp các công cụ có hỗ trợ AI giúp các nhà khoa học dữ liệu phân tích dữ liệu và xây dựng mô hình dễ dàng hơn.
Chẳng hạn, các khả năng AI sinh tạo (PandasAI) đã xuất hiện trong những công cụ đơn giản như pandas, cho phép người dùng nhận kết quả bằng cách viết prompt bằng ngôn ngữ tự nhiên. Tuy nhiên, những công cụ mới này vẫn chưa được giới chuyên môn dữ liệu sử dụng rộng rãi.
Hơn nữa, các công cụ khoa học dữ liệu không bị giới hạn ở một chức năng duy nhất. Chúng cung cấp thêm khả năng để thực hiện các tác vụ nâng cao và, trong một số trường hợp, cung cấp hệ sinh thái cho khoa học dữ liệu. Ví dụ, MLFlow chủ yếu được dùng để theo dõi mô hình. Tuy vậy, nó cũng có thể dùng để quản lý sổ đăng ký mô hình, triển khai và suy luận.
Danh sách 10 công cụ hàng đầu dựa trên các đặc điểm chính sau:
Trong phần đánh giá này, chúng ta sẽ khám phá những công cụ mới và đã thành danh, vốn trở nên thiết yếu với các nhà khoa học dữ liệu tại nơi làm việc. Các công cụ này có nhiều điểm chung — dễ tiếp cận, thân thiện với người dùng và cung cấp khả năng mạnh mẽ cho phân tích dữ liệu và học máy.
Python được sử dụng rộng rãi cho phân tích, xử lý dữ liệu và học máy. Sự đơn giản và cộng đồng nhà phát triển lớn khiến nó trở thành lựa chọn phổ biến.
pandas giúp việc làm sạch, thao tác, phân tích và kỹ thuật đặc trưng trở nên liền mạch trong Python. Đây là thư viện được giới chuyên môn dữ liệu dùng nhiều nhất cho mọi loại tác vụ. Hiện bạn cũng có thể dùng nó để trực quan hóa dữ liệu.
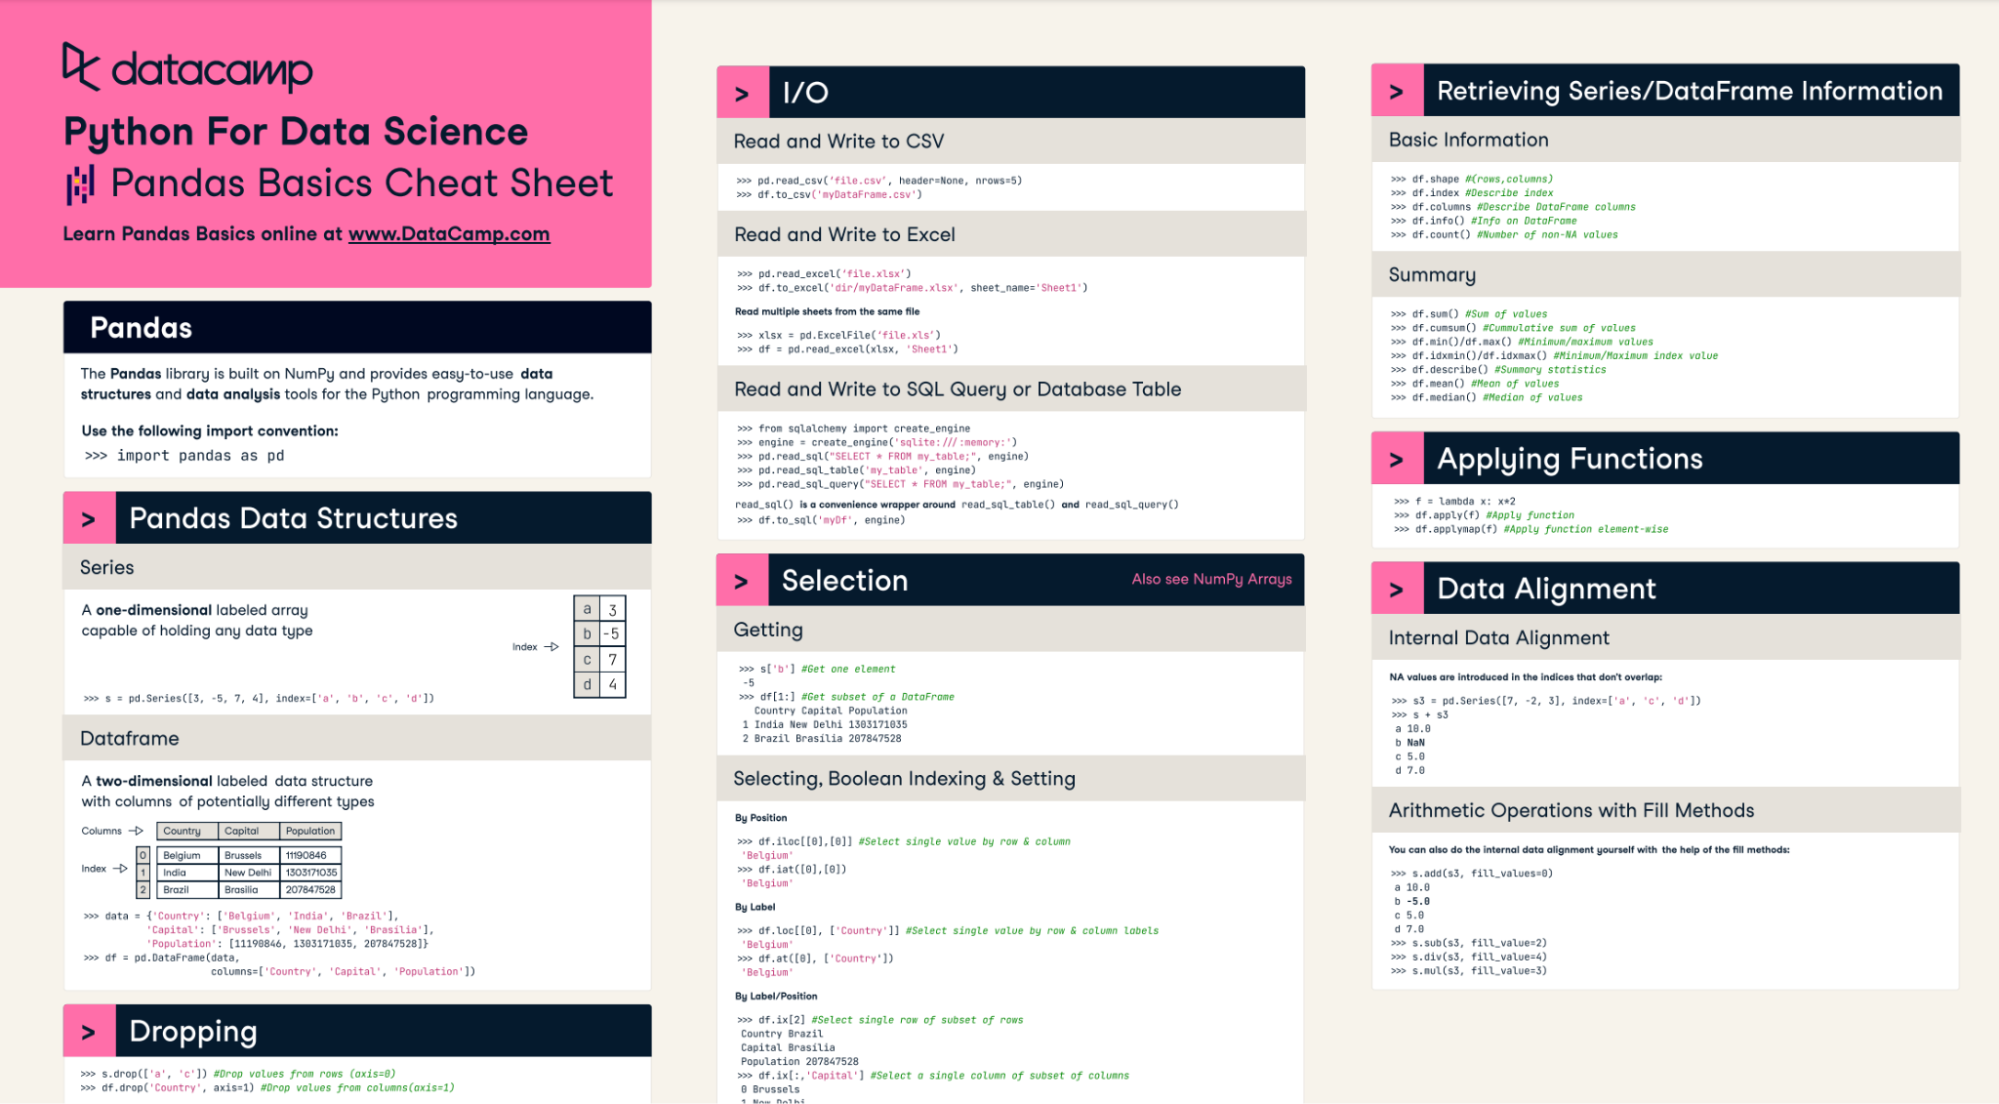
Tờ ghi chú pandas của chúng tôi có thể giúp bạn làm chủ công cụ khoa học dữ liệu này.
Seaborn là một thư viện trực quan hóa dữ liệu mạnh mẽ được xây dựng trên Matplotlib. Nó đi kèm nhiều chủ đề mặc định đẹp mắt, được thiết kế tốt và đặc biệt hữu dụng khi làm việc với DataFrame của pandas. Với Seaborn, bạn có thể nhanh chóng tạo ra các biểu đồ rõ ràng và giàu biểu đạt.
Scikit-learn là thư viện Python hàng đầu cho học máy. Thư viện này cung cấp giao diện nhất quán cho các thuật toán phổ biến, bao gồm hồi quy, phân loại, phân cụm và giảm chiều dữ liệu. Nó được tối ưu hiệu năng và được các nhà khoa học dữ liệu sử dụng rộng rãi.
Các dự án mã nguồn mở đã góp phần quan trọng thúc đẩy lĩnh vực khoa học dữ liệu. Chúng cung cấp vô số công cụ và tài nguyên giúp các nhà khoa học dữ liệu làm việc hiệu quả hơn.
Jupyter Notebooks là một ứng dụng web mã nguồn mở phổ biến, cho phép các nhà khoa học dữ liệu tạo tài liệu có thể chia sẻ, kết hợp mã chạy trực tiếp, trực quan hóa, công thức và phần giải thích văn bản. Rất phù hợp cho phân tích thăm dò, hợp tác và báo cáo.
Pytorch là một khung học máy mã nguồn mở, cực kỳ linh hoạt và được dùng rộng rãi để phát triển các mô hình mạng nơ-ron. Nó cung cấp tính mô-đun và một hệ sinh thái đồ sộ các công cụ để xử lý nhiều loại dữ liệu như văn bản, âm thanh, thị giác và dữ liệu dạng bảng. Với hỗ trợ GPU và TPU, bạn có thể tăng tốc huấn luyện mô hình gấp 10 lần.
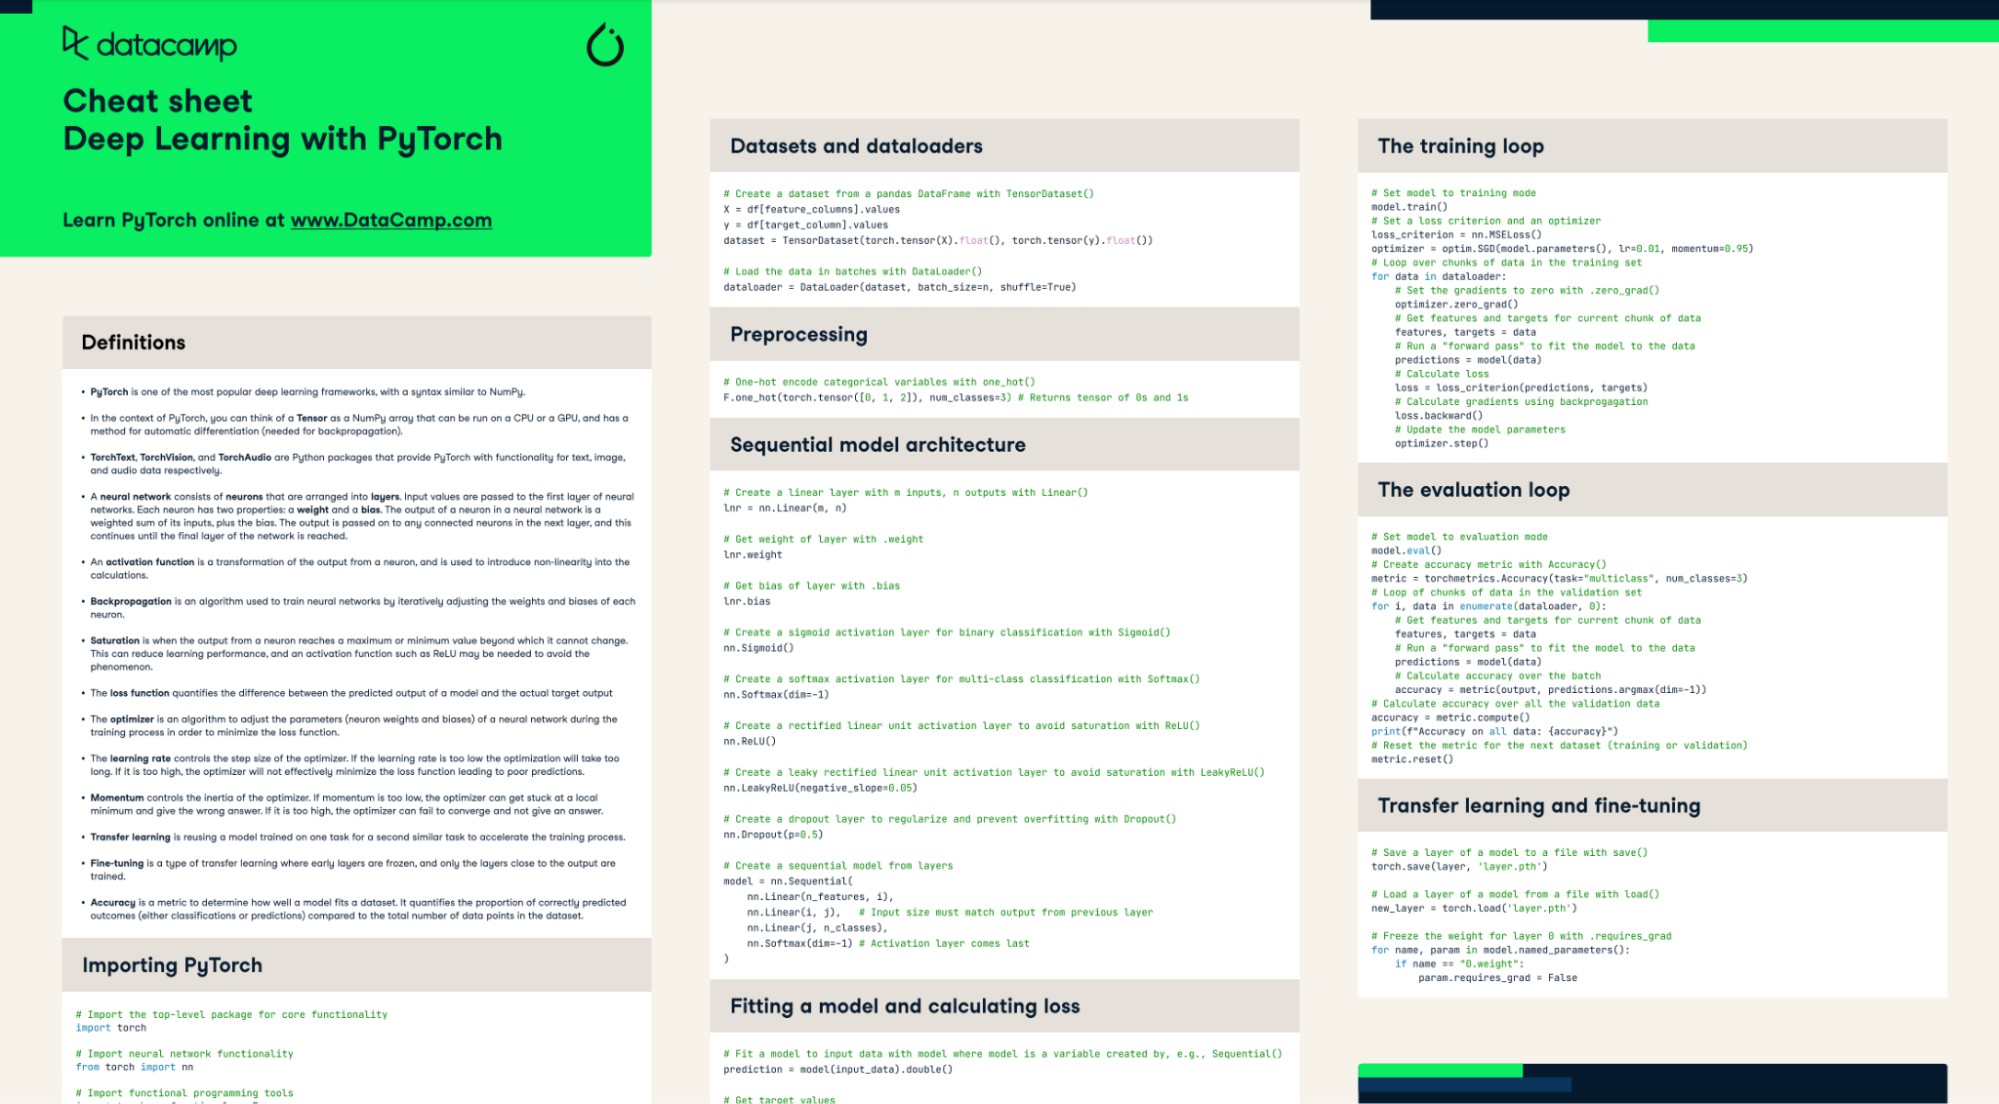
Làm chủ Pytorch với tờ ghi chú tiện dụng của chúng tôi
MLFlow là nền tảng mã nguồn mở từ Databricks để quản lý toàn bộ vòng đời học máy. Nó theo dõi thí nghiệm, đóng gói mô hình và triển khai vào sản xuất trong khi vẫn đảm bảo khả năng tái lập. Nó cũng tương thích với việc theo dõi LLM và hỗ trợ cả giao diện dòng lệnh lẫn giao diện đồ họa. Ngoài ra, còn cung cấp API cho Python, Java, R và Rest.
Hugging Face đã trở thành giải pháp một điểm đến cho phát triển học máy mã nguồn mở. Nền tảng này cung cấp quyền truy cập dễ dàng vào dữ liệu, các mô hình tối tân và suy luận, giúp bạn thuận tiện huấn luyện, đánh giá và triển khai mô hình bằng nhiều công cụ trong hệ sinh thái Hugging Face. Ngoài ra, nó còn cung cấp quyền truy cập GPU cao cấp và các giải pháp doanh nghiệp. Dù bạn là sinh viên, nhà nghiên cứu hay chuyên gia học máy, đây là nền tảng duy nhất bạn cần để phát triển các giải pháp xuất sắc cho dự án của mình.
Những nền tảng độc quyền mạnh mẽ mang lại khả năng ở quy mô doanh nghiệp, thiết lập một lần nhấp và dễ sử dụng. Chúng cũng cung cấp hỗ trợ và bảo mật cho dữ liệu của bạn.
Tableau là công cụ dẫn đầu trong phần mềm thông minh doanh nghiệp. Nó cho phép tạo các trực quan hóa và bảng điều khiển dữ liệu tương tác, trực quan, mở khóa insight từ dữ liệu ở quy mô lớn. Với Tableau, người dùng có thể kết nối với nhiều nguồn dữ liệu, làm sạch và chuẩn bị dữ liệu cho phân tích, rồi tạo các trực quan phong phú như biểu đồ, đồ thị và bản đồ. Phần mềm được thiết kế để dễ sử dụng, cho phép người không chuyên kỹ thuật tạo báo cáo và bảng điều khiển bằng thao tác kéo thả đơn giản.
RapidMiner là nền tảng phân tích nâng cao end-to-end để xây dựng học máy và pipeline dữ liệu, cung cấp trình thiết kế quy trình làm việc trực quan nhằm tinh gọn quy trình. Từ chuẩn bị dữ liệu đến triển khai mô hình, RapidMiner cung cấp mọi công cụ cần thiết để quản lý từng bước trong vòng đời ML. Trình thiết kế quy trình trực quan là lõi của RapidMiner, cho phép người dùng tạo pipeline dễ dàng mà không cần viết mã.
Trong năm qua, các công cụ AI đã trở nên thiết yếu cho phân tích dữ liệu. Chúng được dùng để sinh mã, kiểm định, hiểu kết quả, tạo báo cáo và nhiều hơn nữa.
ChatGPT là một công cụ được hỗ trợ bởi AI có thể trợ giúp bạn với nhiều tác vụ khoa học dữ liệu. Nó có khả năng tạo mã Python và thực thi, đồng thời có thể tạo trọn vẹn các báo cáo phân tích. Nhưng chưa dừng lại ở đó. ChatGPT đi kèm nhiều plugin có thể rất hữu ích cho nghiên cứu, thí nghiệm, toán học, thống kê, tự động hóa và rà soát tài liệu. Một số tính năng nổi bật gồm DALLE-3 (Tạo ảnh), Trình duyệt với Bing và ChatGPT Vision (Nhận diện hình ảnh).
Bạn có thể tham khảo Hướng dẫn sử dụng ChatGPT cho các dự án Khoa học Dữ liệu để học cách dùng ChatGPT và xây dựng các dự án khoa học dữ liệu end-to-end.
Đang tìm cách áp dụng các công cụ dữ liệu này vào bộ dữ liệu thực tế? DataCamp có thể đáp ứng nhu cầu của bạn. Họ cung cấp cả dự án có hướng dẫn và không hướng dẫn, có thể tải trên sổ tay có hỗ trợ AI gọi là DataLab, cho phép bạn bắt đầu làm dự án ngay lập tức. Danh sách dự án của DataCamp rất phong phú, bao trùm nhiều chủ đề như xử lý dữ liệu, học máy, kỹ thuật dữ liệu, MLOps, LLM, NLP và nhiều hơn nữa.
Dưới đây là các liên kết tới nhiều dự án khác giúp bạn áp dụng những công cụ tiên tiến cho bộ dữ liệu của mình:
Những phát triển đầy hứng khởi đang diễn ra trong lĩnh vực khoa học dữ liệu năng động, nơi đổi mới là điều bình thường. Bài viết này đã cung cấp cái nhìn tổng quan toàn diện về 10 công cụ khoa học dữ liệu hàng đầu đang ngày càng phổ biến và nhiều khả năng sẽ được ứng dụng nhiều hơn vào năm 2026.
Các thư viện dựa trên Python như Pandas, Seaborn và Scikit-learn cung cấp khả năng mạnh mẽ cho chuẩn bị dữ liệu, phân tích, trực quan hóa và mô hình hóa. Các nền tảng mã nguồn mở như MLflow, Pytorch và Hugging Face tăng tốc thí nghiệm, phát triển và triển khai. Các giải pháp độc quyền như Tableau và RapidMiner cho phép trí tuệ doanh nghiệp ở quy mô lớn và quản lý vòng đời học máy end-to-end. Và các trợ lý AI mới như ChatGPT tạo mã và insight, nâng cao năng suất.
Nếu bạn mong muốn trở thành một nhà khoa học dữ liệu giỏi và thành thạo sử dụng những công cụ này, hãy đăng ký lộ trình nghề nghiệp Data Scientist with Python. Chương trình này sẽ trang bị cho bạn các kỹ năng thiết yếu để xuất sắc trong vai trò nhà khoa học dữ liệu, từ thao tác dữ liệu đến học máy.
Bắt đầu hành trình Khoa học Dữ liệu của bạn ngay hôm nay!
Lộ trình
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
