Data science is uitgeroepen tot de 'sexyste baan van de 21e eeuw', en dat is niet zomaar een hyperbool. Het US Bureau of Labor Statistics voorspelt dat het aantal functies voor data scientists tussen 2023 en 2033 met 36% zal groeien, een duidelijk teken van het toenemende belang van dit vakgebied.
Maar wat is data science nu eigenlijk, en waarom is het zo belangrijk? In dit artikel nemen we je mee in de wereld van data science. Van de levenscyclus van data science, de toepassingen in verschillende sectoren, de vaardigheden die je nodig hebt om in data science te starten, en meer. We geven je een diepgaand beeld van het waarom en hoe achter de opkomst van data science als een van de meest dynamische sectoren van dit moment.
Wat is data science?
Data science is een interdisciplinaire discipline die wetenschappelijke methoden, processen, algoritmen en systemen gebruikt om kennis en inzichten te halen uit gestructureerde en ongestructureerde data. Simpeler gezegd: data science draait om het verkrijgen, verwerken en analyseren van data om inzichten te genereren voor allerlei doeleinden.
De levenscyclus van data science
De levenscyclus van data science verwijst naar de verschillende fasen die een dataproject doorgaans doorloopt: van het eerste idee en het verzamelen van data tot het communiceren van resultaten en inzichten.
Hoewel elk dataproject uniek is—afhankelijk van het probleem, de sector waarin het wordt toegepast en de betrokken data—volgen de meeste projecten een vergelijkbare levenscyclus.
Deze levenscyclus biedt een gestructureerde aanpak voor het omgaan met complexe data, het trekken van accurate conclusies en het nemen van datagedreven beslissingen.
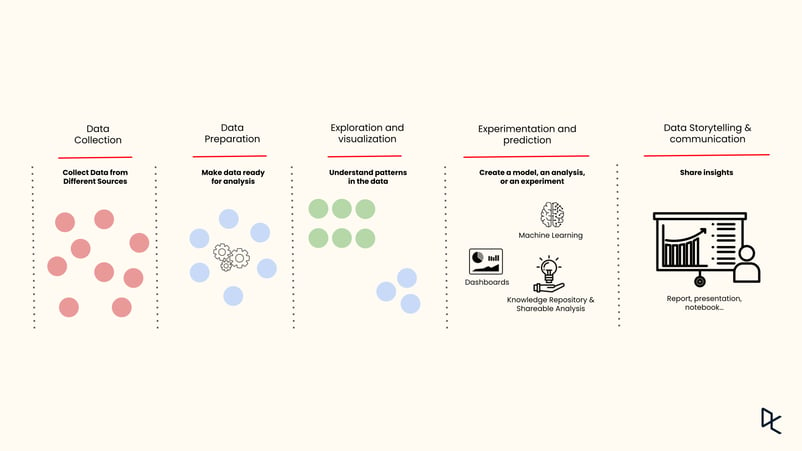
De levenscyclus van data science
Dit zijn de vijf belangrijkste fasen die de levenscyclus van data science structureren:
Dataverzameling en -opslag
In deze eerste fase verzamel je data uit verschillende bronnen, zoals databases, Excel-bestanden, tekstbestanden, API's, webscraping of zelfs realtime datastromen. Het type en de hoeveelheid data hangen grotendeels af van het probleem dat je wilt oplossen.
Na verzameling wordt de data opgeslagen in een geschikt formaat voor verdere verwerking. Het is belangrijk om data veilig en efficiënt op te slaan, zodat deze snel kan worden opgehaald en verwerkt.
Datavoorbereiding
Vaak de meest tijdrovende fase: het opschonen en transformeren van ruwe data naar een geschikt formaat voor analyse. Dit omvat het omgaan met ontbrekende of inconsistente data, het verwijderen van duplicaten, normalisatie en het converteren van datatypes. Het doel is een schoon, kwalitatief hoogwaardig dataset te creëren die accurate en betrouwbare analyseresultaten oplevert.
Exploratie en visualisatie
In deze fase verkennen data scientists de voorbereide data om patronen, kenmerken en mogelijke afwijkingen te begrijpen. Technieken zoals statistische analyse en datavisualisatie vatten de belangrijkste kenmerken van de data samen, vaak met visuele methoden.
Visualisatietools, zoals grafieken en diagrammen, maken de data begrijpelijker, zodat stakeholders trends en patronen beter kunnen doorgronden.
Experimentatie en voorspelling
Data scientists gebruiken in deze fase machinelearning-algoritmen en statistische modellen om patronen te identificeren, voorspellingen te doen of inzichten te ontdekken. Het doel is om iets betekenisvols uit de data te halen dat aansluit bij de projectdoelen, of dat nu gaat om het voorspellen van toekomstige uitkomsten, het classificeren van data of het blootleggen van verborgen patronen.
Dataverhalen en communicatie
De laatste fase draait om het interpreteren en communiceren van de resultaten uit de data-analyse. Inzichten alleen zijn niet genoeg; je moet ze effectief overbrengen met duidelijke, bondige taal en overtuigende visuals. Het doel is om bevindingen zo over te brengen aan niet-technische stakeholders dat ze besluitvorming beïnvloeden of strategische initiatieven aanjagen.
Door deze levenscyclus te begrijpen en te implementeren, pak je dataprojecten systematischer en succesvoller aan. Laten we nu ingaan op waarom data science zo belangrijk is.
Waarom is data science belangrijk?
Data science is uitgegroeid tot een revolutionair vakgebied dat cruciaal is voor het genereren van inzichten uit data en het transformeren van bedrijven. Het is niet overdreven om te zeggen dat data science de ruggengraat vormt van moderne industrieën. Maar waarom is het zo belangrijk geworden?
- Datavolume. Allereerst heeft de opkomst van digitale technologieën geleid tot een explosie aan data. Elke online transactie, sociale interactie en digitaal proces genereert data. Die data is echter pas waardevol als we er betekenisvolle inzichten uit kunnen halen. En precies daar komt data science om de hoek kijken.
- Waardecreatie. Ten tweede draait data science niet alleen om het analyseren van data; het gaat om het interpreteren en gebruiken van die data om onderbouwde zakelijke beslissingen te nemen, toekomstige trends te voorspellen, klantgedrag te begrijpen en operationele efficiëntie te verhogen. Dit vermogen om besluitvorming met data te sturen, maakt data science zo essentieel voor organisaties.
- Carrièremogelijkheden. Tot slot biedt data science lucratieve carrières. Met de groeiende vraag naar professionals die met data kunnen werken, zijn banen in data science tot de best betaalde in de sector. Volgens Glassdoor ligt het gemiddelde basissalaris voor een data scientist in de Verenigde Staten op $116.000, wat het een aantrekkelijke carrièrekeuze maakt.
Waarvoor wordt data science gebruikt?
Data science wordt ingezet voor tal van toepassingen, van het voorspellen van klantgedrag tot het optimaliseren van bedrijfsprocessen. De reikwijdte is groot en omvat verschillende typen analytics.
- Descriptieve analytics. Analyseert historische data om de huidige situatie te begrijpen en trends te identificeren. Een winkel kan dit bijvoorbeeld gebruiken om de verkoop van het afgelopen kwartaal te analyseren of bestsellers te bepalen.
- Diagnostische analytics. Onderzoekt data om te begrijpen waarom bepaalde gebeurtenissen plaatsvonden en identificeert patronen en afwijkingen. Als de verkoop van een bedrijf daalt, helpt dit te bepalen of dat komt door slechte productkwaliteit, toegenomen concurrentie of andere factoren.
- Predictieve analytics. Gebruikt statistische modellen om toekomstige uitkomsten te voorspellen op basis van historische data; veelgebruikt in financiën, gezondheidszorg en marketing. Een creditcardmaatschappij kan dit inzetten om het risico op wanbetaling te voorspellen.
- Prescriptieve analytics. Adviseert acties op basis van de resultaten van andere vormen van analytics om toekomstige problemen te beperken of gunstige trends te benutten. Denk aan een navigatie-app die de snelste route aanbeveelt op basis van actuele verkeersomstandigheden.
De toenemende verfijning van descriptief naar diagnostisch, predictief en prescriptief analytics kan bedrijven waardevolle inzichten geven voor besluitvorming en strategische planning. Lees meer over de vier typen analytics in een apart artikel.
Wat zijn de voordelen van data science?
Data science kan waarde toevoegen aan elk bedrijf dat zijn data benut. Van statistiek tot voorspellingen: effectieve datagedreven praktijken kunnen een bedrijf in een stroomversnelling brengen. Zo wordt data science ingezet:
Optimaliseer bedrijfsprocessen
Data science kan de operaties van een bedrijf aanzienlijk verbeteren in diverse afdelingen, van logistiek en supply chain tot HR en meer. Het helpt bij toewijzing van middelen, prestatie-evaluatie en procesautomatisering. Een logistiek bedrijf kan bijvoorbeeld data science gebruiken om routes te optimaliseren, levertijden te verkorten, brandstofkosten te besparen en klanttevredenheid te verhogen.
Ontdek nieuwe inzichten
Data science kan verborgen patronen en inzichten blootleggen die niet meteen zichtbaar zijn. Deze inzichten kunnen bedrijven een concurrentievoordeel geven en helpen hun bedrijf beter te begrijpen. Zo kan een bedrijf klantdata gebruiken om trends en voorkeuren te identificeren en producten of services daarop af te stemmen.
Creëer innovatieve producten en oplossingen
Bedrijven kunnen met data science innoveren en nieuwe producten of diensten ontwikkelen op basis van klantbehoeften en -voorkeuren. Ook maakt het het mogelijk om markttrends te voorspellen en voor te blijven op de concurrentie. Streamingdiensten zoals Netflix gebruiken data science bijvoorbeeld om kijkvoorkeuren te begrijpen en gepersonaliseerde aanbevelingen te doen, wat de gebruikservaring verbetert.
Welke sectoren gebruiken data science?
De impact van data science strekt zich uit over alle sectoren en verandert fundamenteel hoe organisaties werken en beslissingen nemen. Hoewel elke sector kan profiteren van data science, is de invloed het grootst in data-rijke domeinen.
Laten we dieper ingaan op hoe data science deze sleutelindustrieën verandert:
Toepassingen van data science in financiën
De financiële sector heeft de kracht van data science snel omarmd. Van fraudedetectie en algoritmische handel tot portefeuillevergelijking en risicobeoordeling: data science maakt complexe financiële operaties efficiënter en preciezer. Zo gebruiken creditcardmaatschappijen data science-technieken om fraude te detecteren en te voorkomen, wat jaarlijks miljarden dollars bespaart.
Leer meer over de financiële basis met Python en hoe je datagedreven financiële beslissingen kunt nemen met onze skill track.
Toepassingen van data science in de gezondheidszorg
Ook in de gezondheidszorg is de impact van data science groot. Toepassingen variëren van het voorspellen van ziekte-uitbraken en het verbeteren van de kwaliteit van zorg tot het optimaliseren van ziekenhuismanagement en medicijnontwikkeling. Predictieve modellen helpen artsen om ziekten vroeg te diagnosticeren en behandelingen af te stemmen op de specifieke behoeften van patiënten, wat leidt tot betere uitkomsten.
Ontdek meer over hoe data science de gezondheidszorg verandert in een DataFramed-podcastaflevering.
Toepassingen van data science in marketing
Marketing is sterk veranderd door de komst van data science. Toepassingen variëren van klantsegmentatie en gerichte advertenties tot sales forecasting en sentimentanalyse. Data science stelt marketeers in staat om consumentengedrag ongekend gedetailleerd te begrijpen en effectievere campagnes te maken. Predictive analytics helpt ook om potentiële markttrends te identificeren en zo een voorsprong te nemen. Personalisatie-algoritmen kunnen productaanbevelingen afstemmen op individuele klanten, wat de omzet en klanttevredenheid verhoogt.
We hebben een aparte blogpost met vijf manieren om data science in marketing te gebruiken, waarin enkele methoden in de sector worden verkend. Je kunt ook meer leren in onze skill track Marketing Analytics met Python.
Toepassingen van data science in technologie
Technologiebedrijven profiteren misschien wel het meest van data science. Van het aansturen van aanbevelingssystemen tot het verbeteren van spraak- en beeldherkenning: data science wordt op uiteenlopende gebieden toegepast. Ride-hailingplatforms vertrouwen bijvoorbeeld op data science om chauffeurs te koppelen aan ritten en het aanbod van chauffeurs te optimaliseren afhankelijk van het tijdstip van de dag.
Hoe verschilt data science van andere data-gerelateerde vakgebieden?
Hoewel data science overlappen vertoont met veel andere data-gedreven disciplines, heeft het een unieke mix van principes, tools en technieken die zijn ontworpen om betekenisvolle patronen uit data te halen.
Het onderscheid tussen data science en aanverwante vakgebieden helpt je het landschap beter te begrijpen en de juiste loopbaanrichting te kiezen. Laten we deze verschillen ontrafelen.
Data science vs. data-analyse
Data science en data-analyse spelen allebei een cruciale rol bij het halen van waarde uit data, maar de focus verschilt. Data science is een overkoepelend vakgebied dat methoden gebruikt, waaronder machine learning en predictieve analytics, om inzichten uit data te halen. Data-analyse richt zich daarentegen op het verwerken en statistisch analyseren van bestaande datasets om specifieke vragen te beantwoorden.
Data science vs. business analytics
Business analytics houdt zich ook bezig met data-analyse, maar is sterker gericht op het benutten van data voor strategische bedrijfsbeslissingen. Het is over het algemeen minder technisch en meer business-gericht dan data science. Data science kan weliswaar bedrijfsstrategieën informeren, maar duikt vaak dieper in technische aspecten zoals programmeren en machine learning.
Data science vs. data-engineering
Data-engineering richt zich op het bouwen en onderhouden van de infrastructuur voor dataverzameling, -opslag en -verwerking, zodat data schoon en toegankelijk is. Data science analyseert deze data met statistische en machinelearning-modellen om waardevolle inzichten te halen die de besluitvorming sturen. Simpel gezegd: data engineers leggen de 'dataroutes' aan, terwijl data scientists erop 'rijden' om betekenisvolle inzichten te vinden. Beide rollen zijn onmisbaar in een datagedreven organisatie.
Data science vs. machine learning
Machine learning is een subset van data science en richt zich op het ontwikkelen en toepassen van algoritmen waarmee machines kunnen leren van data en beslissingen kunnen nemen. Data science is breder en omvat veel technieken, waaronder machine learning, om betekenisvolle informatie uit data te halen.
Data science vs. statistiek
Statistiek, de wiskundige discipline rond dataverzameling, -analyse, -interpretatie en -organisatie, is een belangrijk onderdeel van data science. Data science combineert statistiek echter met andere methoden om inzichten uit data te halen en is daarmee multidisciplinairder.
|
Sector
|
Focus
|
Technische nadruk
|
|
Data science
|
Waarde creëren met data over de 4 niveaus van analytics
|
Programmeren, ML, statistiek
|
|
Data-analyse
|
Statistische analyse uitvoeren op bestaande datasets
|
Statistische analyse
|
|
Business analytics
|
Data benutten voor strategische bedrijfsbeslissingen
|
Bedrijfsstrategieën, data-analyse
|
|
Data-engineering
|
Datainfrastructuur bouwen en onderhouden
|
Dataverzameling, -opslag, -verwerking
|
|
Machine learning
|
Algoritmen voor machine learning ontwikkelen en implementeren
|
Algoritme-ontwikkeling, modelimplementatie
|
|
Statistiek
|
Dataverzameling, analyse, interpretatie en organisatie
|
Statistische analyse, wiskundige principes
|
Nu we deze verschillen begrijpen, kunnen we ingaan op de kernconcepten die elke data scientist moet beheersen.
Belangrijke concepten in data science
Een succesvolle data scientist heeft niet alleen technische skills, maar ook begrip van de kernconcepten die de basis van het vakgebied vormen. Dit zijn enkele sleutelconcepten:
Statistiek en kansrekening
Dit zijn de fundamenten van data science. Met statistiek destilleer je betekenisvolle inzichten uit data, en met kansrekening kun je voorspellingen doen over toekomstige gebeurtenissen op basis van beschikbare data. Inzicht in verdelingen, statistische toetsen en kansmodellen is essentieel voor elke data scientist.
Resources om te beginnen
Programmeren
Programmeren is het gereedschap waarmee data scientists met data werken. Talen als Python en R zijn bijzonder populair vanwege hun gebruiksgemak en krachtige bibliotheken voor data. Kennis van deze talen stelt een data scientist in staat om data effectief op te schonen, te verwerken en te analyseren.
Resources om te beginnen
Datavisualisatie
Datavisualisatie is de kunst om complexe data visueel en begrijpelijk weer te geven. Het helpt bevindingen te communiceren en maakt het makkelijker om complexe datasets te doorgronden. Tools zoals Tableau, Matplotlib en Seaborn worden hier vaak voor gebruikt.
Resources om te beginnen
Machine learning
Machine learning, een subset van kunstmatige intelligentie, houdt in dat je een model traint op data om voorspellingen of beslissingen te maken zonder expliciete programmering. Het vormt het hart van veel moderne data science-toepassingen, van aanbevelingssystemen tot predictieve analytics.
Resources om te beginnen
Data-engineering
Data-engineering richt zich op het ontwerpen en bouwen van systemen voor het verzamelen, opslaan en verwerken van data. Het vormt de basis waarop data-analyse en machinelearning-modellen worden gebouwd.
Resources om te beginnen
Data scientists hebben een set tools nodig om hun werk effectief te doen. Deze tools variëren van programmeertalen tot software voor datavisualisatie. Dit zijn enkele essentiële tools.
Programmeertalen
Binnen data science zijn programmeertalen het gereedschap van het vak. Ze bieden een kader om een computer specifieke taken te laten uitvoeren, zoals datamanipulatie, statistische analyse en machine learning. Dit zijn enkele belangrijke talen die elke data scientist zou moeten overwegen te beheersen:
- Python. Bekend om zijn eenvoud en krachtige bibliotheken zoals pandas en NumPy.
- R. Uitstekend voor statistische analyse en visualisatie.
- Julia. Bekend om hoge prestaties en snelheid; ideaal voor numerieke en wetenschappelijke computing.
Resources om te beginnen
Business Intelligence (BI)-tools zijn softwaretoepassingen die worden gebruikt om ruwe data van een organisatie te analyseren. Ze helpen bij visualisatie, rapportage en het delen van inzichten, zodat bedrijven datagedreven beslissingen kunnen nemen. Enkele essentiële BI-tools voor data science:
- Tableau. Voor het maken van interactieve datavisualisaties.
- Power BI. Microsofts suite met businessanalysetools.
- QlikView. Combineert ETL, dataopslag en visualisatie.
Resources om te beginnen
Machinelearning-bibliotheken
Machinelearning-bibliotheken zijn verzamelingen voorgeprogrammeerde code die data scientists tijd besparen. Ze bieden kant-en-klare algoritmen en leerroutines die je in programma's kunt integreren. Dit zijn enkele belangrijke bibliotheken die ML-taken stroomlijnen:
- Scikit-learn. Biedt diverse algoritmen voor classificatie, regressie, clustering, enz.
- TensorFlow. Door Google ontwikkeld voor het bouwen van neurale netwerken.
- PyTorch. Bekend om zijn dynamische computation graph.
Resources om te beginnen
Databasemanagementsystemen
Database Management Systems (DBMS) zijn softwaretoepassingen die met de gebruiker, andere applicaties en de database interageren om data vast te leggen en te analyseren. Een DBMS biedt een systematische manier om data te creëren, op te halen, bij te werken en te beheren. Populaire DBMS die in data science worden gebruikt:
- MySQL. Een open-source relationeel databasesysteem.
- PostgreSQL. Biedt geavanceerde functies zoals Multi-Version Concurrency Control.
- MongoDB. Een populaire NoSQL-database.
Resources om te beginnen
Topbanen in data science
Data science is een breed veld met veel gespecialiseerde rollen, elk met eigen verantwoordelijkheden, skillvereisten en salarisverwachtingen. Dit zijn enkele van de meest gevraagde functietitels binnen data science:
Data-analist
Data-analisten spelen een cruciale rol bij het interpreteren van de data van een organisatie. Ze beheersen wiskundige en statistische analyses en kunnen complexe datasets omzetten in concrete inzichten die zakelijke beslissingen sturen. Met datavisualisatietools communiceren ze hun bevindingen effectief naar zowel technische als niet-technische stakeholders.
Data-analisten duiken in data en leveren rapporten en visualisaties die verborgen inzichten onthullen. Hoewel ze niet per se geavanceerde algoritmen ontwikkelen, gebruiken ze een reeks tools om data te duiden. Hun taken omvatten vaak ook SQL-queries, datacleaning en datamanagement. Lees meer over hoe je data-analist wordt in een apart artikel.
Belangrijke skills:
- Vaardig in SQL, Python of R
- Sterke kennis van statistische analyse
- Vermogen om overtuigende datavisualisaties en rapporten te maken
- Bekwaam in datacleaning en -beheer
- Effectieve communicatieve vaardigheden
Essentiële tools:
- SQL voor databasequeries
- Programmeertalen zoals Python of R voor datamanipulatie
- Datavisualisatietools zoals Tableau of Power BI
- Spreadsheettools zoals MS Excel of Google Sheets
- Statistische software zoals SPSS of SAS
Data scientist
Data scientists duiken in de data van een organisatie om betekenisvolle inzichten te vinden en te communiceren. Ze hebben een diep begrip van machinelearning-workflows en hoe ze die toepassen op realistische businesscases. Data scientists werken vooral met code, voeren grondige analyses uit en gebruiken vaak bigdatatools.
Data scientists zijn te vergelijken met detectives in de dataruimte. Ze sporen rijke databronnen op en interpreteren die, beheren grote datasets en identificeren trends door datapunten te combineren. Met analytische, statistische en programmeervaardigheden verzamelen, analyseren en interpreteren ze omvangrijke datasets. Deze inzichten sturen de ontwikkeling van datagedreven oplossingen voor complexe bedrijfsproblemen, vaak via het bouwen van machinelearning-algoritmen om nieuwe inzichten te genereren, processen te automatiseren of klanten meer waarde te bieden.
We hebben een volledige gids over hoe je data scientist wordt, met de belangrijkste stappen om te beginnen.
Belangrijke skills:
- Goede beheersing van Python, R en SQL
- Inzicht in concepten van machine learning en AI
- Vaardig in statistische analyse, kwantitatieve analytics en predictieve modellering
- Data effectief kunnen visualiseren en rapporteren
- Uitstekende communicatie- en presentatieskills
Essentiële tools:
- Data-analysetools zoals Pandas en NumPy
- Machinelearning-bibliotheken zoals Scikit-learn
- Datavisualisatietools zoals Matplotlib en Tableau
- Bigdata-frameworks zoals Airflow en Spark
- Commandlinetools zoals Git en Bash
Data-engineer
Data-engineers zijn de architecten van de datawereld. Ze ontwerpen, bouwen en beheren datainfrastructuur, zodat data scientists efficiënt kunnen analyseren. Data-engineers focussen op dataverzameling, -opslag en -verwerking en zetten datapijplijnen op die het analysetraject stroomlijnen.
Data-engineers houden zich vaak bezig met algoritmen voor informatie-extractie en bouwen databasesystemen. Ze zorgen voor optimale prestaties door data-architectuur, databases en verwerkende systemen te beheren. Deze rol vereist een brede kennis van programmeertalen en ervaring met relationele en niet-relationele databases. Lees meer over data-engineer worden in een apart artikel.
Belangrijke skills:
- Expertise in SQL en databaseontwerp
- Vaardig in programmeertalen zoals Python of Java
- Kennis van bigdatatechnologieën zoals Hadoop of Spark
- Vertrouwd met datamodellering en principes van datawarehousing
- Sterke probleemoplossende en communicatieve vaardigheden
Tools:
- SQL voor databasemanagement
- Programmeertalen voor het bouwen van datapijplijnen (bijv. Python, Java)
- Bigdataplatforms zoals Hadoop en Spark
- ETL-tools (Extract, Transform, Load) zoals Informatica of Talend
- NoSQL-databases zoals MongoDB of Cassandra
Machine learning engineer
Machine learning engineers zijn de architecten van de AI-wereld. Ze ontwerpen en implementeren ML-systemen die organisatiedata gebruiken om voorspellingen te doen. Ze pakken ook uitdagingen aan zoals churnvoorspelling en klantwaarde-inschatting en zetten modellen in voor gebruik binnen de organisatie. ML-engineers werken vooral met code-gebaseerde tools.
Bekijk onze volledige gids over hoe je machine learning engineer wordt in een apart artikel.
Belangrijke skills:
- Diepgaande kennis van Python, Java en Scala
- Vertrouwd met ML-frameworks zoals Scikit-learn, Keras of PyTorch
- Inzicht in datastructuren, datamodellering en software-architectuur
- Gevorderde wiskundige vaardigheden in lineaire algebra, calculus en statistiek
- Sterk teamwerken en uitstekend probleemoplossend vermogen
Tools:
- ML-bibliotheken en -algoritmen (bijv. Scikit-learn, TensorFlow)
- Data science-bibliotheken zoals Pandas en NumPy
- Cloudplatforms zoals AWS of Google Cloud Platform
- Versiebeheersystemen zoals Git
AI-onderzoeker
AI-onderzoekers richten zich op het verder ontwikkelen van kunstmatige intelligentie door algoritmen en modellen te creëren en te verbeteren. Ze pakken complexe uitdagingen aan, zoals computers leren taal te begrijpen, beelden te herkennen of van ervaring te leren. Hun werk slaat vaak een brug tussen academisch onderzoek en praktische toepassingen en drijft innovaties in AI.
Zo kunnen ze slimmere chatbots ontwikkelen, systemen voor zelfrijdende auto's verbeteren of AI-modellen ontwerpen voor de gezondheidszorg. Deze rol vereist zowel technische expertise als creatief probleemoplossen.
Belangrijke skills:
- Sterke kennis van machine learning en AI-technieken
- Ervaring met neurale netwerken, natural language processing of computer vision
- Vaardig in Python en tools zoals TensorFlow of PyTorch
- Stevige wiskundebasis, zoals lineaire algebra en kansrekening
- Vermogen om theoretische ideeën om te zetten in praktische oplossingen
Essentiële tools:
- Deep learning-frameworks (bijv. TensorFlow, PyTorch)
- Cloudplatforms zoals AWS of Google Cloud
- Versiebeheer zoals Git
- Onderzoeksomgevingen zoals Jupyter Notebooks
- High-performance hardware zoals GPU's
AI-onderzoekers spelen een sleutelrol in het vormgeven van de toekomst van AI. Ze creëren technologieën die slimmere toepassingen aandrijven, automatisering versterken en echte problemen oplossen.
|
Rol
|
Verantwoordelijkheden
|
Belangrijke skills
|
Essentiële tools
|
|
Data-analist
|
Inzichten uit data halen en rapporteren voor zakelijke probleemoplossing
|
SQL, Python of R
|
SQL, Python of R, datavisualisatietools (bijv. Tableau, Power BI), statistische software (bijv. SPSS, SAS), spreadsheettools
|
|
Data scientist
|
Betekenisvolle inzichten ontdekken, datagedreven oplossingen ontwikkelen met machine learning, bevindingen communiceren
|
Python, R, SQL, ML- en AI-concepten, statistische analyse, datavisualisatie, communicatie- en presentatieskills
|
Pandas, NumPy, Scikit-learn, Matplotlib, Tableau, Airflow, Spark, Git, Bash
|
|
Data-engineer
|
Datainfrastructuur ontwerpen, bouwen en beheren; datapijplijnen opzetten; optimale prestaties waarborgen
|
SQL, Python, Java, databaseontwerp, bigdatatechnologieën, datamodellering, probleemoplossen, communicatieve vaardigheden
|
SQL, Python, Java, Hadoop, Spark, ETL-tools, NoSQL-databases
|
|
Machine learning engineer
|
ML-systemen ontwerpen en inzetten, complexe problemen oplossen met ML, samenwerken met teams
|
Python, Java, Scala, ML-frameworks, datastructuren, software-architectuur, wiskunde, teamwork, probleemoplossende vaardigheden
|
Scikit-learn, TensorFlow, Pandas, NumPy, cloudplatforms (bijv. AWS, Google Cloud Platform), versiebeheersystemen (bijv. Git)
|
|
AI-onderzoeker
|
Geavanceerde AI-modellen ontwikkelen, algoritmen verbeteren en complexe problemen oplossen zoals NLP of computer vision
|
Machine learning, neurale netwerken, natural language processing, computer vision, Python, TensorFlow, PyTorch, wiskundige skills
|
TensorFlow, PyTorch, Jupyter Notebooks, cloudplatforms (bijv. AWS, Google Cloud), GPU's voor high-performance computing
|
Hoe begin je met data science
Data science is interdisciplinair, en om te starten heb je een mix nodig van vaardigheden uit wiskunde, statistiek, informatica en domeinkennis. Dit zou een mogelijk stappenplan kunnen zijn om je reis in data science te beginnen.


Data science is uitgeroepen tot de 'sexyste baan van de 21e eeuw', en dat is niet zomaar een hyperbool. Het US Bureau of Labor Statistics voorspelt dat het aantal functies voor data scientists tussen 2023 en 2033 met 36% zal groeien, een duidelijk teken van het toenemende belang van dit vakgebied.
Maar wat is data science nu eigenlijk, en waarom is het zo belangrijk? In dit artikel nemen we je mee in de wereld van data science. Van de levenscyclus van data science, de toepassingen in verschillende sectoren, de vaardigheden die je nodig hebt om in data science te starten, en meer. We geven je een diepgaand beeld van het waarom en hoe achter de opkomst van data science als een van de meest dynamische sectoren van dit moment.
Wat is data science?
Data science is een interdisciplinaire discipline die wetenschappelijke methoden, processen, algoritmen en systemen gebruikt om kennis en inzichten te halen uit gestructureerde en ongestructureerde data. Simpeler gezegd: data science draait om het verkrijgen, verwerken en analyseren van data om inzichten te genereren voor allerlei doeleinden.
De levenscyclus van data science
De levenscyclus van data science verwijst naar de verschillende fasen die een dataproject doorgaans doorloopt: van het eerste idee en het verzamelen van data tot het communiceren van resultaten en inzichten.
Hoewel elk dataproject uniek is—afhankelijk van het probleem, de sector waarin het wordt toegepast en de betrokken data—volgen de meeste projecten een vergelijkbare levenscyclus.
Deze levenscyclus biedt een gestructureerde aanpak voor het omgaan met complexe data, het trekken van accurate conclusies en het nemen van datagedreven beslissingen.
De levenscyclus van data science
Dit zijn de vijf belangrijkste fasen die de levenscyclus van data science structureren:
Dataverzameling en -opslag
In deze eerste fase verzamel je data uit verschillende bronnen, zoals databases, Excel-bestanden, tekstbestanden, API's, webscraping of zelfs realtime datastromen. Het type en de hoeveelheid data hangen grotendeels af van het probleem dat je wilt oplossen.
Na verzameling wordt de data opgeslagen in een geschikt formaat voor verdere verwerking. Het is belangrijk om data veilig en efficiënt op te slaan, zodat deze snel kan worden opgehaald en verwerkt.
Datavoorbereiding
Vaak de meest tijdrovende fase: het opschonen en transformeren van ruwe data naar een geschikt formaat voor analyse. Dit omvat het omgaan met ontbrekende of inconsistente data, het verwijderen van duplicaten, normalisatie en het converteren van datatypes. Het doel is een schoon, kwalitatief hoogwaardig dataset te creëren die accurate en betrouwbare analyseresultaten oplevert.
Exploratie en visualisatie
In deze fase verkennen data scientists de voorbereide data om patronen, kenmerken en mogelijke afwijkingen te begrijpen. Technieken zoals statistische analyse en datavisualisatie vatten de belangrijkste kenmerken van de data samen, vaak met visuele methoden.
Visualisatietools, zoals grafieken en diagrammen, maken de data begrijpelijker, zodat stakeholders trends en patronen beter kunnen doorgronden.
Experimentatie en voorspelling
Data scientists gebruiken in deze fase machinelearning-algoritmen en statistische modellen om patronen te identificeren, voorspellingen te doen of inzichten te ontdekken. Het doel is om iets betekenisvols uit de data te halen dat aansluit bij de projectdoelen, of dat nu gaat om het voorspellen van toekomstige uitkomsten, het classificeren van data of het blootleggen van verborgen patronen.
Dataverhalen en communicatie
De laatste fase draait om het interpreteren en communiceren van de resultaten uit de data-analyse. Inzichten alleen zijn niet genoeg; je moet ze effectief overbrengen met duidelijke, bondige taal en overtuigende visuals. Het doel is om bevindingen zo over te brengen aan niet-technische stakeholders dat ze besluitvorming beïnvloeden of strategische initiatieven aanjagen.
Door deze levenscyclus te begrijpen en te implementeren, pak je dataprojecten systematischer en succesvoller aan. Laten we nu ingaan op waarom data science zo belangrijk is.
Waarom is data science belangrijk?
Data science is uitgegroeid tot een revolutionair vakgebied dat cruciaal is voor het genereren van inzichten uit data en het transformeren van bedrijven. Het is niet overdreven om te zeggen dat data science de ruggengraat vormt van moderne industrieën. Maar waarom is het zo belangrijk geworden?
Waarvoor wordt data science gebruikt?
Data science wordt ingezet voor tal van toepassingen, van het voorspellen van klantgedrag tot het optimaliseren van bedrijfsprocessen. De reikwijdte is groot en omvat verschillende typen analytics.
De toenemende verfijning van descriptief naar diagnostisch, predictief en prescriptief analytics kan bedrijven waardevolle inzichten geven voor besluitvorming en strategische planning. Lees meer over de vier typen analytics in een apart artikel.
Wat zijn de voordelen van data science?
Data science kan waarde toevoegen aan elk bedrijf dat zijn data benut. Van statistiek tot voorspellingen: effectieve datagedreven praktijken kunnen een bedrijf in een stroomversnelling brengen. Zo wordt data science ingezet:
Optimaliseer bedrijfsprocessen
Data science kan de operaties van een bedrijf aanzienlijk verbeteren in diverse afdelingen, van logistiek en supply chain tot HR en meer. Het helpt bij toewijzing van middelen, prestatie-evaluatie en procesautomatisering. Een logistiek bedrijf kan bijvoorbeeld data science gebruiken om routes te optimaliseren, levertijden te verkorten, brandstofkosten te besparen en klanttevredenheid te verhogen.
Ontdek nieuwe inzichten
Data science kan verborgen patronen en inzichten blootleggen die niet meteen zichtbaar zijn. Deze inzichten kunnen bedrijven een concurrentievoordeel geven en helpen hun bedrijf beter te begrijpen. Zo kan een bedrijf klantdata gebruiken om trends en voorkeuren te identificeren en producten of services daarop af te stemmen.
Creëer innovatieve producten en oplossingen
Bedrijven kunnen met data science innoveren en nieuwe producten of diensten ontwikkelen op basis van klantbehoeften en -voorkeuren. Ook maakt het het mogelijk om markttrends te voorspellen en voor te blijven op de concurrentie. Streamingdiensten zoals Netflix gebruiken data science bijvoorbeeld om kijkvoorkeuren te begrijpen en gepersonaliseerde aanbevelingen te doen, wat de gebruikservaring verbetert.
Welke sectoren gebruiken data science?
De impact van data science strekt zich uit over alle sectoren en verandert fundamenteel hoe organisaties werken en beslissingen nemen. Hoewel elke sector kan profiteren van data science, is de invloed het grootst in data-rijke domeinen.
Laten we dieper ingaan op hoe data science deze sleutelindustrieën verandert:
Toepassingen van data science in financiën
De financiële sector heeft de kracht van data science snel omarmd. Van fraudedetectie en algoritmische handel tot portefeuillevergelijking en risicobeoordeling: data science maakt complexe financiële operaties efficiënter en preciezer. Zo gebruiken creditcardmaatschappijen data science-technieken om fraude te detecteren en te voorkomen, wat jaarlijks miljarden dollars bespaart.
Leer meer over de financiële basis met Python en hoe je datagedreven financiële beslissingen kunt nemen met onze skill track.
Toepassingen van data science in de gezondheidszorg
Ook in de gezondheidszorg is de impact van data science groot. Toepassingen variëren van het voorspellen van ziekte-uitbraken en het verbeteren van de kwaliteit van zorg tot het optimaliseren van ziekenhuismanagement en medicijnontwikkeling. Predictieve modellen helpen artsen om ziekten vroeg te diagnosticeren en behandelingen af te stemmen op de specifieke behoeften van patiënten, wat leidt tot betere uitkomsten.
Ontdek meer over hoe data science de gezondheidszorg verandert in een DataFramed-podcastaflevering.
Toepassingen van data science in marketing
Marketing is sterk veranderd door de komst van data science. Toepassingen variëren van klantsegmentatie en gerichte advertenties tot sales forecasting en sentimentanalyse. Data science stelt marketeers in staat om consumentengedrag ongekend gedetailleerd te begrijpen en effectievere campagnes te maken. Predictive analytics helpt ook om potentiële markttrends te identificeren en zo een voorsprong te nemen. Personalisatie-algoritmen kunnen productaanbevelingen afstemmen op individuele klanten, wat de omzet en klanttevredenheid verhoogt.
We hebben een aparte blogpost met vijf manieren om data science in marketing te gebruiken, waarin enkele methoden in de sector worden verkend. Je kunt ook meer leren in onze skill track Marketing Analytics met Python.
Toepassingen van data science in technologie
Technologiebedrijven profiteren misschien wel het meest van data science. Van het aansturen van aanbevelingssystemen tot het verbeteren van spraak- en beeldherkenning: data science wordt op uiteenlopende gebieden toegepast. Ride-hailingplatforms vertrouwen bijvoorbeeld op data science om chauffeurs te koppelen aan ritten en het aanbod van chauffeurs te optimaliseren afhankelijk van het tijdstip van de dag.
Hoe verschilt data science van andere data-gerelateerde vakgebieden?
Hoewel data science overlappen vertoont met veel andere data-gedreven disciplines, heeft het een unieke mix van principes, tools en technieken die zijn ontworpen om betekenisvolle patronen uit data te halen.
Het onderscheid tussen data science en aanverwante vakgebieden helpt je het landschap beter te begrijpen en de juiste loopbaanrichting te kiezen. Laten we deze verschillen ontrafelen.
Data science vs. data-analyse
Data science en data-analyse spelen allebei een cruciale rol bij het halen van waarde uit data, maar de focus verschilt. Data science is een overkoepelend vakgebied dat methoden gebruikt, waaronder machine learning en predictieve analytics, om inzichten uit data te halen. Data-analyse richt zich daarentegen op het verwerken en statistisch analyseren van bestaande datasets om specifieke vragen te beantwoorden.
Data science vs. business analytics
Business analytics houdt zich ook bezig met data-analyse, maar is sterker gericht op het benutten van data voor strategische bedrijfsbeslissingen. Het is over het algemeen minder technisch en meer business-gericht dan data science. Data science kan weliswaar bedrijfsstrategieën informeren, maar duikt vaak dieper in technische aspecten zoals programmeren en machine learning.
Data science vs. data-engineering
Data-engineering richt zich op het bouwen en onderhouden van de infrastructuur voor dataverzameling, -opslag en -verwerking, zodat data schoon en toegankelijk is. Data science analyseert deze data met statistische en machinelearning-modellen om waardevolle inzichten te halen die de besluitvorming sturen. Simpel gezegd: data engineers leggen de 'dataroutes' aan, terwijl data scientists erop 'rijden' om betekenisvolle inzichten te vinden. Beide rollen zijn onmisbaar in een datagedreven organisatie.
Data science vs. machine learning
Machine learning is een subset van data science en richt zich op het ontwikkelen en toepassen van algoritmen waarmee machines kunnen leren van data en beslissingen kunnen nemen. Data science is breder en omvat veel technieken, waaronder machine learning, om betekenisvolle informatie uit data te halen.
Data science vs. statistiek
Statistiek, de wiskundige discipline rond dataverzameling, -analyse, -interpretatie en -organisatie, is een belangrijk onderdeel van data science. Data science combineert statistiek echter met andere methoden om inzichten uit data te halen en is daarmee multidisciplinairder.
Sector
Focus
Technische nadruk
Data science
Waarde creëren met data over de 4 niveaus van analytics
Programmeren, ML, statistiek
Data-analyse
Statistische analyse uitvoeren op bestaande datasets
Statistische analyse
Business analytics
Data benutten voor strategische bedrijfsbeslissingen
Bedrijfsstrategieën, data-analyse
Data-engineering
Datainfrastructuur bouwen en onderhouden
Dataverzameling, -opslag, -verwerking
Machine learning
Algoritmen voor machine learning ontwikkelen en implementeren
Algoritme-ontwikkeling, modelimplementatie
Statistiek
Dataverzameling, analyse, interpretatie en organisatie
Statistische analyse, wiskundige principes
Nu we deze verschillen begrijpen, kunnen we ingaan op de kernconcepten die elke data scientist moet beheersen.
Belangrijke concepten in data science
Een succesvolle data scientist heeft niet alleen technische skills, maar ook begrip van de kernconcepten die de basis van het vakgebied vormen. Dit zijn enkele sleutelconcepten:
Statistiek en kansrekening
Dit zijn de fundamenten van data science. Met statistiek destilleer je betekenisvolle inzichten uit data, en met kansrekening kun je voorspellingen doen over toekomstige gebeurtenissen op basis van beschikbare data. Inzicht in verdelingen, statistische toetsen en kansmodellen is essentieel voor elke data scientist.
Resources om te beginnen
Programmeren
Programmeren is het gereedschap waarmee data scientists met data werken. Talen als Python en R zijn bijzonder populair vanwege hun gebruiksgemak en krachtige bibliotheken voor data. Kennis van deze talen stelt een data scientist in staat om data effectief op te schonen, te verwerken en te analyseren.
Resources om te beginnen
Datavisualisatie
Datavisualisatie is de kunst om complexe data visueel en begrijpelijk weer te geven. Het helpt bevindingen te communiceren en maakt het makkelijker om complexe datasets te doorgronden. Tools zoals Tableau, Matplotlib en Seaborn worden hier vaak voor gebruikt.
Resources om te beginnen
Machine learning
Machine learning, een subset van kunstmatige intelligentie, houdt in dat je een model traint op data om voorspellingen of beslissingen te maken zonder expliciete programmering. Het vormt het hart van veel moderne data science-toepassingen, van aanbevelingssystemen tot predictieve analytics.
Resources om te beginnen
Data-engineering
Data-engineering richt zich op het ontwerpen en bouwen van systemen voor het verzamelen, opslaan en verwerken van data. Het vormt de basis waarop data-analyse en machinelearning-modellen worden gebouwd.
Resources om te beginnen
Belangrijke tools voor data science
Data scientists hebben een set tools nodig om hun werk effectief te doen. Deze tools variëren van programmeertalen tot software voor datavisualisatie. Dit zijn enkele essentiële tools.
Programmeertalen
Binnen data science zijn programmeertalen het gereedschap van het vak. Ze bieden een kader om een computer specifieke taken te laten uitvoeren, zoals datamanipulatie, statistische analyse en machine learning. Dit zijn enkele belangrijke talen die elke data scientist zou moeten overwegen te beheersen:
Resources om te beginnen
Business intelligence-tools
Business Intelligence (BI)-tools zijn softwaretoepassingen die worden gebruikt om ruwe data van een organisatie te analyseren. Ze helpen bij visualisatie, rapportage en het delen van inzichten, zodat bedrijven datagedreven beslissingen kunnen nemen. Enkele essentiële BI-tools voor data science:
Resources om te beginnen
Machinelearning-bibliotheken
Machinelearning-bibliotheken zijn verzamelingen voorgeprogrammeerde code die data scientists tijd besparen. Ze bieden kant-en-klare algoritmen en leerroutines die je in programma's kunt integreren. Dit zijn enkele belangrijke bibliotheken die ML-taken stroomlijnen:
Resources om te beginnen
Databasemanagementsystemen
Database Management Systems (DBMS) zijn softwaretoepassingen die met de gebruiker, andere applicaties en de database interageren om data vast te leggen en te analyseren. Een DBMS biedt een systematische manier om data te creëren, op te halen, bij te werken en te beheren. Populaire DBMS die in data science worden gebruikt:
Resources om te beginnen
Topbanen in data science
Data science is een breed veld met veel gespecialiseerde rollen, elk met eigen verantwoordelijkheden, skillvereisten en salarisverwachtingen. Dit zijn enkele van de meest gevraagde functietitels binnen data science:
Data-analist
Data-analisten spelen een cruciale rol bij het interpreteren van de data van een organisatie. Ze beheersen wiskundige en statistische analyses en kunnen complexe datasets omzetten in concrete inzichten die zakelijke beslissingen sturen. Met datavisualisatietools communiceren ze hun bevindingen effectief naar zowel technische als niet-technische stakeholders.
Data-analisten duiken in data en leveren rapporten en visualisaties die verborgen inzichten onthullen. Hoewel ze niet per se geavanceerde algoritmen ontwikkelen, gebruiken ze een reeks tools om data te duiden. Hun taken omvatten vaak ook SQL-queries, datacleaning en datamanagement. Lees meer over hoe je data-analist wordt in een apart artikel.
Belangrijke skills:
Essentiële tools:
Data scientist
Data scientists duiken in de data van een organisatie om betekenisvolle inzichten te vinden en te communiceren. Ze hebben een diep begrip van machinelearning-workflows en hoe ze die toepassen op realistische businesscases. Data scientists werken vooral met code, voeren grondige analyses uit en gebruiken vaak bigdatatools.
Data scientists zijn te vergelijken met detectives in de dataruimte. Ze sporen rijke databronnen op en interpreteren die, beheren grote datasets en identificeren trends door datapunten te combineren. Met analytische, statistische en programmeervaardigheden verzamelen, analyseren en interpreteren ze omvangrijke datasets. Deze inzichten sturen de ontwikkeling van datagedreven oplossingen voor complexe bedrijfsproblemen, vaak via het bouwen van machinelearning-algoritmen om nieuwe inzichten te genereren, processen te automatiseren of klanten meer waarde te bieden.
We hebben een volledige gids over hoe je data scientist wordt, met de belangrijkste stappen om te beginnen.
Belangrijke skills:
Essentiële tools:
Data-engineer
Data-engineers zijn de architecten van de datawereld. Ze ontwerpen, bouwen en beheren datainfrastructuur, zodat data scientists efficiënt kunnen analyseren. Data-engineers focussen op dataverzameling, -opslag en -verwerking en zetten datapijplijnen op die het analysetraject stroomlijnen.
Data-engineers houden zich vaak bezig met algoritmen voor informatie-extractie en bouwen databasesystemen. Ze zorgen voor optimale prestaties door data-architectuur, databases en verwerkende systemen te beheren. Deze rol vereist een brede kennis van programmeertalen en ervaring met relationele en niet-relationele databases. Lees meer over data-engineer worden in een apart artikel.
Belangrijke skills:
Tools:
Machine learning engineer
Machine learning engineers zijn de architecten van de AI-wereld. Ze ontwerpen en implementeren ML-systemen die organisatiedata gebruiken om voorspellingen te doen. Ze pakken ook uitdagingen aan zoals churnvoorspelling en klantwaarde-inschatting en zetten modellen in voor gebruik binnen de organisatie. ML-engineers werken vooral met code-gebaseerde tools.
Bekijk onze volledige gids over hoe je machine learning engineer wordt in een apart artikel.
Belangrijke skills:
Tools:
AI-onderzoeker
AI-onderzoekers richten zich op het verder ontwikkelen van kunstmatige intelligentie door algoritmen en modellen te creëren en te verbeteren. Ze pakken complexe uitdagingen aan, zoals computers leren taal te begrijpen, beelden te herkennen of van ervaring te leren. Hun werk slaat vaak een brug tussen academisch onderzoek en praktische toepassingen en drijft innovaties in AI.
Zo kunnen ze slimmere chatbots ontwikkelen, systemen voor zelfrijdende auto's verbeteren of AI-modellen ontwerpen voor de gezondheidszorg. Deze rol vereist zowel technische expertise als creatief probleemoplossen.
Belangrijke skills:
Essentiële tools:
AI-onderzoekers spelen een sleutelrol in het vormgeven van de toekomst van AI. Ze creëren technologieën die slimmere toepassingen aandrijven, automatisering versterken en echte problemen oplossen.
Rol
Verantwoordelijkheden
Belangrijke skills
Essentiële tools
Data-analist
Inzichten uit data halen en rapporteren voor zakelijke probleemoplossing
SQL, Python of R
SQL, Python of R, datavisualisatietools (bijv. Tableau, Power BI), statistische software (bijv. SPSS, SAS), spreadsheettools
Data scientist
Betekenisvolle inzichten ontdekken, datagedreven oplossingen ontwikkelen met machine learning, bevindingen communiceren
Python, R, SQL, ML- en AI-concepten, statistische analyse, datavisualisatie, communicatie- en presentatieskills
Pandas, NumPy, Scikit-learn, Matplotlib, Tableau, Airflow, Spark, Git, Bash
Data-engineer
Datainfrastructuur ontwerpen, bouwen en beheren; datapijplijnen opzetten; optimale prestaties waarborgen
SQL, Python, Java, databaseontwerp, bigdatatechnologieën, datamodellering, probleemoplossen, communicatieve vaardigheden
SQL, Python, Java, Hadoop, Spark, ETL-tools, NoSQL-databases
Machine learning engineer
ML-systemen ontwerpen en inzetten, complexe problemen oplossen met ML, samenwerken met teams
Python, Java, Scala, ML-frameworks, datastructuren, software-architectuur, wiskunde, teamwork, probleemoplossende vaardigheden
Scikit-learn, TensorFlow, Pandas, NumPy, cloudplatforms (bijv. AWS, Google Cloud Platform), versiebeheersystemen (bijv. Git)
AI-onderzoeker
Geavanceerde AI-modellen ontwikkelen, algoritmen verbeteren en complexe problemen oplossen zoals NLP of computer vision
Machine learning, neurale netwerken, natural language processing, computer vision, Python, TensorFlow, PyTorch, wiskundige skills
TensorFlow, PyTorch, Jupyter Notebooks, cloudplatforms (bijv. AWS, Google Cloud), GPU's voor high-performance computing
Hoe begin je met data science
Data science is interdisciplinair, en om te starten heb je een mix nodig van vaardigheden uit wiskunde, statistiek, informatica en domeinkennis. Dit zou een mogelijk stappenplan kunnen zijn om je reis in data science te beginnen.