Fondamenti di dati in Python
AdvancedSkill Level
28 ore
La data science è stata definita il "lavoro più sexy del XXI secolo", e non è solo un'esagerazione. Il Bureau of Labor Statistics degli Stati Uniti prevede che il numero di ruoli per data scientist crescerà del 36% tra il 2023 e il 2033, una chiara testimonianza della crescente importanza di questo campo.
Ma cos'è esattamente la data science e perché è così importante? Questo articolo ti guiderà nel mondo della data science: dal ciclo di vita della data science, alle sue applicazioni nei diversi settori, alle competenze necessarie per entrare nel campo, e altro ancora. Offriremo uno sguardo approfondito sul perché e sul come la data science sia salita alla ribalta come una delle industrie più dinamiche di oggi.
La data science è un campo interdisciplinare che utilizza metodi scientifici, processi, algoritmi e sistemi per estrarre conoscenza e insight da dati strutturati e non strutturati. In parole più semplici, la data science riguarda l'ottenimento, l'elaborazione e l'analisi dei dati per ricavare insight con molteplici finalità.
Il ciclo di vita della data science fa riferimento alle varie fasi che un progetto di data science in genere attraversa, dalla concezione iniziale e raccolta dei dati fino alla comunicazione dei risultati e degli insight.
Sebbene ogni progetto di data science sia unico—a seconda del problema, del settore in cui viene applicato e dei dati coinvolti—la maggior parte segue un ciclo di vita simile.
Questo ciclo fornisce un approccio strutturato per gestire dati complessi, trarre conclusioni accurate e prendere decisioni basate sui dati.
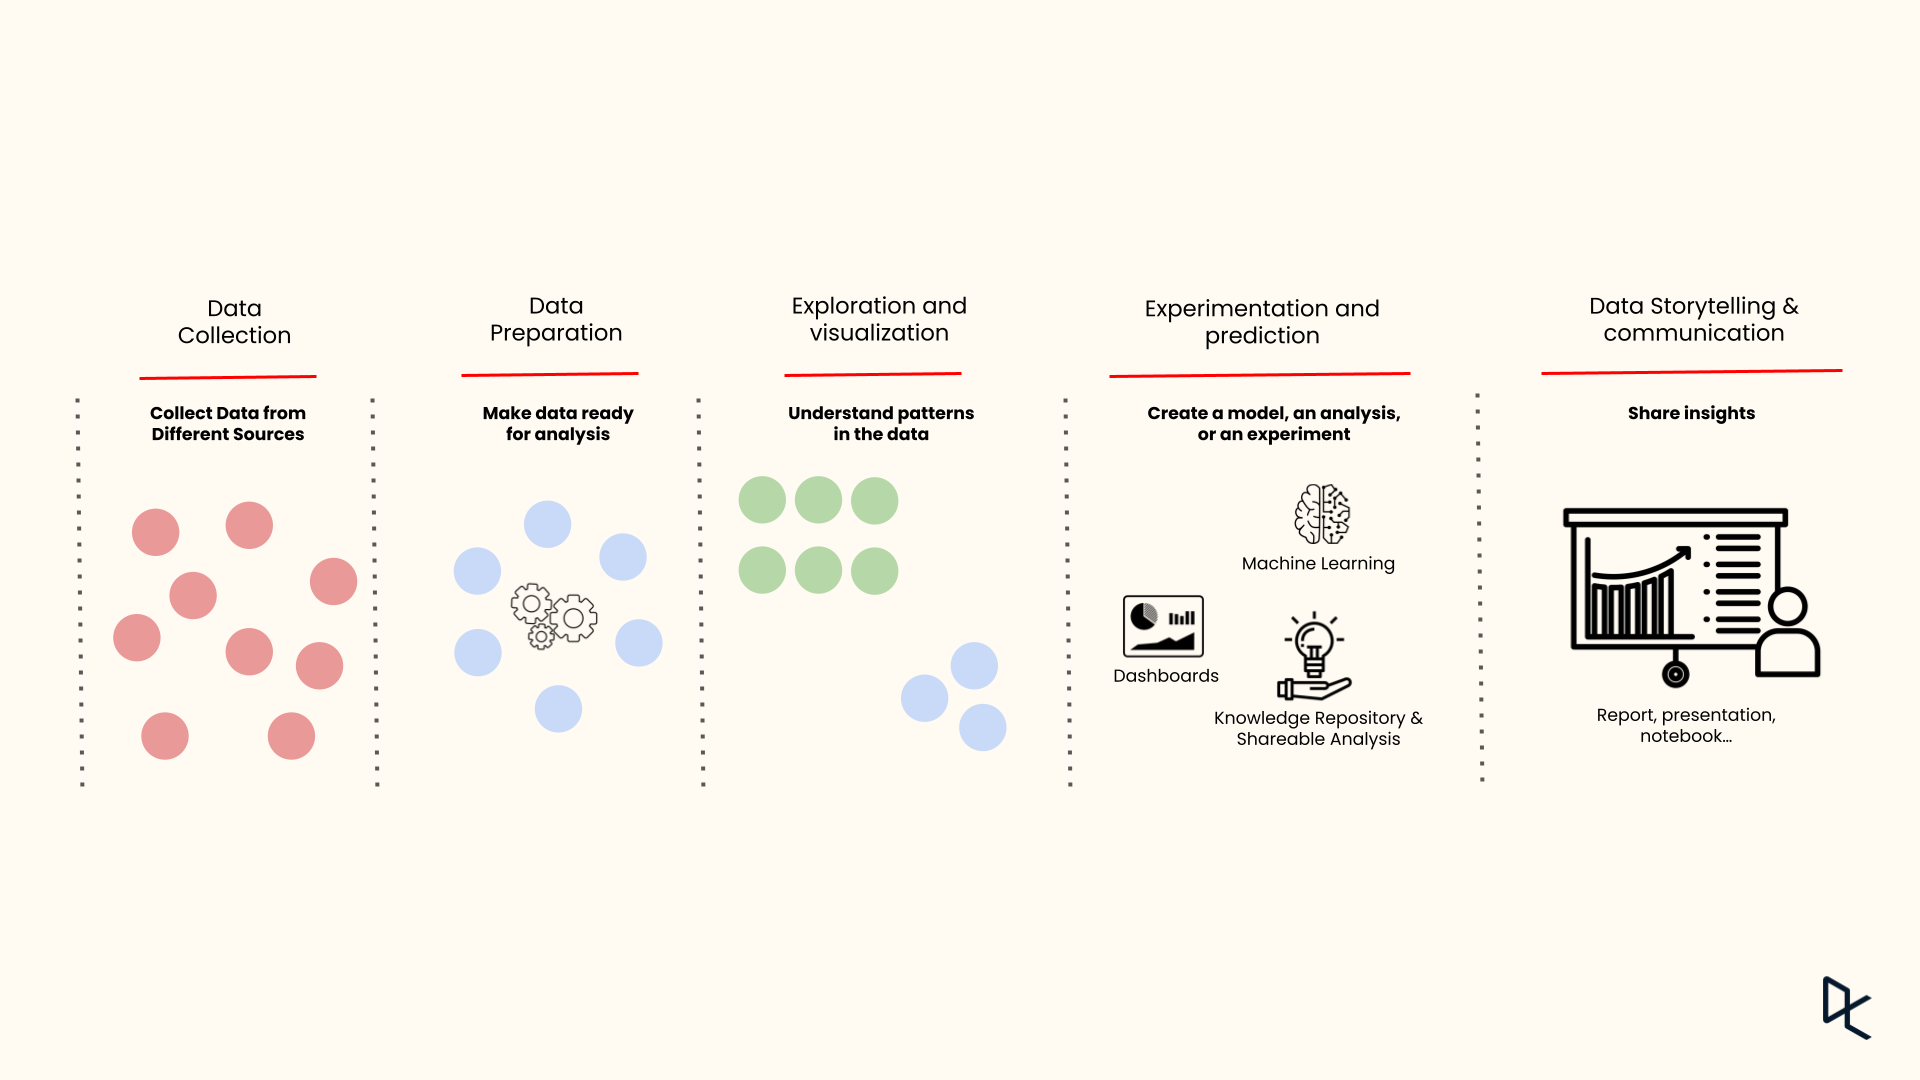
Il ciclo di vita della data science
Ecco le cinque fasi principali che strutturano il ciclo di vita della data science:
Questa fase iniziale prevede la raccolta di dati da varie fonti, come database, file Excel, file di testo, API, web scraping o persino flussi di dati in tempo reale. Il tipo e il volume dei dati raccolti dipendono in larga misura dal problema che stai affrontando.
Una volta raccolti, questi dati vengono archiviati in un formato appropriato, pronto per ulteriori elaborazioni. Archiviare i dati in modo sicuro ed efficiente è importante per consentire un rapido recupero ed elaborazione.
Spesso considerata la fase più dispendiosa in termini di tempo, la preparazione dei dati comporta la pulizia e la trasformazione dei dati grezzi in un formato adatto all'analisi. Questa fase include la gestione dei dati mancanti o incoerenti, la rimozione dei duplicati, la normalizzazione e le conversioni di tipo. L'obiettivo è creare un dataset pulito e di alta qualità che possa fornire risultati analitici accurati e affidabili.
In questa fase, i data scientist esplorano i dati preparati per comprenderne pattern, caratteristiche e potenziali anomalie. Tecniche come l'analisi statistica e la visualizzazione dei dati riassumono le caratteristiche principali dei dati, spesso con metodi visivi.
Gli strumenti di visualizzazione, come grafici e diagrammi, rendono i dati più comprensibili, consentendo alle parti interessate di cogliere meglio trend e pattern.
In questa fase i data scientist utilizzano algoritmi di machine learning e modelli statistici per identificare pattern, fare previsioni o scoprire insight. L'obiettivo è ricavare dai dati qualcosa di significativo che sia in linea con gli obiettivi del progetto, che si tratti di prevedere risultati futuri, classificare i dati o scoprire pattern nascosti.
La fase finale consiste nell'interpretare e comunicare i risultati derivati dall'analisi dei dati. Non basta avere degli insight; devi saperli comunicare in modo efficace, utilizzando un linguaggio chiaro e conciso e visualizzazioni coinvolgenti. L'obiettivo è trasmettere questi risultati a stakeholder non tecnici in modo da influenzare le decisioni o guidare iniziative strategiche.
Comprendere e implementare questo ciclo consente un approccio più sistematico e di successo ai progetti di data science. Passiamo ora ad approfondire perché la data science è così importante.
La data science è emersa come un campo rivoluzionario, cruciale per generare insight dai dati e trasformare le aziende. Non è un'esagerazione dire che la data science è la spina dorsale delle industrie moderne. Ma perché ha acquisito così tanta importanza?
La data science viene utilizzata per una vasta gamma di applicazioni, dal prevedere il comportamento dei clienti all'ottimizzare i processi aziendali. La portata della data science è ampia e comprende vari tipi di analytics.
L'aumento della sofisticazione dall'analisi descrittiva a quella diagnostica, predittiva e prescrittiva può fornire alle aziende insight preziosi per guidare decisioni e pianificazione strategica. Puoi leggere di più sui quattro tipi di analytics in un articolo a parte.
La data science può apportare valore a qualsiasi azienda che utilizzi i propri dati. Dalla statistica alle previsioni, pratiche efficaci basate sui dati possono mettere un'azienda sulla corsia preferenziale verso il successo. Ecco alcuni modi in cui viene utilizzata la data science:
La data science può migliorare in modo significativo le operazioni di un'azienda in vari reparti, dalla logistica e supply chain alle risorse umane e oltre. Può aiutare nell'allocazione delle risorse, nella valutazione delle performance e nell'automazione dei processi. Per esempio, un'azienda logistica può usare la data science per ottimizzare i percorsi, ridurre i tempi di consegna, risparmiare sui costi del carburante e migliorare la soddisfazione dei clienti.
La data science può far emergere pattern e insight nascosti che potrebbero non essere evidenti a prima vista. Questi insight possono fornire alle aziende un vantaggio competitivo e aiutarle a comprendere meglio il proprio business. Ad esempio, un'azienda può utilizzare i dati dei clienti per identificare trend e preferenze, consentendole di adattare di conseguenza prodotti o servizi.
Le aziende possono usare la data science per innovare e creare nuovi prodotti o servizi basati sulle esigenze e preferenze dei clienti. Consente inoltre di prevedere i trend di mercato e restare un passo avanti rispetto alla concorrenza. Per esempio, i servizi di streaming come Netflix usano la data science per comprendere le preferenze degli utenti e creare raccomandazioni personalizzate, migliorando l'esperienza d'uso.
Le implicazioni della data science si estendono a tutti i settori, cambiando radicalmente il modo in cui le organizzazioni operano e prendono decisioni. Sebbene ogni settore possa trarre vantaggio dall'implementazione della data science, è particolarmente influente nei settori ricchi di dati.
Approfondiamo come la data science stia rivoluzionando questi settori chiave:
Il settore finanziario è stato rapido a sfruttare la potenza della data science. Dal rilevamento delle frodi e il trading algoritmico alla gestione dei portafogli e alla valutazione del rischio, la data science ha reso più efficienti e precise operazioni finanziarie complesse. Ad esempio, le società di carte di credito utilizzano tecniche di data science per rilevare e prevenire transazioni fraudolente, risparmiando miliardi di dollari ogni anno.
Scopri di più sui fondamenti di finanza in Python e su come prendere decisioni finanziarie data-driven con il nostro skill track.
La sanità è un altro settore in cui la data science ha un impatto profondo. Le applicazioni spaziano dalla previsione delle epidemie e il miglioramento della qualità dell'assistenza al potenziamento della gestione ospedaliera e alla scoperta di farmaci. I modelli predittivi aiutano i medici a diagnosticare precocemente le malattie, e i piani di trattamento possono essere personalizzati in base alle esigenze specifiche del paziente, portando a esiti migliori.
Puoi scoprire di più su come la data science sta trasformando la sanità in un episodio del podcast DataFramed.
Il marketing è un ambito che è stato profondamente trasformato dall'avvento della data science. Le applicazioni in questo settore sono varie, dal segmentare i clienti e fare pubblicità mirata al forecast delle vendite e all'analisi del sentiment. La data science consente ai marketer di comprendere il comportamento dei consumatori con un livello di dettaglio senza precedenti, permettendo di creare campagne più efficaci. L'analisi predittiva può anche aiutare le aziende a identificare potenziali trend di mercato, dando loro un vantaggio competitivo. Gli algoritmi di personalizzazione possono adattare le raccomandazioni di prodotto al singolo cliente, aumentando così vendite e soddisfazione.
Abbiamo un post dedicato su cinque modi per usare la data science nel marketing, che esplora alcuni dei metodi utilizzati nel settore. Puoi anche approfondire nel nostro skill track Marketing Analytics with Python.
Le aziende tecnologiche sono forse le principali beneficiarie della data science. Dall'alimentare i motori di raccomandazione al migliorare il riconoscimento di immagini e voce, la data science trova applicazione in aree diverse. Le piattaforme di ride-hailing, ad esempio, si affidano alla data science per collegare i driver ai passeggeri e ottimizzare l'offerta di driver a seconda dell'orario della giornata.
Sebbene la data science si sovrapponga a molti campi che lavorano anch'essi con i dati, combina principi, strumenti e tecniche specifici progettati per estrarre pattern significativi dai dati.
Distinguere tra data science e questi campi correlati può offrire una migliore comprensione del panorama e aiutare a definire il giusto percorso di carriera. Facciamo chiarezza su queste differenze.
Data science e data analytics svolgono entrambi ruoli cruciali nell'estrarre valore dai dati, ma si concentrano su aspetti diversi. La data science è un campo ombrello che utilizza metodi, tra cui machine learning e analisi predittiva, per ricavare insight dai dati. Al contrario, la data analytics si concentra sull'elaborazione e l'esecuzione di analisi statistiche su dataset esistenti per rispondere a domande specifiche.
Sebbene anche la business analytics tratti l'analisi dei dati, è più incentrata sullo sfruttare i dati per decisioni strategiche di business. In genere è meno tecnica e più orientata al business rispetto alla data science. La data science, pur potendo informare le strategie aziendali, spesso approfondisce maggiormente gli aspetti tecnici, come la programmazione e il machine learning.
Il data engineering si concentra sulla costruzione e manutenzione dell'infrastruttura per la raccolta, l'archiviazione e l'elaborazione dei dati, garantendo che i dati siano puliti e accessibili. La data science, invece, analizza questi dati utilizzando modelli statistici e di machine learning per estrarre insight preziosi che influenzano le decisioni aziendali. In sostanza, i data engineer creano le "strade" dei dati, mentre i data scientist ci "guidano" sopra per ricavare insight significativi. Entrambi i ruoli sono vitali in un'organizzazione data-driven.
Il machine learning è un sottoinsieme della data science, focalizzato sulla creazione e implementazione di algoritmi che consentono alle macchine di apprendere dai dati e prendere decisioni. La data science, però, è più ampia e incorpora molte tecniche, incluso il machine learning, per estrarre informazioni significative dai dati.
La statistica, disciplina matematica che si occupa di raccolta, analisi, interpretazione e organizzazione dei dati, è un componente chiave della data science. Tuttavia, la data science integra la statistica con altri metodi per estrarre insight dai dati, rendendola un campo più multidisciplinare.
|
Settore |
Focus |
Enfasi tecnica |
|
Data Science |
Generare valore con i dati attraverso i 4 livelli di analytics |
Programmazione, ML, Statistica |
|
Data Analytics |
Eseguire analisi statistiche su dataset esistenti |
Analisi statistica |
|
Business Analytics |
Sfruttare i dati per decisioni strategiche di business |
Strategie di business, analisi dei dati |
|
Data Engineering |
Costruire e mantenere l'infrastruttura dati |
Raccolta, archiviazione, elaborazione dei dati |
|
Machine Learning |
Creare e implementare algoritmi di apprendimento automatico |
Sviluppo di algoritmi, implementazione di modelli |
|
Statistica |
Raccolta, analisi, interpretazione e organizzazione dei dati |
Analisi statistica, principi matematici |
Comprese queste distinzioni, possiamo ora approfondire i concetti chiave che ogni data scientist deve padroneggiare.
Un data scientist di successo non ha bisogno solo di competenze tecniche, ma anche della comprensione dei concetti di base che costituiscono le fondamenta del campo. Ecco alcuni concetti chiave da comprendere:
Sono le fondamenta della data science. La statistica viene utilizzata per ricavare insight significativi dai dati, mentre la probabilità ci permette di fare previsioni su eventi futuri basandoci sui dati disponibili. Comprendere distribuzioni, test statistici e teorie della probabilità è essenziale per qualsiasi data scientist.
La programmazione è lo strumento che consente ai data scientist di lavorare con i dati. Linguaggi come Python e R sono particolarmente popolari grazie alla loro facilità d'uso e alle potenti librerie per la gestione dei dati. La familiarità con questi linguaggi permette a un data scientist di pulire, elaborare e analizzare i dati in modo efficace.
La visualizzazione dei dati è l'arte di rappresentare dati complessi in un formato visivo e facilmente comprensibile. Aiuta a comunicare i risultati e rende più semplice comprendere dataset complessi. Strumenti come Tableau, Matplotlib e Seaborn sono comunemente utilizzati in questo ambito.
Il machine learning, un sottoinsieme dell'intelligenza artificiale, consiste nell'addestrare un modello sui dati per fare previsioni o prendere decisioni senza essere esplicitamente programmato. È al cuore di molte applicazioni moderne di data science, dai sistemi di raccomandazione all'analisi predittiva.
Il data engineering si occupa della progettazione e costruzione di sistemi per la raccolta, l'archiviazione e l'elaborazione dei dati. Rappresenta la base su cui si costruiscono analisi dei dati e modelli di machine learning.
I data scientist hanno bisogno di un set di strumenti per svolgere efficacemente i propri compiti. Questi strumenti vanno dai linguaggi di programmazione al software per la visualizzazione dei dati. Ecco alcuni strumenti essenziali per la data science.
Nel mondo della data science, i linguaggi di programmazione sono gli strumenti del mestiere. Forniscono un framework per istruire un computer a eseguire compiti specifici, come la manipolazione dei dati, l'analisi statistica e il machine learning. Ecco alcuni linguaggi chiave che ogni data scientist dovrebbe considerare di padroneggiare:
Gli strumenti di Business Intelligence (BI) sono applicazioni software utilizzate per analizzare i dati grezzi di un'organizzazione. Aiutano nella visualizzazione, nel reporting e nella condivisione degli insight, consentendo alle aziende di prendere decisioni basate sui dati. Ecco alcuni strumenti BI essenziali per la data science:
Le librerie di machine learning sono raccolte di codice pre-scritto che i data scientist possono utilizzare per risparmiare tempo. Forniscono algoritmi e routine di apprendimento preconfezionati integrabili nei programmi. Ecco alcune librerie chiave che semplificano i compiti di machine learning:
I Database Management Systems (DBMS) sono applicazioni software che interagiscono con l'utente, altre applicazioni e il database per acquisire e analizzare i dati. Un DBMS consente un modo sistematico per creare, recuperare, aggiornare e gestire i dati. Ecco alcuni DBMS popolari usati nella data science:
La data science è un campo vasto con molti ruoli specializzati, ciascuno con responsabilità, requisiti di competenze e aspettative salariali propri. Ecco alcuni dei titoli di lavoro più richiesti nell'ambito della data science:
I data analyst svolgono un ruolo cruciale nell'interpretare i dati di un'organizzazione. Possiedono competenze in analisi matematica e statistica, che consentono loro di trasformare dataset complessi in insight azionabili che guidano le decisioni di business. Utilizzando strumenti di visualizzazione dei dati, comunicano efficacemente i risultati sia a stakeholder tecnici che non tecnici.
I data analyst approfondiscono i dati, fornendo report e visualizzazioni per rivelare insight nascosti. Pur non essendo necessariamente coinvolti nello sviluppo di algoritmi avanzati, utilizzano una serie di strumenti per dare senso ai dati. Le loro responsabilità possono includere anche query SQL, pulizia e gestione dei dati. Maggiori dettagli su come diventare data analyst in un articolo dedicato.
Competenze chiave:
Strumenti essenziali:
I data scientist approfondiscono i dati di un'organizzazione per estrarre e comunicare insight significativi. Hanno una profonda comprensione dei workflow di machine learning e di come applicarli ad applicazioni di business reali. Lavorano prevalentemente con strumenti basati sul codice, conducendo analisi approfondite e interagendo spesso con strumenti di big data.
I data scientist sono simili a detective nel mondo dei dati. Sono responsabili di scoprire e interpretare ricche fonti di dati, gestire grandi dataset e identificare trend unendo punti dati. Sfruttando competenze analitiche, statistiche e di programmazione, raccolgono, analizzano e interpretano ampi dataset. Questi insight alimentano lo sviluppo di soluzioni data-driven a problemi di business complessi, spesso includendo la creazione di algoritmi di machine learning per generare nuovi insight, automatizzare processi o offrire maggiore valore ai clienti.
Abbiamo una guida completa su come diventare data scientist, che illustra alcuni dei passaggi chiave per iniziare in questo ruolo.
Competenze chiave:
Strumenti essenziali:
I data engineer sono gli architetti del mondo della data science. Progettano, costruiscono e gestiscono l'infrastruttura dati, consentendo ai data scientist di analizzare i dati in modo efficiente. Si concentrano su raccolta, archiviazione ed elaborazione dei dati, creando pipeline che semplificano il processo analitico.
I data engineer spesso si occupano della progettazione di algoritmi per l'estrazione di informazioni e creano sistemi di database. Garantiscono prestazioni ottimali gestendo architettura dei dati, database e sistemi di elaborazione. Questo ruolo richiede una comprensione approfondita dei linguaggi di programmazione ed esperienza con database relazionali e non relazionali. Maggiori informazioni su diventare data engineer in un post dedicato.
Competenze chiave:
Strumenti:
I machine learning engineer sono gli architetti del mondo dell'AI. Progettano e implementano sistemi di machine learning che sfruttano i dati aziendali per fare previsioni. Le loro responsabilità includono anche affrontare sfide come la previsione del churn dei clienti e la stima del valore del ciclo di vita, e distribuire modelli per l'uso all'interno dell'organizzazione. Lavorano principalmente con strumenti basati sul codice.
Dai un'occhiata alla nostra guida completa su come diventare machine learning engineer in un articolo dedicato.
Competenze chiave:
Strumenti:
Gli AI Research Scientist si concentrano sull'avanzamento dell'intelligenza artificiale creando e migliorando algoritmi e modelli. Affrontano sfide complesse come insegnare ai computer a comprendere il linguaggio, riconoscere immagini o apprendere dall'esperienza. Il loro lavoro spesso fa da ponte tra ricerca accademica e applicazioni pratiche, guidando le innovazioni nell'AI.
Per esempio, possono sviluppare chatbot più intelligenti, migliorare i sistemi di guida autonoma o progettare modelli di AI per la sanità. Questo ruolo richiede sia competenze tecniche sia creatività nel problem solving.
Competenze chiave:
Strumenti essenziali:
Gli AI Research Scientist giocano un ruolo chiave nel plasmare il futuro dell'AI, creando tecnologie che alimentano applicazioni più intelligenti, migliorano l'automazione e risolvono problemi reali.
|
Ruolo |
Responsabilità |
Competenze chiave |
Strumenti essenziali |
|
Data Analyst |
Estrarre e riportare insight dai dati per la risoluzione di problemi di business |
SQL, Python o R |
SQL, Python o R, strumenti di visualizzazione dei dati (es. Tableau, PowerBI), software statistici (es. SPSS, SAS), fogli di calcolo |
|
Data Scientist |
Scoprire insight significativi, sviluppare soluzioni data-driven usando il machine learning, comunicare i risultati |
Python, R, SQL, concetti di Machine Learning e AI, analisi statistica, visualizzazione dei dati, abilità di comunicazione e presentazione |
Pandas, NumPy, Scikit-learn, Matplotlib, Tableau, Airflow, Spark, Git, Bash |
|
Data Engineer |
Progettare, costruire e gestire l'infrastruttura dati, creare pipeline, garantire prestazioni ottimali |
SQL, Python, Java, progettazione di database, tecnologie big data, data modeling, problem solving, capacità di comunicazione |
SQL, Python, Java, Hadoop, Spark, strumenti ETL, database NoSQL |
|
Machine Learning Engineer |
Progettare e distribuire sistemi di machine learning, risolvere problemi complessi con l'ML, collaborare con i team |
Python, Java, Scala, framework di machine learning, strutture dati, architettura software, matematica, teamwork, problem solving |
Scikit-learn, TensorFlow, Pandas, NumPy, piattaforme cloud (es. AWS, Google Cloud Platform), sistemi di controllo versione (es. Git) |
|
AI Research Scientist |
Sviluppare modelli avanzati di AI, migliorare algoritmi e risolvere problemi complessi come NLP o computer vision |
Machine learning, reti neurali, elaborazione del linguaggio naturale, computer vision, Python, TensorFlow, PyTorch, competenze matematiche |
TensorFlow, PyTorch, Jupyter Notebooks, piattaforme cloud (es. AWS, Google Cloud), GPU per calcolo ad alte prestazioni |
La data science è un campo interdisciplinare e, per iniziare, dovrai acquisire un mix di competenze in matematica, statistica, informatica e conoscenza del dominio. Vediamo una possibile roadmap per dare il via al tuo percorso nella data science.
La data science è un campo affascinante; è dove la curiosità incontra la tecnologia. Il primo passo può sembrare intimidatorio, ma ricorda: non si tratta di conoscere tutti gli algoritmi, bensì di fare le domande giuste e imparare a decifrare insight significativi dai dati. Buttati, inizia a esplorare e il resto verrà da sé.
Richie Cotton, Data Evangelist at DataCamp
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min