

AWS Aurora instellen
Het instellen van AWS Aurora omvat het aanmaken van een databasecluster, het configureren van beveiligingsinstellingen en het zorgen voor de juiste netwerktoegang. Laten we dat in deze sectie doen!
> Als je nieuw bent bij AWS, overweeg dan om eerst de basis te herhalen met de Introductie tot AWS-cursus voordat je in Aurora duikt.
Een Aurora-databasecluster maken
Het opzetten van een Aurora-databasecluster vereist een paar belangrijke stappen, waaronder het kiezen van de juiste database-engine, het configureren van beveiligingsinstellingen en het definiëren van instance-specificaties.
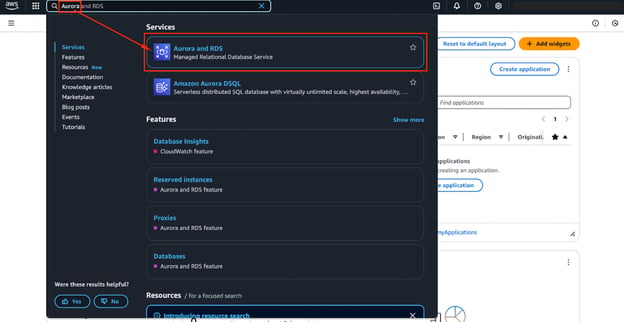
- Log om te beginnen in op de AWS Management Console en ga naar het RDS-dashboard (Relational Database Service).
- Je kunt dit doen door te zoeken naar "Aurora" in het zoekpaneel van de AWS Management Console—zoals te zien is in de onderstaande afbeelding.
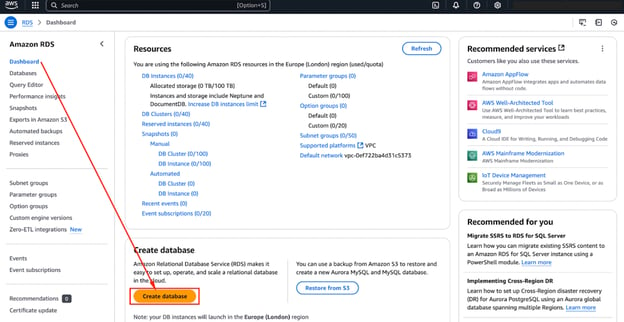
- Klik daar op “Create Database”—zoals te zien is in de onderstaande afbeelding.
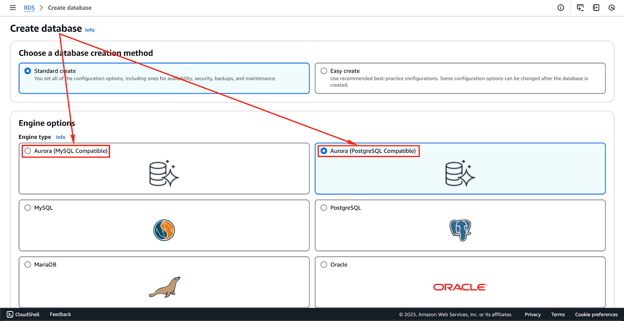
- Vervolgens kun je "Amazon Aurora" kiezen als database-engine.
- Onthoud dat Aurora zowel MySQL als PostgreSQL ondersteunt, dus het is belangrijk de versie te kiezen die het beste past bij de vereisten van je applicatie.
De onderstaande afbeelding toont de engine-opties die momenteel beschikbaar zijn. Deze kunnen in de toekomst veranderen, maar de eerste twee opties—Aurora (MySQL Compatible) en Aurora (PostgreSQL Compatible)—zijn de Aurora-engines.
- Na het selecteren van de engine moet je het instance-type en de opslagconfiguraties opgeven.
- Aurora biedt de flexibiliteit om opslag automatisch op te schalen tot 128 TB, zodat groeiende workloads efficiënt worden verwerkt zonder handmatige tussenkomst.
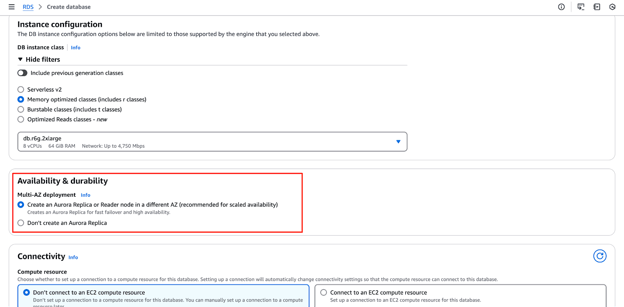
- De volgende stap is het definiëren van replicatie-instellingen. Je kunt kiezen voor een deployment met één instance of read replicas inschakelen om databasetraffic effectiever te verdelen.
- Het gebruik van read replicas verhoogt ook de beschikbaarheid en fouttolerantie, wat zorgt voor meer duurzaamheid bij storingen.
De onderstaande afbeelding markeert de sectie "Availability & durability", waar je deze instellingen kunt configureren.
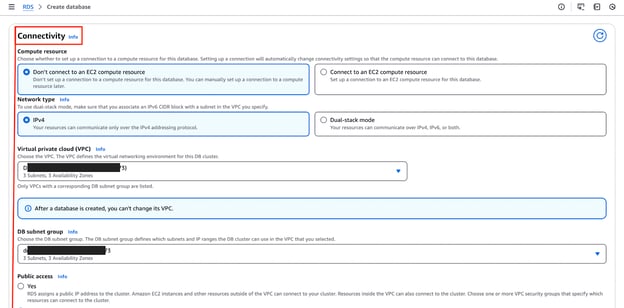
- De netwerkconfiguratie is cruciaal, omdat je hierbij de Virtual Private Cloud (VPC) instelt, een security group selecteert en toegangscontroles definieert.
- Een security group fungeert als firewall die inkomend en uitgaand databasaverkeer reguleert. Voor extra security is het aan te raden alleen toegang toe te staan vanaf vertrouwde IP-adressen en applicaties.
De onderstaande afbeelding markeert de sectie "Connectivity", waar je deze configuraties kunt instellen en aanpassen.
- Database-credentials moeten ook tijdens de setup worden geconfigureerd—waarbij je een mastergebruikersnaam en wachtwoord toewijst die worden gebruikt om verbindingen te verifiëren.
- Aurora maakt het mogelijk om geautomatiseerde back-ups en point-in-time recovery-opties in te schakelen. Dit zorgt ervoor dat databasesnapshots consistent worden gemaakt om dataverlies te voorkomen.
Na het controleren van alle configuraties kun je doorgaan met het aanmaken van het Aurora-cluster. De onderstaande afbeelding toont de knop "Create Database" waarop je kunt klikken om het aanmaakproces te starten.
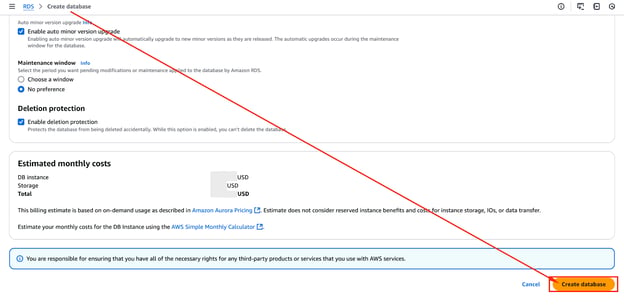
Het inrichten kan enkele minuten duren, afhankelijk van de gekozen instancegrootte en netwerkinstellingen.
> Als je nieuw bent met AWS-services, kan het herbekijken van de AWS Cloud Technology and Services-cursus helpen om belangrijke AWS-concepten te begrijpen die relevant zijn voor de Aurora-setup.
Netwerk en security configureren
Security is cruciaal bij het beheren van een Aurora-database, en AWS biedt meerdere tools om sterke toegangscontrole af te dwingen.
- De eerste stap in het beveiligen van een Aurora-instance is het configureren van VPC-security groups. Deze security groups bepalen welke IP-adressen en services met de database mogen communiceren.
- Beperk toegang tot specifieke applicatieservers en beheerders om ongeautoriseerde verbindingen te voorkomen.
- AWS Identity and Access Management (IAM) kan ook worden gebruikt om fijnmazige permissies voor database-operaties te definiëren.
- Door IAM-rollen te integreren kun je database-toegang afstemmen op specifieke gebruikersrollen en verantwoordelijkheden.
- Zo kun je applicatieontwikkelaars bijvoorbeeld alleen leesrechten geven, terwijl beheerders volledige controle hebben over databasewijzigingen.
- Encryptie moet ook worden ingeschakeld om gevoelige data te beschermen. AWS Aurora ondersteunt versleuteling in rust en tijdens transport met AWS Key Management Service (KMS).
- Data-at-rest versleutelen zorgt ervoor dat zelfs als opslagmedia worden gecompromitteerd, de data ontoegankelijk blijft zonder de juiste decryptiesleutel.
- Evenzo voorkomt het inschakelen van Secure Sockets Layer (SSL)-versleuteling voor data in transit ongeautoriseerde onderschepping van databasecommunicatie.
> Voor een diepere duik in het beveiligen van AWS-omgevingen, bekijk de cursus AWS Security and Cost Management. Wil je meer leren over hoe IAM werkt en hoe je het effectief implementeert, bekijk dan deze gids over AWS Identity and Access Management (IAM).
Verbinding maken met AWS Aurora
Verbinding maken met AWS Aurora is essentieel om met de database te werken. Dat kan via clienttools of via applicaties. Laten we in deze sectie kijken hoe!
Verbinden met Aurora MySQL
Zodra de Aurora-database actief is, moet je een verbinding tot stand brengen om met de database te communiceren.
Voor Aurora MySQL kun je gangbare databaseclients zoals MySQL Workbench en HeidiSQL gebruiken. Alternatief kun je command-line interfaces gebruiken.
Voor de verbinding moet je de database-endpoint opgeven, die je kunt vinden in de AWS Management Console.
Met de MySQL-CLI kun je de verbinding tot stand brengen met het volgende commando:
mysql -h your-cluster-endpoint -u admin -pNa het invoeren van het masterwachtwoord kun je SQL-queries uitvoeren, tabellen maken en data beheren.
Verbinden met Aurora PostgreSQL
Voor Aurora PostgreSQL kun je verbinding maken met tools zoals pgAdmin of de PostgreSQL-commandline-interface (psql).
Het verbindingscommando in psql volgt dit formaat:
psql -h your-cluster-endpoint -U admin -d yourdatabasenameNet als bij MySQL moeten de juiste inloggegevens worden ingevoerd om toegang te krijgen tot de database.
Zodra je toegang hebt, kun je SQL-queries uitvoeren, tabellen maken en data beheren.
Applicatieconnectiviteit configureren
Applicaties die met Aurora moeten communiceren, moeten worden geconfigureerd met de juiste database-connection strings. Gewoonlijk bestaan deze connection strings uit de gebruikersnaam, het wachtwoord, het poortnummer en de endpoint.
Het is aan te raden connection pooling te gebruiken om performance te optimaliseren en de overhead van het opzetten van nieuwe verbindingen voor elk verzoek te verminderen.
Populaire libraries zoals SQLAlchemy voor Python of JDBC voor Java bieden efficiënte manieren om verbindingen in een applicatieomgeving te beheren.
AWS Aurora beheren
Effectief beheer van AWS Aurora omvat het waarborgen van databeveiliging, het monitoren van performance en het opschalen van resources wanneer nodig. In deze sectie bekijken we deze praktijken.
Back-ups en snapshots
AWS Aurora biedt geautomatiseerde back-ups die continu databasewijzigingen vastleggen en opslaan in Amazon S3. Deze back-ups worden bewaard op basis van door de gebruiker ingestelde retentie, zodat je kunt herstellen naar elk punt binnen de retentieperiode.
Naast geautomatiseerde back-ups kun je ook handmatige snapshots maken die buiten het retentievenster blijven bestaan. Handmatige snapshots zijn vooral handig voor langdurige archivering of vóór het uitvoeren van grote database-updates.
Toen ik aan een project met een kritieke applicatie werkte, planden we elke twee uur geautomatiseerde back-ups in. Maar vóórdat we wijzigingen of updates aan de applicatie doorvoerden, maakten we handmatig een back-up om zeker te zijn dat we konden terugdraaien indien nodig. Dit laat zien hoe geautomatiseerde en handmatige back-ups effectief samen kunnen worden gebruikt.
De onderstaande afbeelding laat zien hoe AWS Backup kan worden gebruikt voor disaster recovery met Amazon Aurora.
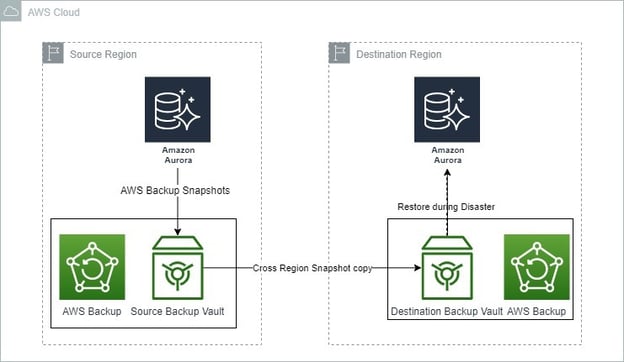
Back-up- en herstelopties voor Amazon Aurora. Bron: AWS Blogs
Aurora monitoren met CloudWatch
Performance-monitoring is essentieel voor het behouden van een gezonde database.
AWS CloudWatch biedt realtime-metrics die CPU-gebruik, geheugengebruik, disk I/O en netwerkverkeer bijhouden.
Het instellen van CloudWatch Alarms kan beheerders helpen meldingen te ontvangen wanneer prestatiedrempels worden overschreden, zodat proactief databasebeheer mogelijk is.
Daarnaast biedt AWS Performance Insights gedetailleerde queryanalyse om trage queries te identificeren en te optimaliseren.
De onderstaande afbeelding laat zien hoe AWS Performance Insights inzicht geeft in databaseperformance.
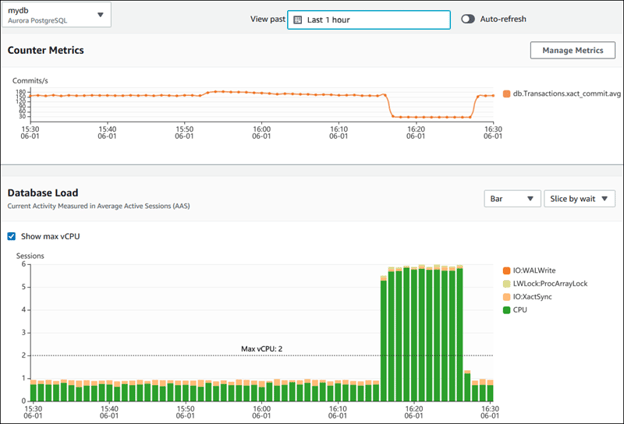
AWS Performance Insights-dashboard met databaseperformancemetrics. Bron: AWS Docs
Aurora schalen
Aurora is ontworpen om automatisch te schalen door de opslagcapaciteit naar behoefte aan te passen. Compute-resources zoals CPU’s en geheugen moeten echter mogelijk handmatig worden aangepast afhankelijk van de workload.
Aurora biedt opties om de read-capaciteit te schalen door read replicas toe te voegen, die read-traffic verdelen en de performance verbeteren.
Wanneer hoge beschikbaarheid cruciaal is, kan een Aurora-cluster worden geconfigureerd met meerdere replicas over verschillende Availability Zones om failoverredundantie te waarborgen.
Performance-optimalisatie in AWS Aurora
Het optimaliseren van performance in Amazon Aurora zorgt voor efficiënte query-uitvoering en schaalbaarheid. Laten we in deze sectie enkele best practices doornemen.
Indexeren en query-optimalisatie
Het optimaliseren van queryperformance in Amazon Aurora is cruciaal voor het onderhouden van een hoog presterende database.
- Indexeren is een van de meest effectieve manieren om de uitvoeringstijd van queries te verkorten en de efficiëntie van de database te verbeteren.
- Indexes aanmaken op vaak bevraagde kolommen helpt data snel te lokaliseren, waardoor volledige tablescans worden geminimaliseerd.
- Je moet primairy en secondary indexes strategisch inzetten zodat ze aansluiten bij querypatronen en workload-eisen.
- Daarnaast kun je samengestelde indexes gebruiken voor queries met meerdere kolommen om zoektijden verder te verbeteren.
- Ook query-optimalisatie speelt een belangrijke rol in databaseperformance. Efficiënte SQL-queries schrijven zorgt ervoor dat Aurora verzoeken sneller verwerkt met minimaal resourceverbruik.
- Het gebruik van
EXPLAIN of EXPLAIN ANALYZEin SQL-queries helpt knelpunten te identificeren en geeft inzicht in uitvoeringsplannen. - Technieken zoals het vermijden van
SELECT *(dat onnodige data ophaalt), het normaliseren van het databaseschema om redundantie te verminderen en het toepassen van partitioneringsstrategieën kunnen tot performancewinst leiden. - Aurora’s queryplan-optimizer verfijnt continu uitvoeringsplannen en past zich aan op basis van database-workloadpatronen, waardoor de algehele efficiëntie toeneemt.
Aurora-read replicas gebruiken
Om hoge traffic-loads aan te kunnen, ondersteunt Amazon Aurora read replicas die helpen read-intensieve queries over meerdere instances te verdelen.
Read replicas verlagen de belasting op de primaire database-instance door read-verzoeken apart te verwerken, wat de responsiviteit verbetert en de latency verlaagt.
Om een Aurora-read replica in te stellen, selecteer je een bestaand Aurora-cluster en schakel je replicatie in met minimale configuratie. Aurora synchroniseert data automatisch tussen de primaire instance en zijn replicas, waardoor dataconsistentie zonder handmatige tussenkomst wordt gegarandeerd.
Het replicatiemechanisme van Aurora is zeer efficiënt en maakt bijna realtime datasynchronisatie mogelijk met een replicatielag van minder dan een seconde.
Applicaties met frequente read-operaties, zoals rapportagedashboards of analytics-services, kunnen aanzienlijk profiteren van read replicas door read-zware queries naar deze instances te sturen.
Bij een storing van de primaire instance kan een read replica worden gepromoveerd tot nieuwe primaire instance met minimale downtime, wat hoge beschikbaarheid en bedrijfscontinuïteit garandeert.
De onderstaande afbeelding toont hoe cross-region Aurora-replicas kunnen helpen bij disaster recovery en hoge beschikbaarheid.
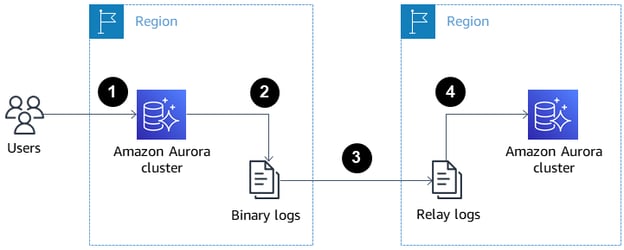
Cross-region Aurora-read replicas voor disaster recovery en hoge beschikbaarheid. Bron: AWS Docs
Cachingstrategieën voor Aurora
Caching is een krachtige techniek om databaseperformance te verbeteren door de directe querylast op Aurora te verminderen. Een cachinglaag kan het ophalen van data voor vaak geraadpleegde queries aanzienlijk versnellen.
Amazon ElastiCache, dat Redis en Memcached ondersteunt, wordt vaak naast Aurora gebruikt om queryresultaten op te slaan en dubbele databasequeries te voorkomen.
Door caching in een applicatiearchitectuur te integreren, kun je responstijden verbeteren en tegelijk compute-resources van de database ontzien.
Cachingstrategieën zoals write-through caching (waarbij data gelijktijdig naar de cache en Aurora wordt geschreven) en lazy loading (waarbij data pas wordt gecachet wanneer deze wordt opgevraagd) helpen de performance te optimaliseren op basis van gebruikspatronen.
Het configureren van een passende time-to-live (TTL) voor gecachete data zorgt ervoor dat de cache vers blijft en voorkomt dat verouderde data wordt opgehaald.
Security en compliance in AWS Aurora
Het beveiligen van je Aurora-database is cruciaal voor het beschermen van gevoelige data en het waarborgen van compliance. Laten we in deze sectie best practices doornemen.
Data-encryptie
Datasecurity is fundamenteel voor databasebeheer, en AWS Aurora biedt robuuste encryptiemechanismen om gevoelige data te beschermen.
- Aurora versleutelt data in rust met AWS Key Management Service (KMS), waardoor opgeslagen informatie veilig blijft, zelfs als de onderliggende opslag wordt gecompromitteerd.
- Encryptie inschakelen tijdens het aanmaken van de database zorgt ervoor dat alle geautomatiseerde back-ups, snapshots en replicas dezelfde encryptie-instellingen overnemen.
- Voor data tijdens transport ondersteunt Aurora SSL/TLS-versleuteling, die databaseverbindingen beveiligt en ongeautoriseerde toegang of onderschepping van datatransmissies voorkomt.
- Applicaties die verbinding maken met Aurora moeten worden geconfigureerd om SSL-certificaten te gebruiken om veilige communicatie te behouden.
Deze encryptiemaatregelen kunnen je helpen te voldoen aan securitybest practices en wettelijke vereisten.
De onderstaande afbeelding laat zien hoe AWS KMS integreert met Amazon Aurora om je database te versleutelen.
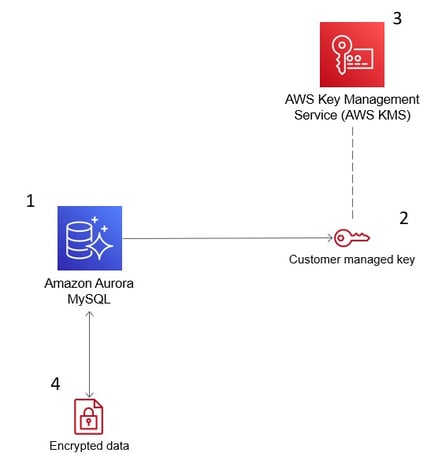
AWS Key Management Service (KMS) versleutelt data in Amazon Aurora voor security-compliance. Bron: AWS Blogs
IAM-integratie voor toegangscontrole
Toegangscontrole in Aurora wordt beheerd via AWS IAM, waarmee beheerders fijnmazige permissies kunnen definiëren op basis van gebruikersrollen.
- IAM-beleidsregels kunnen worden gebruikt om toegang tot database-instances te beperken, waardoor ongeautoriseerde gebruikers geen kritieke handelingen zoals datamodificaties of beheertaken kunnen uitvoeren.
- IAM-authenticatie biedt een veiliger alternatief voor traditionele wachtwoordauthenticatie. Hiermee kunnen applicaties verbinding maken met tijdelijke beveiligingscredentials. Dit elimineert de noodzaak om databasewachtwoorden op te slaan en te beheren, waardoor het risico op blootstelling van credentials wordt verkleind.
Je moet het least-privilege-principe afdwingen, wat beveiligingsrisico’s minimaliseert en strikte controle over database-toegang behoudt.
De onderstaande afbeelding laat zien hoe IAM-authenticatie kan worden geconfigureerd om de toegang tot Amazon Aurora PostgreSQL-databases te beveiligen.
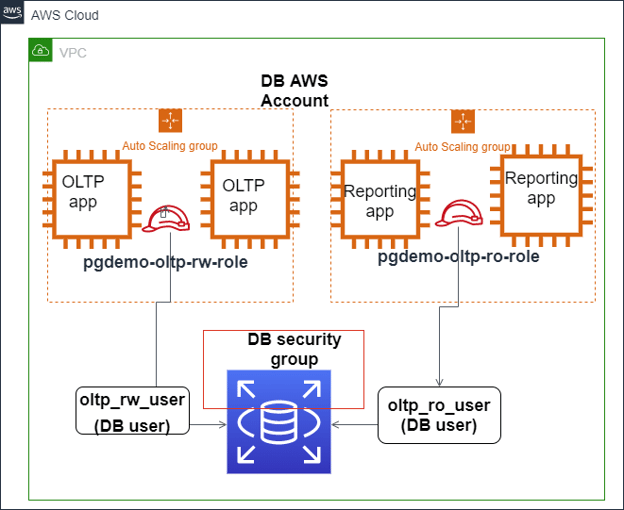
IAM-authenticatie integreert met Amazon Aurora PostgreSQL. Bron: AWS Blogs
Auditen met Aurora-logs
Het monitoren en auditen van database-activiteit is essentieel voor security-compliance en troubleshooting.
Aurora biedt verschillende logmechanismen, waaronder error logs, slow query logs en general logs, die beheerders helpen database-activiteit te volgen en potentiële problemen te identificeren. Deze logs kunnen via de AWS Management Console worden ingeschakeld en in Amazon CloudWatch worden opgeslagen voor gecentraliseerde analyse.
- Error logs leggen database-enginefouten en waarschuwingen vast.
- Slow query logs helpen inefficiënte queries te identificeren die impact op de performance hebben.
Het analyseren van deze logs kan beheerders helpen om query-uitvoering te optimaliseren, ongeautoriseerde toegangspogingen te detecteren en de stabiliteit van de database te waarborgen.
Kostenbeheer en -optimalisatie in AWS Aurora
Om kosten in Amazon Aurora effectief te beheren en te optimaliseren, moet je de prijsstructuur begrijpen. Laten we die doornemen!
Aurora-prijzen begrijpen
Het prijsmodel van Amazon Aurora is gebaseerd op verschillende factoren, waaronder instance-uren, opslagverbruik, I/O-verzoeken en datatransfer.
In tegenstelling tot traditionele databases die voorafgaande infrastructuurprovisioning vereisen, maakt het pay-as-you-go-model van Aurora het mogelijk om alleen te betalen voor de resources die je verbruikt.
Compute-instances worden gefactureerd op basis van de instance-klasse en uptime, terwijl opslag dynamisch wordt opgeschaald, waardoor handmatige aanpassingen overbodig zijn.
De onderstaande afbeelding geeft een uitsplitsing van de verschillende prijscomponenten voor Amazon Aurora. Houd er echter rekening mee dat prijzen kunnen veranderen, dus het is altijd het beste om te raadden naar de Aurora-prijzenpagina voor de meest recente informatie.
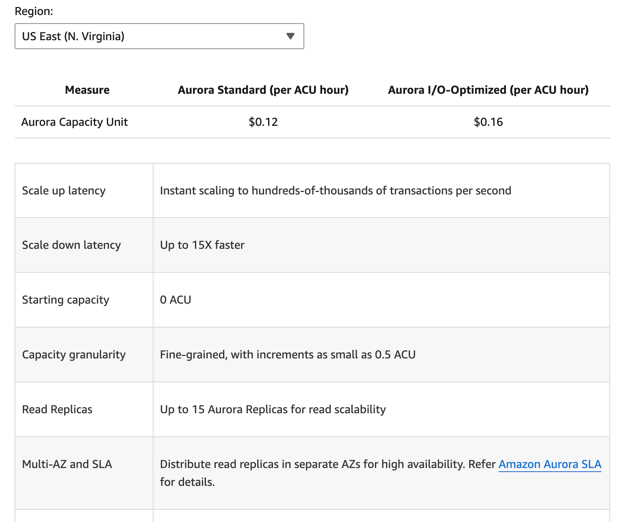
Extra kosten omvatten back-upopslag boven de toegewezen gratis laag, lees- en schrijfbewerkingen (I/O) en datatransferkosten voor cross-region replicatie.
Inzicht in deze prijscomponenten helpt je uitgaven te voorspellen en weloverwogen beslissingen te nemen over databasegebruik.
Kosten optimaliseren met Aurora
Om kosten effectief te beheren, kunnen organisaties verschillende optimalisatiestrategieën toepassen.
Door de juiste instancegrootte te selecteren, zorg je ervoor dat databaseresources aansluiten bij de workload zonder overprovisioning.
- Als je een voorspelbare workload hebt, gebruik dan Reserved Instances, omdat deze aanzienlijke kostenbesparingen bieden ten opzichte van On-Demand-prijzen.
- Opslagoptimalisatietechnieken, zoals het monitoren van ongebruikte of onderbenutte resources, helpen kosten te verlagen.
- De auto-scaling-feature van Aurora past opslag dynamisch aan, waardoor onnodige opslagkosten worden voorkomen.
- Daarnaast kan het implementeren van read replicas queries van de primaire instance overnemen, waardoor mogelijk geen duurdere instanceklassen nodig zijn.
- Maak gebruik van Aurora Serverless, een kostenefficiënte optie voor applicaties met variabele workloads. Aurora Serverless schaalt compute-resources automatisch op basis van de vraag, zodat je alleen betaalt voor het daadwerkelijke gebruik en geen continu draaiende instance hoeft te onderhouden.
> Wil je meer inzicht krijgen in kostenbeheer, raadspleeg dan de cursus AWS Security and Cost Management.
Conclusie
Na geruime tijd bij meerdere bedrijven met Amazon Aurora te hebben gewerkt, kan ik vol vertrouwen zeggen dat het een krachtige en schaalbare databaseoplossing is die het beheer vereenvoudigt zonder in te leveren op performance—je zult het waarschijnlijk met me eens zijn na het doorlopen van deze tutorial.
Aurora is het overwegen waard als je op zoek bent naar een cloud-native relationele database die MySQL en PostgreSQL ondersteunt en tegelijk de operationele overhead vermindert. Het is in sommige van mijn projecten ronduit vernieuwend geweest, en ik raad zeker aan om de mogelijkheden te verkennen als je met AWS-databases werkt.
Als je nieuw bent met AWS-databases, kan het leren van fundamentele concepten via cursussen zoals AWS Cloud Practitioner (CLF-C02) nuttig zijn!
FAQs
Wat is het verschil tussen Aurora MySQL en Aurora PostgreSQL?
Aurora MySQL is geoptimaliseerd voor MySQL-applicaties, terwijl Aurora PostgreSQL PostgreSQL-features en -extensies ondersteunt.
Hoe verhoudt Aurora zich tot RDS?
Aurora biedt hogere performance en schaalbaarheid dan standaard RDS voor MySQL en PostgreSQL, met tot vijf keer de doorvoer van MySQL. Het is volledig compatibel met MySQL/PostgreSQL en omvat door AWS beheerde features zoals automatische back-ups, patching en failover.
Kan ik mijn bestaande MySQL/PostgreSQL-database migreren naar Aurora?
Ja, AWS Database Migration Service (DMS) ondersteunt naadloze migratie naar Aurora.
Ondersteunt Aurora replicatie over meerdere regio's?
Ja, de Aurora Global Database biedt cross-region replicatie met lage latency.
Hoe verlaag ik de kosten van Aurora?
Gebruik Reserved Instances, Serverless Aurora en read replicas om kosten te optimaliseren.
Is Amazon Aurora serverless?
Ja, Amazon Aurora biedt een serverless-optie, Aurora Serverless genaamd, die automatisch op- of afschaalt op basis van de vraag—ideaal voor onvoorspelbare workloads.
Wat zijn de back-up- en herstelopties in Aurora?
Aurora biedt automatische continue back-ups naar Amazon S3 en ondersteunt handmatige snapshots. Je kunt je database herstellen naar een specifiek tijdstip of vanaf een snapshot, afhankelijk van de behoefte.
Kan ik Aurora gebruiken voor een applicatie met hoge beschikbaarheid?
Ja, Aurora is ontworpen voor hoge beschikbaarheid met automatische failover, multi-AZ-deployments en replicatiefeatures zoals Aurora Read Replicas en Aurora Global Database.



Na Aurora van Amazon Aurora een tijd bij verschillende bedrijven te hebben gebruikt, heb ik uit eerste hand gezien hoe het uitblinkt als volledig beheerde relationele database-engine met hoge performance, schaalbaarheid en betrouwbaarheid.
Als cloud-native oplossing die MySQL en PostgreSQL ondersteunt, is Aurora een uitstekende keuze voor bedrijven die hoge beschikbaarheid en automatische schaalbaarheid nodig hebben. Omdat AWS back-ups, failover en replicatie automatisch beheert, kun je met Aurora de database-efficiëntie verhogen en de onderhoudskosten verlagen.
In deze tutorial laat ik je zien hoe je een Aurora-instance opzet, die efficiënt beheert, performance optimaliseert en zorgt voor security en kostenefficiëntie.
Wat is AWS Aurora?
Amazon Aurora is een cloudgebaseerde relationele database die traditionele MySQL en PostgreSQL overtreft door opslag- en compute-resources dynamisch op te schalen.
Volgens AWS kan Aurora tot vijf keer de doorvoer van standaard MySQL en drie keer de performance van standaard PostgreSQL leveren—dankzij de gedistribueerde en hoog beschikbare architectuur.
Aurora is gebouwd met features zoals geautomatiseerde back-ups, read replicas voor horizontale schaalvergroting en failovermechanismen die minimale downtime garanderen.
De opslaglaag van Aurora is ontworpen om fouttolerant en zelfherstellend te zijn.
Daarnaast wordt data automatisch over meerdere Availability Zones (AZ’s) gerepliceerd om duurzaamheid te waarborgen.
De onderstaande afbeelding geeft een overzicht op hoofdlijnen van de architectuur en kernfeatures van Amazon Aurora.
De relatie tussen het clustervolume, de writer-DB-instance en de reader-DB-instances in een Aurora-cluster. Bron: AWS Docs
De database-engine bewaakt continu queries en optimaliseert uitvoeringsplannen, wat leidt tot aanzienlijke efficiëntiewinst.
Een van de belangrijkste voordelen van Aurora is de compatibiliteit met bestaande MySQL- en PostgreSQL-databases, waardoor bedrijven eenvoudig kunnen migreren zonder hun applicaties ingrijpend te hoeven aanpassen.
Ook de kostenstructuur van Aurora is aantrekkelijk. Je betaalt op basis van het daadwerkelijke gebruik van compute- en opslagresources. Dit kostenmodel elimineert de noodzaak om infrastructuur te overprovisioneren, wat geld bespaart.
> Ben je geïnteresseerd in een breder begrip van AWS-opslagopties, bekijk dan deze AWS Storage-tutorial.