

AWS Aurora सेटअप करना
AWS Aurora सेटअप करने में एक डेटाबेस क्लस्टर बनाना, सुरक्षा सेटिंग्स कॉन्फ़िगर करना, और उचित नेटवर्क एक्सेस सुनिश्चित करना शामिल है। आइए इस खंड में यह सब करें!
> यदि आप AWS में नए हैं, तो Aurora में जाने से पहले Introduction to AWS कोर्स के साथ बुनियादी विषयों की समीक्षा करने पर विचार करें।
Aurora डेटाबेस क्लस्टर बनाना
Aurora डेटाबेस क्लस्टर सेटअप करने के लिए कुछ प्रमुख चरणों की आवश्यकता होती है, जिनमें उपयुक्त डेटाबेस इंजन का चयन, सुरक्षा सेटिंग्स कॉन्फ़िगर करना, और इंस्टेंस विनिर्देश तय करना शामिल है।
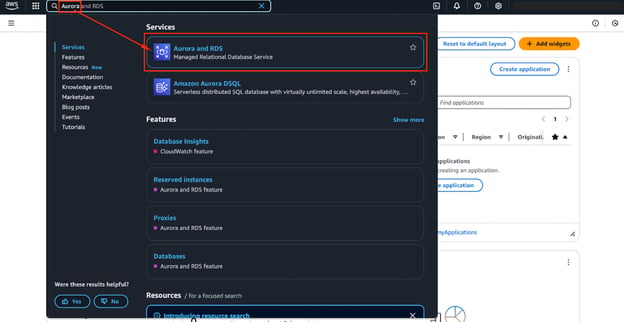
- शुरू करने के लिए, AWS Management Console में लॉग इन करें और RDS (Relational Database Service) डैशबोर्ड पर जाएं.
- आप यह AWS Management Console के सर्च पैनल में "Aurora" खोजकर कर सकते हैं—जैसा कि नीचे दी गई छवि में दिखाया गया है।
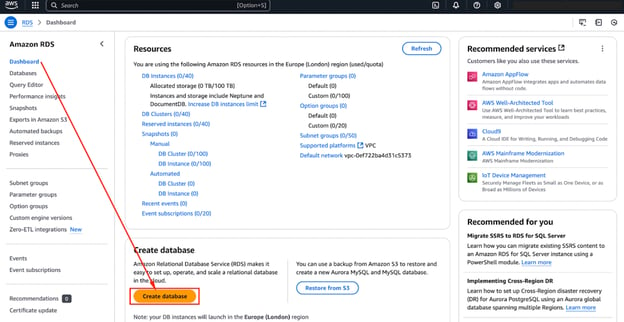
- वहाँ पहुँचने के बाद, “Create Database” पर क्लिक करें—जैसा कि नीचे दी गई छवि में दिखाया गया है।
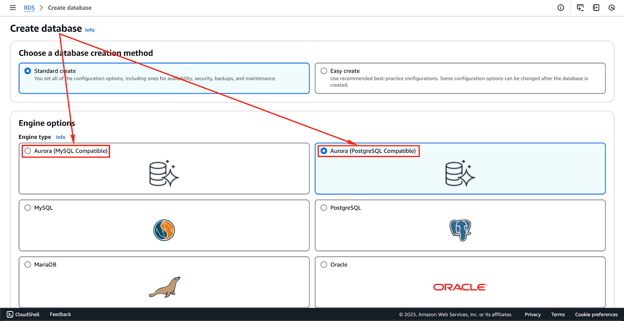
- इसके बाद आपको डेटाबेस इंजन के रूप में "Amazon Aurora" चुनने का विकल्प मिलेगा.
- ध्यान रखें कि Aurora MySQL और PostgreSQL दोनों को सपोर्ट करता है, इसलिए अपने एप्लिकेशन की आवश्यकताओं के अनुरूप संस्करण चुनना महत्वपूर्ण है।
नीचे दी गई छवि वर्तमान में उपलब्ध इंजन विकल्प दिखाती है। ये भविष्य में बदल सकते हैं, लेकिन पहले दो विकल्प—Aurora (MySQL Compatible) और Aurora (PostgreSQL Compatible)—Aurora इंजन हैं।
- इंजन चुनने के बाद, आपको इंस्टेंस टाइप और स्टोरेज कॉन्फ़िगरेशन निर्दिष्ट करने होंगे.
- Aurora स्वचालित रूप से स्टोरेज को 128TB तक स्केल करने की लचीलापन प्रदान करता है, जिससे बढ़ते वर्कलोड को बिना मैन्युअल हस्तक्षेप के कुशलतापूर्वक संभाला जा सके.
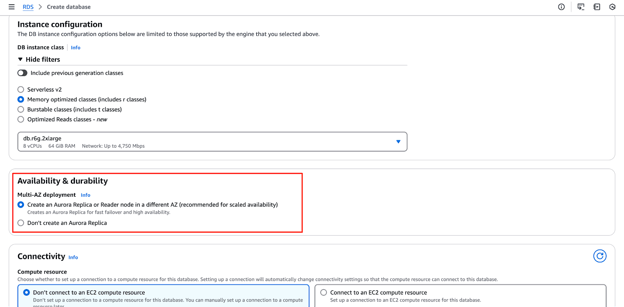
- अगला चरण रेप्लिकेशन सेटिंग्स को परिभाषित करना है। आप सिंगल-इंस्टेंस डिप्लॉयमेंट चुन सकते हैं या डेटाबेस ट्रैफिक को अधिक प्रभावी ढंग से वितरित करने के लिए रीड रेप्लिकाज सक्षम कर सकते हैं.
- रीड रेप्लिकाज का उपयोग उपलब्धता और फॉल्ट टॉलरेंस को भी बढ़ाता है, जो विफलताओं की स्थिति में उच्च टिकाऊपन सुनिश्चित करता है।
नीचे दी गई छवि में "Availability & durability" सेक्शन को हाइलाइट किया गया है, जहां आप इन सेटिंग्स को कॉन्फ़िगर कर सकते हैं।
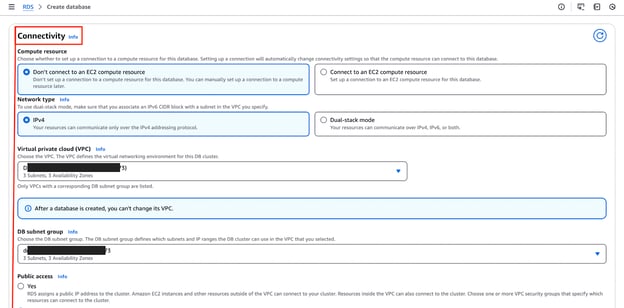
- नेटवर्किंग कॉन्फ़िगरेशन चरण महत्वपूर्ण है, क्योंकि इसमें Virtual Private Cloud (VPC) सेट करना, एक सुरक्षा समूह चुनना, और एक्सेस नियंत्रण परिभाषित करना शामिल है.
- सुरक्षा समूह एक फ़ायरवॉल की तरह काम करता है जो इनबाउंड और आउटबाउंड डेटाबेस ट्रैफिक को नियंत्रित करता है। सुरक्षा बढ़ाने के लिए, यह अनुशंसित है कि आप केवल विश्वसनीय IP पतों और एप्लिकेशन से ही एक्सेस की अनुमति दें।
नीचे दी गई छवि में "Connectivity" सेक्शन हाइलाइट किया गया है, जहां आप इन कॉन्फ़िगरेशन को सेटअप और कस्टमाइज़ कर सकते हैं।
- सेटअप के दौरान डेटाबेस क्रेडेंशियल्स भी कॉन्फ़िगर करने होते हैं—जहां आप एक मास्टर यूज़रनेम और पासवर्ड असाइन करते हैं जिसका उपयोग कनेक्शन को प्रमाणित करने के लिए किया जाएगा.
- Aurora में स्वचालित बैकअप और पॉइंट-इन-टाइम रिकवरी विकल्प सक्षम किए जा सकते हैं। यह सुनिश्चित करता है कि डेटा लॉस को रोकने के लिए डेटाबेस स्नैपशॉट लगातार बनाए जाएं।
सभी कॉन्फ़िगरेशन की समीक्षा करने के बाद, आप Aurora क्लस्टर बनाने की प्रक्रिया आगे बढ़ा सकते हैं। नीचे दी गई छवि में वह "Create Database" बटन दिखाया गया है, जिस पर क्लिक कर आप क्रिएशन प्रक्रिया शुरू कर सकते हैं।
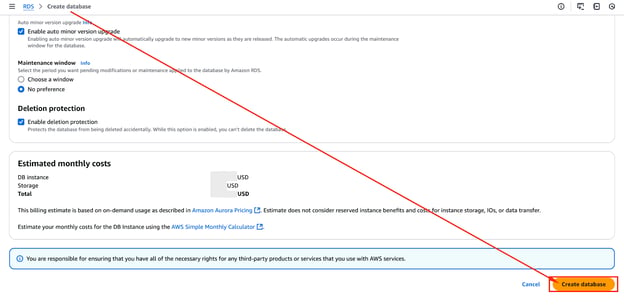
प्रोविज़निंग प्रक्रिया में, चुने गए इंस्टेंस आकार और नेटवर्क सेटिंग्स के आधार पर, कुछ मिनट लग सकते हैं।
> यदि आप AWS सेवाओं में नए हैं, तो AWS Cloud Technology and Services कोर्स की समीक्षा करने से आपको Aurora सेटअप से संबंधित प्रमुख AWS कॉन्सेप्ट समझने में मदद मिल सकती है।
नेटवर्क और सुरक्षा कॉन्फ़िगर करना
Aurora डेटाबेस को प्रबंधित करने में सुरक्षा अत्यंत महत्वपूर्ण है, और AWS मजबूत एक्सेस नियंत्रण लागू करने के लिए कई उपकरण प्रदान करता है.
- Aurora इंस्टेंस को सुरक्षित करने का पहला कदम VPC सुरक्षा समूह कॉन्फ़िगर करना है। ये सुरक्षा समूह निर्धारित करते हैं कि कौन से IP पते और सेवाएं डेटाबेस के साथ इंटरैक्ट कर सकती हैं.
- अनधिकृत कनेक्शनों को रोकने के लिए आपको एक्सेस को विशिष्ट एप्लिकेशन सर्वर और प्रशासकों तक सीमित रखना चाहिए।
- AWS Identity and Access Management (IAM) का उपयोग भी डेटाबेस कार्यों के लिए सूक्ष्म-स्तरीय अनुमतियाँ परिभाषित करने के लिए किया जा सकता है.
- IAM roles को इंटीग्रेट करना आपको विशिष्ट यूज़र रोल और जिम्मेदारियों के अनुसार डेटाबेस एक्सेस को अनुकूलित करने की अनुमति देता है।
- उदाहरण के लिए, एप्लिकेशन डेवलपर्स को केवल रीड एक्सेस दी जा सकती है, जबकि प्रशासकों को डेटाबेस संशोधनों पर पूर्ण नियंत्रण होगा।
- संवेदनशील डेटा की सुरक्षा के लिए एन्क्रिप्शन भी सक्षम होना चाहिए। AWS Aurora, AWS Key Management Service (KMS) का उपयोग करके at rest और in transit एन्क्रिप्शन को सपोर्ट करता है।
- डेटा at rest को एन्क्रिप्ट करने से सुनिश्चित होता है कि यदि स्टोरेज मीडिया से समझौता भी हो जाए, तब भी उचित डिक्रिप्शन कुंजी के बिना डेटा तक पहुंच संभव न हो।
- इसी प्रकार, डेटा in transit के लिए Secure Sockets Layer (SSL) एन्क्रिप्शन सक्षम करने से डेटाबेस संचार के अनधिकृत इंटरसेप्शन को रोका जा सकता है।
> AWS वातावरण को सुरक्षित करने में गहराई से जानने के लिए AWS Security and Cost Management कोर्स देखें। यदि आप जानना चाहते हैं कि IAM कैसे काम करता है और इसे प्रभावी ढंग से कैसे लागू करें, तो यह AWS Identity and Access Management (IAM) पर गाइड देखें।
AWS Aurora से कनेक्ट करना
डेटाबेस के साथ इंटरैक्ट करने के लिए AWS Aurora से कनेक्ट करना आवश्यक है। आप यह क्लाइंट टूल्स या एप्लिकेशन के माध्यम से कर सकते हैं। आइए इस खंड में देखें कैसे!
Aurora MySQL से कनेक्ट करना
Aurora डेटाबेस के चालू होने के बाद, डेटाबेस के साथ इंटरैक्ट करना शुरू करने के लिए आपको कनेक्शन स्थापित करने की आवश्यकता होगी.
Aurora MySQL के लिए, MySQL Workbench और HeidiSQL जैसे सामान्य डेटाबेस क्लाइंट का उपयोग करके कनेक्ट किया जा सकता है। वैकल्पिक रूप से, आप कमांड-लाइन इंटरफेस का उपयोग कर सकते हैं।
कनेक्शन के लिए डेटाबेस एंडपॉइंट निर्दिष्ट करना आवश्यक है, जो AWS Management Console में मिल सकता है.
MySQL CLI का उपयोग करते हुए, निम्न कमांड के साथ कनेक्शन स्थापित किया जा सकता है:
mysql -h your-cluster-endpoint -u admin -pमास्टर पासवर्ड दर्ज करने के बाद, आप SQL क्वेरी चलाने, टेबल बनाने, और डेटा मैनेज करने में सक्षम होने चाहिए।
Aurora PostgreSQL से कनेक्ट करना
Aurora PostgreSQL के लिए, आप pgAdmin या PostgreSQL कमांड-लाइन इंटरफेस (psql) जैसे टूल का उपयोग करके कनेक्ट कर सकते हैं.
psql में कनेक्शन कमांड इस प्रारूप का अनुसरण करता है:
psql -h your-cluster-endpoint -U admin -d yourdatabasenameठीक MySQL की तरह, डेटाबेस तक पहुंचने के लिए सही क्रेडेंशियल दर्ज करने होंगे.
एक्सेस मिल जाने के बाद, आप SQL क्वेरी चलाने, टेबल बनाने और डेटा मैनेज करने में सक्षम होंगे।
एप्लिकेशन कनेक्टिविटी कॉन्फ़िगर करना
Aurora के साथ इंटरैक्ट करने की आवश्यकता वाले एप्लिकेशन को उपयुक्त डेटाबेस कनेक्शन स्ट्रिंग्स के साथ कॉन्फ़िगर करना आवश्यक है। सामान्यतया, इन कनेक्शन स्ट्रिंग्स में यूज़रनेम, पासवर्ड, पोर्ट नंबर, और एंडपॉइंट शामिल होते हैं.
प्रदर्शन को ऑप्टिमाइज़ करने और हर अनुरोध के लिए नए कनेक्शन स्थापित करने के ओवरहेड को कम करने हेतु कनेक्शन पूलिंग का उपयोग करने की अनुशंसा की जाती है.
Python के लिए SQLAlchemy या Java के लिए JDBC जैसी लोकप्रिय लाइब्रेरी एप्लिकेशन वातावरण में कनेक्शनों को कुशलतापूर्वक प्रबंधित करने के तरीके प्रदान करती हैं।
AWS Aurora का प्रबंधन
AWS Aurora का प्रभावी प्रबंधन डेटा सुरक्षा सुनिश्चित करने, प्रदर्शन की निगरानी करने, और आवश्यकता अनुसार संसाधनों को स्केल करने से जुड़ा है। इस खंड में हम इन प्रथाओं की समीक्षा करेंगे।
बैकअप और स्नैपशॉट
AWS Aurora स्वचालित बैकअप प्रदान करता है जो Amazon S3 में डेटाबेस परिवर्तनों को लगातार कैप्चर और स्टोर करते हैं। ये बैकअप उपयोगकर्ता-परिभाषित सेटिंग्स के आधार पर रिटेन किए जाते हैं, जिससे रिटेंशन अवधि के भीतर किसी भी समय बिंदु पर रिस्टोर करना संभव हो जाता है.
स्वचालित बैकअप के अलावा, आप मैनुअल स्नैपशॉट भी बना सकते हैं जो रिटेंशन विंडो से परे बने रहते हैं। मैनुअल स्नैपशॉट दीर्घकालिक आर्काइविंग के लिए या प्रमुख डेटाबेस अपडेट से पहले विशेष रूप से उपयोगी होते हैं.
जब मैं एक महत्वपूर्ण एप्लिकेशन वाले प्रोजेक्ट पर काम कर रहा था, तो हमने हर दो घंटे में स्वचालित बैकअप शेड्यूल किए थे। हालांकि, किसी भी बदलाव या अपडेट करने से पहले, हम मैन्युअल रूप से बैकअप बनाते थे ताकि जरूरत पड़ने पर रोल बैक कर सकें। यह दर्शाता है कि स्वचालित और मैनुअल दोनों बैकअप को एक साथ प्रभावी रूप से कैसे उपयोग किया जा सकता है।
नीचे दी गई छवि दिखाती है कि Amazon Aurora के साथ डिजास्टर रिकवरी के लिए AWS Backup का कैसे उपयोग किया जा सकता है।
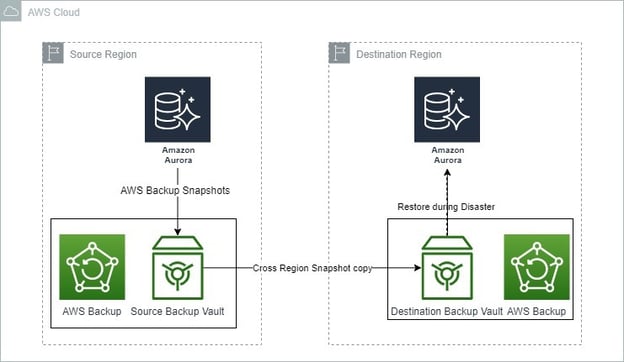
Amazon Aurora के लिए बैकअप और रिकवरी विकल्प। स्रोत: AWS Blogs
CloudWatch के साथ Aurora की मॉनिटरिंग
स्वस्थ डेटाबेस बनाए रखने के लिए प्रदर्शन मॉनिटरिंग आवश्यक है.
AWS CloudWatch वास्तविक-समय मेट्रिक्स प्रदान करता है जो CPU उपयोग, मेमोरी उपयोग, डिस्क I/O, और नेटवर्क ट्रैफिक को ट्रैक करते हैं.
CloudWatch Alarms सेट करने से प्रशासकों को प्रदर्शन सीमा पार होने पर सूचित किया जा सकता है, जिससे सक्रिय डेटाबेस प्रबंधन संभव होता है.
इसके अलावा, AWS Performance Insights धीमी चल रही क्वेरी को पहचानने और ऑप्टिमाइज़ करने के लिए विस्तृत क्वेरी विश्लेषण प्रदान करता है।
नीचे दी गई छवि दर्शाती है कि AWS Performance Insights डेटाबेस प्रदर्शन में कैसे अंतर्दृष्टि प्रदान करता है।
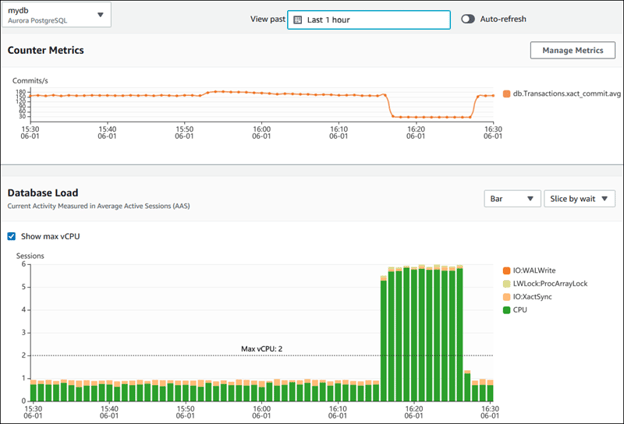
AWS Performance Insights डैशबोर्ड जिसमें डेटाबेस प्रदर्शन मेट्रिक्स दिख रहे हैं। स्रोत: AWS Docs
Aurora को स्केल करना
Aurora को आवश्यकतानुसार स्टोरेज क्षमता समायोजित करके स्वतः स्केल करने के लिए डिज़ाइन किया गया है। हालांकि, CPUs और मेमोरी जैसे कंप्यूट संसाधनों को वर्कलोड के आधार पर मैन्युअल रूप से समायोजित करने की आवश्यकता हो सकती है.
Aurora रीड क्षमताओं को स्केल करने के विकल्प प्रदान करता है, जिसमें रीड रेप्लिकाज जोड़ना शामिल है, जो रीड ट्रैफिक को वितरित करते हैं और प्रदर्शन में सुधार करते हैं.
जब उच्च उपलब्धता महत्वपूर्ण होती है, तो फेलओवर रेडंडेंसी सुनिश्चित करने के लिए Aurora क्लस्टर को विभिन्न Availability Zones में कई रेप्लिकाज के साथ कॉन्फ़िगर किया जा सकता है।
AWS Aurora में प्रदर्शन अनुकूलन
Amazon Aurora में प्रदर्शन का अनुकूलन कुशल क्वेरी एक्जीक्यूशन और स्केलेबिलिटी सुनिश्चित करता है। आइए इस खंड में कुछ सर्वोत्तम प्रथाओं पर जाएं।
इंडेक्सिंग और क्वेरी ऑप्टिमाइज़ेशन
Amazon Aurora में क्वेरी प्रदर्शन का अनुकूलन एक उच्च-प्रदर्शन डेटाबेस बनाए रखने के लिए महत्वपूर्ण है.
- इंडेक्सिंग क्वेरी एक्जीक्यूशन समय कम करने और डेटाबेस दक्षता बढ़ाने के सबसे प्रभावी तरीकों में से एक है.
- अक्सर क्वेरी की जाने वाली कॉलम पर इंडेक्स बनाना डेटा को जल्दी ढूंढने में मदद कर सकता है, जिससे पूर्ण टेबल स्कैन की आवश्यकता कम होती है.
- आपको क्वेरी पैटर्न और वर्कलोड मांगों के अनुरूप प्राइमरी और सेकेंडरी इंडेक्स का रणनीतिक रूप से उपयोग करना चाहिए.
- उपरोक्त के अलावा, आप कई कॉलम शामिल करने वाली क्वेरीज़ के लिए कॉम्पोज़िट इंडेक्स का उपयोग कर सकते हैं ताकि लुकअप समय और बेहतर हो।
- क्वेरी ऑप्टिमाइज़ेशन भी डेटाबेस प्रदर्शन में महत्वपूर्ण भूमिका निभाता है। कुशल SQL क्वेरी लिखने से Aurora कम संसाधन खपत के साथ अनुरोधों को तेज़ी से प्रोसेस करता है.
- SQL क्वेरी में
EXPLAIN or EXPLAIN ANALYZEका उपयोग बाधाओं की पहचान करने और एक्जीक्यूशन प्लान में अंतर्दृष्टि प्रदान करने में मदद करता है. - जैसी तकनीकें, जैसे
SELECT *से बचना (जो अनावश्यक डेटा पुनर्प्राप्त करता है), डेटाबेस स्कीमा का नॉर्मलाइज़ेशन करके पुनरावृत्ति कम करना, और पार्टिशनिंग रणनीतियों का लाभ उठाना, प्रदर्शन लाभ दे सकती हैं। - Aurora का क्वेरी प्लान ऑप्टिमाइज़र लगातार एक्जीक्यूशन प्लान को परिष्कृत करता है, जो डेटाबेस वर्कलोड पैटर्न के आधार पर समायोजन करता है, और इस प्रकार समग्र दक्षता बढ़ाता है।
Aurora रीड रेप्लिकाज का उपयोग
उच्च ट्रैफिक लोड को संभालने के लिए, Amazon Aurora रीड रेप्लिकाज को सपोर्ट करता है जो रीड-इंटेंसिव क्वेरीज़ को कई इंस्टेंस में वितरित करने में मदद करते हैं.
रीड रेप्लिकाज रीड अनुरोधों को अलग से प्रोसेस करके प्राथमिक डेटाबेस इंस्टेंस पर भार कम करते हैं, जिससे प्रतिक्रिया-क्षमता बेहतर होती है और लेटेंसी घटती है.
Aurora रीड रेप्लिका सेटअप करने के लिए, आपको मौजूदा Aurora क्लस्टर का चयन करना होगा और न्यूनतम कॉन्फ़िगरेशन के साथ रेप्लिकेशन सक्षम करना होगा। Aurora प्राथमिक इंस्टेंस और उसके रेप्लिकाज के बीच डेटा को स्वतः सिंक्रनाइज़ करता है, जिससे बिना मैन्युअल हस्तक्षेप के स्थिरता सुनिश्चित होती है।
Aurora का रेप्लिकेशन मैकेनिज्म अत्यधिक कुशल है, जो लगभग वास्तविक-समय डेटा सिंक्रनाइज़ेशन की अनुमति देता है, जिसमें रेप्लिकेशन लैग एक सेकंड से कम होता है।
बार-बार रीड ऑपरेशन करने वाले एप्लिकेशन, जैसे रिपोर्टिंग डैशबोर्ड या एनालिटिक्स सेवाएं, रीड-हैवी क्वेरीज़ को इन इंस्टेंस पर निर्देशित करके रीड रेप्लिकाज से काफी लाभ उठा सकते हैं.
प्राथमिक इंस्टेंस विफल होने की स्थिति में, न्यूनतम डाउनटाइम के साथ रीड रेप्लिका को नए प्राथमिक इंस्टेंस के रूप में प्रमोट किया जा सकता है, जिससे उच्च उपलब्धता और व्यवसाय निरंतरता सुनिश्चित होती है।
नीचे दी गई छवि दिखाती है कि क्रॉस-रीजन Aurora रेप्लिकाज डिजास्टर रिकवरी और उच्च उपलब्धता में कैसे मदद कर सकते हैं।
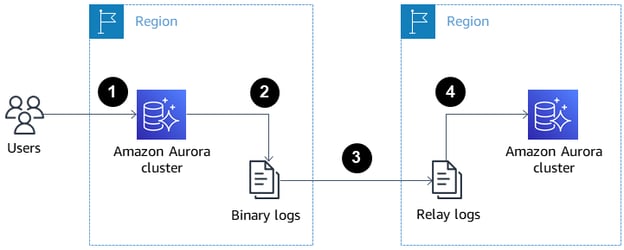
डिजास्टर रिकवरी और उच्च उपलब्धता के लिए क्रॉस-रीजन Aurora रीड रेप्लिकाज। स्रोत: AWS Docs
Aurora के लिए कैशिंग रणनीतियाँ
कैशिंग, Aurora पर प्रत्यक्ष क्वेरी लोड को कम करके डेटाबेस प्रदर्शन बढ़ाने की एक शक्तिशाली तकनीक है। कैशिंग लेयर अक्सर एक्सेस की जाने वाली क्वेरी के लिए डेटा पुनर्प्राप्ति को काफी तेज कर सकती है.
Amazon ElastiCache, जो Redis और Memcached को सपोर्ट करता है, आमतौर पर Aurora के साथ उपयोग किया जाता है ताकि क्वेरी परिणामों को संग्रहीत किया जा सके और अनावश्यक डेटाबेस क्वेरीज़ को रोका जा सके।
एप्लिकेशन आर्किटेक्चर में कैशिंग इंटीग्रेट करने से प्रतिक्रिया समय में सुधार होता है, जबकि डेटाबेस कंप्यूट संसाधनों की बचत होती है.
राइट-थ्रू कैशिंग (जहां डेटा एक साथ कैश और Aurora दोनों में लिखा जाता है) और लेज़ी लोडिंग (जहां डेटा केवल अनुरोध करने पर कैश किया जाता है) जैसी कैशिंग रणनीतियाँ, उपयोग पैटर्न के आधार पर प्रदर्शन को ऑप्टिमाइज़ करने में मदद करती हैं.
कैश किए गए डेटा के लिए उपयुक्त time-to-live (TTL) कॉन्फ़िगर करना सुनिश्चित करता है कि कैश ताज़ा बना रहे और बासी डेटा की पुनर्प्राप्ति से बचा जा सके।
AWS Aurora में सुरक्षा और अनुपालन
अपने Aurora डेटाबेस को सुरक्षित रखना संवेदनशील डेटा की सुरक्षा और अनुपालन सुनिश्चित करने के लिए महत्वपूर्ण है। आइए इस खंड में सर्वोत्तम प्रथाओं की समीक्षा करें।
डेटा एन्क्रिप्शन
डेटा सुरक्षा डेटाबेस प्रबंधन का मूल है, और AWS Aurora संवेदनशील डेटा की सुरक्षा के लिए मजबूत एन्क्रिप्शन मैकेनिज्म प्रदान करता है।
- Aurora डेटा at rest को AWS Key Management Service (KMS) का उपयोग करके एन्क्रिप्ट करता है, जो सुनिश्चित करता है कि अंतर्निहित स्टोरेज से समझौता होने पर भी संग्रहीत जानकारी सुरक्षित रहे।
- डेटाबेस निर्माण के दौरान एन्क्रिप्शन सक्षम करने से सभी स्वचालित बैकअप, स्नैपशॉट और रेप्लिकाज एक ही एन्क्रिप्शन सेटिंग्स को विरासत में लेते हैं।
- डेटा in transit के लिए, Aurora SSL/TLS एन्क्रिप्शन को सपोर्ट करता है, जो डेटाबेस कनेक्शनों को सुरक्षित करता है और डेटा ट्रांसमिशन के अनधिकृत एक्सेस या इंटरसेप्शन को रोकता है.
- Aurora से कनेक्ट करने वाले एप्लिकेशन को सुरक्षित संचार बनाए रखने के लिए SSL सर्टिफिकेट्स का उपयोग करने हेतु कॉन्फ़िगर किया जाना चाहिए.
ये एन्क्रिप्शन उपाय आपको सुरक्षा सर्वोत्तम प्रथाओं और नियामक आवश्यकताओं का पालन करने में मदद कर सकते हैं।
नीचे दी गई छवि दर्शाती है कि आपका डेटाबेस एन्क्रिप्ट करने के लिए AWS KMS Amazon Aurora के साथ कैसे इंटीग्रेट होता है।
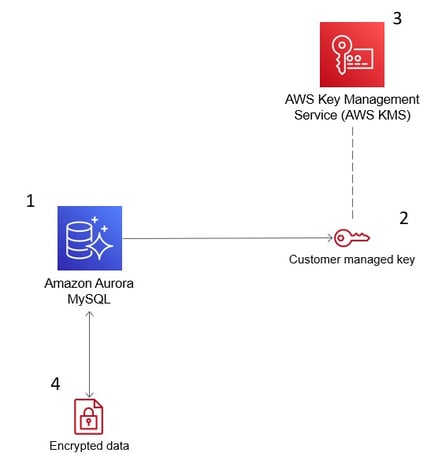
सुरक्षा अनुपालन के लिए AWS Key Management Service (KMS) Amazon Aurora में डेटा को एन्क्रिप्ट करता है। स्रोत: AWS Blogs
एक्सेस नियंत्रण के लिए IAM इंटीग्रेशन
Aurora में एक्सेस नियंत्रण AWS IAM के माध्यम से प्रबंधित होता है, जो प्रशासकों को यूज़र रोल के आधार पर सूक्ष्म-स्तरीय अनुमतियाँ परिभाषित करने की अनुमति देता है.
- IAM policies का उपयोग डेटाबेस इंस्टेंस तक पहुंच को प्रतिबंधित करने के लिए किया जा सकता है, जिससे अनधिकृत उपयोगकर्ता डेटा संशोधन या प्रशासनिक कार्य जैसी महत्वपूर्ण कार्रवाइयाँ न कर सकें।
- IAM authentication पारंपरिक पासवर्ड-आधारित प्रमाणीकरण की तुलना में अधिक सुरक्षित विकल्प प्रदान करता है। यह एप्लिकेशन को अस्थायी सुरक्षा क्रेडेंशियल्स का उपयोग करके कनेक्ट करने की अनुमति देता है। इससे डेटाबेस पासवर्ड को स्टोर और मैनेज करने की आवश्यकता समाप्त हो जाती है, और क्रेडेंशियल एक्सपोजर का जोखिम कम होता है.
आपको न्यूनतम विशेषाधिकार (least privilege) के सिद्धांत लागू करने चाहिए, जो सुरक्षा जोखिमों को कम करते हैं और डेटाबेस एक्सेस पर कड़ा नियंत्रण बनाए रखते हैं।
नीचे दी गई छवि दिखाती है कि Amazon Aurora PostgreSQL डेटाबेस एक्सेस को सुरक्षित करने के लिए IAM authentication कैसे कॉन्फ़िगर किया जा सकता है।
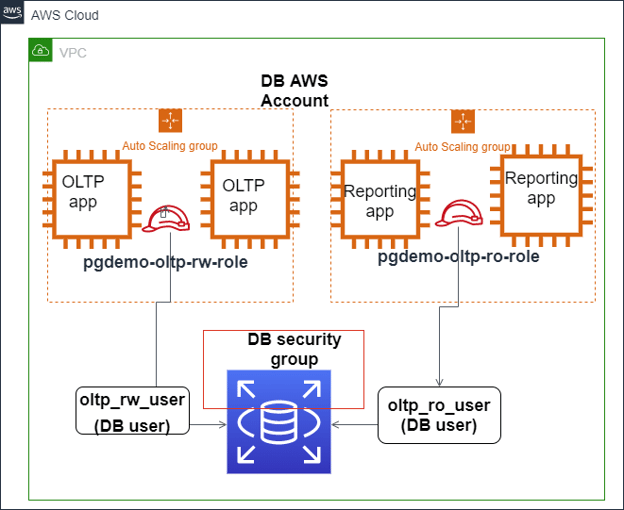
IAM authentication Amazon Aurora PostgreSQL के साथ इंटीग्रेट होता है। स्रोत: AWS Blogs
Aurora लॉग्स के साथ ऑडिटिंग
सुरक्षा अनुपालन और ट्रबलशूटिंग के लिए डेटाबेस गतिविधि की मॉनिटरिंग और ऑडिटिंग आवश्यक है.
Aurora कई लॉगिंग मैकेनिज्म प्रदान करता है, जिनमें error logs, slow query logs, और general logs शामिल हैं, जो प्रशासकों को डेटाबेस गतिविधि को ट्रैक करने और संभावित समस्याओं की पहचान करने में मदद करते हैं। इन लॉग्स को AWS Management Console के माध्यम से सक्षम किया जा सकता है और केंद्रीकृत विश्लेषण के लिए Amazon CloudWatch में संग्रहीत किया जा सकता है।
- Error logs डेटाबेस इंजन की त्रुटियों और चेतावनियों को कैप्चर करते हैं।
- Slow query लॉग्स अक्षम क्वेरीज़ की पहचान करने में मदद करते हैं जो प्रदर्शन पर प्रभाव डाल सकती हैं.
इन लॉग्स का विश्लेषण प्रशासकों को क्वेरी एक्जीक्यूशन को ऑप्टिमाइज़ करने, अनधिकृत एक्सेस प्रयासों का पता लगाने, और डेटाबेस स्थिरता सुनिश्चित करने में मदद कर सकता है।
AWS Aurora में लागत प्रबंधन और अनुकूलन
Amazon Aurora में लागत को प्रभावी ढंग से प्रबंधित और अनुकूलित करने के लिए, आपको इसकी प्राइसिंग संरचना को समझना चाहिए। आइए इसकी समीक्षा करें!
Aurora प्राइसिंग को समझना
Amazon Aurora का प्राइसिंग मॉडल कई कारकों पर आधारित है, जिनमें इंस्टेंस घंटे, स्टोरेज खपत, I/O रिक्वेस्ट, और डेटा ट्रांसफर शामिल हैं.
पारंपरिक डेटाबेस के विपरीत, जिन्हें अग्रिम इन्फ्रास्ट्रक्चर प्रोविज़निंग की आवश्यकता होती है, Aurora का पे-एज़-यू-गो मॉडल व्यवसायों को केवल उपयोग किए गए संसाधनों के लिए भुगतान करने की अनुमति देता है।
कंप्यूट इंस्टेंस को इंस्टेंस क्लास और अपटाइम के आधार पर बिल किया जाता है, जबकि स्टोरेज को डायनेमिक रूप से स्केल किया जाता है, जिससे मैन्युअल समायोजन की आवश्यकता समाप्त होती है।
नीचे दी गई छवि Amazon Aurora के विभिन्न प्राइसिंग घटकों का ब्रेकडाउन प्रदान करती है। हालांकि, ध्यान रखें कि प्राइसिंग बदल सकती है, इसलिए सबसे नई जानकारी के लिए हमेशा Aurora pricing page देखना सबसे अच्छा है।
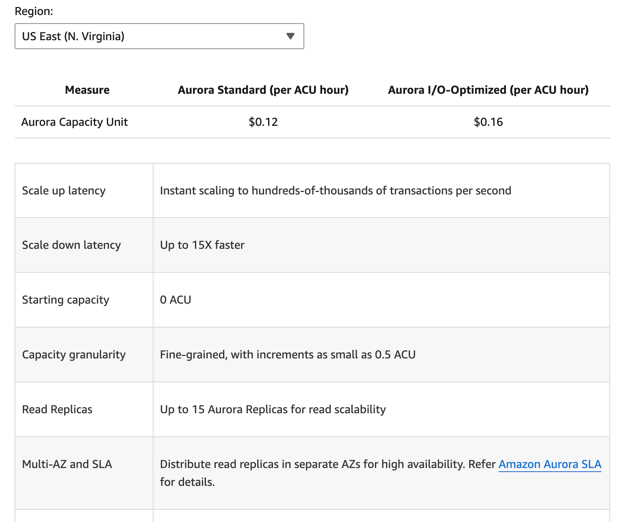
अतिरिक्त लागतों में आवंटित फ्री टियर से परे बैकअप स्टोरेज, रीड और राइट I/O रिक्वेस्ट, और क्रॉस-रीजन रेप्लिकेशन के लिए डेटा ट्रांसफर शुल्क शामिल हैं.
इन प्राइसिंग घटकों को समझने से आप खर्चों का पूर्वानुमान लगा सकते हैं और डेटाबेस उपयोग के संबंध में सूचित निर्णय ले सकते हैं।
Aurora के साथ लागत का अनुकूलन
लागत को प्रभावी ढंग से प्रबंधित करने के लिए, संगठन कई अनुकूलन रणनीतियाँ लागू कर सकते हैं.
उपयुक्त इंस्टेंस आकार का चयन करने से यह सुनिश्चित होगा कि डेटाबेस संसाधन वर्कलोड मांगों के अनुरूप हों और ओवर-प्रोविज़निंग न हो.
- यदि आपका वर्कलोड पूर्वानुमेय है, तो Reserved Instances का उपयोग करें, क्योंकि वे On-Demand प्राइसिंग की तुलना में महत्वपूर्ण लागत बचत प्रदान करते हैं।
- स्टोरेज ऑप्टिमाइज़ेशन तकनीकें, जैसे अनुपयोगी या कम उपयोग किए गए संसाधनों की मॉनिटरिंग, लागत कम करने में मदद करती हैं.
- Aurora की ऑटो-स्केलिंग सुविधा स्टोरेज को डायनेमिक रूप से समायोजित करती है, जिससे अनावश्यक स्टोरेज खर्चों को रोका जा सकता है.
- इसके अलावा, रीड रेप्लिकाज लागू करना प्राथमिक इंस्टेंस से क्वेरीज़ का लोड हटा सकता है, जिससे उच्च-स्तरीय इंस्टेंस की आवश्यकता संभावित रूप से कम हो सकती है।
- Aurora Serverless का लाभ उठाएं, क्योंकि यह परिवर्तनीय वर्कलोड वाले एप्लिकेशन के लिए एक और किफायती विकल्प है। Aurora Serverless मांग के आधार पर कंप्यूट संसाधनों को स्वचालित रूप से स्केल करता है, जिससे व्यवसाय केवल वास्तविक उपयोग के लिए भुगतान करते हैं, बजाय एक निरंतर चल रहे इंस्टेंस को बनाए रखने के।
> यदि आप लागत प्रबंधन पर और अंतर्दृष्टि प्राप्त करना चाहते हैं, तो AWS Security and Cost Management कोर्स देखें।
निष्कर्ष
कई कंपनियों में लंबे समय तक Amazon Aurora के साथ काम करने के बाद, मैं आत्मविश्वास से कह सकता हूं कि यह एक शक्तिशाली और स्केलेबल डेटाबेस समाधान है जो प्रबंधन को आसान बनाता है, बिना प्रदर्शन से समझौता किए—आप भी इस ट्यूटोरियल से गुजरने के बाद संभवतः सहमत होंगे।
यदि आप ऐसा क्लाउड-नेटिव रिलेशनल डेटाबेस ढूंढ रहे हैं जो MySQL और PostgreSQL को सपोर्ट करता हो और परिचालन ओवरहेड को कम करता हो, तो Aurora विचार करने योग्य है। यह मेरे कुछ प्रोजेक्ट्स में क्रांतिकारी रहा है, और यदि आप AWS डेटाबेस के साथ काम कर रहे हैं तो मैं इसकी क्षमताओं पर गौर करने की सिफारिश करता हूं।
यदि आप AWS डेटाबेस में नए हैं, तो जैसे कोर्स AWS Cloud Practitioner (CLF-C02) के माध्यम से बुनियादी अवधारणाएँ सीखना उपयोगी हो सकता है!
FAQs
Aurora MySQL और Aurora PostgreSQL में क्या अंतर है?
Aurora MySQL MySQL एप्लिकेशन के लिए ऑप्टिमाइज़्ड है, जबकि Aurora PostgreSQL, PostgreSQL की विशेषताओं और एक्सटेंशन्स को सपोर्ट करता है।
Aurora RDS की तुलना में कैसा है?
Aurora, मानक RDS (MySQL और PostgreSQL के लिए) की तुलना में उच्च प्रदर्शन और स्केलेबिलिटी प्रदान करता है, MySQL की थ्रूपुट से पांच गुना तक। यह MySQL/PostgreSQL के साथ पूर्णतः संगत है और AWS-प्रबंधित सुविधाएँ जैसे स्वचालित बैकअप, पैचिंग, और फेलओवर शामिल करता है।
क्या मैं अपने मौजूदा MySQL/PostgreSQL डेटाबेस को Aurora में माइग्रेट कर सकता/सकती हूँ?
हाँ, AWS Database Migration Service (DMS) Aurora में सहज माइग्रेशन का समर्थन करता है।
क्या Aurora मल्टी-रीजन रेप्लिकेशन को सपोर्ट करता है?
हाँ, Aurora Global Database कम-लेटेंसी क्रॉस-रीजन रेप्लिकेशन की अनुमति देता है।
मैं Aurora की लागत कैसे कम करूँ?
लागत को अनुकूलित करने के लिए Reserved Instances, Serverless Aurora, और रीड रेप्लिकाज का उपयोग करें।
क्या Amazon Aurora सर्वरलेस है?
हाँ, Amazon Aurora एक सर्वरलेस विकल्प प्रदान करता है जिसे Aurora Serverless कहा जाता है, जो मांग के आधार पर स्वतः ऊपर या नीचे स्केल करता है, जो अप्रत्याशित वर्कलोड के लिए आदर्श है।
Aurora में बैकअप और रिकवरी के क्या विकल्प हैं?
Aurora Amazon S3 में स्वचालित निरंतर बैकअप प्रदान करता है और मैनुअल स्नैपशॉट को सपोर्ट करता है। आप अपनी आवश्यकता अनुसार किसी विशिष्ट समय बिंदु या स्नैपशॉट से डेटाबेस रिस्टोर कर सकते हैं।
क्या मैं उच्च उपलब्धता वाले एप्लिकेशन के लिए Aurora का उपयोग कर सकता/सकती हूँ?
हाँ, Aurora को स्वचालित फेलओवर, मल्टी-AZ डिप्लॉयमेंट, और Aurora Read Replicas तथा Aurora Global Database जैसी रेप्लिकेशन सुविधाओं के साथ उच्च उपलब्धता के लिए डिज़ाइन किया गया है।

कई कंपनियों में Amazon Aurora का काफी समय से उपयोग करते हुए, मैंने प्रत्यक्ष रूप से देखा है कि यह एक पूर्णतः प्रबंधित रिलेशनल डेटाबेस इंजन के रूप में उच्च प्रदर्शन, स्केलेबिलिटी, और विश्वसनीयता प्रदान करते हुए कैसे उत्कृष्टता दिखाता है।
MySQL और PostgreSQL को समर्थन देने वाला एक क्लाउड-नेटिव समाधान होने के नाते, Aurora उन व्यवसायों के लिए उत्कृष्ट विकल्प है जिन्हें उच्च उपलब्धता और स्वचालित स्केलिंग की आवश्यकता होती है। क्योंकि AWS बैकअप, फेलओवर और रेप्लिकेशन को स्वचालित रूप से प्रबंधित करता है, Aurora का उपयोग आपको डेटाबेस दक्षता बढ़ाने और रखरखाव लागत घटाने की अनुमति देता है।
इस ट्यूटोरियल में, मैं आपको Aurora इंस्टेंस सेटअप करने, उसे कुशलतापूर्वक प्रबंधित करने, प्रदर्शन अनुकूलित करने, और सुरक्षा व किफायतीपन सुनिश्चित करने की प्रक्रिया से परिचित कराऊंगा।
AWS Aurora क्या है?
Amazon Aurora एक क्लाउड-आधारित रिलेशनल डेटाबेस है जो स्टोरेज और कंप्यूट संसाधनों को डायनेमिक तरीके से स्केल करके पारंपरिक MySQL और PostgreSQL से बेहतर प्रदर्शन देता है.
AWS के अनुसार, Aurora पांच गुना तक मानक MySQL के थ्रूपुट और तीन गुना तक मानक PostgreSQL के प्रदर्शन की डिलीवरी कर सकता है—अपनी डिस्ट्रीब्यूटेड और अत्यधिक उपलब्ध आर्किटेक्चर के कारण।
Aurora में स्वचालित बैकअप, हॉरिजॉन्टल स्केलिंग के लिए रीड रेप्लिकाज, और फेलओवर मैकेनिज्म जैसी सुविधाएं शामिल हैं, जो न्यूनतम डाउनटाइम सुनिश्चित करती हैं.
Aurora की स्टोरेज लेयर फॉल्ट-टॉलरेंट और सेल्फ-हीलिंग के लिए डिज़ाइन की गई है.
इसके अलावा, डेटा को टिकाऊपन सुनिश्चित करने के लिए स्वतः कई Availability Zones (AZs) में रेप्लिकेट किया जाता है।
नीचे दी गई छवि Amazon Aurora की आर्किटेक्चर और प्रमुख फीचर्स का उच्च-स्तरीय अवलोकन प्रदान करती है।
Aurora क्लस्टर में क्लस्टर वॉल्यूम, राइटर DB इंस्टेंस, और रीडर DB इंस्टेंस के बीच संबंध। स्रोत: AWS Docs
डेटाबेस इंजन लगातार क्वेरीज़ की निगरानी करता है और एक्जीक्यूशन प्लान को ऑप्टिमाइज़ करता है, जिससे दक्षता में उल्लेखनीय सुधार होता है।
Aurora के प्रमुख फायदों में से एक इसकी मौजूदा MySQL और PostgreSQL डेटाबेस के साथ संगतता है, जो व्यवसायों के लिए बिना अपने एप्लिकेशन में बड़े बदलाव किए माइग्रेट करना आसान बनाती है।
Aurora की लागत संरचना भी आकर्षक है। यह कंप्यूट और स्टोरेज संसाधनों के वास्तविक उपयोग के आधार पर शुल्क लेता है। यह लागत मॉडल इन्फ्रास्ट्रक्चर के ओवर-प्रोविज़निंग की आवश्यकता को समाप्त करता है, जिससे अंततः पैसे की बचत होती है।
> यदि आप AWS स्टोरेज विकल्पों की व्यापक समझ में रुचि रखते हैं, तो यह AWS Storage Tutorial देखें।