

Configurare AWS Aurora
La configurazione di AWS Aurora prevede la creazione di un cluster di database, la configurazione delle impostazioni di sicurezza e la garanzia del corretto accesso alla rete. Facciamolo in questa sezione!
> Se sei alle prime armi con AWS, valuta di rivedere gli argomenti fondamentali con il corso Introduzione ad AWS prima di addentrarti in Aurora.
Creare un cluster di database Aurora
La configurazione di un cluster di database Aurora richiede alcuni passaggi chiave, tra cui la scelta del motore di database appropriato, la configurazione della sicurezza e la definizione delle specifiche dell'istanza.
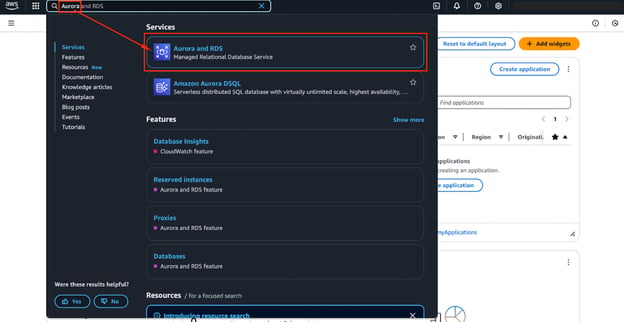
- Per iniziare, accedi alla AWS Management Console e vai alla dashboard RDS (Relational Database Service).
- Puoi farlo cercando "Aurora" nel pannello di ricerca della AWS Management Console, come mostrato nell'immagine qui sotto.
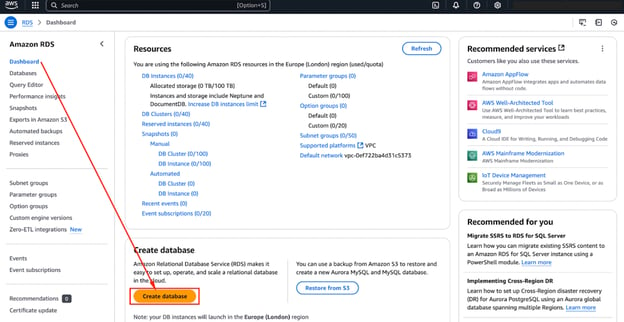
- Una volta lì, fai clic su “Create Database”, come mostrato nell'immagine seguente.
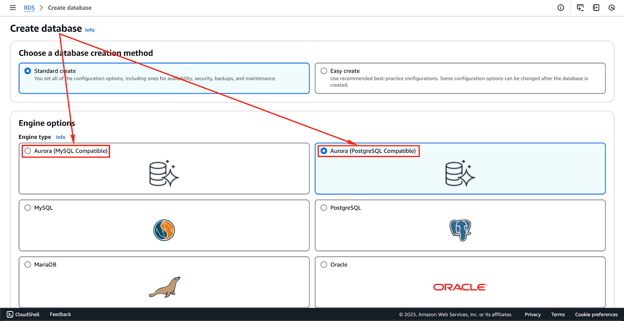
- Avrai quindi la possibilità di scegliere "Amazon Aurora" come motore di database.
- Ricorda che Aurora supporta sia MySQL che PostgreSQL, quindi è importante selezionare la versione che soddisfa al meglio i requisiti della tua applicazione.
L'immagine qui sotto mostra le opzioni del motore attualmente disponibili. Potrebbero cambiare in futuro, ma le prime due opzioni—Aurora (compatibile con MySQL) e Aurora (compatibile con PostgreSQL)—sono i motori Aurora.
- Dopo aver selezionato il motore, devi specificare il tipo di istanza e le configurazioni di storage.
- Aurora offre la flessibilità di scalare automaticamente lo storage fino a 128 TB, assicurando che i carichi di lavoro in crescita siano gestiti in modo efficiente senza interventi manuali.
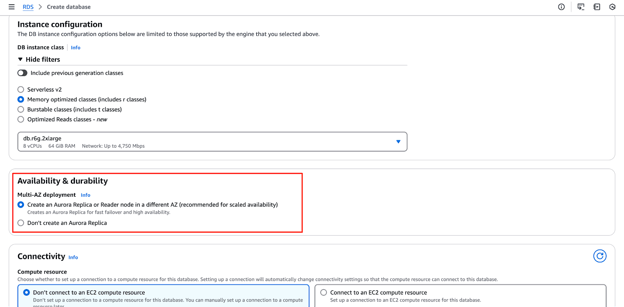
- Il passaggio successivo è definire le impostazioni di replica. Puoi optare per un deployment a istanza singola oppure abilitare le read replica per distribuire il traffico del database in modo più efficace.
- L'uso delle read replica migliora anche disponibilità e tolleranza ai guasti, garantendo maggiore durabilità in caso di problemi.
L'immagine seguente evidenzia la sezione "Availability & durability", dove puoi configurare queste impostazioni.
- La fase di configurazione del networking è cruciale, poiché prevede l'impostazione della Virtual Private Cloud (VPC), la selezione di un security group e la definizione dei controlli di accesso.
- Un security group funge da firewall che regola il traffico in entrata e in uscita del database. Per migliorare la sicurezza, si consiglia di consentire l'accesso solo da indirizzi IP e applicazioni fidate.
L'immagine seguente evidenzia la sezione "Connectivity", dove puoi impostare e personalizzare queste configurazioni.
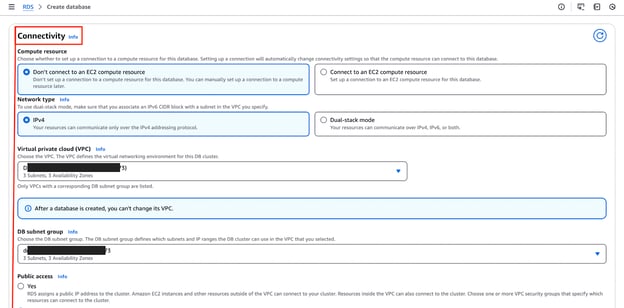
- Durante la configurazione devono essere impostate anche le credenziali del database, dove assegni un nome utente master e una password che verranno utilizzati per autenticare le connessioni.
- Aurora consente di abilitare backup automatici e opzioni di ripristino point-in-time. Questo garantisce la creazione costante di snapshot del database per prevenire la perdita di dati.
Dopo aver esaminato tutte le configurazioni, puoi procedere con la creazione del cluster Aurora. L'immagine qui sotto mostra il pulsante "Create Database" su cui puoi fare clic per avviare il processo di creazione.
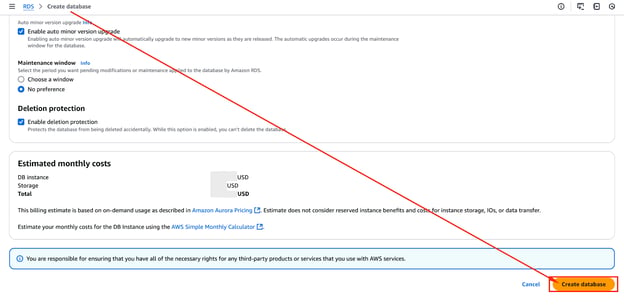
Il provisioning può richiedere diversi minuti, a seconda della dimensione dell'istanza selezionata e delle impostazioni di rete.
> Se sei nuovo ai servizi AWS, rivedere i concetti nel corso AWS Cloud Technology and Services può aiutarti a comprendere i concetti chiave di AWS rilevanti per la configurazione di Aurora.
Configurare rete e sicurezza
La sicurezza è fondamentale nella gestione di un database Aurora e AWS offre diversi strumenti per applicare solidi controlli di accesso.
- Il primo passo per mettere in sicurezza un'istanza Aurora è configurare i security group della VPC. Questi security group determinano quali indirizzi IP e servizi possono interagire con il database.
- Dovresti limitare l'accesso a specifici server applicativi e amministratori per prevenire connessioni non autorizzate.
- AWS Identity and Access Management (IAM) può essere usato anche per definire permessi di dettaglio per le operazioni di database.
- Integrare i ruoli IAM ti permette di adattare l'accesso al database in base a ruoli e responsabilità specifici degli utenti.
- Ad esempio, agli sviluppatori applicativi si può concedere solo l'accesso in lettura, mentre gli amministratori avranno il pieno controllo delle modifiche al database.
- È consigliabile abilitare anche la crittografia per proteggere i dati sensibili. AWS Aurora supporta la crittografia a riposo e in transito usando AWS Key Management Service (KMS).
- La crittografia dei dati a riposo garantisce che, anche se il supporto di archiviazione viene compromesso, i dati restano inaccessibili senza la chiave di decrittazione corretta.
- Allo stesso modo, abilitare la crittografia Secure Sockets Layer (SSL) per i dati in transito impedisce intercettazioni non autorizzate delle comunicazioni del database.
> Per approfondire la messa in sicurezza degli ambienti AWS, dà un'occhiata al corso AWS Security and Cost Management. Se vuoi saperne di più su come funziona IAM e come implementarlo in modo efficace, dai un'occhiata a questa guida su AWS Identity and Access Management (IAM).
Connessione ad AWS Aurora
Connettersi ad AWS Aurora è essenziale per interagire con il database. Puoi farlo tramite strumenti client o applicazioni. Vediamo come in questa sezione!
Connessione ad Aurora MySQL
Una volta che il database Aurora è attivo, devi stabilire una connessione per iniziare a interagire con il database.
Per Aurora MySQL, si possono usare client comuni come MySQL Workbench e HeidiSQL. In alternativa, puoi usare interfacce a riga di comando.
La connessione richiede di specificare l'endpoint del database, che puoi trovare nella AWS Management Console.
Usando la CLI MySQL, la connessione può essere stabilita con il seguente comando:
mysql -h your-cluster-endpoint -u admin -pDopo aver inserito la password master, dovresti poter eseguire query SQL, creare tabelle e gestire i dati.
Connessione ad Aurora PostgreSQL
Per Aurora PostgreSQL, puoi connetterti usando strumenti come pgAdmin o l'interfaccia a riga di comando di PostgreSQL (psql).
Il comando di connessione in psql segue questo formato:
psql -h your-cluster-endpoint -U admin -d yourdatabasenameCome con MySQL, è necessario inserire le credenziali corrette per accedere al database.
Una volta ottenuto l'accesso, dovresti poter eseguire query SQL, creare tabelle e gestire i dati.
Configurare la connettività delle applicazioni
Le applicazioni che devono interagire con Aurora vanno configurate con adeguate stringhe di connessione al database. Di solito, queste stringhe includono nome utente, password, numero di porta ed endpoint.
Si consiglia di utilizzare il connection pooling per ottimizzare le prestazioni e ridurre l'overhead della creazione di nuove connessioni per ogni richiesta.
Librerie diffuse come SQLAlchemy per Python o JDBC per Java offrono modi efficienti per gestire le connessioni in un ambiente applicativo.
Gestire AWS Aurora
Gestire efficacemente AWS Aurora significa garantire la protezione dei dati, monitorare le prestazioni e scalare le risorse secondo necessità. In questa sezione esamineremo queste pratiche.
Backup e snapshot
AWS Aurora offre backup automatici che acquisiscono e archiviano continuamente le modifiche al database in Amazon S3. Questi backup vengono conservati in base alle impostazioni definite dall'utente, consentendo il ripristino a qualsiasi punto entro il periodo di conservazione.
Oltre ai backup automatici, puoi creare snapshot manuali che persistono oltre la finestra di conservazione. Gli snapshot manuali sono particolarmente utili per l'archiviazione a lungo termine o prima di eseguire aggiornamenti importanti al database.
Quando ho lavorato a un progetto con un'applicazione critica, programmavamo backup automatici ogni due ore. Tuttavia, prima di apportare qualsiasi modifica o aggiornamento all'applicazione, creavamo manualmente un backup per assicurarci di poter tornare indietro se necessario. Questo dimostra come backup automatici e manuali possano essere usati efficacemente insieme.
L'immagine seguente mostra come AWS Backup può essere utilizzato per il disaster recovery con Amazon Aurora.
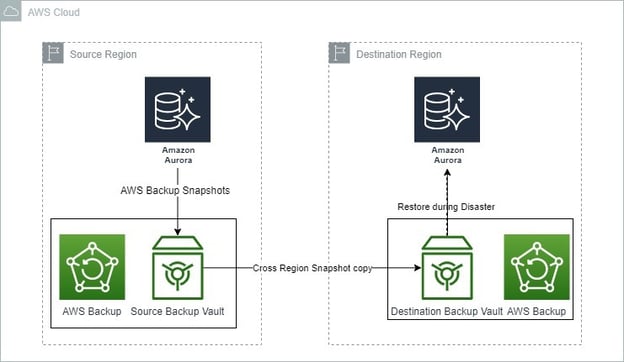
Opzioni di backup e ripristino per Amazon Aurora. Fonte: AWS Blogs
Monitorare Aurora con CloudWatch
Il monitoraggio delle prestazioni è essenziale per mantenere un database in salute.
AWS CloudWatch fornisce metriche in tempo reale che tracciano utilizzo della CPU, uso della memoria, I/O su disco e traffico di rete.
Configurare CloudWatch Alarms può aiutare gli amministratori a essere avvisati quando vengono superate soglie di prestazioni, consentendo una gestione proattiva del database.
Inoltre, AWS Performance Insights offre analisi dettagliate delle query per identificare e ottimizzare quelle lente.
L'immagine seguente mostra come AWS Performance Insights fornisca visibilità sulle prestazioni del database.
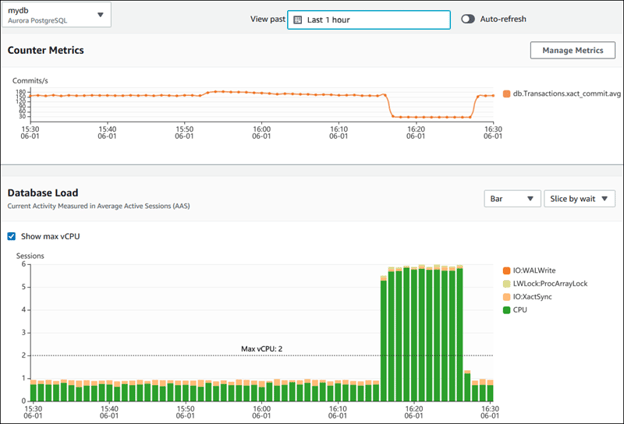
Dashboard AWS Performance Insights con metriche di prestazioni del database. Fonte: AWS Docs
Scalare Aurora
Aurora è progettato per scalare automaticamente regolando la capacità di storage secondo necessità. Tuttavia, le risorse di calcolo come CPU e memoria potrebbero dover essere regolate manualmente a seconda del carico di lavoro.
Aurora fornisce opzioni per scalare la capacità di lettura aggiungendo read replica, che distribuiscono il traffico in lettura e migliorano le prestazioni.
Quando l'alta disponibilità è critica, un cluster Aurora può essere configurato con più replica in diverse Availability Zone per garantire ridondanza in caso di failover.
Ottimizzazione delle prestazioni in AWS Aurora
Ottimizzare le prestazioni in Amazon Aurora garantisce un'esecuzione efficiente delle query e scalabilità. Vediamo alcune best practice in questa sezione.
Indicizzazione e ottimizzazione delle query
Ottimizzare le prestazioni delle query in Amazon Aurora è fondamentale per mantenere un database ad alte prestazioni.
- L'indicizzazione è uno dei modi più efficaci per ridurre i tempi di esecuzione delle query e migliorare l'efficienza del database.
- Creare indici sulle colonne interrogate più frequentemente aiuta a individuare rapidamente i dati, riducendo al minimo la necessità di full table scan.
- Dovresti usare strategicamente indici primari e secondari in linea con i pattern di query e le esigenze del carico di lavoro.
- Inoltre, puoi usare indici compositi per query che coinvolgono più colonne, migliorando ulteriormente i tempi di ricerca.
- Anche l'ottimizzazione delle query gioca un ruolo significativo nelle prestazioni del database. Scrivere query SQL efficienti fa sì che Aurora elabori le richieste più velocemente con un consumo minimo di risorse.
- L'uso di
EXPLAIN o EXPLAIN ANALYZEnelle query SQL aiuta a identificare i colli di bottiglia e fornisce informazioni sui piani di esecuzione. - Tecniche come evitare
SELECT *(che recupera dati non necessari), normalizzare lo schema del database per ridurre la ridondanza e sfruttare strategie di partizionamento possono portare a guadagni prestazionali. - L'optimizer dei piani di query di Aurora affina continuamente i piani di esecuzione, apportando adeguamenti in base ai pattern di carico del database e migliorando così l'efficienza complessiva.
Uso delle read replica di Aurora
Per gestire carichi di traffico elevati, Amazon Aurora supporta read replica che aiutano a distribuire le query intensive in lettura su più istanze.
Le read replica riducono il carico sull'istanza primaria elaborando separatamente le richieste in lettura, migliorando la reattività e abbassando la latenza.
Per configurare una read replica Aurora, devi selezionare un cluster Aurora esistente e abilitare la replica con una configurazione minima. Aurora sincronizza automaticamente i dati tra l'istanza primaria e le sue replica, garantendo la coerenza dei dati senza interventi manuali.
Il meccanismo di replica di Aurora è altamente efficiente, consentendo una sincronizzazione dei dati quasi in tempo reale con un lag di replica inferiore al secondo.
Applicazioni che eseguono frequenti operazioni di lettura, come dashboard di reportistica o servizi di analytics, possono trarre grande vantaggio dalle read replica indirizzando a queste istanze le query pesanti in lettura.
In caso di guasto dell'istanza primaria, una read replica può essere promossa a nuova istanza primaria con tempi di inattività minimi, garantendo alta disponibilità e continuità operativa.
L'immagine seguente mostra come le replica Aurora cross-region possano aiutare con disaster recovery e alta disponibilità.
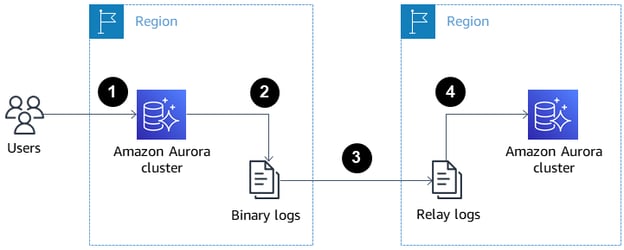
Read replica Aurora cross-region per disaster recovery e alta disponibilità. Fonte: AWS Docs
Strategie di caching per Aurora
Il caching è una tecnica potente per migliorare le prestazioni del database riducendo il carico di query dirette su Aurora. Un layer di cache può velocizzare sensibilmente il recupero dei dati per le query più frequenti.
Amazon ElastiCache, che supporta Redis e Memcached, è comunemente usato insieme ad Aurora per archiviare i risultati delle query ed evitare interrogazioni ridondanti al database.
Integrare il caching nell'architettura applicativa può aiutare a migliorare i tempi di risposta preservando le risorse di calcolo del database.
Strategie di caching come il write-through (in cui i dati vengono scritti sia nella cache che in Aurora simultaneamente) e il lazy loading (in cui i dati vengono messi in cache solo quando richiesti) aiutano a ottimizzare le prestazioni in base ai pattern d'uso.
Configurare un time-to-live (TTL) appropriato per i dati in cache garantisce che la cache rimanga aggiornata e previene il recupero di dati obsoleti.
Sicurezza e conformità in AWS Aurora
Mettere in sicurezza il tuo database Aurora è cruciale per proteggere i dati sensibili e garantire la conformità. Rivediamo le best practice in questa sezione.
Crittografia dei dati
La sicurezza dei dati è fondamentale nella gestione dei database e AWS Aurora offre meccanismi di crittografia robusti per proteggere i dati sensibili.
- Aurora cripta i dati a riposo usando AWS Key Management Service (KMS), garantendo che le informazioni archiviate restino sicure anche se lo storage sottostante viene compromesso.
- Abilitare la crittografia durante la creazione del database assicura che tutti i backup automatici, gli snapshot e le replica ereditino le stesse impostazioni di crittografia.
- Per i dati in transito, Aurora supporta la crittografia SSL/TLS, che mette in sicurezza le connessioni al database e previene accessi non autorizzati o intercettazioni delle trasmissioni dati.
- Le applicazioni che si connettono ad Aurora dovrebbero essere configurate per usare certificati SSL per mantenere la comunicazione sicura.
Queste misure di crittografia possono aiutarti a rispettare le best practice di sicurezza e i requisiti normativi.
L'immagine seguente mostra come AWS KMS si integri con Amazon Aurora per criptare il tuo database.
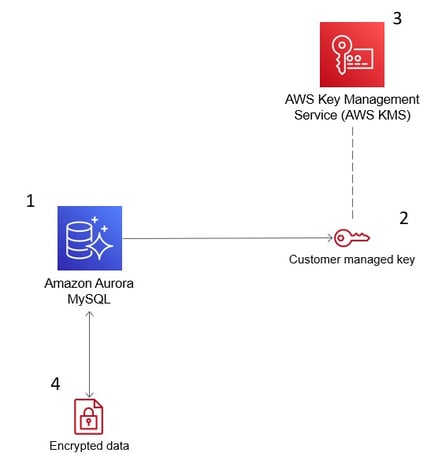
AWS Key Management Service (KMS) cripta i dati in Amazon Aurora per la conformità alla sicurezza. Fonte: AWS Blogs
Integrazione IAM per il controllo degli accessi
Il controllo degli accessi in Aurora è gestito tramite AWS IAM, che permette agli amministratori di definire permessi granulati basati sui ruoli utente.
- Policy IAM possono essere utilizzate per limitare l'accesso alle istanze di database, impedendo a utenti non autorizzati di eseguire operazioni critiche come modifiche ai dati o attività amministrative.
- Autenticazione IAM offre un'alternativa più sicura all'autenticazione tradizionale basata su password. Consente alle applicazioni di connettersi utilizzando credenziali di sicurezza temporanee. Ciò elimina la necessità di archiviare e gestire password del database, riducendo il rischio di esposizione delle credenziali.
Dovresti applicare il principio del minimo privilegio, che riduce i rischi per la sicurezza e mantiene un controllo rigoroso sull'accesso al database.
L'immagine seguente mostra come configurare l'autenticazione IAM per mettere in sicurezza l'accesso al database Amazon Aurora PostgreSQL.
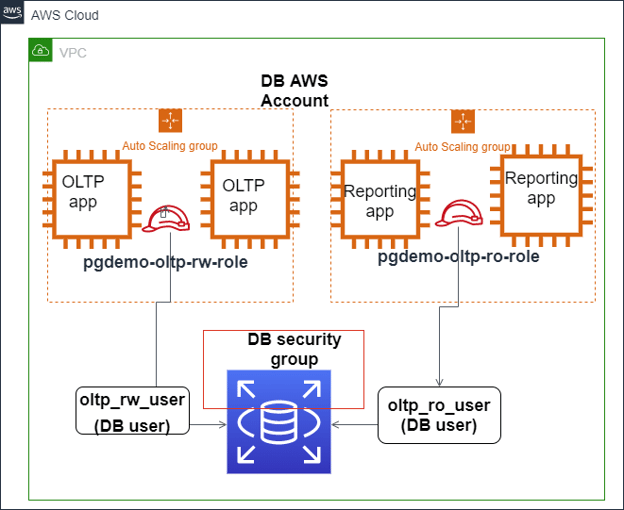
L'autenticazione IAM si integra con Amazon Aurora PostgreSQL. Source: AWS Blogs
Audit con i log di Aurora
Monitorare e fare audit dell'attività del database è essenziale per la conformità alla sicurezza e il troubleshooting.
Aurora fornisce diversi meccanismi di logging, tra cui error log, slow query log e general log, che aiutano gli amministratori a tracciare l'attività del database e identificare potenziali problemi. Questi log possono essere abilitati tramite la AWS Management Console e archiviati in Amazon CloudWatch per un'analisi centralizzata.
- Error log acquisiscono errori e avvisi del motore del database.
- Slow query log aiutano a identificare query inefficienti che possono impattare sulle prestazioni.
Analizzare questi log può aiutare gli amministratori a ottimizzare l'esecuzione delle query, rilevare tentativi di accesso non autorizzati e garantire la stabilità del database.
Gestione e ottimizzazione dei costi in AWS Aurora
Per gestire e ottimizzare efficacemente i costi in Amazon Aurora, devi comprenderne la struttura di prezzo. Rivediamola!
Comprendere il pricing di Aurora
Il modello di pricing di Amazon Aurora si basa su diversi fattori, tra cui ore di istanza, consumo di storage, richieste I/O e trasferimento dati.
A differenza dei database tradizionali che richiedono il provisioning anticipato dell'infrastruttura, il modello pay-as-you-go di Aurora consente alle aziende di pagare solo per le risorse effettivamente utilizzate.
Le istanze di calcolo vengono fatturate in base alla classe di istanza e al tempo di attività, mentre lo storage scala dinamicamente, eliminando la necessità di regolazioni manuali.
L'immagine seguente offre una scomposizione delle diverse componenti di prezzo per Amazon Aurora. Tuttavia, tieni presente che i prezzi possono cambiare, quindi è sempre meglio fare riferimento alla pagina dei prezzi di Aurora per le informazioni più aggiornate.
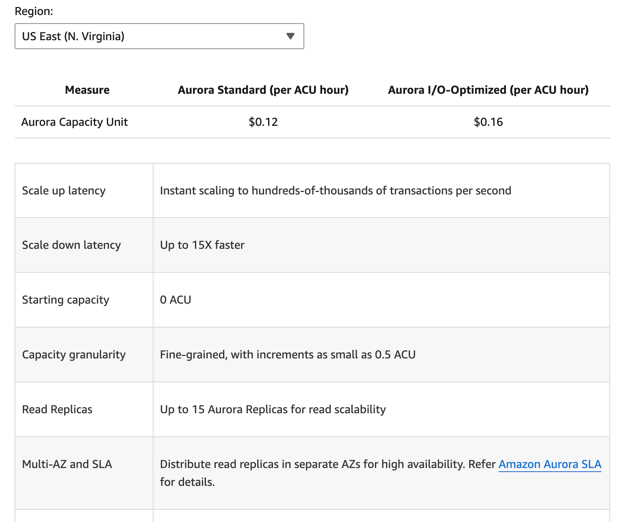
Costi aggiuntivi includono storage per i backup oltre la quota gratuita, richieste I/O di lettura e scrittura e commissioni di trasferimento dati per la replica cross-region.
Comprendere queste componenti di prezzo può aiutarti a prevedere le spese e a prendere decisioni informate sull'uso del database.
Ottimizzare i costi con Aurora
Per gestire efficacemente i costi, le organizzazioni possono implementare diverse strategie di ottimizzazione.
Selezionare la dimensione di istanza appropriata assicura che le risorse del database siano allineate con le esigenze del carico di lavoro senza overprovisioning.
- Se hai un carico prevedibile, usa le Reserved Instances, perché offrono un notevole risparmio rispetto al pricing On-Demand.
- Tecniche di ottimizzazione dello storage, come il monitoraggio di risorse non utilizzate o sottoutilizzate, aiutano a ridurre i costi.
- La funzionalità di auto-scaling di Aurora regola dinamicamente lo storage, prevenendo spese inutili.
- Inoltre, implementare read replica può scaricare le query dall'istanza primaria, riducendo potenzialmente la necessità di istanze di livello superiore.
- Sfrutta Aurora Serverless: è un'altra opzione conveniente per applicazioni con carichi variabili. Aurora Serverless scala automaticamente le risorse di calcolo in base alla domanda, garantendo che le aziende paghino solo per l'uso effettivo anziché mantenere un'istanza sempre attiva.
> Se vuoi approfondire la gestione dei costi, fai riferimento al corso AWS Security and Cost Management.
Conclusione
Dopo aver lavorato con Amazon Aurora in diverse aziende per un bel po' di tempo, posso affermare con sicurezza che è una soluzione di database potente e scalabile che semplifica la gestione senza compromettere le prestazioni—probabilmente sarai d'accordo dopo aver seguito questo tutorial.
Aurora vale la pena di essere considerato se cerchi un database relazionale cloud-native che supporti MySQL e PostgreSQL riducendo al contempo l'overhead operativo. È stato rivoluzionario in alcuni dei miei progetti e consiglio vivamente di esplorarne le capacità se lavori con database AWS.
Se sei nuovo ai database AWS, imparare i concetti fondamentali attraverso corsi come AWS Cloud Practitioner (CLF-C02) può essere utile!
FAQ
Qual è la differenza tra Aurora MySQL e Aurora PostgreSQL?
Aurora MySQL è ottimizzato per applicazioni MySQL, mentre Aurora PostgreSQL supporta funzionalità ed estensioni PostgreSQL.
Come si confronta Aurora con RDS?
Aurora offre prestazioni e scalabilità superiori rispetto a RDS standard per MySQL e PostgreSQL, con fino a cinque volte il throughput di MySQL. È pienamente compatibile con MySQL/PostgreSQL e include funzionalità gestite da AWS come backup automatici, patching e failover.
Posso migrare il mio database MySQL/PostgreSQL esistente ad Aurora?
Sì, AWS Database Migration Service (DMS) supporta la migrazione a Aurora senza interruzioni.
Aurora supporta la replica multi-regione?
Sì, Aurora Global Database consente la replica cross-region a bassa latenza.
Come posso ridurre i costi di Aurora?
Usa Reserved Instances, Aurora Serverless e le read replica per ottimizzare i costi.
Amazon Aurora è serverless?
Sì, Amazon Aurora offre un'opzione serverless chiamata Aurora Serverless, che scala automaticamente verso l'alto o verso il basso in base alla domanda, rendendola ideale per carichi di lavoro imprevedibili.
Quali sono le opzioni di backup e ripristino in Aurora?
Aurora fornisce backup continui automatici su Amazon S3 e supporta snapshot manuali. Puoi ripristinare il database da un punto specifico nel tempo o da uno snapshot secondo necessità.
Posso usare Aurora per un'applicazione ad alta disponibilità?
Sì, Aurora è progettato per l'alta disponibilità con failover automatico, deployment multi-AZ e funzionalità di replica come Aurora Read Replicas e Aurora Global Database.






Dopo aver utilizzato Amazon Aurora per un po' in diverse aziende, ho visto in prima persona come eccella come motore di database relazionale completamente gestito, offrendo alte prestazioni, scalabilità e affidabilità.
Come soluzione cloud-native che supporta MySQL e PostgreSQL, Aurora è un’ottima scelta per le aziende che richiedono alta disponibilità e scaling automatico. Poiché AWS gestisce automaticamente backup, failover e replica, usare Aurora ti permette di aumentare l’efficienza del database riducendo i costi di manutenzione.
In questo tutorial ti guiderò nella configurazione di un'istanza Aurora, nella sua gestione efficiente, nell'ottimizzazione delle prestazioni e nel garantire sicurezza ed economicità.
Che cos'è AWS Aurora?
Amazon Aurora è un database relazionale basato sul cloud che supera i tradizionali MySQL e PostgreSQL scalando dinamicamente le risorse di storage e calcolo.
Secondo AWS, Aurora può offrire fino a cinque volte il throughput del MySQL standard e tre volte le prestazioni del PostgreSQL standard, grazie alla sua architettura distribuita e ad alta disponibilità.
Aurora è costruito con funzionalità come backup automatici, read replica per lo scaling orizzontale e meccanismi di failover che garantiscono tempi di inattività minimi.
Il livello di storage di Aurora è progettato per essere tollerante ai guasti e auto-riparante.
Inoltre, i dati vengono replicati automaticamente tra più Availability Zone (AZ) per garantirne la durabilità.
L'immagine qui sotto offre una panoramica di alto livello dell'architettura e delle caratteristiche principali di Amazon Aurora.
La relazione tra il volume del cluster, l'istanza DB writer e le istanze DB reader in un cluster Aurora. Sorgente: AWS Docs
Il motore del database monitora continuamente le query e ottimizza i piani di esecuzione, con notevoli miglioramenti di efficienza.
Uno dei principali vantaggi di Aurora è la sua compatibilità con i database MySQL e PostgreSQL, che rende facile per le aziende migrare senza dover modificare pesantemente le proprie applicazioni.
Anche la struttura dei costi di Aurora è interessante. La tariffazione si basa sull'uso effettivo delle risorse di calcolo e storage. Questo modello elimina la necessità di overprovisioning dell'infrastruttura, con conseguente risparmio.
> Se ti interessa una visione più ampia delle opzioni di storage AWS, da un'occhiata a questo tutorial su AWS Storage.