
Cursus
Data Engineering begrijpen
2 uur
377.9K
Partities zijn essentiële onderdelen binnen Kafka's gedistribueerde architectuur die horizontale schaalbaarheid mogelijk maken, waardoor efficiënte parallelle gegevensverwerking mogelijk is. Ze vormen de bouwstenen voor het organiseren en distribueren van data over het Kafka-cluster.
Zie ze als afzonderlijke kanalen binnen een topic waarin berichten worden opgeslagen. Elke partitie kan meerdere replica's hebben die over verschillende brokers zijn verspreid, wat fouttolerantie en gegevensredundantie garandeert.
Bovendien bieden partities ordeningsgaranties: berichten binnen een partitie worden verwerkt in de volgorde waarin ze zijn geproduceerd. Dit maakt Kafka-partities cruciaal voor het waarborgen van gegevensintegriteit en consistentie, wat essentieel is voor realtime dataverwerkingssituaties.
In dit artikel gaan we dieper in op het volgende:
Bekijk ook onze vergelijking van Kafka vs SQS voor een uitgebreide gids over hoe de twee tools zich tot elkaar verhouden.
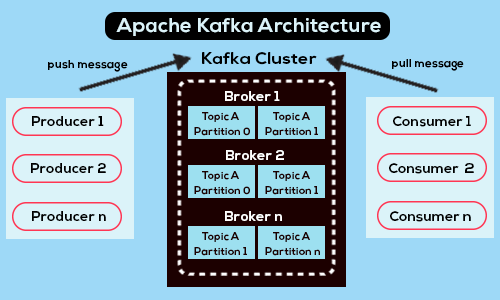
Een overzicht van Kafka’s architectuur - Bron
Apache Kafka is een open-source, gedistribueerd streamingplatform dat is ontworpen voor hoge doorvoer, fouttolerantie en schaalbaarheid. Het is daarmee een populaire keuze voor het bouwen van realtime datapijplijnen en applicaties.
In de kern bestaat Kafka uit meerdere componenten. Deze componenten omvatten producers, consumers, brokers, topics en partities, en elk speelt een cruciale rol in het algehele systeem.
Partities spelen een sleutelrol in de efficiëntie en robuustheid van Kafka. Ze faciliteren datadistributie over Kafka-brokers, waardoor horizontale schaalvergroting mogelijk is.
Door topics in partities te verdelen kan Kafka werkbelasting voor gegevensverwerking over meerdere servers spreiden. Zo worden resources efficiënt benut en kunnen toenemende datavolumes worden opgevangen zonder individuele brokers te overbelasten.
Daarnaast maken partities ook parallellisme in gegevensverwerking mogelijk. Consumers kunnen gelijktijdig uit meerdere partities lezen, waardoor de rekenlast wordt verdeeld en de doorvoer toeneemt. Deze parallelle gegevensconsumptie zorgt voor een efficiënte inzet van consumerresources en verlaagt de latency in dataverwerkingspijplijnen.
Een andere reden waarom partities belangrijk zijn in Kafka, is dat ze bijdragen aan de fouttolerantie van het platform. Elke partitie kan meerdere replica's hebben die over verschillende brokers zijn verdeeld. In het geval van een brokerstoring kan Kafka data blijven leveren vanaf replica's op andere brokers, wat de beschikbaarheid en betrouwbaarheid van data waarborgt.
Kortom, partities zijn om meerdere redenen belangrijk. Ze zijn cruciaal voor Kafka’s architectuur en spelen een sleutelrol bij het mogelijk maken van schaalbaarheid, fouttolerantie, parallellisme en dataconsistentie.
Zoals eerder in het artikel genoemd, fungeert elke partitie als een gesegmenteerde, geordende en onveranderlijke reeks records. Wanneer een producer data naar Kafka stuurt, gebruikt deze partitioneringslogica om te bepalen naar welke partitie binnen een topic de data moet worden geschreven.
Die logica kan gebaseerd zijn op verschillende factoren, zoals een sleutel die aan de data is gekoppeld of een aangepaste partitioner die door de producer is geïmplementeerd. Zodra de partitie is bepaald, voegt Kafka de data achteraan de partitie toe, waarbij de volgorde van berichten op basis van hun offsets behouden blijft.
Intern handelen Kafka-brokers de opslag en replicatie van partitiedata af. Elke partitie kan meerdere replica's hebben die over verschillende brokers zijn verspreid om fouttolerantie te garanderen.
Er wordt een leader-followermodel gebruikt, waarbij één broker optreedt als leader die lees- en schrijfbewerkingen voor de partitie afhandelt, terwijl de andere brokers als followers data van de leader repliceren. Deze opzet waarborgt dataduurzaamheid en beschikbaarheid, zelfs bij brokerstoringen.
Zorg ervoor dat Apache Kafka en Zookeeper zijn geïnstalleerd, geconfigureerd en actief op je lokale machine voordat je een Kafka-partitie instelt. Dit wordt aanbevolen voor optimale compatibiliteit. Controleer ook of Java 8 of een nieuwere versie is geïnstalleerd en werkt.
Let op: Kafka kan op Windows verschillende problemen ondervinden vanwege het ontbreken van native compatibiliteit met dit besturingssysteem. Daarom raden we aan de volgende methoden te gebruiken om Apache Kafka op Windows te starten:
Het gebruiken van de JVM om Kafka op Windows te draaien wordt afgeraden, omdat het bepaalde POSIX-eigenschappen mist die eigen zijn aan Linux. Pogingen om Kafka op Windows te draaien zonder WSL2 kunnen uiteindelijk tot problemen leiden.
Meer over het instellen van Apache Kafka leer je in Apache Kafka for Beginners: A Comprehensive Guide.
Hier is een stapsgewijze handleiding voor het instellen van partities:
Open de opdrachtprompt en navigeer naar de hoofdmap van Kafka. Voer daar de volgende opdracht uit om Zookeeper te starten:
bin/zookeeper-server-start.sh config/zookeeper.propertiesOpen een andere opdrachtprompt en voer de volgende opdracht uit vanuit de hoofdmap van Apache Kafka om Apache Kafka te starten:
.\bin\windows\kafka-server-start.bat .\config\server.propertiesOm een topic met drie partities te maken, start je een nieuwe opdrachtprompt vanuit de hoofdmap van Kafka en voer je de volgende opdracht uit:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic my_topicDit maakt een nieuw Kafka-topic met de naam “my_topic”.
Let op: om te bevestigen dat het correct is aangemaakt, zal het uitvoeren van de opdracht “Create topic <name of topic>.” retourneren
Je kunt verifiëren dat het topic correct is aangemaakt door het volgende uit te voeren:
bin/kafka-topics.sh --list --zookeeper localhost:2181Wat het volgende zou moeten opleveren:
my_topicHet herpartioneren van bestaande topics in Kafka houdt in dat je het aantal partities wijzigt. Dit kan nodig zijn om veranderende datavolumes op te vangen, parallellisme te verbeteren of het resourcegebruik te optimaliseren.
Hier zijn enkele technieken en aandachtspunten voor het herpartioneren van bestaande topics:
kafka-topics.sh --alter om het aantal partities van een bestaand topic te verhogen. Dit zal data over de nieuwe partities herverdelen.Het optimaliseren van partitiegebruik en prestaties in Kafka is essentieel om efficiënte gegevensverwerking, resourcegebruik en algehele systeemschaalbaarheid te garanderen.
Laten we enkele strategieën voor partitiebalancering en optimalisatie bekijken:
Kafka is de ruggengraat geworden van veel data-intensieve applicaties, maar om oom Ben uit Spider-Man te parafraseren: met grote kracht komt een grotere kans op complexe uitdagingen.
Er kunnen de nodige veelvoorkomende partitieproblemen optreden bij het gebruik van Kafka. Dit kan komen door misconfiguraties, resourcebeperkingen, ongelijke dataverdeling of iets anders.
In dit deel gaan we dieper in op de veelvoorkomende partitieproblemen en bespreken we hoe je ze oplost.
Wanneer data ongelijk over partities is verdeeld, kunnen sommige partities hotspots worden, met onevenredig resourcegebruik en mogelijke prestatieknelpunten tot gevolg. De oplossing is om de dataverdeling voortdurend te monitoren, wat kan met Kafka’s monitoringtools zoals Kafka Manager of Confluent Control Center. Overweeg ook een aangepaste partitioneringsstrategie te implementeren of het aantal partities te verhogen om een meer gebalanceerde verdeling te bereiken.
Wanneer een partitie in de loop van de tijd veel data verzamelt, kan dat leiden tot prestatievermindering en hogere latency bij het ophalen en verwerken van data.
De sleutel tot de oplossing is het regelmatig monitoren van de partitiegrootte en grote partities opsplitsen in kleinere om de data gelijkmatiger te verdelen. Daarnaast helpt het om retentiebeleid aan te passen om de hoeveelheid data in partities te beheersen.
Onder-gerepliceerde partities treden op wanneer het aantal in-sync replicas (ISR's) onder het geconfigureerde minimum zakt door brokerstoringen of netwerkproblemen.
Om dit te voorkomen, monitor je de replicatiestatus van partities en onderzoek je alle onder-gerepliceerde partities. Zorg dat de replicatiefactor passend is geconfigureerd om het gewenste niveau van fouttolerantie te behouden. Pak problemen met netwerkconnectiviteit of brokerstoringen snel aan.
Partitie-leaders handelen lees- en schrijfbewerkingen af in een Kafka-cluster. Een onbalans in partitie-leaders over brokers kan leiden tot ongelijk resourcegebruik en mogelijke prestatieproblemen.
Dit kun je voorkomen door de verdeling van partitie-leaders te monitoren met Kafka Manager of Confluent Control Center en zo nodig leaders te herverdelen. Overweeg ook brokerconfiguraties aan te passen om partitie-leaders gelijkmatig over brokers te verdelen.
Partitie-skew ontstaat wanneer bepaalde partities onevenredig veel verkeer ontvangen in vergelijking met andere, wat leidt tot ongelijk resourcegebruik en mogelijke prestatievermindering. Daarom is het belangrijk om verkeerspatronen te analyseren.
Overweeg een aangepaste partitioneringsstrategie te implementeren om data gelijkmatig over partities te verdelen en optimaliseer de configuraties van consumer groups om de werkdruk gelijkmatig over consumers te verdelen.
Apache Kafka is een robuust, gedistribueerd streamingplatform dat de ruggengraat vormt van talloze data-intensieve applicaties. In de kern ligt het concept van partities, de essentiële eenheden voor het organiseren en distribueren van data binnen Kafka-topics. Partities zijn bepalend in Kafka's ecosysteem en maken schaalbaarheid, fouttolerantie, parallellisme en efficiënte gegevensverwerking mogelijk.
Door data over meerdere brokers te verdelen, stellen partities Kafka in staat om grote hoeveelheden data te verwerken met behoud van hoge doorvoer en betrouwbaarheid. Daarnaast faciliteren partities parallelle gegevensverwerking, wat zorgt voor optimaal resourcegebruik en lagere latency.
Uiteindelijk is het begrijpen en effectief beheren van partities cruciaal om de prestaties en betrouwbaarheid van Kafka-clusters te maximaliseren. Zo zijn ze onmisbare componenten bij het bouwen van schaalbare en veerkrachtige realtime datapijplijnen en applicaties.
Hier zijn enkele bronnen om verder te leren:
Blijf leren met DataCamp
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

