50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Voordat we ergens induiken, richten we onze omgeving in voor de tutorial.
Maak eerst een nieuwe Conda-omgeving aan:
$ conda create -n langchain python=3.9 -y
$ conda activate langchain
Installeer de pakketten van LangChain en een paar andere benodigde libraries:
$ pip install langchain langchain_openai langchain_community langgraph ipykernel python-dotenvVoeg de nieuw aangemaakte Conda-omgeving toe aan Jupyter als kernel:
$ ipython kernel install --user --name=langchainMaak een .env-bestand aan om secrets zoals API-sleutels op te slaan:
$ touch .env
$ vim .env # Paste your OPENAI keyOPENAI_API_KEY='YOUR_KEY_HERE'Haal je OpenAI API-sleutel op uit het .env-bestand:
import os
from dotenv import load_dotenv
load_dotenv()
api_key = os.getenv('OPENAI_API_KEY')
Test of alles correct werkt door GPT-3.5 (het standaardtaalmodel) van OpenAI aan te spreken:
from langchain_openai import OpenAI
llm = OpenAI(openai_api_key=api_key)
question = "Is Messi the best footballer of all time?"
output = llm.invoke(question)
print(output[:75])
There is no definitive answer to this question, as it is subjective and deNu kunnen we aan de slag.
Laten we even stilstaan bij het agentframework. We bekijken specifiek hoe het verschilt van het traditionele chain-paradigma en wat de componenten van een agent zijn. Begrijpen waarom we een nieuwe manier van applicatiebouw nodig hebben, bereidt ons voor op het schrijven van de code.
Het onderscheidende kenmerk van agents is hun vermogen om, gegeven een set tools, de beste volgorde van acties te kiezen om een probleem op te lossen.
Stel bijvoorbeeld dat we het volgende hebben:
Traditionele probleemoplossing zou bestaan uit het gebruiken van een keten van geselecteerde tools uit de lijst:
Keten 1: Weergebonden kledingaanbeveler
Keten 2: Weergebonden suggesties voor fietsroutes
Keten 3: Outfitfoto-analyzer
Elke keten lost een specifiek probleem op met een vooraf bepaalde reeks stappen en een subset van de beschikbare tools. Ze kunnen niet buiten hun gedefinieerde scope aanpassen. Ze vereisen bovendien drie afzonderlijke ontwikkeltrajecten, wat inefficiënt is qua tijd en middelen.
Stel je nu een agentisch systeem voor met toegang tot al deze tools. Het zou kunnen:
Als een gebruiker bijvoorbeeld vraagt: “Wat moet ik vandaag aantrekken voor mijn fietstocht?”, dan kan de agent de weer-API checken, geschikte fietsroutes via Strava analyseren, passende kleding aanbevelen rekening houdend met eerdere voorkeuren, en een gepersonaliseerd antwoord genereren.
De agent kan:
LangChains vermogen om taalmodellen—die op zichzelf alleen tekst produceren—te transformeren in redeneermachines die de beschikbare middelen kunnen inzetten om passend te handelen, is een van de belangrijkste toepassingen. Kort gezegd maakt LangChain de ontwikkeling mogelijk van sterke autonome agents die met de buitenwereld interageren.
Een LangChain-agent bestaat uit verschillende componenten, zoals chatmodellen, prompttemplates, externe tools en andere verwante constructen. Om succesvolle agents te bouwen, moeten we elke component doornemen en hun gebruik begrijpen.
Er komt veel kijken bij het bouwen van een LangChain-agent. De eerste en meest voor de hand liggende is een taalmodel.
from langchain_openai import OpenAI
llm = OpenAI(api_key=api_key, model="gpt-3.5-turbo-instruct")
question = "What is special about the number 73?"
output = llm.invoke(question)
print(output[:100])
1. Prime Number: 73 is a prime number, which means it is only divisible by 1 and itself. This makeTaalmodellen, zoals OpenAI’s GPT-3.5 Turbo, nemen strings aan en genereren strings. Het zijn meestal oudere modellen en werken het best voor losse gebruikersvragen.
Nieuwere en krachtigere modellen zijn doorgaans chatmodellen, die een reeks berichten als input kunnen nemen en chatberichten als output teruggeven (in plaats van platte tekst):
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessageChunk, SystemMessage
# Initialize the model
chat_model = ChatOpenAI(api_key=api_key, model='gpt-4o-mini')
# Write the messages
messages = [SystemMessage(content='You are a grumpy pirate.'),
           HumanMessage(content="What's up?")]
output = chat_model.invoke(messages)
Anders gezegd: chatmodellen stellen ons in staat om gesprekken te voeren in natuurlijke taal. In het bovenstaande voorbeeld initialiseren we GPT-4o-mini met een systeembericht, gevolgd door een gebruikersvraag. Let op het gebruik van de klassen SystemMessage en HumanMessage.
De output is een message-object, wat het verwachte gedrag is van chatmodellen:
type(output)langchain_core.messages.ai.AIMessageprint(output.content)Arrr, not much but the sound of waves and the creakin' of me ship. What do ye want? Make it quick, I've got treasure to hunt and rum to drink!Daarnaast geven ze andere nuttige metadata terug die via dot-notatie toegankelijk zijn:
output.dict(){'content': "Arrr, not much but the sound of waves and the creakin' of me ship. What do ye want? Make it quick, I've got treasure to hunt and rum to drink!",
'additional_kwargs': {},
'response_metadata': {'token_usage': {'completion_tokens': 38,
'prompt_tokens': 21,
'total_tokens': 59},
'model_name': 'gpt-4o-mini-2024-07-18',
'system_fingerprint': 'fp_48196bc67a',
'finish_reason': 'stop',
'logprobs': None},
'type': 'ai',
'name': None,
'id': 'run-fde829bf-8f5f-4926-a1ed-ab53609ce03a-0',
'example': False,
'tool_calls': [],
'invalid_tool_calls': [],
'usage_metadata': {'input_tokens': 21,
'output_tokens': 38,
'total_tokens': 59}}De meeste agents gebruiken chatmodellen vanwege hun up-to-date kennisbasis en conversatievaardigheden. Maar voor eenvoudige agents zonder geheugenvereisten volstaan taalmodellen zoals GPT-3.5.
De efficiëntste manier om taal- of chatmodellen te bevragen is met prompttemplates. Die laten je je vragen consistent structureren en dynamisch variabelen invoegen, waardoor je interacties met het model flexibeler en herbruikbaarder worden.
In LangChain zijn er veel soorten prompttemplates, waarvan de meest basale de klasse PromptTemplate is. Deze kan worden gebruikt met taalmodellen (platte tekst):
from langchain_core.prompts import PromptTemplate
query_template = "Tell me about {book_name} by {author}."
prompt = PromptTemplate(input_variables=["book_name", "author"], template=query_template)
prompt.invoke({"book_name": "Song of Ice and Fire", "author": "GRRM"})
StringPromptValue(text='Tell me about Song of Ice and Fire by GRRM.')De klasse vereist dat je een string maakt met placeholders voor variabelen die je wilt vervangen met bracketnotatie. Daarna geef je deze templatestring door aan de klasse PromptTemplate samen met de namen van de variabelen, waarmee je je prompt construeert.
Aanroepen van .invoke() met waarden voor variabelen laat zien hoe je prompt naar een model wordt gestuurd.
Deze prompttemplate doorgeven aan een taalmodel vereist dat we hem chainen met de pipe-operator:
from langchain_openai import OpenAI
llm = OpenAI(api_key=api_key)
# Create a chain
chain = prompt | llm
# Invoke the chain
output = chain.invoke({"book_name": "Deathly Hallows", "author": "J.K. Rowling"})
print(output[:100])
Deathly Hallows is the seventh and final book in the popular Harry Potter series, written by J.K. RDe pipe-operator (|) maakt deel uit van de LangChain Expression Language (LCEL), ontworpen om meerdere LangChain-componenten en -tools te ketenen.
type(chain)langchain_core.runnables.base.RunnableSequenceAls je de pipe-operator gebruikt op LangChain-objecten, maak je een instantie van de klasse RunnableSequence. Een runnable sequence vertegenwoordigt een keten van objecten die de methode .invoke() ondersteunen, zoals prompttemplates en taal-/chatmodellen.
Laten we nu een andere prompttemplateklasse voor chatmodellen bekijken:
from langchain_core.prompts import ChatPromptTemplateWe noemden dat chatmodellen een reeks berichten als input vereisen. De eerste input is meestal een systeemprompt die het gedrag van het chatmodel bepaalt. Met de klasse ChatPromptTemplate kunnen we eenvoudig chatmodellen met verschillende persoonlijkheden maken:
chat_model = ChatOpenAI(api_key=api_key, model="gpt-4o-mini")
template = ChatPromptTemplate([
   ('system', 'You are a helpful AI bot. Your specialty is {specialty}.'),
   ('human', 'Explain the concept of {concept} based on your expertise.')
])
De klasse verwacht een lijst met rolegebaseerde berichten als input. Elk lid van de lijst moet een (rol, bericht)-tuple zijn met waar nodig gedefinieerde variabele placeholders.
Als dit klaar is, kunnen we met dezelfde pipe-operator chatmodellen met verschillende gedrag maken:
specialties = ["psychology", "economics", "politics"]
concept = "time"
# Call the model with different personalities
for s in specialties:
   chain = template | chat_model
   output = chain.invoke({"specialty": s, "concept": concept})
   print(output.content[:100], end="\n" + "-" * 25 + '\n')
Time is a complex and multifaceted concept that has been explored from various perspectives, includi
-------------------------
In economics, the concept of time is multifaceted and plays a crucial role in various theories and m
-------------------------
While my primary focus is on politics, I can provide a brief overview of the concept of time as it m
-------------------------Eerder noemden we dat agents een combinatie van hun beschikbare tools kunnen kiezen om een bepaald probleem op te lossen, met LLM’s als redeneermotor onder de motorkap.
LangChain biedt integraties met tientallen populaire API’s en services zodat agents met de rest van de wereld kunnen interageren. De meeste daarvan zijn beschikbaar in het pakket langchain_community, terwijl sommige in langchain_core zitten.
Hier is bijvoorbeeld hoe je de ArXiv-tool kunt gebruiken om samenvattingen van papers over verschillende onderwerpen op te halen:
!pip install -Uq arxiv # Install arXiv Python SDKfrom langchain_community.tools import ArxivQueryRun
tool = ArxivQueryRun()
print(tool.invoke('Photosynthesis')[:250])Published: 2019-08-28
Title: Photosynthesis on Exoplanets and Exomoons from Reflected Light
Authors: Manasvi Lingam, Abraham Loeb
Summary: Photosynthesis offers a convenient means of sustaining biospheres. We
quantify the constraints for photosynthesEr is een alternatieve manier om tools te laden in plaats van ze op klassennaam te importeren:
from langchain_community.agent_toolkits.load_tools import load_tools
tools = load_tools(["arxiv", "dalle-image-generator"])
Hierboven laden we tegelijkertijd zowel de arXiv- als de Dall-E-afbeeldingsgenerator-tools met de functie load_tools(). Tools die met deze functie geladen zijn, hebben dezelfde gebruikssyntaxis:
# Call arXiv
print(tools[0].invoke("Kaggle")[:150])
Published: 2020-06-06
Title: StackOverflow vs Kaggle: A Study of Developer Discussions About Data Science
Authors: David Hin
Summary: Software develop# Generate an image with DallE
output_image_url = tools[1].invoke("A magnificent chain in a cartoon.")
output_image_url'https://oaidalleapiprodscus.blob.core.windows.net/...'
De functie load_tools vereist dat je de stringnamen van toolklassen kent, zoals in het voorbeeld van ArxivQueryRun versus 'arxiv'. Je kunt de stringnaam van een tool snel checken met de functie get_all_tool_names:
from langchain_community.agent_toolkits.load_tools import get_all_tool_names
get_all_tool_names()[:10]
['sleep',
'wolfram-alpha',
'google-search',
'google-search-results-json',
'searx-search-results-json',
'bing-search',
'metaphor-search',
'ddg-search',
'google-lens',
'google-serper']Let op dat load_tools() slechts een shorthand is. Bij het bouwen van agents is het aan te raden tools te laden via hun class constructor, zodat je ze kunt configureren op basis van hun specifieke gedrag.
Tot slot bekijken we in deze sectie hoe je stap voor stap LangChain-agents maakt met de kennis uit de vorige secties.
In de komende voorbeelden bouwen we een agent die elk onderwerp kan uitleggen via drie media: tekst, beeld of video. Concreter: op basis van de gestelde vraag beslist de agent in welk formaat het onderwerp wordt uitgelegd.
Laten we beginnen. Vergeet niet te bekijken hoe je de omgeving instelt; dat staat aan het begin van het artikel.
De eerste stap na het configureren van onze omgeving is het definiëren van de tools die we aan onze agent geven. Laten we ze importeren:
from langchain_community.tools import WikipediaQueryRun  # pip install wikipedia
from langchain_community.utilities import WikipediaAPIWrapper
from langchain_community.tools import YouTubeSearchTool  # pip install youtube_search
from langchain_community.tools.openai_dalle_image_generation import (
   OpenAIDALLEImageGenerationTool
)
from langchain_community.utilities.dalle_image_generator import DallEAPIWrapper
We importeren vijf klassen:
WikipediaAPIWrapper: om te configureren hoe je de Wikipedia-API benadertWikipediaQueryRun: om Wikipedia-paginasamenvattingen te genererenYouTubeSearchTool: om YouTube-video’s over onderwerpen te zoekenDallEAPIWrapper: om te configureren hoe je OpenAI’s DallE-endpoint benadertOpenAIDALLEImageGenerationTool: om afbeeldingen te genereren met promptsWanneer een gebruiker onze agent bevraagt, beslist die of het onderwerp wordt uitgelegd met een Wikipedia-artikel in tekstvorm, door een afbeelding te maken met Dall-E voor visueel begrip, of door YouTube-video’s aan te bevelen voor diepere uitleg.
Laten we ze initialiseren, te beginnen met de Wikipedia-tool:
wiki_api_wrapper = WikipediaAPIWrapper(top_k_results=1, doc_content_chars_max=250)
wikipedia = WikipediaQueryRun(description="A tool to explain things in text format. Use this tool if you think the user’s asked concept is best explained through text.", api_wrapper=wiki_api_wrapper)
print(wikipedia.invoke("Mobius strip"))
Page: Möbius strip
Summary: In mathematics, a Möbius strip, Möbius band, or Möbius loop is a surface that can be formed by attaching the ends of a strip of paper together with a half-twist. As a mathematical object, it was discovered by Johann BenediDallE-afbeeldingsgenerator:
dalle_api_wrapper = DallEAPIWrapper(model="dall-e-3", size="1792x1024")
dalle = OpenAIDALLEImageGenerationTool(
   api_wrapper=dalle_api_wrapper, description="A tool to generate images. Use this tool if you think the user’s asked concept is best explained through an image."
)
output = dalle.invoke("A mountain bike illustration.")
print(output)
YouTube-zoektool:
youtube = YouTubeSearchTool(
   description="A tool to search YouTube videos. Use this tool if you think the user’s asked concept can be best explained by watching a video."
)
youtube.run("Oiling a bike's chain")
"['https://www.youtube.com/watch?v=X1Vze17bhgk&pp=ygUVT2lsaW5nIGEgYmlrZSdzIGNoYWlu', 'https://www.youtube.com/watch?v=T6xyn1FGHiU&pp=ygUVT2lsaW5nIGEgYmlrZSdzIGNoYWlu']"Let extra op de toolbeschrijvingen. De agent beslist op basis van jouw beschrijving welke ene tool hij gebruikt.
We stoppen de tools nu in een lijst:
tools = [wikipedia, dalle, youtube]We kunnen deze set tools nu al aan een chatmodel binden zonder een agent te maken:
chat_model = ChatOpenAI(api_key=api_key)
model_with_tools = chat_model.bind_tools(tools)
Laten we het model met een eenvoudig bericht aanroepen:
response = model_with_tools.invoke([HumanMessage("What's up?!")])
print(f"Text response: {response.content}")
print(f"Tools used in the response: {response.tool_calls}")
Text response: Hello! How can I assist you today?
Tools used in the response: []De output laat zien dat geen van de gebonden tools is gebruikt bij het genereren van een antwoord. Laten we nu een specifieke vraag stellen die het model dwingt verder te kijken dan zijn trainingsdata:
response = model_with_tools.invoke([
   HumanMessage("Can you generate an image of a mountain bike?")
])
print(f"Text response: {response.content}")
print(f"Tools used in the response: {response.tool_calls}")
Text response:
Tools used in the response: [{'name': 'openai_dalle', 'args': {'query': 'mountain bike'}, 'id': 'call_92GBfmsYtPi9TpGuIOFB1pG8', 'type': 'tool_call'}]We zien dat er geen tekstoutput is, maar OpenAI’s DallE wordt genoemd. De tool is nog niet aangeroepen; het model suggereert alleen om hem te gebruiken. Om hem echt aan te roepen—om te handelen—moeten we een agent maken.
Na het definiëren van het model en de tools maken we de agent. LangChain biedt een high-level interface create_react_agent() vanuit het pakket langgraph om snel ReAct (reason and act) agents te maken:
from langgraph.prebuilt import create_react_agent
system_prompt = SystemMessage("You are a helpful bot named Chandler.")
agent = create_react_agent(chat_model, tools, state_modifier=system_prompt)
Bij het initialiseren van de agent met een chatmodel en een lijst tools geven we een systeemprompt mee om het algemene gedrag te sturen. Hij is nu klaar om vragen te accepteren:
from pprint import pprint
response = agent.invoke({"messages": HumanMessage("What's up?")})
pprint(response["messages"])
[HumanMessage(content="What's up?", id='133b9380-cfe1-495a-98f7-b835c874bd57'),
AIMessage(content='Hello! How can I assist you today?', response_metadata={'token_usage': {'completion_tokens': 10, 'prompt_tokens': 112, 'total_tokens': 122}, 'model_name': 'gpt-3.5-turbo-0125', 'system_fingerprint': None, 'finish_reason': 'stop', 'logprobs': None}, id='run-0a920c15-39b4-4857-ab51-6ea905575dba-0', usage_metadata={'input_tokens': 112, 'output_tokens': 10, 'total_tokens': 122})]We kregen een logisch antwoord: een eenvoudig tekstantwoord zonder toolaanroepen. Laten we nu iets gerichter vragen:
response = agent.invoke({"messages": [
   HumanMessage('Explain how photosynthesis works.')
]})
print(len(response['messages']))4Dit keer zijn er vier berichten. Laten we de klassenamen en hun inhoud bekijken:
for message in response['messages']:
   print(
       f"{message.__class__.__name__}: {message.content}"
   )  # Print message class name and its content
   print("-" * 20, end="\n")
HumanMessage: Explain how photosynthesis works.
--------------------
AIMessage:
--------------------
ToolMessage: Page: Photosynthesis
Summary: Photosynthesis ( FOH-tə-SINTH-ə-sis) is a system of biological processes by which photosynthetic organisms, such as most plants, algae, and cyanobacteria, convert light energy, typically from sunlight, into the chemical
--------------------
AIMessage: Photosynthesis is a biological process where photosynthetic organisms like plants, algae, and cyanobacteria convert light energy, usually from sunlight, into chemical energy. This process involves capturing light energy through pigments like chlorophyll in plant cells and using it to convert carbon dioxide and water into glucose and oxygen. Glucose serves as a source of energy for the plant, while oxygen is released into the atmosphere as a byproduct. Photosynthesis is crucial for the survival of plants and the balance of oxygen and carbon dioxide in the atmosphere.
--------------------Kijk, daar is het! Het derde bericht komt van een toolaanroep: een samenvatting van een Wikipedia-pagina over fotosynthese. Het laatste bericht is van het chatmodel, dat de inhoud van de toolaanroep gebruikt om zijn antwoord te construeren.
Laten we snel een functie maken om de laatste stappen te modulariseren:
def execute(agent, query):
   response = agent.invoke({'messages': [HumanMessage(query)]})

   for message in response['messages']:
       print(
           f"{message.__class__.__name__}: {message.content}"
       )  # Print message class name and its content

       print("-" * 20, end="\n")

return responseWe werken onze systeemprompt bij met gedetailleerde instructies over hoe de agent zich moet gedragen:
system_prompt = SystemMessage(
   """
   You are a helpful bot named Chandler. Your task is to explain topics
   asked by the user via three mediums: text, image or video.

   If the asked topic is best explained in text format, use the Wikipedia tool.
   If the topic is best explained by showing a picture of it, generate an image
   of the topic using Dall-E image generator and print the image URL.
   Finally, if video is the best medium to explain the topic, conduct a YouTube search on it
   and return found video links.
   """
)
We maken onze agent opnieuw aan met de nieuwe systeemprompt:
agent = create_react_agent(chat_model, tools, state_modifier=system_prompt)
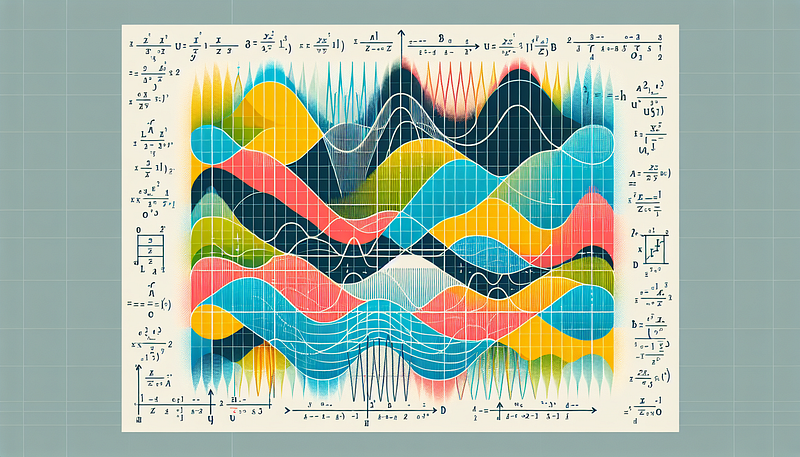
response = execute(agent, query='Explain the Fourier Series visually.')
HumanMessage: Explain the Fourier Series visually.
--------------------
AIMessage:
--------------------
ToolMessage: https://oaidalleapiprodscus.blob.core.windows.net/private/org-qRwX4bsgcnaYHHwbxFBdZxUy/user-LOXQPflMtXxamV72hac9oS2O/img-iY3gXXBzWapRWKdmkd9cXEIN.png?st=2024-08-09T18%3A36%3A46Z&se=2024-08-09T20%3A36%3A46Z&sp=r&sv=2024-08-04&sr=b&rscd=inline&rsct=image/png&skoid=d505667d-d6c1-4a0a-bac7-5c84a87759f8&sktid=a48cca56-e6da-484e-a814-9c849652bcb3&skt=2024-08-09T17%3A56%3A46Z&ske=2024-08-10T17%3A56%3A46Z&sks=b&skv=2024-08-04&sig=Ly8F4jvakFeEtpZ/6jMliLq%2BG3Xs%2Bz1AmX1sL06%2BQ3U%3D
--------------------
AIMessage: Here is a visual representation of the Fourier Series:

The Fourier Series is a way to represent a function as the sum of simple sine waves. It is used in many areas of mathematics and physics to analyze and understand periodic phenomena.
--------------------Top: op basis van onze boodschap (die erg instructief was :) koos de agent de juiste tool voor de klus. Hier is de gegenereerde afbeelding:
Op dit moment is onze agent stateless, wat betekent dat hij eerdere interacties niet onthoudt:
response = execute(agent, query="What did I ask you in the previous query?")HumanMessage: What did I ask you in the previous query?
--------------------
AIMessage: I'm sorry, I cannot remember the previous query as I don't have access to the conversation history. How can I assist you today?
--------------------De makkelijkste manier om chatgeschiedenis toe te voegen aan agents is met de klasse langgraph’s SqliteSaver:
from langgraph.checkpoint.sqlite import SqliteSaver
memory = SqliteSaver.from_conn_string(':agent_history:')
agent = create_react_agent(chat_model, tools, checkpointer=memory, state_modifier=system_prompt)
We initialiseren het geheugen met de methode .from_conn_string() van de klasse SqliteSaver, die een databasebestand aanmaakt. Vervolgens geven we het memory door aan de parameter checkpointer van de functie create_react_agent().
Nu maken we een configuratiewoordenboek:
config = {'configurable': {'thread_id': 'a1b2c3'}}Dit woordenboek definieert een thread-ID om één gesprek van een ander te onderscheiden en wordt doorgegeven aan de methode .invoke() van onze agent. We updaten dus onze functie execute() hiermee:
def execute(agent, query, thread_id="a1b2c3"):
   config = {"configurable": {"thread_id": thread_id}}
   response = agent.invoke({'messages': [HumanMessage(query)]}, config=config)
   for message in response["messages"]:
       print(
           f"{message.__class__.__name__}: {message.content}"
       )  # Print message class name and its content
       print("-" * 20, end="\n")
   return response
Let’s test it again:
response = execute(
   agent, query="Explain how to oil a bike's chain using a YouTube video", thread_id="123"
)
HumanMessage: Explain how to oil a bike's chain using a YouTube video
--------------------
AIMessage:
--------------------
ToolMessage: ['https://www.youtube.com/watch?v=X1Vze17bhgk&pp=ygUXaG93IHRvIG9pbCBhIGJpa2UgY2hhaW4%3D', 'https://www.youtube.com/watch?v=ubKCHtZ20-0&pp=ygUXaG93IHRvIG9pbCBhIGJpa2UgY2hhaW4%3D']
--------------------
AIMessage: I found a couple of YouTube videos that explain how to oil a bike chain:
1. [Video 1: How to oil a bike chain](https://www.youtube.com/watch?v=X1Vze17bhgk&pp=ygUXaG93IHRvIG9pbCBhIGJpa2UgY2hhaW4%3D)
2. [Video 2: Step-by-step guide on oiling a bike chain](https://www.youtube.com/watch?v=ubKCHtZ20-0&pp=ygUXaG93IHRvIG9pbCBhIGJpa2UgY2hhaW4%3D)
You can watch these videos to learn how to oil your bike's chain effectively.
--------------------Laten we de agent nu vragen naar eerdere vragen:
response = execute(agent, query='What have I asked you so far?', thread_id='123')
print(response)
{'messages': [HumanMessage(content="Explain how to oil a bike's chain using a YouTube video", id='8254142b-fb77-4958-8ad9-0a0283c6611a'), ...
]Zoals verwacht geeft de agent de eerdere berichten terug! Nu hebben we alleen nog een chat-UI zoals die van ChatGPT nodig en dan hebben we onze eigen chatbot.
Door het artikel heen zagen we waar LangChain heengaat op het gebied van agents. Tot voor kort werd vooral de klasse AgentExecutor gebruikt, maar die wordt langzaam vervangen door langgraph-agents.
Pure LangChain-agents zijn prima om te starten, maar ze vereisen meer code om dezelfde agent te bouwen dan in LangGraph. En na een bepaald punt biedt het AgentExecutor-framework niet de flexibiliteit die LangGraph heeft voor het bouwen van complexe multi-tool-agents.
Daarom is dit een goed moment om op de golf mee te gaan en direct met LangGraph te beginnen.
We raden ook sterk aan om LangSmith te gebruiken, dat een kernonderdeel is geworden van het LangChain-ecosysteem voor het bouwen van production-grade LLM-applicaties. Enkele belangrijke voordelen:
Zo start je met LangSmith:
export LANGCHAIN_TRACING_V2="true"
export LANGCHAIN_API_KEY="..."
en je bent klaar! Zodra je taal-/chatmodellen begint te bevragen, begint LangSmith allerlei metrics over elke run te loggen:
In dit artikel hebben we onderzocht wat LangChain-agents onderscheidt van chains en welke belangrijke bouwstenen worden gebruikt om ze te construeren. We introduceerden eerst wat agents zijn en hoe ze verschillen van de meer traditionele chain-constructen qua flexibiliteit en het kunnen nemen van beslissingen.
Daarna bekeken we de kerncomponenten die je moet kennen om een agent te bouwen: chatmodellen, tools en prompttemplates. Tot slot liepen we twee voorbeelden door die laten zien hoe je eenvoudige en geavanceerde agents bouwt. Natural language processing ontwikkelt zich voortdurend, en LangChain-agents lopen voorop in deze evolutie en effenen het pad voor een nog intelligenter en veelzijdiger familie van AI.
Hier zijn enkele gerelateerde resources om je LangChain-kennis te vergroten:
Bedankt voor het lezen!
Top DataCamp LLM-cursussen
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min