
कोर्स
Google ADK के साथ AI एजेंट बनाना
1 घंटा
7.6K
किसी भी चीज़ में जाने से पहले, आइए ट्यूटोरियल के लिए अपना वातावरण सेट करें।
सबसे पहले, नया Conda वातावरण बनाना:
$ conda create -n langchain python=3.9 -y
$ conda activate langchain
LangChain के पैकेज और कुछ अन्य आवश्यक लाइब्रेरियाँ इंस्टॉल करना:
$ pip install langchain langchain_openai langchain_community langgraph ipykernel python-dotenvनए बनाए गए Conda वातावरण को Jupyter में एक कर्नेल के रूप में जोड़ना:
$ ipython kernel install --user --name=langchainसीक्रेट्स जैसे API keys स्टोर करने के लिए एक .env फ़ाइल बनाना:
$ touch .env
$ vim .env # Paste your OPENAI keyOPENAI_API_KEY='YOUR_KEY_HERE'अपनी OpenAI API key को .env फ़ाइल से प्राप्त करना:
import os
from dotenv import load_dotenv
load_dotenv()
api_key = os.getenv('OPENAI_API_KEY')
यह जाँचना कि सब कुछ सही ढंग से काम कर रहा है, OpenAI के GPT-3.5 (डिफ़ॉल्ट भाषा मॉडल) से क्वेरी करके:
from langchain_openai import OpenAI
llm = OpenAI(openai_api_key=api_key)
question = "Is Messi the best footballer of all time?"
output = llm.invoke(question)
print(output[:75])
There is no definitive answer to this question, as it is subjective and deअब, हम शुरू करने के लिए तैयार हैं।
आइए कुछ समय एजेंट फ्रेमवर्क के बारे में सोचते हैं। विशेष रूप से, हम यह देखेंगे कि यह पारंपरिक चेन पैरेडाइम से कैसे भिन्न है और एक एजेंट के घटक क्या हैं। यह समझना कि हमें एप्लिकेशन बनाने का नया तरीका क्यों चुनना चाहिए, कोड लिखने के लिए हमें तैयार करेगा।
एजेंट्स की परिभाषित विशेषता यह है कि वे दिए गए टूल्स के सेट के आधार पर किसी समस्या को सुलझाने के लिए कार्यों के सर्वोत्तम क्रम का चयन कर सकते हैं।
उदाहरण के लिए, मान लें कि हमारे पास निम्नलिखित हैं:
पारंपरिक समस्या-समाधान में सूची में से चुनिंदा टूल्स की एक चेन का उपयोग शामिल होगा:
चेन 1: मौसम-आधारित कपड़े सुझाने वाला
चेन 2: मौसम-आधारित साइकिल रूट सुझावक
चेन 3: आउटफिट फोटो एनालाइज़र
प्रत्येक चेन उपलब्ध टूल्स के उप-समुच्चय और पूर्वनिर्धारित चरणों की श्रृंखला का उपयोग करके एक विशिष्ट समस्या हल करती है। वे अपनी परिभाषित सीमा से परे अनुकूलित नहीं हो सकतीं। इन्हें अलग-अलग तीन विकास शाखाओं की आवश्यकता भी होती है, जो समय और संसाधनों की दृष्टि से अक्षम है।
अब, कल्पना कीजिए कि एक एजेंटिक सिस्टम को इन सभी टूल्स तक पहुँच हो। यह सक्षम होगा:
उदाहरण के लिए, यदि कोई उपयोगकर्ता पूछता है, “आज की मेरी बाइक राइड के लिए मुझे क्या पहनना चाहिए?” तो एजेंट मौसम API की जाँच कर सकता है, Strava के माध्यम से उपयुक्त साइक्लिंग रूट्स का विश्लेषण कर सकता है, उपयोगकर्ता की पिछली वरीयताओं को ध्यान में रखते हुए उपयुक्त कपड़े सुझा सकता है, और एक वैयक्तिक उत्तर तैयार कर सकता है।
एजेंट यह कर सकता है:
LangChain की क्षमता भाषा मॉडलों—जो अपने आप में केवल टेक्स्ट उत्पन्न करते हैं—को ऐसे तर्क इंजन में बदलने की, जो अपने पास उपलब्ध संसाधनों का उपयोग कर उपयुक्त कार्रवाई कर सकें, इसकी प्रमुख उपयोगिताओं में से एक है। संक्षेप में, LangChain बाहरी दुनिया के साथ इंटरैक्ट करने वाले सशक्त स्वायत्त एजेंट्स के विकास को सक्षम करता है।
एक LangChain एजेंट कई घटकों से बना होता है, जैसे चैट मॉडल्स, प्रॉम्प्ट टेम्पलेट्स, बाहरी टूल्स, और अन्य संबंधित कॉन्स्ट्रक्ट्स। सफल एजेंट बनाने के लिए, हमें प्रत्येक घटक की समीक्षा करनी और उनके उपयोग को समझना होगा।
LangChain एजेंट बनाने में कई गतिमान हिस्से शामिल होते हैं। पहला और सबसे स्पष्ट है एक भाषा मॉडल।
from langchain_openai import OpenAI
llm = OpenAI(api_key=api_key, model="gpt-3.5-turbo-instruct")
question = "What is special about the number 73?"
output = llm.invoke(question)
print(output[:100])
1. Prime Number: 73 is a prime number, which means it is only divisible by 1 and itself. This makeभाषा मॉडल, जैसे OpenAI का GPT-3.5 Turbo, स्ट्रिंग्स लेते और जनरेट करते हैं। वे आमतौर पर पुराने होते हैं और व्यक्तिगत उपयोगकर्ता क्वेरियों का उत्तर देने में बेहतर काम करते हैं।
नए और अधिक शक्तिशाली मॉडल आमतौर पर चैट मॉडल होते हैं, जो संदेशों के अनुक्रम को इनपुट के रूप में ले सकते हैं और आउटपुट के रूप में चैट संदेश लौटाते हैं (सादा टेक्स्ट के स्थान पर):
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessageChunk, SystemMessage
# Initialize the model
chat_model = ChatOpenAI(api_key=api_key, model='gpt-4o-mini')
# Write the messages
messages = [SystemMessage(content='You are a grumpy pirate.'),
           HumanMessage(content="What's up?")]
output = chat_model.invoke(messages)
दूसरे शब्दों में, चैट मॉडल हमें प्राकृतिक भाषा में बातचीत करने देते हैं। ऊपर के उदाहरण में, हम GPT-4o-mini को एक सिस्टम संदेश के साथ इनिशियलाइज़ कर रहे हैं, जिसके बाद उपयोगकर्ता की क्वेरी है। ध्यान दें SystemMessage और HumanMessage क्लासेस के उपयोग पर।
output एक संदेश ऑब्जेक्ट होता है, जो चैट मॉडलों का अपेक्षित व्यवहार है:
type(output)langchain_core.messages.ai.AIMessageprint(output.content)Arrr, not much but the sound of waves and the creakin' of me ship. What do ye want? Make it quick, I've got treasure to hunt and rum to drink!इसके अलावा, वे अन्य उपयोगी मेटाडेटा भी लौटाते हैं जिन्हें डॉट-नोटेशन से एक्सेस किया जा सकता है:
output.dict(){'content': "Arrr, not much but the sound of waves and the creakin' of me ship. What do ye want? Make it quick, I've got treasure to hunt and rum to drink!",
'additional_kwargs': {},
'response_metadata': {'token_usage': {'completion_tokens': 38,
'prompt_tokens': 21,
'total_tokens': 59},
'model_name': 'gpt-4o-mini-2024-07-18',
'system_fingerprint': 'fp_48196bc67a',
'finish_reason': 'stop',
'logprobs': None},
'type': 'ai',
'name': None,
'id': 'run-fde829bf-8f5f-4926-a1ed-ab53609ce03a-0',
'example': False,
'tool_calls': [],
'invalid_tool_calls': [],
'usage_metadata': {'input_tokens': 21,
'output_tokens': 38,
'total_tokens': 59}}अधिकांश एजेंट अपडेटेड नॉलेज बेस और वार्तालाप क्षमताओं के कारण चैट मॉडल का उपयोग करते हैं। हालाँकि, मेमोरी आवश्यकताओं के बिना सरल एजेंट्स के लिए GPT-3.5 जैसे भाषा मॉडल पर्याप्त होंगे।
भाषा या चैट मॉडल्स को क्वेरी करने का सबसे कुशल तरीका प्रॉम्प्ट टेम्पलेट्स का उपयोग करना है। वे आपको अपनी क्वेरियों को लगातार संरचित करने और वेरिएबल्स को डायनेमिक रूप से इंसर्ट करने देते हैं, जिससे मॉडल के साथ आपकी इंटरैक्शन्स अधिक लचीली और पुन: प्रयोज्य बनती हैं।
LangChain में, प्रॉम्प्ट टेम्पलेट्स के कई प्रकार हैं, जिनमें सबसे बुनियादी है PromptTemplate क्लास। इसे भाषा (सादा टेक्स्ट) मॉडलों के साथ इस्तेमाल किया जा सकता है:
from langchain_core.prompts import PromptTemplate
query_template = "Tell me about {book_name} by {author}."
prompt = PromptTemplate(input_variables=["book_name", "author"], template=query_template)
prompt.invoke({"book_name": "Song of Ice and Fire", "author": "GRRM"})
StringPromptValue(text='Tell me about Song of Ice and Fire by GRRM.')यह क्लास आपसे एक स्ट्रिंग बनाने की मांग करती है जिसमें उन वेरिएबल्स के लिए प्लेसहोल्डर्स हों जिन्हें आप ब्रैकेट नोटेशन से बदलना चाहते हैं। फिर, आपको इस टेम्पलेट स्ट्रिंग को PromptTemplate क्लास में वेरिएबल्स के नामों के साथ पास करना होता है, जिससे आपका prompt निर्मित होता है।
वेरिएबल्स के मानों के साथ .invoke() कॉल करने पर दिखेगा कि आपका प्रॉम्प्ट मॉडल को कैसे पास होगा।
इस प्रॉम्प्ट टेम्पलेट को भाषा मॉडल में पास करने के लिए हमें पाइप ऑपरेटर का उपयोग करके इसे चेन करना होगा:
from langchain_openai import OpenAI
llm = OpenAI(api_key=api_key)
# Create a chain
chain = prompt | llm
# Invoke the chain
output = chain.invoke({"book_name": "Deathly Hallows", "author": "J.K. Rowling"})
print(output[:100])
Deathly Hallows is the seventh and final book in the popular Harry Potter series, written by J.K. Rपाइप ऑपरेटर (|) का हिस्सा है LangChain Expression Language (LCEL), जिसे कई LangChain कॉम्पोनेंट्स और टूल्स को चेन करने के लिए डिज़ाइन किया गया है।
type(chain)langchain_core.runnables.base.RunnableSequenceजब आप LangChain ऑब्जेक्ट्स पर पाइप ऑपरेटर का उपयोग करते हैं, तो आप RunnableSequence क्लास का एक इंस्टेंस बनाते हैं। एक रननेबल सीक्वेंस ऐसे ऑब्जेक्ट्स की चेन को दर्शाता है जो .invoke() मेथड को सपोर्ट करते हैं, जैसे प्रॉम्प्ट टेम्पलेट्स और भाषा/चैट मॉडल।
अब, आइए चैट मॉडल्स के लिए एक अन्य प्रॉम्प्ट टेम्पलेट क्लास देखें:
from langchain_core.prompts import ChatPromptTemplateहमने उल्लेख किया कि चैट मॉडल्स को इनपुट के रूप में संदेशों का एक अनुक्रम चाहिए। प्रारंभिक इनपुट आमतौर पर एक सिस्टम प्रॉम्प्ट होता है जो चैट मॉडल को बताता है कि उसे कैसे व्यवहार करना है। इसलिए, ChatPromptTemplate क्लास का उपयोग करके, हम आसानी से अलग-अलग पर्सनैलिटी वाले चैट मॉडल बना सकते हैं:
chat_model = ChatOpenAI(api_key=api_key, model="gpt-4o-mini")
template = ChatPromptTemplate([
   ('system', 'You are a helpful AI bot. Your specialty is {specialty}.'),
   ('human', 'Explain the concept of {concept} based on your expertise.')
])
यह क्लास इनपुट के रूप में रोल-आधारित संदेशों की सूची मांगती है। सूची का प्रत्येक सदस्य (role, message) टपल होना चाहिए, जहाँ आवश्यक हो वहाँ वेरिएबल प्लेसहोल्डर्स परिभाषित हों।
यह तैयार हो जाने के बाद, हम वही पाइप ऑपरेटर उपयोग करके अलग-अलग व्यवहार वाले चैट मॉडल बना सकते हैं:
specialties = ["psychology", "economics", "politics"]
concept = "time"
# Call the model with different personalities
for s in specialties:
   chain = template | chat_model
   output = chain.invoke({"specialty": s, "concept": concept})
   print(output.content[:100], end="\n" + "-" * 25 + '\n')
Time is a complex and multifaceted concept that has been explored from various perspectives, includi
-------------------------
In economics, the concept of time is multifaceted and plays a crucial role in various theories and m
-------------------------
While my primary focus is on politics, I can provide a brief overview of the concept of time as it m
-------------------------पिछले खंड में, हमने उल्लेख किया कि एजेंट्स अपने पास उपलब्ध टूल्स के संयोजन का चयन करके एक विशेष समस्या हल कर सकते हैं, जहाँ अंदरूनी तौर पर LLMs तर्क इंजन के रूप में काम करते हैं।
LangChain एजेंट्स को बाकी दुनिया के साथ इंटरैक्ट करने देने के लिए दर्जनों लोकप्रिय APIs और सेवाओं के साथ इंटीग्रेशन्स प्रदान करता है। इनमें से अधिकांश langchain_community पैकेज के अंतर्गत उपलब्ध हैं, जबकि कुछ langchain_core के अंदर हैं।
उदाहरण के लिए, यहाँ बताया गया है कि आप विभिन्न विषयों पर पेपर के सारांश प्राप्त करने के लिए ArXiv टूल को कैसे उपयोग कर सकते हैं:
!pip install -Uq arxiv # Install arXiv Python SDKfrom langchain_community.tools import ArxivQueryRun
tool = ArxivQueryRun()
print(tool.invoke('Photosynthesis')[:250])Published: 2019-08-28
Title: Photosynthesis on Exoplanets and Exomoons from Reflected Light
Authors: Manasvi Lingam, Abraham Loeb
Summary: Photosynthesis offers a convenient means of sustaining biospheres. We
quantify the constraints for photosynthesक्लास नाम से इम्पोर्ट करने की बजाय टूल्स को लोड करने का एक वैकल्पिक तरीका है:
from langchain_community.agent_toolkits.load_tools import load_tools
tools = load_tools(["arxiv", "dalle-image-generator"])
ऊपर, हम load_tools() फ़ंक्शन का उपयोग करके एक साथ arXiv और Dall-E इमेज जेनरेटर टूल्स दोनों को लोड कर रहे हैं। इस फ़ंक्शन से लोड किए गए टूल्स का उपयोग सिंटैक्स समान होता है:
# Call arXiv
print(tools[0].invoke("Kaggle")[:150])
Published: 2020-06-06
Title: StackOverflow vs Kaggle: A Study of Developer Discussions About Data Science
Authors: David Hin
Summary: Software develop# Generate an image with DallE
output_image_url = tools[1].invoke("A magnificent chain in a cartoon.")
output_image_url'https://oaidalleapiprodscus.blob.core.windows.net/...'
load_tools फ़ंक्शन आपको टूल क्लासेस के स्ट्रिंग नाम जानने की आवश्यकता करता है, जैसे ArxivQueryRun बनाम 'arxiv' के उदाहरण में। आप get_all_tool_names फ़ंक्शन चलाकर किसी भी टूल का स्ट्रिंग नाम जल्दी से देख सकते हैं:
from langchain_community.agent_toolkits.load_tools import get_all_tool_names
get_all_tool_names()[:10]
['sleep',
'wolfram-alpha',
'google-search',
'google-search-results-json',
'searx-search-results-json',
'bing-search',
' metaphor-search',
'ddg-search',
'google-lens',
'google-serper']ध्यान दें कि load_tools() केवल एक शॉर्टहैंड फ़ंक्शन है। एजेंट बनाते समय, यह अनुशंसा की जाती है कि टूल्स को उनकी क्लास कंस्ट्रक्टर के माध्यम से लोड करें, जो आपको उनके विशिष्ट व्यवहार के आधार पर उन्हें कॉन्फ़िगर करने देता है।
अंततः, इस खंड में, हम पिछले खंडों में प्राप्त ज्ञान का उपयोग करते हुए चरण-दर-चरण देखेंगे कि LangChain एजेंट्स कैसे बनाए जाते हैं।
आने वाले उदाहरणों में, हम एक ऐसा एजेंट बनाएँगे जो किसी भी विषय को तीन माध्यमों में समझा सके: टेक्स्ट, इमेज, या वीडियो। विशेष रूप से, पूछे गए प्रश्न के आधार पर, एजेंट तय करेगा कि विषय को किस प्रारूप में समझाया जाए।
आइए शुरू करें। वातावरण सेट करने का तरीका देखना याद रखें, जिसे लेख की शुरुआत में कवर किया गया है।
अपने वातावरण को कॉन्फ़िगर करने के बाद पहला कदम है उन टूल्स को परिभाषित करना जिन्हें हम अपने एजेंट को देंगे। इन्हें इम्पोर्ट करें:
from langchain_community.tools import WikipediaQueryRun  # pip install wikipedia
from langchain_community.utilities import WikipediaAPIWrapper
from langchain_community.tools import YouTubeSearchTool  # pip install youtube_search
from langchain_community.tools.openai_dalle_image_generation import (
   OpenAIDALLEImageGenerationTool
)
from langchain_community.utilities.dalle_image_generator import DallEAPIWrapper
हम पाँच क्लासेस इम्पोर्ट कर रहे हैं:
WikipediaAPIWrapper: Wikipedia API तक पहुँच कैसे करें, इसे कॉन्फ़िगर करने के लिएWikipediaQueryRun: Wikipedia पेज सारांश जनरेट करने के लिएYouTubeSearchTool: विषयों पर YouTube वीडियो खोजने के लिएDallEAPIWrapper: OpenAI के DallE एंडपॉइंट तक पहुँच कैसे करें, इसे कॉन्फ़िगर करने के लिएOpenAIDALLEImageGenerationTool: प्रॉम्प्ट्स का उपयोग करके इमेज जनरेट करने के लिएजब कोई उपयोगकर्ता हमारे एजेंट को क्वेरी करेगा, तो यह तय करेगा कि विषय को टेक्स्ट फ़ॉर्मेट में Wikipedia लेख के माध्यम से समझाना है, या विज़ुअल समझ के लिए Dall-E से इमेज बनानी है, या गहन समझ के लिए YouTube वीडियो सुझाने हैं।
आइए इन्हें इनिशियलाइज़ करें, Wikipedia टूल से शुरू करते हुए:
wiki_api_wrapper = WikipediaAPIWrapper(top_k_results=1, doc_content_chars_max=250)
wikipedia = WikipediaQueryRun(description="A tool to explain things in text format. Use this tool if you think the user’s asked concept is best explained through text.", api_wrapper=wiki_api_wrapper)
print(wikipedia.invoke("Mobius strip"))
Page: Möbius strip
Summary: In mathematics, a Möbius strip, Möbius band, or Möbius loop is a surface that can be formed by attaching the ends of a strip of paper together with a half-twist. As a mathematical object, it was discovered by Johann BenediDallE इमेज जेनरेटर:
dalle_api_wrapper = DallEAPIWrapper(model="dall-e-3", size="1792x1024")
dalle = OpenAIDALLEImageGenerationTool(
   api_wrapper=dalle_api_wrapper, description="A tool to generate images. Use this tool if you think the user’s asked concept is best explained through an image."
)
output = dalle.invoke("A mountain bike illustration.")
print(output)
YouTube सर्च टूल:
youtube = YouTubeSearchTool(
   description="A tool to search YouTube videos. Use this tool if you think the user’s asked concept can be best explained by watching a video."
)
youtube.run("Oiling a bike's chain")
"['https://www.youtube.com/watch?v=X1Vze17bhgk&pp=ygUVT2lsaW5nIGEgYmlrZSdzIGNoYWlu', 'https://www.youtube.com/watch?v=T6xyn1FGHiU&pp=ygUVT2lsaW5nIGEgYmlrZSdzIGNoYWlu']"टूल डिस्क्रिप्शन्स पर विशेष ध्यान दें। एजेंट आपके द्वारा दी गई विवरण के आधार पर यह तय करेगा कि कौन सा एक टूल उपयोग करना है।
अब, हम टूल्स को एक सूची में डालेंगे:
tools = [wikipedia, dalle, youtube]हम बिना एजेंट बनाए भी इस टूलसेट को चैट मॉडल से बाँध सकते हैं:
chat_model = ChatOpenAI(api_key=api_key)
model_with_tools = chat_model.bind_tools(tools)
आइए एक सरल संदेश के साथ मॉडल को कॉल करने की कोशिश करें:
response = model_with_tools.invoke([HumanMessage("What's up?!")])
print(f"Text response: {response.content}")
print(f"Tools used in the response: {response.tool_calls}")
Text response: Hello! How can I assist you today?
Tools used in the response: []आउटपुट दिखाता है कि उत्तर जनरेट करते समय किसी भी बाउंड टूल का उपयोग नहीं किया गया। अब, एक विशिष्ट प्रश्न पूछते हैं जो मॉडल को अपने प्रशिक्षण डेटा से परे देखने के लिए बाध्य करे:
response = model_with_tools.invoke([
   HumanMessage("Can you generate an image of a mountain bike?")
])
print(f"Text response: {response.content}")
print(f"Tools used in the response: {response.tool_calls}")
Text response:
Tools used in the response: [{'name': 'openai_dalle', 'args': {'query': 'mountain bike'}, 'id': 'call_92GBfmsYtPi9TpGuIOFB1pG8', 'type': 'tool_call'}]हम देख सकते हैं कि कोई टेक्स्ट आउटपुट नहीं है, लेकिन OpenAI का DallE उल्लिखित है। टूल अभी कॉल नहीं हुआ है; मॉडल केवल इसका उपयोग करने का सुझाव दे रहा है। वास्तव में इसे कॉल करने—यानी कार्रवाई करने—के लिए, हमें एक एजेंट बनाना होगा।
मॉडल और टूल्स परिभाषित करने के बाद, हम एजेंट बनाते हैं। LangChain अपने langgraph पैकेज से एक हाई-लेवल create_react_agent() फ़ंक्शन इंटरफेस प्रदान करता है, जिससे जल्दी से ReAct (reason and act) एजेंट बनाए जा सकें:
from langgraph.prebuilt import create_react_agent
system_prompt = SystemMessage("You are a helpful bot named Chandler.")
agent = create_react_agent(chat_model, tools, state_modifier=system_prompt)
एजेंट को चैट मॉडल और टूल्स की सूची से इनिशियलाइज़ करते समय, हम मॉडल को सामान्य रूप से कैसे व्यवहार करना है यह बताने के लिए एक सिस्टम प्रॉम्प्ट पास कर रहे हैं। अब यह क्वेरियाँ स्वीकार करने के लिए तैयार है:
from pprint import pprint
response = agent.invoke({"messages": HumanMessage("What's up?")})
pprint(response["messages"])
[HumanMessage(content="What's up?", id='133b9380-cfe1-495a-98f7-b835c874bd57'),
AIMessage(content='Hello! How can I assist you today?', response_metadata={'token_usage': {'completion_tokens': 10, 'prompt_tokens': 112, 'total_tokens': 122}, 'model_name': 'gpt-3.5-turbo-0125', 'system_fingerprint': None, 'finish_reason': 'stop', 'logprobs': None}, id='run-0a920c15-39b4-4857-ab51-6ea905575dba-0', usage_metadata={'input_tokens': 112, 'output_tokens': 10, 'total_tokens': 122})]हमें एक संभावित उत्तर मिला है, जो टूल कॉल्स के बिना एक साधारण टेक्स्ट उत्तर है। अब, कुछ और सटीक पूछते हैं:
response = agent.invoke({"messages": [
   HumanMessage('Explain how photosynthesis works.')
]})
print(len(response['messages']))4इस बार, चार संदेश हैं। आइए संदेश क्लास के नाम और उनका कंटेंट देखें:
for message in response['messages']:
   print(
       f"{message.__class__.__name__}: {message.content}"
   )  # Print message class name and its content
   print("-" * 20, end="\n")
HumanMessage: Explain how photosynthesis works.
--------------------
AIMessage:
--------------------
ToolMessage: Page: Photosynthesis
Summary: Photosynthesis ( FOH-tə-SINTH-ə-sis) is a system of biological processes by which photosynthetic organisms, such as most plants, algae, and cyanobacteria, convert light energy, typically from sunlight, into the chemical
--------------------
AIMessage: Photosynthesis is a biological process where photosynthetic organisms like plants, algae, and cyanobacteria convert light energy, usually from sunlight, into chemical energy. This process involves capturing light energy through pigments like chlorophyll in plant cells and using it to convert carbon dioxide and water into glucose and oxygen. Glucose serves as a source of energy for the plant, while oxygen is released into the atmosphere as a byproduct. Photosynthesis is crucial for the survival of plants and the balance of oxygen and carbon dioxide in the atmosphere.
--------------------लीजिए! तीसरा संदेश एक टूल कॉल से है, जो प्रकाश संश्लेषण पर Wikipedia पृष्ठ का सारांश है। अंतिम संदेश चैट मॉडल से है, जो अपना उत्तर बनाते समय टूल कॉल की सामग्री का उपयोग कर रहा है।
आइए जल्दी से एक फ़ंक्शन बनाते हैं ताकि हमने जो अंतिम चरण लिए थे उन्हें मॉड्यूलराइज़ किया जा सके:
def execute(agent, query):
   response = agent.invoke({'messages': [HumanMessage(query)]})

   for message in response['messages']:
       print(
           f"{message.__class__.__name__}: {message.content}"
       )  # Print message class name and its content

       print("-" * 20, end="\n")

return responseअब, आइए विस्तृत निर्देशों के साथ अपने सिस्टम प्रॉम्प्ट को अपडेट करें कि एजेंट को कैसे व्यवहार करना चाहिए:
system_prompt = SystemMessage(
   """
   You are a helpful bot named Chandler. Your task is to explain topics
   asked by the user via three mediums: text, image or video.

   If the asked topic is best explained in text format, use the Wikipedia tool.
   If the topic is best explained by showing a picture of it, generate an image
   of the topic using Dall-E image generator and print the image URL.
   Finally, if video is the best medium to explain the topic, conduct a YouTube search on it
   and return found video links.
   """
)
आइए नए सिस्टम प्रॉम्प्ट के साथ अपना एजेंट फिर से बनाते हैं:
agent = create_react_agent(chat_model, tools, state_modifier=system_prompt)
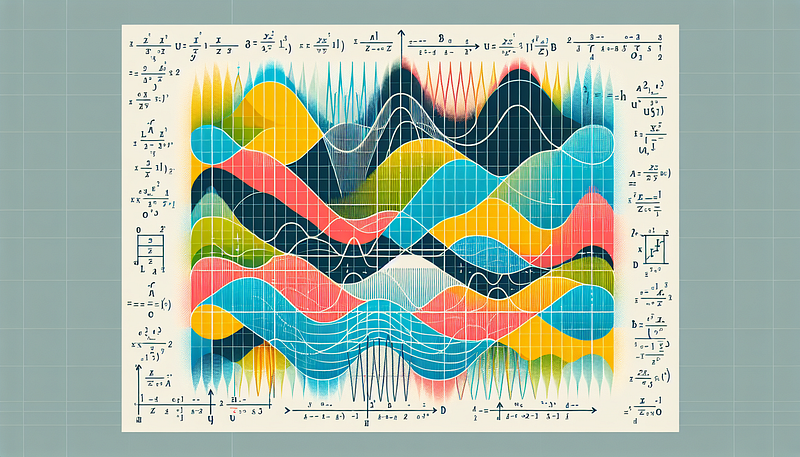
response = execute(agent, query='Explain the Fourier Series visually.')
HumanMessage: Explain the Fourier Series visually.
--------------------
AIMessage:
--------------------
ToolMessage: https://oaidalleapiprodscus.blob.core.windows.net/private/org-qRwX4bsgcnaYHHwbxFBdZxUy/user-LOXQPflMtXxamV72hac9oS2O/img-iY3gXXBzWapRWKdmkd9cXEIN.png?st=2024-08-09T18%3A36%3A46Z&se=2024-08-09T20%3A36%3A46Z&sp=r&sv=2024-08-04&sr=b&rscd=inline&rsct=image/png&skoid=d505667d-d6c1-4a0a-bac7-5c84a87759f8&sktid=a48cca56-e6da-484e-a814-9c849652bcb3&skt=2024-08-09T17%3A56%3A46Z&ske=2024-08-10T17%3A56%3A46Z&sks=b&skv=2024-08-04&sig=Ly8F4jvakFeEtpZ/6jMliLq%2BG3Xs%2Bz1AmX1sL06%2BQ3U%3D
--------------------
AIMessage: Here is a visual representation of the Fourier Series:

The Fourier Series is a way to represent a function as the sum of simple sine waves. It is used in many areas of mathematics and physics to analyze and understand periodic phenomena.
--------------------बहुत बढ़िया, हमारे संदेश के आधार पर (जो काफी निर्देशात्मक था :), एजेंट ने काम के लिए सही टूल चुना। यहाँ जनरेट की गई इमेज है:
फिलहाल, हमारा एजेंट स्टेटलेस है, यानी यह पिछली बातचीतें याद नहीं रखता:
response = execute(agent, query="What did I ask you in the previous query?")HumanMessage: What did I ask you in the previous query?
--------------------
AIMessage: I'm sorry, I cannot remember the previous query as I don't have access to the conversation history. How can I assist you today?
--------------------एजेंट्स में चैट संदेश इतिहास जोड़ने का सबसे आसान तरीका है langgraph की SqliteSaver क्लास का उपयोग करना:
from langgraph.checkpoint.sqlite import SqliteSaver
memory = SqliteSaver.from_conn_string(':agent_history:')
agent = create_react_agent(chat_model, tools, checkpointer=memory, state_modifier=system_prompt)
हम SqliteSaver क्लास के .from_conn_string() मेथड का उपयोग करके मेमोरी इनिशियलाइज़ करते हैं, जो एक डेटाबेस फ़ाइल बनाता है। फिर, हम memory को create_react_agent() फ़ंक्शन के checkpointer पैरामीटर में पास करते हैं।
अब, हमें एक कॉन्फ़िगरेशन डिक्शनरी बनानी है:
config = {'configurable': {'thread_id': 'a1b2c3'}}डिक्शनरी एक थ्रेड ID परिभाषित करती है ताकि एक बातचीत को दूसरी से अलग किया जा सके और इसे हमारे एजेंट के .invoke() मेथड में पास किया जाता है। तो, आइए अपने execute() फ़ंक्शन को इस व्यवहार को शामिल करने के लिए अपडेट करें:
def execute(agent, query, thread_id="a1b2c3"):
   config = {"configurable": {"thread_id": thread_id}}
   response = agent.invoke({'messages': [HumanMessage(query)]}, config=config)
   for message in response["messages"]:
       print(
           f"{message.__class__.__name__}: {message.content}"
       )  # Print message class name and its content
       print("-" * 20, end="\n")
   return response
Let’s test it again:
response = execute(
   agent, query="Explain how to oil a bike's chain using a YouTube video", thread_id="123"
)
HumanMessage: Explain how to oil a bike's chain using a YouTube video
--------------------
AIMessage:
--------------------
ToolMessage: ['https://www.youtube.com/watch?v=X1Vze17bhgk&pp=ygUXaG93IHRvIG9pbCBhIGJpa2UgY2hhaW4%3D', 'https://www.youtube.com/watch?v=ubKCHtZ20-0&pp=ygUXaG93IHRvIG9pbCBhIGJpa2UgY2hhaW4%3D']
--------------------
AIMessage: I found a couple of YouTube videos that explain how to oil a bike chain:
1. [Video 1: How to oil a bike chain](https://www.youtube.com/watch?v=X1Vze17bhgk&pp=ygUXaG93IHRvIG9pbCBhIGJpa2UgY2hhaW4%3D)
2. [Video 2: Step-by-step guide on oiling a bike chain](https://www.youtube.com/watch?v=ubKCHtZ20-0&pp=ygUXaG93IHRvIG9pbCBhIGJpa2UgY2hhaW4%3D)
You can watch these videos to learn how to oil your bike's chain effectively.
--------------------अब, एजेंट से पिछली क्वेरियों के बारे में पूछते हैं:
response = execute(agent, query='What have I asked you so far?', thread_id='123')
print(response)
{'messages': [HumanMessage(content="Explain how to oil a bike's chain using a YouTube video", id='8254142b-fb77-4958-8ad9-0a0283c6611a'), ...
]जैसा अपेक्षित था, एजेंट पिछले संदेश लौटा रहा है! अब हमें केवल ChatGPT जैसी एक चैट UI चाहिए और हमारे पास एक कस्टम चैटबॉट तैयार है।
पूरे लेख में, हमने एजेंट्स के संदर्भ में LangChain कहाँ जा रहा है, इसकी एक झलक देखी है। बहुत हाल तक, LangChain मुख्यतः AgentExecutor क्लास का उपयोग करता था, लेकिन इसे धीरे-धीरे langgraph एजेंट्स से प्रतिस्थापित किया जा रहा है।
शुद्ध LangChain एजेंट्स शुरुआत के लिए ठीक हैं, लेकिन समान एजेंट बनाने के लिए उन्हें LangGraph की तुलना में ज्यादा कोड लाइनों की आवश्यकता होती है। साथ ही, एक बिंदु के बाद, AgentExecutor फ्रेमवर्क जटिल मल्टी-टूल एजेंट्स बनाने के लिए LangGraph जितनी लचीलापन नहीं देगा।
इसीलिए अभी इस लहर पर सवार होने और सीधे LangGraph से शुरू करने का यह सही समय है।
हम LangSmith का उपयोग शुरू करने की भी कड़ी सलाह देते हैं, जो प्रोडक्शन-ग्रेड LLM एप्लिकेशन बनाने के लिए LangChain इकोसिस्टम का एक मुख्य हिस्सा बन गया है। यहाँ इसके कुछ प्रमुख लाभ हैं:
यहाँ बताया गया है कि आप LangSmith के साथ कैसे शुरू कर सकते हैं:
export LANGCHAIN_TRACING_V2="true"
export LANGCHAIN_API_KEY="..."
और आप तैयार हैं! जैसे ही आप भाषा/चैट मॉडल्स से क्वेरी करना शुरू करते हैं, LangSmith प्रत्येक रन के बारे में विभिन्न मैट्रिक्स लॉग करना शुरू कर देता है:
इस लेख में, हमने देखा कि LangChain एजेंट्स को चेंस से अलग क्या बनाता है और उन्हें बनाने में उपयोग किए जाने वाले महत्वपूर्ण बिल्डिंग ब्लॉक्स क्या हैं। हमने पहले एजेंट्स का परिचय दिया और यह बताया कि निर्णय लेने में लचीलापन और क्षमता के संदर्भ में वे पारंपरिक चेन कॉन्स्ट्रक्ट्स से कैसे भिन्न हैं।
फिर हमने उन प्रमुख घटकों को देखा जिन्हें एजेंट बनाने के लिए जानना आवश्यक है: चैट मॉडल्स, टूल्स, और प्रॉम्प्ट टेम्पलेट्स। अंत में, हमने दो उदाहरणों के माध्यम से देखा कि सरल और उन्नत एजेंट्स कैसे बनाए जाते हैं। नैचुरल लैंग्वेज प्रोसेसिंग लगातार विकसित हो रही है, और LangChain एजेंट्स इस प्रगति के अग्रभाग में हैं, जो और भी बुद्धिमान और बहुमुखी AI परिवार के लिए मार्ग प्रशस्त कर रहे हैं।
यहाँ कुछ संबंधित संसाधन हैं जो आपका LangChain ज्ञान बढ़ाएँगे:
पढ़ने के लिए धन्यवाद!
शीर्ष DataCamp LLM कोर्स
कोर्स
कोर्स
कोर्स