
Cursus
AI-agents bouwen met Google ADK
1 uur
7.7K
Dit artikel behandelt de basis van LangChain Tools en hoe je ze gebruikt in Python. We gebruiken een Jupyter Notebook met zowel de bibliotheken openai als langchain geïnstalleerd. Als je eerst meer over het LangChain-framework wilt leren, raad ik je zeker aan het artikel Introduction to LangChain for Data Engineering & Data Applications te bekijken.
In deze tutorial leren we vier bestaande LangChain Tools te gebruiken om het standaard GPT-model te voorzien van diverse externe bronnen om te raadplegen bij het afhandelen van gebruikersverzoeken. Concreet verkennen we Tools die de volgende bronnen gebruiken:
Na het instellen van deze Tools hebben we geleerd hoe je in het algemeen elke LangChain Tool gebruikt, en hoe je ze combineert in een Toolkit om het model browsefuncties te geven.
Zoals we in de inleiding bespraken, kunnen LangChain Tools de mogelijkheden van een model uitbreiden door het in staat te stellen externe bronnen te raadplegen bij het beantwoorden van een prompt van een gebruiker. Deze Tools zijn belangrijk in een promptingtechniek die bekendstaat als ReAct Prompting. ReAct, een acroniem voor Reasoning and Acting, verdeelt de verwerking van het model in twee fasen:
Dit proces genereert redeneringssporen die het model zelf naar het juiste antwoord kunnen leiden. Deze techniek blijkt Large Language Models (LLM’s) te helpen om nauwkeurigere en betrouwbaardere antwoorden te geven, vooral bij kennisintensieve taken en besluitvorming. Dat komt deels doordat het het model extra tijd geeft om te ‘denken’.
LangChain Tools kunnen de ReAct-promptingtechniek verder versterken door aanvullende informatiebronnen te bieden. In onze aanpak houdt de reasoning-fase in dat het model beslist welke tool het gebruikt op basis van de vraag van de gebruiker. Ondertussen stelt de action-fase het model in staat te koppelen met de gekozen externe bron om extra informatie te verzamelen.
Als je geïnteresseerd bent in een diepgaande introductie tot ReAct-prompting met LangChain, is het artikel ChatGPT ReAct Prompting iets voor jou!
Er zijn twee belangrijke elementen binnen het LangChain-framework om deze promptingtechniek te gebruiken: Agents en Tools.
De zogeheten agents zijn entiteiten die verantwoordelijk zijn voor het uitvoeren van de daadwerkelijke reasoning- en acting-fasen. Ze geven de resultaten terug aan het model, zodat de LLM een antwoord in natuurlijke taal kan genereren met de extra informatie. Er zijn verschillende typen agents, elk geschikt voor andere taken die je de LLM wilt laten uitvoeren. Een gedetailleerd overzicht van de verschillende typen agents is beschikbaar in de officiële LangChain-documentatie over Agents.
Tools hebben we al uitgebreid besproken. Technisch gezien zijn Tools functies die een agent kan aanroepen. LangChain biedt een breed scala aan Tools, zoals Google-hulpprogramma’s (zoals Search, Drive en Scholar), Wikipedia-zoekacties, de ArXiV-database, een shell-extensie en native ChatGPT-plugins, en meer. In dit artikel maken we kennis met vier ervan. Raadpleeg de officiële LangChainFor voor een volledige lijst van alle beschikbare Tools.
Laten we praktisch aan de slag gaan!
Zoals bij elk ander project dat GPT-modellen gebruikt, is de eerste stap het laden van de OpenAI API-sleutel in onze omgeving. Hiervoor gebruiken we de modules os en openai.
import openai
import os

os.environ["OPENAI_API_KEY"] = os.getenv("OPENAI_API_KEY")
Als je nog geen OpenAI API-sleutel hebt, is dit artikel, A Beginner’s Guide to the OpenAI API, iets voor jou!
Omdat we het LangChain-framework gaan gebruiken, laden we ook het eigenlijke gpt-model uit de langchain-bibliotheek:
from langchain.llms.openai import OpenAI

llm = OpenAI(model_name="gpt-3.5-turbo")
In dit geval gebruiken we het gpt-3.5-turbo-model als kosteloze optie, maar gebruik gerust elk ander model naar voorkeur.
In de volgende sectie leren we hoe je onze eerste Tool instelt. We gebruiken de DuckDuckGo-zoektool als voorbeeld, maar je zult zien dat alle Tools dezelfde stappen volgen om te gaan werken!
DuckDuckGo is een zoekmachine die de privacy van gebruikers centraal stelt. In tegenstelling tot sommige andere zoekmachines volgt DuckDuckGo de zoekgeschiedenis van gebruikers niet, wat betekent dat het geen persoonlijk profiel van zijn gebruikers aanmaakt of bijhoudt.
Er is een Python-bibliotheek die we moeten installeren om de zoekmachine te gebruiken. Deze is te installeren via pip:
!pip install duckduckgo-searchDaarnaast moeten we de DuckDuckGo Tool importeren uit de langchain-bibliotheek:
from langchain.tools import DuckDuckGoSearchRun

ddg_search = DuckDuckGoSearchRun()
De methode DuckDuckGoSearchRun() maakt op zichzelf al browsen op internet mogelijk zonder te koppelen met een LLM. Laten we een eenvoudig voorbeeld bekijken:
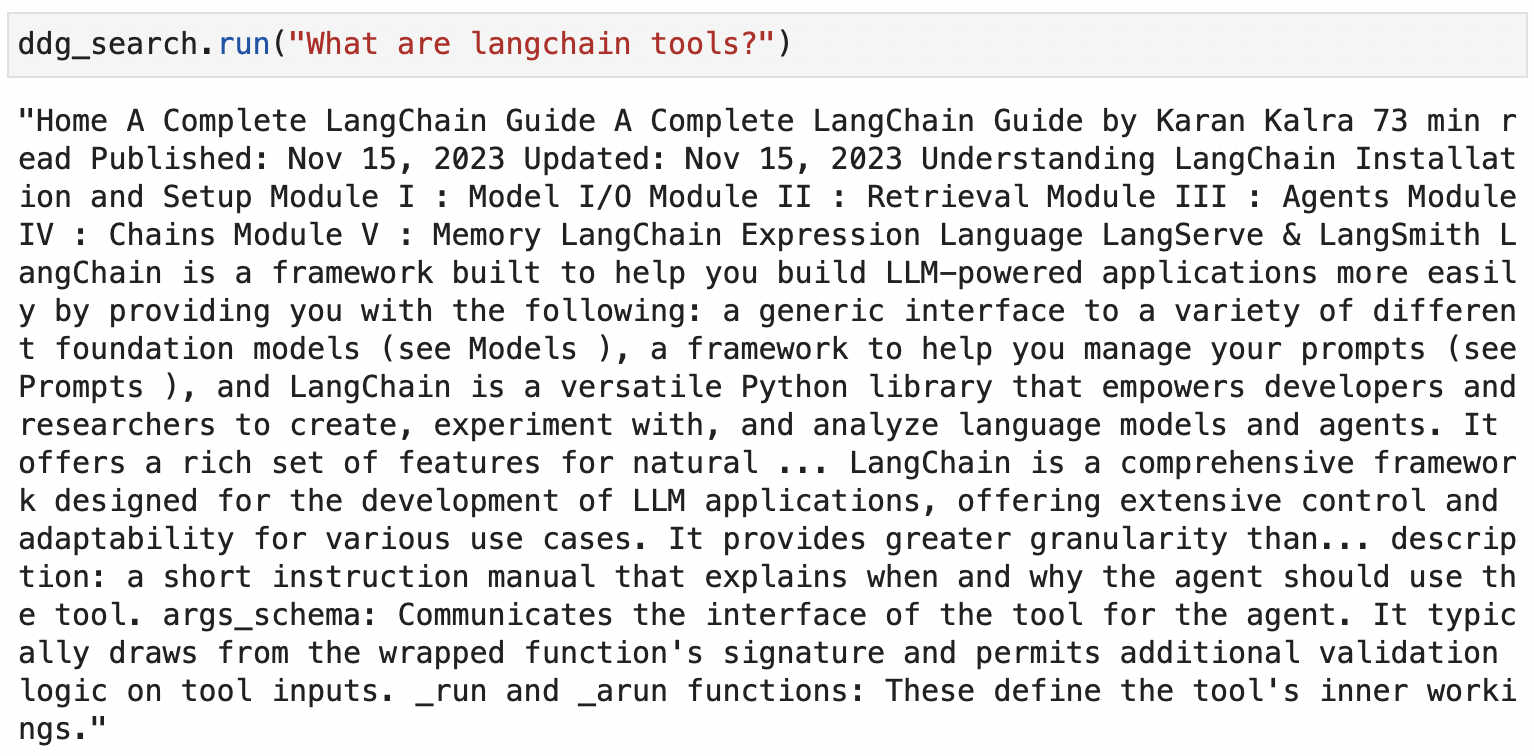
Schermafbeelding van de uitvoering van ddg_search.run() voor browsen op internet met DuckDuckGo
Het idee achter Tools is om deze browsefunctionaliteit te integreren in een LLM, zodat we een samenhangend antwoord in natuurlijke taal krijgen, in plaats van alleen een ruwe brok informatie. Hiervoor moeten we deze methode inbedden in een instantie van de langchain Tool-klasse als volgt:
from langchain.agents import Tool

tools = [
   Tool(
       name="DuckDuckGo Search",
       func=ddg_search.run,
       description="Useful to browse information from the Internet.",
   )
]
Elke tool heeft een naam (name) nodig waar de LangChain-agent naar zal verwijzen, een functie (func) die de agent kan uitvoeren om externe bronnen te raadplegen (ddg_search.run zoals hierboven getoond) en een beschrijving (description) die kan worden gebruikt om de agent te informeren wanneer de tool te gebruiken.
Voor dit voorbeeld hebben we de volgende beschrijving gekozen: „Useful to browse information from the Internet”. Er zijn ook meer optionele parameters in de Tool-definitie die je kunt aanpassen aan je behoeften.
Zodra we hebben geleerd hoe we onze eerste tool instellen, zou het instellen van de rest vrij eenvoudig moeten zijn, omdat ze allemaal dezelfde structuur volgen.
Google Serper is een goedkope Google Search API waarmee we, net als met DuckDuckGo, op internet kunnen browsen.
Voor deze tool hebben we een API-sleutel nodig die we kunnen krijgen door een gratis account aan te maken op https://serper.dev/.
Schermafbeelding van de hoofdpagina van de Google Serper API.
Als we eenmaal in ons Serper-account zitten, zouden we in het paneel aan de linkerkant de optie voor de API-sleutel moeten zien:
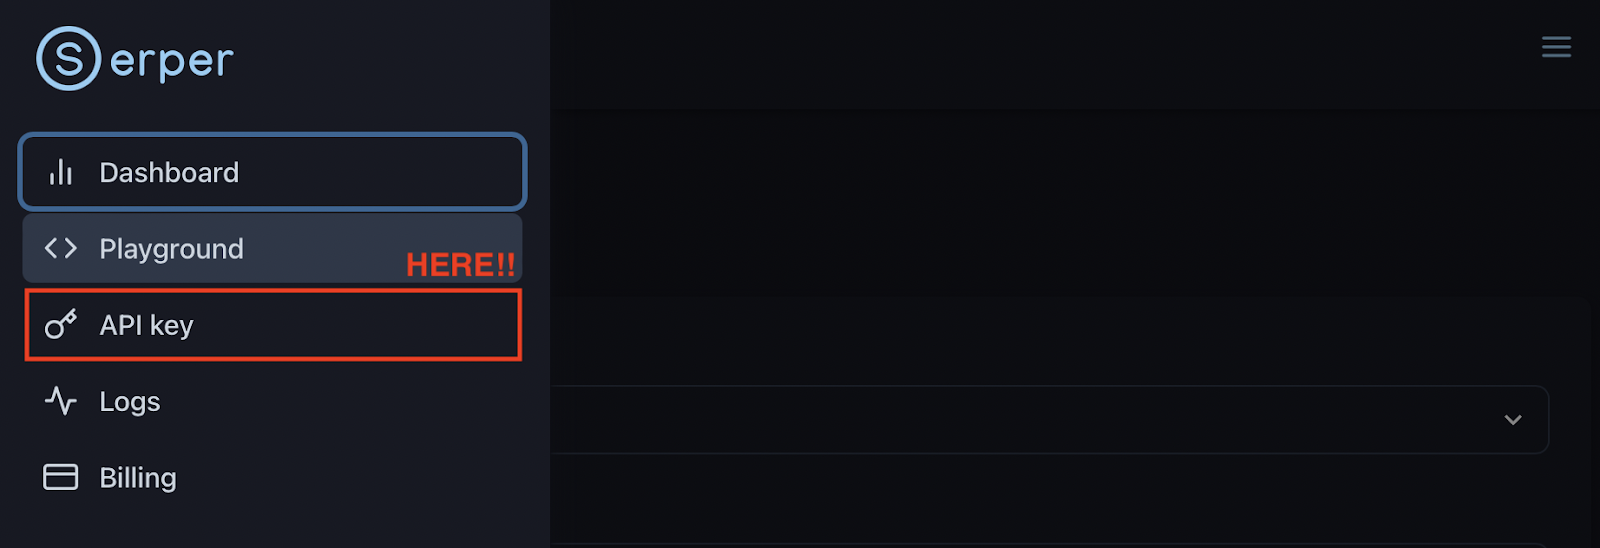
Schermafbeelding van een accountpagina op Google Serper API. API-sleuteloptie in het linker paneel.
Door erop te klikken krijgen we de API-sleutel die we eenvoudig kunnen kopiëren en integreren in onze Python-scripts:
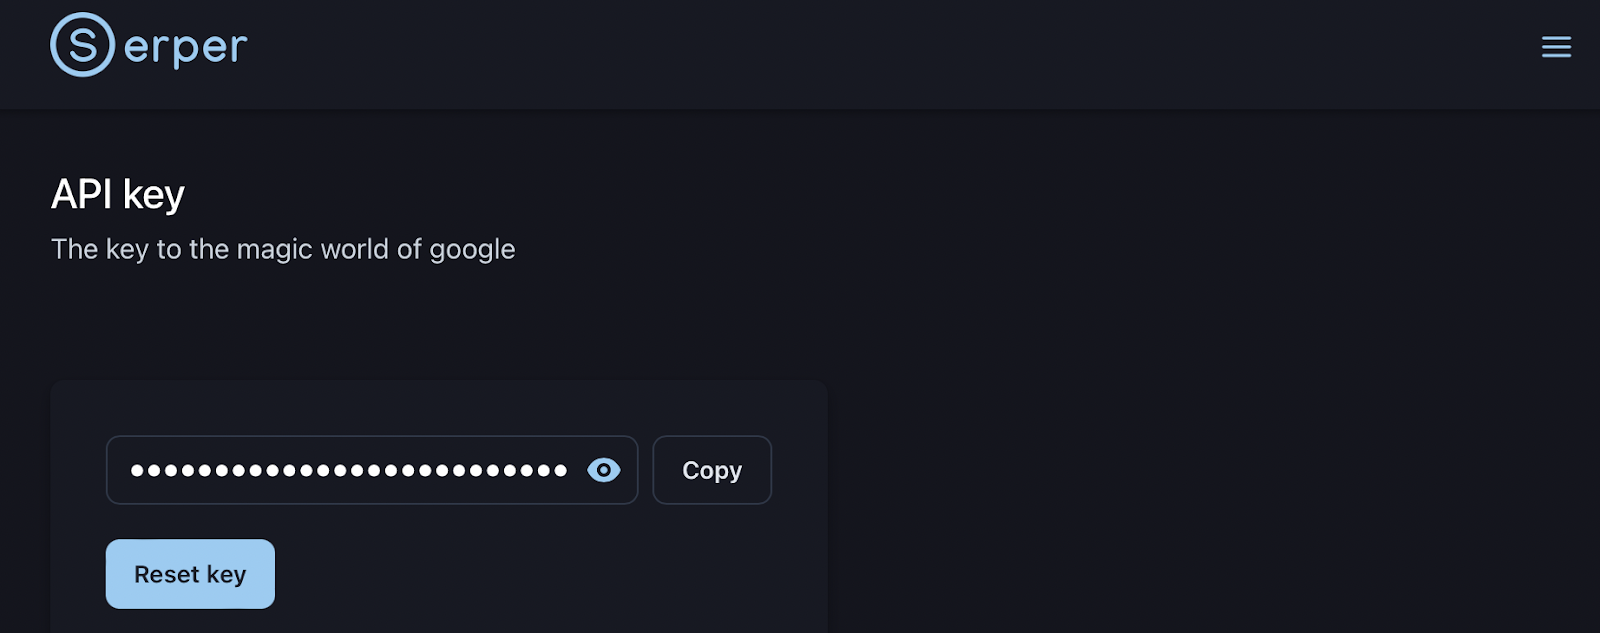
Schermafbeelding van het genereren van de API-sleutel op de Google Serper-pagina.
Terug naar de code: we kunnen de sleutel eenvoudig in onze omgeving importeren:
serper_api_key = os.environ["SERPER_API_KEY"]Om de Google Serper API te gebruiken, moeten we eerst de vereiste Python-bibliotheek installeren (pip install google-serp-api). Daarnaast moeten we de GoogleSerper Tool importeren uit de langchain-bibliotheek:
from langchain.utilities import GoogleSerperAPIWrapper

google_search = GoogleSerperAPIWrapper()
Net als in het vorige geval is google_search.run() ook een methode die zelfstandig op internet zal browsen. Het idee is echter opnieuw om dit te integreren als een LangChain-tool als volgt:
tools.append(
   Tool(
       name="Google Search",
       func=google_search.run,
       description="Useful to search in Google. Use by default.",
   )
)
Merk op dat we in dit geval een nieuwe tool toevoegen aan de lijst tools. Onze tools-lijst bevat nu dus beide zoekmachines.
Laten we onze set Tools aanvullen met de bekende Wikipedia-bronnen volgens hetzelfde proces als bij de vorige Tools.
De eerste stap is het installeren van de Python-bibliotheek wikipedia via pip (pip install wikipedia), en het laden van de vereiste modules uit de LangChain-bibliotheek. Deze tool heeft eigenlijk twee modules nodig vanwege de architectuur van de Wikipedia API:
from langchain.tools import WikipediaQueryRun
from langchain.utilities import WikipediaAPIWrapper

wikipedia = WikipediaQueryRun(api_wrapper=WikipediaAPIWrapper())
Tot slot kunnen we een nieuwe instantie van de Tool-klasse toevoegen met een functie die de methode wikipedia.run() uitvoert:
tools.append(
   Tool(
       name="Wikipedia Search",
       func=wikipedia.run,
       description="Useful when users request biographies or historical moments.",
   )
)
Tot slot vond ik het erg interessant om YouTube-bronnen te integreren, zodat het model een extra mogelijkheid heeft om te antwoorden in de vorm van video’s, niet alleen geschreven tekst. Volgend dezelfde procedure als hiervoor:
!pip install youtube

from langchain.tools import YouTubeSearchTool
youtube = YouTubeSearchTool()

tools.append(
   Tool(
       name="Youtube Search",
       func=youtube.run,
       description="Useful for when the user explicitly asks you to look on Youtube.",
   )
)
Nu zijn we er klaar voor!
We hebben een toolkit (tools-lijst) gebouwd met de vier Tools die ons model browsefuncties geven. We hebben echter nog niet met het model gecommuniceerd.
Laten we zien hoe het daar gebruik van kan maken!
Zoals we al vermeldden, zijn de zogeheten agents de entiteiten die verantwoordelijk zijn voor het gebruik van de Tools. We moeten ze daarom ook importeren uit de langchain-bibliotheek:
from langchain.agents import initialize_agentMet de methode initialize_agent kunnen we onze agent instellen:
agent = initialize_agent(
   tools, llm, agent="zero-shot-react-description", verbose=True
)
Zoals we uit de initialisatie kunnen opmaken, moeten we de agent voorzien van de lijst met beschikbare Tools (tools), de te gebruiken LLM (llm) en het type agent (agent=”zero-shot-react-description”). Voor dit voorbeeld gebruiken we het Zero-shot ReAct-agenttype als het meest algemene action-agent. In dit geval hebben we ook verbose=True ingesteld om het redeneerproces van de agent te kunnen zien.
Zodra de agent is geïnitialiseerd, kunnen we elke gebruikersprompt uitvoeren met de methode agent.run().
In principe zal de agent, zodra we een gebruikersprompt indienen, de beschrijvingen van de Tools analyseren en degene gebruiken die het best geschikt is voor de usecase. Daarnaast zal de agent nog steeds terugvallen op de andere Tools als hij met de geselecteerde tool niet de juiste informatie vindt.
Laten we een eerste test uitvoeren en vragen om een biografie. In dit geval is er een geschikte tool die we hebben geconfigureerd voor biografieën en historische momenten, dus we verwachten dat de agent de geconfigureerde tool selecteert:
agent.run(
   "Harry Styles biography"
)
We kunnen het redeneerproces observeren:
> Entering new AgentExecutor chain...
I should look for a biography of the singer

Action: Wikipedia Search
Action Input: Harry Styles biography

Observation:

Page: Harry Styles
Summary: Harry Edward Styles (born 1 February 1994) is an English singer. His musical career began in 2010 as part of One Direction, a boy band formed on the British music competition series The X Factor after each member of the band had been eliminated from the solo contest. They became one of the best-selling boy groups of all time before going on an indefinite hiatus in 2016.
Styles released his self-titled debut solo album through Columbia Records in 2017. It debuted at number one in the UK and the US and was one of the world's top-ten best-selling albums of the year, while its lead single, "Sign of the Times", topped the UK Singles Chart. Styles' second album, Fine Line (2019), debuted atop the US Billboard 200 with the biggest ever first-week sales by an English male artist, and was the most recent album to be included in Rolling Stone's "500 Greatest Albums of All Time" in 2020. Its fourth single, "Watermelon Sugar", topped the US Billboard Hot 100. Styles' third album, Harry's House (2022), broke several records and was widely acclaimed, receiving the Grammy Award for Album of the Year in 2023. Its lead single, "As It Was", became the number-one song of 2022 globally according to Billboard.
Styles has received various accolades, including six Brit Awards, three Grammy Awards, an Ivor Novello Award, and three American Music Awards. His film roles include Dunkirk (2017), Don't Worry Darling (2022), and My Policeman (2022). Aside from music and acting, Styles is known for his flamboyant fashion. He is the first man to appear solo on the cover of Vogue.

Page: Debbie Harry
Summary: Deborah Ann Harry (born Angela Trimble; July 1, 1945) is an American singer, songwriter and actress, best known as the lead vocalist of the band Blondie. Four of her songs with the band reached No. 1 on the US charts between 1979 and 1981.
Born in Miami, Florida, Harry was adopted as an infant and raised in Hawthorne, New Jersey. After college she worked various jobs—as a dancer, a Playboy Bunny, and a secretary (including at the BBC in New York)—before her breakthrough in the music industry. She co-formed Blondie in 1974 in New York City. The band released its eponymous debut studio album in 1976 and released three more studio albums between then and 1979, including Parallel Lines, which spawned six singles, including "Heart of Glass". Their fifth studio album, Autoamerican (1980), spawned such hits as a cover of "The Tide Is High", and "Rapture", which is considered the first rap song to chart at number one in the United States.Harry released her debut solo studio album, KooKoo, in 1981. During a Blondie hiatus, she embarked on an acting career, appearing in lead roles in the neo-noir Union City (1980) and in David Cronenberg's body horror film Videodrome (1983). She released her second solo studio album, 1986's Rockbird, and starred in John Waters's cult dance film Hairspray (1988). She released two more solo albums between then and 1993, before returning to film with roles in a John Carpenter-directed segment of the horror film Body Bags (1993), and in the drama Heavy (1995).
Blondie reunited in the late 1990s, releasing No Exit (1999), followed by The Curse of Blondie (2003). Harry continued to appear in independent films throughout the 2000s, including Deuces Wild (2002), My Life Without Me (2003) and Elegy (2008). With Blondie, she released the group's ninth studio album, Panic of Girls, in 2011, followed by Ghosts of Download (2014). The band's eleventh studio album, 2017's Pollinator, charted at number 4 in the United Kingdom.

Page: Harry Potter
Summary: Harry Potter is a series of seven fantasy novels written by British author J. K. Rowling. The novels chronicle the lives of a young wizard, Harry Potter, and his friends Hermione Granger and Ron Weasley, all of whom are students at Hogwarts School of Witchcraft and Wizardry. The main story arc concerns Harry's conflict with Lord Voldemort, a dark wizard who intends

Thought: I now know the final answer
Final Answer: Harry Styles is an English singer, songwriter and actor. He rose to fame as a member of the boy band One Direction, and later embarked on a solo career. He released his debut solo album, Harry Styles, in 2017, and his second album, Fine Line, in 2019. He has also had success in film, appearing in Dunkirk (2017), Don't Worry Darling (2022) and My Policeman (2022).

> Finished chain.

"Harry Styles is an English singer, songwriter and actor. He rose to fame as a member of the boy band One Direction, and later embarked on a solo career. He released his debut solo album, Harry Styles, in 2017, and his second album, Fine Line, in 2019. He has also had success in film, appearing in Dunkirk (2017), Don't Worry Darling (2022) and My Policeman (2022)."
We zien dat zodra we de .run()-methode uitvoeren, de agent de gebruikersprompt verwerkt en de reasoning-fase start, die eindigt met het volgende resultaat: „I should look for a biography of the singer”. Om dat te doen, ontwerpt hij een actieplan dat bestaat uit het gebruiken van de Wikipedia Search-tool – volgens onze tooldefinitie – met „Harry Styles biography” als invoer. Vervolgens start het actieplan en haalt de agent gerelateerde informatie op uit de Wikipedia-database, verwerkt de bevindingen en genereert een passend antwoord in natuurlijke taal.
Laten we nu een generieke browsetaak vragen, zodat de agent geen specifieke tool heeft die in de toolkitbeschrijving wordt genoemd:
agent.run(
   "Yesterday's latest news in Spain"
)
Laten we in dit geval het redeneerproces bekijken:
> Entering new AgentExecutor chain...
I should look for news from yesterday

Action: Google Search
Action Input: "Yesterday's news in Spain"

Observation: The latest breaking news, comment and features from The Independent. All the latest content about Spain from the BBC. Find all national and international information about spain. Select the subjects you want to know more about on euronews.com. Latest Spain news stories including accidents, crime and policing, politics, and Spanish sport news headlines. Latest news, essential insights and practical guides to life in Spain from The Local, Europe's leading independent voice. Missing: Yesterday's | Show results with:Yesterday's. Stay on top of Spain latest developments on the ground with Al Jazeera's fact-based news, exclusive video footage, photos and updated maps. Missing: Yesterday's | Show results with:Yesterday's. Spain · Shakira due to go on trial in Spain over tax fraud claims · The Observer view on Pedro Sánchez's election deal to take power: it undermines democracy. Missing: Yesterday's | Show results with:Yesterday's. Latest News · Hundreds leave Al-Shifa hospital as Israeli forces take control of facility · F1 fans file class-action suit over being forced to exit Las Vegas ... Missing: Yesterday's | Show results with:Yesterday's. Follow the latest Spain news stories and headlines. Get breaking news alerts when you download the ABC News App and subscribe to Spain notifications. Missing: Yesterday's | Show results with:Yesterday's. Get the latest breaking news and top news headlines at Reuters ... Spain Headlines. Shakira stands trial in Spain for alleged tax fraud. Shakira ... Missing: Yesterday's | Show results with:Yesterday's.
Thought: I found a lot of news sources with yesterday's news, so the final answer should be about that.

Final Answer: The latest news in Spain from yesterday is that Shakira is standing trial in Spain for alleged tax fraud, hundreds of people have left Al-Shifa hospital as Israeli forces take control, and F1 fans have filed a class-action suit over being forced to exit Las Vegas. Other news includes insights and practical guides to life in Spain, Pedro Sánchez's election deal to take power, and the top news headlines from Reuters.

> Finished chain.
"The latest news in Spain from yesterday is that Shakira is standing trial in Spain for alleged tax fraud, hundreds of people have left Al-Shifa hospital as Israeli forces take control, and F1 fans have filed a class-action suit over being forced to exit Las Vegas. Other news includes insights and practical guides to life in Spain, Pedro Sánchez's election deal to take power, and the top news headlines from Reuters."
In dit geval valt de agent succesvol terug op de standaard Google Serper-tool en vindt het laatste nieuws in Spanje. Dit browsevoorbeeld is vooral interessant omdat we een zeer actuele prompt stellen aan een LLM waarvan de trainingsdata in september 2021 stopte, en we toch een actueel antwoord krijgen.
Tot slot, stel dat we geïnteresseerd zijn in een videoresource. Laten we kijken of het model ons er daadwerkelijk naartoe kan wijzen. We zetten de verbose-modus uit en bekijken het daadwerkelijke antwoord van het model:
agent = initialize_agent(
   tools, llm, agent="zero-shot-react-description"
)

agent.run(
   "Can you point me to the Procrastination TED talk by Tim Urban?"
)
En, zoals verwacht, krijgen we het volgende antwoord terug:
'The TED Talk "Procrastination" by Tim Urban can be found at
https://www.youtube.com/watch?v=arj7oStGLkU'
Het werkt! Met deze drie voorbeelden hebben we de verschillende bronnen laten zien waarvan onze LLM gebruik kan maken om aan onze verzoeken te voldoen.
Als je geïnteresseerd bent in het toevoegen van meer Tools aan onze Toolkit, raad ik het artikel ReAct: 3 LangChain Tools To Enhance the Default GPT Capabilities van harte aan.
In deze tutorial hebben we geleerd over het gebruik van LangChain Tools om browsefuncties in LLM’s te verbeteren. Centraal in LangChain staat het vermogen om de ontwikkeling van LLM-gebaseerde applicaties te stroomlijnen, met een reeks krachtige functies zoals ingebouwde memories, complete chatbots en de in dit artikel verkende Tools, naast andere.
Hoewel OpenAI vooruitgang boekt op het gebied van maatwerk-AI met de lancering van zijn nieuwste GPT-modellen, denk ik dat er nog veel ruimte is voor groei en innovatie.
In dit opzicht hebben LangChain Tools een aanzienlijk voordeel in deze technologische race voor gebruikers die vaak via Python en de OpenAI API met GPT-modellen werken. Dit staat in schril contrast met GPT’s, die lijken te zijn afgestemd op een niet-coderend publiek. GPT-gebruikers kunnen vanuit de ChatGPT-interface eenvoudig een gespecialiseerde instantie configureren en deze naar behoefte gebruiken: gebruiksvriendelijk, maar met beperkte flexibiliteit.
Bovendien vergroot het vermogen van LangChain Tools om externe informatiebronnen zoals Google of Wikipedia te raadplegen de kennisbasis van het model aanzienlijk. Dit biedt een aanzienlijk voordeel ten opzichte van GPT’s, die wel het uploaden van informatie ondersteunen, maar op kleinere schaal.
Kortom, LangChain Tools zijn naar mijn mening de krachtigste functies om de mogelijkheden van het model te vergroten en onze eigen instanties te personaliseren met algemeen beschikbare openbare data. Kun je je nu voorstellen hoe krachtig het is om Tools te combineren met onze eigen privédatabase?
Nieuw in de wereld van LLM’s? Bekijk onze cursus Large Language Models Concepts om snel bij te spijkeren!
Ontwikkel je AI-skills!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

