
Cursus
Multi-agent systemen met LangGraph
2 uur 45 min
8.8K
In de wereld van AI is het Model Context Protocol (MCP) razendsnel een hot topic geworden. MCP is een open standaard die AI-modellen zoals Claude 4 een consistente manier biedt om te verbinden met externe tools, services en realtime databronnen. Die connectiviteit is een gamechanger, omdat grote taalmodellen (LLM’s) zo relevantere, actuelere en bruikbare antwoorden kunnen geven door de kloof te overbruggen tussen AI en de systemen.
In deze tutorial duiken we in FastMCP 2.0, een krachtig framework waarmee je met slechts een paar regels code je eigen MCP-server bouwt. We behandelen de kerncomponenten van FastMCP, hoe je zowel een MCP-server als -client bouwt, en hoe je die naadloos integreert in je workflow. Ben je nieuw met MCP? Bekijk dan onze Model Context Protocol-gids met demoproject voor meer info.
FastMCP 2.0 is een open-source Python-framework dat is ontworpen om het bouwen van Model Context Protocol (MCP)-servers en -clients eenvoudig en efficiënt te maken. Met een paar regels code kunnen ontwikkelaars aangepaste MCP-servers maken en die koppelen aan hun AI-toepassingen, zoals code-editors of chatbot-assistenten.
FastMCP 2.0 is de opvolger van FastMCP 1.0, dat nu bekendstaat als de MCP Python SDK, en het biedt een complete toolkit om binnen het MCP-ecosysteem te werken.
Wat FastMCP 2.0 onderscheidt, is de uitgebreide set functies die ver voorbij de kernspecificatie van MCP gaat. Het vereenvoudigt deployment, authenticatie, proxy’s voor client en server, en maakt het zelfs mogelijk om servers te genereren vanuit REST API’s.
FastMCP 2.0 is opgebouwd rond drie essentiële componenten: Tools, Resources en Prompts.
Tools zijn Python-functies die via het MCP-protocol worden blootgesteld aan LLM’s. Door een functie te decoreren met @mcp.tool kan het AI-model die tijdens een gesprek aanroepen. Zo kunnen LLM’s acties in de echte wereld uitvoeren, zoals databases bevragen, API’s aanroepen of berekeningen doen.
from fastmcp import FastMCPmcp = FastMCP(name="UtilityServer")@mcp.tooldef convert_usd_to_eur(amount: float, rate: float = 0.91) -> float: """Converts a given amount in USD to EUR using the provided rate.""" return round(amount * rate, 2)Resources geven LLM’s of clientapplicaties alleen-lezen toegang tot data, zoals bestanden, databaserecords, configuraties of dynamisch gegenereerde content. Bijvoorbeeld:
from fastmcp import FastMCPmcp = FastMCP(name="WeatherResourceServer")@mcp.resource("config://weather-settings")def get_weather_settings() -> dict: """Provides weather configuration.""" return { "default_units": "metric", "default_location": "Berlin", "features_enabled": ["forecast", "alerts"] }@mcp.resource("resource://welcome-message")def welcome_message() -> str: """Returns a dynamic greeting for users based on time of day.""" from datetime import datetime hour = datetime.now().hour if hour < 12: return "Good morning! Here's your weather update." elif hour < 18: return "Good afternoon! Need a forecast?" else: return "Good evening! Let's check the weather."Prompts zijn herbruikbare, geparametriseerde berichtsjablonen die LLM-antwoorden sturen. Door prompts als functies te definiëren, zorg je voor consistente, contextrijke instructies die door clients kunnen worden aangeroepen.
Deze zijn nodig om meerdere tools achter elkaar uit te voeren en het LLM te sturen om bepaalde taken uit te voeren met de beschikbare tools en resources.
from fastmcp import FastMCPfrom fastmcp.prompts.prompt import PromptMessage, TextContentmcp = FastMCP(name="TutorPromptServer")@mcp.promptdef explain_math_concept(concept: str) -> PromptMessage: """Creates a message asking an AI tutor to explain a math concept simply.""" text = f"Can you explain the math concept of '{concept}' in a way that's easy for a 12-year-old to understand?" return PromptMessage(role="user", content=TextContent(type="text", text=text))In deze sectie bouwen we een "ArXiv Explorer" MCP-server. Deze server bestaat uit twee tools: één om de links en titels van onderzoeksartikelen op te halen, en een tweede om de artikelen samen te vatten. Naast deze tools bevat de server ook resources en prompts om een compleet rapport over het gekozen onderwerp te maken.
Voordat je begint, heb je de Tavily API-sleutel nodig. Je kunt een gratis sleutel krijgen met 1.000 maandelijkse requests op tavily.com. Installeer daarna de benodigde Python-libraries:
pip install fastmcp tavily-pythonWe maken eerst het Python-bestand voor de server. Het bestand bestaat uit:
@mcp.resource stelt onze functie arxiv_topics bloot als een alleen-lezen databron. Een AI-client kan deze topics ophalen om ideeën te krijgen voor onderzoek, als de gebruiker het niet zeker weet.@mcp.tool verandert gewone Python-functies in acties die een LLM kan uitvoeren.qna_search, geoptimaliseerd om directe, beknopte antwoorden te geven, ideaal voor het genereren van een samenvatting.@mcp.prompt maakt een herbruikbaar sjabloon. Dit is niet zomaar een prompt; het is een strategisch plan dat een LLM instrueert hoe de tools van de server in een volgorde te gebruiken om een complexe taak uit te voeren.mcp.run(transport="http") is een cruciale regel. In plaats van “stdio” voor lokale processen te gebruiken, start dit een webserver. Hierdoor kan elke client op het netwerk (of op dezelfde machine) via een URL met onze server verbinden, waardoor het echt een externe en deelbare tool wordt.server.py:
import osfrom typing import Dict, Listfrom fastmcp import FastMCPfrom tavily import TavilyClient# --- Configuration ---TAVILY_API_KEY = os.environ.get("TAVILY_API_KEY")if not TAVILY_API_KEY: raise ValueError("Please set the TAVILY_API_KEY environment variable.")tavily = TavilyClient(api_key=TAVILY_API_KEY)mcp = FastMCP(name="ArxivExplorer")print("✅ ArxivExplorer server initialized.")# --- Dynamic Resource: Suggested AI research topics ---@mcp.resource("resource://ai/arxiv_topics")def arxiv_topics() -> List[str]: return [ "Transformer interpretability", "Efficient large-scale model training", "Federated learning privacy", "Neural network pruning", ]print("✅ Resource 'resource://ai/arxiv_topics' registered.")# --- Tool: Search ArXiv for recent papers ---@mcp.tool(annotations={"title": "Search Arxiv"})def search_arxiv(query: str, max_results: int = 5) -> List[Dict]: """ Queries ArXiv via Tavily, returning title + link for each paper, and *only* ArXiv results. """ resp = tavily.search( query=f"site:arxiv.org {query}", max_results=max_results ) return [ {"title": r["title"].strip(), "url": r["url"]} for r in resp.get("results", []) ]# --- Tool: Summarize an ArXiv paper ---@mcp.tool(annotations={"title": "Summarize Paper"})def summarize_paper(paper_url: str) -> str: """ Returns a one-paragraph summary of the paper at the given URL. """ prompt = f"Summarize the key contributions of this ArXiv paper: {paper_url}" return tavily.qna_search(query=prompt)print("✅ Tools 'Search Arxiv' and 'Summarize Paper' registered.")# --- Prompt Template: Explore a topic thoroughly ---@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )print("✅ Prompt 'explore_topic_prompt' registered.")if __name__ == "__main__": print("\n🚀 Starting ArxivExplorer Server...") mcp.run(transport="http")We moeten de MCP-serverfuncties en -endpoints testen voordat we die integreren in de AI-toepassing. Hiervoor biedt FastMCP een eenvoudige API om met de MCP-server te verbinden en al zijn functies te testen.
Het clientbestand bestaat uit:
StreamableHttpTransport is speciaal ontworpen om verbinding te maken met een FastMCP-server die in HTTP-modus draait.arxiv_topics en parseert het resultaat correct.search_arxiv aan en gebruikt de helper om de lijst met papers uit te pakken.summarize_paper.explore_topic_prompt op, waarmee je de uiteindelijke instructies ziet die naar een LLM gestuurd zouden worden.client.py:
import astimport asyncioimport pprintfrom fastmcp import Clientfrom fastmcp.client.transports import StreamableHttpTransport# --- Configuration ---SERVER_URL = "http://localhost:8000/mcp" # adjust if hosted elsewherepp = pprint.PrettyPrinter(indent=2, width=100)def unwrap_tool_result(resp): """ Safely unwraps the content from a FastMCP tool call result object. """ if hasattr(resp, "content") and resp.content: # The content is a list containing a single content object content_object = resp.content[0] # It could be JSON or plain text if hasattr(content_object, "json"): return content_object.json if hasattr(content_object, "text"): try: # Use ast.literal_eval for safely evaluating a string containing a Python literal return ast.literal_eval(content_object.text) except (ValueError, SyntaxError): # If it's not a literal, return the raw text return content_object.text return respasync def main(): transport = StreamableHttpTransport(url=SERVER_URL) client = Client(transport) print("\n🚀 Connecting to FastMCP server at:", SERVER_URL) async with client: # 1. Ping to test connectivity print("\n🔗 Testing server connectivity...") await client.ping() print("✅ Server is reachable!\n") # 2. Discover server capabilities print("🛠️ Available tools:") pp.pprint(await client.list_tools()) print("\n📚 Available resources:") pp.pprint(await client.list_resources()) print("\n💬 Available prompts:") pp.pprint(await client.list_prompts()) # 3. Fetch the topics resource print("\n\n📖 Fetching resource: resource://ai/arxiv_topics") res = await client.read_resource("resource://ai/arxiv_topics") topics = ast.literal_eval(res[0].text) print("Today's AI topics:") for i, t in enumerate(topics, 1): print(f" {i}. {t}") # 4. Test the search tool print("\n\n🔍 Testing tool: search_arxiv") raw_search = await client.call_tool( "search_arxiv", {"query": "Transformer interpretability", "max_results": 3}, ) search_results = unwrap_tool_result(raw_search) for i, paper in enumerate(search_results, 1): print(f" {i}. {paper['title']}\n {paper['url']}") # 5. Test the summarize tool on the first result if search_results: first_url = search_results[0]["url"] print("\n\n📝 Testing tool: summarize_paper") raw_summary = await client.call_tool( "summarize_paper", {"paper_url": first_url} ) summary = unwrap_tool_result(raw_summary) print("\nSummary of first paper:\n", summary) # 6. Test the prompt generator print("\n\n🚀 Testing prompt: explore_topic_prompt") prompt_resp = await client.get_prompt( "explore_topic_prompt", {"topic": "Transformer interpretability"} ) print("\nGenerated prompt for an LLM:") for msg in prompt_resp.messages: print(f"{msg.role.upper()}: {msg.content.text}\n")if __name__ == "__main__": asyncio.run(main())Alle bestanden en configuraties zijn beschikbaar in de GitHub-repository kingabzpro/FastMCP-Project. Handig als je ergens tegenaan loopt. Ik heb ook een set-upgids toegevoegd om het lokaal te draaien.
We gaan nu zowel de MCP-server als de client draaien.
Stel eerst de Tavily API-sleutel in als omgevingsvariabele op je lokale systeem:
export TAVILY_API_KEY='your_tavily_api_key'Start daarna de server:
python server.pyBinnen enkele seconden zie je dat de FastMCP-server draait op http://localhost:8000/mcp.
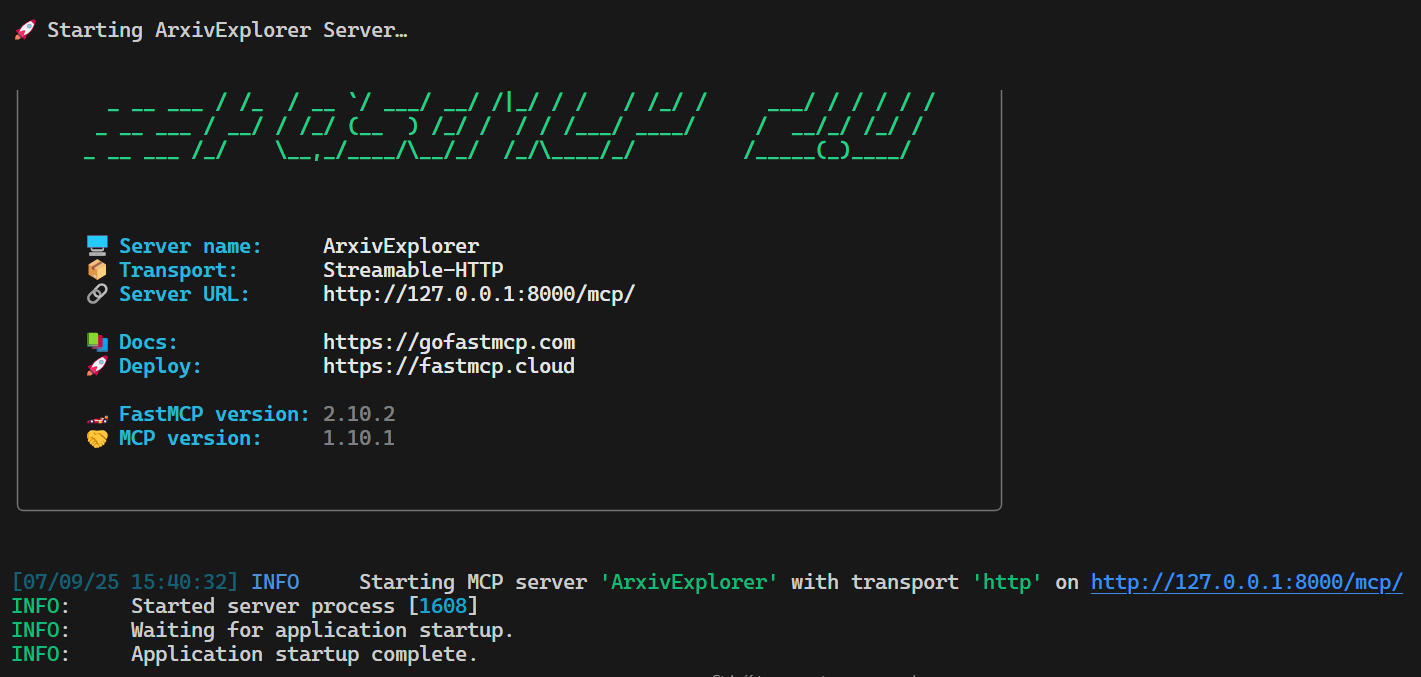
Open een nieuwe terminal en voer het clientscript uit om te testen of alles goed werkt:
python client.pyZoals je ziet werken alle functies, resources, tools en prompts perfect. Onze MCP-server presteert goed, zelfs met meerdere Tavily API-verzoeken.
🚀 Connecting to FastMCP server at: http://localhost:8000/mcp🔗 Testing server connectivity...✅ Server is reachable!🛠️ Available tools:[ Tool(name='search_arxiv', title='Search Arxiv', description='Queries ArXiv via Tavily, returning title + link for each paper,\nand *only* ArXiv results.', inputSchema={'properties': {'query': {'title': 'Query', 'type': 'string'}, 'max_results': {'default': 5, 'title': 'Max Results', 'type': 'integer'}}, 'required': ['query'], 'type': 'object'}, outputSchema={'properties': {'result': {'items': {'additionalProperties': True, 'type': 'object'}, 'title': 'Result', 'type': 'array'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Search Arxiv', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None), Tool(name='summarize_paper', title='Summarize Paper', description='Returns a one-paragraph summary of the paper at the given URL.', inputSchema={'properties': {'paper_url': {'title': 'Paper Url', 'type': 'string'}}, 'required': ['paper_url'], 'type': 'object'}, outputSchema={'properties': {'result': {'title': 'Result', 'type': 'string'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Summarize Paper', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None)]📚 Available resources:[ Resource(name='arxiv_topics', title=None, uri=AnyUrl('resource://ai/arxiv_topics'), description=None, mimeType='text/plain', size=None, annotations=None, meta=None)]💬 Available prompts:[ Prompt(name='explore_topic_prompt', title=None, description=None, arguments=[PromptArgument(name='topic', description=None, required=True)], meta=None)]📖 Fetching resource: resource://ai/arxiv_topicsToday's AI topics: 1. Transformer interpretability 2. Efficient large-scale model training 3. Federated learning privacy 4. Neural network pruning🔍 Testing tool: search_arxiv 1. Transformer Interpretability Beyond Attention Visualization https://arxiv.org/abs/2012.09838 2. A Practical Review of Mechanistic Interpretability for ... https://arxiv.org/abs/2407.02646 3. Mechanistic Interpretability of Fine-Tuned Vision ... https://arxiv.org/abs/2503.18762📝 Testing tool: summarize_paperSummary of first paper: The paper proposes a novel method for interpreting Transformer networks beyond attention visualization, introducing a new way to compute relevancy. It aims to enhance interpretability in vision tasks. The method is shown to provide more accurate insights into model decisions.🚀 Testing prompt: explore_topic_promptGenerated prompt:USER: type='text' text="I want to explore recent work on 'Transformer interpretability'.\n1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n3. Combine all summaries into an overview report." annotations=None meta=NoneLaat de MCP-server draaien, want we gaan hem integreren in de Cursor AI-code-editor.
{ "mcpServers": { "ArxivExplorer": { "url": "http://127.0.0.1:8000/mcp/" } }}Zodra je het bestand mcp.json met bovenstaande configuraties opslaat, zie je de nieuwe MCP-server in de sectie “Tools & Integrations”. Daar worden twee tools weergegeven, zoals hieronder.
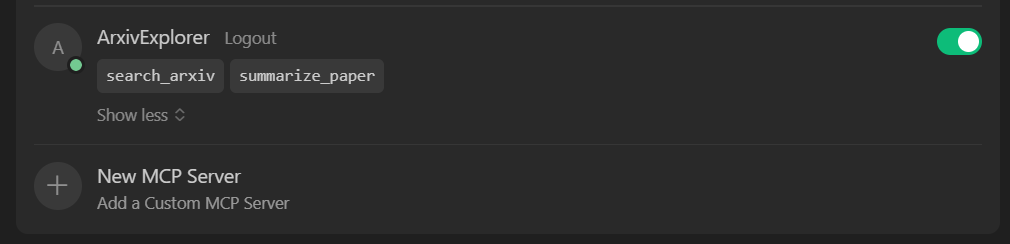
Nu komt het leuke deel. Laten we kijken hoe onze MCP-server presteert met de Cursor AI code-editor. We leren prompts gebruiken om tools aan te roepen, resources te benaderen en aangepaste prompts uit te voeren — allemaal binnen de code-editor.
Begin met controleren of je MCP-server nuttige data kan leveren via zijn resources.
Prompt: “what are the some popular arxiv topics”
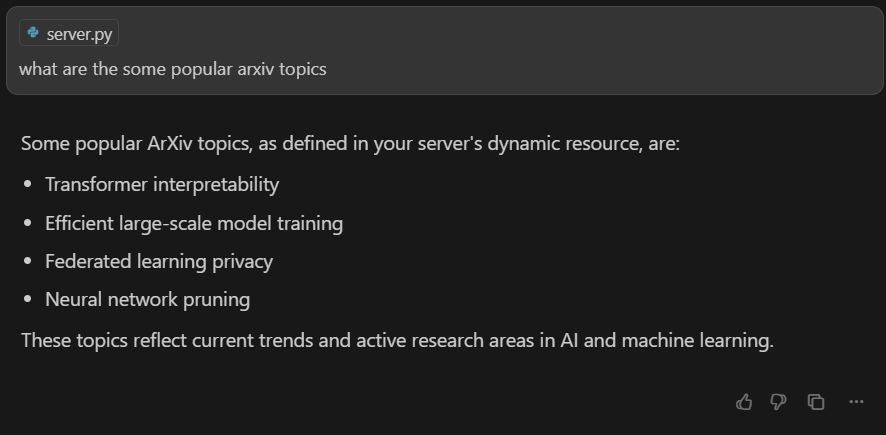
Als alles goed is ingesteld, begrijpt het AI-model je verzoek en haalt het automatisch de lijst met topics op via het resource-endpoint van je MCP-server.
Laten we vervolgens de tools proberen die je via MCP hebt blootgesteld. We testen eerst de tool search_arxiv door het AI-model te vragen de tien beste onderzoeksartikelen over large language models op te sommen.
Prompt: “Please search for the top 10 research papers on large language models.”
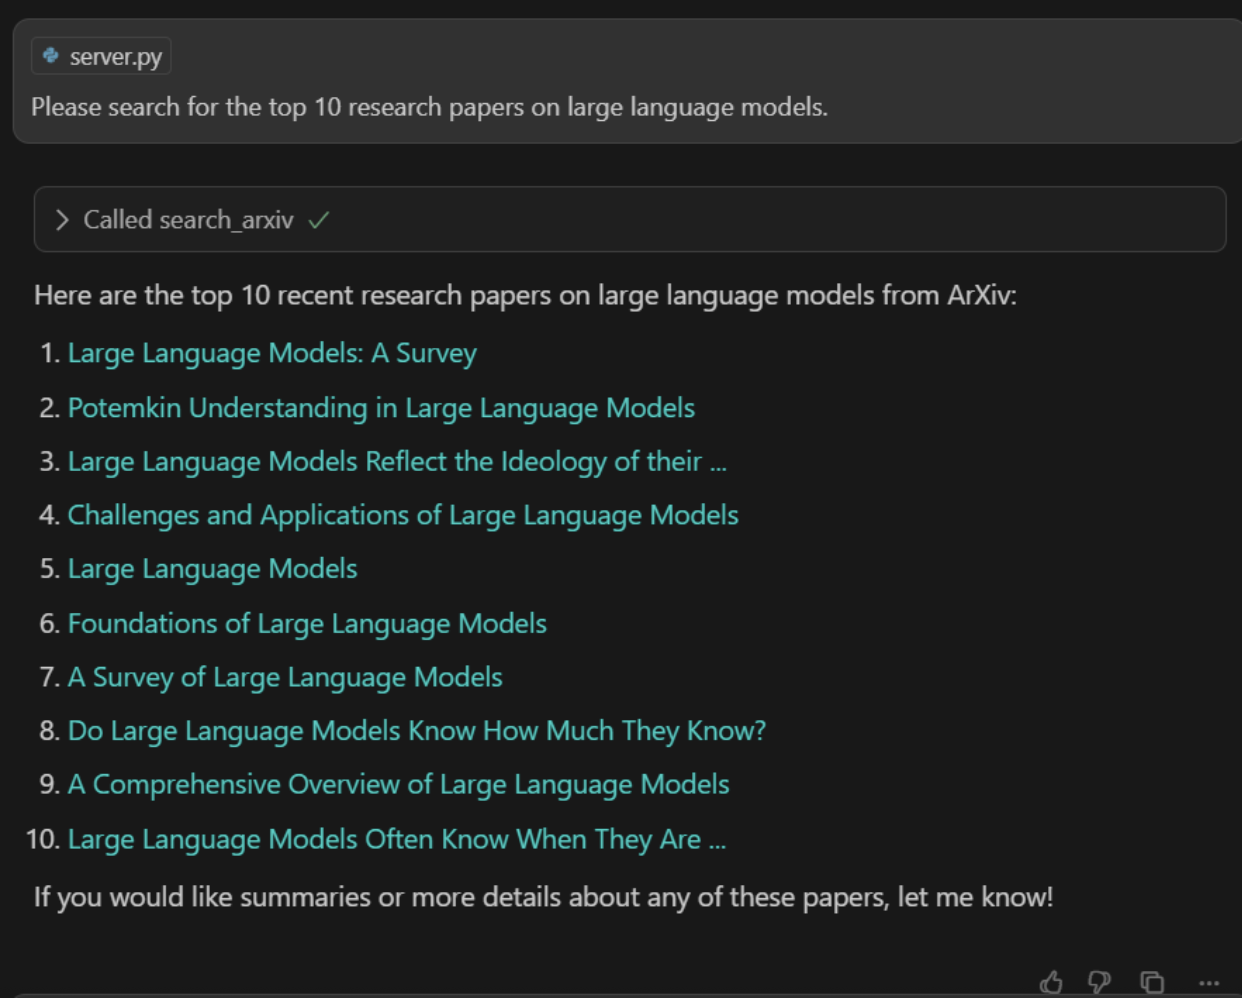
De AI zal de tool search_arxiv aanroepen en je zou snel een nauwkeurige lijst met relevante papers moeten zien, direct opgehaald van arXiv.
Daarna testen we de samenvattingstool die de URL van het onderzoeksartikel neemt en een samenvatting van het rapport oplevert.
Prompt: “Please summarize the following paper for me: https://arxiv.org/abs/2402.06196”
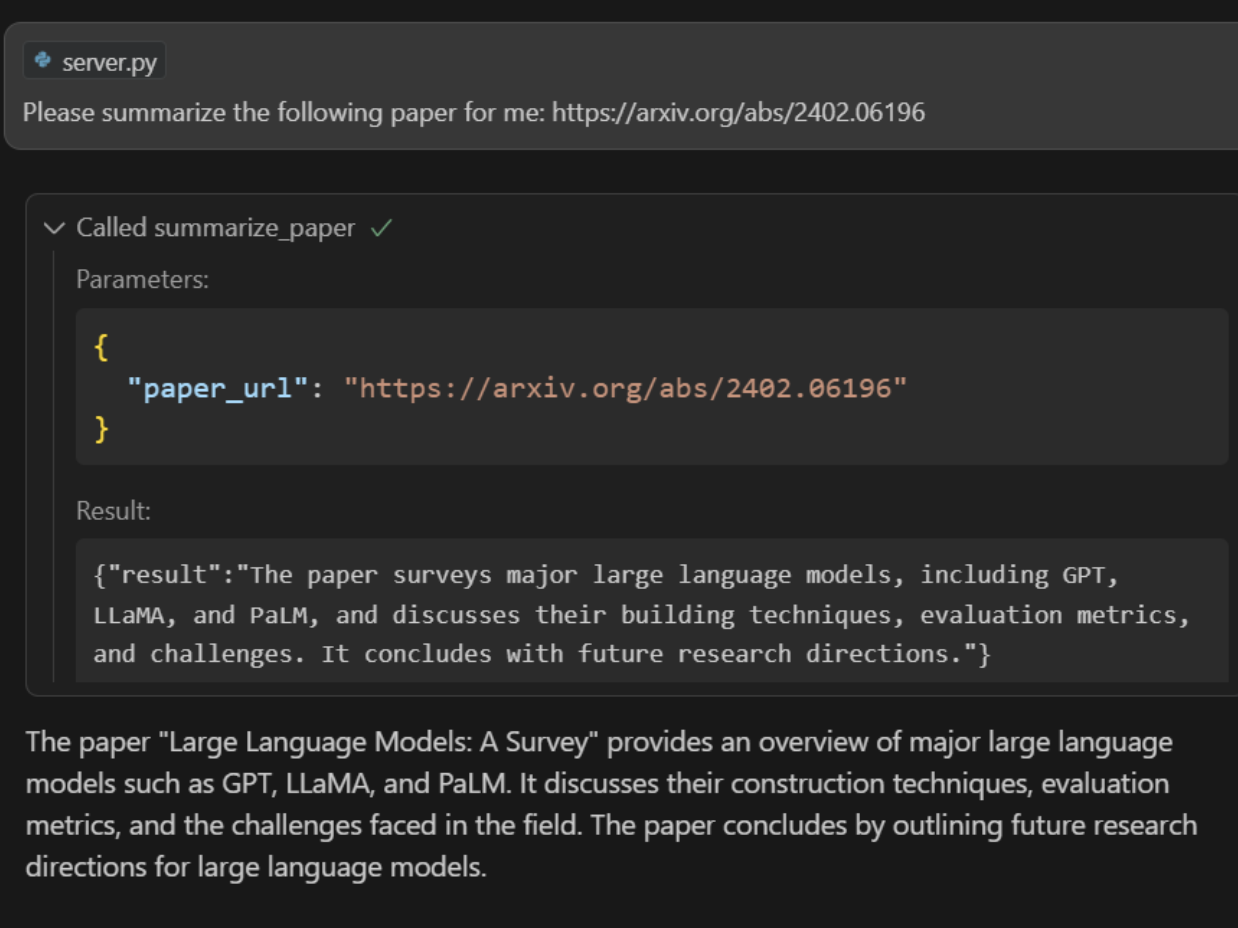
De samenvattingstool haalt het artikel op en geeft een beknopte samenvatting terug.
We roepen nu een aangepaste prompt aan vanuit de MCP die ons helpt een rapport te genereren.
Prompt: “Create a report on Quantum computing using the latest work.”
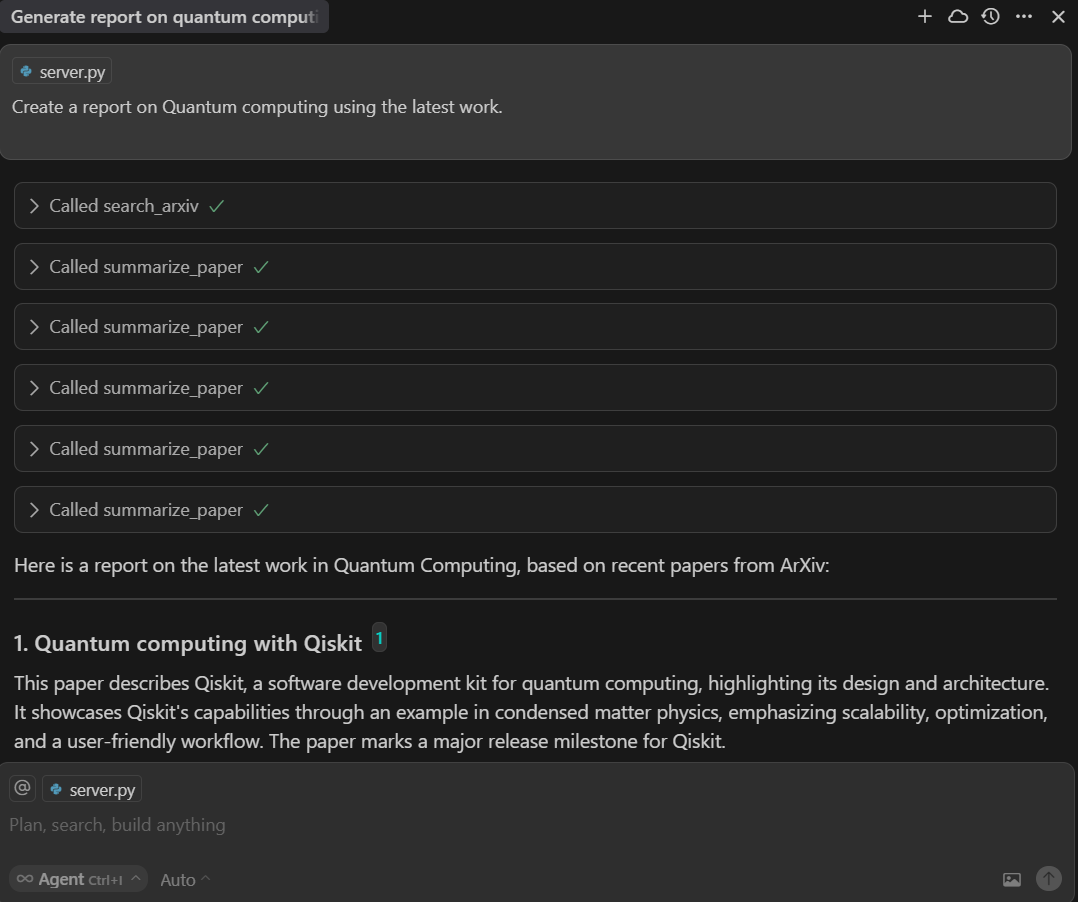
Als je de servercode bekijkt, zie je dat het AI-model de taak begrijpt en de functie explore_topic_prompt gebruikt.
@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )Eerst roept het de tool ‘Search Arxiv’ aan om links naar de papers te vinden.
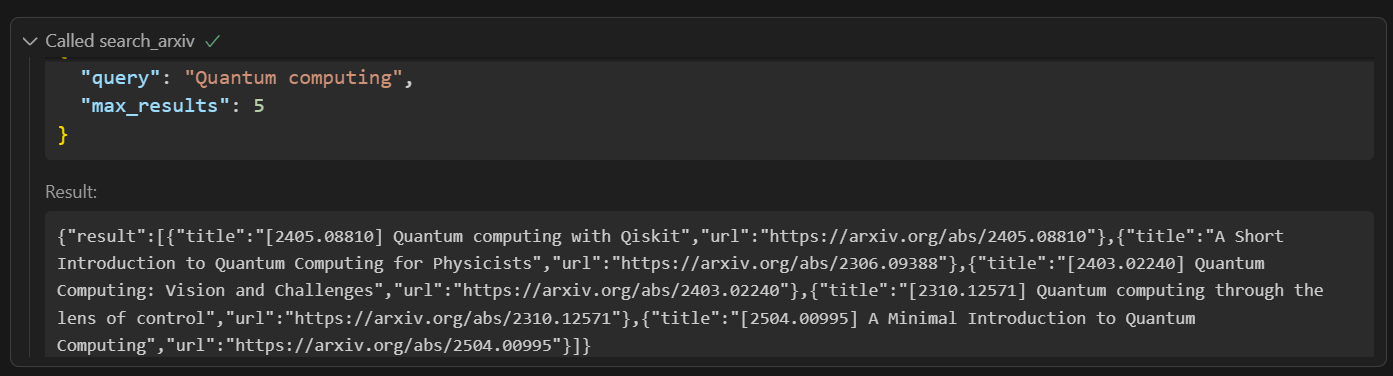
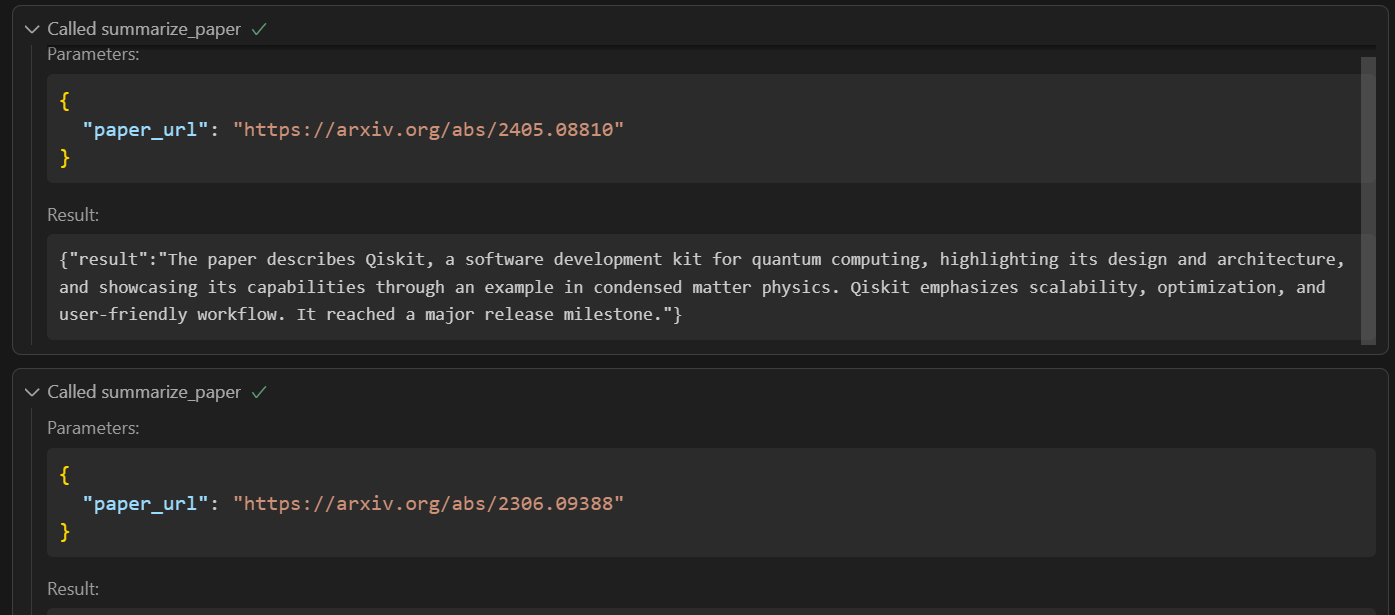
Vervolgens geeft het de links één voor één door aan de tool ‘Summarize Paper’ om de samenvattingen te genereren. Tot slot maak ik het rapport.
FastMCP 2.0 biedt veel meer dan alleen een eenvoudige manier om MCP-servers te maken. Het levert een robuust framework voor het bouwen van veilige, modulaire en schaalbare AI-integraties. Met functies zoals authenticatie, geavanceerde proxying (waarbij één FastMCP-server als frontend kan dienen voor een andere) en de mogelijkheid om meerdere FastMCP-servers te combineren in één toepassing via mounting en importing, kun je moeiteloos complexe, onderhoudbare systemen ontwerpen.
Ondersteuning voor middleware laat je cross-cutting functionaliteit toevoegen, zoals logging of het aanpassen van requests, voor alle MCP-requests en -responses. Je kunt ook logberichten en voortgangsupdates terugsturen naar clients via de MCP-context, zodat je langlopende operaties eenvoudig kunt monitoren en beheren.
In deze tutorial hebben we geleerd hoe je een volledig functionele MCP-server bouwt en de functies test. Deze tools en het MCP-protocol worden essentiële onderdelen van moderne AI-toepassingen, waarmee LLM’s geavanceerdere taken kunnen uitvoeren en workflows effectiever kunnen automatiseren.
Wil je blijven leren over MCP-servers? Bekijk dan zeker onze andere resources:
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

