
Kurs
Multi-Agent Systems mit LangGraph
2 Std. 45 Min.
8.4K
In der KI-Welt ist das Model Context Protocol (MCP) rasant zum Gesprächsthema geworden. MCP ist ein offener Standard, der KI-Modellen wie Claude 4 eine einheitliche Anbindung an externe Tools, Services und Echtzeit-Datenquellen gibt. Diese Verbindung ist ein echter Gamechanger: Große Sprachmodelle (LLMs) liefern damit relevantere, aktuellere und handlungsorientierte Antworten, weil sie die Lücke zwischen KI und bestehenden Systemen schließen.
In diesem Tutorial tauchen wir in FastMCP 2.0 ein – ein leistungsstarkes Framework, mit dem du mit wenigen Zeilen Code deinen eigenen MCP-Server bauen kannst. Wir schauen uns die Kernkomponenten von FastMCP an, erstellen einen MCP-Server und -Client und integrieren beide nahtlos in deinen Workflow. Wenn MCP für dich neu ist, lies zuerst unseren Model Context Protocol Guide mit Demo-Projekt, um die Grundlagen zu verstehen.
FastMCP 2.0 ist ein Open-Source-Python-Framework, das das Erstellen von MCP-Servern und -Clients einfach und effizient macht. Mit wenigen Zeilen Code bauen Entwickler individuelle MCP-Server und verbinden sie mit ihren KI-Anwendungen wie Code-Editoren oder Chatbot-Assistenten.
FastMCP 2.0 ist der Nachfolger von FastMCP 1.0, das heute als MCP Python SDK bekannt ist und ein komplettes Toolkit für das Arbeiten im MCP-Ökosystem bietet.
Was FastMCP 2.0 auszeichnet, ist sein Funktionsumfang, der weit über die MCP-Standardspezifikation hinausgeht. Es vereinfacht Deployment, Authentifizierung, Proxying für Client und Server und kann sogar aus REST-APIs automatisch Server generieren.
FastMCP 2.0 basiert auf drei elementaren Bausteinen: Tools, Resources und Prompts.
Tools sind Python-Funktionen, die über das MCP-Protokoll für LLMs verfügbar gemacht werden. Wenn du eine Funktion mit @mcp.tool dekorierst, kann das KI-Modell sie während einer Unterhaltung aufrufen. So lassen sich echte Aktionen anstoßen, etwa Datenbankabfragen, API-Calls oder Berechnungen.
from fastmcp import FastMCPmcp = FastMCP(name="UtilityServer")@mcp.tooldef convert_usd_to_eur(amount: float, rate: float = 0.91) -> float: """Converts a given amount in USD to EUR using the provided rate.""" return round(amount * rate, 2)Resources geben LLMs oder Client-Anwendungen schreibgeschützten Zugriff auf Daten wie Dateien, Datenbankeinträge, Konfigurationen oder dynamisch erzeugte Inhalte. Zum Beispiel:
from fastmcp import FastMCPmcp = FastMCP(name="WeatherResourceServer")@mcp.resource("config://weather-settings")def get_weather_settings() -> dict: """Provides weather configuration.""" return { "default_units": "metric", "default_location": "Berlin", "features_enabled": ["forecast", "alerts"] }@mcp.resource("resource://welcome-message")def welcome_message() -> str: """Returns a dynamic greeting for users based on time of day.""" from datetime import datetime hour = datetime.now().hour if hour < 12: return "Good morning! Here's your weather update." elif hour < 18: return "Good afternoon! Need a forecast?" else: return "Good evening! Let's check the weather."Prompts sind wiederverwendbare, parametrisierte Nachrichtenvorlagen, die LLM-Antworten steuern. Als Funktionen definiert sorgen sie für konsistente, kontextreiche Anweisungen, die Clients abrufen können.
Sie sind notwendig, um mehrere Tools der Reihe nach auszuführen und das LLM gezielt mit den verfügbaren Tools und Ressourcen arbeiten zu lassen.
from fastmcp import FastMCPfrom fastmcp.prompts.prompt import PromptMessage, TextContentmcp = FastMCP(name="TutorPromptServer")@mcp.promptdef explain_math_concept(concept: str) -> PromptMessage: """Creates a message asking an AI tutor to explain a math concept simply.""" text = f"Can you explain the math concept of '{concept}' in a way that's easy for a 12-year-old to understand?" return PromptMessage(role="user", content=TextContent(type="text", text=text))In diesem Abschnitt bauen wir einen MCP-Server namens "ArXiv Explorer". Er umfasst zwei Tools: Eines extrahiert Links und Titel von Forschungspapieren, das andere fasst die Papers zusammen. Zusätzlich liefern Ressourcen und Prompts die Bausteine für einen umfassenden Report zum gewählten Thema.
Bevor es losgeht, brauchst du einen Tavily-API-Schlüssel. Einen kostenlosen Schlüssel mit 1.000 Anfragen pro Monat bekommst du auf tavily.com. Installiere dann die benötigten Python-Bibliotheken:
pip install fastmcp tavily-pythonZuerst erstellen wir die Server-Python-Datei. Sie enthält:
@mcp.resource-Decorator stellt unsere Funktion arxiv_topics als schreibgeschützte Datenquelle bereit. Ein KI-Client kann diese Topics abrufen, um Ideenvorschläge zu bekommen, falls der Nutzer unschlüssig ist.@mcp.tool-Decorator macht aus normalen Python-Funktionen ausführbare Aktionen für ein LLM.qna_search, das auf direkte, knappe Antworten optimiert ist – ideal für Zusammenfassungen.@mcp.prompt-Decorator erzeugt eine wiederverwendbare Vorlage. Das ist nicht nur ein einfacher Prompt, sondern ein Fahrplan, der dem LLM erklärt, wie es die Server-Tools schrittweise für eine komplexe Aufgabe nutzt.mcp.run(transport="http") ist entscheidend. Statt „stdio“ für lokale Prozesse zu verwenden, startet dies einen Webserver. So kann jeder Client im Netzwerk (oder auf derselben Maschine) per URL verbinden – der Server wird wirklich remote und teilbar.server.py:
import osfrom typing import Dict, Listfrom fastmcp import FastMCPfrom tavily import TavilyClient# --- Configuration ---TAVILY_API_KEY = os.environ.get("TAVILY_API_KEY")if not TAVILY_API_KEY: raise ValueError("Please set the TAVILY_API_KEY environment variable.")tavily = TavilyClient(api_key=TAVILY_API_KEY)mcp = FastMCP(name="ArxivExplorer")print("✅ ArxivExplorer server initialized.")# --- Dynamic Resource: Suggested AI research topics ---@mcp.resource("resource://ai/arxiv_topics")def arxiv_topics() -> List[str]: return [ "Transformer interpretability", "Efficient large-scale model training", "Federated learning privacy", "Neural network pruning", ]print("✅ Resource 'resource://ai/arxiv_topics' registered.")# --- Tool: Search ArXiv for recent papers ---@mcp.tool(annotations={"title": "Search Arxiv"})def search_arxiv(query: str, max_results: int = 5) -> List[Dict]: """ Queries ArXiv via Tavily, returning title + link for each paper, and *only* ArXiv results. """ resp = tavily.search( query=f"site:arxiv.org {query}", max_results=max_results ) return [ {"title": r["title"].strip(), "url": r["url"]} for r in resp.get("results", []) ]# --- Tool: Summarize an ArXiv paper ---@mcp.tool(annotations={"title": "Summarize Paper"})def summarize_paper(paper_url: str) -> str: """ Returns a one-paragraph summary of the paper at the given URL. """ prompt = f"Summarize the key contributions of this ArXiv paper: {paper_url}" return tavily.qna_search(query=prompt)print("✅ Tools 'Search Arxiv' and 'Summarize Paper' registered.")# --- Prompt Template: Explore a topic thoroughly ---@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )print("✅ Prompt 'explore_topic_prompt' registered.")if __name__ == "__main__": print("\n🚀 Starting ArxivExplorer Server...") mcp.run(transport="http")Bevor wir in die KI-Anwendung integrieren, testen wir die MCP-Serverfunktionen und Endpunkte. Dafür stellt FastMCP eine einfache API bereit, um den MCP-Server zu verbinden und alle Funktionen zu prüfen.
Die Client-Datei umfasst:
StreamableHttpTransport ist speziell dafür ausgelegt, sich mit einem im HTTP-Modus laufenden FastMCP-Server zu verbinden.arxiv_topics und korrektes Parsen des Ergebnisses.search_arxiv und Entpacken der Paperliste mit der Hilfsfunktion.summarize_paper übergeben wird.explore_topic_prompt, um die finalen, einsatzbereiten Anweisungen zu sehen, die an ein LLM gehen würden.client.py:
import astimport asyncioimport pprintfrom fastmcp import Clientfrom fastmcp.client.transports import StreamableHttpTransport# --- Configuration ---SERVER_URL = "http://localhost:8000/mcp" # adjust if hosted elsewherepp = pprint.PrettyPrinter(indent=2, width=100)def unwrap_tool_result(resp): """ Safely unwraps the content from a FastMCP tool call result object. """ if hasattr(resp, "content") and resp.content: # The content is a list containing a single content object content_object = resp.content[0] # It could be JSON or plain text if hasattr(content_object, "json"): return content_object.json if hasattr(content_object, "text"): try: # Use ast.literal_eval for safely evaluating a string containing a Python literal return ast.literal_eval(content_object.text) except (ValueError, SyntaxError): # If it's not a literal, return the raw text return content_object.text return respasync def main(): transport = StreamableHttpTransport(url=SERVER_URL) client = Client(transport) print("\n🚀 Connecting to FastMCP server at:", SERVER_URL) async with client: # 1. Ping to test connectivity print("\n🔗 Testing server connectivity...") await client.ping() print("✅ Server is reachable!\n") # 2. Discover server capabilities print("🛠️ Available tools:") pp.pprint(await client.list_tools()) print("\n📚 Available resources:") pp.pprint(await client.list_resources()) print("\n💬 Available prompts:") pp.pprint(await client.list_prompts()) # 3. Fetch the topics resource print("\n\n📖 Fetching resource: resource://ai/arxiv_topics") res = await client.read_resource("resource://ai/arxiv_topics") topics = ast.literal_eval(res[0].text) print("Today's AI topics:") for i, t in enumerate(topics, 1): print(f" {i}. {t}") # 4. Test the search tool print("\n\n🔍 Testing tool: search_arxiv") raw_search = await client.call_tool( "search_arxiv", {"query": "Transformer interpretability", "max_results": 3}, ) search_results = unwrap_tool_result(raw_search) for i, paper in enumerate(search_results, 1): print(f" {i}. {paper['title']}\n {paper['url']}") # 5. Test the summarize tool on the first result if search_results: first_url = search_results[0]["url"] print("\n\n📝 Testing tool: summarize_paper") raw_summary = await client.call_tool( "summarize_paper", {"paper_url": first_url} ) summary = unwrap_tool_result(raw_summary) print("\nSummary of first paper:\n", summary) # 6. Test the prompt generator print("\n\n🚀 Testing prompt: explore_topic_prompt") prompt_resp = await client.get_prompt( "explore_topic_prompt", {"topic": "Transformer interpretability"} ) print("\nGenerated prompt for an LLM:") for msg in prompt_resp.messages: print(f"{msg.role.upper()}: {msg.content.text}\n")if __name__ == "__main__": asyncio.run(main())Alle Dateien und Konfigurationen findest du im GitHub-Repository kingabzpro/FastMCP-Project. Nutze es, falls Probleme auftreten. Eine Anleitung für das lokale Setup ist ebenfalls enthalten.
Jetzt starten wir MCP-Server und -Client.
Zuerst setzt du den Tavily-API-Schlüssel als Umgebungsvariable auf deinem System:
export TAVILY_API_KEY='your_tavily_api_key'Starte dann den Server:
python server.pyNach wenigen Sekunden siehst du, dass der FastMCP-Server unter http://localhost:8000/mcp läuft.
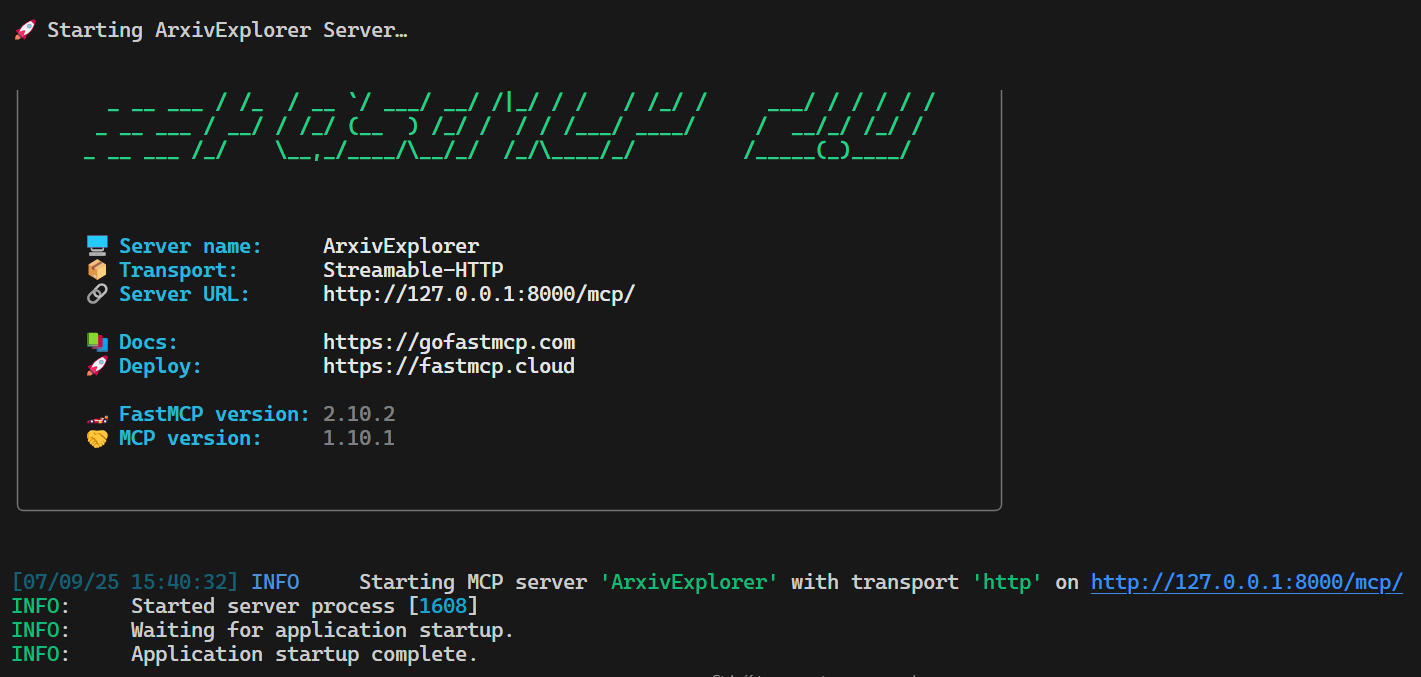
Öffne ein neues Terminal und starte das Client-Skript, um zu prüfen, ob alles korrekt funktioniert:
python client.pyWie du siehst, funktionieren sämtliche Funktionen, Ressourcen, Tools und Prompts einwandfrei. Unser MCP-Server bleibt selbst bei mehreren Tavily-API-Anfragen performant.
🚀 Connecting to FastMCP server at: http://localhost:8000/mcp🔗 Testing server connectivity...✅ Server is reachable!🛠️ Available tools:[ Tool(name='search_arxiv', title='Search Arxiv', description='Queries ArXiv via Tavily, returning title + link for each paper,\nand *only* ArXiv results.', inputSchema={'properties': {'query': {'title': 'Query', 'type': 'string'}, 'max_results': {'default': 5, 'title': 'Max Results', 'type': 'integer'}}, 'required': ['query'], 'type': 'object'}, outputSchema={'properties': {'result': {'items': {'additionalProperties': True, 'type': 'object'}, 'title': 'Result', 'type': 'array'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Search Arxiv', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None), Tool(name='summarize_paper', title='Summarize Paper', description='Returns a one-paragraph summary of the paper at the given URL.', inputSchema={'properties': {'paper_url': {'title': 'Paper Url', 'type': 'string'}}, 'required': ['paper_url'], 'type': 'object'}, outputSchema={'properties': {'result': {'title': 'Result', 'type': 'string'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Summarize Paper', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None)]📚 Available resources:[ Resource(name='arxiv_topics', title=None, uri=AnyUrl('resource://ai/arxiv_topics'), description=None, mimeType='text/plain', size=None, annotations=None, meta=None)]💬 Available prompts:[ Prompt(name='explore_topic_prompt', title=None, description=None, arguments=[PromptArgument(name='topic', description=None, required=True)], meta=None)]📖 Fetching resource: resource://ai/arxiv_topicsToday's AI topics: 1. Transformer interpretability 2. Efficient large-scale model training 3. Federated learning privacy 4. Neural network pruning🔍 Testing tool: search_arxiv 1. Transformer Interpretability Beyond Attention Visualization https://arxiv.org/abs/2012.09838 2. A Practical Review of Mechanistic Interpretability for ... https://arxiv.org/abs/2407.02646 3. Mechanistic Interpretability of Fine-Tuned Vision ... https://arxiv.org/abs/2503.18762📝 Testing tool: summarize_paperSummary of first paper: The paper proposes a novel method for interpreting Transformer networks beyond attention visualization, introducing a new way to compute relevancy. It aims to enhance interpretability in vision tasks. The method is shown to provide more accurate insights into model decisions.🚀 Testing prompt: explore_topic_promptGenerated prompt:USER: type='text' text="I want to explore recent work on 'Transformer interpretability'.\n1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n3. Combine all summaries into an overview report." annotations=None meta=NoneLass den MCP-Server laufen, denn gleich binden wir ihn in den Code-Editor Cursor AI ein.
{ "mcpServers": { "ArxivExplorer": { "url": "http://127.0.0.1:8000/mcp/" } }}Sobald du die mcp.json mit dieser Konfiguration speicherst, erscheint der neue MCP-Server im Bereich „Tools & Integrations“ – inklusive der beiden Tools wie unten gezeigt.
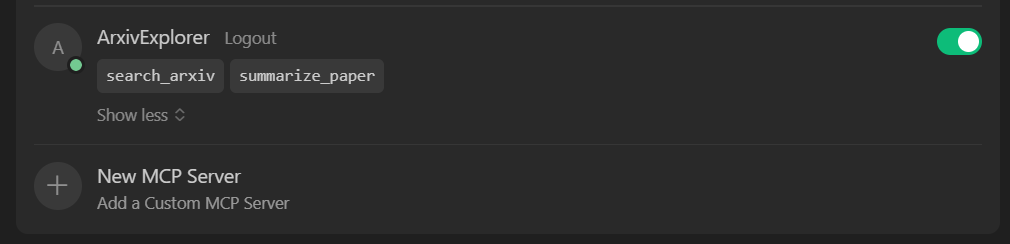
Jetzt kommt der spannende Teil. Schauen wir, wie sich unser MCP-Server im Cursor AI Code-Editor schlägt. Wir rufen Tools per Prompts auf, greifen auf Ressourcen zu und führen Custom-Prompts direkt im Editor aus.
Prüfe zunächst, ob dein MCP-Server über seine Ressourcen nützliche Daten liefern kann.
Prompt: „what are the some popular arxiv topics“
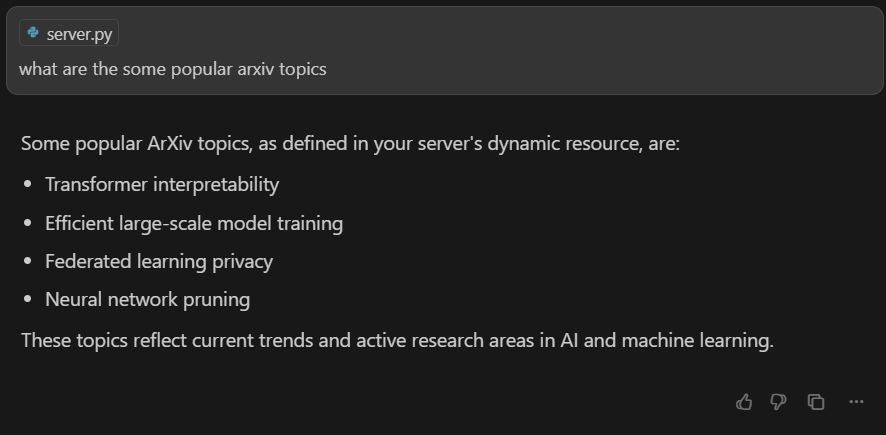
Wenn alles korrekt eingerichtet ist, versteht das KI-Modell deine Anfrage und holt die Liste der Themen automatisch vom Resource-Endpunkt deines MCP-Servers.
Als Nächstes probieren wir die via MCP bereitgestellten Tools aus. Wir testen zuerst das Tool search_arxiv, indem wir das KI-Modell bitten, die zehn wichtigsten Forschungspapiere zu Large Language Models aufzulisten.
Prompt: „Please search for the top 10 research papers on large language models.“
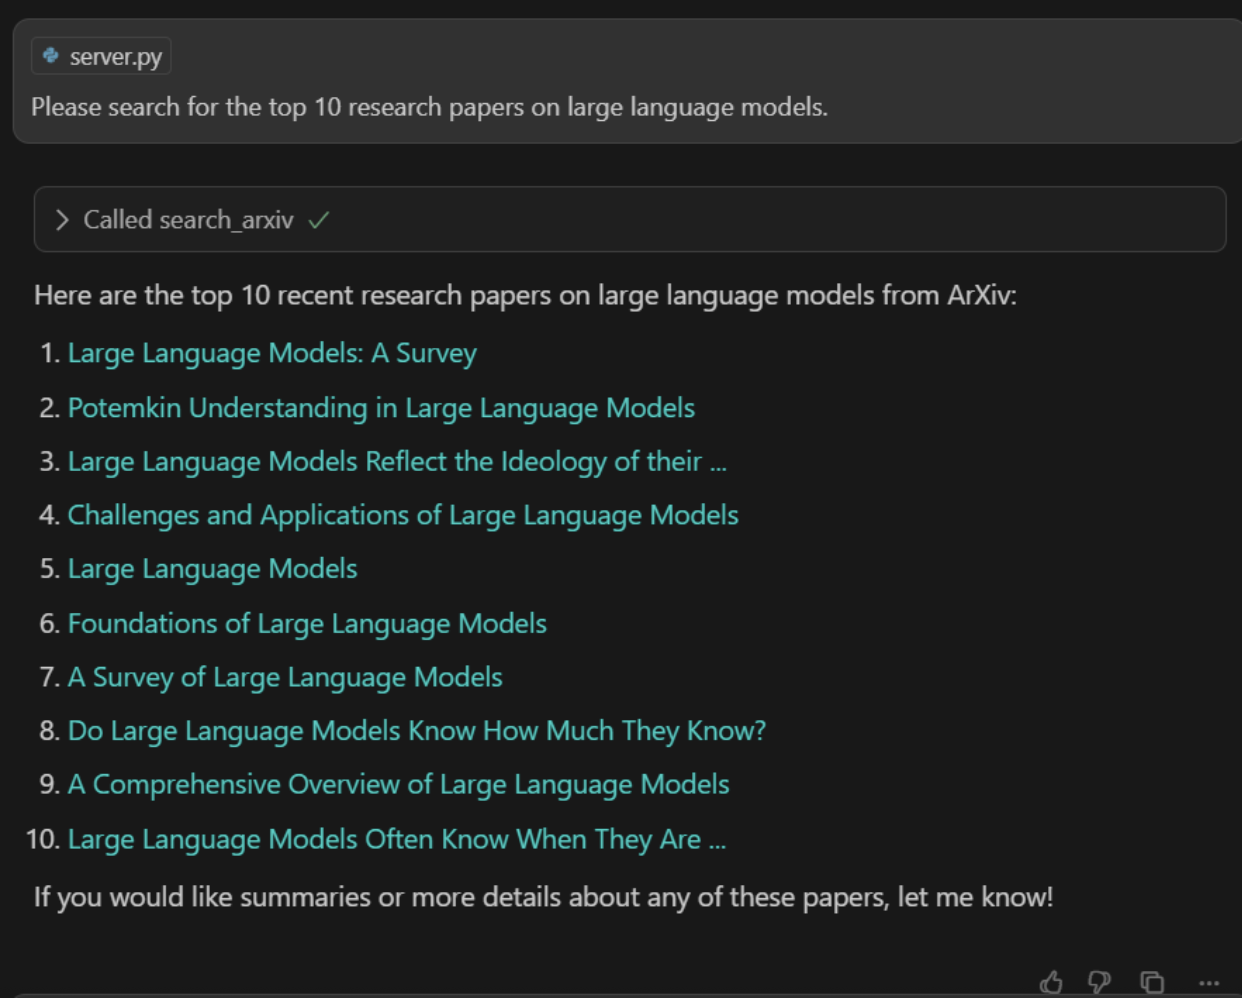
Das KI-System ruft search_arxiv auf, und du solltest eine schnelle, präzise Liste relevanter Papers sehen – direkt von arXiv.
Anschließend testen wir den Zusammenfasser, der die Paper-URL entgegennimmt und eine Kurzfassung liefert.
Prompt: „Please summarize the following paper for me: https://arxiv.org/abs/2402.06196“
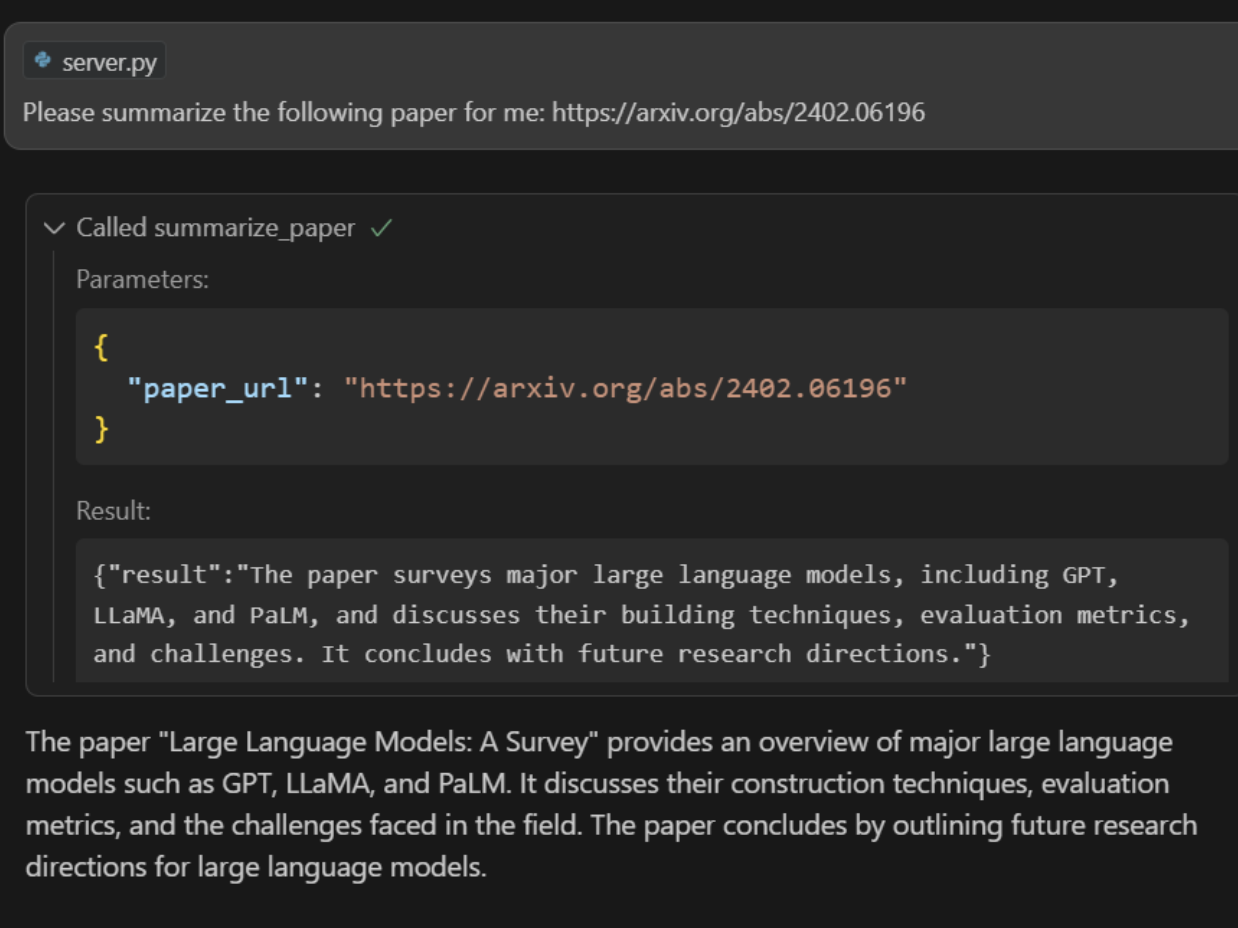
Das Tool ruft das Paper ab und liefert eine prägnante Zusammenfassung.
Jetzt rufen wir einen benutzerdefinierten Prompt aus dem MCP auf, der uns beim Erstellen eines Reports hilft.
Prompt: „Create a report on Quantum computing using the latest work.“
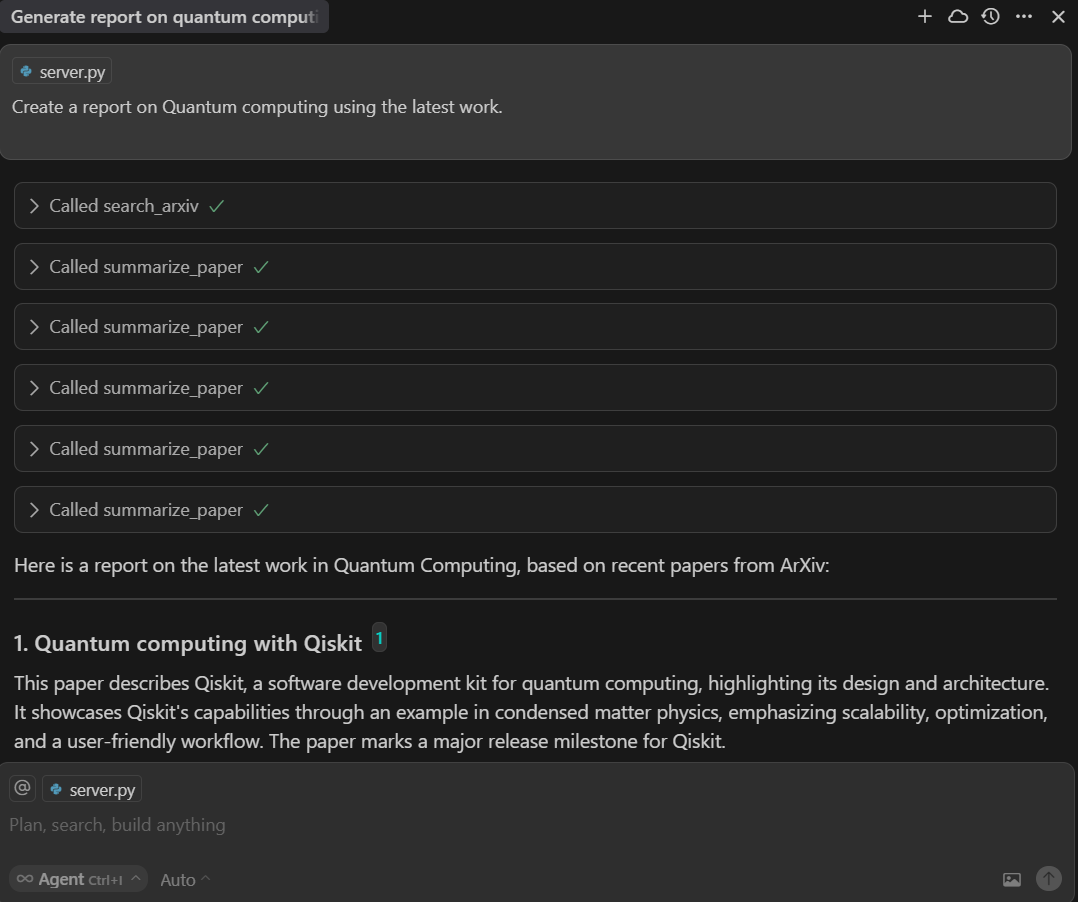
Wenn du den Servercode ansiehst, erkennst du, dass das KI-Modell die Aufgabe versteht und die Funktion explore_topic_prompt nutzt.
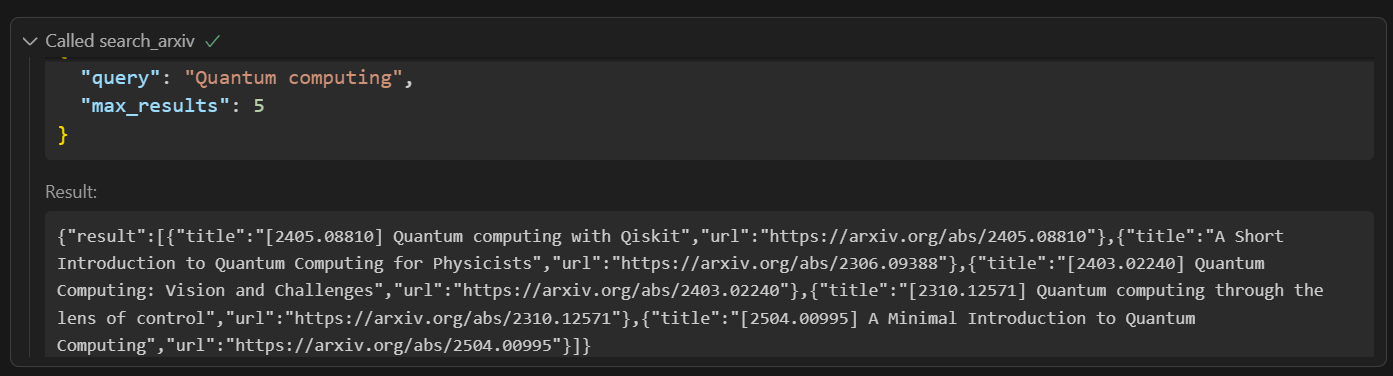
@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )Zuerst ruft es das Tool „Search Arxiv“ auf, um die Paper-Links zu finden.
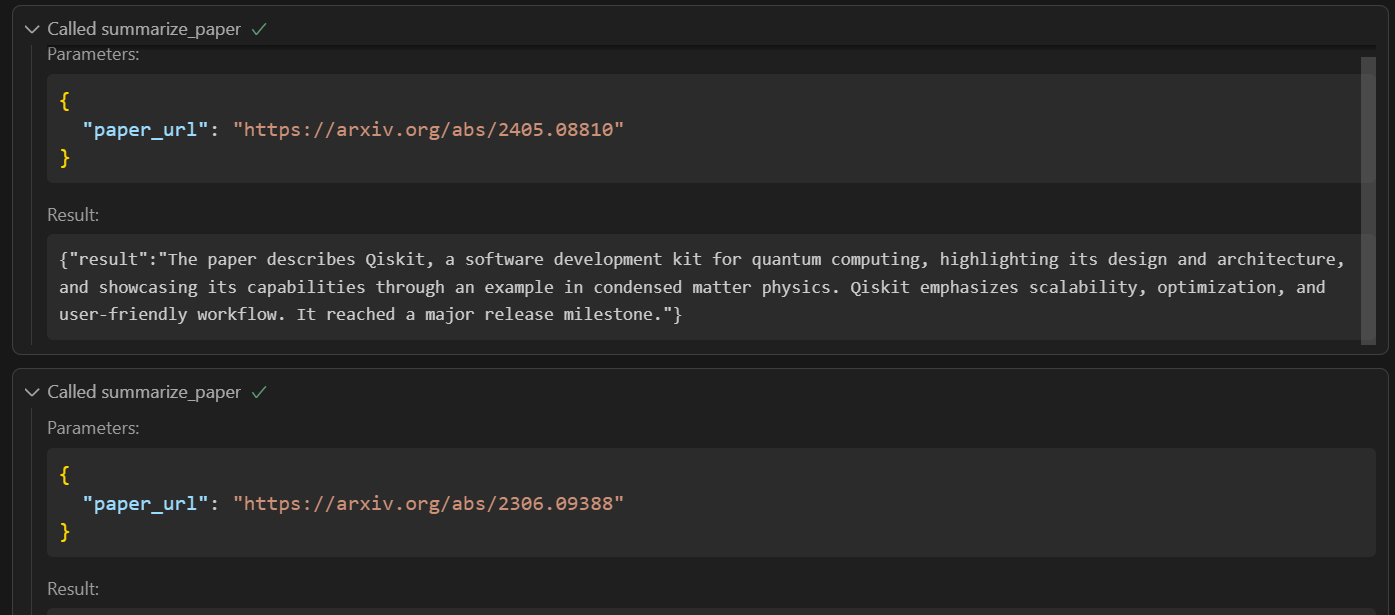
Dann übergibt es die Links nacheinander an „Summarize Paper“, um die Zusammenfassungen zu erzeugen. Zum Schluss entsteht der Report.
FastMCP 2.0 ist weit mehr als nur ein einfacher Weg, MCP-Server zu erstellen. Es ist ein robustes Framework für sichere, modulare und skalierbare KI-Integrationen. Mit Features wie Authentifizierung, fortgeschrittenem Proxying (ein FastMCP-Server kann als Frontend für einen anderen dienen) und der Möglichkeit, mehrere FastMCP-Server per Mounting und Importing zu einer Anwendung zu kombinieren, entwirfst du mühelos komplexe, wartbare Systeme.
Middleware-Unterstützung ermöglicht Querschnittsfunktionen wie Logging oder Request-Anpassungen über alle MCP-Anfragen und -Antworten hinweg. Über den MCP-Kontext kannst du außerdem Logmeldungen und Fortschritts-Updates an Clients senden – ideal, um langlaufende Prozesse zu überwachen und zu steuern.
In diesem Tutorial hast du gelernt, wie man einen voll funktionsfähigen MCP-Server baut und seine Features testet. Diese Tools und das MCP-Protokoll werden zu zentralen Bausteinen moderner KI-Anwendungen, weil sie LLMs zu anspruchsvolleren Aufgaben befähigen und Workflows effizienter automatisieren.
Wenn du weiter über MCP-Server lernen möchtest, schau dir diese Ressourcen an:
Top-DataCamp-Kurse
Kurs
Kurs
Kurs