
कोर्स
LangGraph के साथ Multi-Agent Systems
2 घंटा 45 मिनट
8.8K
AI की दुनिया में Model Context Protocol (MCP) तेज़ी से चर्चा का विषय बना है। MCP एक ओपन स्टैंडर्ड है जो Claude 4 जैसे AI मॉडलों को बाहरी टूल्स, सेवाओं और रियल-टाइम डेटा स्रोतों से जुड़ने का एक सुसंगत तरीका देता है। यह कनेक्टिविटी गेम-चेंजर है, क्योंकि यह बड़े भाषा मॉडल्स (LLMs) को AI और प्रणालियों के बीच की खाई पाटकर अधिक प्रासंगिक, अद्यतन, और क्रियाशील उत्तर देने में सक्षम बनाती है।
इस ट्यूटोरियल में, हम FastMCP 2.0 में गहराई से जाएंगे—एक शक्तिशाली फ़्रेमवर्क जो कुछ पंक्तियों के कोड से अपना MCP सर्वर बनाना आसान बनाता है। हम FastMCP के मुख्य घटकों, MCP सर्वर और क्लाइंट—दोनों—बनाने के तरीके, और उन्हें आपके वर्कफ़्लो में सहजता से एकीकृत करने के बारे में सीखेंगे। यदि आप MCP में नए हैं, तो अधिक जानने के लिए हमारा Model Context Protocol गाइड और डेमो प्रोजेक्ट देखें।
FastMCP 2.0 एक ओपन-सोर्स Python फ़्रेमवर्क है, जिसे Model Context Protocol (MCP) सर्वर और क्लाइंट को सरल और दक्षतापूर्वक बनाने के लिए डिज़ाइन किया गया है। कुछ पंक्तियों के कोड से, डेवलपर कस्टम MCP सर्वर बना सकते हैं और उन्हें अपने AI अनुप्रयोगों, जैसे कोड एडिटर्स या चैटबॉट असिस्टेंट्स, से जोड़ सकते हैं।
FastMCP 2.0, FastMCP 1.0 का उत्तराधिकारी है, जिसे अब MCP Python SDK के नाम से जाना जाता है, और यह MCP इकोसिस्टम के भीतर काम करने के लिए एक पूर्ण टूलकिट प्रदान करता है।
FastMCP 2.0 को जो अलग बनाता है, वह इसका व्यापक फ़ीचर सेट है जो कोर MCP स्पेसिफ़िकेशन से कहीं आगे जाता है। यह डिप्लॉयमेंट, ऑथेंटिकेशन, क्लाइंट और सर्वर प्रॉक्सिइंग को सरल करता है, और यहाँ तक कि REST APIs से सर्वर जनरेट करने की सुविधा भी देता है।
FastMCP 2.0 तीन आवश्यक घटकों पर आधारित है: टूल्स, रिसोर्सेज, और प्रॉम्प्ट्स।
टूल्स वे Python फ़ंक्शंस हैं जो MCP प्रोटोकॉल के माध्यम से LLMs को उपलब्ध कराए जाते हैं। किसी फ़ंक्शन को @mcp.tool से डेकोरेट करने पर, आप AI मॉडल को बातचीत के दौरान उसे कॉल करने की अनुमति देते हैं। इससे LLMs वास्तविक दुनिया की कार्रवाइयाँ कर सकते हैं, जैसे डेटाबेस क्वेरी करना, APIs कॉल करना, या कैलकुलेशन चलाना।
from fastmcp import FastMCPmcp = FastMCP(name="UtilityServer")@mcp.tooldef convert_usd_to_eur(amount: float, rate: float = 0.91) -> float: """Converts a given amount in USD to EUR using the provided rate.""" return round(amount * rate, 2)रिसोर्सेज LLMs या क्लाइंट अनुप्रयोगों को डेटा—जैसे फ़ाइलें, डेटाबेस रिकॉर्ड्स, कॉन्फ़िगरेशन, या डायनामिक रूप से उत्पन्न सामग्री—तक केवल-पढ़ने की पहुँच प्रदान करते हैं। उदाहरण के लिए:
from fastmcp import FastMCPmcp = FastMCP(name="WeatherResourceServer")@mcp.resource("config://weather-settings")def get_weather_settings() -> dict: """Provides weather configuration.""" return { "default_units": "metric", "default_location": "Berlin", "features_enabled": ["forecast", "alerts"] }@mcp.resource("resource://welcome-message")def welcome_message() -> str: """Returns a dynamic greeting for users based on time of day.""" from datetime import datetime hour = datetime.now().hour if hour < 12: return "Good morning! Here's your weather update." elif hour < 18: return "Good afternoon! Need a forecast?" else: return "Good evening! Let's check the weather."प्रॉम्प्ट्स पुन: उपयोग योग्य, पैरामीटरयुक्त मैसेज टेम्पलेट होते हैं जो LLM के उत्तरों का मार्गदर्शन करते हैं। प्रॉम्प्ट्स को फ़ंक्शंस के रूप में परिभाषित करने से, आप सुसंगत, संदर्भ-समृद्ध निर्देश सुनिश्चित करते हैं जिन्हें क्लाइंट द्वारा कॉल किया जा सकता है।
ये एक के बाद एक कई टूल्स चलाने और उपलब्ध टूल्स व रिसोर्सेज का उपयोग करके LLM को कुछ कार्य करवाने के लिए आवश्यक होते हैं।
from fastmcp import FastMCPfrom fastmcp.prompts.prompt import PromptMessage, TextContentmcp = FastMCP(name="TutorPromptServer")@mcp.promptdef explain_math_concept(concept: str) -> PromptMessage: """Creates a message asking an AI tutor to explain a math concept simply.""" text = f"Can you explain the math concept of '{concept}' in a way that's easy for a 12-year-old to understand?" return PromptMessage(role="user", content=TextContent(type="text", text=text))इस खंड में, हम एक "ArXiv Explorer" MCP सर्वर बनाएँगे। यह सर्वर दो टूल्स से बना होगा: एक शोध-पत्रों के लिंक और शीर्षक निकालने के लिए, और दूसरा शोध-पत्रों का सारांश बनाने के लिए। इन टूल्स के अलावा, सर्वर में रिसोर्सेज और प्रॉम्प्ट्स भी होंगे जो चुने हुए विषय पर एक व्यापक रिपोर्ट तैयार करने में मदद करेंगे।
शुरू करने से पहले, आपको Tavily API कुंजी प्राप्त करनी होगी। आप tavily.com पर 1,000 मासिक अनुरोधों के साथ एक निःशुल्क कुंजी प्राप्त कर सकते हैं। फिर आवश्यक Python लाइब्रेरीज़ इंस्टॉल करें:
pip install fastmcp tavily-pythonहम पहले सर्वर का Python फ़ाइल बनाएँगे। फ़ाइल में ये भाग होंगे:
@mcp.resource डेकोरेटर हमारी arxiv_topics फ़ंक्शन को read-only डेटा स्रोत के रूप में एक्सपोज़ करता है। यदि उपयोगकर्ता सुनिश्चित न हो, तो AI क्लाइंट इन विषयों को शोध के लिए विचार पाने हेतु ला सकता है।@mcp.tool डेकोरेटर सामान्य Python फ़ंक्शंस को ऐसे एक्शन्स में बदल देता है जिन्हें कोई LLM निष्पादित कर सकता है।qna_search का उपयोग करता है, जो सीधे, संक्षिप्त उत्तर देने के लिए अनुकूलित है—सारांश बनाने के लिए उपयुक्त।@mcp.prompt डेकोरेटर एक पुन: उपयोग योग्य टेम्पलेट बनाता है। यह केवल साधारण प्रॉम्प्ट नहीं है; यह एक रणनीतिक योजना है जो किसी जटिल कार्य को करने के लिए सर्वर के टूल्स का क्रम में उपयोग करने हेतु LLM को निर्देश देती है।mcp.run(transport="http") एक अहम पंक्ति है। “stdio” का स्थानीय प्रक्रियाओं के लिए उपयोग करने के बजाय, यह एक वेब सर्वर शुरू करता है। इससे नेटवर्क पर (या उसी मशीन पर) कोई भी क्लाइंट URL के माध्यम से हमारे सर्वर से जुड़ सकता है, जिससे यह सचमुच रिमोट और साझा करने योग्य टूल बन जाता है।server.py:
import osfrom typing import Dict, Listfrom fastmcp import FastMCPfrom tavily import TavilyClient# --- Configuration ---TAVILY_API_KEY = os.environ.get("TAVILY_API_KEY")if not TAVILY_API_KEY: raise ValueError("Please set the TAVILY_API_KEY environment variable.")tavily = TavilyClient(api_key=TAVILY_API_KEY)mcp = FastMCP(name="ArxivExplorer")print("✅ ArxivExplorer server initialized.")# --- Dynamic Resource: Suggested AI research topics ---@mcp.resource("resource://ai/arxiv_topics")def arxiv_topics() -> List[str]: return [ "Transformer interpretability", "Efficient large-scale model training", "Federated learning privacy", "Neural network pruning", ]print("✅ Resource 'resource://ai/arxiv_topics' registered.")# --- Tool: Search ArXiv for recent papers ---@mcp.tool(annotations={"title": "Search Arxiv"})def search_arxiv(query: str, max_results: int = 5) -> List[Dict]: """ Queries ArXiv via Tavily, returning title + link for each paper, and *only* ArXiv results. """ resp = tavily.search( query=f"site:arxiv.org {query}", max_results=max_results ) return [ {"title": r["title"].strip(), "url": r["url"]} for r in resp.get("results", []) ]# --- Tool: Summarize an ArXiv paper ---@mcp.tool(annotations={"title": "Summarize Paper"})def summarize_paper(paper_url: str) -> str: """ Returns a one-paragraph summary of the paper at the given URL. """ prompt = f"Summarize the key contributions of this ArXiv paper: {paper_url}" return tavily.qna_search(query=prompt)print("✅ Tools 'Search Arxiv' and 'Summarize Paper' registered.")# --- Prompt Template: Explore a topic thoroughly ---@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )print("✅ Prompt 'explore_topic_prompt' registered.")if __name__ == "__main__": print("\n🚀 Starting ArxivExplorer Server...") mcp.run(transport="http")AI अनुप्रयोग में एकीकृत करने से पहले हमें MCP सर्वर की विशेषताओं और एंडपॉइंट्स का परीक्षण करना होगा। इसके लिए, FastMCP ने MCP सर्वर से कनेक्ट करने और उसके सभी फ़ंक्शंस का परीक्षण करने हेतु एक सरल API दिया है।
क्लाइंट फ़ाइल में ये भाग होते हैं:
StreamableHttpTransport विशेष रूप से HTTP मोड में चल रहे FastMCP सर्वर से कनेक्ट होने के लिए डिज़ाइन किया गया है।arxiv_topics रिसोर्स पढ़ता है और परिणाम को सही ढंग से पार्स करता है।search_arxiv टूल को कॉल करता है और सहायक फ़ंक्शन का उपयोग करके पेपर्स की सूची अनरैप करता है।summarize_paper टूल को पास करके टूल्स की चेनिंग करता है।explore_topic_prompt प्राप्त करता है, जो LLM को भेजे जाने वाले अंतिम, उपयोग-के-लिए-तैयार निर्देश दिखाता है।client.py:
import astimport asyncioimport pprintfrom fastmcp import Clientfrom fastmcp.client.transports import StreamableHttpTransport# --- Configuration ---SERVER_URL = "http://localhost:8000/mcp" # adjust if hosted elsewherepp = pprint.PrettyPrinter(indent=2, width=100)def unwrap_tool_result(resp): """ Safely unwraps the content from a FastMCP tool call result object. """ if hasattr(resp, "content") and resp.content: # The content is a list containing a single content object content_object = resp.content[0] # It could be JSON or plain text if hasattr(content_object, "json"): return content_object.json if hasattr(content_object, "text"): try: # Use ast.literal_eval for safely evaluating a string containing a Python literal return ast.literal_eval(content_object.text) except (ValueError, SyntaxError): # If it's not a literal, return the raw text return content_object.text return respasync def main(): transport = StreamableHttpTransport(url=SERVER_URL) client = Client(transport) print("\n🚀 Connecting to FastMCP server at:", SERVER_URL) async with client: # 1. Ping to test connectivity print("\n🔗 Testing server connectivity...") await client.ping() print("✅ Server is reachable!\n") # 2. Discover server capabilities print("🛠️ Available tools:") pp.pprint(await client.list_tools()) print("\n📚 Available resources:") pp.pprint(await client.list_resources()) print("\n💬 Available prompts:") pp.pprint(await client.list_prompts()) # 3. Fetch the topics resource print("\n\n📖 Fetching resource: resource://ai/arxiv_topics") res = await client.read_resource("resource://ai/arxiv_topics") topics = ast.literal_eval(res[0].text) print("Today's AI topics:") for i, t in enumerate(topics, 1): print(f" {i}. {t}") # 4. Test the search tool print("\n\n🔍 Testing tool: search_arxiv") raw_search = await client.call_tool( "search_arxiv", {"query": "Transformer interpretability", "max_results": 3}, ) search_results = unwrap_tool_result(raw_search) for i, paper in enumerate(search_results, 1): print(f" {i}. {paper['title']}\n {paper['url']}") # 5. Test the summarize tool on the first result if search_results: first_url = search_results[0]["url"] print("\n\n📝 Testing tool: summarize_paper") raw_summary = await client.call_tool( "summarize_paper", {"paper_url": first_url} ) summary = unwrap_tool_result(raw_summary) print("\nSummary of first paper:\n", summary) # 6. Test the prompt generator print("\n\n🚀 Testing prompt: explore_topic_prompt") prompt_resp = await client.get_prompt( "explore_topic_prompt", {"topic": "Transformer interpretability"} ) print("\nGenerated prompt for an LLM:") for msg in prompt_resp.messages: print(f"{msg.role.upper()}: {msg.content.text}\n")if __name__ == "__main__": asyncio.run(main())सभी फ़ाइलें और कॉन्फ़िगरेशन kingabzpro/FastMCP-Project GitHub रिपॉज़िटरी में उपलब्ध हैं। यदि आप किसी समस्या का सामना कर रहे हैं तो आप इसका उपयोग कर सकते हैं। मैंने इसे लोकली चलाने के लिए सेटअप गाइड भी शामिल किया है।
अब हम MCP सर्वर और क्लाइंट—दोनों—चलाएँगे।
सबसे पहले, अपने लोकल सिस्टम पर Tavily API कुंजी को एक environment variable के रूप में सेट करें:
export TAVILY_API_KEY='your_tavily_api_key'इसके बाद, सर्वर चलाएँ:
python server.pyकुछ ही सेकंड में, आप देखेंगे कि FastMCP सर्वर http://localhost:8000/mcp पर चल रहा है।
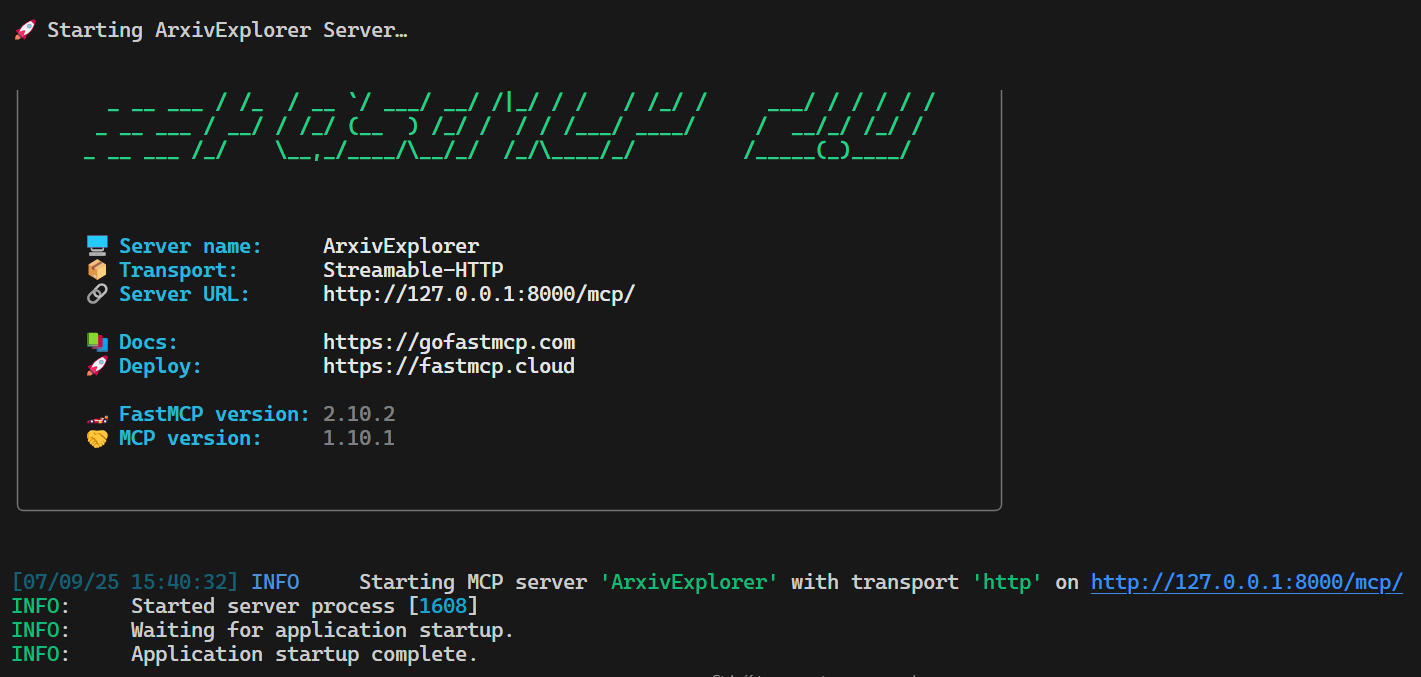
एक नया टर्मिनल खोलें और यह जाँचना करने के लिए क्लाइंट स्क्रिप्ट चलाएँ कि सब कुछ ठीक से काम कर रहा है:
python client.pyजैसा कि हम देख सकते हैं, सभी फ़ंक्शंस, रिसोर्सेज, टूल्स और प्रॉम्प्ट्स पूरी तरह काम कर रहे हैं। हमारा MCP सर्वर, कई Tavily API अनुरोधों के साथ भी, अच्छा प्रदर्शन कर रहा है।
🚀 Connecting to FastMCP server at: http://localhost:8000/mcp🔗 Testing server connectivity...✅ Server is reachable!🛠️ Available tools:[ Tool(name='search_arxiv', title='Search Arxiv', description='Queries ArXiv via Tavily, returning title + link for each paper,\nand *only* ArXiv results.', inputSchema={'properties': {'query': {'title': 'Query', 'type': 'string'}, 'max_results': {'default': 5, 'title': 'Max Results', 'type': 'integer'}}, 'required': ['query'], 'type': 'object'}, outputSchema={'properties': {'result': {'items': {'additionalProperties': True, 'type': 'object'}, 'title': 'Result', 'type': 'array'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Search Arxiv', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None), Tool(name='summarize_paper', title='Summarize Paper', description='Returns a one-paragraph summary of the paper at the given URL.', inputSchema={'properties': {'paper_url': {'title': 'Paper Url', 'type': 'string'}}, 'required': ['paper_url'], 'type': 'object'}, outputSchema={'properties': {'result': {'title': 'Result', 'type': 'string'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Summarize Paper', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None)]📚 Available resources:[ Resource(name='arxiv_topics', title=None, uri=AnyUrl('resource://ai/arxiv_topics'), description=None, mimeType='text/plain', size=None, annotations=None, meta=None)]💬 Available prompts:[ Prompt(name='explore_topic_prompt', title=None, description=None, arguments=[PromptArgument(name='topic', description=None, required=True)], meta=None)]📖 Fetching resource: resource://ai/arxiv_topicsToday's AI topics: 1. Transformer interpretability 2. Efficient large-scale model training 3. Federated learning privacy 4. Neural network pruning🔍 Testing tool: search_arxiv 1. Transformer Interpretability Beyond Attention Visualization https://arxiv.org/abs/2012.09838 2. A Practical Review of Mechanistic Interpretability for ... https://arxiv.org/abs/2407.02646 3. Mechanistic Interpretability of Fine-Tuned Vision ... https://arxiv.org/abs/2503.18762📝 Testing tool: summarize_paperSummary of first paper: The paper proposes a novel method for interpreting Transformer networks beyond attention visualization, introducing a new way to compute relevancy. It aims to enhance interpretability in vision tasks. The method is shown to provide more accurate insights into model decisions.🚀 Testing prompt: explore_topic_promptGenerated prompt:USER: type='text' text="I want to explore recent work on 'Transformer interpretability'.\n1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n3. Combine all summaries into an overview report." annotations=None meta=NoneMCP सर्वर को चालू रखें, क्योंकि हम इसे Cursor AI कोड एडिटर में एकीकृत करने वाले हैं।
{ "mcpServers": { "ArxivExplorer": { "url": "http://127.0.0.1:8000/mcp/" } }}उपरोक्त कॉन्फ़िगरेशन के साथ mcp.json फ़ाइल सहेजने के बाद, आपको “Tools & Integrations” अनुभाग में नया MCP सर्वर सूचीबद्ध दिखेगा, जिसमें नीचे दिखाए अनुसार दो टूल्स प्रदर्शित होंगे।
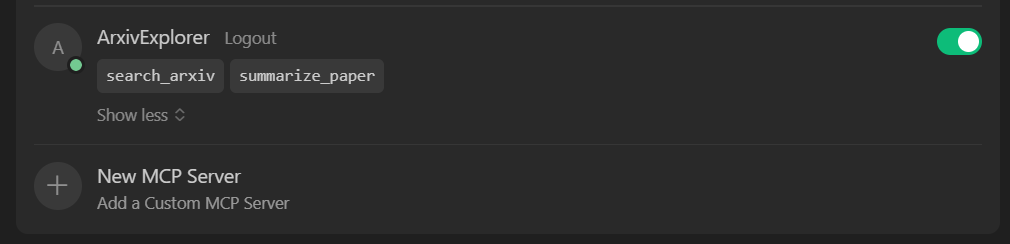
अब मज़ेदार हिस्सा आता है। देखें कि हमारा MCP सर्वर Cursor AI कोड एडिटर के साथ कैसा प्रदर्शन करता है। हम सीखेंगे कि एडिटर के भीतर ही प्रॉम्प्ट्स का उपयोग करके टूल्स कैसे चलाएँ, रिसोर्सेज तक पहुँचें, और कस्टम प्रॉम्प्ट्स निष्पादित करें।
यह जाँचकर शुरू करें कि आपका MCP सर्वर अपने रिसोर्सेज के माध्यम से उपयोगी डेटा प्रदान कर सकता है या नहीं।
Prompt: “what are the some popular arxiv topics”
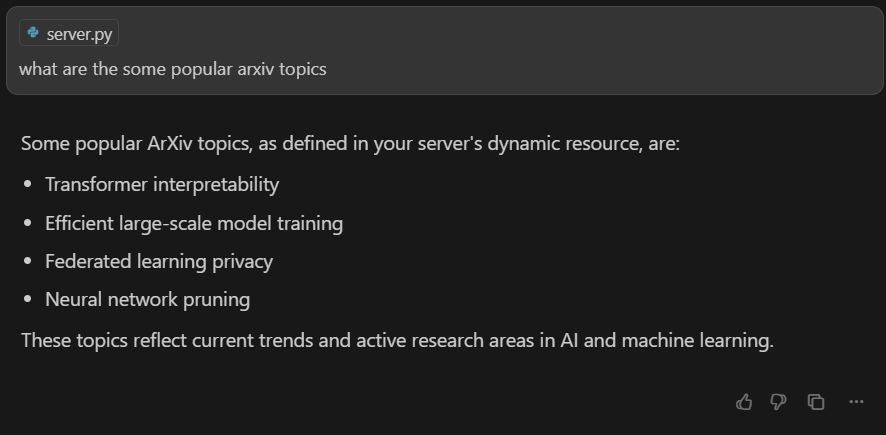
यदि सब कुछ सही से सेट है, तो AI मॉडल आपकी रिक्वेस्ट समझेगा और अपने आप MCP सर्वर के रिसोर्स एंडपॉइंट से विषयों की सूची प्राप्त कर लेगा।
अब, MCP के माध्यम से एक्सपोज़ किए गए टूल्स आज़माएँ। सबसे पहले हम search_arxiv टूल का परीक्षण करेंगे, AI मॉडल से बड़े भाषा मॉडलों पर शीर्ष दस शोध-पत्रों की सूची माँगकर।
Prompt: “Please search for the top 10 research papers on large language models.”
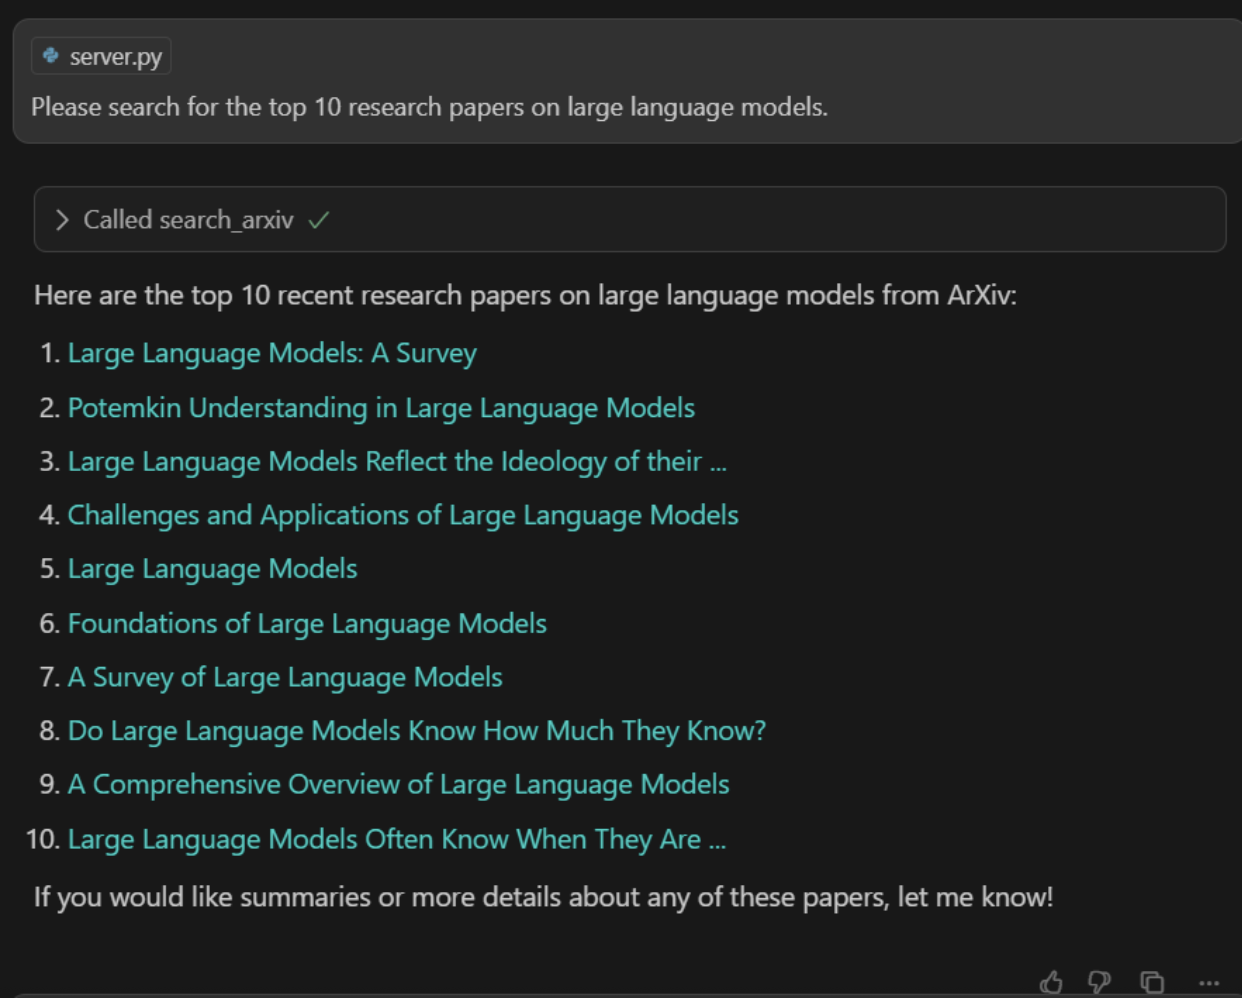
AI search_arxiv टूल को कॉल करेगा, और आपको arXiv से सीधे खींची गई प्रासंगिक पेपर्स की तेज़, सटीक सूची दिखनी चाहिए।
इसके बाद, हम summarizer टूल का परीक्षण करेंगे जो शोध-पत्र के URL को लेकर रिपोर्ट का सारांश लौटाता है।
Prompt: “Please summarize the following paper for me: https://arxiv.org/abs/2402.06196”
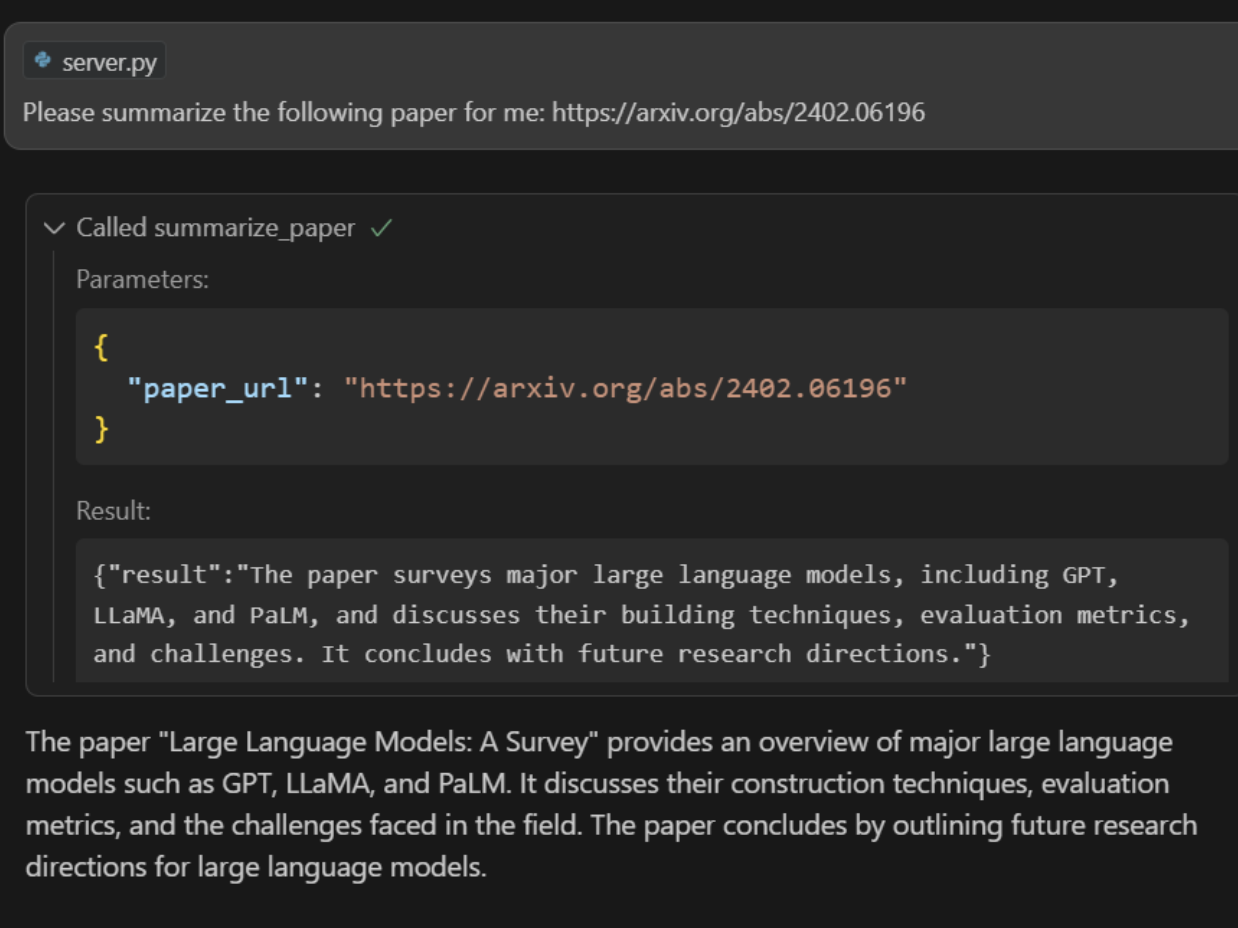
Summarizer टूल पेपर को फ़ेच करेगा और एक संक्षिप्त सारांश लौटाएगा।
अब हम MCP से एक कस्टम प्रॉम्प्ट कॉल करेंगे जो हमें रिपोर्ट जनरेट करने में मदद करेगा।
Prompt: “Create a report on Quantum computing using the latest work.”
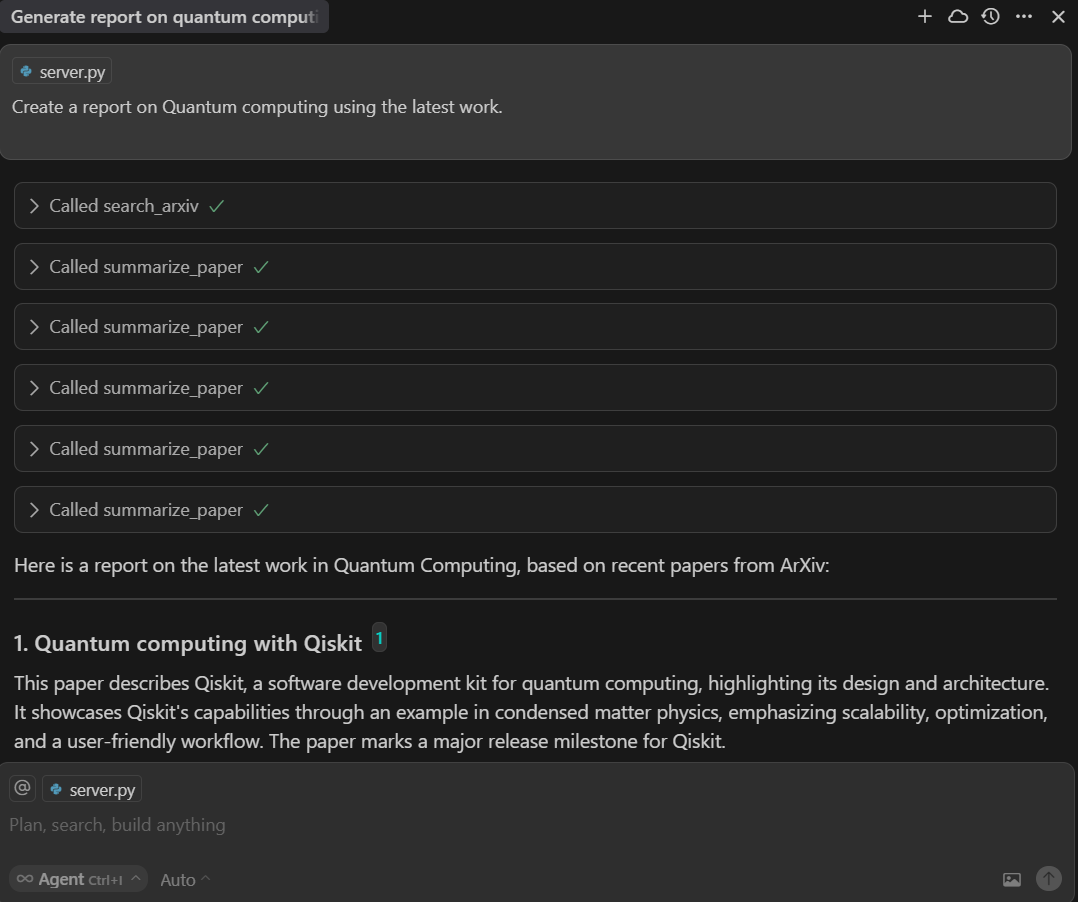
यदि आप सर्वर कोड देखें, तो आप पाएँगे कि AI मॉडल कार्य समझता है और explore_topic_prompt फ़ंक्शन का उपयोग करता है।
@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )सबसे पहले, यह पेपर्स के लिंक खोजने के लिए 'Search Arxiv' टूल को कॉल करेगा।
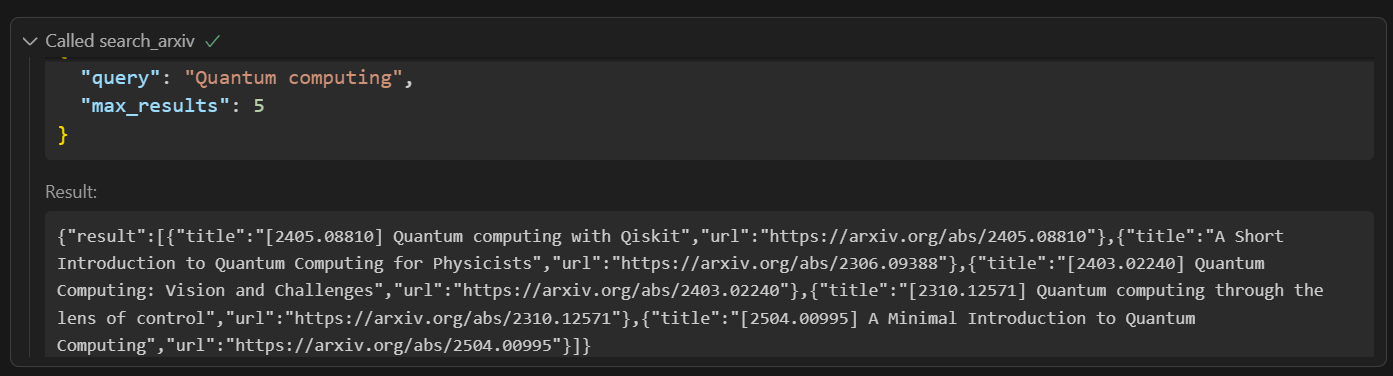
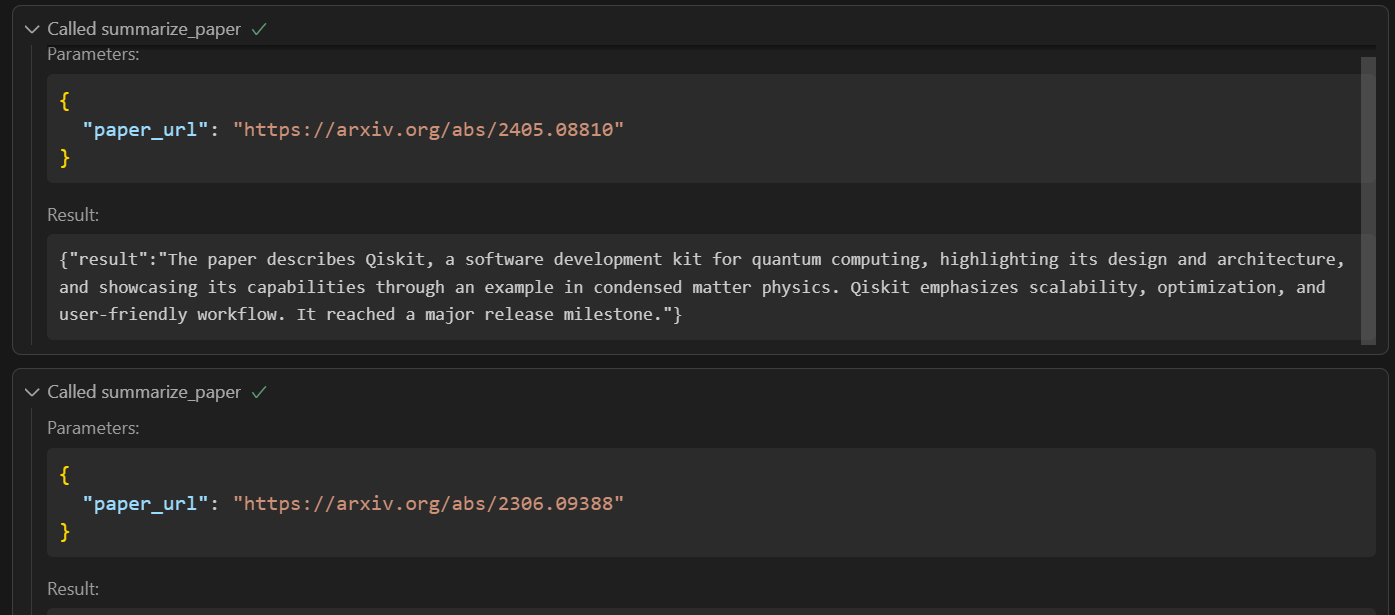
फिर, यह एक-एक करके लिंक 'Summarize Paper' टूल को देगा ताकि सारांश जनरेट हो सकें। अंत में, मैं रिपोर्ट तैयार करूँगा।
FastMCP 2.0 केवल MCP सर्वर बनाने का सरल तरीका भर नहीं है। यह सुरक्षित, मॉड्यूलर और स्केलेबल AI इंटीग्रेशन्स बनाने के लिए एक मज़बूत फ़्रेमवर्क देता है। ऑथेंटिकेशन, एडवांस्ड प्रॉक्सिइंग (जिससे एक FastMCP सर्वर दूसरे के लिए फ्रंटएंड की तरह काम कर सकता है), और माउंटिंग व इंपोर्टिंग के ज़रिए कई FastMCP सर्वरों को एक ही एप्लिकेशन में संयोजित करने जैसी सुविधाओं के साथ, आप आसानी से जटिल, मेंटनेबल सिस्टम आर्किटेक्ट कर सकते हैं।
मिडलवेयर सपोर्ट आपको सभी MCP रिक्वेस्ट्स और रिस्पॉन्सेज के पार लॉगिंग या रिक्वेस्ट मोडिफ़िकेशन जैसी क्रॉस-कटिंग फ़ंक्शनैलिटी जोड़ने देता है। आप MCP कॉन्टेक्स्ट के माध्यम से क्लाइंट्स को लॉग संदेश और प्रोग्रेस अपडेट भी भेज सकते हैं, जिससे लंबे समय तक चलने वाले ऑपरेशंस की निगरानी और प्रबंधन आसान हो जाता है।
इस ट्यूटोरियल में, हमने एक पूर्णतः कार्यात्मक MCP सर्वर बनाना और उसकी विशेषताओं का परीक्षण करना सीखा। ये टूल्स और MCP प्रोटोकॉल आधुनिक AI अनुप्रयोगों के आवश्यक घटक बनते जा रहे हैं, जो LLMs को अधिक उन्नत कार्य करने और वर्कफ़्लोज़ को अधिक प्रभावी ढंग से स्वचालित करने में सक्षम बनाते हैं।
MCP सर्वर्स के बारे में सीखते रहने के लिए, हमारे अन्य संसाधन ज़रूर देखें:
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स