
Kurs
LangGraph ile Çoklu Aracılı Sistemler
2 sa 45 dk
9K
Yapay zekâ dünyasında Model Context Protocol (MCP) kısa sürede gündemin merkezi haline geldi. MCP, Claude 4 gibi yapay zekâ modellerinin harici araçlara, servislere ve gerçek zamanlı veri kaynaklarına tutarlı bir şekilde bağlanmasını sağlayan açık bir standarttır. Bu bağlantı imkânı, büyük dil modellerinin (LLM) yapay zekâ ile sistemler arasındaki boşluğu kapatarak daha ilgili, güncel ve uygulanabilir yanıtlar üretmesini sağladığı için oyunun kurallarını değiştiriyor.
Bu eğitimde, yalnızca birkaç satır kodla kendi MCP sunucunuzu oluşturmayı kolaylaştıran güçlü bir çerçeve olan FastMCP 2.0’a derinlemesine bakacağız. FastMCP’nin temel bileşenlerini, hem MCP sunucusu hem de istemcisini nasıl oluşturacağınızı ve bunları iş akışınıza sorunsuz bir şekilde nasıl entegre edeceğinizi öğreneceğiz. MCP’ye yeniyseniz, daha fazla bilgi için Model Context Protocol Rehberi ve Demo Projesi'ni inceleyin.
FastMCP 2.0, Model Context Protocol (MCP) sunucuları ve istemcilerini hem basit hem de verimli şekilde oluşturmayı amaçlayan açık kaynaklı bir Python çerçevesidir. Yalnızca birkaç satır kodla geliştiriciler özel MCP sunucuları oluşturup bunları kod düzenleyicileri veya sohbet asistanları gibi yapay zekâ uygulamalarına bağlayabilir.
FastMCP 2.0, artık MCP Python SDK olarak bilinen FastMCP 1.0’ın halefidir ve MCP ekosisteminde çalışmak için eksiksiz bir araç takımı sunar.
FastMCP 2.0’ı öne çıkaran şey, çekirdek MCP spesifikasyonunun çok ötesine geçen kapsamlı özellik setidir. Dağıtımı, kimlik doğrulamayı, istemci ve sunucu proxy’lemeyi kolaylaştırır ve hatta REST API’lerinden sunucu üretmeyi mümkün kılar.
FastMCP 2.0; Araçlar (Tools), Kaynaklar (Resources) ve İstemler (Prompts) olmak üzere üç temel bileşen etrafında inşa edilmiştir.
Araçlar, MCP protokolü aracılığıyla LLM’lere açığa çıkarılan Python fonksiyonlarıdır. Bir fonksiyonu @mcp.tool ile süsleyerek, yapay zekâ modelinin sohbet sırasında onu çağırabilmesini sağlarsınız. Bu, LLM’lerin veritabanlarını sorgulama, API çağırma veya hesaplama yapma gibi gerçek dünya eylemlerini gerçekleştirmesini mümkün kılar.
from fastmcp import FastMCPmcp = FastMCP(name="UtilityServer")@mcp.tooldef convert_usd_to_eur(amount: float, rate: float = 0.91) -> float: """Converts a given amount in USD to EUR using the provided rate.""" return round(amount * rate, 2)Kaynaklar, dosyalar, veritabanı kayıtları, yapılandırmalar veya dinamik olarak oluşturulan içerik gibi verilere LLM’lere veya istemci uygulamalara salt-okunur erişim sağlar. Örneğin:
from fastmcp import FastMCPmcp = FastMCP(name="WeatherResourceServer")@mcp.resource("config://weather-settings")def get_weather_settings() -> dict: """Provides weather configuration.""" return { "default_units": "metric", "default_location": "Berlin", "features_enabled": ["forecast", "alerts"] }@mcp.resource("resource://welcome-message")def welcome_message() -> str: """Returns a dynamic greeting for users based on time of day.""" from datetime import datetime hour = datetime.now().hour if hour < 12: return "Good morning! Here's your weather update." elif hour < 18: return "Good afternoon! Need a forecast?" else: return "Good evening! Let's check the weather."İstemler, LLM yanıtlarını yönlendiren, yeniden kullanılabilir ve parametreli ileti şablonlarıdır. İstemleri fonksiyon olarak tanımlayarak, istemciler tarafından çağrılabilen tutarlı ve bağlamca zengin talimatlar sağlarsınız.
Bunlar, birden fazla aracı sırayla çalıştırmak ve LLM’i mevcut araçlar ve kaynakları kullanarak belirli görevleri gerçekleştirmeye yönlendirmek için gereklidir.
from fastmcp import FastMCPfrom fastmcp.prompts.prompt import PromptMessage, TextContentmcp = FastMCP(name="TutorPromptServer")@mcp.promptdef explain_math_concept(concept: str) -> PromptMessage: """Creates a message asking an AI tutor to explain a math concept simply.""" text = f"Can you explain the math concept of '{concept}' in a way that's easy for a 12-year-old to understand?" return PromptMessage(role="user", content=TextContent(type="text", text=text))Bu bölümde bir "ArXiv Explorer" MCP sunucusu oluşturacağız. Bu sunucu; araştırma makalelerinin bağlantılarını ve başlıklarını çıkarmaya yarayan bir araç ile makaleleri özetleyen ikinci bir araçtan oluşacak. Bu araçlara ek olarak, seçilen konu hakkında kapsamlı bir rapor oluşturmayı kolaylaştırmak için sunucuya kaynaklar ve istemler de dahil edilecek.
Başlamadan önce Tavily API anahtarını edinmeniz gerekecek. tavily.com adresinden ayda 1.000 isteğe kadar ücretsiz bir anahtar alabilirsiniz. Ardından gerekli Python kütüphanelerini kurun:
pip install fastmcp tavily-pythonÖnce sunucu Python dosyasını oluşturacağız. Dosya şu bölümlerden oluşur:
@mcp.resource dekoratörü, arxiv_topics fonksiyonumuzu salt-okunur bir veri kaynağı olarak açığa çıkarır. Kullanıcı emin değilse, bir yapay zekâ istemcisi bu konuları araştırma fikri almak için çekebilir.@mcp.tool dekoratörü sıradan Python fonksiyonlarını bir LLM’in çalıştırabileceği eylemlere dönüştürür.qna_search özelliğini kullanır; özet üretmek için idealdir.@mcp.prompt dekoratörü yeniden kullanılabilir bir şablon oluşturur. Bu yalnızca basit bir istem değildir; bir LLM’e, sunucunun araçlarını sıralı şekilde kullanarak karmaşık bir görevi nasıl yerine getireceğini anlatan stratejik bir plandır.mcp.run(transport="http") kritik bir satırdır. Yerel süreçler için “stdio” kullanmak yerine bir web sunucusu başlatır. Bu sayede ağdaki (veya aynı makinedeki) herhangi bir istemci, bir URL üzerinden sunucumuza bağlanabilir; böylece gerçekten uzak ve paylaşılabilir bir araç elde ederiz.server.py:
import osfrom typing import Dict, Listfrom fastmcp import FastMCPfrom tavily import TavilyClient# --- Configuration ---TAVILY_API_KEY = os.environ.get("TAVILY_API_KEY")if not TAVILY_API_KEY: raise ValueError("Please set the TAVILY_API_KEY environment variable.")tavily = TavilyClient(api_key=TAVILY_API_KEY)mcp = FastMCP(name="ArxivExplorer")print("✅ ArxivExplorer server initialized.")# --- Dynamic Resource: Suggested AI research topics ---@mcp.resource("resource://ai/arxiv_topics")def arxiv_topics() -> List[str]: return [ "Transformer interpretability", "Efficient large-scale model training", "Federated learning privacy", "Neural network pruning", ]print("✅ Resource 'resource://ai/arxiv_topics' registered.")# --- Tool: Search ArXiv for recent papers ---@mcp.tool(annotations={"title": "Search Arxiv"})def search_arxiv(query: str, max_results: int = 5) -> List[Dict]: """ Queries ArXiv via Tavily, returning title + link for each paper, and *only* ArXiv results. """ resp = tavily.search( query=f"site:arxiv.org {query}", max_results=max_results ) return [ {"title": r["title"].strip(), "url": r["url"]} for r in resp.get("results", []) ]# --- Tool: Summarize an ArXiv paper ---@mcp.tool(annotations={"title": "Summarize Paper"})def summarize_paper(paper_url: str) -> str: """ Returns a one-paragraph summary of the paper at the given URL. """ prompt = f"Summarize the key contributions of this ArXiv paper: {paper_url}" return tavily.qna_search(query=prompt)print("✅ Tools 'Search Arxiv' and 'Summarize Paper' registered.")# --- Prompt Template: Explore a topic thoroughly ---@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )print("✅ Prompt 'explore_topic_prompt' registered.")if __name__ == "__main__": print("\n🚀 Starting ArxivExplorer Server...") mcp.run(transport="http")MCP sunucusunu yapay zekâ uygulamasına entegre etmeden önce özelliklerini ve uç noktalarını test etmemiz gerekir. Bunun için FastMCP, MCP sunucusuna bağlanıp tüm işlevleri test etmek üzere basit bir API sağlar.
İstemci dosyası şunlardan oluşur:
StreamableHttpTransport, özellikle HTTP modunda çalışan bir FastMCP sunucusuna bağlanmak için tasarlanmıştır.arxiv_topics kaynağını okur ve sonucu doğru şekilde ayrıştırır.search_arxiv aracını çağırır ve makale listesini sarmalayıcıdan çıkarmak için yardımcı fonksiyonu kullanır.summarize_paper aracına geçirerek araçları zincirler.explore_topic_prompt’u alır.client.py:
import astimport asyncioimport pprintfrom fastmcp import Clientfrom fastmcp.client.transports import StreamableHttpTransport# --- Configuration ---SERVER_URL = "http://localhost:8000/mcp" # adjust if hosted elsewherepp = pprint.PrettyPrinter(indent=2, width=100)def unwrap_tool_result(resp): """ Safely unwraps the content from a FastMCP tool call result object. """ if hasattr(resp, "content") and resp.content: # The content is a list containing a single content object content_object = resp.content[0] # It could be JSON or plain text if hasattr(content_object, "json"): return content_object.json if hasattr(content_object, "text"): try: # Use ast.literal_eval for safely evaluating a string containing a Python literal return ast.literal_eval(content_object.text) except (ValueError, SyntaxError): # If it's not a literal, return the raw text return content_object.text return respasync def main(): transport = StreamableHttpTransport(url=SERVER_URL) client = Client(transport) print("\n🚀 Connecting to FastMCP server at:", SERVER_URL) async with client: # 1. Ping to test connectivity print("\n🔗 Testing server connectivity...") await client.ping() print("✅ Server is reachable!\n") # 2. Discover server capabilities print("🛠️ Available tools:") pp.pprint(await client.list_tools()) print("\n📚 Available resources:") pp.pprint(await client.list_resources()) print("\n💬 Available prompts:") pp.pprint(await client.list_prompts()) # 3. Fetch the topics resource print("\n\n📖 Fetching resource: resource://ai/arxiv_topics") res = await client.read_resource("resource://ai/arxiv_topics") topics = ast.literal_eval(res[0].text) print("Today's AI topics:") for i, t in enumerate(topics, 1): print(f" {i}. {t}") # 4. Test the search tool print("\n\n🔍 Testing tool: search_arxiv") raw_search = await client.call_tool( "search_arxiv", {"query": "Transformer interpretability", "max_results": 3}, ) search_results = unwrap_tool_result(raw_search) for i, paper in enumerate(search_results, 1): print(f" {i}. {paper['title']}\n {paper['url']}") # 5. Test the summarize tool on the first result if search_results: first_url = search_results[0]["url"] print("\n\n📝 Testing tool: summarize_paper") raw_summary = await client.call_tool( "summarize_paper", {"paper_url": first_url} ) summary = unwrap_tool_result(raw_summary) print("\nSummary of first paper:\n", summary) # 6. Test the prompt generator print("\n\n🚀 Testing prompt: explore_topic_prompt") prompt_resp = await client.get_prompt( "explore_topic_prompt", {"topic": "Transformer interpretability"} ) print("\nGenerated prompt for an LLM:") for msg in prompt_resp.messages: print(f"{msg.role.upper()}: {msg.content.text}\n")if __name__ == "__main__": asyncio.run(main())Tüm dosya ve yapılandırmalar kingabzpro/FastMCP-Project GitHub deposunda mevcuttur. Herhangi bir sorun yaşıyorsanız kullanabilirsiniz. Yerelde çalıştırma için kurulum rehberini de ekledim.
Şimdi hem MCP sunucusunu hem de istemciyi çalıştıracağız.
Önce, yerel sisteminizde Tavily API anahtarını bir ortam değişkeni olarak ayarlayın:
export TAVILY_API_KEY='your_tavily_api_key'Ardından sunucuyu çalıştırın:
python server.pyBirkaç saniye içinde FastMCP sunucusunun http://localhost:8000/mcp adresinde çalıştığını göreceksiniz.
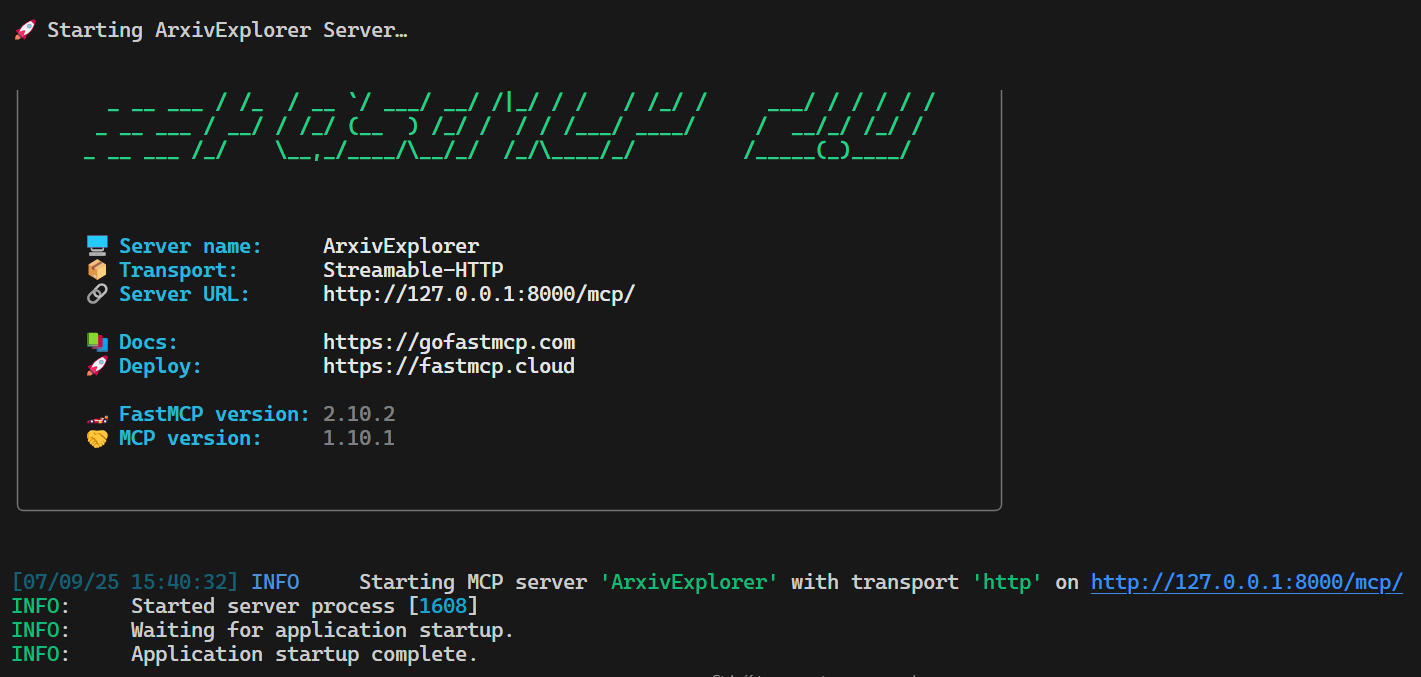
Yeni bir terminal açın ve her şeyin düzgün çalıştığını test etmek için istemci betiğini çalıştırın:
python client.pyGörüldüğü gibi, tüm işlevler, kaynaklar, araçlar ve istemler sorunsuz çalışıyor. MCP sunucumuz, birden fazla Tavily API isteğinde bile iyi performans gösteriyor.
🚀 Connecting to FastMCP server at: http://localhost:8000/mcp🔗 Testing server connectivity...✅ Server is reachable!🛠️ Available tools:[ Tool(name='search_arxiv', title='Search Arxiv', description='Queries ArXiv via Tavily, returning title + link for each paper,\nand *only* ArXiv results.', inputSchema={'properties': {'query': {'title': 'Query', 'type': 'string'}, 'max_results': {'default': 5, 'title': 'Max Results', 'type': 'integer'}}, 'required': ['query'], 'type': 'object'}, outputSchema={'properties': {'result': {'items': {'additionalProperties': True, 'type': 'object'}, 'title': 'Result', 'type': 'array'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Search Arxiv', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None), Tool(name='summarize_paper', title='Summarize Paper', description='Returns a one-paragraph summary of the paper at the given URL.', inputSchema={'properties': {'paper_url': {'title': 'Paper Url', 'type': 'string'}}, 'required': ['paper_url'], 'type': 'object'}, outputSchema={'properties': {'result': {'title': 'Result', 'type': 'string'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Summarize Paper', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None)]📚 Available resources:[ Resource(name='arxiv_topics', title=None, uri=AnyUrl('resource://ai/arxiv_topics'), description=None, mimeType='text/plain', size=None, annotations=None, meta=None)]💬 Available prompts:[ Prompt(name='explore_topic_prompt', title=None, description=None, arguments=[PromptArgument(name='topic', description=None, required=True)], meta=None)]📖 Fetching resource: resource://ai/arxiv_topicsToday's AI topics: 1. Transformer interpretability 2. Efficient large-scale model training 3. Federated learning privacy 4. Neural network pruning🔍 Testing tool: search_arxiv 1. Transformer Interpretability Beyond Attention Visualization https://arxiv.org/abs/2012.09838 2. A Practical Review of Mechanistic Interpretability for ... https://arxiv.org/abs/2407.02646 3. Mechanistic Interpretability of Fine-Tuned Vision ... https://arxiv.org/abs/2503.18762📝 Testing tool: summarize_paperSummary of first paper: The paper proposes a novel method for interpreting Transformer networks beyond attention visualization, introducing a new way to compute relevancy. It aims to enhance interpretability in vision tasks. The method is shown to provide more accurate insights into model decisions.🚀 Testing prompt: explore_topic_promptGenerated prompt:USER: type='text' text="I want to explore recent work on 'Transformer interpretability'.\n1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n3. Combine all summaries into an overview report." annotations=None meta=NoneMCP sunucusunu çalışır durumda tutun; şimdi onu Cursor AI kod düzenleyicisine entegre edeceğiz.
{ "mcpServers": { "ArxivExplorer": { "url": "http://127.0.0.1:8000/mcp/" } }}mcp.json dosyasını yukarıdaki yapılandırmalarla kaydettikten sonra, “Tools & Integrations” bölümünde yeni MCP sunucusunu göreceksiniz; aşağıda gösterildiği gibi iki aracı görüntüleyecektir.
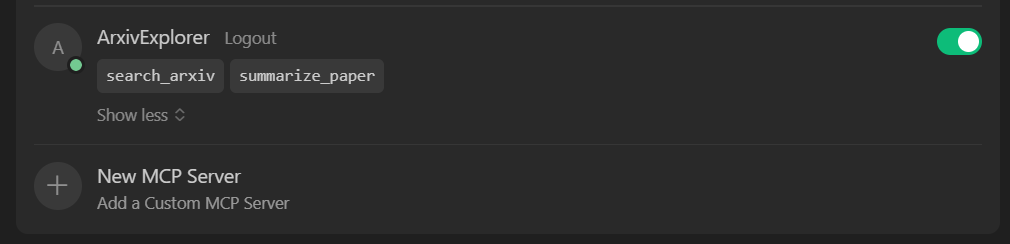
Şimdi eğlenceli kısım geliyor. MCP sunucumuzun Cursor AI kod düzenleyicisinde nasıl performans gösterdiğine bakalım. Kod düzenleyici içinde istemleri kullanarak araçları nasıl çağıracağınızı, kaynaklara nasıl erişeceğinizi ve özel istemleri nasıl çalıştıracağınızı öğreneceğiz.
Öncelikle MCP sunucunuzun kaynakları aracılığıyla faydalı veri sağlayıp sağlamadığını kontrol edin.
İstem: “en popüler arxiv konuları nelerdir”
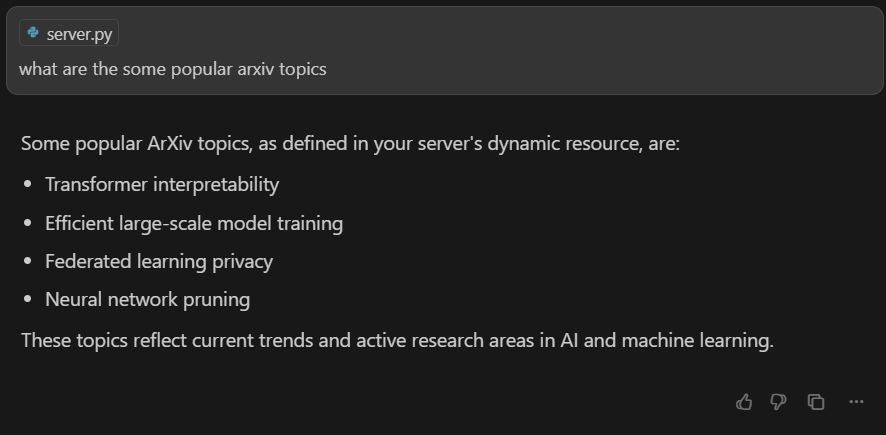
Her şey doğru ayarlandıysa, yapay zekâ modeli isteğinizi anlayacak ve MCP sunucunuzun kaynak uç noktasından konu listesini otomatik olarak alacaktır.
Şimdi MCP aracılığıyla açığa çıkardığınız araçları deneyelim. Önce search_arxiv aracını, yapay zekâ modelinden büyük dil modelleri üzerine en iyi on araştırma makalesini listelemesini isteyerek test edeceğiz.
İstem: “Lütfen büyük dil modelleri üzerine en iyi 10 araştırma makalesini arayın.”
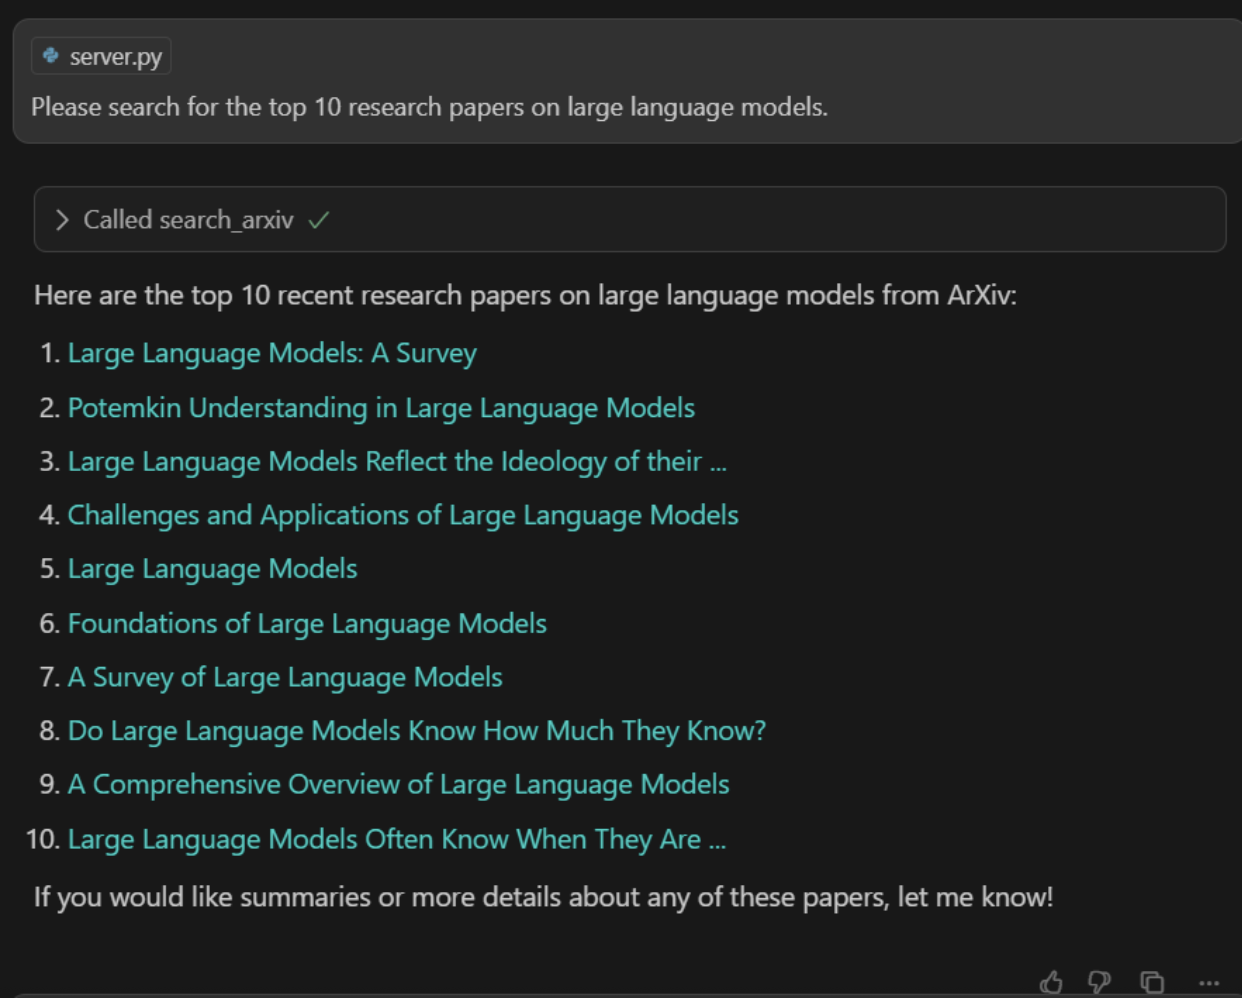
Yapay zekâ search_arxiv aracını çağıracak ve arXiv’den doğrudan çekilen, hızlı ve isabetli bir ilgili makaleler listesi görmelisiniz.
Sonraki adımda, araştırma makalesi URL’sini alıp raporun özetini döndüren özetleyici aracı test edeceğiz.
İstem: “Lütfen şu makaleyi benim için özetleyin: https://arxiv.org/abs/2402.06196”
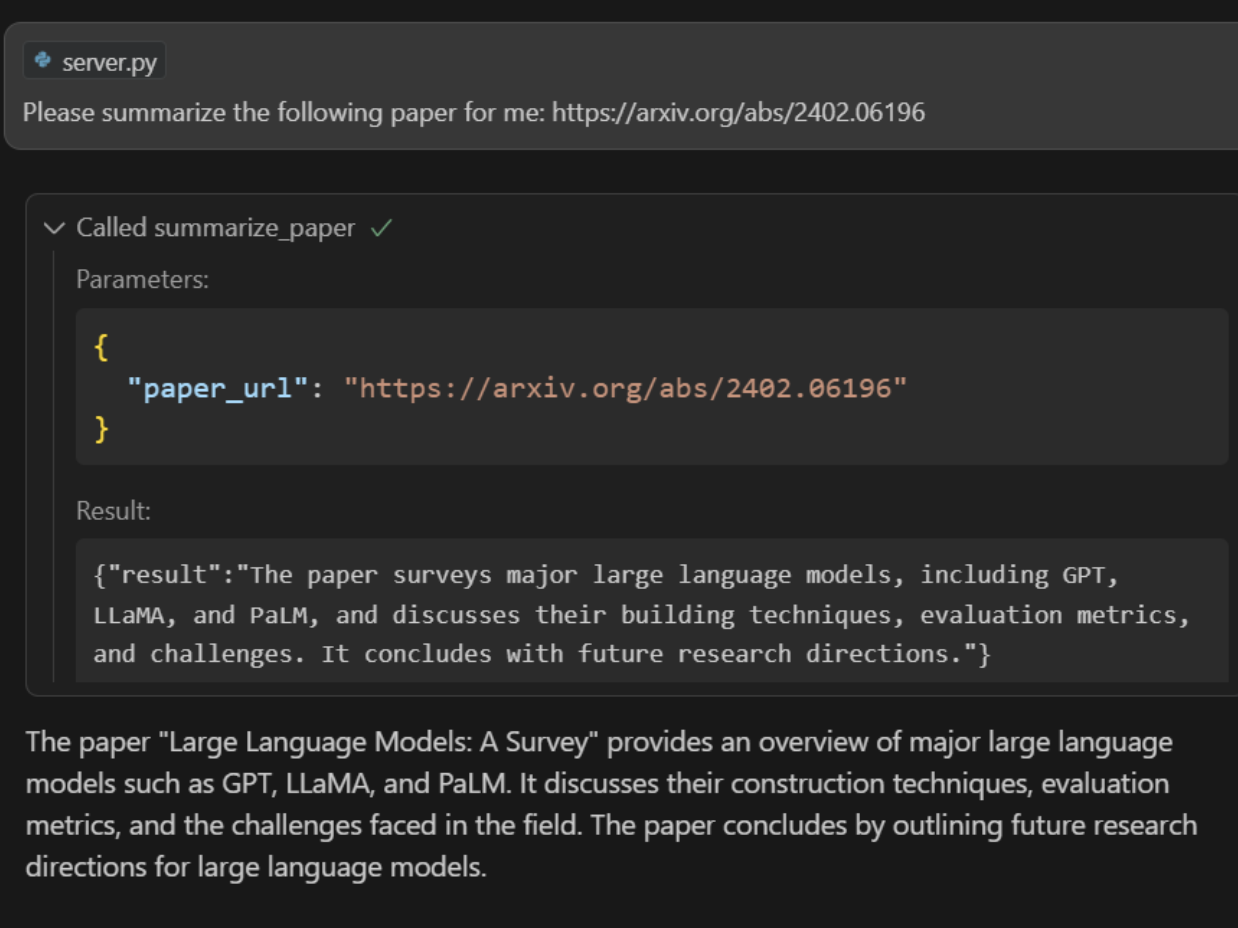
Özetleyici araç makaleyi alacak ve kısa bir özet döndürecektir.
Şimdi, bir rapor oluşturmamıza yardımcı olacak MCP’den özel bir istem çağıracağız.
İstem: “En güncel çalışmaları kullanarak Kuantum hesaplama hakkında bir rapor oluştur.”
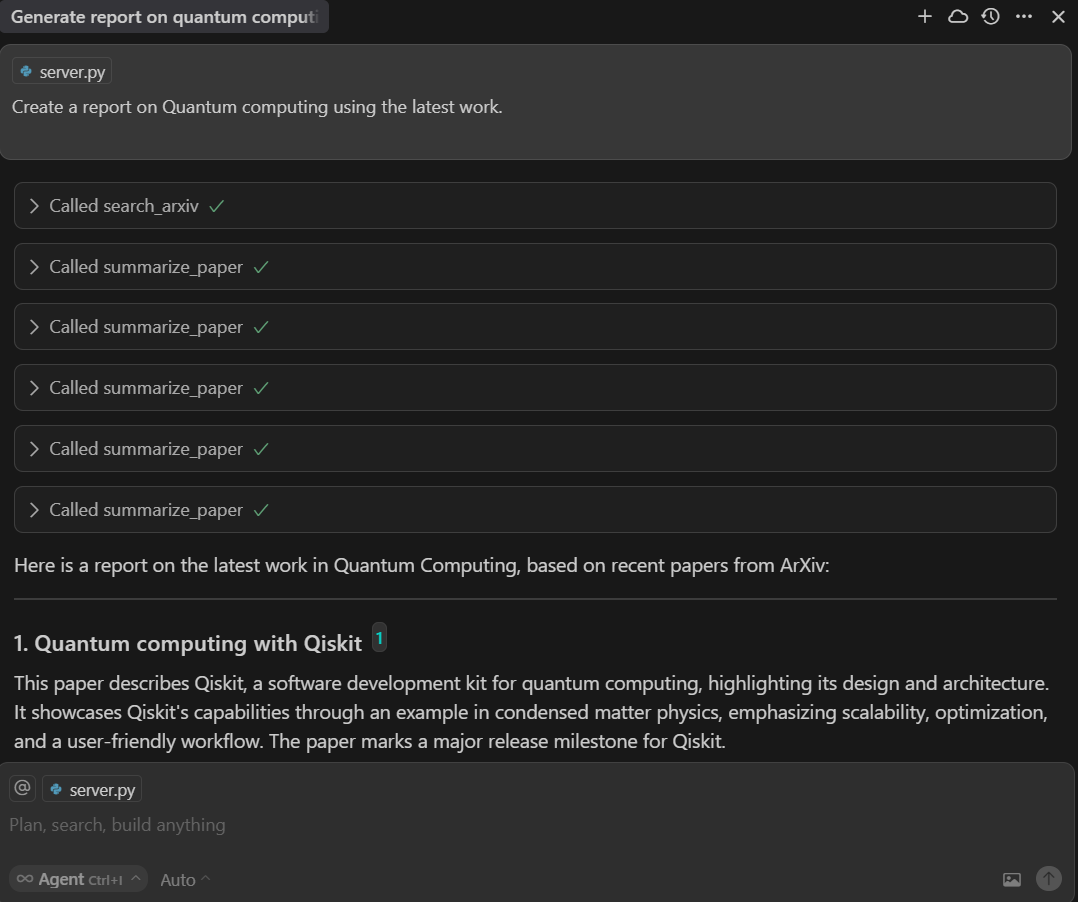
Sunucu kodunu incelerseniz, yapay zekâ modelinin görevi anladığını ve explore_topic_prompt fonksiyonunu kullandığını göreceksiniz.
@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )Önce, makalelere ait bağlantıları bulmak için 'Search Arxiv' aracını çağıracaktır.
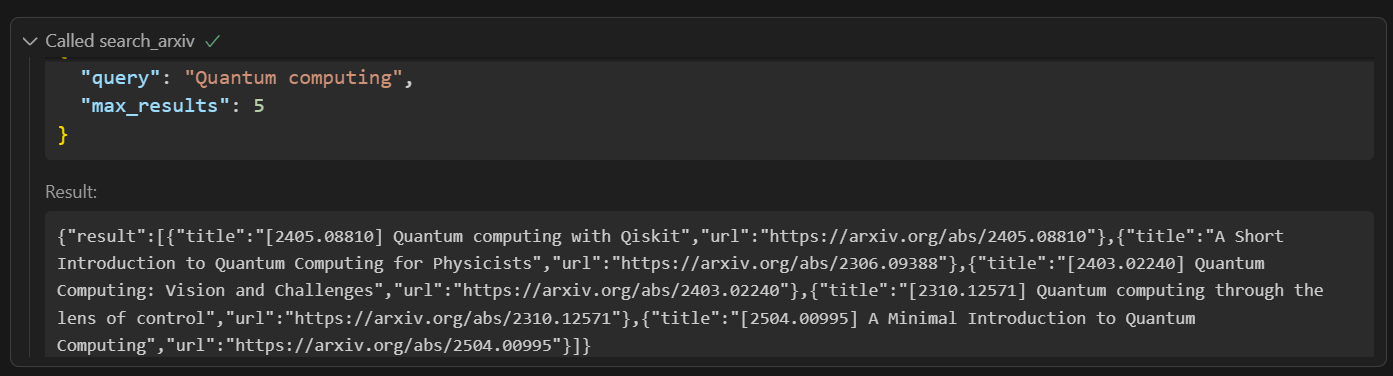
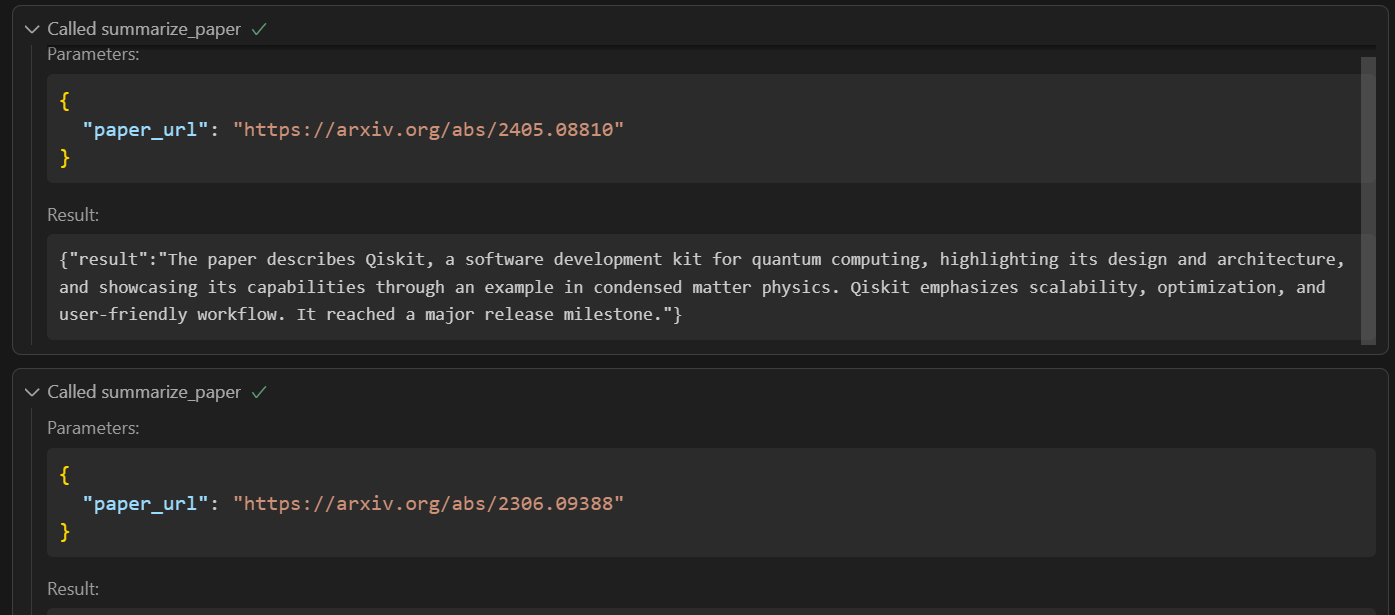
Ardından, özetleri oluşturmak için bağlantıları tek tek 'Summarize Paper' aracına verecektir. Sonunda ben raporu oluşturacağım.
FastMCP 2.0, yalnızca MCP sunucuları oluşturmanın basit bir yolundan fazlasını sunar. Güvenli, modüler ve ölçeklenebilir yapay zekâ entegrasyonları oluşturmak için sağlam bir çerçevedir. Kimlik doğrulama, gelişmiş proxy’leme (bir FastMCP sunucusunun diğeri için ön uç olarak hareket etmesini sağlar) ve birden fazla FastMCP sunucusunu bağlama ve içe aktarma yoluyla tek bir uygulamada birleştirme gibi özelliklerle, karmaşık ve sürdürülebilir sistemleri kolayca tasarlayabilirsiniz.
Ara katman (middleware) desteği, tüm MCP istek ve yanıtları genelinde günlükleme veya istek değiştirme gibi kesitsel işlevler eklemenizi sağlar. Ayrıca MCP bağlamı üzerinden istemcilere günlük mesajları ve ilerleme güncellemeleri gönderebilir, böylece uzun süreli işlemleri izlemek ve yönetmek kolaylaşır.
Bu eğitimde, tamamen işlevsel bir MCP sunucusunun nasıl kurulacağını ve özelliklerinin nasıl test edileceğini öğrendik. Bu araçlar ve MCP protokolü, LLM’lerin daha gelişmiş görevleri yerine getirmesini ve iş akışlarını daha etkili biçimde otomatikleştirmesini sağlayarak modern yapay zekâ uygulamalarının temel bileşenleri haline geliyor.
MCP Sunucuları hakkında öğrenmeye devam etmek için diğer kaynaklarımıza da göz atın:
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




