
Curso
Sistemas Multiagentes com LangGraph
2 h 45 min
8.4K
No mundo da IA, o Model Context Protocol (MCP) rapidamente virou assunto quente. O MCP é um padrão aberto que dá a modelos de IA como o Claude 4 uma forma consistente de se conectar a ferramentas externas, serviços e fontes de dados em tempo real. Essa conectividade muda o jogo, pois permite que modelos de linguagem grandes (LLMs) entreguem respostas mais relevantes, atualizadas e acionáveis, fazendo a ponte entre a IA e os sistemas.
Neste tutorial, vamos explorar o FastMCP 2.0, um framework poderoso que facilita criar nosso próprio servidor MCP com poucas linhas de código. Você vai conhecer os componentes centrais do FastMCP, como construir um servidor e um cliente MCP, e como integrá-los ao seu fluxo de trabalho sem atrito. Se você é novo em MCP, confira nosso guia do Model Context Protocol com projeto de demonstração para saber mais.
O FastMCP 2.0 é um framework Python open source projetado para tornar simples e eficiente a criação de servidores e clientes baseados no Model Context Protocol (MCP). Com poucas linhas de código, desenvolvedores criam servidores MCP personalizados e os conectam a aplicações de IA, como editores de código ou assistentes de chat.
O FastMCP 2.0 é o sucessor do FastMCP 1.0, hoje chamado de MCP Python SDK, e oferece um kit completo para trabalhar no ecossistema MCP.
O diferencial do FastMCP 2.0 é seu conjunto abrangente de recursos que vai muito além da especificação central do MCP. Ele simplifica a implantação, autenticação, proxy de cliente e servidor e até permite gerar servidores a partir de APIs REST.
O FastMCP 2.0 é construído em torno de três componentes essenciais: Tools, Resources e Prompts.
Tools são funções Python expostas a LLMs via o protocolo MCP. Ao decorar uma função com @mcp.tool, você permite que o modelo de IA a chame durante a conversa. Isso habilita LLMs a executar ações no mundo real, como consultar bancos de dados, chamar APIs ou rodar cálculos.
from fastmcp import FastMCPmcp = FastMCP(name="UtilityServer")@mcp.tooldef convert_usd_to_eur(amount: float, rate: float = 0.91) -> float: """Converts a given amount in USD to EUR using the provided rate.""" return round(amount * rate, 2)Resources oferecem a LLMs ou a aplicações cliente acesso somente leitura a dados, como arquivos, registros de banco, configurações ou conteúdo gerado dinamicamente. Por exemplo:
from fastmcp import FastMCPmcp = FastMCP(name="WeatherResourceServer")@mcp.resource("config://weather-settings")def get_weather_settings() -> dict: """Provides weather configuration.""" return { "default_units": "metric", "default_location": "Berlin", "features_enabled": ["forecast", "alerts"] }@mcp.resource("resource://welcome-message")def welcome_message() -> str: """Returns a dynamic greeting for users based on time of day.""" from datetime import datetime hour = datetime.now().hour if hour < 12: return "Good morning! Here's your weather update." elif hour < 18: return "Good afternoon! Need a forecast?" else: return "Good evening! Let's check the weather."Prompts são modelos de mensagens reutilizáveis e parametrizados que orientam as respostas de LLMs. Ao defini-los como funções, você garante instruções consistentes e ricas em contexto, que podem ser invocadas pelos clientes.
Eles são necessários para executar múltiplas tools em sequência e guiar o LLM a realizar certas tarefas usando as tools e resources disponíveis.
from fastmcp import FastMCPfrom fastmcp.prompts.prompt import PromptMessage, TextContentmcp = FastMCP(name="TutorPromptServer")@mcp.promptdef explain_math_concept(concept: str) -> PromptMessage: """Creates a message asking an AI tutor to explain a math concept simply.""" text = f"Can you explain the math concept of '{concept}' in a way that's easy for a 12-year-old to understand?" return PromptMessage(role="user", content=TextContent(type="text", text=text))Nesta seção, vamos construir um servidor MCP "ArXiv Explorer". Esse servidor terá duas tools: uma para extrair links e títulos de artigos científicos e outra para resumir esses artigos. Além dessas tools, o servidor também inclui resources e prompts para ajudar a criar um relatório completo sobre o tema escolhido.
Antes de começar, você vai precisar da chave de API do Tavily. Você pode obter uma chave gratuita com 1.000 solicitações mensais em tavily.com. Depois, instale as bibliotecas Python necessárias:
pip install fastmcp tavily-pythonVamos primeiro criar o arquivo Python do servidor. O arquivo contém:
@mcp.resource expõe nossa função arxiv_topics como uma fonte de dados somente leitura. Um cliente de IA pode buscar esses tópicos para ter ideias do que pesquisar, caso o usuário não tenha certeza.@mcp.tool transforma funções Python comuns em ações que um LLM pode executar.qna_search do Tavily, otimizado para fornecer respostas diretas e concisas — perfeito para gerar um resumo.@mcp.prompt cria um template reutilizável. Não é só um prompt simples; é um plano estratégico que instrui um LLM a usar as tools do servidor em sequência para executar uma tarefa complexa.mcp.run(transport="http") é uma linha crítica. Em vez de usar “stdio” para processos locais, isso inicia um servidor web. Assim, qualquer cliente na rede (ou na mesma máquina) pode se conectar ao nosso servidor via URL, tornando-o realmente remoto e compartilhável.server.py:
import osfrom typing import Dict, Listfrom fastmcp import FastMCPfrom tavily import TavilyClient# --- Configuration ---TAVILY_API_KEY = os.environ.get("TAVILY_API_KEY")if not TAVILY_API_KEY: raise ValueError("Please set the TAVILY_API_KEY environment variable.")tavily = TavilyClient(api_key=TAVILY_API_KEY)mcp = FastMCP(name="ArxivExplorer")print("✅ ArxivExplorer server initialized.")# --- Dynamic Resource: Suggested AI research topics ---@mcp.resource("resource://ai/arxiv_topics")def arxiv_topics() -> List[str]: return [ "Transformer interpretability", "Efficient large-scale model training", "Federated learning privacy", "Neural network pruning", ]print("✅ Resource 'resource://ai/arxiv_topics' registered.")# --- Tool: Search ArXiv for recent papers ---@mcp.tool(annotations={"title": "Search Arxiv"})def search_arxiv(query: str, max_results: int = 5) -> List[Dict]: """ Queries ArXiv via Tavily, returning title + link for each paper, and *only* ArXiv results. """ resp = tavily.search( query=f"site:arxiv.org {query}", max_results=max_results ) return [ {"title": r["title"].strip(), "url": r["url"]} for r in resp.get("results", []) ]# --- Tool: Summarize an ArXiv paper ---@mcp.tool(annotations={"title": "Summarize Paper"})def summarize_paper(paper_url: str) -> str: """ Returns a one-paragraph summary of the paper at the given URL. """ prompt = f"Summarize the key contributions of this ArXiv paper: {paper_url}" return tavily.qna_search(query=prompt)print("✅ Tools 'Search Arxiv' and 'Summarize Paper' registered.")# --- Prompt Template: Explore a topic thoroughly ---@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )print("✅ Prompt 'explore_topic_prompt' registered.")if __name__ == "__main__": print("\n🚀 Starting ArxivExplorer Server...") mcp.run(transport="http")Precisamos testar os recursos e endpoints do servidor MCP antes de integrá-lo à aplicação de IA. Para isso, o FastMCP fornece uma API simples para conectar ao servidor MCP e testar todas as suas funções.
O arquivo do cliente contém:
StreamableHttpTransport é projetado especificamente para se conectar a um servidor FastMCP rodando em modo HTTP.arxiv_topics e faz o parsing correto do resultado.search_arxiv e usa a função helper para desembrulhar a lista de artigos.summarize_paper.explore_topic_prompt, exibindo as instruções finais, prontas para uso, que seriam enviadas a um LLM.client.py:
import astimport asyncioimport pprintfrom fastmcp import Clientfrom fastmcp.client.transports import StreamableHttpTransport# --- Configuration ---SERVER_URL = "http://localhost:8000/mcp" # adjust if hosted elsewherepp = pprint.PrettyPrinter(indent=2, width=100)def unwrap_tool_result(resp): """ Safely unwraps the content from a FastMCP tool call result object. """ if hasattr(resp, "content") and resp.content: # The content is a list containing a single content object content_object = resp.content[0] # It could be JSON or plain text if hasattr(content_object, "json"): return content_object.json if hasattr(content_object, "text"): try: # Use ast.literal_eval for safely evaluating a string containing a Python literal return ast.literal_eval(content_object.text) except (ValueError, SyntaxError): # If it's not a literal, return the raw text return content_object.text return respasync def main(): transport = StreamableHttpTransport(url=SERVER_URL) client = Client(transport) print("\n🚀 Connecting to FastMCP server at:", SERVER_URL) async with client: # 1. Ping to test connectivity print("\n🔗 Testing server connectivity...") await client.ping() print("✅ Server is reachable!\n") # 2. Discover server capabilities print("🛠️ Available tools:") pp.pprint(await client.list_tools()) print("\n📚 Available resources:") pp.pprint(await client.list_resources()) print("\n💬 Available prompts:") pp.pprint(await client.list_prompts()) # 3. Fetch the topics resource print("\n\n📖 Fetching resource: resource://ai/arxiv_topics") res = await client.read_resource("resource://ai/arxiv_topics") topics = ast.literal_eval(res[0].text) print("Today's AI topics:") for i, t in enumerate(topics, 1): print(f" {i}. {t}") # 4. Test the search tool print("\n\n🔍 Testing tool: search_arxiv") raw_search = await client.call_tool( "search_arxiv", {"query": "Transformer interpretability", "max_results": 3}, ) search_results = unwrap_tool_result(raw_search) for i, paper in enumerate(search_results, 1): print(f" {i}. {paper['title']}\n {paper['url']}") # 5. Test the summarize tool on the first result if search_results: first_url = search_results[0]["url"] print("\n\n📝 Testing tool: summarize_paper") raw_summary = await client.call_tool( "summarize_paper", {"paper_url": first_url} ) summary = unwrap_tool_result(raw_summary) print("\nSummary of first paper:\n", summary) # 6. Test the prompt generator print("\n\n🚀 Testing prompt: explore_topic_prompt") prompt_resp = await client.get_prompt( "explore_topic_prompt", {"topic": "Transformer interpretability"} ) print("\nGenerated prompt for an LLM:") for msg in prompt_resp.messages: print(f"{msg.role.upper()}: {msg.content.text}\n")if __name__ == "__main__": asyncio.run(main())Todos os arquivos e configurações estão disponíveis no repositório do GitHub kingabzpro/FastMCP-Project. Você pode usá-lo caso enfrente qualquer problema. Também incluí o guia de setup para rodar localmente.
Agora vamos subir o servidor e o cliente MCP.
Primeiro, defina a chave de API do Tavily como uma variável de ambiente no seu sistema local:
export TAVILY_API_KEY='your_tavily_api_key'Em seguida, execute o servidor:
python server.pyEm segundos, você verá que o servidor FastMCP está rodando em http://localhost:8000/mcp.
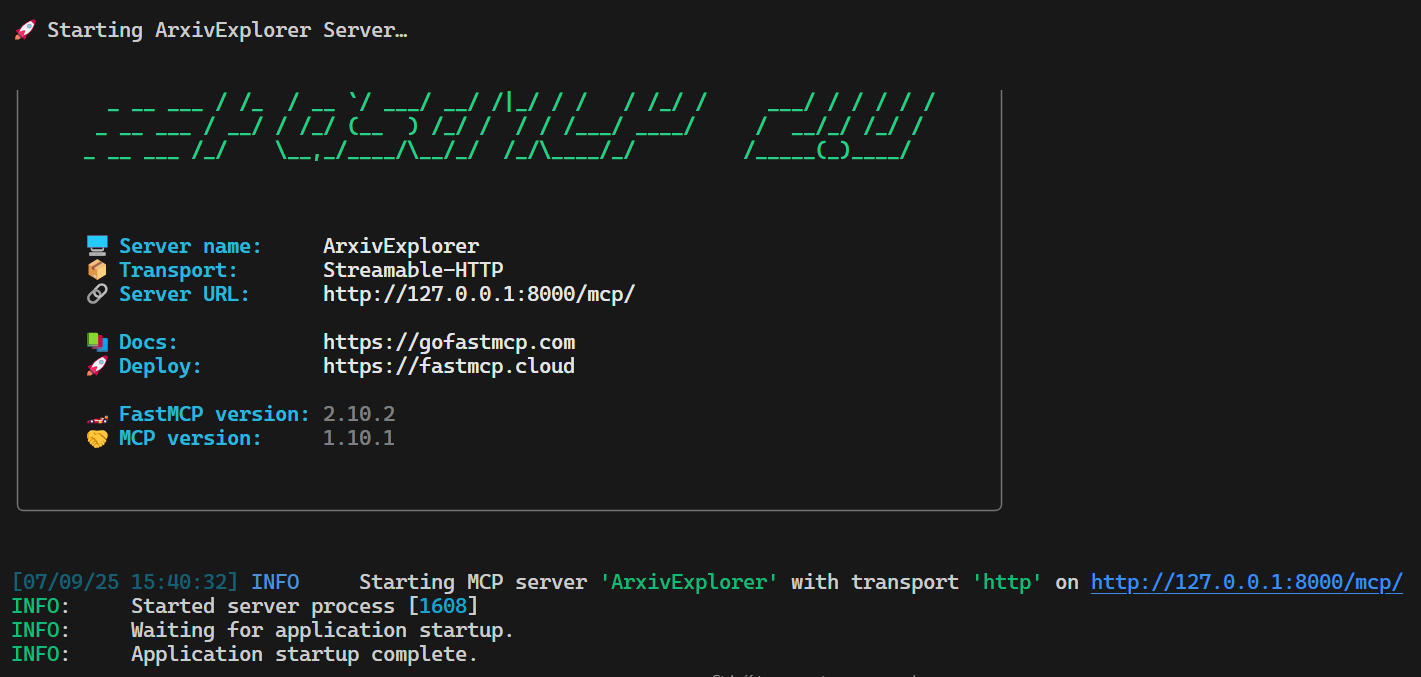
Abra um novo terminal e rode o script do cliente para testar se tudo está funcionando direitinho:
python client.pyComo podemos ver, todas as funções, resources, tools e prompts estão funcionando perfeitamente. Nosso servidor MCP está mandando bem, mesmo com várias requisições à API do Tavily.
🚀 Connecting to FastMCP server at: http://localhost:8000/mcp🔗 Testing server connectivity...✅ Server is reachable!🛠️ Available tools:[ Tool(name='search_arxiv', title='Search Arxiv', description='Queries ArXiv via Tavily, returning title + link for each paper,\nand *only* ArXiv results.', inputSchema={'properties': {'query': {'title': 'Query', 'type': 'string'}, 'max_results': {'default': 5, 'title': 'Max Results', 'type': 'integer'}}, 'required': ['query'], 'type': 'object'}, outputSchema={'properties': {'result': {'items': {'additionalProperties': True, 'type': 'object'}, 'title': 'Result', 'type': 'array'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Search Arxiv', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None), Tool(name='summarize_paper', title='Summarize Paper', description='Returns a one-paragraph summary of the paper at the given URL.', inputSchema={'properties': {'paper_url': {'title': 'Paper Url', 'type': 'string'}}, 'required': ['paper_url'], 'type': 'object'}, outputSchema={'properties': {'result': {'title': 'Result', 'type': 'string'}}, 'required': ['result'], 'title': '_WrappedResult', 'type': 'object', 'x-fastmcp-wrap-result': True}, annotations=ToolAnnotations(title='Summarize Paper', readOnlyHint=None, destructiveHint=None, idempotentHint=None, openWorldHint=None), meta=None)]📚 Available resources:[ Resource(name='arxiv_topics', title=None, uri=AnyUrl('resource://ai/arxiv_topics'), description=None, mimeType='text/plain', size=None, annotations=None, meta=None)]💬 Available prompts:[ Prompt(name='explore_topic_prompt', title=None, description=None, arguments=[PromptArgument(name='topic', description=None, required=True)], meta=None)]📖 Fetching resource: resource://ai/arxiv_topicsToday's AI topics: 1. Transformer interpretability 2. Efficient large-scale model training 3. Federated learning privacy 4. Neural network pruning🔍 Testing tool: search_arxiv 1. Transformer Interpretability Beyond Attention Visualization https://arxiv.org/abs/2012.09838 2. A Practical Review of Mechanistic Interpretability for ... https://arxiv.org/abs/2407.02646 3. Mechanistic Interpretability of Fine-Tuned Vision ... https://arxiv.org/abs/2503.18762📝 Testing tool: summarize_paperSummary of first paper: The paper proposes a novel method for interpreting Transformer networks beyond attention visualization, introducing a new way to compute relevancy. It aims to enhance interpretability in vision tasks. The method is shown to provide more accurate insights into model decisions.🚀 Testing prompt: explore_topic_promptGenerated prompt:USER: type='text' text="I want to explore recent work on 'Transformer interpretability'.\n1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n3. Combine all summaries into an overview report." annotations=None meta=NoneMantenha o servidor MCP rodando, pois vamos integrá-lo ao editor de código Cursor AI.
{ "mcpServers": { "ArxivExplorer": { "url": "http://127.0.0.1:8000/mcp/" } }}Ao salvar o arquivo mcp.json com as configurações acima, você verá o novo servidor MCP listado na seção “Tools & Integrations”, exibindo duas tools como mostrado abaixo.
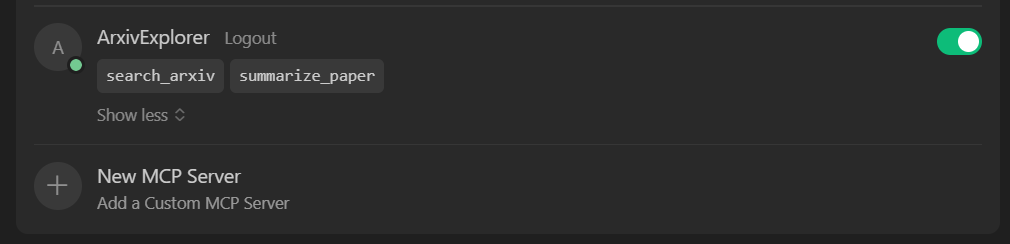
Agora vem a parte divertida. Vamos ver como nosso servidor MCP se sai com o editor de código Cursor AI. Vamos aprender a usar prompts para acionar tools, acessar resources e executar prompts personalizados — tudo dentro do editor.
Comece verificando se o seu servidor MCP consegue fornecer dados úteis por meio de seus resources.
Prompt: “what are the some popular arxiv topics”
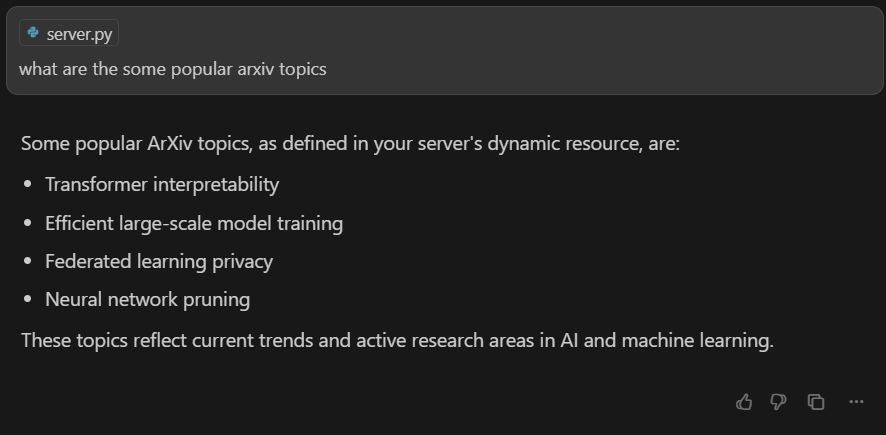
Se tudo estiver configurado corretamente, o modelo de IA vai entender seu pedido e buscar automaticamente a lista de tópicos no endpoint de resource do seu servidor MCP.
Em seguida, vamos experimentar as tools que você expôs via MCP. Primeiro, vamos testar a tool search_arxiv, pedindo ao modelo de IA que liste os dez principais artigos sobre large language models.
Prompt: “Please search for the top 10 research papers on large language models.”
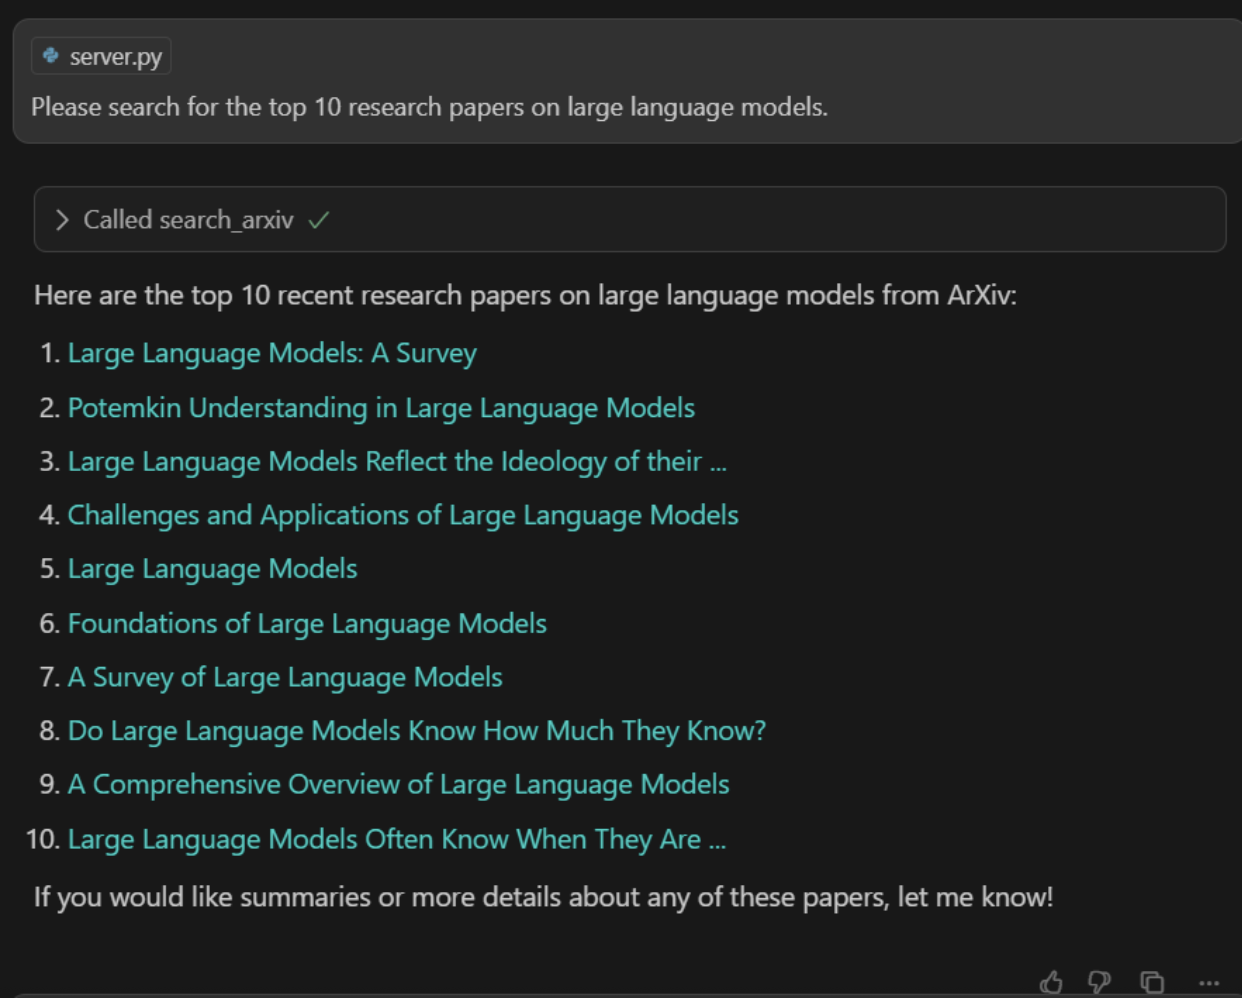
A IA vai chamar a tool search_arxiv e você deve ver uma lista rápida e precisa de artigos relevantes, puxados diretamente do arXiv.
Depois, vamos testar a tool de sumarização, que recebe a URL do artigo e retorna um resumo do trabalho.
Prompt: “Please summarize the following paper for me: https://arxiv.org/abs/2402.06196”
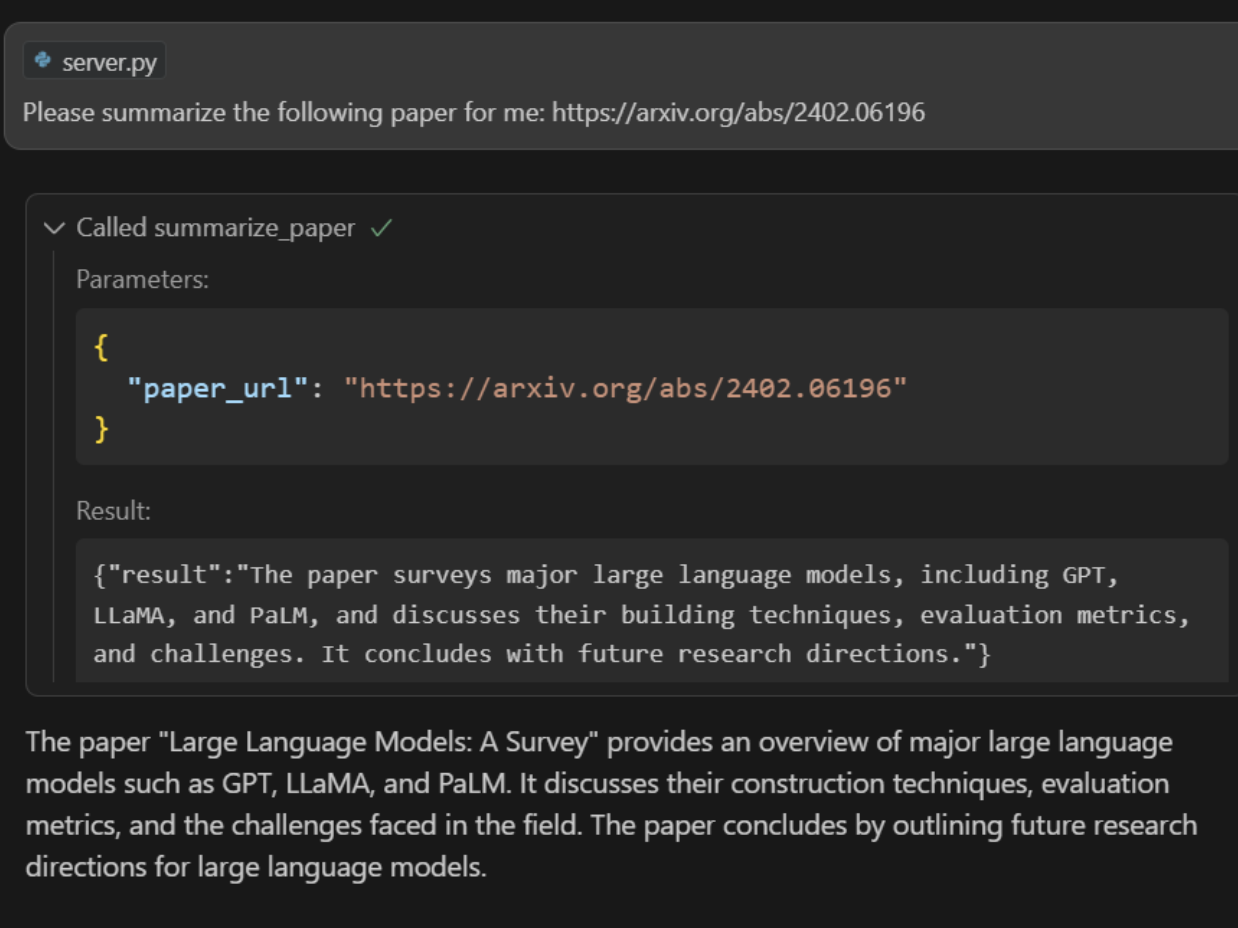
A tool de resumo vai buscar o artigo e retornar um sumário conciso.
Agora vamos invocar um prompt personalizado do MCP que vai nos ajudar a gerar um relatório.
Prompt: “Create a report on Quantum computing using the latest work.”
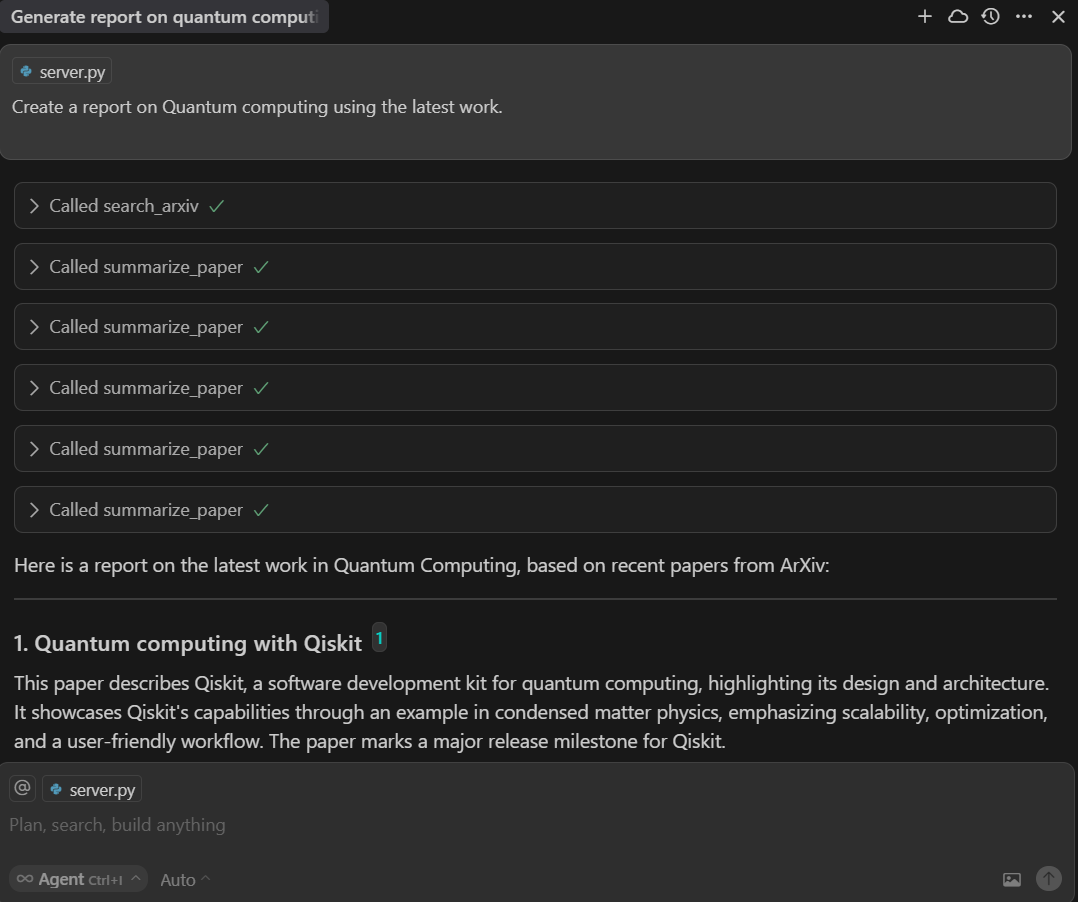
Se você examinar o código do servidor, verá que o modelo de IA entende a tarefa e usa a função explore_topic_prompt.
@mcp.promptdef explore_topic_prompt(topic: str) -> str: return ( f"I want to explore recent work on '{topic}'.\n" f"1. Call the 'Search Arxiv' tool to find the 5 most recent papers.\n" f"2. For each paper URL, call 'Summarize Paper' to extract its key contributions.\n" f"3. Combine all summaries into an overview report." )Primeiro, ele chama a tool 'Search Arxiv' para encontrar os links dos artigos.
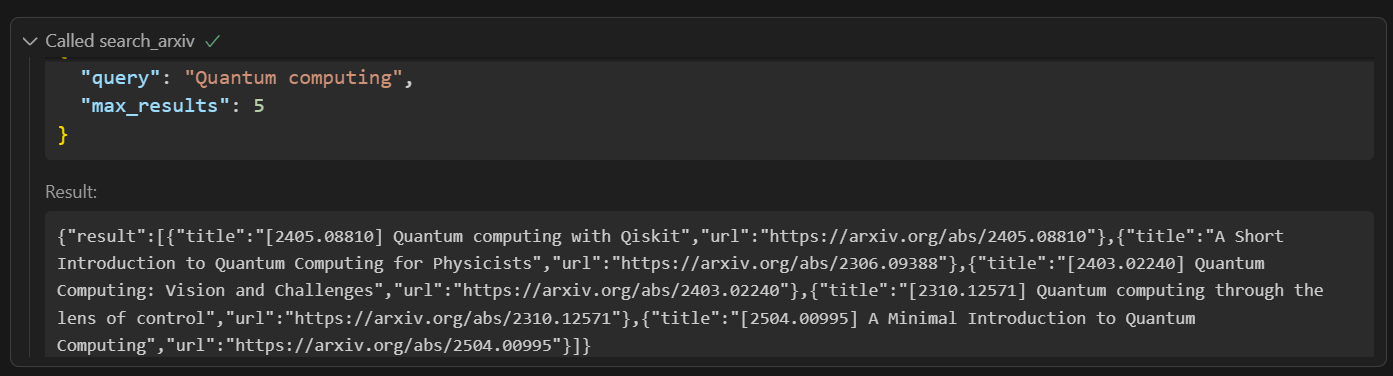
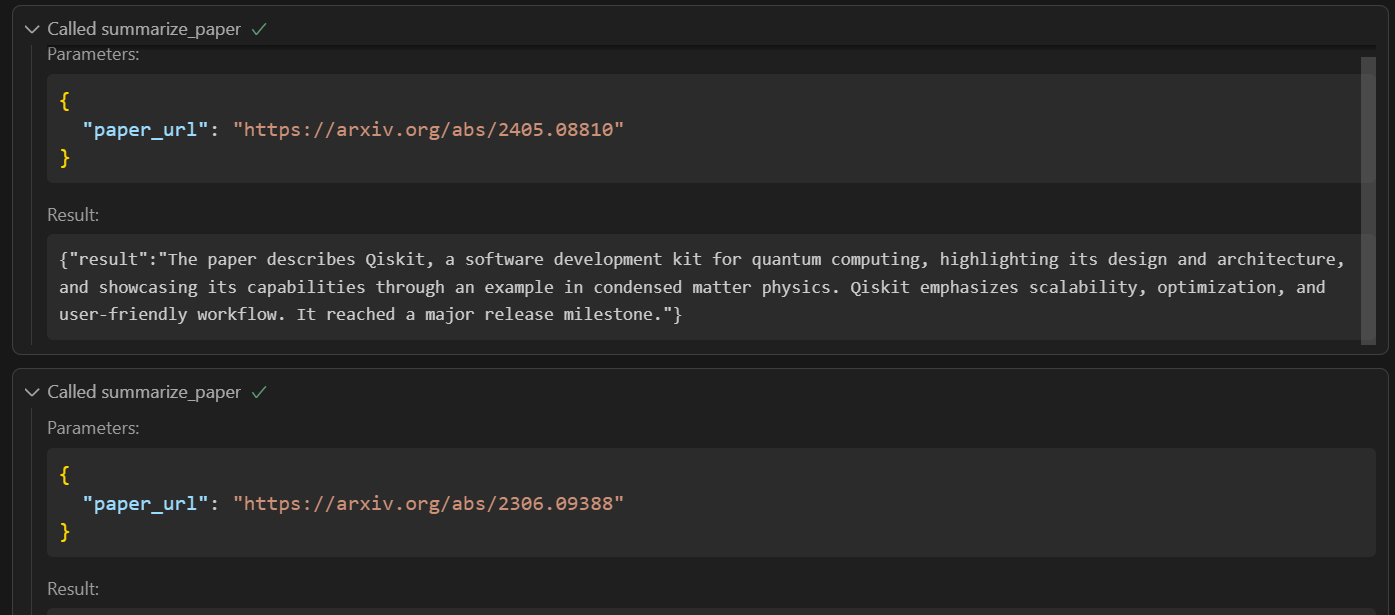
Depois, ele fornece os links para a tool 'Summarize Paper' um a um para gerar os resumos. Por fim, criarei o relatório.
O FastMCP 2.0 vai muito além de uma forma simples de criar servidores MCP. Ele oferece um framework robusto para construir integrações de IA seguras, modulares e escaláveis. Com recursos como autenticação, proxy avançado (permitindo que um servidor FastMCP atue como frontend para outro) e a capacidade de combinar múltiplos servidores FastMCP em uma única aplicação por meio de mounting e importing, você consegue arquitetar sistemas complexos e fáceis de manter.
O suporte a middleware permite adicionar funcionalidades transversais, como logging ou modificação de requisições, a todas as solicitações e respostas MCP. Você também pode enviar mensagens de log e atualizações de progresso de volta aos clientes pelo contexto MCP, facilitando o monitoramento e a gestão de operações longas.
Neste tutorial, aprendemos a construir um servidor MCP totalmente funcional e a testar seus recursos. Essas ferramentas e o protocolo MCP estão se tornando componentes essenciais de aplicações modernas de IA, permitindo que LLMs executem tarefas mais avançadas e automatizem fluxos de trabalho com mais eficiência.
Para continuar aprendendo sobre servidores MCP, confira também nossos outros recursos:
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
Tutorial
Moez Ali
12 min
Tutorial
Matt Crabtree
6 min
Tutorial
Moez Ali
13 min
Tutorial
Zoumana Keita
8 min
Tutorial







