
Cursus
Artificial Intelligence begrijpen
2 uur
427K
Vandaag, 10 augustus, publiceerde Anthropic een onderzoeksnota over wat er gebeurde toen een medewerker Claude vroeg om de Riemann-hypothese te proberen, waarschijnlijk het beroemdste open probleem in de wiskunde. (Altijd denkend aan hun investeerders, benadrukte Anthropic dat dit project werd uitgevoerd op een nog niet uitgebrachte versie van een Claude-model.)
Claude heeft de hypothese niet bewezen. Dat verwachtte niemand. Maar ergens tijdens de poging, werkend aan een nevenvraag uit hetzelfde gebied, kwam Claude met een echte verbetering van een al lang bestaande ondergrens: het aandeel nullen van de Riemann-zetafunctie waarvan bekend is dat ze op de "kritieke lijn" liggen die door de hypothese wordt voorspeld. Voorheen was dat getal 41,6%, het resultaat van decennia werk. Het resultaat van Claude verhoogt dit naar 67,2%.
Twee wiskundigen van Anthropic hebben het werk intern beoordeeld, en twee externe experts, Brian Conrey en Dan Goldston, zijn ingeschakeld om het te bekijken. Claude leverde ook een machine-verifieerbare Lean-formalisering van het bewijs, zodat de logische stappen mechanisch konden worden gecontroleerd. Het resultaat staat, is significant en interessant.
Ik laat je niet doorklikken naar een ander artikel om dit te snappen: de Riemann-zetafunctie is een wiskundige functie die, op een omweg, informatie codeert over de verdeling van priemgetallen.
Priemgetallen zijn niet willekeurig in de zin dat ze stuk voor stuk onvoorspelbaar zouden zijn.
Of een getal priem is, staat volledig vast. Maar ze volgen ook geen eenvoudige formule, want er is geen vergelijking die het 100-miljoenste priemgetal uitspuugt.
Er zijn wel formules die priemgetallen vinden, maar dat zijn in feite vermomde manieren om elk getal één voor één te controleren. Uitgezoomd dunnen priemgetallen echter uit met een tempo dat je best goed kunt voorspellen: rond een groot getal n is grofweg 1 op elke ln(n) getallen priem, en die verhouding blijft gelden naarmate n groeit.
Zoals veel functies heeft de zetafunctie "nullen": punten waar de uitkomst precies nul is, en in het geval van de zetafunctie zijn dat er oneindig veel. Een deel van die nullen is triviaal en goed begrepen; de interessante zijn de rest, en de Riemann-hypothese beweert dat al die niet-triviale nullen precies op één specifieke verticale lijn liggen, de kritieke lijn.
Zo zie je de link met priemgetallen. De zetafunctie is in de simpelste vorm een som: 1 + 1/2ˢ + 1/3ˢ + 1/4ˢ + 1/5ˢ + ... over alle gehele getallen, ingevuld in een exponent s. Nog niets met priemgetallen. Het is gewoon breuken optellen.
Eulers truc, terug in de 18e eeuw, was laten zien dat diezelfde oneindige som exact gelijk is aan een oneindig product dat alleen priemgetallen gebruikt: een keten van termen als 1/(1 − 1/2ˢ) × 1/(1 − 1/3ˢ) × 1/(1 − 1/5ˢ) × 1/(1 − 1/7ˢ) × ..., één factor voor elk priemgetal, zonder samengestelde getallen erin. De reden dat dit werkt komt neer op unieke ontbinding: elk geheel getal factoriseert op precies één manier in priemgetallen, dus sommeren over alle gehele getallen en vermenigvuldigen over alle priemgetallen codeert uiteindelijk identieke informatie. Die gelijkheid is de hele koppeling. Het betekent dat de zetafunctie niet alleen geassocieerd is met priemgetallen, maar er feitelijk een herverpakking van is.
Nog één ding: Riemann liet zien dat deze nullen de foutterm bepalen in hoe priemgetallen uitdunnen (die eerdere schatting van "ongeveer 1 op elke ln(n)"). De nullen werken als de kleine lettertjes die een ruwe schatting corrigeren: daar komen de afwijkingen tussen de werkelijke posities van priemgetallen en het vloeiende gemiddelde naar voren. De Riemann-hypothese is de bewering dat elk van de interessante (de "niet-triviale" van daarnet) nullen precies op één specifieke verticale lijn ligt, de kritieke lijn, wat, als het waar is, betekent dat die afwijkingen zo klein en regelmatig mogelijk blijven, en priemgetallen ongeveer zo voorspelbaar verdeeld zijn als kan.
De Riemann-hypothese zegt dat 100% van de niet-triviale nullen op de kritieke lijn ligt. Niemand heeft dat bewezen, en niemand heeft het weerlegd. Wat wiskundigen wél hebben bewezen, met totaal andere methodes, is een ondergrens: een gegarandeerd minimaal aandeel van die nullen dat op de lijn moet liggen, ongeacht wat dan ook.
Dit is niet hetzelfde als met computers nullen één voor één controleren. Er zijn triljoenen individuele nullen berekend, en tot nu toe lag elke enkele op de kritieke lijn, maar dat is slechts een eindige steekproef. Hoe groot ook, die kan niet uitsluiten dat ergens ver weg op de getallenlijn een nul het patroon doorbreekt. Ten tweede, en dat is het belangrijke deel, de cijfers 41,6% en 67,2% zijn helemaal geen steekproefresultaten. Het zijn bewezen uitspraken over de hele oneindige verzameling nullen: een strikte garantie dat minstens dat aandeel, als je steeds meer nullen bekijkt, altijd op de lijn zal liggen. Het is een harde wiskundige ondergrens, geen schatting en geen waarschijnlijkheid.
Dus wanneer het getal verschuift van 41,6% naar 67,2%, is er niets "gevonden". Wat verandert is de grootte van de gegarandeerde ondergrens zelf, via nieuwe bewijsstechnieken die meer zekerheid uit dezelfde oneindige verzameling persen. Die ondergrens zelfs maar een beetje laten stijgen is historisch traag, technisch werk. Dat hij in één klap 25 procentpunt omhoog gaat, is waarom dit resultaat het waard was om er een artikel over te schrijven.
Zelfs een ondergrens die uiteindelijk 99% bereikt, is geen bewijs. De hypothese is een alles-of-niets-verklaring over elke nul, dus één enkele verdwaalde nul buiten de lijn, waar dan ook in een oneindige verzameling, zou haar nog steeds breken.
Wat dit wél is: een echte, geverifieerde verbetering van een specifieke kwantitatieve vraag waar wiskundigen sinds Montgomery zijn technieken in 1973 introduceerde, aan sleutelen zijn. Het resultaat van Claude bouwt daar specifiek op voort: die technieken uit 1973, later aangepast door Baluyot, Goldston, Suriajaya en Turnage-Butterbaugh zodat ze niet langer aannemen dat de hypothese waar is, gecombineerd met een artikel uit 2000 van Enrico Bombieri. Claude vond een manier om deze samen te voegen, door een bepaalde functieruimte in één keer te behandelen met zowel positief als negatief definit deel, in plaats van apart. Dat duwde de ondergrens van 41,6% naar 67,2%.
Volgens Anthropic vroeg een medewerker van Anthropic, Jarred Sumner, eenvoudigweg aan Claude, draaiend binnen Claude Code, om de Riemann-hypothese te proberen, en liet de feitelijke wiskundige beslissingen aan het model over.
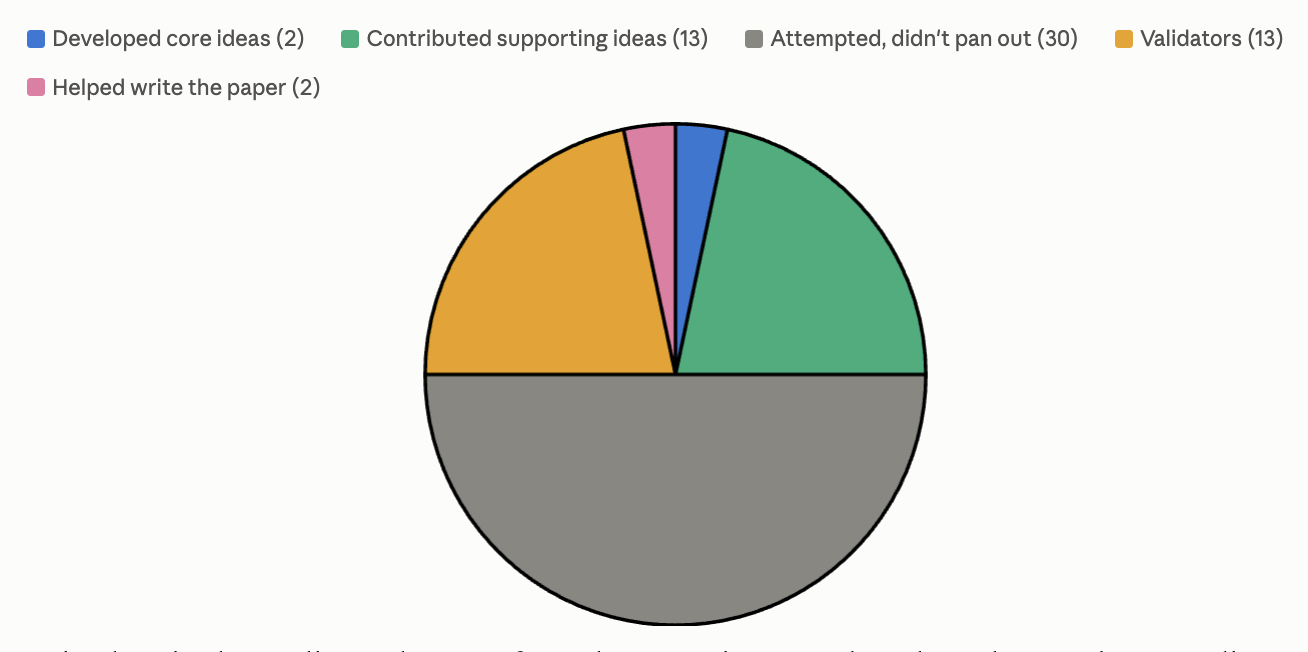
De eerste poging mislukte: Claude genereerde en probeerde 650 verschillende ideeën, waarvan geen enkel werkte. Aangespoord om het opnieuw te proberen, besteedde Claude ongeveer anderhalve dag aan het coördineren van zo'n 60 subagents, die samen zo'n 2.400 shell-commando's uitvoerden en honderden Python-scripts schreven, numerieke beweringen kruisten met bekende zeta-nullen en elkaars redeneringen nakeken. Van die 60 subagents ontwikkelden er uiteindelijk slechts twee de kernwiskundige ideeën die ertoe deden; dertien droegen ondersteunende ideeën bij, dertig probeerden paden die doodliepen, dertien werkten als controleurs, en de laatste twee hielpen bij het opstellen van het paper.
De hele run gebruikte ongeveer 31 miljoen outputtokens over twee sessies. Opvallend genoeg bestond de menselijke bijdrage tijdens het proces vooral uit aanmoediging ("ga door!" – dat soort dingen), waarvan Anthropic suggereert dat het Claude hielp om zijn eigen vroege scepsis dat het probleem hanteerbaar was, te overwinnen.
Toen Claude het resultaat eenmaal had, stopte het daar niet: het liet subagents naar tegenvoorbeelden zoeken, haalde 54 papers van arXiv om te controleren of het resultaat niet al gepubliceerd was, en leidde de bevinding onafhankelijk opnieuw af als sanitycheck. Daarna stelde het voor om het resultaat als paper op te schrijven en raadde het aan een menselijke getaltheoreticus het werk te laten controleren, wat precies is wat er daarna gebeurde, met de wiskundigen van Anthropic Levent Alpöge en Ralph Furman die het intern onderzochten en Conrey en Goldston die extern beoordeelden, en vervolgens een aparte Lean-formalisering, geproduceerd met Eric Easley van Anthropic.
Twee dingen springen er voor mij uit:
Dit is geen doorbraak voor de Riemann-hypothese, en niemand beweert dat ook. Maar het is wel een echte, formeel geverifieerde verbetering van een specifieke, technische, decennia oude vraag die voortkwam uit een poging op het echte doel.
Verder lezen: we schreven eerder over ander interessant AI- en wiskundig nieuws:
Leer AI met DataCamp
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

