
Cours
Comprendre l'intelligence artificielle
2 h
423.1K
Aujourd’hui, 10 août, Anthropic a publié une note de recherche décrivant ce qui s’est passé lorsqu’un membre de l’équipe a demandé à Claude de s’attaquer à l’hypothèse de Riemann, sans doute le problème ouvert le plus célèbre en mathématiques. (Soucieuse de ses investisseurs, Anthropic précise que ce projet a été mené avec une version de Claude encore non publiée.)
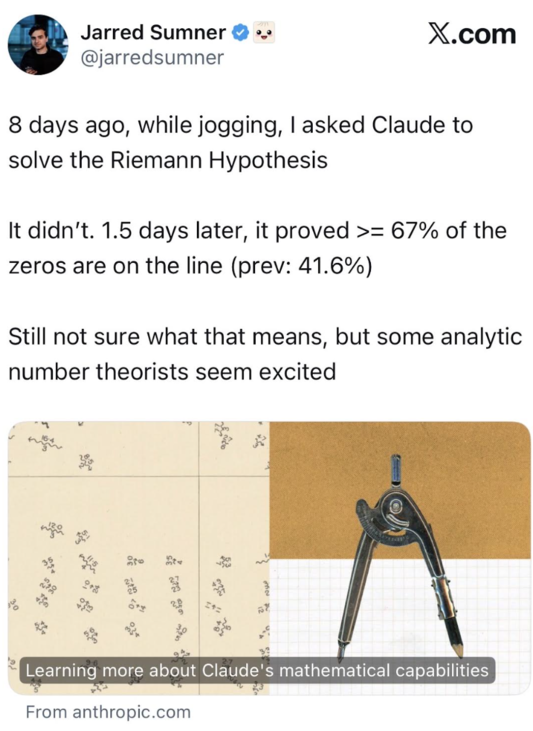
Claude n’a pas démontré l’hypothèse. Personne ne s’y attendait. Mais au cours de la tentative, en travaillant sur une question connexe du même territoire, Claude a obtenu une amélioration réelle d’une borne inférieure établie de longue date : la proportion de zéros de la fonction zêta de Riemann dont on sait qu’ils se trouvent sur la « ligne critique » prédite par l’hypothèse. Auparavant, ce chiffre était de 41,6 %, résultat de décennies d’efforts. Le résultat de Claude le porte à 67,2 %.
Deux mathématiciens d’Anthropic ont relu le travail en interne, et deux experts externes, Brian Conrey et Dan Goldston, ont été sollicités pour l’examiner. Claude a également produit une formalisation Lean vérifiable par machine de la preuve, afin que les étapes logiques puissent être contrôlées mécaniquement. Le résultat tient, il est significatif et intéressant.
Pas besoin d’ouvrir un autre article pour suivre : la fonction zêta de Riemann est une fonction mathématique qui, de manière détournée, encode des informations sur la répartition des nombres premiers.
Les nombres premiers ne sont pas « aléatoires » au sens où ils seraient imprévisibles un par un.
Le fait qu’un nombre donné soit premier est entièrement déterminé. Mais ils ne suivent pas non plus de formule simple, car il n’existe pas d’équation qui « crache » le 100 millionième nombre premier.
Il existe bien des formules qui trouvent des nombres premiers, mais ce ne sont que des versions déguisées de la vérification un par un. En revanche, si l’on prend du recul, les premiers s’espacent à un rythme que l’on peut assez bien prédire : autour d’un grand nombre n, environ 1 nombre sur ln(n) est premier, et ce ratio se maintient quand n grandit.
Comme beaucoup de fonctions, la fonction zêta possède des « zéros », c’est-à-dire des points où sa valeur est exactement nulle, et dans son cas, ils sont en nombre infini. Certains de ces zéros sont triviaux et bien compris ; les intéressants sont les autres, et l’hypothèse de Riemann affirme que chacun de ces zéros non triviaux se trouve exactement sur une verticale spécifique, appelée la ligne critique.
Voici une façon de voir le lien avec les premiers. La fonction zêta, dans sa forme la plus simple, est une somme : 1 + 1/2ˢ + 1/3ˢ + 1/4ˢ + 1/5ˢ + ... qui court sur tous les entiers, élevés à une puissance s. Rien à voir, pour l’instant, avec les premiers. On additionne juste des fractions.
L’astuce d’Euler, au XVIIIe siècle, a été de montrer que cette même somme infinie est exactement égale à un produit infini qui n’utilise que les nombres premiers : une chaîne de termes comme 1/(1 − 1/2ˢ) × 1/(1 − 1/3ˢ) × 1/(1 − 1/5ˢ) × 1/(1 − 1/7ˢ) × ..., un facteur par nombre premier, sans aucun composé. La raison tient à la factorisation unique : chaque entier se décompose en premiers d’une seule manière, si bien que sommer sur tous les entiers et multiplier sur tous les premiers encode la même information. Cette égalité fait tout le lien. Elle signifie que la fonction zêta n’est pas seulement associée aux premiers, elle en est une reformulation.
Dernier point ici : Riemann a montré que ces zéros contrôlent le terme d’erreur dans la manière dont les premiers s’espacent (l’estimation « environ 1 sur ln(n) » mentionnée plus haut). Les zéros jouent le rôle des petites lignes qui corrigent une estimation grossière : c’est là que se logent les écarts entre la position réelle des premiers et la moyenne lissée. L’hypothèse de Riemann affirme que chacun des zéros intéressants (les « non triviaux » dont nous parlions) se trouve exactement sur une verticale spécifique, la ligne critique, ce qui, si c’est vrai, signifie que ces écarts restent aussi faibles et réguliers que possible, et que les premiers sont distribués de façon aussi prévisible que possible.
L’hypothèse de Riemann dit que 100 % des zéros non triviaux sont sur la ligne critique. Personne ne l’a démontré, et personne ne l’a réfuté non plus. Ce que les mathématiciens ont démontré, par des méthodes entièrement différentes, c’est un plancher : une fraction minimale garantie de ces zéros qui doivent se trouver sur la ligne, quoi qu’il arrive.
Ce n’est pas la même chose que de vérifier des zéros un par un par ordinateur. Des billions de zéros individuels ont été calculés, et chacun jusqu’ici est tombé sur la ligne critique, mais cela reste un échantillon fini. Si grand soit-il, il ne peut exclure qu’un zéro très lointain rompe le motif. Deuxièmement — et c’est le point essentiel — les chiffres de 41,6 % et 67,2 % ne sont pas des résultats d’échantillonnage. Ce sont des énoncés prouvés sur l’ensemble infini des zéros : une garantie rigoureuse qu’au moins cette fraction, à mesure que l’on considère de plus en plus de zéros, sera toujours sur la ligne. C’est un plancher mathématique dur, ni une estimation ni une probabilité.
Donc, quand le nombre passe de 41,6 % à 67,2 %, rien n’a été « trouvé ». Ce qui change, c’est la hauteur du plancher lui-même, grâce à de nouvelles techniques de preuve qui tirent davantage de certitude du même ensemble infini. Faire monter ce plancher, même un peu, est historiquement un travail lent et technique. Le faire bondir de 25 points de pourcentage d’un coup, c’est ce qui rend ce résultat digne d’un article.
Même un plancher qui atteindrait 99 % ne constituerait pas une preuve. L’hypothèse est un énoncé du tout ou rien sur chaque zéro, si bien qu’un seul zéro égaré hors de la ligne, n’importe où dans un ensemble infini, la ferait échouer.
Ce que c’est : une amélioration réelle et vérifiée d’une question quantitative précise, sur laquelle les mathématiciens travaillent avec acharnement depuis que Montgomery a introduit ses techniques en 1973. Le résultat de Claude s’inscrit dans ce fil en particulier : ces techniques de 1973, plus tard adaptées par Baluyot, Goldston, Suriajaya et Turnage-Butterbaugh pour ne plus supposer la véracité de l’hypothèse, combinées à un article de 2000 d’Enrico Bombieri. Claude a trouvé comment les assembler, en traitant d’un seul tenant un certain espace de fonctions avec des parties à la fois définies positives et définies négatives, plutôt que séparément. C’est ce qui a fait passer le plancher de 41,6 % à 67,2 %.
Selon Anthropic, un membre du personnel, Jarred Sumner, a simplement demandé à Claude, exécuté dans Claude Code, de tenter l’hypothèse de Riemann, en laissant au modèle les décisions mathématiques.
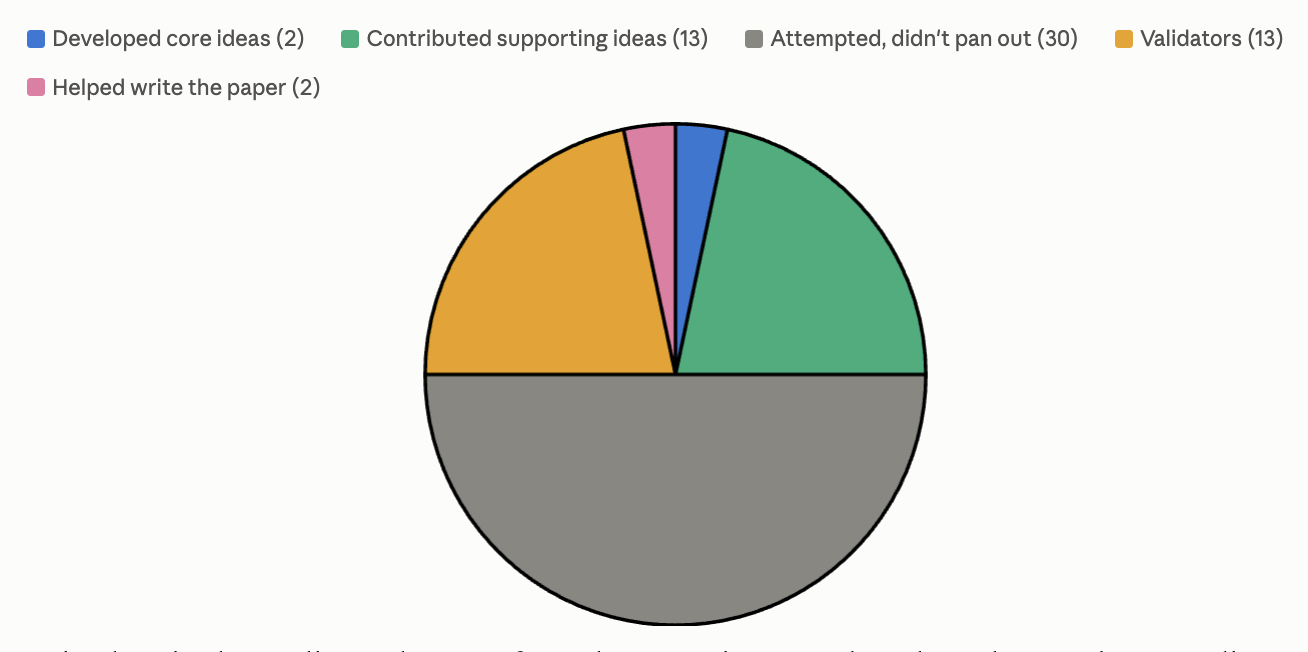
La première passe a échoué : Claude a généré et testé 650 idées différentes, sans succès. Invité à recommencer, Claude a passé environ un jour et demi à coordonner quelque 60 sous-agents qui, à eux tous, ont exécuté près de 2 400 commandes shell et écrit des centaines de scripts Python, recoupant des affirmations numériques avec des zéros connus de zêta et relisant mutuellement leurs raisonnements. Sur ces 60 sous-agents, seuls deux ont finalement développé les idées mathématiques centrales qui comptaient ; treize ont apporté des idées de soutien, trente ont tenté des approches qui n’ont pas abouti, treize ont agi en validateurs, et les deux derniers ont aidé à rédiger l’article.
L’ensemble de l’exécution a utilisé environ 31 millions de tokens de sortie sur deux sessions. À noter : la contribution humaine pendant le processus a surtout été de l’encouragement (« continuez ! » — ce genre de choses), ce qui, selon Anthropic, a peut-être aidé Claude à dépasser son propre scepticisme initial quant à la « traitabilité » du problème.
Une fois le résultat atteint, Claude ne s’est pas arrêté là : il a chargé des sous-agents de chercher des contre-exemples, a extrait 54 articles d’arXiv pour vérifier que le résultat n’avait pas déjà été publié, et a redérivé la trouvaille de manière indépendante comme test de cohérence. Il a ensuite proposé de rédiger le résultat sous forme d’article et recommandé qu’un spécialiste humain de théorie des nombres le contrôle, ce qui s’est effectivement produit : les mathématiciens d’Anthropic Levent Alpöge et Ralph Furman l’ont examiné en interne, Conrey et Goldston en externe, puis une formalisation Lean distincte a été produite avec Eric Easley d’Anthropic.
Deux points principaux ressortent :
Ce n’est pas une percée sur l’hypothèse de Riemann, et personne n’affirme le contraire. Mais c’est une amélioration réelle, formellement vérifiée, d’une question technique et précise, vieille de plusieurs décennies, née d’une tentative sur la véritable cible.
Pour aller plus loin : nous avons écrit sur d’autres actualités intéressantes autour de l’IA et des maths :
Apprenez l’IA avec DataCamp
Cours
Cursus
Cours