
Belangrijke metrics voor LLM-evaluatie
Het evalueren van LLM's vraagt om een brede aanpak met uiteenlopende maatstaven om verschillende aspecten van hun prestaties te beoordelen. In deze bespreking verkennen we kerncriteria voor LLM-evaluatie, waaronder nauwkeurigheid en performance, bias en eerlijkheid, en andere belangrijke metrics.
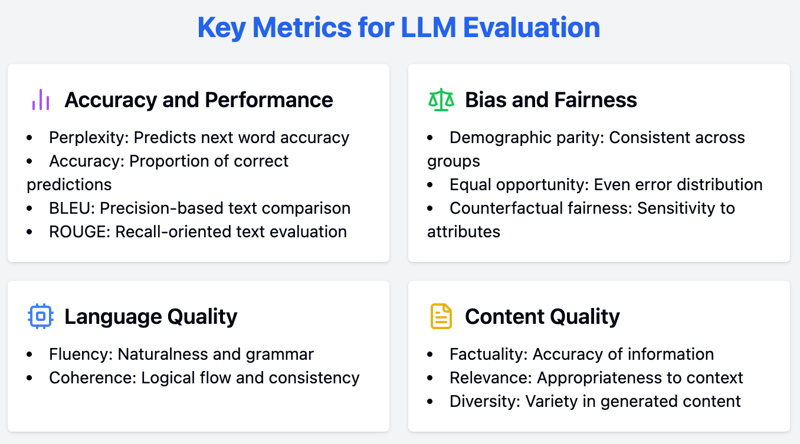
Nauwkeurigheids- en performancemetrics
Prestaties nauwkeurig meten is een belangrijke stap om de capaciteiten van een LLM te begrijpen. Deze sectie gaat in op de primaire metrics die worden gebruikt om nauwkeurigheid en performance te evalueren.
Perplexity
Perplexity is een fundamentele metric om te evalueren en te meten hoe goed een LLM het volgende woord in een reeks kan voorspellen. Zo kun je het berekenen:
- Waarschijnlijkheid: eerst berekent het model de waarschijnlijkheid van elk woord dat als volgend in een zin kan komen.
- Inverse waarschijnlijkheid: we nemen het omgekeerde van deze waarschijnlijkheid. Bijvoorbeeld: als een woord een hoge waarschijnlijkheid heeft (het model acht het waarschijnlijk), dan is de inverse waarschijnlijkheid lager.
- Normalisatie: vervolgens middelen we deze inverse waarschijnlijkheid over alle woorden in de testset (de tekst waarop we het model testen).
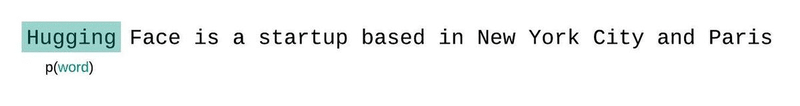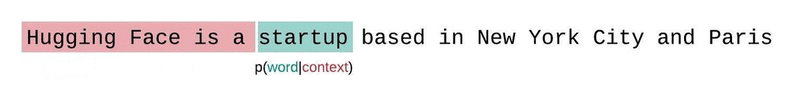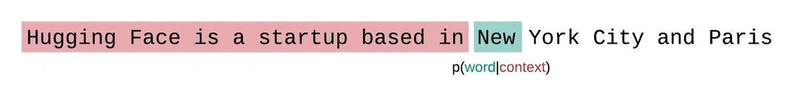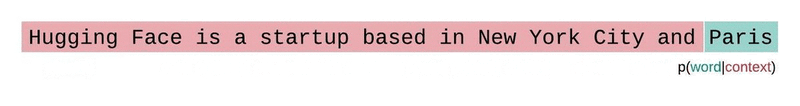
Illustratie van een LLM die de kans op het volgende woord voorspelt op basis van de context. Bron
Lagere perplexity-scores geven aan dat het model het volgende woord nauwkeuriger voorspelt, wat betere prestaties weerspiegelt. In essentie kwantificeert het hoe goed een kansverdeling of voorspellend model een steekproef voorspelt.
Voor LLM's betekent een lagere perplexity dat het model zekerder is van zijn woordvoorspellingen, wat leidt tot samenhangendere en contextueel passender tekstgeneratie.
Accuracy
Accuracy is een veelgebruikte metric voor classificatietaken en staat voor het aandeel correcte voorspellingen door het model. Hoewel dit doorgaans een intuïtieve metric is, kan het in de context van open-einde generatie taken vaak misleidend zijn.
Bijvoorbeeld: bij het genereren van creatieve of contextueel genuanceerde tekst is de "correctheid" van de output niet zo eenduidig te definiëren als bij taken zoals sentimentanalyse of topicclassificatie. Daarom is accuracy nuttig voor specifieke taken, maar moet het bij LLM-evaluaties worden aangevuld met andere metrics.
BLEU/ROUGE-scores
BLEU (Bilingual Evaluation Understudy) en ROUGE (Recall-Oriented Understudy for Gisting Evaluation) worden gebruikt om de kwaliteit van gegenereerde tekst te evalueren door die te vergelijken met referentieteksten.
BLEU draait om precisie: als een machinale vertaling exact dezelfde woorden gebruikt als een menselijke vertaling, krijgt die een hoge BLEU-score. Als de menselijke referentie bijvoorbeeld "The cat is on the mat" is en de machine-output "The cat sits on the mat", dan is de BLEU-score hoog omdat veel woorden overlappen.
ROUGE focust op recall: het controleert of de door de machine gegenereerde tekst alle belangrijke ideeën uit de menselijke referentie bevat. Stel dat een menselijk geschreven samenvatting luidt: "The study found that people who exercise regularly tend to have lower blood pressure." Als de AI-samenvatting "Exercise linked to lower blood pressure" is, zou ROUGE een hoge score geven omdat het de kern weergeeft, ook al is de bewoording anders.
Deze metrics zijn nuttig voor taken zoals machinale vertaling, samenvatten en tekstgeneratie, en geven een kwantitatieve inschatting van hoe dicht de modeloutput bij menselijk gegenereerde referentieteksten ligt.
Bias- en eerlijkheidsmetrics
Zorgen voor eerlijkheid en het verminderen van bias in LLM's is essentieel voor eerlijke toepassingen. Hier behandelen we kernmetrics voor het evalueren van bias en eerlijkheid in LLM's.
Demografische pariteit
Demografische pariteit geeft aan of de prestaties van een model consistent zijn over verschillende demografische groepen. Het evalueert de proportie positieve uitkomsten tussen groepen gedefinieerd door kenmerken zoals ras, gender of leeftijd.
Demografische pariteit bereiken betekent dat de voorspellingen van het model niet bevooroordeeld zijn ten gunste van een specifieke groep, wat eerlijkheid en gelijkheid in de toepassing waarborgt.
Gelijke kansen
Gelijke kansen richten zich op de vraag of de fouten van het model gelijkmatig zijn verdeeld over verschillende demografische groepen. Het beoordeelt de false-negative-ratio's per groep en controleert of het model niet onevenredig vaak faalt voor bepaalde demografieën.
Deze metric is cruciaal voor toepassingen waar eerlijkheid en gelijke toegang essentieel zijn, zoals wervingsalgoritmen of processen voor het goedkeuren van leningen.
Counterfactual fairness
Counterfactual fairness beoordeelt of de voorspellingen van een model zouden veranderen als bepaalde gevoelige attributen anders waren. Dit omvat het genereren van contrafeitelijke voorbeelden waarbij het gevoelige attribuut (bijv. gender of ras) wordt aangepast terwijl andere kenmerken gelijk blijven.
Als de voorspelling van het model door deze aanpassing verandert, wijst dat op een bias gerelateerd aan het gevoelige attribuut. Counterfactual fairness is cruciaal om biases te identificeren en te beperken die met andere metrics niet zichtbaar zijn.
Andere metrics
Naast performance en eerlijkheid zijn aanvullende criteria nuttig voor een volledige evaluatie van LLM's. Deze sectie licht deze aspecten uit.
Vloeiendheid
Vloeiendheid beoordeelt de natuurlijkheid en grammaticale correctheid van de gegenereerde tekst. Een vloeiende LLM produceert outputs die prettig lezen en makkelijk te begrijpen zijn, met de flow van mensentaal.
Dit kan worden geëvalueerd met geautomatiseerde tools of menselijke beoordeling, met focus op zaken als grammatica, zinsbouw en algehele leesbaarheid.
Coherentie
Coherentie helpt de logische opbouw en consistentie van de gegenereerde tekst te analyseren. Coherente tekst behoudt een duidelijke structuur en logische voortgang van ideeën, waardoor lezers makkelijk kunnen volgen. Coherentie is vooral belangrijk bij langere teksten, zoals essays of artikelen, waar een consistente verhaallijn cruciaal is.
Feitelijkheid
Feitelijkheid beoordeelt de juistheid van de informatie die de LLM geeft, met name bij informatiegerichte taken. Deze metric bevestigt dat het model tekst genereert die niet alleen plausibel is, maar ook feitelijk correct.
Feitelijkheid is onmisbaar voor toepassingen zoals nieuwsproductie, educatieve content en klantenservice, waar het leveren van correcte informatie het hoofddoel is.
Evaluatiemethodologieën
Een robuuste evaluatie van LLM's combineert kwantitatieve en kwalitatieve benaderingen. Deze sectie bespreekt diverse methodologieën, zoals benchmarkdatasets, methoden voor menselijke evaluatie en geautomatiseerde evaluatie, om LLM-prestaties grondig te beoordelen.
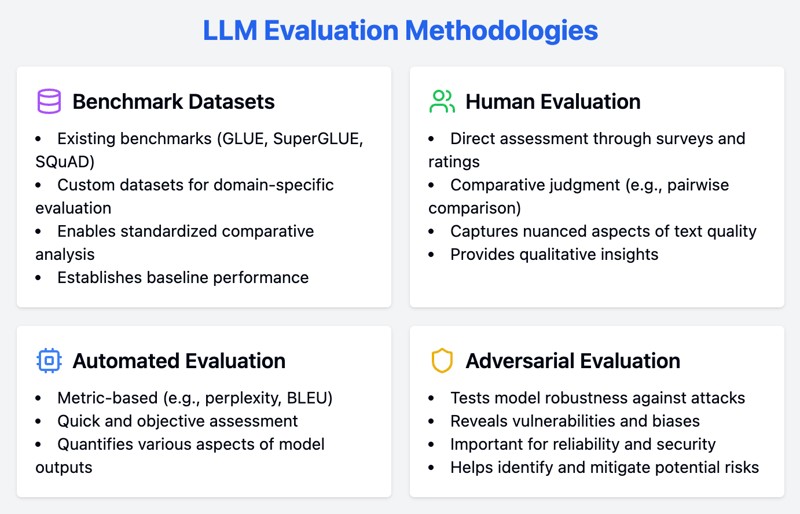
Benchmarkdatasets
Benchmarkdatasets zijn waardevolle hulpmiddelen voor het evalueren van LLM's. Ze bieden gestandaardiseerde taken waarmee je modellen onderling kunt vergelijken. Deze datasets helpen een basislijn voor modelprestaties vast te leggen en benchmarking mogelijk te maken.
Bestaande benchmarks
Benchmarkdatasets zijn belangrijke tools om LLM's te evalueren. Ze bieden gestandaardiseerde taken waarmee je modellen kunt vergelijken. Enkele van de populairste benchmarkdatasets voor uiteenlopende natural language processing (NLP)-taken zijn:
- GLUE (General Language Understanding Evaluation): een verzameling diverse taken om de algemene taalkundige capaciteiten van LLM's te evalueren, waaronder sentimentanalyse, tekstuele entailment en vraagbeantwoording.
- SuperGLUE: een geavanceerde versie van GLUE, met uitdagendere taken om de robuustheid en genuanceerde taalbegrip van LLM's te testen.
- SQuAD (Stanford Question Answering Dataset): een dataset gericht op begrijpend lezen, waarbij modellen worden beoordeeld op hun vermogen om vragen te beantwoorden die uit Wikipedia-artikelen zijn afgeleid.
Aangepaste datasets
Hoewel bestaande benchmarks onmisbaar zijn, is het maken van aangepaste datasets cruciaal voor domeinspecifieke evaluatie. Aangepaste datasets stellen ons in staat het evaluatieproces af te stemmen op de unieke vereisten en uitdagingen van een specifieke toepassing of sector.
Een zorgorganisatie kan bijvoorbeeld een dataset van medische dossiers en klinische notities samenstellen om te evalueren hoe een LLM met medische terminologie en context omgaat. Aangepaste datasets zorgen ervoor dat de modelprestaties aansluiten op realistische use-cases en leveren relevantere, actiegerichte inzichten op.
Menselijke evaluatie
Methoden voor menselijke evaluatie zijn onmisbaar om genuanceerde aspecten van LLM-outputs te beoordelen die geautomatiseerde metrics kunnen missen. Deze technieken omvatten directe feedback van menselijke beoordelaars en bieden kwalitatieve inzichten in de modelprestaties.
Directe beoordeling
Menselijke evaluatie blijft de gouden standaard voor het beoordelen van de kwaliteit van LLM-outputs. Directe beoordelingsmethoden omvatten het verzamelen van feedback van menselijke beoordelaars via enquêtes en beoordelingsschalen.
Deze methoden kunnen genuanceerde aspecten van tekstkwaliteit vastleggen, zoals vloeiendheid, coherentie en relevantie, die geautomatiseerde metrics kunnen over het hoofd zien. Beoordelaars kunnen kwalitatieve feedback geven over specifieke sterke en zwakke punten en zo gerichte verbeterpunten identificeren.
Vergelijkend oordeel
Vergelijkend oordeel omvat technieken zoals pairwise comparison, waarbij menselijke beoordelaars de outputs van verschillende modellen direct vergelijken. Deze methode kan betrouwbaarder zijn dan absolute beoordelingsschalen, omdat ze de subjectiviteit van individuele scores vermindert.
Beoordelaars kiezen het beste resultaat uit paren van gegenereerde teksten, wat een relatieve rangschikking van modelprestaties oplevert. Vergelijkend oordeel is vooral nuttig voor het fijn-afstellen van modellen en het selecteren van best presterende varianten.
Geautomatiseerde evaluatie
Geautomatiseerde evaluatiemethoden bieden een snelle en objectieve manier om LLM-prestaties te beoordelen. Deze methoden gebruiken verschillende metrics om uiteenlopende aspecten van modeloutputs te kwantificeren voor een complete evaluatie.
Op metrics gebaseerd
Geautomatiseerde metrics bieden een snelle en objectieve manier om LLM-prestaties te evalueren. Metrics zoals perplexity en BLEU worden veel gebruikt om verschillende aspecten van tekstgeneratie te beoordelen.
Zoals eerder besproken, meet perplexity het voorspellend vermogen van het model, waarbij lagere scores op betere prestaties duiden. BLEU beoordeelt daarentegen de kwaliteit van gegenereerde tekst door die te vergelijken met referentieteksten, met focus op de precisie van n-grams.
Adversariële evaluatie
Adversariële evaluatie houdt in dat je LLM's aan adversariële aanvallen blootstelt om hun robuustheid te testen. Deze aanvallen zijn ontworpen om zwaktes en biases in het model uit te buiten en zo kwetsbaarheden bloot te leggen die met standaardmethoden mogelijk niet zichtbaar zijn.
Een adversariële aanval kan bestaan uit het invoeren van subtiel aangepaste of misleidende data om te analyseren hoe het model reageert. Deze aanpak is nuttig voor toepassingen waar betrouwbaarheid en veiligheid zwaar wegen, omdat het helpt potentiële risico's te identificeren en te beperken.
Best practices voor LLM-evaluatie
Om de capaciteiten van LLM's effectief te beoordelen, is een strategische aanpak nodig. Met best practices zorg je dat je evaluatie grondig, transparant en afgestemd op jouw behoeften is. Hier behandelen we best practices om te volgen.
|
Best practice |
Beschrijving |
Voorbeeldcase |
Relevante metric(s) |
|
Stel duidelijke doelen |
Identificeer de taken en doelstellingen die de LLM moet behalen voordat je met het evaluatieproces begint. |
De prestaties van een LLM voor machinale vertaling verbeteren |
BLEU/ROUGE-scores |
|
Houd rekening met je doelgroep |
Stem de evaluatie af op de beoogde gebruikers van de LLM, rekening houdend met hun verwachtingen en behoeften. |
LLM voor het genereren van tekst |
Perplexity, vloeiendheid, coherentie |
|
Transparantie en reproduceerbaarheid |
Zorg dat het evaluatieproces goed gedocumenteerd is en door anderen gerepliceerd kan worden voor verificatie en verbetering. |
Het publiek vrijgeven van de evaluatiedataset en code die zijn gebruikt om de capaciteiten van de LLM te beoordelen |
Elke relevante metric, afhankelijk van de specifieke taak en doelen van de evaluatie |
Conclusie
Deze gids gaf een volledig overzicht van de essentiële metrics en methodologieën om LLM's te beoordelen, van perplexity en accuracy tot maatstaven voor bias en eerlijkheid.
Door zowel kwantitatieve als kwalitatieve evaluatietechnieken toe te passen en best practices te volgen, zorgen we voor een grondige en betrouwbare beoordeling van deze modellen.
Met deze kennis zijn we beter in staat LLM's te selecteren en implementeren die het best aan onze behoeften voldoen, zodat ze optimaal presteren en betrouwbaar zijn binnen onze gekozen toepassingen.

Recent afgestudeerde MSc met een specialisatie in kunstmatige intelligentie


Grote taalmodellen (LLM's) worden razendsnel onmisbaar in talloze toepassingen, van chatbots tot contentcreatie.
Het evalueren van deze krachtige modellen is echter een uitdaging. Hoe meten we hun prestaties en betrouwbaarheid nauwkeurig, gezien hun diverse mogelijkheden en implementaties?
Deze gids biedt een uitgebreid overzicht van LLM-evaluatie, met essentiële metrics, methodologieën en best practices om je te helpen weloverwogen keuzes te maken over welke modellen het beste bij jouw behoeften passen.