Cursus
Introductie tot Embeddings met de OpenAI API
3 uur
24.1K
Oefen en volg je voortgang.
Ga Verder Met GoogleTekstembedding (hetzelfde als woordembeddings) is een transformerende techniek in Natural Language Processing (NLP) die heeft verbeterd hoe machines menselijke taal begrijpen en verwerken.
Tekstembedding zet ruwe tekst om in numerieke vectoren, zodat computers die beter kunnen begrijpen.
De reden is simpel: computers denken alleen in cijfers en kunnen menselijke woorden niet op zichzelf begrijpen. Dankzij tekstembeddings wordt het voor computers makkelijker om teksten te lezen, te begrijpen en nauwkeuriger te reageren op vragen.
In dit artikel ontrafelen we de betekenis van tekstembedding, het belang ervan, de evolutie, use cases, topmodellen en de onderliggende intuïtie.
Tekstembeddings zijn een manier om woorden of zinnen uit tekst om te zetten in numerieke data die een machine kan begrijpen. Zie het als het omzetten van tekst in een lijst met getallen, waarbij elk getal een deel van de betekenis van de tekst vastlegt. Deze techniek helpt machines de context en relaties tussen woorden te doorgronden.
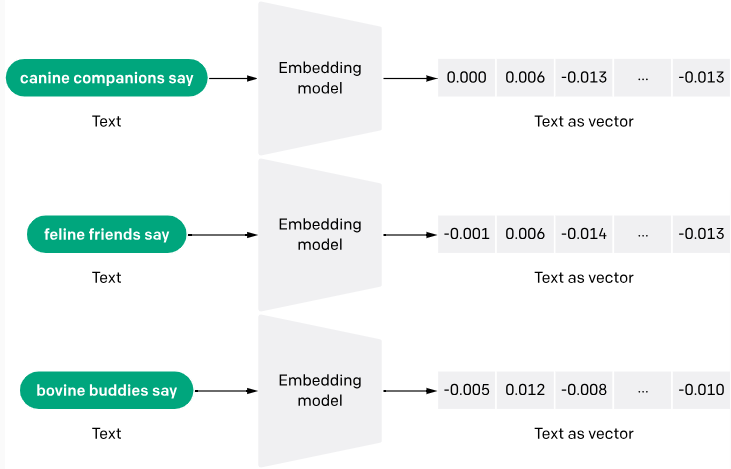
Het genereren van tekstembeddings gebeurt vaak met neurale netwerken die leren de semantische betekenis van woorden te coderen in dichte vectoren van reële getallen. Methoden als Word2Vec en GloVe zijn populair om deze embeddings te maken door co-occurrences van woorden in grote tekstverzamelingen te analyseren.
Je kunt meer leren over tekstembeddings met de OpenAI API en een praktische toepassing zien in een apart artikel.
Conventionele taalmodellen beschouwden woorden als onafhankelijke eenheden. Woordembeddings pakken dit probleem aan door woorden met gedeelde betekenissen of contexten dicht bij elkaar te plaatsen in een multidimensionale ruimte.
Hier zijn nog wat redenen waarom tekstembeddings belangrijk zijn:
Embeddings helpen modellen beter te generaliseren naar nieuwe, ongeziene woorden of zinnen door gebruik te maken van de geleerde context uit de trainingsdata. Dit is vooral nuttig in dynamische talen waarin regelmatig nieuwe woorden opduiken.
Embeddings worden veel gebruikt als features in diverse machinelearning-taken, zoals documentclassificatie, sentimentanalyse en automatische vertaling. Ze verbeteren de prestaties van algoritmen door een rijke, compacte vorm van data te bieden die basale tekstuele eigenschappen vastlegt.
Tekstembeddings kunnen meerdere talen afhandelen door semantische overeenkomsten over verschillende talen heen te identificeren en te representeren. Een voorbeeld is het Language-agnostic BERT Sentence Embedding (LaBSE)-model, dat opmerkelijke capaciteiten heeft laten zien in het produceren van cross-linguale zinsembeddings voor 109 talen.
Traditionele methoden zoals one-hot encoding kunnen tot sparse data leiden (vooral omdat de meeste observaties een waarde van 0 hebben) en tot hoog-dimensionale vectoren, wat inefficiënt is voor grote woordenschatten. Embeddings verlagen de dimensionaliteit en computationele complexiteit, waardoor ze beter geschikt zijn voor het verwerken van grote hoeveelheden tekstdata.
Tekstembeddings zijn dichte vectorrepresentaties van tekstdata, waarbij woorden en documenten met vergelijkbare betekenissen worden weergegeven door vergelijkbare vectoren in een hoog-dimensionale vectorruimte.
De intuïtie achter tekstembeddings is het vastleggen van de semantische en contextuele relaties tussen tekstelementen, zodat machinelearning-modellen tekstdata effectiever kunnen verwerken en erover kunnen redeneren.
Een van de kernintuïties achter tekstembeddings is de distributionele hypothese, die stelt dat woorden of zinnen die in vergelijkbare contexten voorkomen, de neiging hebben vergelijkbare betekenissen te hebben.
Neem bijvoorbeeld de woorden "king" en "queen". Hoewel het geen synoniemen zijn, delen ze een vergelijkbare context die met royalty en monarchie te maken heeft. Tekstembeddings proberen deze semantische gelijkenis vast te leggen door deze woorden te representeren met vectoren die dicht bij elkaar liggen in de vectorruimte.
Een andere intuïtie achter tekstembeddings is het idee van vectorruimte-bewerkingen. Door tekst als numerieke vectoren te representeren, kunnen we bewerkingen in de vectorruimte gebruiken, zoals optellen, aftrekken en cosinus-similariteit, om semantische relaties tussen woorden en zinnen vast te leggen en te manipuleren. Laten we bijvoorbeeld het volgende voorbeeld bekijken:
king - man + woman ≈ queen
In dit voorbeeld kan de vectorbewerking "king - man + woman" resulteren in een vector die heel dicht bij de embedding voor "queen" ligt, waarmee de analoge relatie tussen deze woorden wordt vastgelegd.
Een andere intuïtie die ik wil benadrukken is dimensionaliteitsreductie bij tekstembedding. Traditionele sparse tekstrepresentaties, zoals one-hot encoding, kunnen extreem hoge dimensionaliteit hebben (gelijk aan de grootte van de woordenschat). Tekstembeddings hebben daarentegen doorgaans een lagere dimensionaliteit (bijv. 300 dimensies), waardoor ze de meest opvallende kenmerken van de tekst kunnen vastleggen en tegelijkertijd ruis en computationele complexiteit verminderen.
Ik gebruik het voorbeeld van een restaurant om een algemene intuïtie van woordembeddings te illustreren:
Stel, je hebt een corpus met restaurantrecensies en je wilt een systeem bouwen dat automatisch het sentiment van elke recensie classificeert als positief of negatief. Ik raad aan om tekstembeddings te gebruiken om elke recensie als een dichte vector te representeren, zodat de semantische betekenis en het sentiment in de tekst worden vastgelegd.
Laten we twee recensies bekijken:
Recensie 1: "The food was delicious, and the service was excellent. I highly recommend this restaurant."
Recensie 2: "The food was mediocre, and the service was poor. I won't be going back."
Hoewel deze recensies niet veel woorden delen, zouden hun embeddings ver van elkaar verwijderd moeten zijn in de vectorruimte, wat de tegengestelde sentimenten weerspiegelt. De positieve sentimentwoorden zoals "delicious" en "excellent" in Recensie 1 zouden embeddings hebben die dichter bij de positieve regio van de vectorruimte liggen, terwijl de negatieve sentimentwoorden zoals "mediocre" en "poor" in Recensie 2 dichter bij de negatieve regio zouden liggen.
Door een machinelearning-model te trainen op deze tekstembeddings kan het de semantische patronen en sentimentinformatie in de embeddings leren koppelen aan de bijbehorende sentimentlabels (positief of negatief), en zo nieuwe, ongeziene recensies nauwkeurig classificeren.
Volgens het boek “Embeddings in Natural Language Processing: Theory and Advances in Vector Representations of Meaning” van Mohammad Taher Pilehvar en Jose Camacho-Collados werden tekstembeddings
“voornamelijk populair na 2013, met de introductie van Word2vec.”
Dit jaar betekende inderdaad een grote doorbraak voor tekstembeddings. Onderzoek naar tekstembeddings gaat echter terug tot de jaren 50. Hoewel dit gedeelte niet uitputtend is, behandel ik enkele van de belangrijkste mijlpalen in de evolutie van tekstembeddings.
Van de jaren 50 tot 2000 waren methoden als one-hot encoding en Bag-of-Words (BoW) de norm. Helaas waren deze methoden niet erg toereikend en brachten ze uitdagingen met zich mee, zoals:
TF-IDF (Term Frequency–Inverse Document Frequency) was in de jaren 70 een andere vroege poging om teksten als getallen te vatten. Deze aanpak berekende het gewicht van elk woord niet alleen op basis van de frequentie in een specifiek document, maar ook op basis van hoe algemeen het woord is in alle documenten, waarbij minder voorkomende woorden hogere waarden kregen. Hoewel dit een verbetering was ten opzichte van one-hot encoding en meer inzicht bood, schoot het nog steeds tekort in het vastleggen van de semantische betekenis van woorden.
Volgens IBM begonnen onderzoekers in de jaren 2000
“neurale taalmodellen (NLM's) te verkennen, die neurale netwerken gebruiken om de relaties tussen woorden in een continue ruimte te modelleren. Deze vroege modellen legden de basis voor de latere ontwikkeling van woordembeddings.”
Een vroeg voorbeeld is de introductie van "Neural probabilistic language models" door Bengio et al. rond 2000, die gericht waren op het leren van gedistribueerde representaties van woorden.
Later, in 2013, verscheen Word2Vec als het revolutionaire model dat het idee introduceerde om woorden om te zetten in numerieke vectoren. Deze vectoren legden semantische gelijkenissen vast, zodat woorden met vergelijkbare betekenissen dichter bij elkaar eindigden in de vectorruimte. Het was alsof je een kaart van woorden maakte op basis van hun relaties.
In 2014 werd GloVe geïntroduceerd in een onderzoekspaper getiteld “GloVe: Global Vectors for Word Representation” door Jeffery Pennington en zijn coauteurs. GloVe verbeterde Word2Vec door woordbetekenissen beter te begrijpen, zowel door de directe context van een woord als door het algemene gebruik in het corpus mee te nemen.
In deze periode kwamen methoden als attention-mechanismen (2017) en Transfer Learning en context (2018) op de voorgrond.
Attention-mechanismen stelden modellen in staat zich te richten op specifieke delen van een zin en daaraan verschillende gewichten toe te kennen op basis van hun belangrijkheid. Dit hielp het model de relaties tussen woorden en hun bijdrage aan de betekenis te begrijpen.
In de zin "The quick brown fox jumps over the lazy dog" kan het attention-mechanisme bijvoorbeeld meer aandacht besteden aan "quick" en "jumps" bij het voorspellen van het volgende woord, vergeleken met "the" of "brown".
Aan de andere kant zorgden Transfer Learning en context voor de doorbraak van voorgetrainde modellen. Technieken als ULMFiT en BERT maakten het mogelijk deze voorgetrainde modellen fijn af te stemmen voor specifieke taken. Daardoor waren minder data en rekenkracht nodig voor hoge prestaties.
Embedding-API's zijn een recente benadering van tekstembedding. Hoewel ze recent zijn, gaat hun geleidelijke opkomst terug tot de jaren 2010, toen cloudgebaseerde AI-oplossingen en vooruitgang in voorgetrainde modellen wijdverbreid raakten.
Snel vooruit naar de jaren 2020. Het gebruik van API's is enorm toegenomen binnen de ontwikkelaarscommunity, en embedding-API's dus ook. Een embedding-API maakt het eenvoudiger om embeddings voor teksten te verkrijgen via voorgetrainde modellen.
Een goed voorbeeld van een embedding-API is de OpenAI embedding API. OpenAI introduceerde zijn Embedding API met belangrijke updates in december 2022. Deze API biedt één uniform model, text-embedding-ada-002, dat mogelijkheden van meerdere eerdere modellen in één model samenbrengt. Dit model is ontworpen om uit te blinken in taken als tekstzoekopdrachten, codezoekopdrachten en zinsgelijkenis.
Laten we enkele use cases van tekstembeddings bespreken.
Woordembeddings stellen zoekmachines in staat de onderliggende betekenis van je zoekopdracht te begrijpen en relevante documenten te vinden, zelfs als die niet exact de woorden bevatten die jij hebt gebruikt. Dit is vooral handig bij ambigue zoekopdrachten of het vinden van vergelijkbare content.
E-commerceplatforms, socialmediaplatforms en streamingdiensten zijn veelvoorkomende toepassingen die tekstembeddings gebruiken om producten of content aan te bevelen op basis van je eerdere voorkeuren. Door de beschrijvingen en reviews van items waarmee je interactie had te analyseren, kunnen ze vergelijkbare dingen voorstellen die je mogelijk interesseren.
Meta (Facebook) gebruikt tekstembeddings voor zijn sociale zoekfunctie. Je kunt hier meer over leren in dit abstract.
Tekstembeddings gaan verder dan één-op-één vertaling van woorden. Ze houden rekening met de context en betekenis van de tekst, wat leidt tot nauwkeurigere en natuurlijker klinkende vertalingen.
Chatbots die gebruikmaken van tekstembeddings kunnen de intentie achter je vragen begrijpen en zinvoller en boeiender reageren. Ze kunnen het sentiment van je bericht analyseren en hun communicatiestijl daarop afstemmen.
Woordembeddings kunnen worden gebruikt om verschillende creatieve tekstformaten te genereren, zoals productbeschrijvingen of socialmediaberichten. Merken kunnen ook tekstembeddings gebruiken om gesprekken op sociale media te analyseren en het klantensentiment ten opzichte van hun producten of diensten te begrijpen.
Hier volgt een blik op de beste tekstembedding-modellen, inclusief zowel open-source als closed-source opties:
Zoals we al bespraken, is Word2Vec een van de pionierende tekstembedding-modellen. Het werd ontwikkeld door Tomas Mikolov en collega's bij Google. Word2Vec gebruikt ondiepe neurale netwerken om woordvectoren te genereren die semantische gelijkenissen vastleggen.
Word2Vec maakt gebruik van twee modelarchitecturen: Continuous Bag-of-Words (CBOW) en Skip-Gram. CBOW voorspelt een woord op basis van de omringende context, terwijl Skip-Gram de omringende woorden voorspelt op basis van een gegeven woord. Dit proces helpt semantische relaties tussen woorden te coderen.
Populaire NLP-bibliotheken zoals Gensim en spaCy bieden implementaties van Word2Vec. Je vindt de open-source versie van Word2Vec, gehost door Google en uitgebracht onder de Apache 2.0-licentie.
Stanford's GloVe is een ander veelgebruikt model. Het richt zich op het vastleggen van zowel lokale als globale context door co-occurrencestatistieken van woorden binnen een groot tekstcorpus te analyseren. GloVe bouwt een woord-co-occurrencematrix en factoriseert die vervolgens om woordvectoren te verkrijgen. Dit proces houdt rekening met zowel nabije als verre co-occurrences, wat leidt tot een omvattend begrip van woordbetekenis.
GloVe is ook open-source. Voorgetrainde GloVe-vectoren zijn beschikbaar om te downloaden, en implementaties zijn onder meer te vinden in bibliotheken zoals Gensim.
FastText, ontwikkeld door Facebook (nu Meta), is een uitbreiding op Word2Vec die de beperking aanpakt dat out-of-vocabulary (OOV) woorden niet worden afgehandeld. Het neemt subwoordinformatie op om woorden te representeren, waardoor het embeddings kan maken voor ongeziene woorden.
FastText splitst woorden op in karakter-n-grammen (subwoorden). Net als Word2Vec traint het woordvectoren op basis van deze subwoordeenheden. Hierdoor kan het model nieuwe woorden representeren op basis van de betekenis van hun samenstellende subwoorden.
FastText is open-source en beschikbaar via de FastText-bibliotheek. Voorgetrainde FastText-vectoren zijn ook te downloaden voor diverse talen.
Embedding v3 (Text-embedding-3) is de nieuwste release van OpenAI's embedding-modellen. De modellen komen in twee klassen: text-embedding-3-small (het kleinere model) en text-embedding-3-large (het grotere model). Ze zijn closed-source en je hebt een betaalde API nodig om toegang te krijgen.
Text-embedding-3-modellen zetten tekst om in numerieke representaties door die eerst op te splitsen in tokens (woorden of subwoorden). Elk token wordt afgebeeld op een vector in een hoog-dimensionale ruimte. Een Transformer-encoder analyseert vervolgens deze vectoren, waarbij de context van elk woord wordt meegenomen op basis van zijn omgeving.
Tot slot geeft het model één vector terug die de volledige tekst representeert, waarin de algehele betekenis en de relaties tussen de woorden zijn vastgelegd. De grote versie heeft een complexere architectuur en hogere dimensionaliteit voor mogelijk betere nauwkeurigheid, terwijl de kleine versie snelheid en efficiëntie prioriteert met een eenvoudigere architectuur en lagere dimensionaliteit.
Wil je meer weten over OpenAI-embeddings? Bekijk dan onze gids: Exploring Text-Embedding-3-Large: A Comprehensive Guide to the new OpenAI Embeddings.
USE is een closed-source zinsembedding-model van Google AI. Het zet tekst om in hoog-dimensionale embeddings die de semantische betekenis van zinnen of korte alinea's weerspiegelen.
In tegenstelling tot modellen die individuele woorden embedden, verwerkt USE volledige zinnen met een voorgetraind diep neuraal netwerk op een divers tekstcorpus. Dit ontwerp stelt het in staat semantische relaties effectief vast te leggen en produceert vectoren met vaste grootte voor zinnen met variabele lengte, wat de computationele efficiëntie verhoogt.
Google biedt toegang via de TensorFlow Hub-repository.
In deze gids kregen we een uitgebreide introductie tot tekstembeddings, wat ze betekenen, hun belang en de belangrijkste mijlpalen in hun evolutie. We bekeken ook use cases van tekstembeddings en toonaangevende tekstembedding-modellen.
Wil je je verdiepen in AI, NLP en tekstembeddings? Bekijk dan deze bronnen:
Leer meer over AI met DataCamp
Cursus
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

