
Leerpad
AI-basisprincipes
10 uur
In deze tutorial leren we over Stable Diffusion XL en DreamBooth, en hoe je het afbeeldingsgeneratiemodel gebruikt met de Diffusers-bibliotheek. Daarnaast leren we het model te finetunen op persoonlijke foto’s en de prestaties te evalueren. Ben je nieuw in AI? Volg dan eerst de cursus AI Fundamentals als opstap.
Het team van Stability AI heeft Stable Diffusion XL (SDXL) 1.0 uitgebracht, de volgende evolutie in AI-modellen voor tekst-naar-beeldgeneratie. Dit open-sourcemodel bouwt voort op het eerdere, alleen-voor-onderzoek beschikbare SDXL 0.9 en is uitgegroeid tot het meest capabele, publiek beschikbare beeldcreatiemodel ter wereld.
Zowel kwantitatieve analyses als kwalitatieve beoordelingen door mensen, over weken van experimenteren, laten zien dat SDXL de hoogste kwaliteit en meest geprefereerde beelden genereert vergeleken met andere open-sourcemodellen.
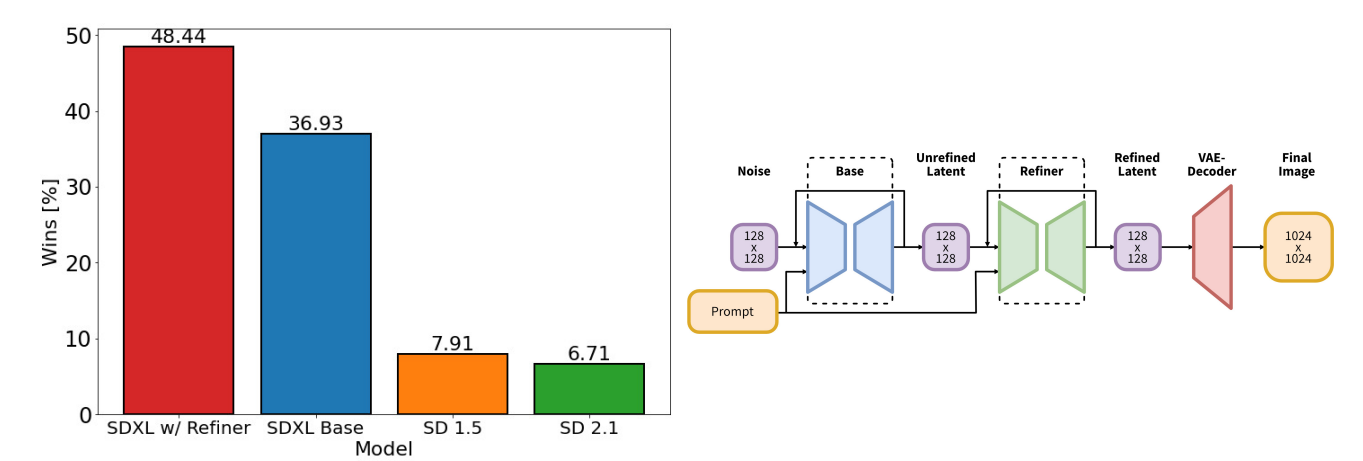
Afbeelding van arxiv.org
Deze hoge kwaliteit is bereikt door een ensemble van twee modellen te gebruiken: een basisgenerator met 3,5 miljard parameters en een refiner met 6,6 miljard parameters. Deze dubbele pijplijn maximaliseert de beeldkwaliteit en blijft toch efficiënt genoeg om op consumenten-GPU’s te draaien.
Met SDXL 1.0 heb je geen lange, complexe prompts meer nodig om verbluffende beelden te maken. Dankzij de “intelligentie” kun je met slechts een paar woorden al complexe afbeeldingen genereren.
Finetunen van SDXL op aangepaste datasets en taken is nog eenvoudiger geworden. Het geeft je fijne controle over structuur, stijl en compositie.
DreamBooth, geïntroduceerd in 2022 door het onderzoeksteam van Google, is een belangrijke stap voorwaarts binnen generatieve AI, met name voor tekst-naar-beeldmodellen zoals Stable Diffusion.
Het heet DreamBooth omdat, in de woorden van de Google-onderzoekers:
"Het is als een fotohokje, maar het legt het onderwerp zo vast dat het overal kan worden gesynthetiseerd waar je dromen je brengen."
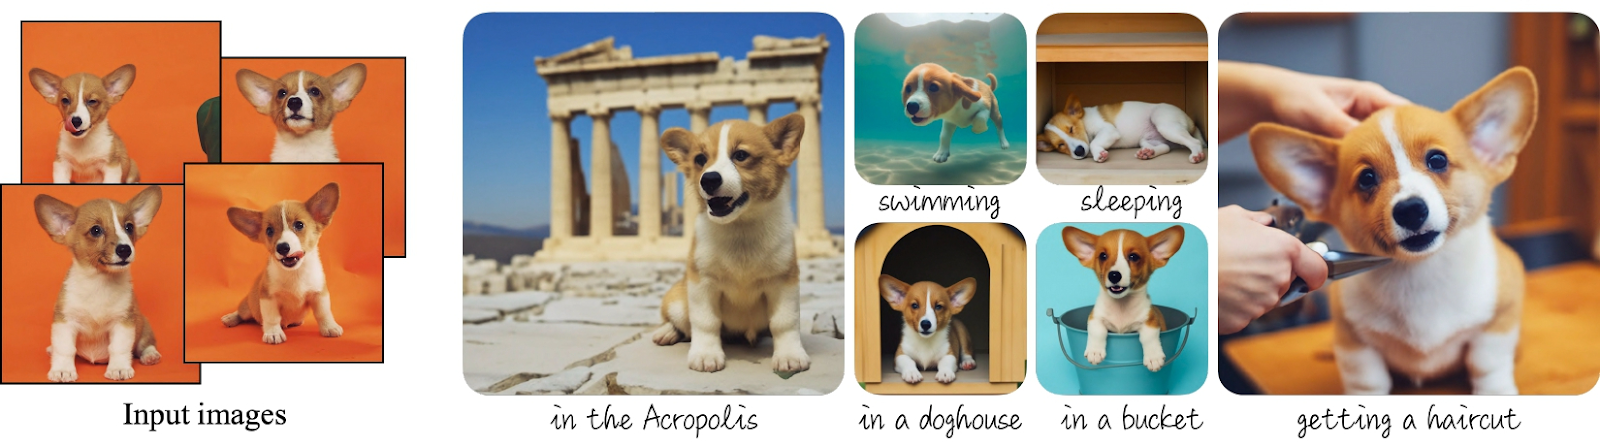
Afbeelding van DreamBooth
Met DreamBooth kun je een specifiek, aangepast onderwerp injecteren, waarop het gefinetunede model zich vervolgens specialiseert om het op verschillende manieren weer te geven. In zekere zin kun je dus je eigen beeldgenerator maken die is gericht op een bepaalde persoon, een karakter, een object of een scène.
DreamBooth heeft maar een paar (meestal 3-5) afbeeldingen van het onderwerp nodig om het model effectief te trainen. Na training kan het model het onderwerp in talloze omgevingen, scènes en poses plaatsen, beperkt alleen door de verbeelding van de gebruiker.
Het finetunen van het afbeeldingsgeneratiemodel met DreamBooth kan voor veel sectoren nuttig zijn. Het biedt meer vrijheid om te experimenteren en beelden van hoge kwaliteit te genereren, zónder Photoshop-vaardigheden. Hier zijn enkele voorbeelden van hoe het eenvoudig waarde kan toevoegen op de werkvloer.
In de volgende secties gaan we dieper in op het benaderen en finetunen van het SDXL-model op een aangepaste dataset met gratis Kaggle-GPU’s.
Je kunt de Stable Diffusion XL Spaces-demo op Hugging Face proberen, die snel vier beelden genereert op basis van je invoer. Speel ermee voordat je beslist of het geschikt is voor jouw toepassing.
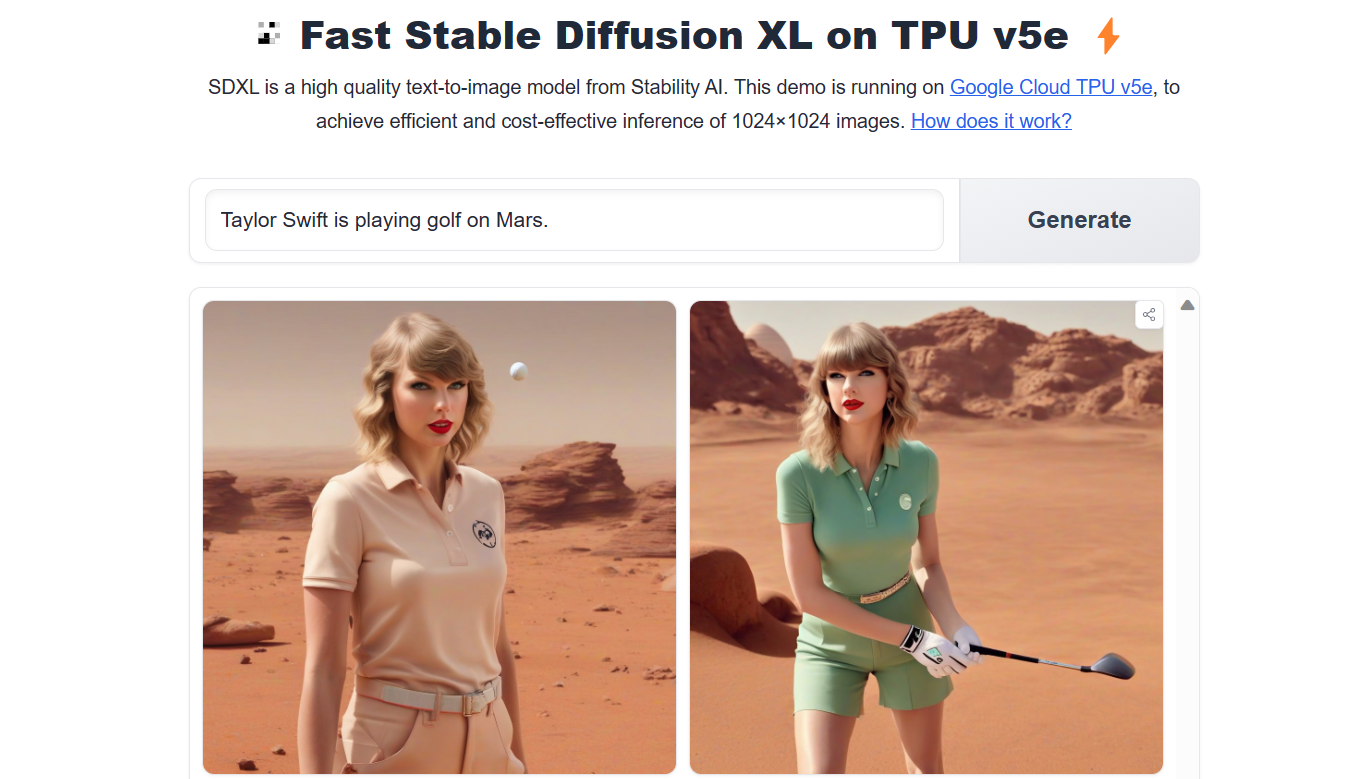
Afbeelding van Stable Diffusion XL op TPUv5e
Een andere manier is de Python-bibliotheek diffusers gebruiken om een afbeelding te genereren met je eigen prompt.
Voordat je de code draait, zorg dat je een GPU-machine met CUDA-ondersteuning gebruikt.
!nvidia-smi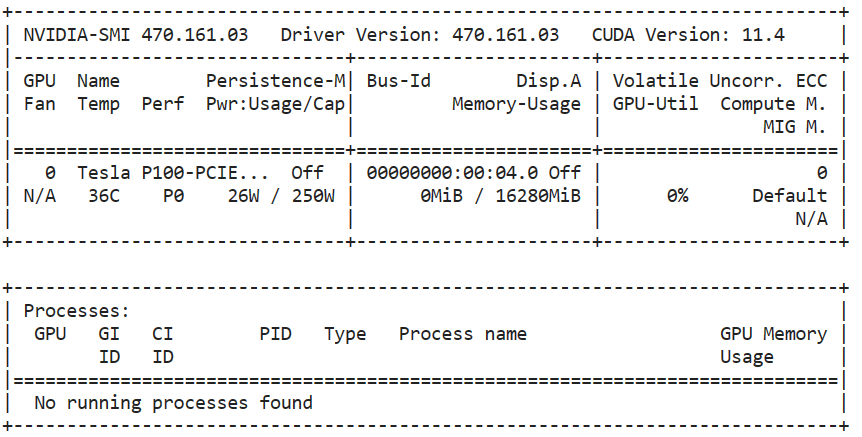
Installeer daarna het diffusers-pakket met PIP.
%pip install --upgrade diffusers[torch] -qWe laden de aangepaste VAE-decoder die is gewijzigd om in fp16-precisie te draaien zonder NaN’s te genereren.
Daarna bouwen we een pijplijn door het SDXL-basismodel met fp16-precisie te laden en de VAE-decoder te integreren in de Diffusers-workflow.
We hadden het basismodel rechtstreeks zonder “fp16” kunnen laden, maar dat zou GPU-geheugenproblemen veroorzaken. Om het op Kaggle-, Colab- en laptop-GPU’s te draaien, moet je het model dus in de fp16-variant gebruiken.
from diffusers import DiffusionPipeline, AutoencoderKL
import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");Om de afbeelding te genereren, geef je een eenvoudige prompt, het aantal inferentiestappen en het aantal beelden per prompt op.
In ons geval genereren we vier beelden uit één prompt.
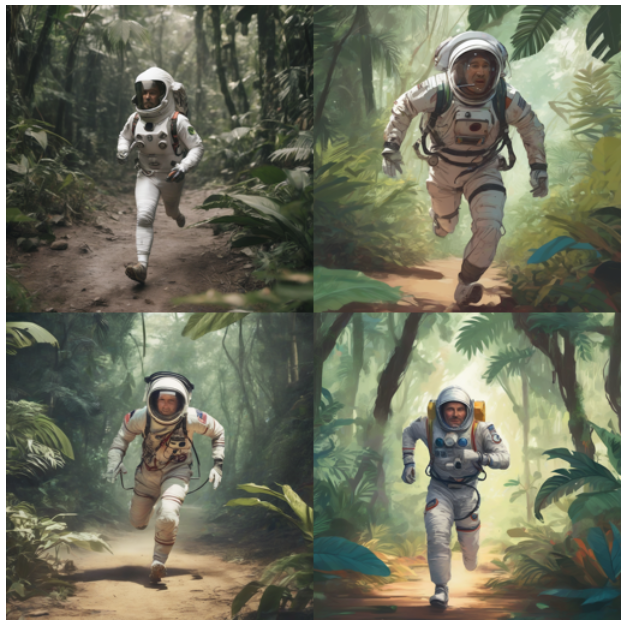
prompt = "A man in a spacesuit is running a marathon in the jungle."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 4)
Om beelden in een raster te tonen, kunnen we een eenvoudige Python-functie schrijven die de afbeeldingen schaalt en in een grid plaatst.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid
We tonen vier beelden in een 2x2-raster om de modeluitvoer makkelijk te vergelijken.
image_grid(image.images, 2, 2)De resultaten zijn geweldig. SDXL is zeker veel beter dan Stable Diffusion 1.6.
Laten we nog een prompt schrijven en drie afbeeldingen genereren van een aap die met vuurwerk speelt.
prompt = "A playful monkey handling fireworks with ease."
image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)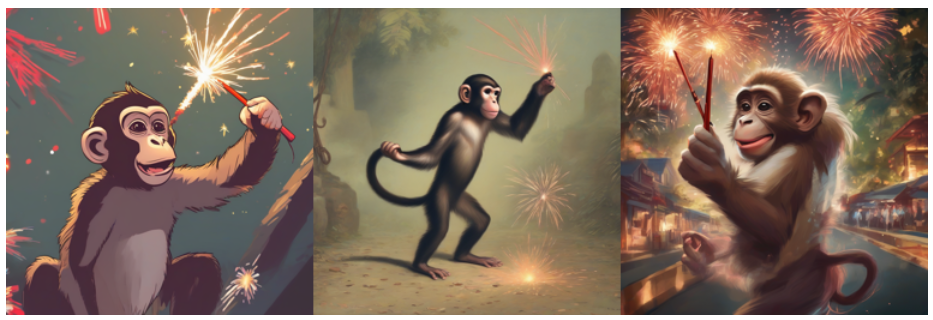
Leer hoe je het Stable Diffusion-model online en lokaal kunt gebruiken in de tutorial How to Run Stable Diffusion.
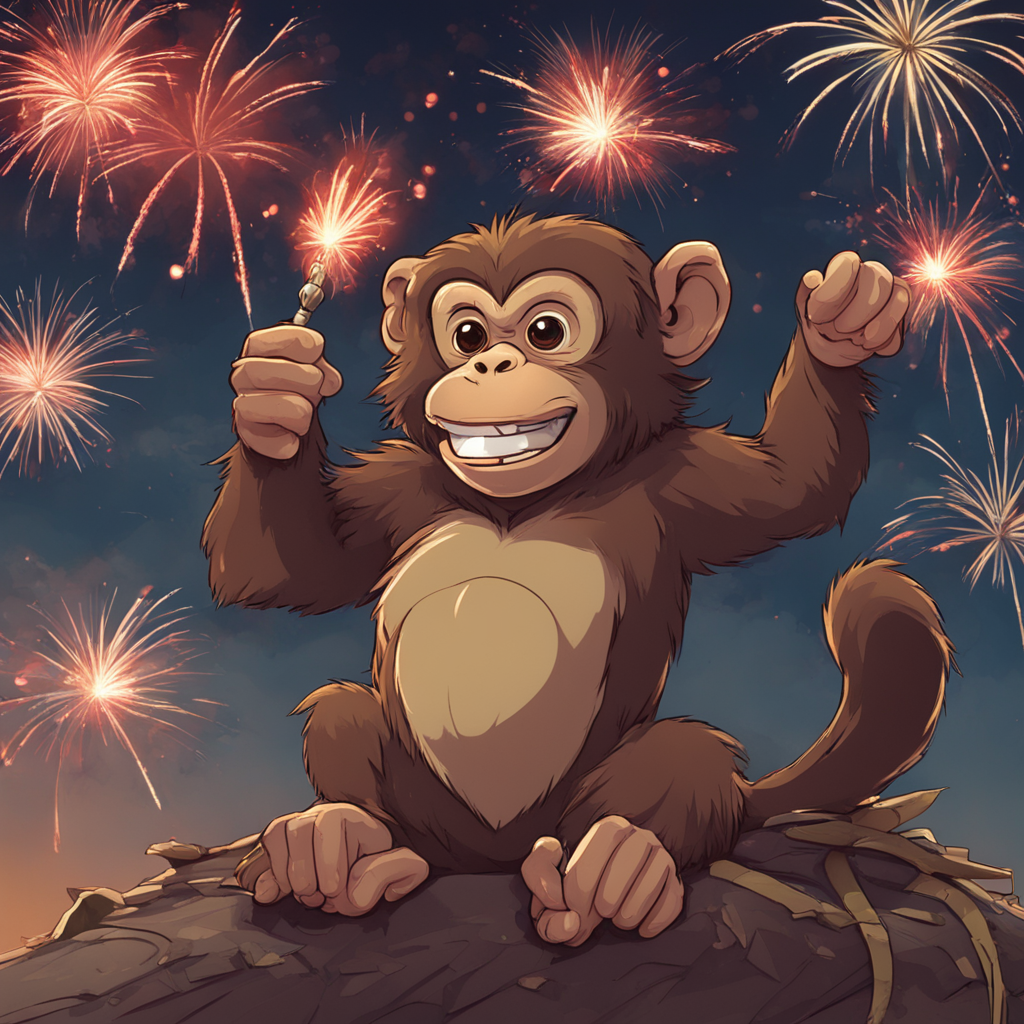
Om de beeldkwaliteit en modelnauwkeurigheid verder te verbeteren, gebruiken we de Refiner.
refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda")

n_steps = 40
high_noise_frac = 0.7

image = pipe(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_end=high_noise_frac,
    output_type="latent",
).images

image = refiner(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_start=high_noise_frac,
    image=image,
).images[0]

image
De verfijnde afbeelding is van hoge kwaliteit en volgt de prompt nauwkeurig.
Leer fotorealistische beelden genereren met Python en state-of-the-art diffusiemodellen in de code-along Generating Photorealistic Images using AI with Diffusers in Python.
SDXL finetunen is in de loop der tijd veel eenvoudiger geworden. Dankzij AutoTrain Advance kunnen we ons model nu finetunen met slechts één Python-script. Deze AutoML-bibliotheek is ontworpen voor het trainen en deployen van state-of-the-art modellen met minimale code.
Je kunt het Python-pakket installeren met PIP:
%pip install -U autotrain-advancedBen je geïnteresseerd in het finetunen van het SDXL-model met accelerate en transformers? Bekijk dan de Colab-notebook SDXL DreamBoot LoRA. De notebook is wat verouderd en je moet mogelijk aanpassingen doen om hem goed te laten draaien.
Voordat we het DreamBooth-script draaien, zetten we een paar variabelen klaar die we in het script gaan gebruiken.
PROJECT_NAME = "Dreambooth_SDXL"
MODEL_NAME = "stabilityai/stable-diffusion-xl-base-1.0"
DATA_DIR = "/kaggle/input/abids-photos"
REPO_ID = "kingabzpro/sdxl-lora-abid"
Vervolgens stel je een Hugging Face-token in met de Secret-functie van Kaggle. Leer hoe je secrets instelt in de Mistral 7B Tutorial: Step-by-Step Guide for Using Mistral 7B.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
HF_TOKEN = user_secrets.get_secret("HUGGINGFACE_TOKEN")Om de privédataset van je selfies in Kaggle te maken, klik je op de uploadknop in het rechterpaneel van de notebook.
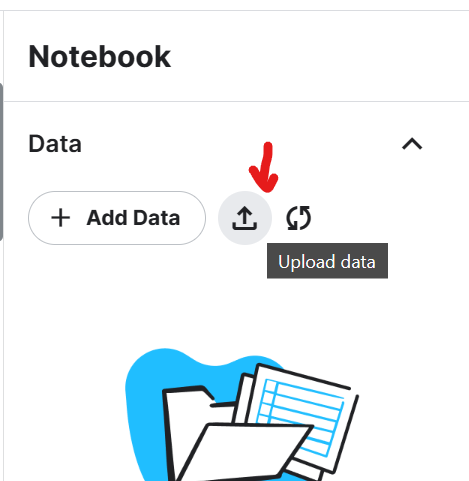
Voeg een titel voor de dataset toe en upload het zip-bestand met vijf selfie-foto’s die op verschillende locaties zijn genomen. In dit geval gaat het om de foto’s van de auteur.
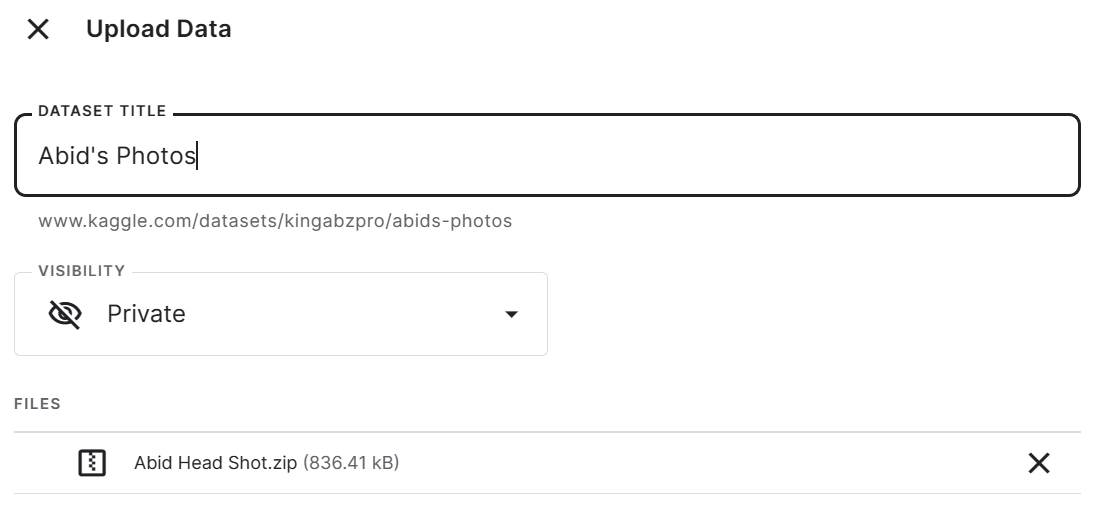
Om alle vijf afbeeldingen in de Jupyter Notebook te bekijken, laden we ze met PIL en geven we ze door aan onze image_grid-functie.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid

import glob
We tonen vijf afbeeldingen van hoge kwaliteit van de auteur op verschillende locaties. Zorg ervoor dat alle foto’s van hoge kwaliteit en vergelijkbare grootte zijn.
imgs = [Image.open(path) for path in glob.glob("/kaggle/input/abids-photos/*.jpg")]
image_grid(imgs, 1, 5)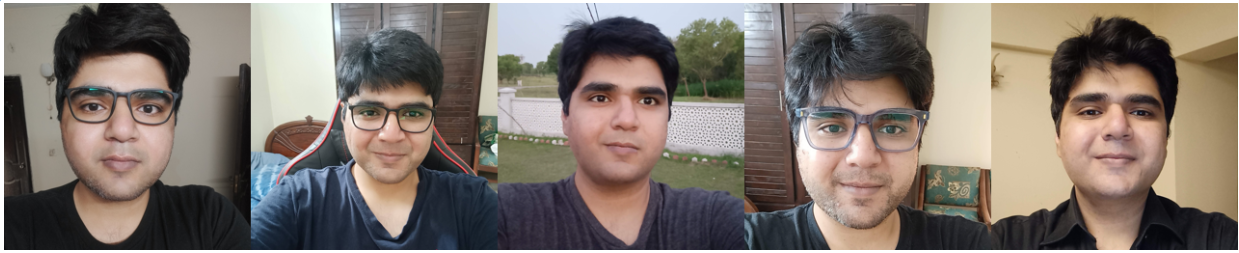
Tijd om ons model op deze vijf afbeeldingen te finetunen met het AutoTrain DreamBooth-script.
!autotrain dreambooth \
--model $MODEL_NAME \
--project-name $PROJECT_NAME \
--image-path $DATA_DIR \
--prompt "A photo of Abid Ali Awan wearing casual clothes, taking a selfie, and smiling." \
--resolution 1024 \
--batch-size 1 \
--num-steps 500 \
--gradient-accumulation 4 \
--lr 1e-4 \
--fp16 \
--gradient-checkpointing \
--push-to-hub \
--token $HF_TOKEN \
--repo-id $REPO_ID
Het kostte 2 uur en 15 minuten om het model te trainen en de LoRA-gewichten naar Hugging Face te pushen.
LoRA, kort voor Low-Rank Adaptation, is een techniek waarbij kleine trainbare lagen aan een bestaand model worden toegevoegd zonder de oorspronkelijke gewichten te wijzigen.
LoRA is handig omdat je er nieuwe concepten, zoals kunststijlen, personages of thema’s, mee kunt introduceren zonder veel rekenkracht of geheugen te vergen.
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 14.49s/it, loss=0.119, lr=0.0001]Model weights saved in Dreambooth_SDXL/pytorch_lora_weights.safetensors
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 16.22s/it, loss=0.119, lr=0.0001]
pytorch_lora_weights.safetensors: 100%|████| 23.4M/23.4M [00:01<00:00, 11.9MB/s]
In plaats van een modelbestand van 7 GB op te slaan, slaan we een LoRA-adapter van 23,4 MB op die tijdens inferentie aan het basismodel wordt gekoppeld.
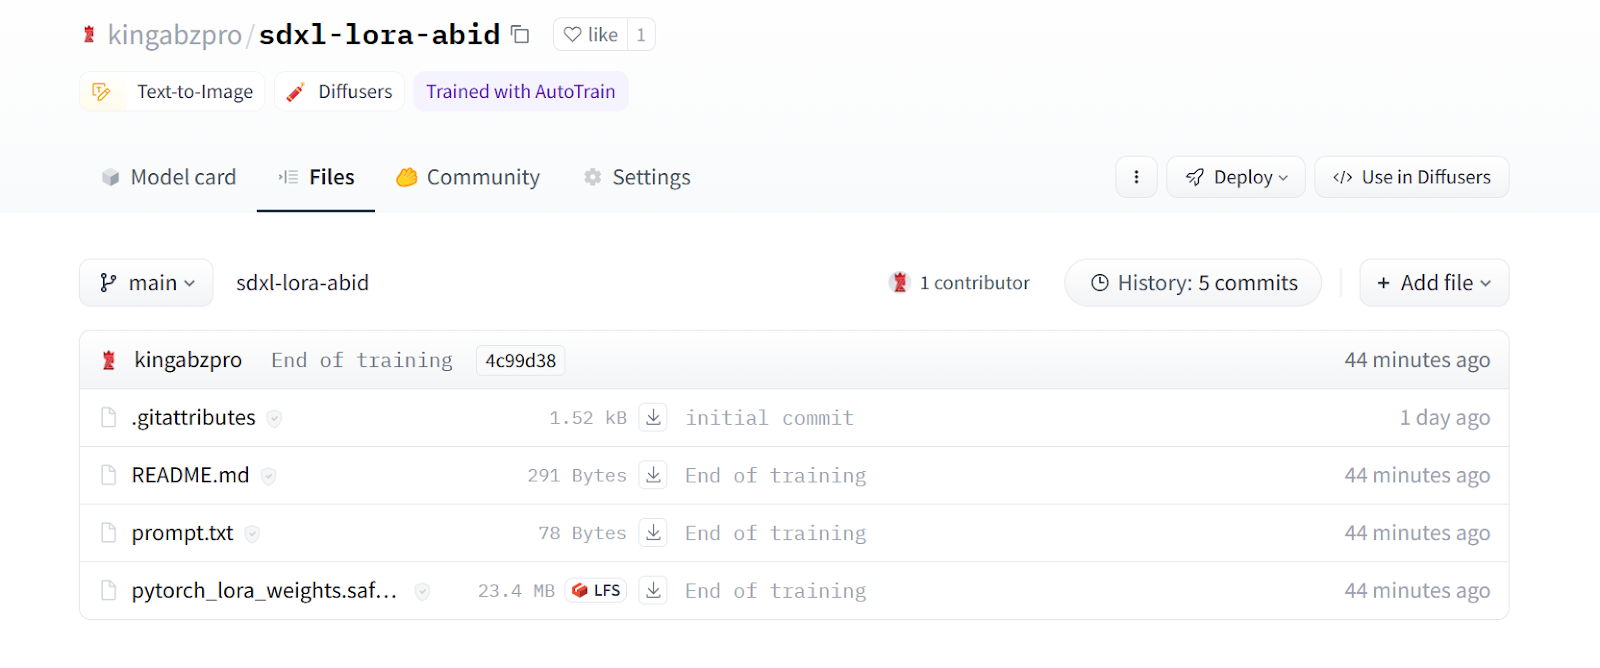
Afbeelding van kingabzpro/sdxl-lora-abid
We maken een diffusion-pijplijn om het beeld te genereren, met een aangepaste VAE-decoder en het SDXL-basismodel in FP16-precisie.
Vervolgens laden we de LoRA-gewichten en voegen die toe aan het basismodel via onze Hugging Face-repo-ID.
Tot slot draaien we de pijplijn met de prompt en genereren we drie afbeeldingen.
from diffusers import DiffusionPipeline, AutoencoderKL, StableDiffusionXLImg2ImgPipeline

import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");
pipe.load_lora_weights(REPO_ID, weight_name="pytorch_lora_weights.safetensors")


prompt = "A photo of Abid Ali Awan participating in a marathon."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
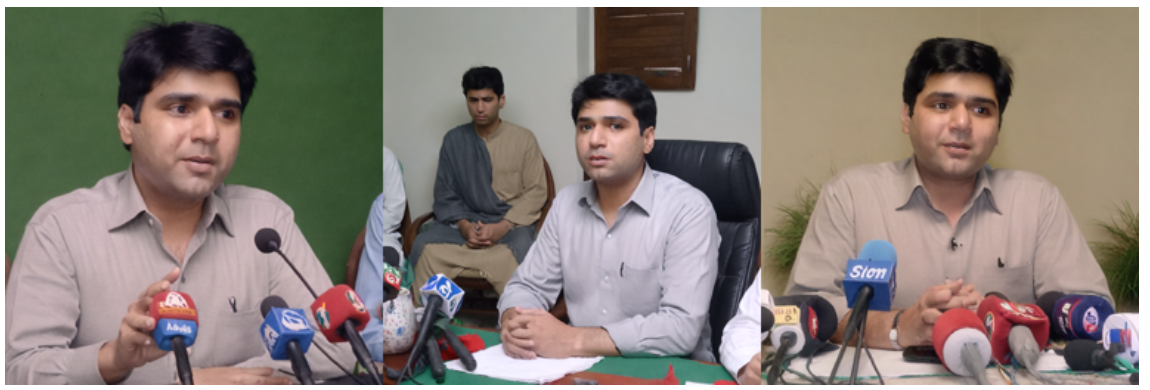
image_grid(image.images, 1, 3)
De resultaten zijn indrukwekkend. We hebben ons model succesvol gefinetuned om afbeeldingen van de auteur “Abid Ali Awan” te genereren.
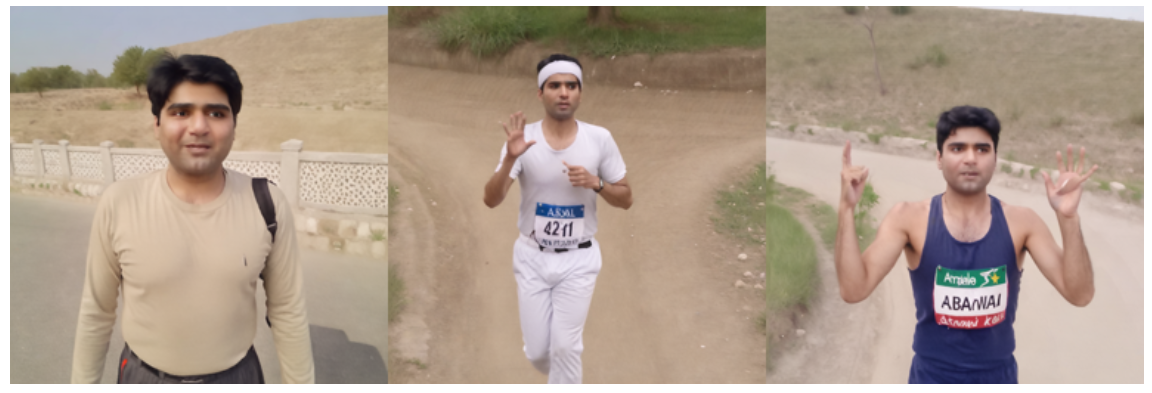
Laten we het nog eens proberen met een andere prompt.
prompt = "A photo of Abid Ali Awan giving a press conference."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
De resultaten zijn opnieuw uitstekend.
In deze sectie verbeteren we het gegenereerde beeld met de SDXL Refiner 1.0.
Eerst genereren we het beeld met de Stable Diffusion-pijplijn en geven we een handmatige seed op voor reproduceerbaarheid.
prompt = "A photo of Abid Ali Awan wearing a business suit at an office meeting."

seed = 65
generator = torch.Generator("cuda").manual_seed(seed)
image = pipe(prompt=prompt, num_inference_steps=25, generator=generator).images[0]
image.resize((300, 300))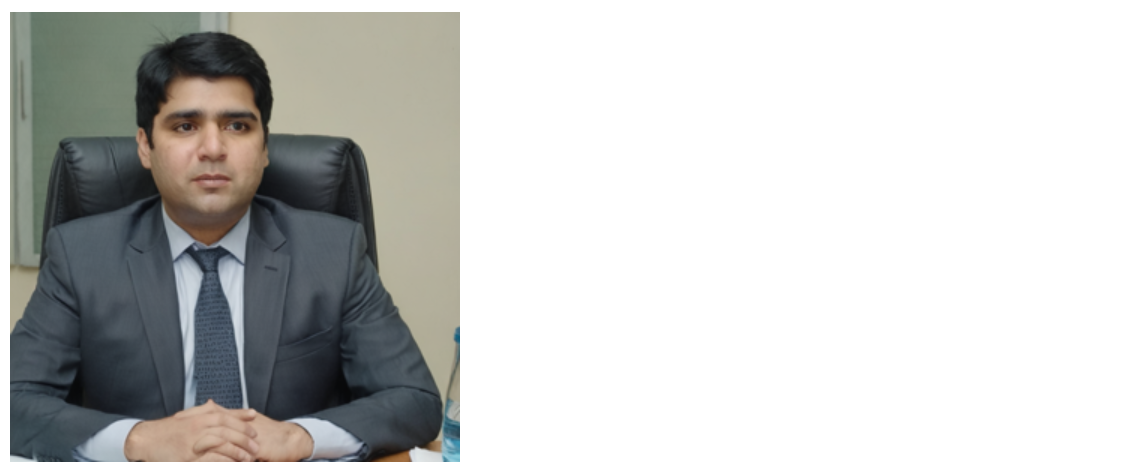
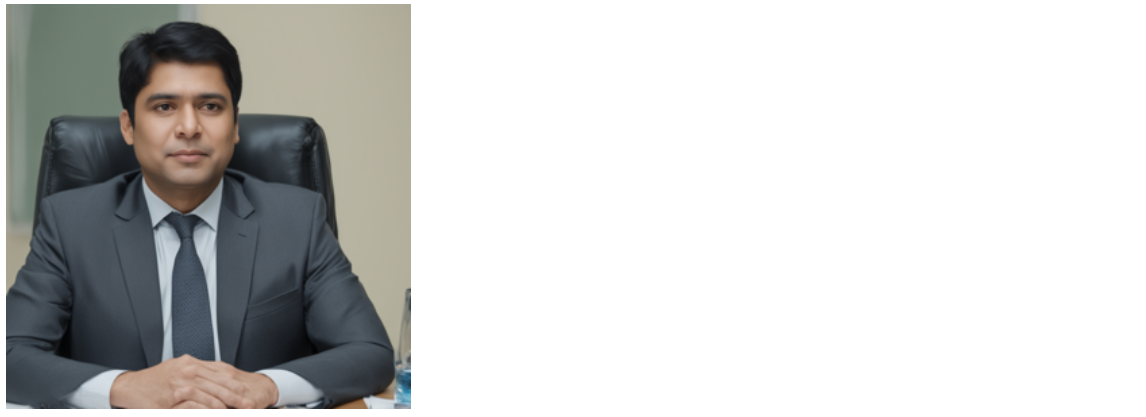
Vervolgens laden we de SDXL refiner en draaien we de refiner-pijplijn met dezelfde prompt, generator en het gegenereerde beeld.
refiner = StableDiffusionXLImg2ImgPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda");

image = refiner(prompt=prompt, num_inference_steps=25, generator=generator, image=image)
image.images[0].resize((300, 300))
De image refiner heeft de beeldkwaliteit verbeterd, maar het resulterende beeld lijkt totaal niet op de oorspronkelijke foto van de auteur. In plaats daarvan toont het een generieke zakenman uit Zuid-Azië. Mogelijk is het bij gefinetunede modellen beter om de refiner te vermijden.
Na het finetunen van het SDXL-model is de volgende stap een Generative AI-applicatie bouwen. Ter inspiratie voor je project: bekijk de blog 5 Projects Built with Generative Models and Open Source Tools.
In deze tutorial hebben we het Stable Diffusion XL-model en de DreamBooth-techniek besproken. Daarnaast hebben we geleerd hoe je Stable Diffusion XL kunt finetunen met de DreamBooth-script van AutoTrain Advance voor gepersonaliseerde beeldgeneratie.
Na het laden van het SDXL-basismodel hebben we een lichte LoRA-adapter getraind met slechts vijf foto’s van de auteur. Vervolgens zijn de LoRA-gewichten aan SDXL gekoppeld, waardoor het model afbeeldingen van hoge kwaliteit van de auteur in verschillende bedachte scenario’s kan genereren, terwijl de capaciteiten van het volledige model met meerdere miljarden parameters behouden blijven.
Hoewel de SDXL Refiner de beeldkwaliteit verbeterde, werkte hij het best voor generieke prompts en leek hij een deel van de personalisatie door finetuning te overschrijven. Desondanks liet de tutorial zien hoe eenvoudig het is om een SDXL-model te finetunen met AutoTrain Advance met slechts enkele afbeeldingen.
Als je nieuw bent in de AI-wereld en wilt begrijpen waar alle hype vandaan komt, raden we de cursus AI Fundamentals aan. Hiermee leer je over Generatieve AI en complexe taalmodellen. Je kunt je carrière in AI-engineering ook een vliegende start geven met het carrièrepad Machine Learning Scientist with Python. Dit complete programma helpt je bij het leren van natural language processing en beeldverwerking, evenals populaire Python-ML-pakketten zoals scikit-learn, PySpark en Keras.
Begin vandaag nog met je AI-reis!
Leerpad
Leerpad
blog
Adel Nehme
15 min

