programa
Fundamentos de la IA
10 h
En este tutorial, aprenderemos sobre Stable Diffusion XL y DreamBooth, y cómo acceder al modelo de generación de imágenes usando la librería diffusers. Además, veremos cómo ajustar el modelo con fotos personales y evaluar su rendimiento. Si estás empezando en IA, te recomendamos hacer el curso de AI Fundamentals para ponerte en contexto.
El equipo de Stability AI ha lanzado Stable Diffusion XL (SDXL) 1.0, la siguiente evolución en modelos de IA de texto a imagen. Este modelo de código abierto parte del SDXL 0.9 (previamente solo para investigación) y se ha convertido en el modelo de creación de imágenes más capaz disponible públicamente.
Tanto el análisis cuantitativo como las evaluaciones humanas cualitativas, realizadas durante semanas de experimentos, demuestran la capacidad de SDXL para generar las imágenes de mayor calidad y preferencia frente a otros modelos open source.
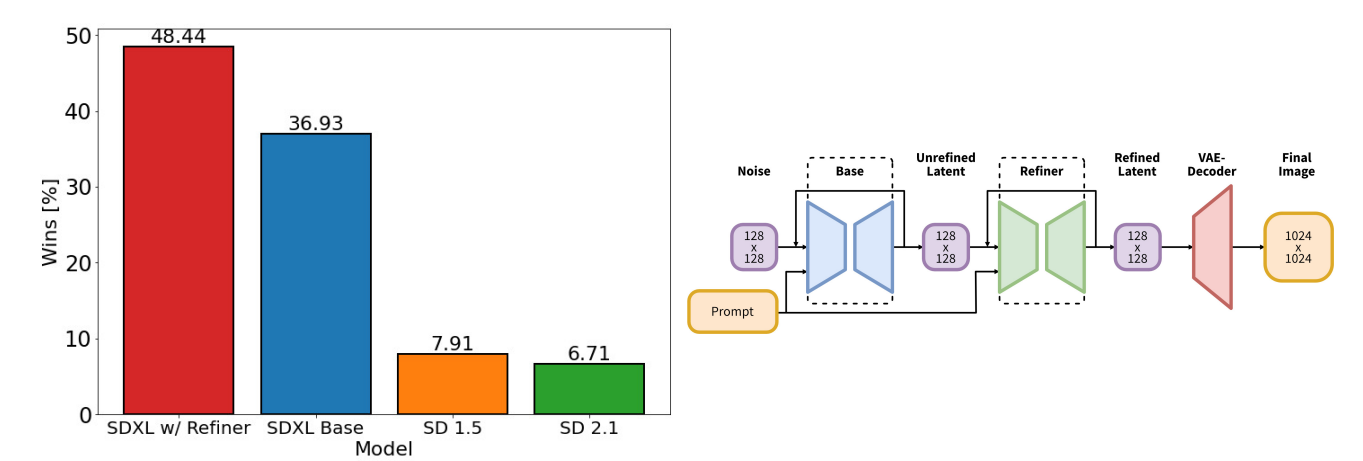
Imagen de arxiv.org
Esta alta calidad se logra con un conjunto de dos modelos: un generador base de 3.500 millones de parámetros y un refinador de 6.600 millones. Esta doble canalización maximiza la calidad manteniendo la eficiencia suficiente para ejecutarse en GPUs de consumo.
Con SDXL 1.0, ya no necesitas prompts largos y complejos para obtener resultados espectaculares. Su "inteligencia" permite crear imágenes detalladas a partir de muy pocas palabras.
Ajustar SDXL en conjuntos de datos y tareas personalizadas es ahora más sencillo. Nos da control granular sobre estructura, estilo y composición.
DreamBooth, presentado en 2022 por el equipo de investigación de Google, supuso un gran avance en IA generativa, especialmente en modelos de texto a imagen como Stable Diffusion.
Se llama DreamBooth porque, en palabras de los investigadores de Google:
"Es como un fotomatón, pero captura al sujeto de modo que puede sintetizarse allí donde te lleven tus sueños."
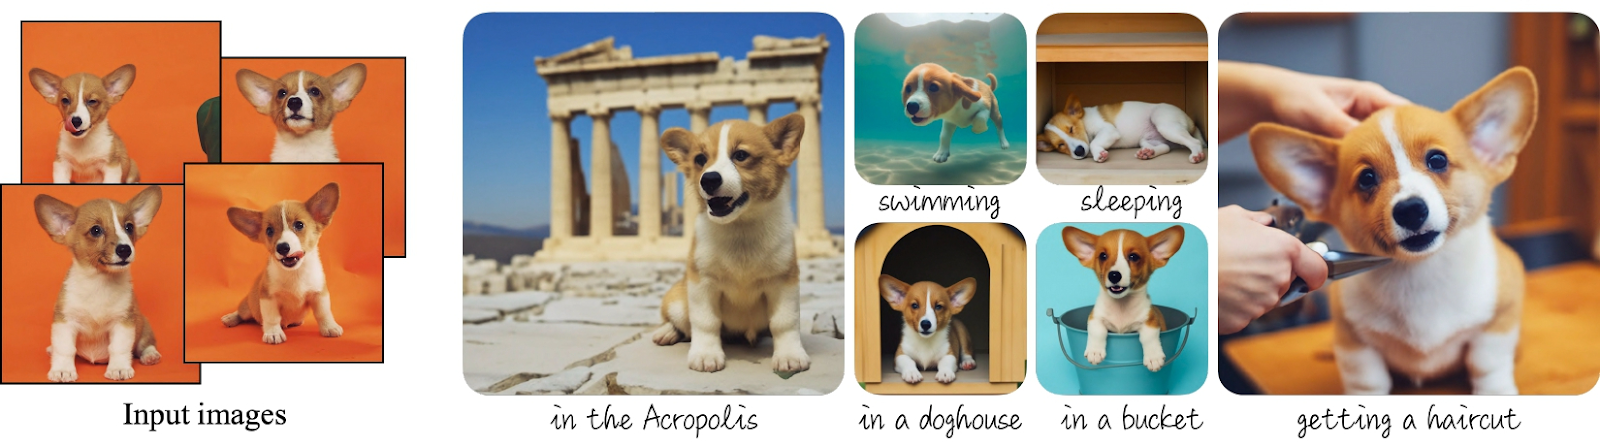
Imagen de DreamBooth
DreamBooth te permite inyectar un sujeto específico y personalizado para que el modelo ajustado se especialice en representarlo de distintas formas. En cierto modo, te abre la puerta a crear tu propio generador de imágenes centrado en una persona, personaje, objeto o escena concreta.
DreamBooth solo necesita unas pocas imágenes del sujeto (normalmente 3-5) para entrenar el modelo de forma eficaz. Una vez entrenado, el modelo puede colocar al sujeto en infinidad de entornos, escenas y poses, limitado únicamente por tu imaginación.
Ajustar el modelo de generación de imágenes con DreamBooth puede ser útil en muchos ámbitos. Da más libertad para experimentar y generar imágenes de alta calidad sin necesidad de dominar Photoshop. Aquí tienes algunos ejemplos de cómo puede aportar valor fácilmente en el trabajo.
En las siguientes secciones, profundizaremos en el proceso de acceso y ajuste del modelo SDXL con un conjunto de datos propio usando GPUs gratuitas de Kaggle.
Podemos probar la demo de Stable Diffusion XL Spaces en Hugging Face, que genera rápidamente cuatro imágenes a partir de tu entrada. Trastea con ella antes de decidir si encaja con tu caso.
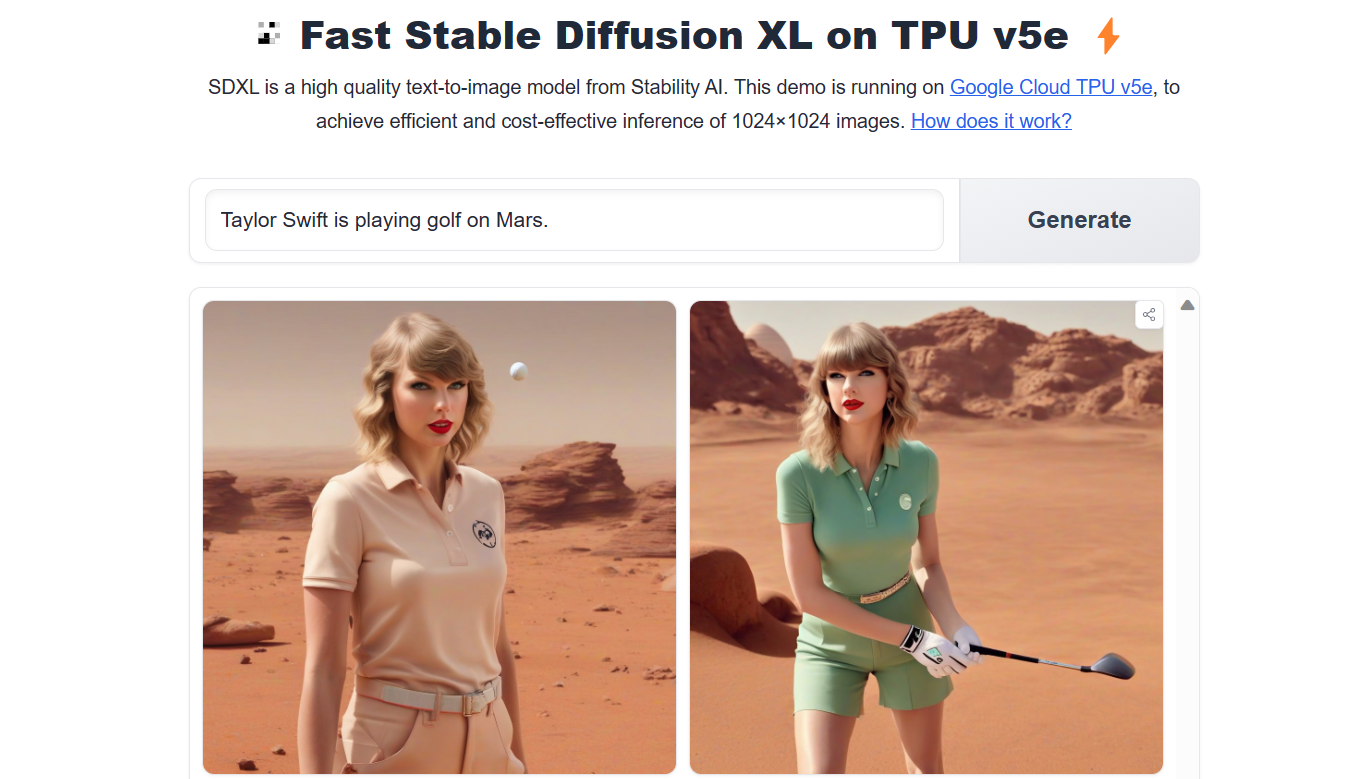
Imagen de Stable Diffusion XL en TPUv5e
La otra vía es usar la librería de Python diffusers para generar la imagen con un prompt personalizado.
Antes de ejecutar el código, asegúrate de que estás usando una máquina con GPU y soporte CUDA.
!nvidia-smi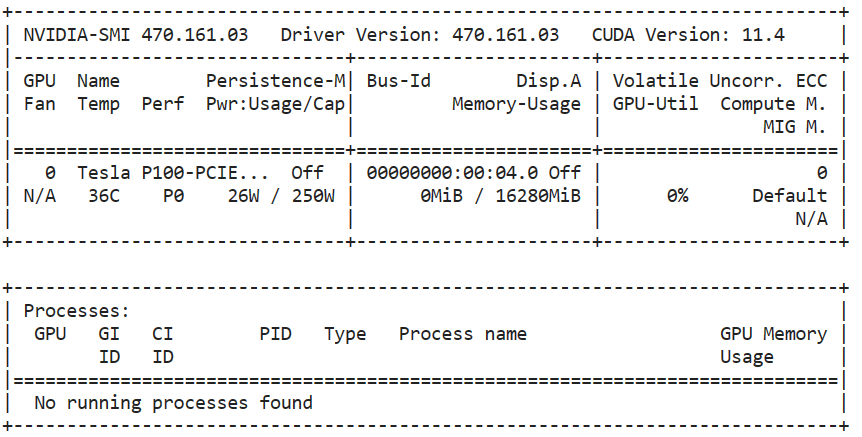
Después, instala el paquete diffusers con PIP.
%pip install --upgrade diffusers[torch] -qCargaremos el decodificador VAE personalizado, modificado para ejecutarse en precisión fp16 sin generar NaNs.
Después, construiremos una pipeline cargando el modelo base SDXL con precisión fp16 e integrando el VAE en el flujo de diffusers.
Podríamos cargar el modelo base directamente sin "fp16", pero causaría problemas de memoria en la GPU. Para ejecutarlo en GPUs de Kaggle, Colab o portátiles, debes usar la variante fp16.
from diffusers import DiffusionPipeline, AutoencoderKL
import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");Para generar la imagen, debes indicar un prompt sencillo, el número de pasos de inferencia y cuántas imágenes quieres por prompt.
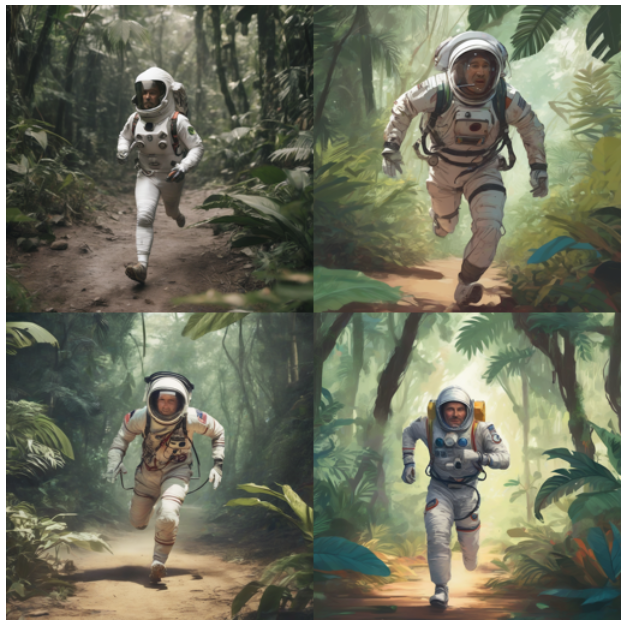
En nuestro caso, generaremos cuatro imágenes a partir de un único prompt.
prompt = "A man in a spacesuit is running a marathon in the jungle."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 4)
Para mostrarlas en cuadrícula, podemos escribir una función en Python que las redimensione y las disponga en una rejilla.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid
Mostraremos cuatro imágenes en una cuadrícula 2x2 para comparar fácilmente la salida del modelo.
image_grid(image.images, 2, 2)Los resultados son fantásticos. Sin duda, SDXL mejora mucho a Stable Diffusion 1.6.
Escribamos otro prompt y generemos tres imágenes de un mono jugando con fuegos artificiales.
prompt = "A playful monkey handling fireworks with ease."
image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)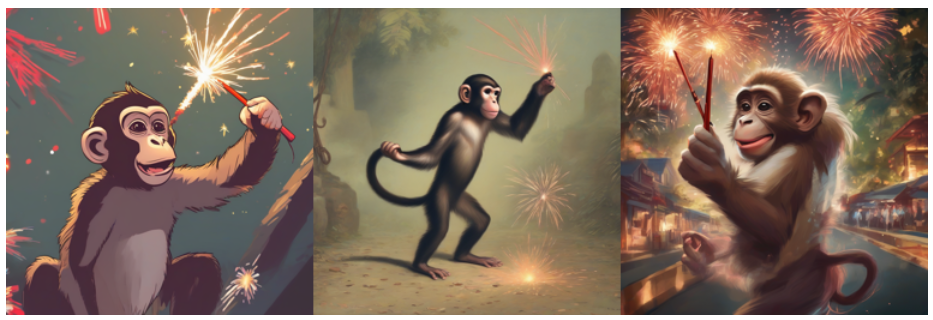
Aprende a acceder al modelo Stable Diffusion online y en local siguiendo el tutorial How to Run Stable Diffusion.
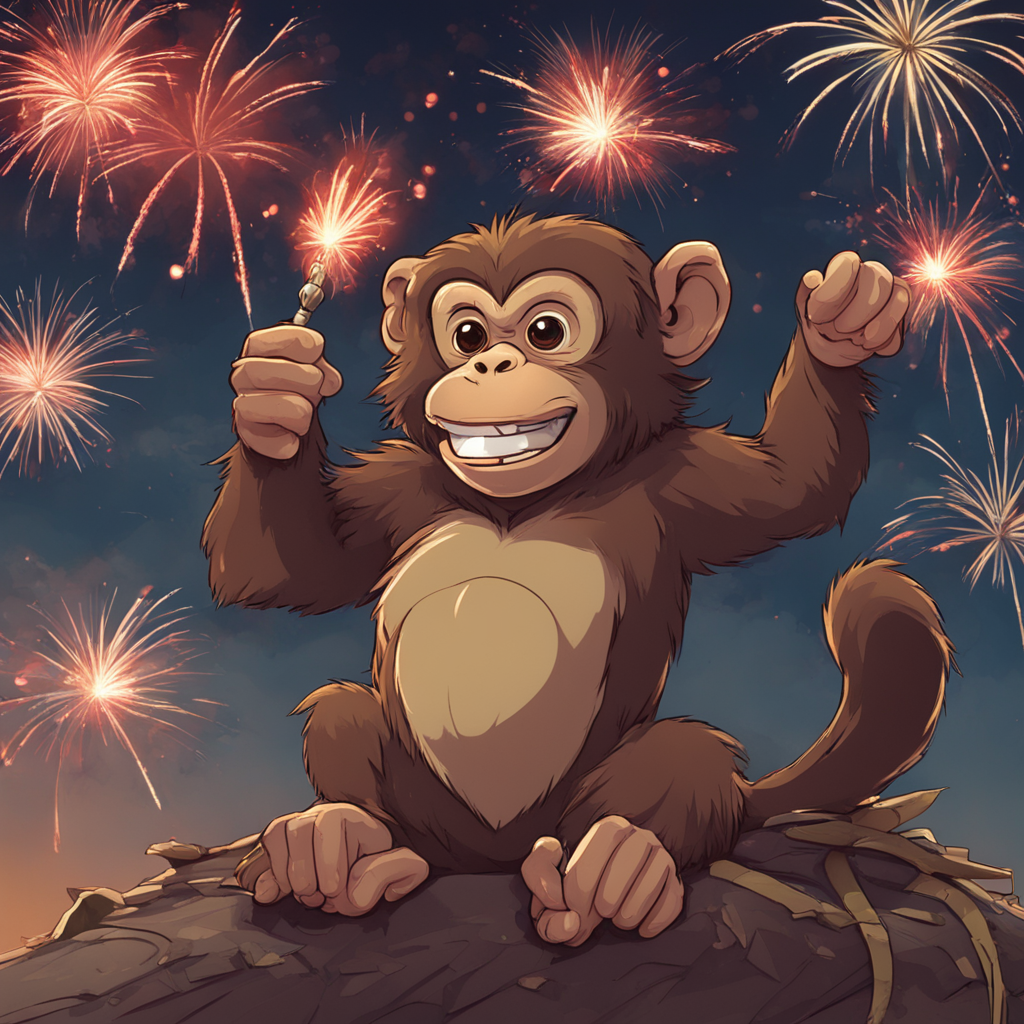
Para mejorar aún más la calidad y la fidelidad, usaremos Refiner.
refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda")

n_steps = 40
high_noise_frac = 0.7

image = pipe(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_end=high_noise_frac,
    output_type="latent",
).images

image = refiner(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_start=high_noise_frac,
    image=image,
).images[0]

image
La imagen refinada tiene gran calidad y sigue el prompt con precisión.
Aprende a generar imágenes fotorrealistas con Python y modelos de difusión de última generación con el code-along Generating Photorealistic Images using AI with Diffusers in Python.
Con el tiempo, ajustar SDXL se ha vuelto mucho más sencillo. Gracias a AutoTrain Advance, ahora podemos ajustar el modelo con un único script de Python. Esta librería de AutoML está pensada para entrenar y desplegar modelos punteros con muy poco código.
Puedes instalar el paquete de Python con PIP:
%pip install -U autotrain-advancedSi te interesa ajustar el modelo SDXL con accelerate y transformers, echa un vistazo al cuaderno de Colab SDXL DreamBoot LoRA. El cuaderno está algo desactualizado y quizá necesites hacer cambios para ejecutarlo correctamente.
Antes de ejecutar el script de DreamBooth, definiremos algunas variables que usaremos en la ejecución.
PROJECT_NAME = "Dreambooth_SDXL"
MODEL_NAME = "stabilityai/stable-diffusion-xl-base-1.0"
DATA_DIR = "/kaggle/input/abids-photos"
REPO_ID = "kingabzpro/sdxl-lora-abid"
A continuación, configura un token de Hugging Face usando la función Secret de Kaggle. Aprende a configurar secretos leyendo Mistral 7B Tutorial: Step-by-Step Guide for Using Mistral 7B.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
HF_TOKEN = user_secrets.get_secret("HUGGINGFACE_TOKEN")Para crear el dataset privado de tus selfies en Kaggle, haz clic en el botón de subida en el panel derecho del cuaderno.
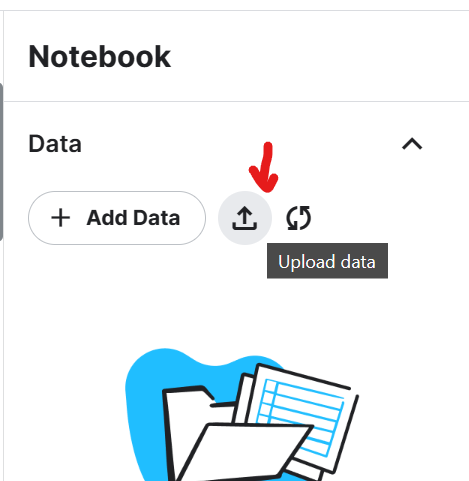
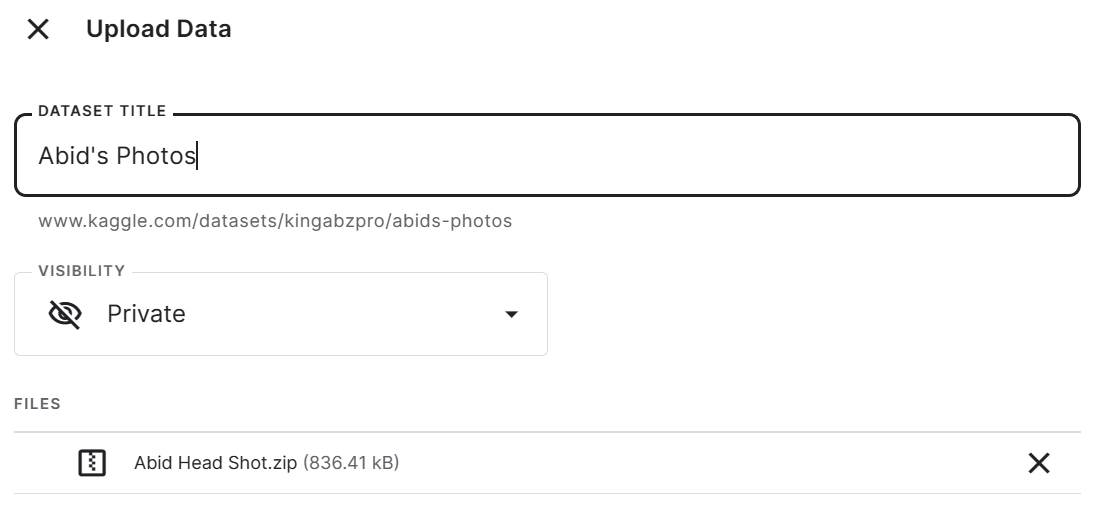
Añade el título del dataset y sube el archivo zip con cinco fotos de selfies tomadas en diferentes lugares. En este caso, son fotos del autor.
Para ver las cinco imágenes en Jupyter Notebook, cargaremos las imágenes con PIL y se las pasaremos a nuestra función image_grid.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid

import glob
Mostramos cinco imágenes de alta calidad del autor en distintas ubicaciones. Asegúrate de que todas las fotos tengan buena calidad y un tamaño similar.
imgs = [Image.open(path) for path in glob.glob("/kaggle/input/abids-photos/*.jpg")]
image_grid(imgs, 1, 5)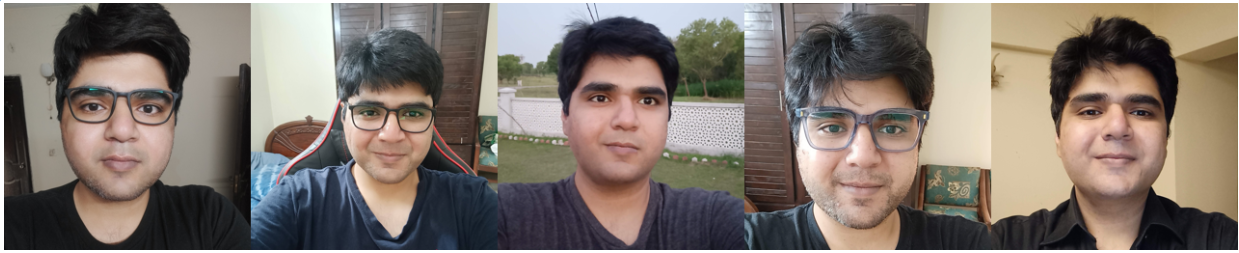
Es el momento de ajustar nuestro modelo con estas cinco imágenes usando el script de DreamBooth de AutoTrain.
!autotrain dreambooth \
--model $MODEL_NAME \
--project-name $PROJECT_NAME \
--image-path $DATA_DIR \
--prompt "A photo of Abid Ali Awan wearing casual clothes, taking a selfie, and smiling." \
--resolution 1024 \
--batch-size 1 \
--num-steps 500 \
--gradient-accumulation 4 \
--lr 1e-4 \
--fp16 \
--gradient-checkpointing \
--push-to-hub \
--token $HF_TOKEN \
--repo-id $REPO_ID
El entrenamiento del modelo y la subida de los pesos LoRA a Hugging Face tardó 2 horas y 15 minutos.
LoRA, de Low-Rank Adaptation, es una técnica que añade pequeñas capas entrenables a un modelo existente sin modificar sus pesos originales.
LoRA es útil porque permite introducir nuevos conceptos (estilos artísticos, personajes o temáticas) sin requerir gran cómputo ni memoria.
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 14.49s/it, loss=0.119, lr=0.0001]Model weights saved in Dreambooth_SDXL/pytorch_lora_weights.safetensors
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 16.22s/it, loss=0.119, lr=0.0001]
pytorch_lora_weights.safetensors: 100%|████| 23.4M/23.4M [00:01<00:00, 11.9MB/s]
En lugar de guardar un archivo de modelo de 7GB, guardaremos un adaptador LoRA de 23,4MB que se adjuntará al modelo base durante la inferencia.
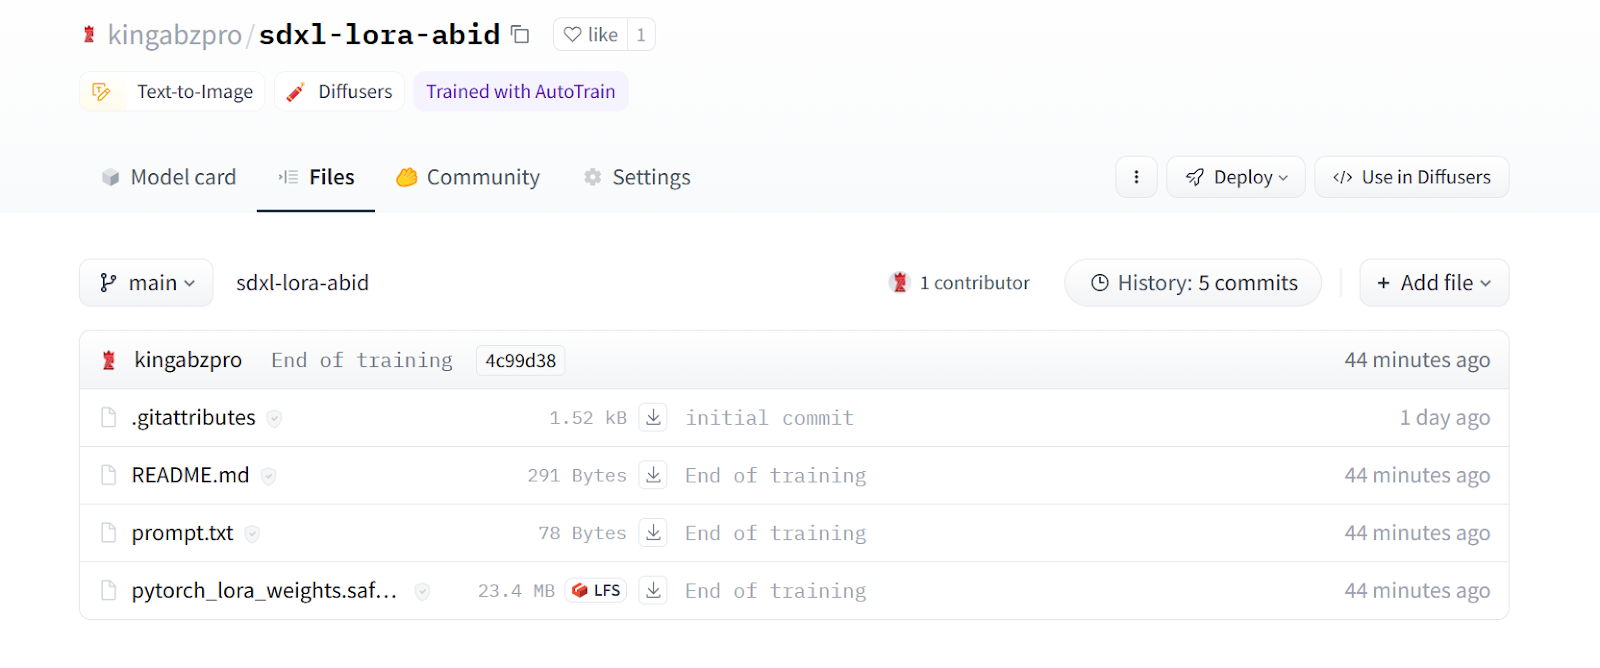
Imagen de kingabzpro/sdxl-lora-abid
Crearemos una pipeline de difusión para generar la imagen usando un VAE personalizado y el modelo base SDXL con precisión FP16.
Luego cargaremos los pesos LoRA y los añadiremos al modelo base usando nuestro repo de Hugging Face.
Por último, ejecutaremos la pipeline con el prompt y generaremos tres imágenes.
from diffusers import DiffusionPipeline, AutoencoderKL, StableDiffusionXLImg2ImgPipeline

import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");
pipe.load_lora_weights(REPO_ID, weight_name="pytorch_lora_weights.safetensors")


prompt = "A photo of Abid Ali Awan participating in a marathon."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
Los resultados son muy buenos. Hemos ajustado con éxito nuestro modelo para generar imágenes del autor, "Abid Ali Awan".
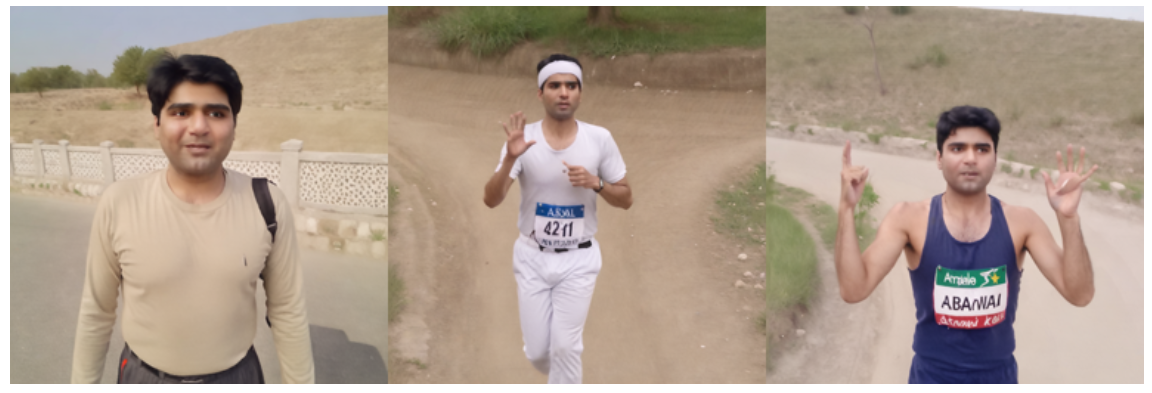
Probemos de nuevo con otro prompt.
prompt = "A photo of Abid Ali Awan giving a press conference."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
De nuevo, los resultados son excelentes.
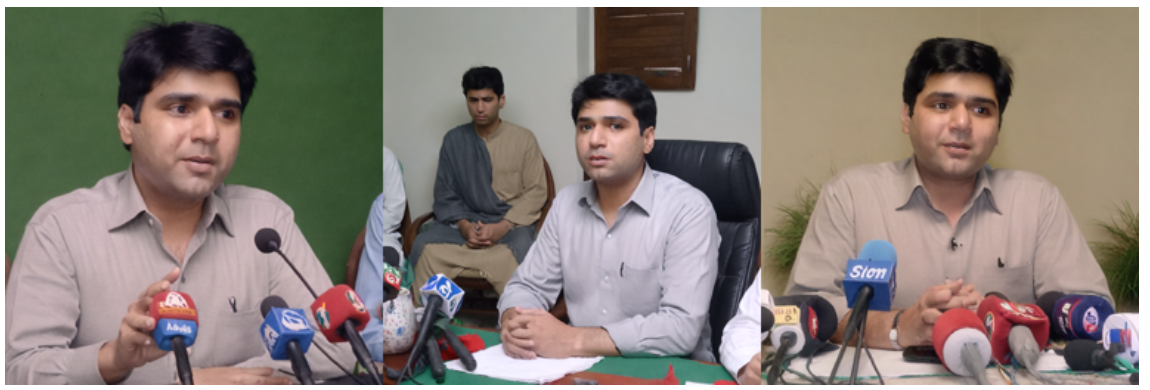
En esta sección, mejoraremos la imagen generada con SDXL Refiner 1.0.
Primero generaremos la imagen con la pipeline de Stable Diffusion y fijaremos una semilla manual para garantizar la reproducibilidad.
prompt = "A photo of Abid Ali Awan wearing a business suit at an office meeting."

seed = 65
generator = torch.Generator("cuda").manual_seed(seed)
image = pipe(prompt=prompt, num_inference_steps=25, generator=generator).images[0]
image.resize((300, 300))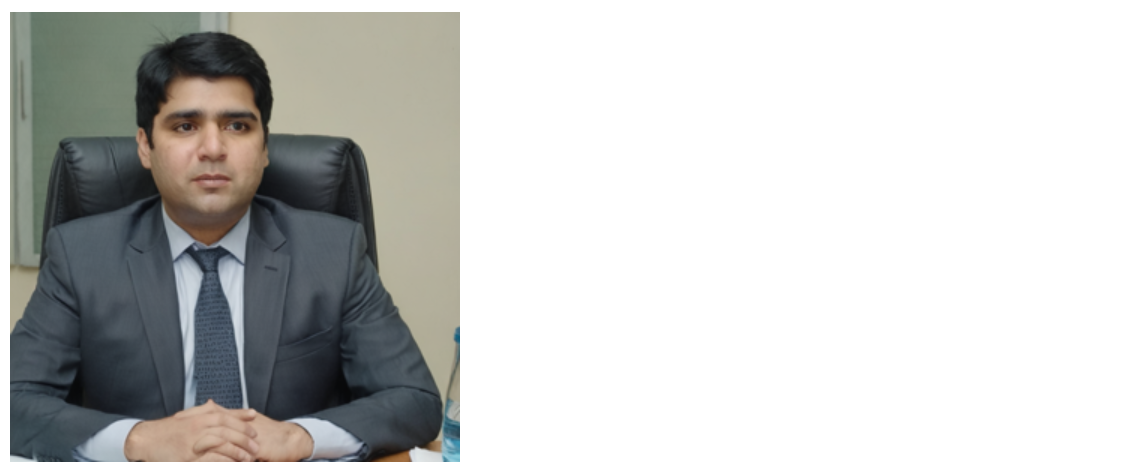
A continuación, cargaremos SDXL refiner y ejecutaremos la pipeline de refinado con el mismo prompt, generador e imagen generada.
refiner = StableDiffusionXLImg2ImgPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda");

image = refiner(prompt=prompt, num_inference_steps=25, generator=generator, image=image)
image.images[0].resize((300, 300))
El refinador ha mejorado la calidad, pero el resultado no se parece a la foto original del autor. En su lugar, muestra a un ejecutivo genérico del sur de Asia. Quizá, para modelos ajustados, sea mejor evitar el refinador.
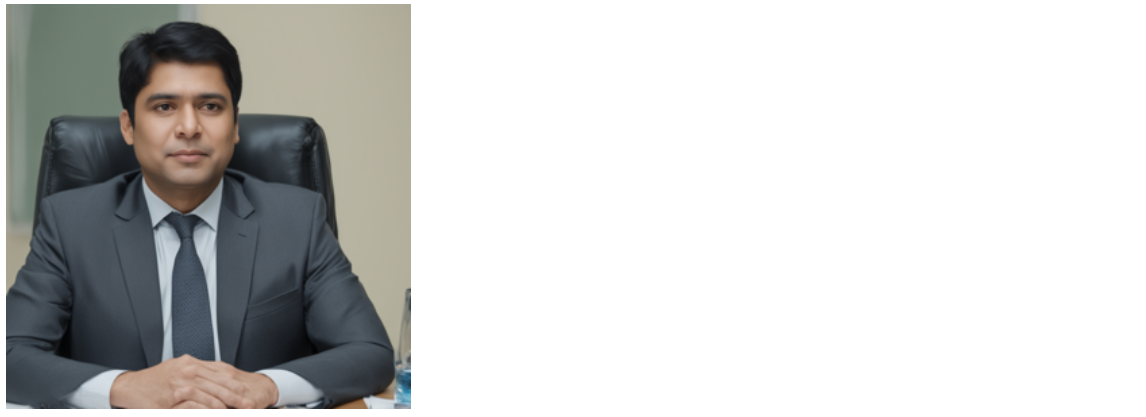
Tras ajustar el modelo SDXL, el siguiente paso es crear una aplicación de IA generativa. Para inspirarte, echa un vistazo al blog 5 Projects Built with Generative Models and Open Source Tools.
En este tutorial hemos visto el modelo Stable Diffusion XL y la técnica DreamBooth. Además, hemos aprendido a ajustar Stable Diffusion XL con el script de DreamBooth de AutoTrain Advance para generar imágenes personalizadas.
Tras cargar el modelo base SDXL, entrenamos un adaptador LoRA ligero con solo cinco fotos del autor. Después, acoplamos los pesos LoRA al SDXL base, lo que permitió generar imágenes de alta calidad del autor en distintos escenarios imaginados, manteniendo las capacidades del modelo completo de varios miles de millones de parámetros.
Aunque SDXL Refiner mejoró la calidad, funcionó mejor con prompts genéricos y pareció sobrescribir parte de la personalización lograda con el ajuste fino. Aun así, el tutorial mostró lo sencillo que es ajustar un modelo SDXL con AutoTrain Advance usando solo unas pocas imágenes.
Si eres nuevo en el mundo de la IA y quieres entender de qué va todo esto, te sugerimos el curso de AI Fundamentals. Te ayudará a aprender sobre IA generativa y modelos de lenguaje complejos. Además, puedes impulsar tu carrera en ingeniería de IA inscribiéndote en el itinerario profesional Machine Learning Scientist with Python. Este programa completo te ayudará a aprender procesamiento del lenguaje natural y de imágenes, así como librerías populares de machine learning en Python como scikit-learn, PySpark y Keras.
¡Empieza hoy tu camino en IA!
programa
programa
Tutorial
Kurtis Pykes
7 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Dimitri Didmanidze
9 min
Tutorial
Aashi Dutt
14 min
Tutorial
Zoumana Keita
12 min