
लर्निंग पाथ
एआई मूलभूत बातें
10 घंटा
इस ट्यूटोरियल में, हम Stable Diffusion XL और DreamBooth के बारे में जानेंगे, और diffuser लाइब्रेरी का उपयोग करके इमेज जेनरेशन मॉडल तक कैसे पहुँचा जाए। साथ ही, हम व्यक्तिगत फ़ोटो पर मॉडल को फाइन-ट्यून करना और उसके प्रदर्शन का मूल्यांकन करना सीखेंगे। यदि आप AI में नए हैं, तो एक शुरुआती जानकारी के लिए हम AI Fundamentals कोर्स लेने की सलाह देते हैं।
Stability AI टीम ने Stable Diffusion XL (SDXL) 1.0 जारी किया है, जो AI टेक्स्ट-टू-इमेज जेनरेशन मॉडलों के अगले चरण का प्रतिनिधित्व करता है। यह ओपन-सोर्स मॉडल शोध-केवल SDXL 0.9 पर आधारित है और दुनिया का सबसे सक्षम सार्वजनिक रूप से उपलब्ध इमेज क्रिएशन मॉडल बन गया है।
कई सप्ताहों के प्रयोगों में मात्रात्मक विश्लेषण और गुणात्मक मानवीय मूल्यांकन, दोनों, यह दर्शाते हैं कि SDXL अन्य ओपन-सोर्स मॉडलों की तुलना में सर्वोच्च गुणवत्ता और सबसे पसंदीदा छवियाँ उत्पन्न करता है।
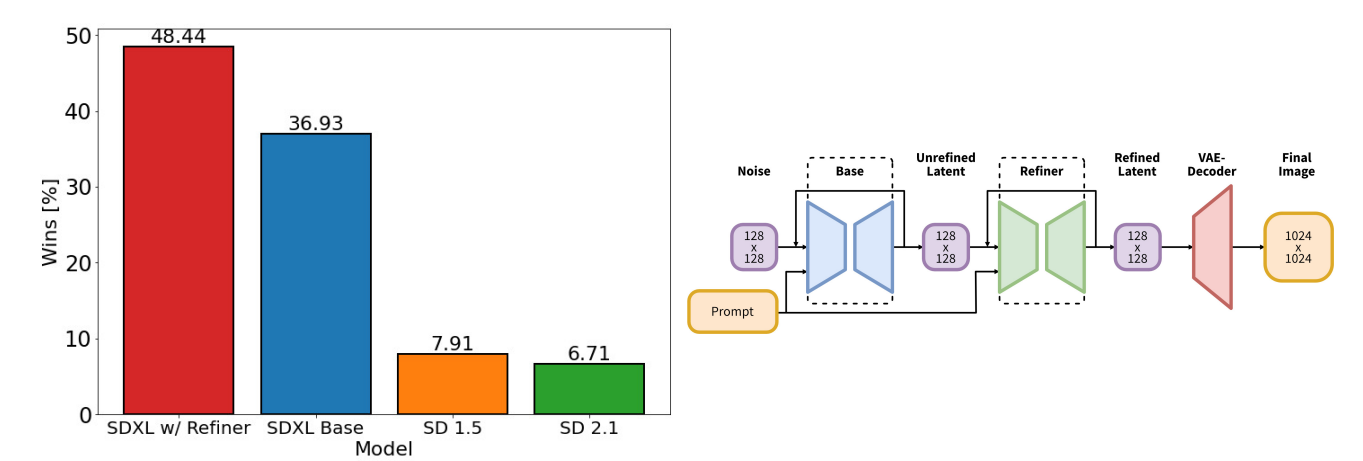
छवि स्रोत: arxiv.org
यह उच्च गुणवत्ता दो मॉडलों के एंसेंबल से हासिल हुई है—3.5 बिलियन पैरामीटर वाला बेस जेनरेटर और 6.6 बिलियन पैरामीटर वाला रिफ़ाइनर। यह डुअल पाइपलाइन, उपभोक्ता GPUs पर कुशलतापूर्वक चल सकने के साथ, इमेज क्वालिटी को अधिकतम करती है।
अब SDXL 1.0 के साथ, शानदार छवियाँ बनाने के लिए लंबे, जटिल प्रॉम्प्ट्स की आवश्यकता नहीं है। इसकी बुद्धिमत्ता कुछ ही शब्दों से जटिल छवियाँ रच सकती है।
कस्टम डेटासेट्स और टास्क्स पर SDXL को फाइन-ट्यून करना और भी आसान हो गया है। यह हमें संरचना, शैली और रचना पर सूक्ष्म नियंत्रण देता है।
DreamBooth, जिसे 2022 में Google रिसर्च टीम ने पेश किया, जनरेटिव AI के क्षेत्र—विशेषकर Stable Diffusion जैसे टेक्स्ट-टू-इमेज मॉडलों—में एक महत्वपूर्ण प्रगति है।
इसे DreamBooth इसलिए कहा जाता है क्योंकि, Google के शोधकर्ताओं के शब्दों में:
"यह फोटो बूथ जैसा है, लेकिन विषय को इस तरह कैप्चर करता है कि उसे वहाँ संश्लेषित किया जा सके जहाँ भी आपके सपने ले जाएँ।"
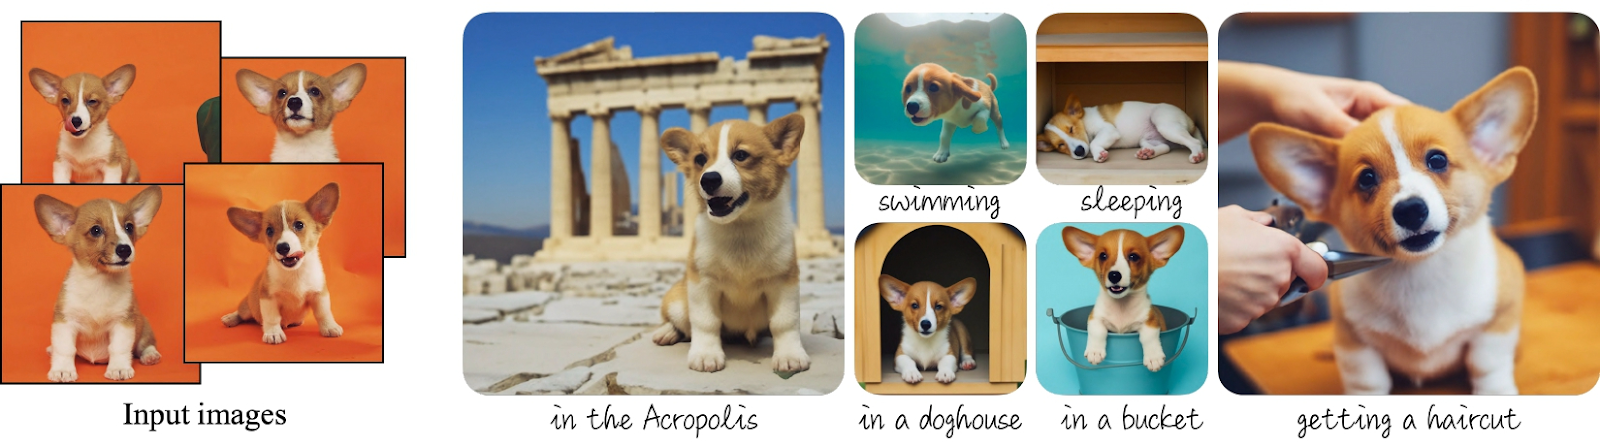
छवि स्रोत: DreamBooth
DreamBooth आपको एक विशिष्ट कस्टम सब्जेक्ट जोड़ने देता है, जिस पर फाइन-ट्यून किया गया मॉडल फिर अलग-अलग तरीकों से बेहतर रेंडरिंग करने में विशेषज्ञ बन जाता है। इस तरह, यह किसी विशिष्ट व्यक्ति, किरदार, वस्तु या दृश्य पर केंद्रित आपका अपना इमेज जेनरेटर बनाने की संभावना खोल देता है।
DreamBooth को मॉडल को प्रभावी ढंग से प्रशिक्षित करने के लिए विषय की केवल कुछ (आमतौर पर 3–5) छवियों की आवश्यकता होती है। एक बार प्रशिक्षित हो जाने पर, मॉडल उपयोगकर्ता की कल्पना तक सीमित रहते हुए विषय को असंख्य सेटिंग्स, दृश्यों और पोज़ में रख सकता है।
DreamBooth के साथ इमेज जेनरेशन मॉडल का फाइन-ट्यूनिंग कई क्षेत्रों के लिए लाभकारी हो सकता है। यह बिना Photoshop कौशल के प्रयोग करने और उच्च-गुणवत्ता की छवियाँ बनाने की अधिक स्वतंत्रता देता है। यहाँ कुछ उदाहरण हैं कि यह कार्यस्थल में कैसे आसानी से मूल्य जोड़ सकता है।
आगे के अनुभागों में, हम मुफ्त Kaggle GPUs का उपयोग करके कस्टम डेटासेट पर SDXL मॉडल तक पहुँचने और उसे फाइन-ट्यून करने की प्रक्रिया को गहराई से समझेंगे।
हम Hugging Face पर Stable Diffusion XL Spaces के डेमो को आज़मा सकते हैं, जो आपके इनपुट के आधार पर जल्दी से चार छवियाँ बनाता है। यह आपके उपयोग के लिए उपयुक्त है या नहीं, यह तय करने से पहले इसे थोड़ा आज़माएँ।
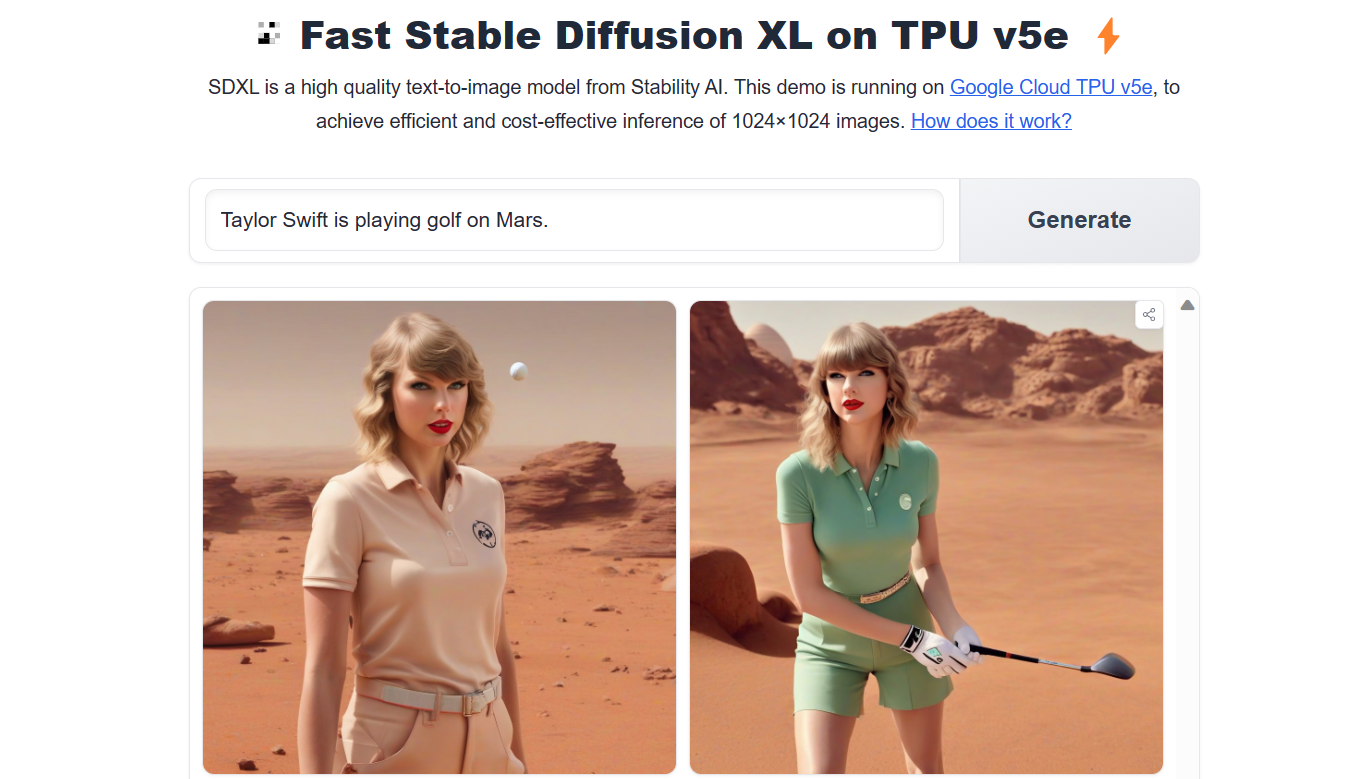
छवि स्रोत: Stable Diffusion XL on TPUv5e
दूसरा तरीका है कि आप Python लाइब्रेरी diffusers का उपयोग करके कस्टम प्रॉम्प्ट से छवि जनरेट करें।
कोड चलाने से पहले, सुनिश्चित करें कि आप CUDA सपोर्ट वाली GPU मशीन चला रहे हैं।
!nvidia-smi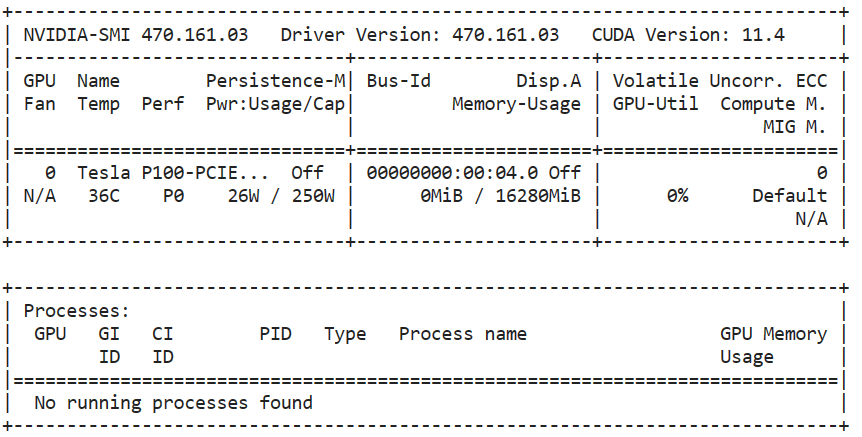
उसके बाद, PIP से diffuser पैकेज इंस्टॉल करें।
%pip install --upgrade diffusers[torch] -qहम कस्टम VAE डिकोडर लोड करेंगे, जिसे fp16 प्रिसीजन में NaNs जनरेट किए बिना चलने के लिए संशोधित किया गया है।
इसके बाद, हम diffuser के वर्कफ़्लो में VAE डिकोडर को इंटीग्रेट करके fp16 प्रिसीजन के साथ बेस SDXL मॉडल लोड कर एक पाइपलाइन बनाएँगे।
हम बेस मॉडल को सीधे “fp16” के बिना भी लोड कर सकते थे, लेकिन इससे GPU मेमोरी से संबंधित समस्याएँ आतीं। इसलिए Kaggle, Colab और लैपटॉप GPUs पर चलाने के लिए आपको fp16 वेरिएंट में मॉडल एक्सेस करना होगा।
from diffusers import DiffusionPipeline, AutoencoderKL
import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");छवि जनरेट करने के लिए, आपको एक सरल प्रॉम्प्ट, इन्फ़रेंस स्टेप्स की संख्या और प्रति प्रॉम्प्ट छवियों की संख्या देनी होगी।
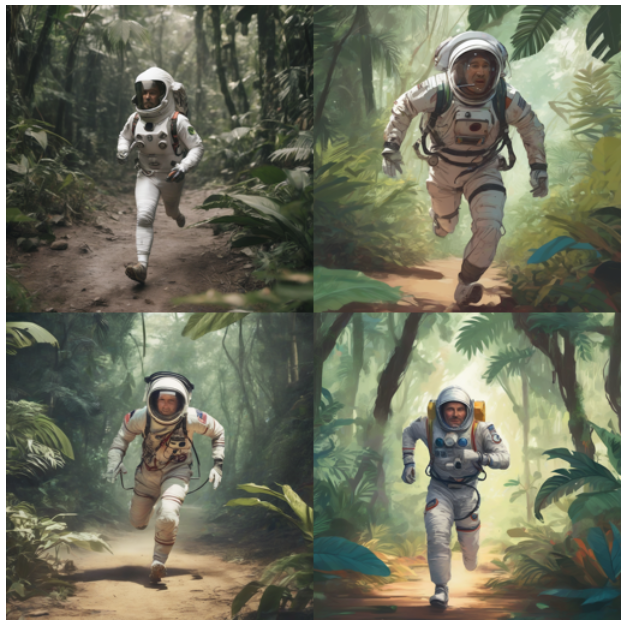
हमारे मामले में, हम एक ही प्रॉम्प्ट से चार छवियाँ जनरेट करेंगे।
prompt = "A man in a spacesuit is running a marathon in the jungle."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 4)
ग्रिड में छवियाँ दिखाने के लिए, हम एक सरल Python फ़ंक्शन लिख सकते हैं जो छवियों का आकार बदलकर उन्हें ग्रिड में प्रदर्शित करे।
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid
हम 2x2 ग्रिड में चार छवियाँ प्रदर्शित करेंगे ताकि मॉडल के आउटपुट की तुलना आसानी से हो सके।
image_grid(image.images, 2, 2)नतीजे शानदार हैं। निश्चित रूप से, SDXL, Stable Diffusion 1.6 से काफी बेहतर है।
आइए एक और प्रॉम्प्ट लिखते हैं और पटाखों से खेलते बंदर की तीन छवियाँ जनरेट करते हैं।
prompt = "A playful monkey handling fireworks with ease."
image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)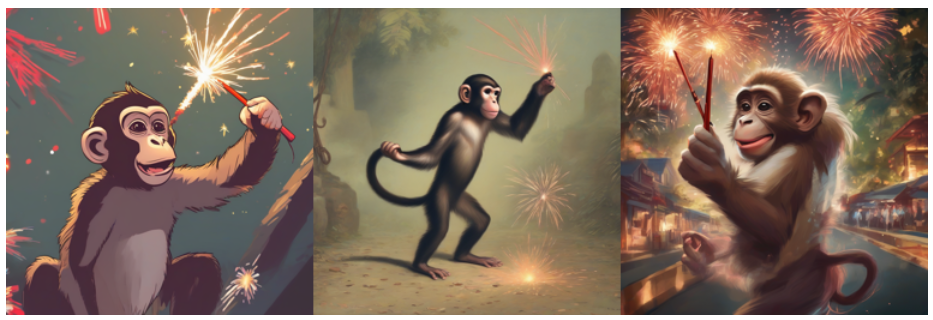
Stable Diffusion मॉडल को ऑनलाइन और लोकली कैसे एक्सेस करें, यह How to Run Stable Diffusion ट्यूटोरियल का अनुसरण करके सीखें।
छवि गुणवत्ता और मॉडल की सटीकता को और बेहतर करने के लिए, हम Refiner का उपयोग करेंगे।
refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda")

n_steps = 40
high_noise_frac = 0.7

image = pipe(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_end=high_noise_frac,
    output_type="latent",
).images

image = refiner(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_start=high_noise_frac,
    image=image,
).images[0]

image
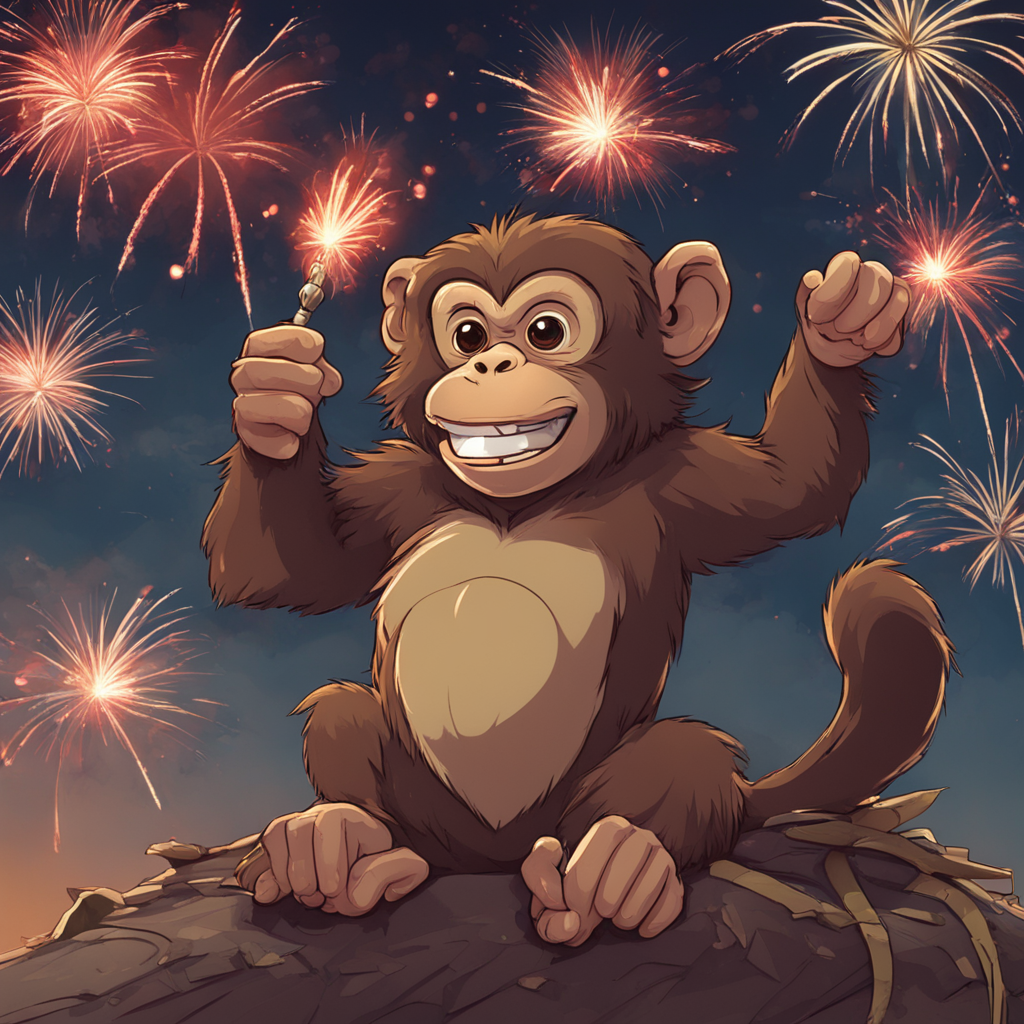
रिफ़ाइंड छवि उच्च गुणवत्ता वाली है और प्रॉम्प्ट का सटीक पालन करती है।
Python में अत्याधुनिक डिफ्यूज़न मॉडलों के साथ फ़ोटो-यथार्थवादी छवियाँ कैसे जनरेट करें, यह Generating Photorealistic Images using AI with Diffusers in Python कोड-अलॉन्ग देखकर सीखें।
समय के साथ SDXL का फाइन-ट्यूनिंग काफी आसान हो गया है। AutoTrain Advance के धन्यवाद, अब हम केवल एक Python स्क्रिप्ट से अपना मॉडल फाइन-ट्यून कर सकते हैं। यह ऑटोमैटिक मशीन लर्निंग लाइब्रेरी कम से कम कोड के साथ अत्याधुनिक मशीन लर्निंग मॉडलों को ट्रेन और डिप्लॉय करने के लिए डिज़ाइन की गई है।
आप PIP के माध्यम से Python पैकेज इंस्टॉल कर सकते हैं:
%pip install -U autotrain-advancedयदि आप accelerate और transformers के साथ SDXL मॉडल का फाइन-ट्यूनिंग करने में रुचि रखते हैं, तो SDXL DreamBoot LoRA Colab नोटबुक देखें। यह नोटबुक थोड़ी पुरानी है और इसे सही से चलाने के लिए आपको कुछ बदलाव करने पड़ सकते हैं।
DreamBooth स्क्रिप्ट चलाने से पहले, उन कुछ वेरिएबल्स को सेट कर लें जिनका उपयोग हम स्क्रिप्ट चलाने के लिए करने वाले हैं।
PROJECT_NAME = "Dreambooth_SDXL"
MODEL_NAME = "stabilityai/stable-diffusion-xl-base-1.0"
DATA_DIR = "/kaggle/input/abids-photos"
REPO_ID = "kingabzpro/sdxl-lora-abid"
अगले चरण में, आप Kaggle की Secret सुविधा का उपयोग करके Hugging Face टोकन सेट करेंगे। सीक्रेट्स सेट करना कैसे है, यह Mistral 7B Tutorial: Step-by-Step Guide for Using Mistral 7B पढ़कर सीखें।
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
HF_TOKEN = user_secrets.get_secret("HUGGINGFACE_TOKEN")
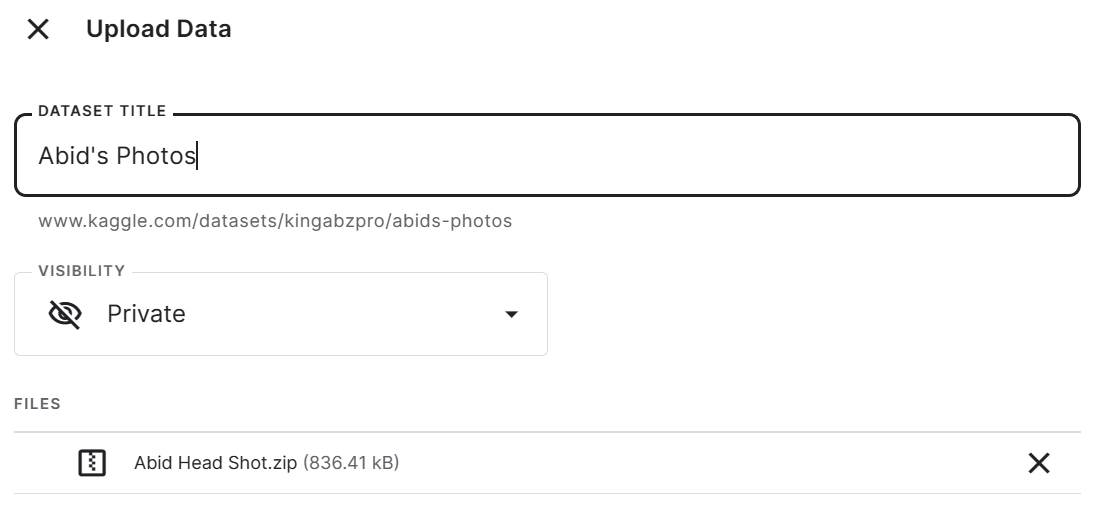
Kaggle में अपनी सेल्फ़ीज़ का प्राइवेट डेटासेट बनाने के लिए, आपको नोटबुक के दाएँ पैनल में अपलोड बटन पर क्लिक करना होगा।
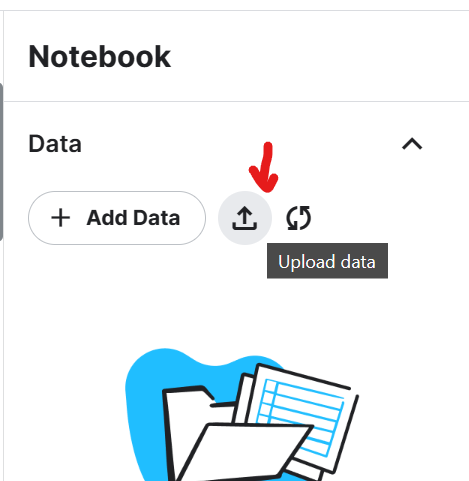
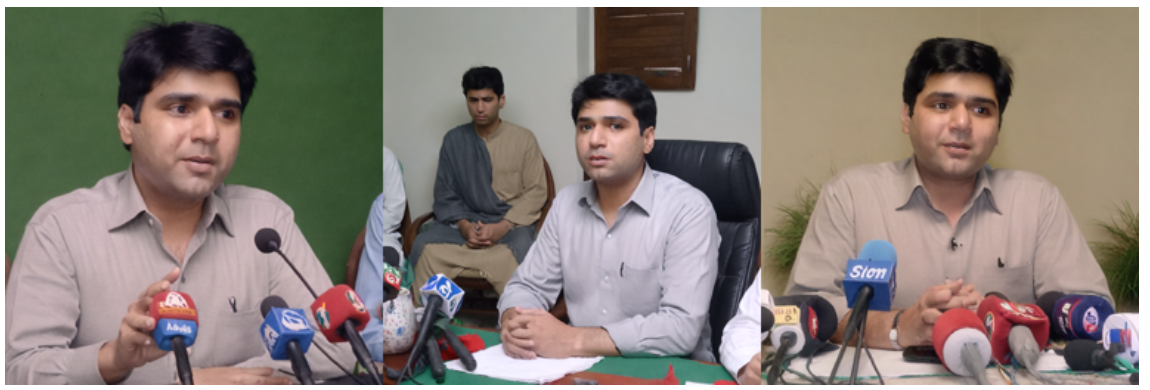
डेटासेट का शीर्षक जोड़ें और अलग-अलग स्थानों पर ली गई पाँच सेल्फ़ीज़ वाली zip फ़ाइल अपलोड करें। इस मामले में, ये लेखक की फ़ोटो हैं।
Jupyter Notebook में सभी पाँच छवियाँ देखने के लिए, हम PIL से छवियाँ लोड करेंगे और उन्हें अपनी image_grid फ़ंक्शन में भेजेंगे।
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid

import glob
हमने विभिन्न स्थानों पर लेखक की पाँच उच्च-गुणवत्ता वाली छवियाँ प्रदर्शित कीं। कृपया सुनिश्चित करें कि सभी फ़ोटो उच्च गुणवत्ता की हों और समान आकार की हों।
imgs = [Image.open(path) for path in glob.glob("/kaggle/input/abids-photos/*.jpg")]
image_grid(imgs, 1, 5)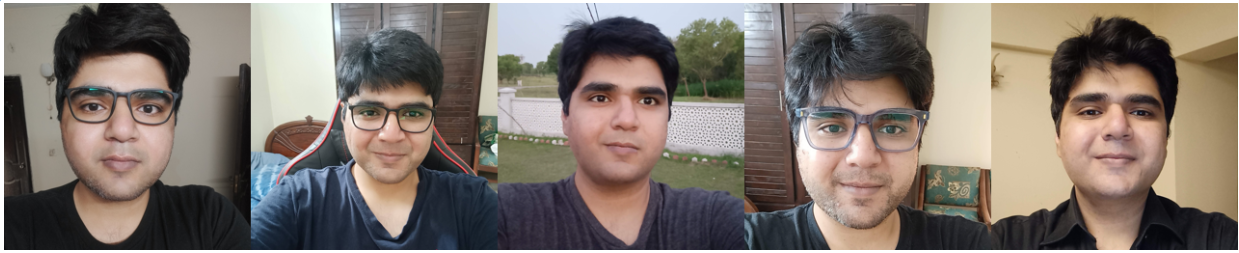
अब समय है AutoTrain DreamBooth स्क्रिप्ट का उपयोग करके इन पाँच छवियों पर हमारे मॉडल को फाइन-ट्यून करने का।
!autotrain dreambooth \
--model $MODEL_NAME \
--project-name $PROJECT_NAME \
--image-path $DATA_DIR \
--prompt "A photo of Abid Ali Awan wearing casual clothes, taking a selfie, and smiling." \
--resolution 1024 \
--batch-size 1 \
--num-steps 500 \
--gradient-accumulation 4 \
--lr 1e-4 \
--fp16 \
--gradient-checkpointing \
--push-to-hub \
--token $HF_TOKEN \
--repo-id $REPO_ID
मॉडल को ट्रेन करने और LoRA वेट्स को Hugging Face पर पुश करने में 2 घंटे 15 मिनट लगे।
LoRA, जिसका अर्थ Low-Rank Adaptation है, एक तकनीक है जिसमें मूल वेट्स को बदले बिना मौजूदा मॉडल में छोटे-छोटे ट्रेन करने योग्य लेयर्स जोड़ी जाती हैं।
LoRA इसलिए उपयोगी है क्योंकि यह आर्ट शैलियाँ, किरदार या थीम जैसे नए कॉन्सेप्ट्स को बिना अधिक कम्प्यूटेशन या मेमोरी उपयोग के मॉडल में जोड़ने देता है।
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 14.49s/it, loss=0.119, lr=0.0001]Model weights saved in Dreambooth_SDXL/pytorch_lora_weights.safetensors
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 16.22s/it, loss=0.119, lr=0.0001]
pytorch_lora_weights.safetensors: 100%|████| 23.4M/23.4M [00:01<00:00, 11.9MB/s]
7GB के मॉडल फ़ाइल को सेव करने के बजाय, हम 23.4MB का LoRA अडॉप्टर सेव करेंगे, जिसे इन्फ़रेंस के दौरान बेस मॉडल से जोड़ा जाएगा।
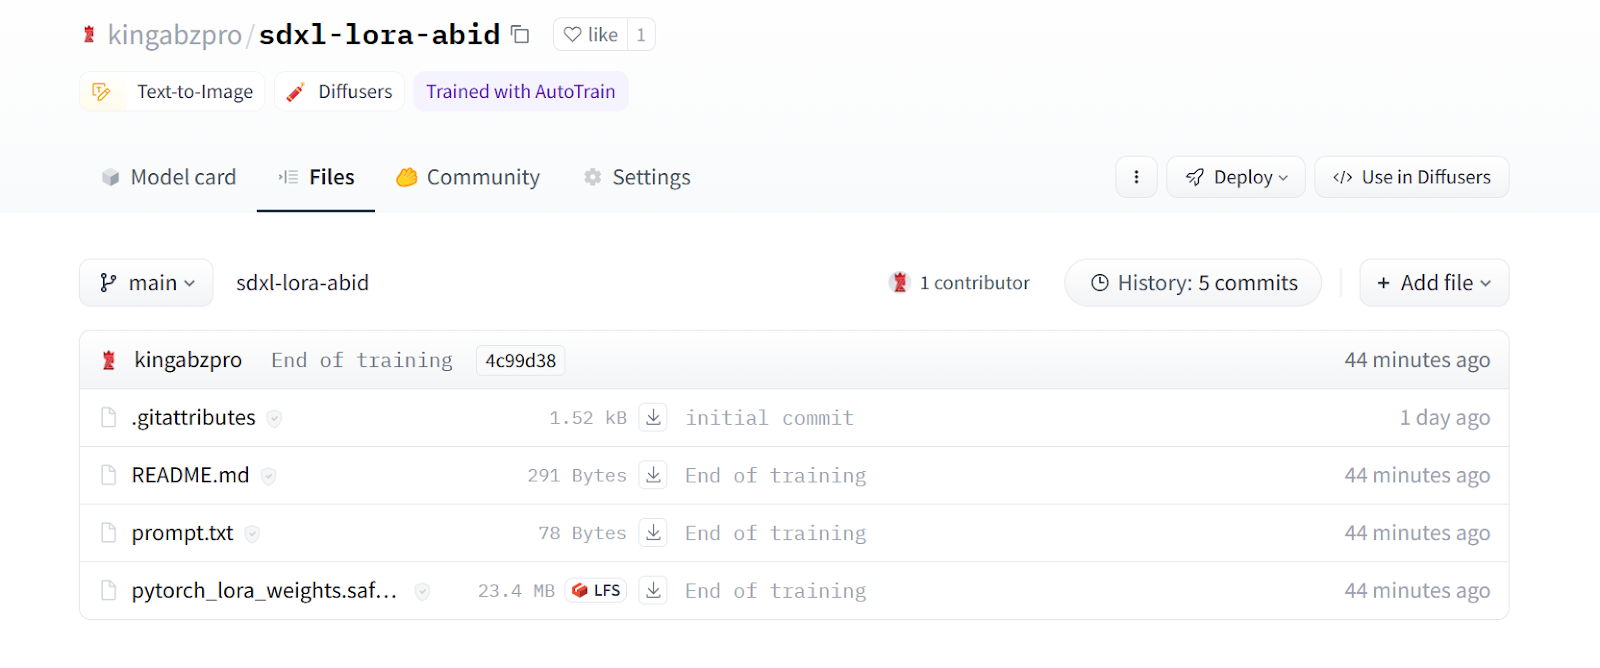
छवि स्रोत: kingabzpro/sdxl-lora-abid
हम एक डिफ्यूज़न पाइपलाइन बनाएँगे ताकि कस्टम VAE डिकोडर और FP16 प्रिसीजन के साथ SDXL बेस मॉडल का उपयोग करके छवियाँ जनरेट की जा सकें।
फिर, हम LoRA वेट्स लोड करेंगे और अपने Hugging Face repo ID का उपयोग करके उन्हें बेस मॉडल में जोड़ेंगे।
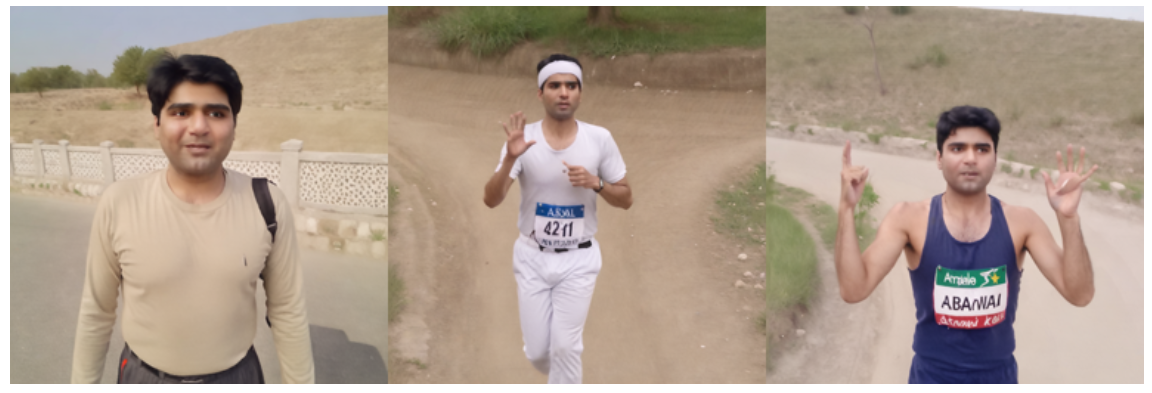
अंत में, हम प्रॉम्प्ट के साथ पाइपलाइन चलाएँगे और तीन छवियाँ जनरेट करेंगे।
from diffusers import DiffusionPipeline, AutoencoderKL, StableDiffusionXLImg2ImgPipeline

import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");
pipe.load_lora_weights(REPO_ID, weight_name="pytorch_lora_weights.safetensors")


prompt = "A photo of Abid Ali Awan participating in a marathon."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
नतीजे प्रभावशाली हैं। हमने सफलतापूर्वक अपने मॉडल को “Abid Ali Awan” की छवियाँ जनरेट करने के लिए फाइन-ट्यून कर लिया है।
आइए एक और प्रॉम्प्ट के साथ फिर प्रयास करते हैं।
prompt = "A photo of Abid Ali Awan giving a press conference."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
नतीजे एक बार फिर असाधारण हैं।
इस सेक्शन में, हम SDXL Refiner 1.0 से जनरेटेड छवि को बेहतर बनाएँगे।
पहले हम Stable Diffusion पाइपलाइन के साथ छवि जनरेट करेंगे और पुनरुत्पादकता सुनिश्चित करने के लिए एक मैनुअल सीड देंगे।
prompt = "A photo of Abid Ali Awan wearing a business suit at an office meeting."

seed = 65
generator = torch.Generator("cuda").manual_seed(seed)
image = pipe(prompt=prompt, num_inference_steps=25, generator=generator).images[0]
image.resize((300, 300))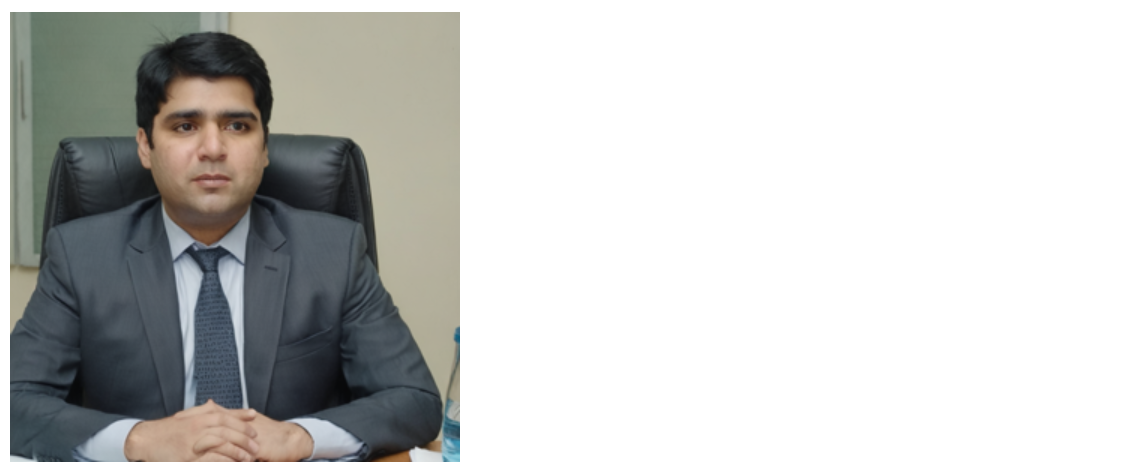
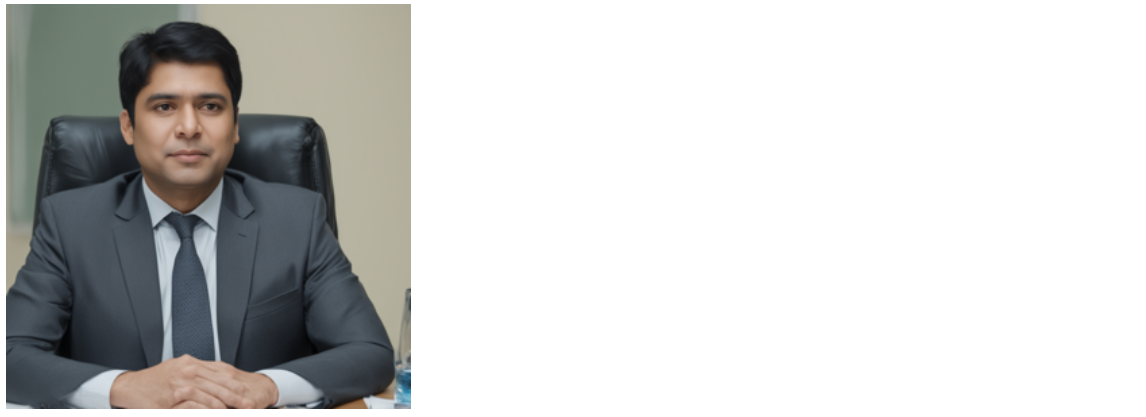
इसके बाद, हम SDXL refiner लोड करेंगे और उसी प्रॉम्प्ट, जेनरेटर और जनरेटेड इमेज के साथ रिफ़ाइनर पाइपलाइन चलाएँगे।
refiner = StableDiffusionXLImg2ImgPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda");

image = refiner(prompt=prompt, num_inference_steps=25, generator=generator, image=image)
image.images[0].resize((300, 300))
इमेज रिफ़ाइनर ने छवि गुणवत्ता को बेहतर किया है, लेकिन परिणाम मूल लेखक की फ़ोटो से मेल नहीं खाता। इसके बजाय, यह दक्षिण एशिया के एक सामान्य व्यवसायी को दिखाता है। संभवतः फाइन-ट्यून किए गए मॉडलों के लिए रिफ़ाइनर का उपयोग करने से बचना बेहतर है।
SDXL मॉडल को फाइन-ट्यून करने के बाद, अगला कदम एक जनरेटिव AI एप्लिकेशन बनाना है। अपना प्रोजेक्ट बनाने के लिए प्रेरणा पाने हेतु 5 Projects Built with Generative Models and Open Source Tools ब्लॉग देखें।
इस ट्यूटोरियल में, हमने Stable Diffusion XL मॉडल और DreamBooth तकनीक के बारे में जाना। साथ ही, हमने AutoTrain Advance की DreamBooth स्क्रिप्ट का उपयोग करके Stable Diffusion XL को व्यक्तिगत इमेज जेनरेशन के लिए फाइन-ट्यून करना सीखा।
बेस SDXL मॉडल लोड करने के बाद, हमने केवल पाँच फ़ोटो से एक हल्का LoRA अडॉप्टर प्रशिक्षित किया। फिर LoRA वेट्स को बेस SDXL से जोड़ दिया गया, जिससे वह बहु-बिलियन पैरामीटर वाले पूर्ण मॉडल की क्षमताएँ बनाए रखते हुए लेखक की विभिन्न काल्पनिक स्थितियों में उच्च-गुणवत्ता की छवियाँ बना सका।
हालाँकि SDXL Refiner ने छवि गुणवत्ता को बेहतर किया, यह सामान्य प्रॉम्प्ट्स के लिए सबसे प्रभावी रहा और लगता है कि फाइन-ट्यूनिंग से हासिल कुछ पर्सनलाइज़ेशन पर हावी हो गया। फिर भी, ट्यूटोरियल ने दिखाया कि केवल कुछ छवियों के साथ AutoTrain Advance का उपयोग कर SDXL मॉडल को फाइन-ट्यून करना कितना सरल है।
यदि आप AI की दुनिया में नए हैं और जानना चाहते हैं कि इतनी चर्चा क्यों है, तो हम AI Fundamentals कोर्स लेने का सुझाव देते हैं। इससे आप जनरेटिव AI और जटिल भाषा मॉडलों के बारे में सीखेंगे। इसके अतिरिक्त, आप Machine Learning Scientist with Python करियर ट्रैक में दाखिला लेकर AI इंजीनियरिंग में अपना करियर शुरू कर सकते हैं। यह संपूर्ण प्रोग्राम आपको नैचुरल लैंग्वेज प्रोसेसिंग, इमेज प्रोसेसिंग और scikit-learn, PySpark, तथा Keras जैसे लोकप्रिय Python मशीन लर्निंग पैकेज सिखाएगा।
आज ही अपनी AI यात्रा शुरू करें!
लर्निंग पाथ
लर्निंग पाथ