
Cursus
Principes fondamentaux de l'IA
10 h
Dans ce tutoriel, nous allons découvrir Stable Diffusion XL et DreamBooth, et voir comment accéder au modèle de génération d’images via la bibliothèque diffusers. Nous apprendrons aussi à affiner le modèle sur des photos personnelles et à évaluer ses performances. Si vous débutez en IA, nous vous suggérons de suivre le parcours AI Fundamentals pour une mise à niveau rapide.
L’équipe de Stability AI a publié Stable Diffusion XL (SDXL) 1.0, la nouvelle étape des modèles de génération d’images à partir de texte. Ce modèle open source s’appuie sur la version SDXL 0.9 (réservée à la recherche) pour devenir le modèle de création d’images le plus performant disponible publiquement.
Des analyses quantitatives et des évaluations humaines qualitatives, menées sur plusieurs semaines d’expérimentation, montrent qu’SDXL génère les images les plus qualitatives et les plus appréciées parmi les modèles open source.
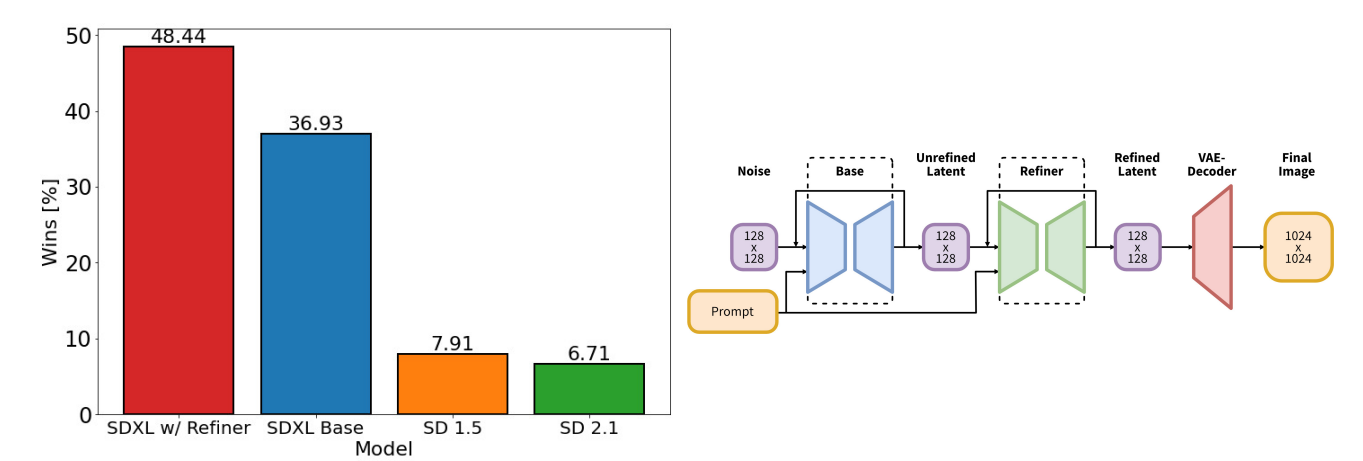
Image de arxiv.org
Cette qualité élevée est obtenue grâce à un ensemble de deux modèles : un générateur de base de 3,5 milliards de paramètres et un affinateur de 6,6 milliards de paramètres. Ce double pipeline maximise la qualité des images tout en restant suffisamment efficace pour s’exécuter sur des GPU grand public.
Avec SDXL 1.0, il n’est plus nécessaire d’écrire de longues invites complexes pour générer des images remarquables. Son « intelligence » permet de créer des visuels détaillés à partir de quelques mots.
L’ajustement fin d’SDXL sur des jeux de données et des tâches personnalisés est devenu encore plus simple. Il offre un contrôle fin sur la structure, le style et la composition.
DreamBooth, présenté en 2022 par l’équipe de recherche de Google, constitue une avancée majeure en IA générative, notamment pour les modèles texte‑vers‑image comme Stable Diffusion.
Il est appelé DreamBooth car, selon les chercheurs de Google :
« C’est comme une cabine photo, mais qui capture le sujet d’une manière permettant de le synthétiser partout où vos rêves vous emmènent. »
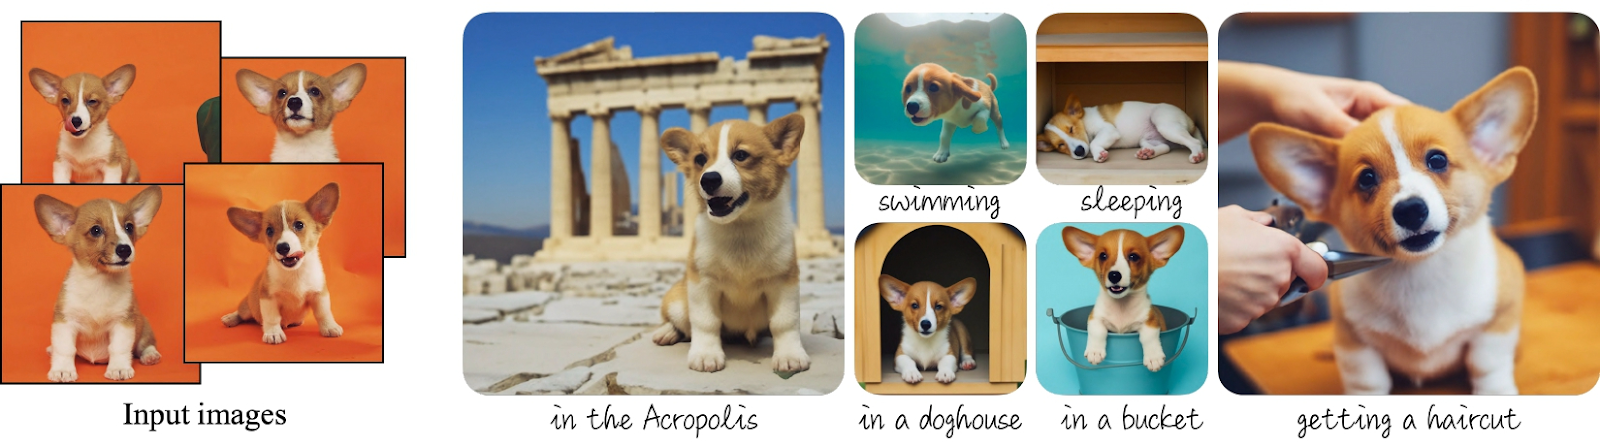
Image de DreamBooth
DreamBooth vous permet d’injecter un sujet personnalisé spécifique, que le modèle ajusté finement va apprendre à restituer sous différentes formes. En ce sens, il ouvre la voie à la création de votre propre générateur d’images centré sur une personne, un personnage, un objet ou une scène.
DreamBooth ne nécessite que quelques images du sujet (généralement 3 à 5) pour entraîner efficacement le modèle. Une fois entraîné, le modèle peut placer ce sujet dans une multitude de contextes, de scènes et de poses, avec pour seule limite votre imagination.
Ajuster finement le modèle de génération d’images avec DreamBooth peut être utile dans de nombreux domaines. Il offre une grande liberté d’expérimentation et permet de générer des images de haute qualité sans compétences Photoshop. Voici quelques exemples de valeur ajoutée au quotidien.
Dans les sections suivantes, nous allons détailler l’accès au modèle SDXL et son ajustement fin sur un jeu de données personnalisé en utilisant des GPU gratuits sur Kaggle.
Vous pouvez tester la démo Stable Diffusion XL Spaces sur Hugging Face, qui génère rapidement quatre images à partir de votre saisie. Expérimentez avant de décider si cela convient à votre cas d’usage.
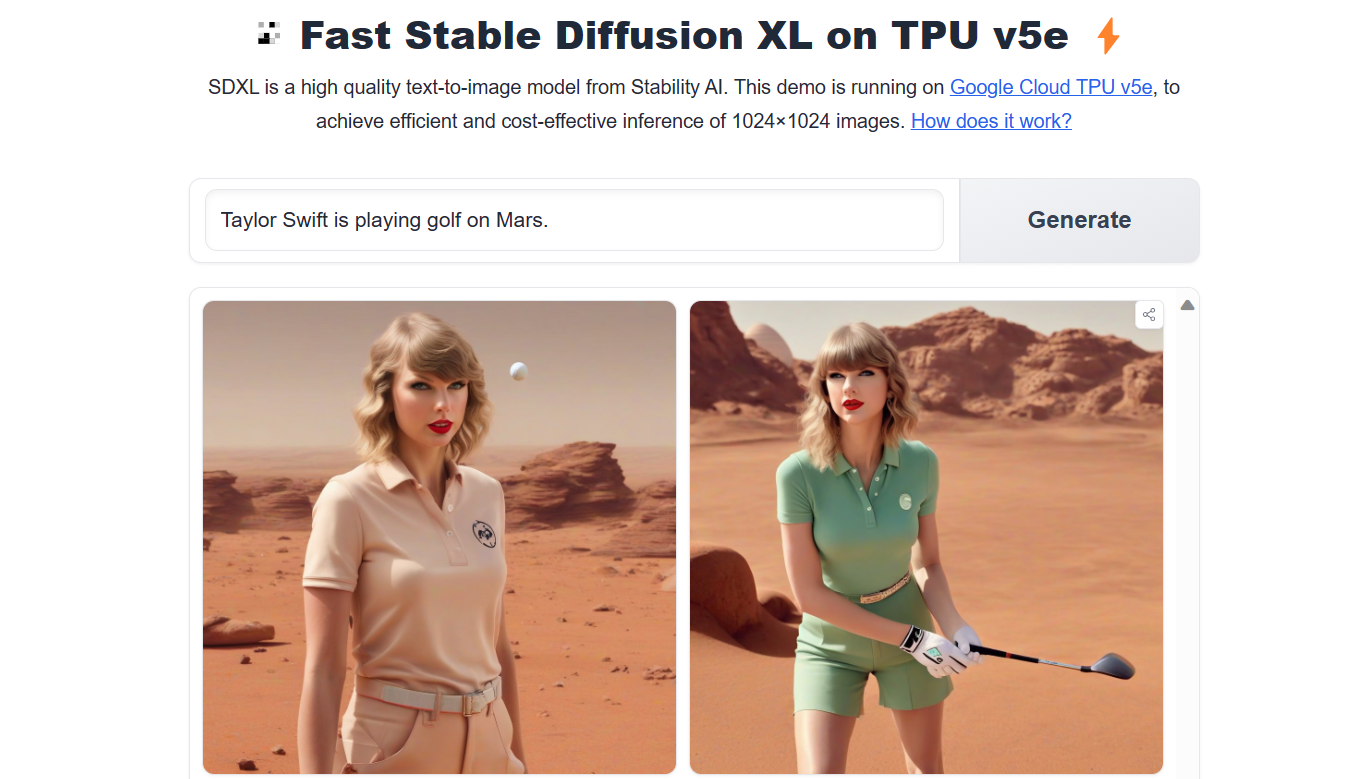
Image de Stable Diffusion XL on TPUv5e
Autre possibilité : utiliser la bibliothèque Python diffusers pour générer des images avec une invite personnalisée.
Avant d’exécuter le code, assurez-vous d’utiliser une machine GPU avec prise en charge CUDA.
!nvidia-smi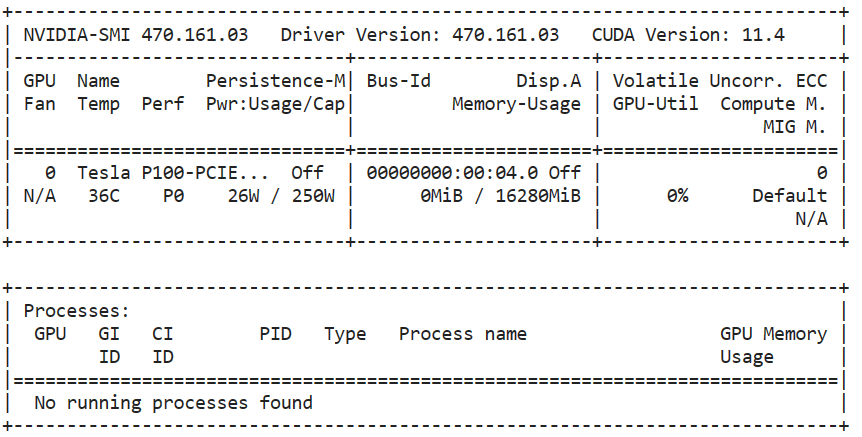
Ensuite, installez le paquet diffusers avec PIP.
%pip install --upgrade diffusers[torch] -qNous allons charger le décodeur VAE personnalisé modifié pour s’exécuter en précision fp16 sans générer de NaN.
Ensuite, nous construirons un pipeline en chargeant le modèle SDXL de base en fp16 et en intégrant le décodeur VAE dans le flux diffusers.
Nous pourrions charger le modèle de base sans « fp16 », mais cela provoquerait des problèmes de mémoire GPU. Pour l’exécuter sur Kaggle, Colab et des GPU d’ordinateurs portables, il faut donc utiliser la variante fp16.
from diffusers import DiffusionPipeline, AutoencoderKL
import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");Pour générer une image, fournissez une invite simple, le nombre d’étapes d’inférence et le nombre d’images par invite.
Ici, nous allons générer quatre images à partir d’une seule invite.
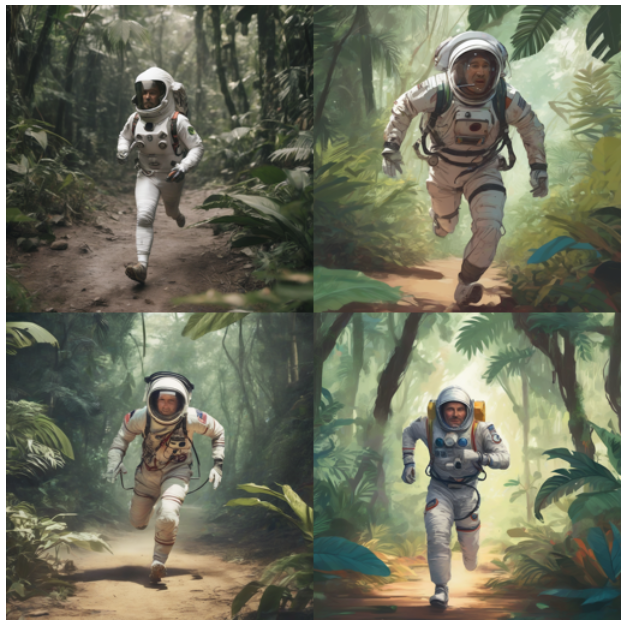
prompt = "A man in a spacesuit is running a marathon in the jungle."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 4)
Pour afficher les images en grille, écrivons une petite fonction Python qui les redimensionne et les dispose en mosaïque.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid
Nous afficherons quatre images dans une grille 2×2 pour comparer facilement les résultats.
image_grid(image.images, 2, 2)Les résultats sont bluffants. SDXL surpasse nettement Stable Diffusion 1.6.
Écrivons une autre invite et générons trois images d’un singe jouant avec des feux d’artifice.
prompt = "A playful monkey handling fireworks with ease."
image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)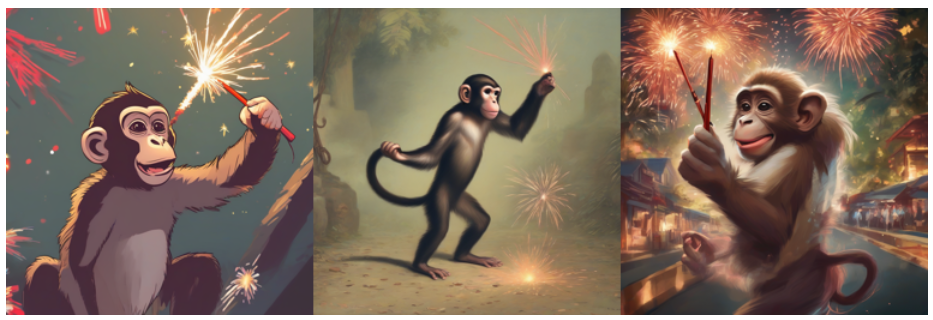
Apprenez à utiliser Stable Diffusion en ligne et en local en suivant le tutoriel How to Run Stable Diffusion.
Pour améliorer encore la qualité et la fidélité, nous allons utiliser le Refiner.
refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda")

n_steps = 40
high_noise_frac = 0.7

image = pipe(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_end=high_noise_frac,
    output_type="latent",
).images

image = refiner(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_start=high_noise_frac,
    image=image,
).images[0]

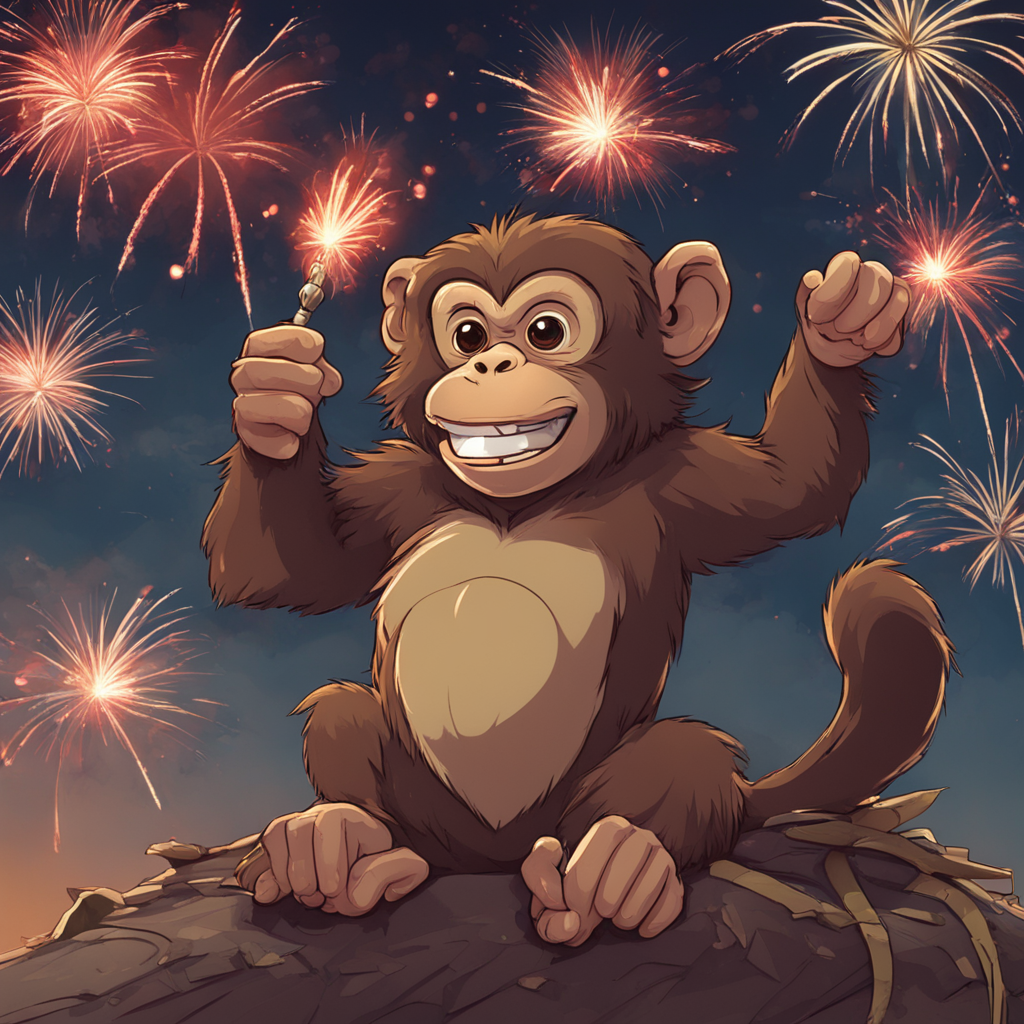
image
L’image affinée est de grande qualité et respecte fidèlement l’invite.
Apprenez à générer des images photoréalistes en Python avec des modèles de diffusion de pointe dans le code‑along Generating Photorealistic Images using AI with Diffusers in Python.
Avec le temps, l’ajustement fin d’SDXL est devenu bien plus simple. Grâce à AutoTrain Advance, nous pouvons désormais affiner notre modèle avec un seul script Python. Cette bibliothèque d’AutoML est conçue pour entraîner et déployer des modèles de pointe avec un minimum de code.
Vous pouvez installer le package Python avec PIP :
%pip install -U autotrain-advancedSi vous souhaitez ajuster le modèle SDXL avec accelerate et transformers, consultez le notebook Colab SDXL DreamBoot LoRA. Le notebook est un peu daté et peut nécessiter quelques modifications pour fonctionner correctement.
Avant d’exécuter le script DreamBooth, définissons les variables qui serviront à le lancer.
PROJECT_NAME = "Dreambooth_SDXL"
MODEL_NAME = "stabilityai/stable-diffusion-xl-base-1.0"
DATA_DIR = "/kaggle/input/abids-photos"
REPO_ID = "kingabzpro/sdxl-lora-abid"
Ensuite, configurez un jeton Hugging Face en utilisant la fonctionnalité Secret de Kaggle. Pour savoir comment procéder, lisez le tutoriel Mistral 7B : guide pas à pas pour utiliser Mistral 7B.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
HF_TOKEN = user_secrets.get_secret("HUGGINGFACE_TOKEN")Pour créer votre jeu de données privé de selfies dans Kaggle, cliquez sur le bouton d’upload dans le panneau de droite du notebook.
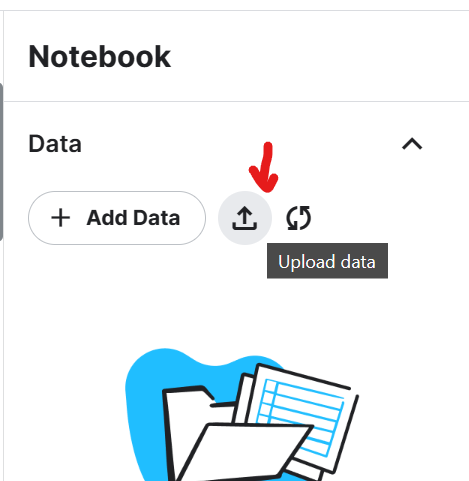
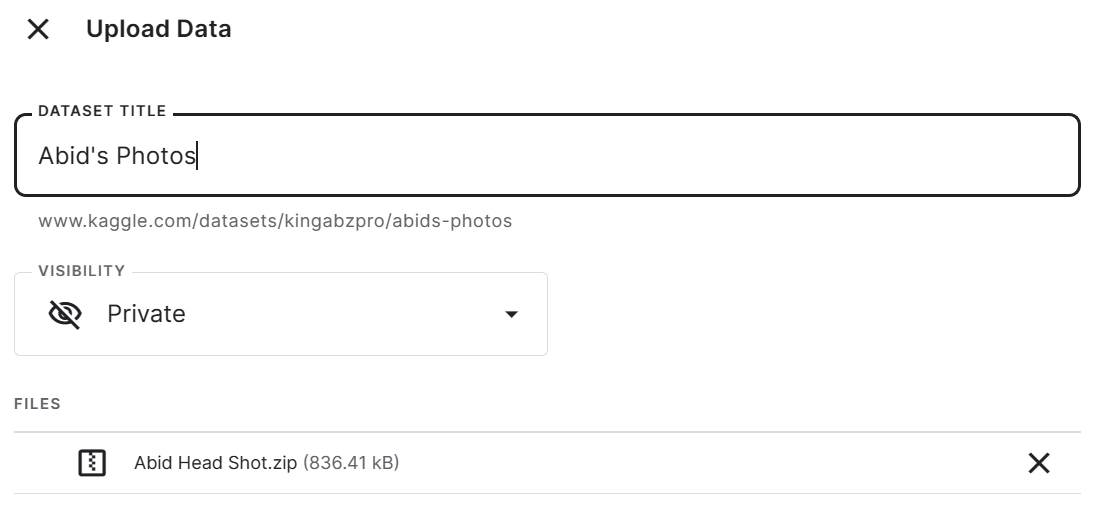
Ajoutez un titre au jeu de données et téléversez l’archive zip contenant cinq photos prises dans des lieux différents. Dans notre cas, il s’agit des photos de l’auteur.
Pour afficher les cinq images dans Jupyter Notebook, nous allons les charger avec PIL et les passer à notre fonction image_grid.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid

import glob
Nous avons affiché cinq images haute définition de l’auteur dans différents lieux. Veillez à ce que toutes les photos soient de bonne qualité et de taille similaire.
imgs = [Image.open(path) for path in glob.glob("/kaggle/input/abids-photos/*.jpg")]
image_grid(imgs, 1, 5)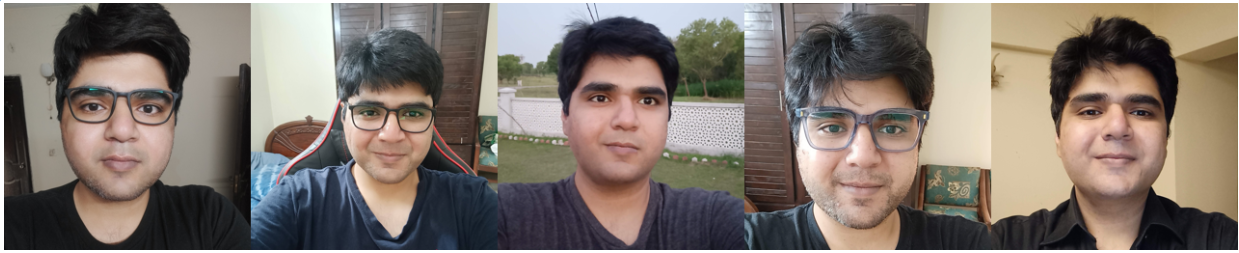
Il est temps d’ajuster finement notre modèle sur ces cinq images avec le script DreamBooth d’AutoTrain.
!autotrain dreambooth \
--model $MODEL_NAME \
--project-name $PROJECT_NAME \
--image-path $DATA_DIR \
--prompt "A photo of Abid Ali Awan wearing casual clothes, taking a selfie, and smiling." \
--resolution 1024 \
--batch-size 1 \
--num-steps 500 \
--gradient-accumulation 4 \
--lr 1e-4 \
--fp16 \
--gradient-checkpointing \
--push-to-hub \
--token $HF_TOKEN \
--repo-id $REPO_ID
L’entraînement a pris 2 heures et 15 minutes, puis les poids LoRA ont été poussés sur Hugging Face.
LoRA, pour Low‑Rank Adaptation, consiste à ajouter de petites couches entraînables à un modèle existant sans modifier ses poids d’origine.
LoRA est intéressant car il permet d’introduire de nouveaux concepts — styles artistiques, personnages, thèmes — sans exiger trop de calcul ni de mémoire.
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 14.49s/it, loss=0.119, lr=0.0001]Model weights saved in Dreambooth_SDXL/pytorch_lora_weights.safetensors
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 16.22s/it, loss=0.119, lr=0.0001]
pytorch_lora_weights.safetensors: 100%|████| 23.4M/23.4M [00:01<00:00, 11.9MB/s]
Au lieu d’enregistrer un fichier modèle de 7 Go, nous enregistrons un adaptateur LoRA de 23,4 Mo qui sera rattaché au modèle de base lors de l’inférence.
Image de kingabzpro/sdxl-lora-abid
Nous allons créer un pipeline de diffusion pour générer des images, en utilisant un décodeur VAE personnalisé et le modèle SDXL de base en précision FP16.
Nous chargerons ensuite les poids LoRA et les ajouterons au modèle de base en utilisant l’ID de notre dépôt Hugging Face.
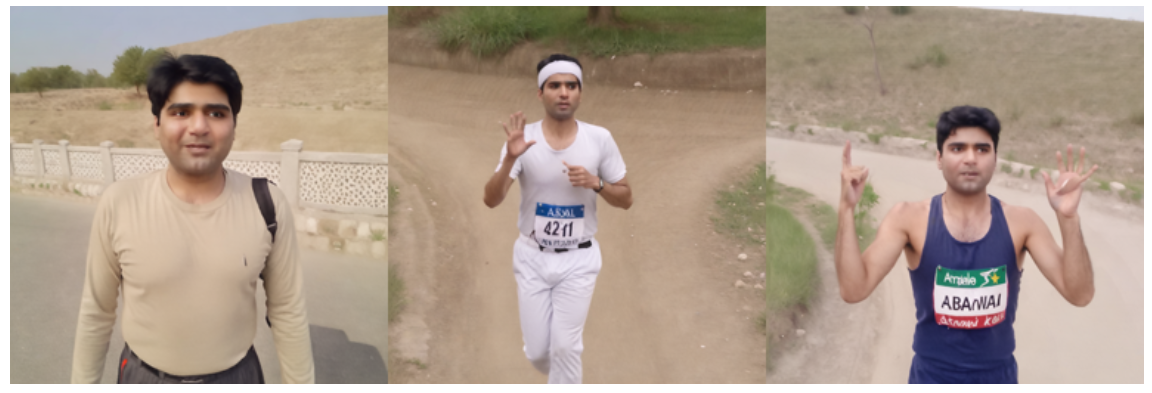
Enfin, nous exécuterons le pipeline avec une invite et générerons trois images.
from diffusers import DiffusionPipeline, AutoencoderKL, StableDiffusionXLImg2ImgPipeline

import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");
pipe.load_lora_weights(REPO_ID, weight_name="pytorch_lora_weights.safetensors")


prompt = "A photo of Abid Ali Awan participating in a marathon."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
Les résultats sont impressionnants. Nous avons ajusté avec succès notre modèle pour générer des images de l’auteur « Abid Ali Awan ».
Essayons avec une autre invite.
prompt = "A photo of Abid Ali Awan giving a press conference."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
Les résultats sont à nouveau excellents.
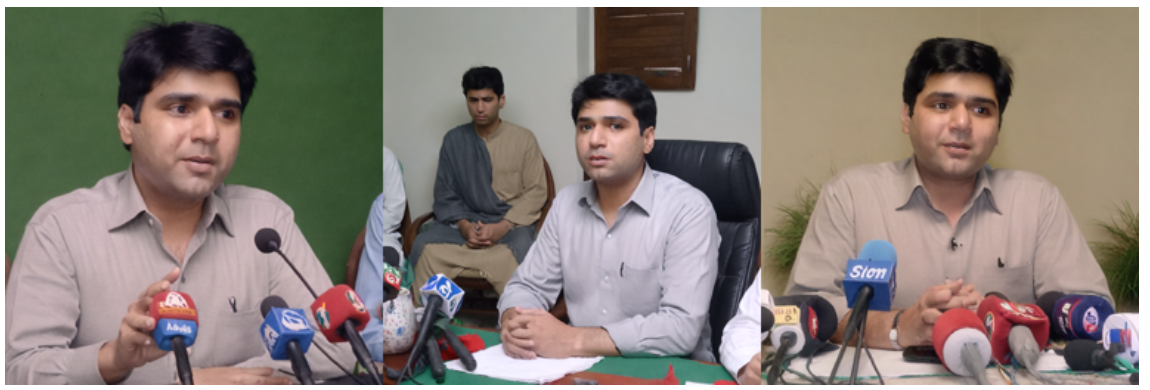
Dans cette section, nous allons améliorer l’image générée avec SDXL Refiner 1.0.
D’abord, nous générerons l’image via le pipeline Stable Diffusion et fixerons une graine aléatoire pour assurer la reproductibilité.
prompt = "A photo of Abid Ali Awan wearing a business suit at an office meeting."

seed = 65
generator = torch.Generator("cuda").manual_seed(seed)
image = pipe(prompt=prompt, num_inference_steps=25, generator=generator).images[0]
image.resize((300, 300))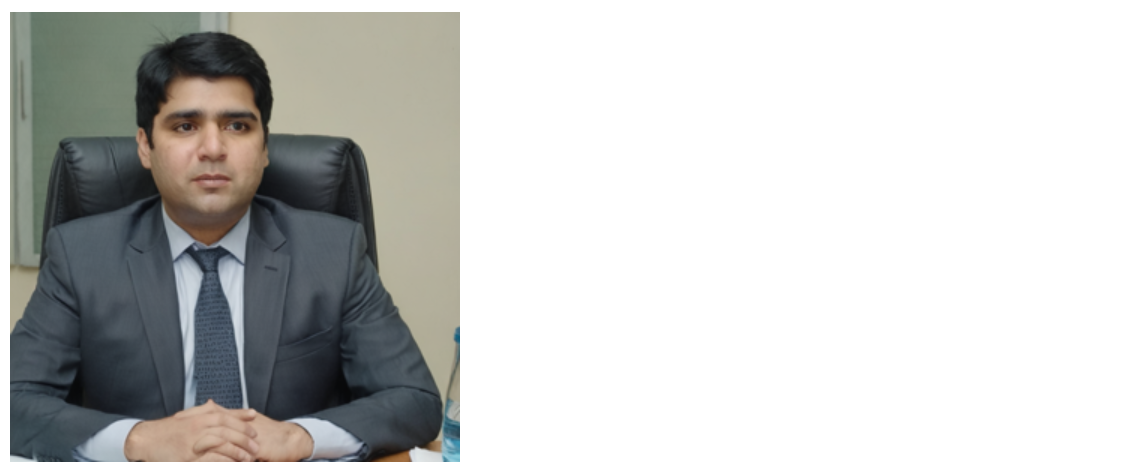
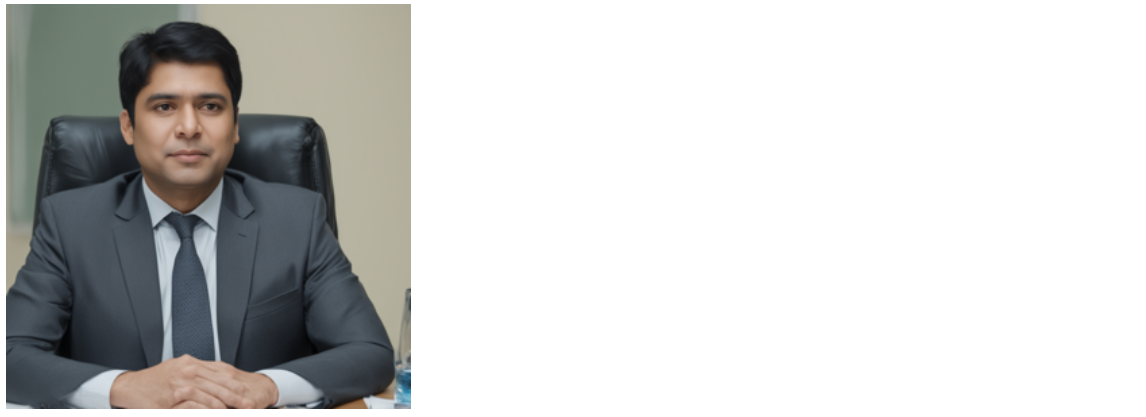
Ensuite, nous chargerons SDXL Refiner et exécuterons le pipeline d’affinage avec la même invite, le même générateur et l’image produite.
refiner = StableDiffusionXLImg2ImgPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda");

image = refiner(prompt=prompt, num_inference_steps=25, generator=generator, image=image)
image.images[0].resize((300, 300))
L’affinateur a amélioré la qualité, mais le résultat ne ressemble plus à la photo originale de l’auteur : il montre un homme d’affaires générique d’Asie du Sud. Pour des modèles ajustés finement, il vaut peut‑être mieux éviter le refiner.
Après avoir ajusté finement SDXL, l’étape suivante consiste à créer une application d’IA générative. Pour vous inspirer, consultez l’article 5 Projects Built with Generative Models and Open Source Tools.
Dans ce tutoriel, nous avons passé en revue le modèle Stable Diffusion XL et la technique DreamBooth. Nous avons également appris à affiner SDXL à l’aide du script DreamBooth d’AutoTrain Advance pour générer des images personnalisées.
Après avoir chargé le modèle SDXL de base, nous avons entraîné un adaptateur LoRA léger à partir de seulement cinq photos de l’auteur. Les poids LoRA ont ensuite été rattachés au modèle de base, ce qui a permis de générer des images de haute qualité de l’auteur dans divers scénarios imaginés, tout en conservant les capacités d’un modèle à plusieurs milliards de paramètres.
Bien que SDXL Refiner ait amélioré la qualité visuelle, il s’est montré surtout efficace pour des invites génériques et semble avoir atténué une partie de la personnalisation obtenue via l’ajustement fin. Ce tutoriel montre néanmoins à quel point il est simple d’affiner un modèle SDXL avec AutoTrain Advance à partir de quelques images seulement.
Si vous découvrez l’IA et souhaitez comprendre l’engouement actuel, nous vous recommandons le parcours AI Fundamentals. Vous y apprendrez la génération de contenu et les grands modèles de langage. Vous pouvez également lancer votre carrière d’ingénieur IA en rejoignant le parcours Machine Learning Scientist with Python. Ce programme complet vous initiera au traitement du langage naturel, au traitement d’images et aux bibliothèques Python phares comme scikit‑learn, PySpark et Keras.
Commencez votre aventure IA dès aujourd’hui !
Cursus
Cursus