
Programma
Nozioni di base sull'intelligenza artificiale
10 ore
In questo tutorial, vedremo Stable Diffusion XL e DreamBooth e come accedere al modello di generazione di immagini usando la libreria diffusers. Inoltre, impareremo a eseguire il fine-tuning del modello su foto personali e a valutarne le prestazioni. Se sei alle prime armi con l’IA, ti consigliamo di seguire il corso Fondamenti di IA per una base introduttiva.
Il team di Stability AI ha rilasciato Stable Diffusion XL (SDXL) 1.0, la prossima evoluzione dei modelli di generazione di immagini da testo. Questo modello open source si basa sul precedente SDXL 0.9 (solo per ricerca) e diventa il modello di creazione di immagini più capace disponibile pubblicamente al mondo.
Sia analisi quantitative che valutazioni umane qualitative, condotte per settimane di sperimentazione, dimostrano che SDXL è in grado di generare immagini della massima qualità e maggiormente preferite rispetto ad altri modelli open source.
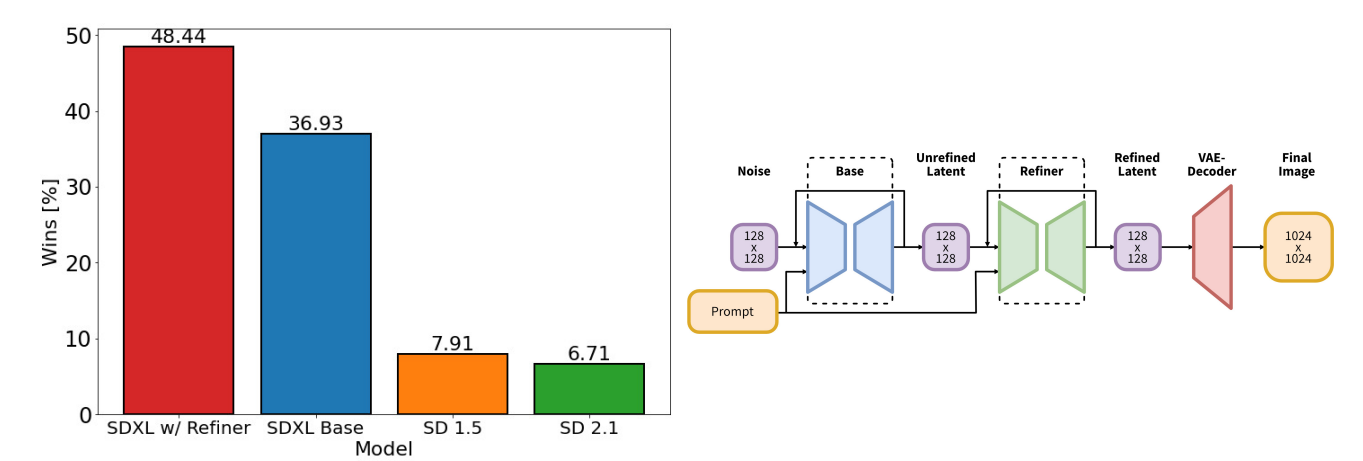
Immagine da arxiv.org
Questa alta qualità è stata raggiunta usando un ensemble di due modelli: un generatore base da 3,5 miliardi di parametri e un refiner da 6,6 miliardi di parametri. Questa pipeline doppia massimizza la qualità dell’immagine restando abbastanza efficiente da girare su GPU consumer.
Con SDXL 1.0 non servono più prompt lunghi e complessi per generare immagini straordinarie. La sua intelligenza consente di creare immagini intricate partendo da poche parole.
Eseguire il fine-tuning di SDXL su dataset e task personalizzati è diventato ancora più semplice. Ci offre un controllo granulare su struttura, stile e composizione.
DreamBooth, introdotto nel 2022 dal team di ricerca di Google, rappresenta un notevole avanzamento nell’IA generativa, in particolare nell’ambito dei modelli testo-immagine come Stable Diffusion.
Si chiama DreamBooth perché, nelle parole dei ricercatori Google:
"È come una cabina fotografica, ma cattura il soggetto in un modo che permette di sintetizzarlo ovunque i tuoi sogni ti portino."
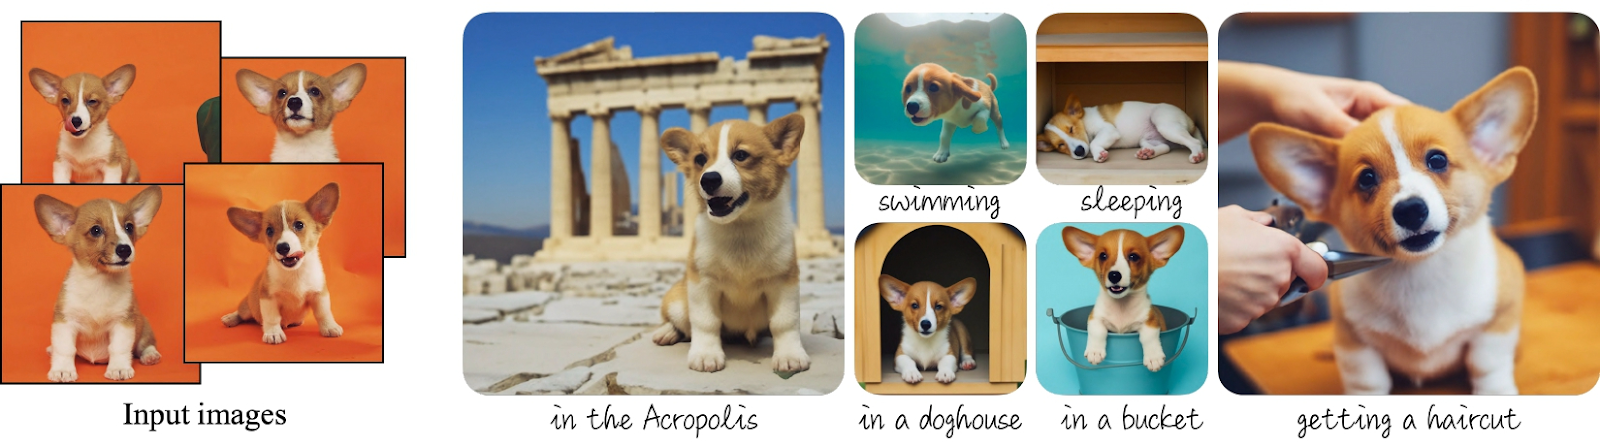
Immagine da DreamBooth
DreamBooth ti permette di iniettare un soggetto personalizzato specifico, su cui il modello ottimizzato diventa poi specializzato nel renderlo in modi diversi. In un certo senso, apre la possibilità di creare un tuo generatore di immagini focalizzato su una persona, un personaggio, un oggetto o una scena in particolare.
DreamBooth richiede solo poche immagini (tipicamente 3-5) del soggetto per addestrare efficacemente il modello. Una volta addestrato, il modello può collocare il soggetto in una miriade di contesti, scene e pose, limitato solo dall’immaginazione dell’utente.
Eseguire il fine-tuning del modello di generazione di immagini con DreamBooth può essere utile in molti ambiti. Offre più libertà di sperimentazione e di generare immagini di alta qualità senza competenze in Photoshop. Ecco alcuni esempi di come può facilmente portare valore sul lavoro.
Nelle sezioni seguenti, approfondiremo il processo di accesso e fine-tuning del modello SDXL su un dataset personalizzato usando GPU gratuite di Kaggle.
Possiamo provare la demo di Stable Diffusion XL su Hugging Face, che genera rapidamente quattro immagini in base al tuo input. Sperimenta un po’ prima di decidere se fa al caso tuo.
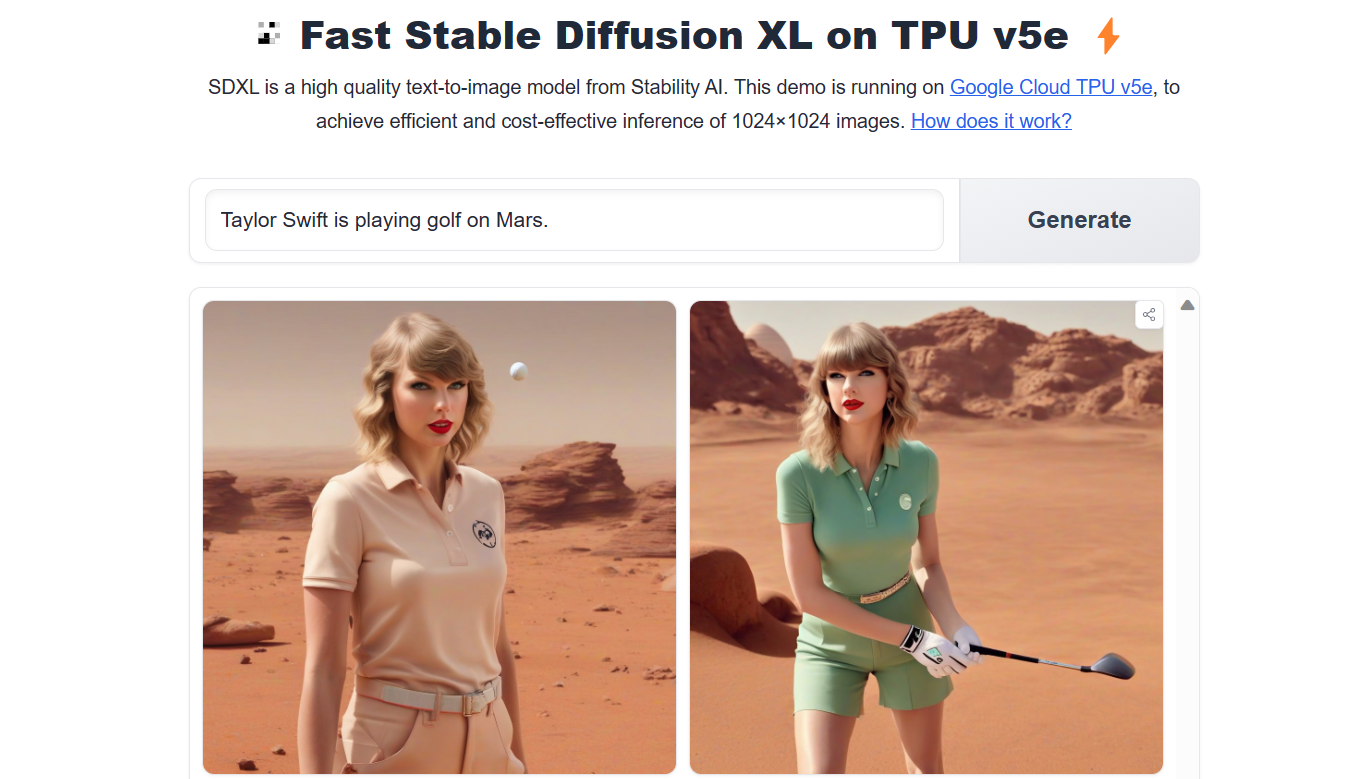
Immagine da Stable Diffusion XL on TPUv5e
Un altro modo è usare la libreria Python diffusers per generare l’immagine tramite un prompt personalizzato.
Prima di eseguire il codice, assicurati di usare una macchina con GPU e supporto CUDA.
!nvidia-smi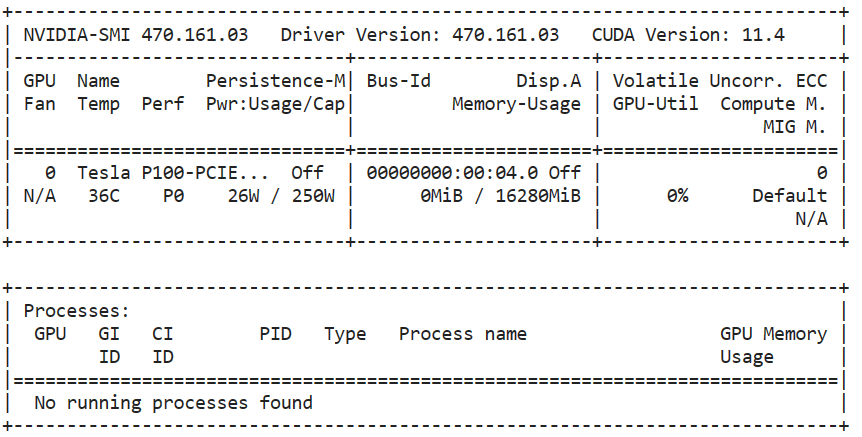
Dopodiché, installa il pacchetto diffusers con PIP.
%pip install --upgrade diffusers[torch] -qCaricheremo il decoder VAE personalizzato modificato per girare in precisione fp16 senza generare NaN.
Successivamente, costruiremo una pipeline caricando il modello base SDXL con precisione fp16 integrando il decoder VAE nel workflow di diffusers.
Avremmo potuto caricare il modello base direttamente senza “fp16”, ma ciò avrebbe causato problemi di memoria GPU. Quindi, per eseguirlo su Kaggle, Colab e GPU di laptop, è necessario accedere al modello nella variante fp16.
from diffusers import DiffusionPipeline, AutoencoderKL
import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");Per generare l’immagine, devi fornire un prompt semplice, i passaggi di inferenza e il numero di immagini per prompt.
Nel nostro caso genereremo quattro immagini da un singolo prompt.
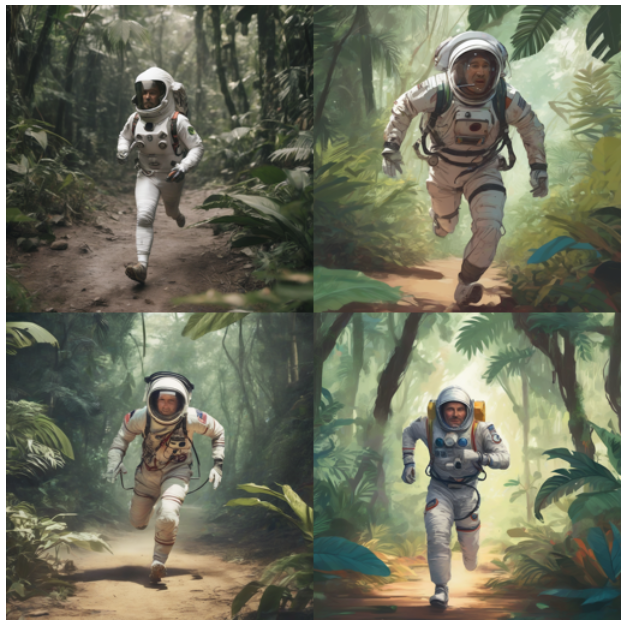
prompt = "A man in a spacesuit is running a marathon in the jungle."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 4)
Per mostrare le immagini in griglia, possiamo scrivere una semplice funzione Python che ridimensiona le immagini e le visualizza in una griglia.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid
Mostreremo quattro immagini in una griglia 2x2 per confrontare facilmente l’output del modello.
image_grid(image.images, 2, 2)I risultati sono notevoli. SDXL è sicuramente molto meglio di Stable Diffusion 1.6.
Scriviamo un altro prompt e generiamo tre immagini di una scimmia che gioca con i fuochi d’artificio.
prompt = "A playful monkey handling fireworks with ease."
image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)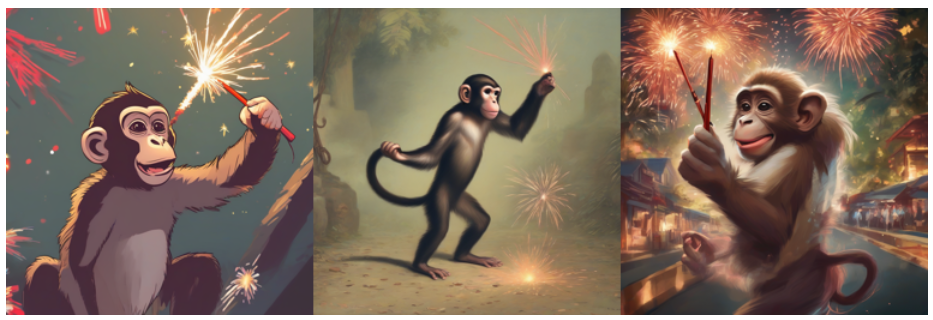
Scopri come accedere al modello Stable Diffusion online e in locale seguendo il tutorial How to Run Stable Diffusion.
Per migliorare ulteriormente la qualità dell’immagine e l’accuratezza del modello, useremo il Refiner.
refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda")

n_steps = 40
high_noise_frac = 0.7

image = pipe(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_end=high_noise_frac,
    output_type="latent",
).images

image = refiner(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_start=high_noise_frac,
    image=image,
).images[0]

image
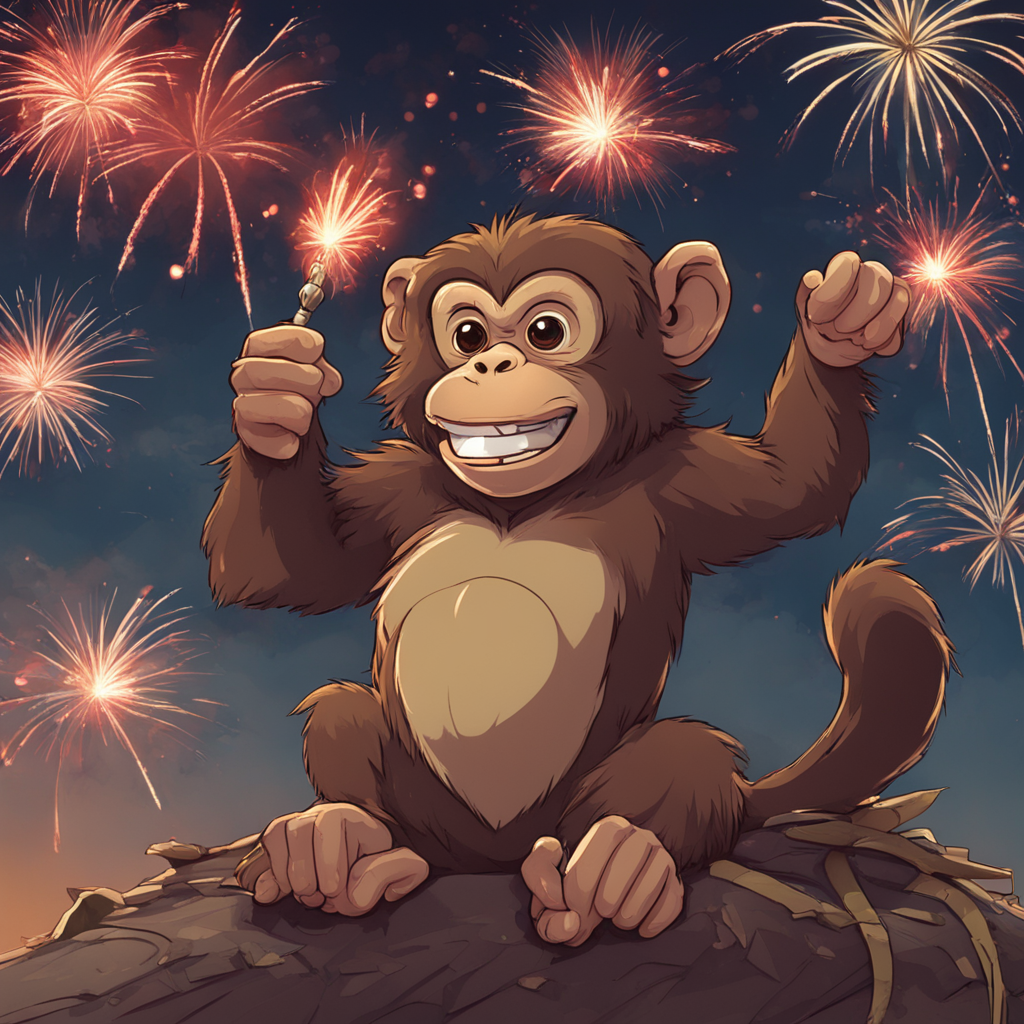
L’immagine raffinata è di alta qualità e segue accuratamente il prompt.
Impara a generare immagini fotorealistiche con Python usando modelli di diffusione all’avanguardia seguendo il code-along Generating Photorealistic Images using AI with Diffusers in Python.
Col tempo, fare fine-tuning di SDXL è diventato molto più semplice. Grazie ad AutoTrain Advance, ora possiamo eseguire il fine-tuning del nostro modello con un solo script Python. Questa libreria di AutoML è progettata per addestrare e distribuire modelli di machine learning all’avanguardia con il minimo codice.
Puoi installare il pacchetto Python con PIP:
%pip install -U autotrain-advancedSe ti interessa fare il fine-tuning del modello SDXL con accelerate e transformers, dai un’occhiata al notebook Colab SDXL DreamBoot LoRA. Il notebook è un po’ datato e potresti dover apportare modifiche per eseguirlo correttamente.
Prima di eseguire lo script DreamBooth, impostiamo alcune variabili che useremo per farlo girare.
PROJECT_NAME = "Dreambooth_SDXL"
MODEL_NAME = "stabilityai/stable-diffusion-xl-base-1.0"
DATA_DIR = "/kaggle/input/abids-photos"
REPO_ID = "kingabzpro/sdxl-lora-abid"
Successivamente, imposterai un token Hugging Face usando la funzione Secret di Kaggle. Scopri come impostare i secret leggendo Mistral 7B Tutorial: guida passo-passo all’uso di Mistral 7B.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
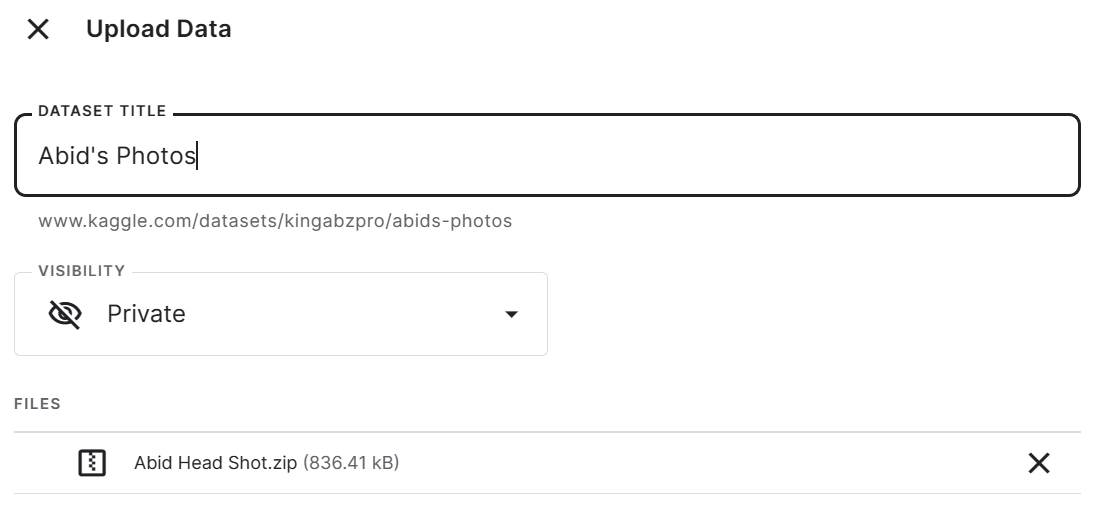
HF_TOKEN = user_secrets.get_secret("HUGGINGFACE_TOKEN")Per creare il dataset privato dei tuoi selfie in Kaggle, clicca sul pulsante di upload nel pannello a destra del notebook.
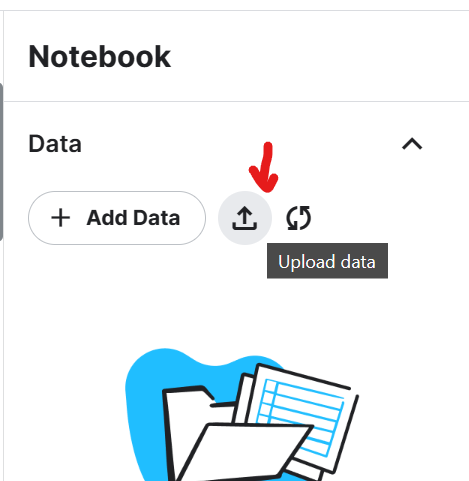
Aggiungi il titolo del dataset e carica il file zip contenente cinque foto di selfie scattati in luoghi diversi. In questo caso, sono le foto dell’autore.
Per visualizzare tutte e cinque le immagini nel Jupyter Notebook, caricheremo le immagini con PIL e le passeremo alla nostra funzione image_grid.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid

import glob
Abbiamo visualizzato cinque immagini di alta qualità dell’autore in luoghi diversi. Assicurati che tutte le foto siano di alta qualità e di dimensioni simili.
imgs = [Image.open(path) for path in glob.glob("/kaggle/input/abids-photos/*.jpg")]
image_grid(imgs, 1, 5)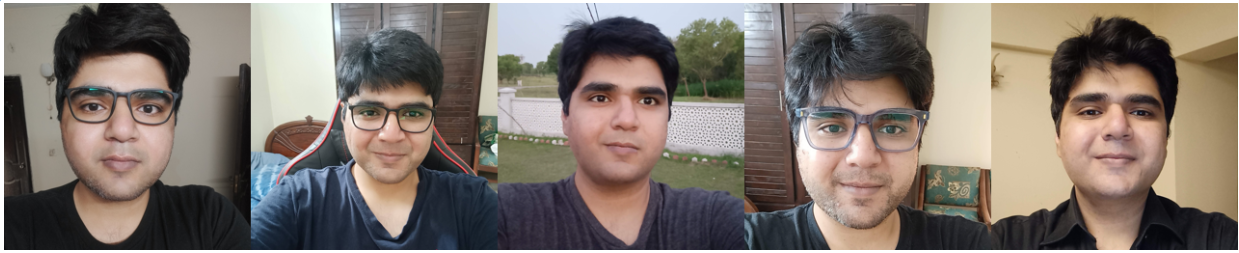
È il momento di fare il fine-tuning del nostro modello su queste cinque immagini usando lo script DreamBooth di AutoTrain.
!autotrain dreambooth \
--model $MODEL_NAME \
--project-name $PROJECT_NAME \
--image-path $DATA_DIR \
--prompt "A photo of Abid Ali Awan wearing casual clothes, taking a selfie, and smiling." \
--resolution 1024 \
--batch-size 1 \
--num-steps 500 \
--gradient-accumulation 4 \
--lr 1e-4 \
--fp16 \
--gradient-checkpointing \
--push-to-hub \
--token $HF_TOKEN \
--repo-id $REPO_ID
Ci sono volute 2 ore e 15 minuti per addestrare il modello e inviare i pesi LoRA su Hugging Face.
LoRA, acronimo di Low-Rank Adaptation, è una tecnica che prevede l’aggiunta di piccoli layer addestrabili a un modello esistente senza modificare i pesi originali.
LoRA è utile perché consente di introdurre nel modello nuovi concetti, come stili artistici, personaggi o temi, senza richiedere grandi risorse di calcolo o memoria.
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 14.49s/it, loss=0.119, lr=0.0001]Model weights saved in Dreambooth_SDXL/pytorch_lora_weights.safetensors
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 16.22s/it, loss=0.119, lr=0.0001]
pytorch_lora_weights.safetensors: 100%|████| 23.4M/23.4M [00:01<00:00, 11.9MB/s]
Invece di salvare un file modello da 7 GB, salveremo un adapter LoRA da 23,4 MB che verrà collegato al modello base durante l’inferenza.
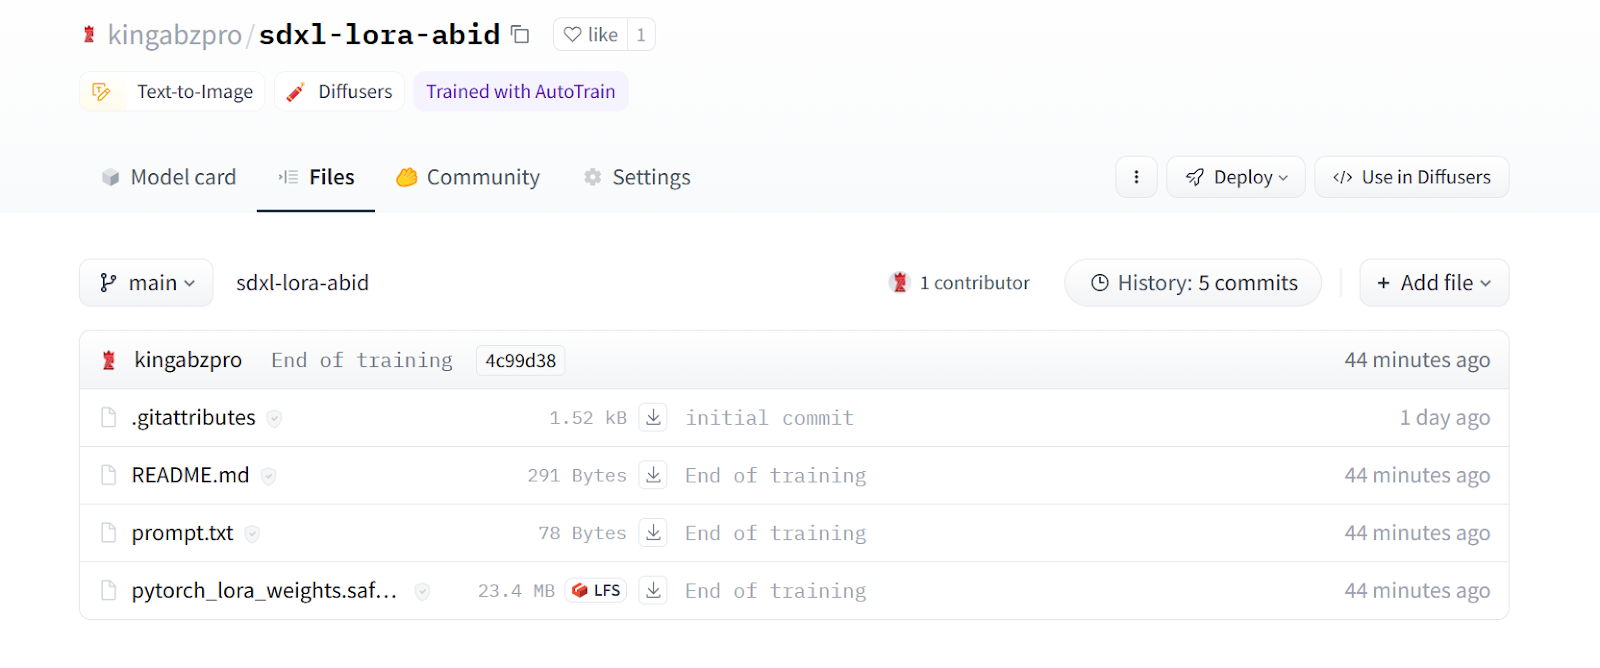
Immagine da kingabzpro/sdxl-lora-abid
Creeremo una diffusion pipeline per generare l’immagine, usando un decoder VAE personalizzato e il modello base SDXL con precisione FP16.
Poi caricheremo i pesi LoRA e li aggiungeremo al modello base usando il nostro repo ID su Hugging Face.
Infine eseguiremo la pipeline con il prompt e genereremo tre immagini.
from diffusers import DiffusionPipeline, AutoencoderKL, StableDiffusionXLImg2ImgPipeline

import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");
pipe.load_lora_weights(REPO_ID, weight_name="pytorch_lora_weights.safetensors")


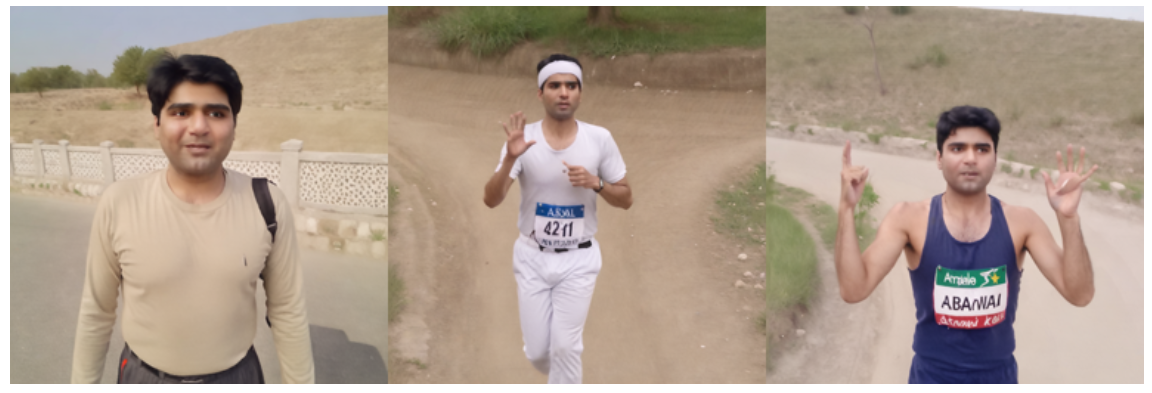
prompt = "A photo of Abid Ali Awan participating in a marathon."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
I risultati sono notevoli. Abbiamo eseguito con successo il fine-tuning del nostro modello per generare immagini dell’autore “Abid Ali Awan”.
Proviamo di nuovo con un altro prompt.
prompt = "A photo of Abid Ali Awan giving a press conference."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
Anche questa volta i risultati sono eccezionali.
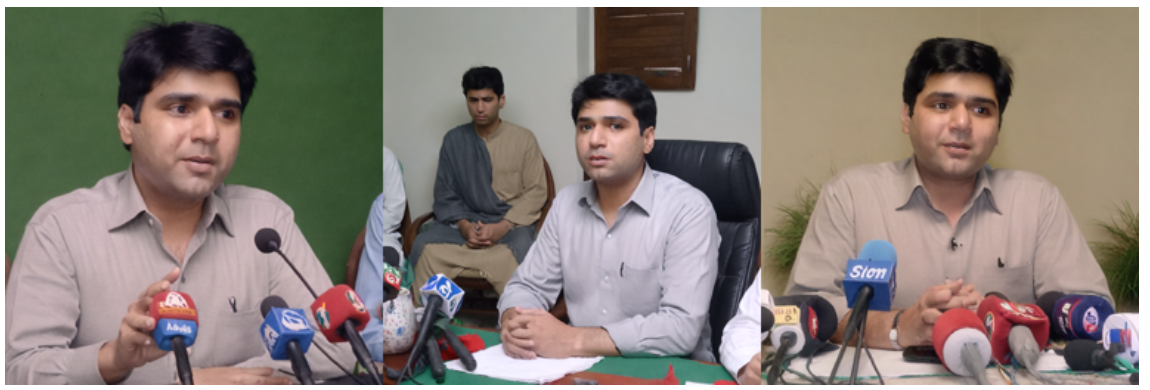
In questa sezione, miglioreremo l’immagine generata con SDXL Refiner 1.0.
Per prima cosa genereremo l’immagine usando la pipeline di Stable Diffusion e forniremo un seed manuale per garantire la riproducibilità.
prompt = "A photo of Abid Ali Awan wearing a business suit at an office meeting."

seed = 65
generator = torch.Generator("cuda").manual_seed(seed)
image = pipe(prompt=prompt, num_inference_steps=25, generator=generator).images[0]
image.resize((300, 300))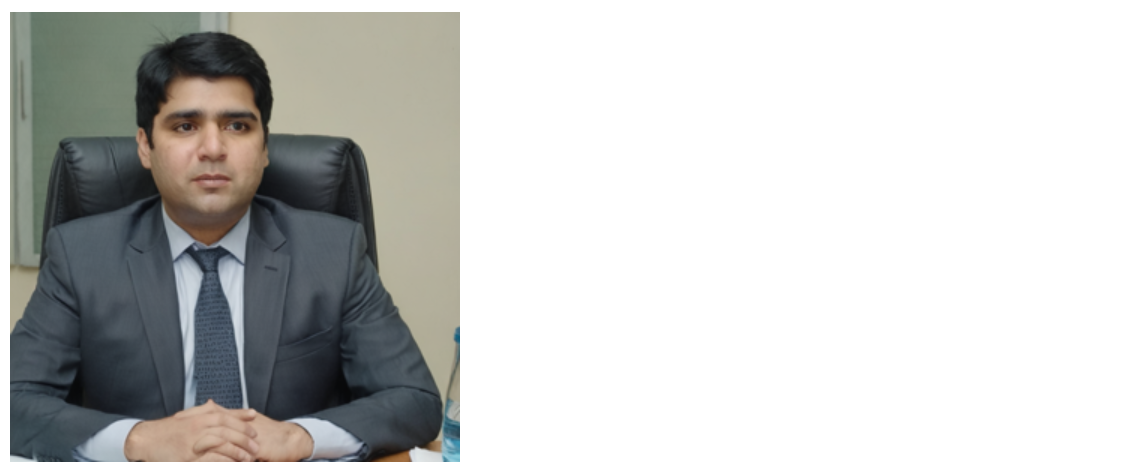
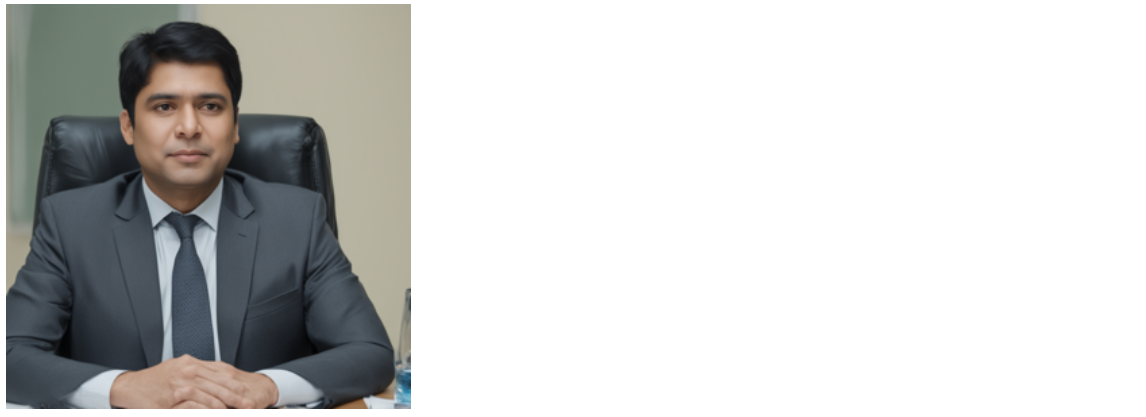
Poi caricheremo SDXL refiner ed eseguiremo la pipeline del refiner con lo stesso prompt, generator e immagine generata.
refiner = StableDiffusionXLImg2ImgPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda");

image = refiner(prompt=prompt, num_inference_steps=25, generator=generator, image=image)
image.images[0].resize((300, 300))
Il refiner ha migliorato la qualità dell’immagine, ma il risultato non assomiglia alla foto originale dell’autore. Mostra invece un uomo d’affari generico dell’Asia meridionale. Forse, per i modelli con fine-tuning, è meglio evitare di usare il refiner.
Dopo il fine-tuning del modello SDXL, il prossimo passo è creare un’applicazione di IA generativa. Per ispirarti nella realizzazione del tuo progetto, dai un’occhiata al post 5 progetti realizzati con modelli generativi e strumenti open source.
In questo tutorial, abbiamo visto il modello Stable Diffusion XL e la tecnica DreamBooth. Inoltre, abbiamo imparato a fare il fine-tuning di Stable Diffusion XL usando lo script DreamBooth di AutoTrain Advance per la generazione di immagini personalizzate.
Dopo aver caricato il modello base SDXL, abbiamo addestrato un adapter LoRA leggero usando solo cinque foto dell’autore. Poi i pesi LoRA sono stati collegati a SDXL base, permettendogli di generare immagini di alta qualità dell’autore in vari scenari immaginati, mantenendo al contempo le capacità del modello completo da miliardi di parametri.
Sebbene SDXL Refiner abbia migliorato la qualità dell’immagine, è stato più efficace con prompt generici e sembrava sovrascrivere parte della personalizzazione ottenuta con il fine-tuning. Ciononostante, il tutorial ha mostrato quanto sia semplice eseguire il fine-tuning di un modello SDXL con AutoTrain Advance usando poche immagini.
Se sei nuovo nel mondo dell’IA e vuoi capire di cosa si parla, ti suggeriamo di seguire il corso Fondamenti di IA. Ti aiuterà a conoscere l’IA generativa e i modelli linguistici complessi. Inoltre, puoi dare slancio alla tua carriera nell’ingegneria dell’IA iscrivendoti al percorso Machine Learning Scientist with Python. Questo programma completo ti aiuterà a imparare l’elaborazione del linguaggio naturale e delle immagini, oltre ai pacchetti Python più popolari per il machine learning come scikit-learn, PySpark e Keras.
Inizia oggi il tuo percorso nell’IA!
Programma
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



