
Lernpfad
Grundlagen der KI
10 Std.
In diesem Tutorial lernst du Stable Diffusion XL und DreamBooth kennen und wie du über die Diffusers-Bibliothek auf das Bildgenerierungsmodell zugreifst. Außerdem zeigen wir, wie du das Modell mit eigenen Fotos feinabstimmst und seine Leistung bewertest. Wenn du neu in der KI bist, empfehlen wir dir als Einstieg den Kurs AI Fundamentals.
Das Team von Stability AI hat Stable Diffusion XL (SDXL) 1.0 veröffentlicht — die nächste Evolutionsstufe textbasierter Bildgenerierungsmodelle. Dieses Open-Source-Modell baut auf dem zuvor nur für die Forschung verfügbaren SDXL 0.9 auf und ist aktuell das leistungsfähigste frei verfügbare Bildgenerierungsmodell.
Sowohl quantitative Analysen als auch qualitative, menschliche Bewertungen über mehrere Wochen belegen, dass SDXL im Vergleich zu anderen Open-Source-Modellen die höchste Bildqualität und Präferenz erzielt.
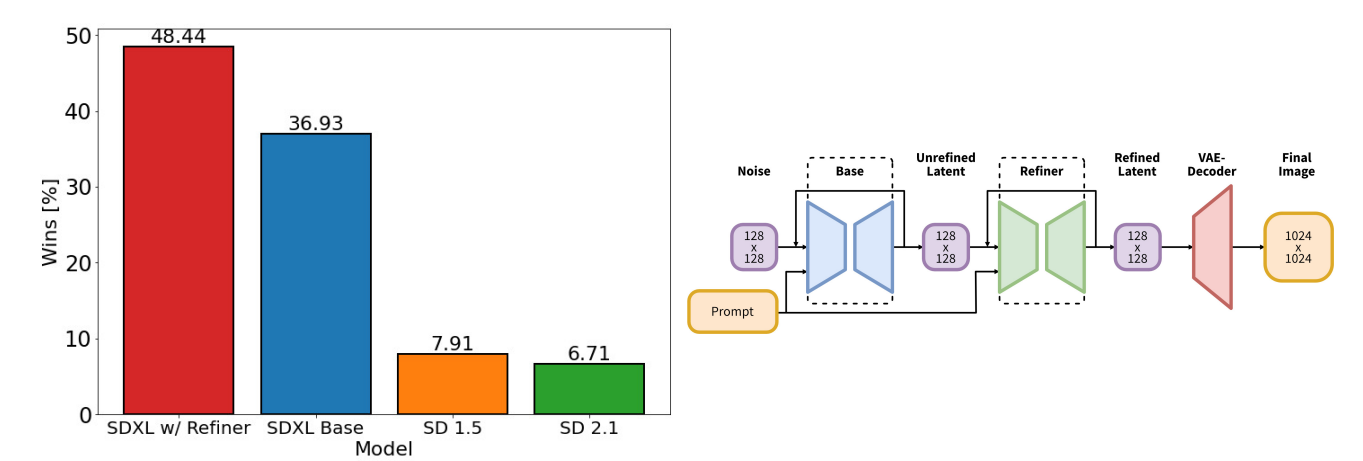
Bild von arxiv.org
Die hohe Qualität wird durch ein Ensemble aus zwei Modellen erreicht — einem Basisgenerator mit 3,5 Milliarden Parametern und einem Refiner mit 6,6 Milliarden Parametern. Diese doppelte Pipeline maximiert die Bildqualität und bleibt dennoch effizient genug für Consumer-GPUs.
Mit SDXL 1.0 sind keine langen, komplexen Prompts mehr nötig, um beeindruckende Bilder zu erzeugen. Die Modellintelligenz ermöglicht detailreiche Bilder schon mit wenigen Wörtern.
Die Feinabstimmung von SDXL auf individuelle Datensätze und Aufgaben ist noch einfacher geworden. So erhalten wir sehr feine Kontrolle über Aufbau, Stil und Komposition.
DreamBooth, 2022 vom Google-Forschungsteam vorgestellt, ist ein großer Fortschritt in der generativen KI, insbesondere für Text-zu-Bild-Modelle wie Stable Diffusion.
Der Name DreamBooth kommt von der Beschreibung der Google-Forschenden:
"Es ist wie eine Fotobox, die ein Motiv so einfängt, dass es überall dort synthetisiert werden kann, wohin dich deine Träume führen."
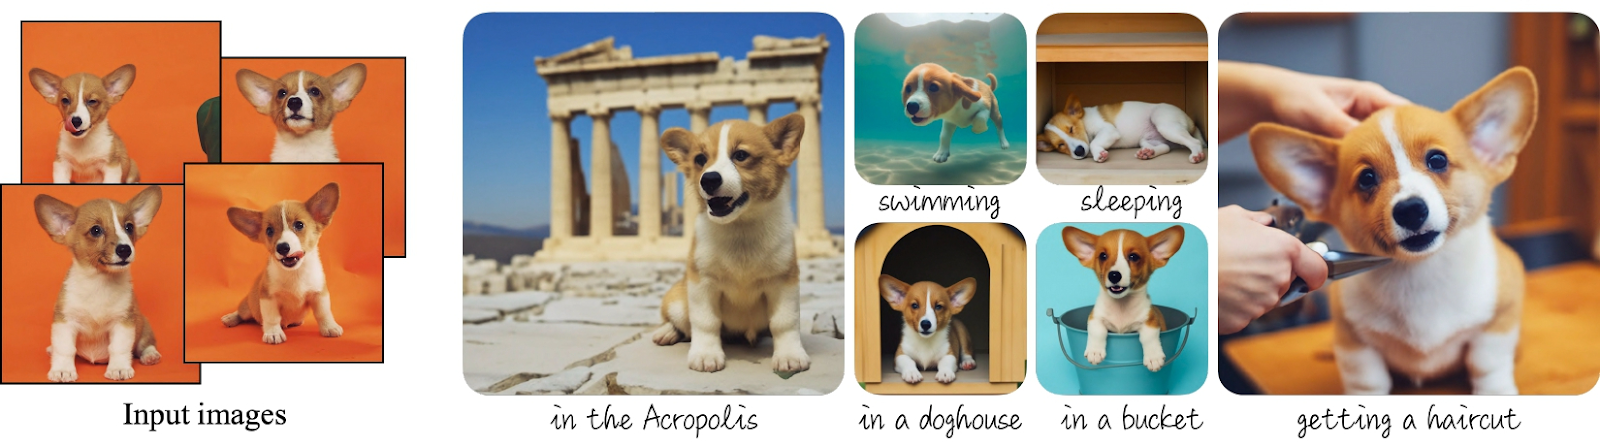
Bild von DreamBooth
DreamBooth erlaubt es, ein spezifisches, individuelles Motiv in das Modell einzubringen, auf das sich das feinabgestimmte Modell dann in unterschiedlichen Varianten spezialisiert. Im Ergebnis kannst du dir so deinen eigenen Bildgenerator für eine bestimmte Person, Figur, ein Objekt oder eine Szene bauen.
Für DreamBooth genügen wenige Bilder (typisch 3–5) des Motivs, um das Modell effektiv zu trainieren. Nach dem Training kann das Modell das Motiv in unzählige Umgebungen, Szenen und Posen versetzen — begrenzt nur durch deine Fantasie.
Die Feinabstimmung des Bildgenerierungsmodells mit DreamBooth ist in vielen Bereichen hilfreich. Sie bietet mehr Freiheit zum Experimentieren und erzeugt hochwertige Bilder — ganz ohne Photoshop-Kenntnisse. Hier ein paar Beispiele, wie DreamBooth im Arbeitsalltag schnell Mehrwert stiften kann.
In den folgenden Abschnitten zeigen wir Schritt für Schritt, wie du das SDXL-Modell mit einem eigenen Datensatz über kostenlose Kaggle-GPUs nutzt und feinabstimmst.
Du kannst das Stable Diffusion XL Spaces-Demo auf Hugging Face testen. Es erzeugt schnell vier Bilder basierend auf deinem Prompt. Probiere es aus, bevor du entscheidest, ob es für deinen Use Case passt.
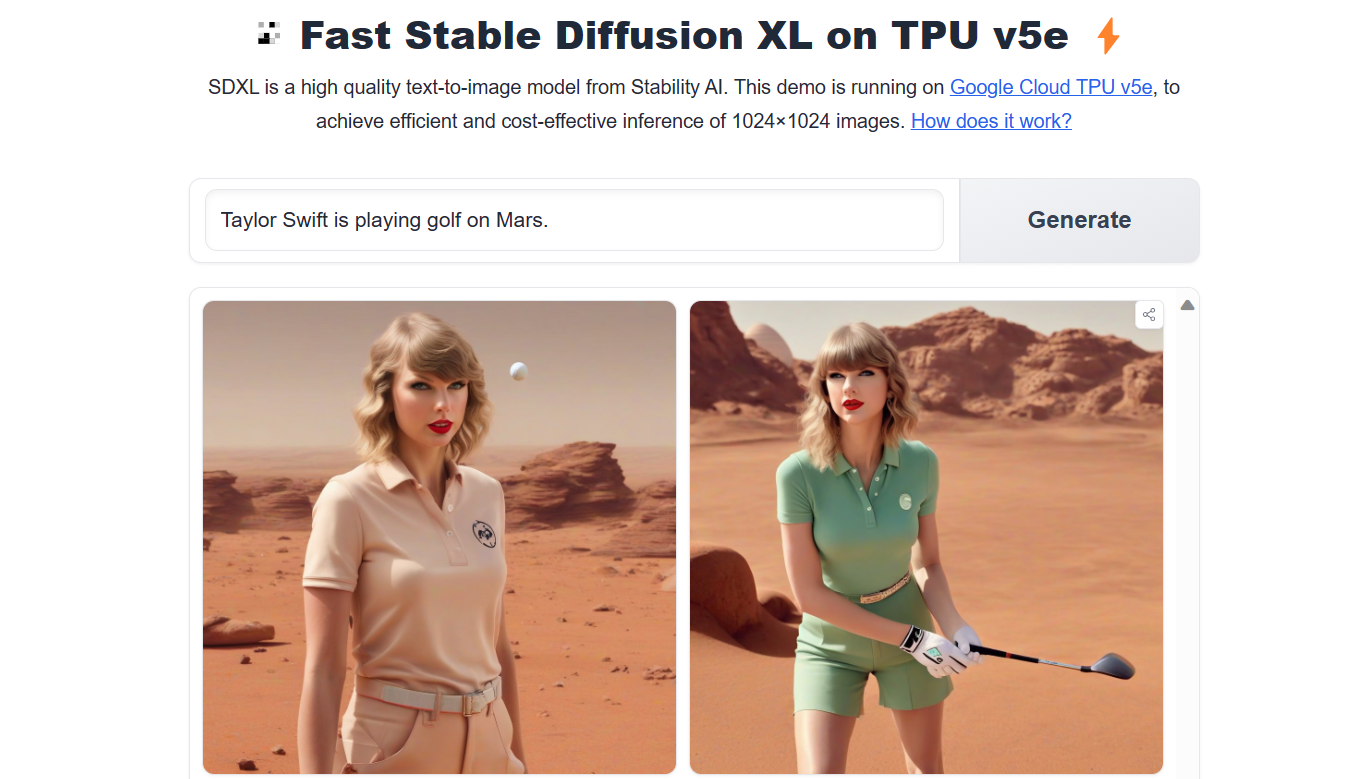
Bild von Stable Diffusion XL auf TPUv5e
Alternativ kannst du mit der Python-Bibliothek diffusers Bilder mit eigenem Prompt generieren.
Bevor du den Code ausführst, stelle sicher, dass du eine GPU-Maschine mit CUDA-Unterstützung nutzt.
!nvidia-smi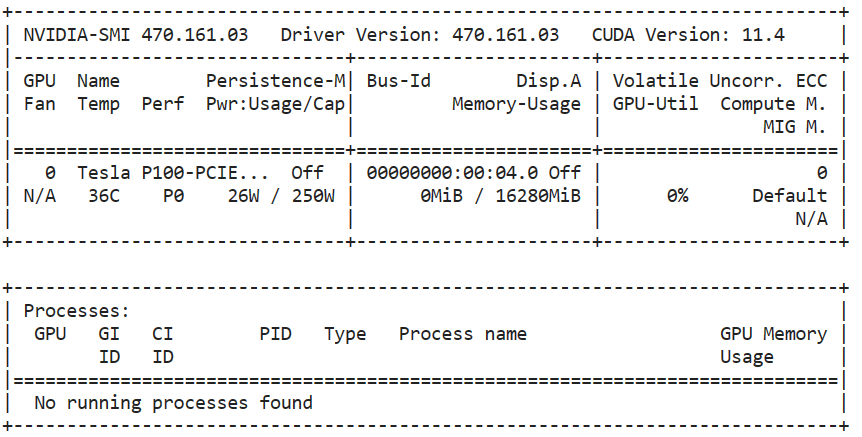
Installiere danach das Diffusers-Paket über PIP.
%pip install --upgrade diffusers[torch] -qWir laden den angepassten VAE-Decoder, der für fp16-Präzision modifiziert ist, ohne NaNs zu erzeugen.
Danach bauen wir eine Pipeline, indem wir das SDXL-Basismodell mit fp16-Präzision laden und den VAE-Decoder in den Diffusers-Workflow integrieren.
Wir könnten das Basismodell auch ohne „fp16“ laden, würden damit aber in GPU-Speicherprobleme laufen. Um SDXL auf Kaggle-, Colab- und Laptop-GPUs auszuführen, solltest du daher die fp16-Variante verwenden.
from diffusers import DiffusionPipeline, AutoencoderKL
import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");Zur Bildgenerierung brauchst du einen einfachen Prompt, die Anzahl der Inferenzschritte und die Anzahl der Bilder pro Prompt.
In unserem Beispiel erzeugen wir vier Bilder aus einem Prompt.
prompt = "A man in a spacesuit is running a marathon in the jungle."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 4)
Um die Bilder in einem Raster anzuzeigen, schreiben wir eine kleine Python-Funktion, die die Bilder skaliert und in einem Grid darstellt.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid
Wir zeigen vier Bilder in einem 2x2-Grid, um die Modellausgaben bequem zu vergleichen.
image_grid(image.images, 2, 2)Die Ergebnisse sind stark. SDXL ist deutlich besser als Stable Diffusion 1.6.
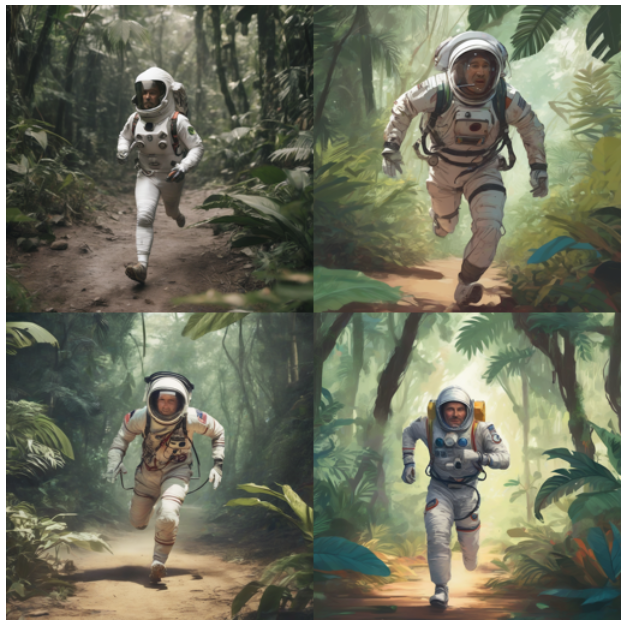
Schreiben wir noch einen Prompt und generieren drei Bilder eines Affen, der mit Feuerwerk spielt.
prompt = "A playful monkey handling fireworks with ease."
image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)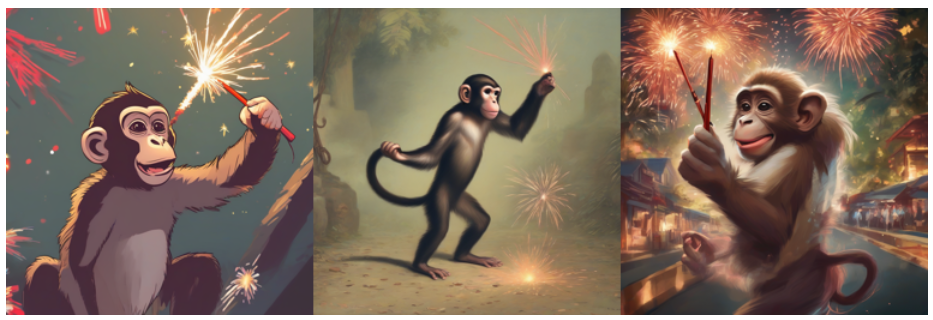
Lerne im Tutorial How to Run Stable Diffusion, wie du das Stable-Diffusion-Modell online und lokal nutzt.
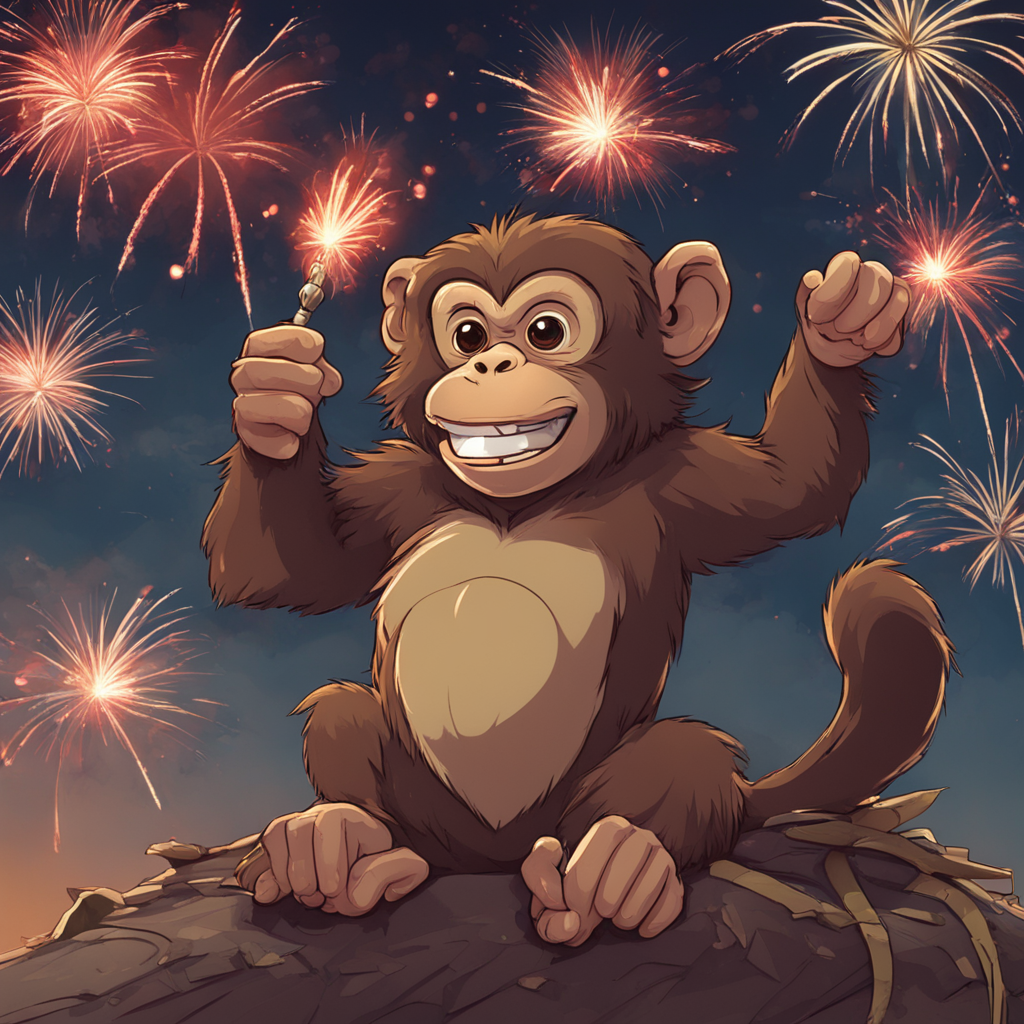
Um Bildqualität und Genauigkeit weiter zu steigern, nutzen wir den Refiner.
refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda")

n_steps = 40
high_noise_frac = 0.7

image = pipe(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_end=high_noise_frac,
    output_type="latent",
).images

image = refiner(
    prompt=prompt,
    num_inference_steps=n_steps,
    denoising_start=high_noise_frac,
    image=image,
).images[0]

image
Das verfeinerte Bild ist hochwertig und folgt dem Prompt sehr genau.
Erfahre im Code-Along Generating Photorealistic Images using AI with Diffusers in Python, wie du mit modernen Diffusionsmodellen fotorealistische Bilder in Python erzeugst.
Die Feinabstimmung von SDXL ist über die Zeit deutlich einfacher geworden. Dank AutoTrain Advanced können wir unser Modell jetzt mit nur einem Python-Skript feinabstimmen. Diese AutoML-Bibliothek ist für das Trainieren und Ausrollen modernster ML-Modelle mit minimalem Code gedacht.
Du kannst das Python-Paket mit PIP installieren:
%pip install -U autotrain-advancedWenn du SDXL mit accelerate und transformers feinabstimmen möchtest, sieh dir das Colab-Notebook SDXL DreamBoot LoRA an. Das Notebook ist etwas veraltet, du musst es eventuell anpassen.
Bevor wir das DreamBooth-Skript starten, definieren wir einige Variablen, die wir für die Ausführung benötigen.
PROJECT_NAME = "Dreambooth_SDXL"
MODEL_NAME = "stabilityai/stable-diffusion-xl-base-1.0"
DATA_DIR = "/kaggle/input/abids-photos"
REPO_ID = "kingabzpro/sdxl-lora-abid"
Als nächstes legst du ein Hugging-Face-Token über die Secret-Funktion von Kaggle an. Wie du Secrets einrichtest, erfährst du im Artikel Mistral 7B Tutorial: Step-by-Step Guide for Using Mistral 7B.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
HF_TOKEN = user_secrets.get_secret("HUGGINGFACE_TOKEN")Um einen privaten Datensatz deiner Selfies in Kaggle zu erstellen, klicke im rechten Seitenpanel des Notebooks auf den Upload-Button.
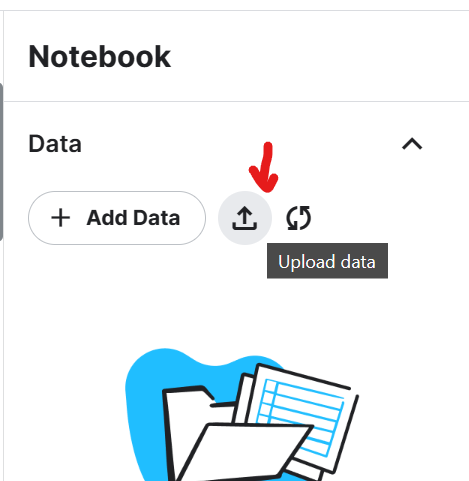
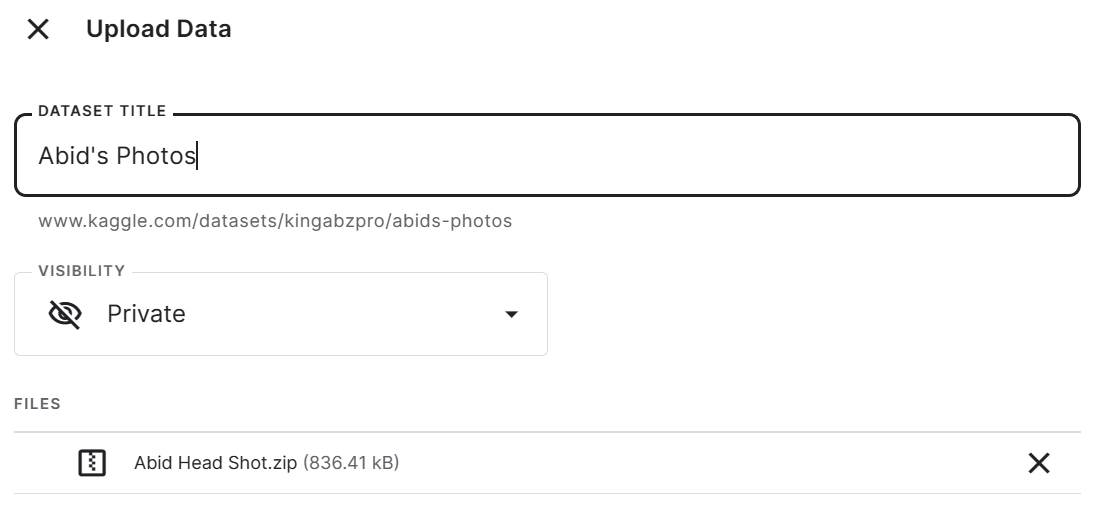
Vergib einen Titel für den Datensatz und lade die ZIP-Datei mit fünf Selfies hoch, die an unterschiedlichen Orten aufgenommen wurden. In diesem Beispiel sind es Fotos des Autors.
Um alle fünf Bilder im Jupyter Notebook anzuzeigen, laden wir sie mit PIL und geben sie an unsere Funktion image_grid weiter.
from PIL import Image

def image_grid(imgs, rows, cols, resize=256):
    assert len(imgs) == rows * cols

    if resize is not None:
        imgs = [img.resize((resize, resize)) for img in imgs]

    w, h = imgs[0].size
    grid_w, grid_h = cols * w, rows * h
    grid = Image.new("RGB", size=(grid_w, grid_h))

    for i, img in enumerate(imgs):
        x = i % cols * w
        y = i // cols * h
        grid.paste(img, box=(x, y))

    return grid

import glob
Wir zeigen fünf hochwertige Bilder des Autors an unterschiedlichen Orten. Achte darauf, dass alle Fotos in hoher Qualität und ähnlicher Größe vorliegen.
imgs = [Image.open(path) for path in glob.glob("/kaggle/input/abids-photos/*.jpg")]
image_grid(imgs, 1, 5)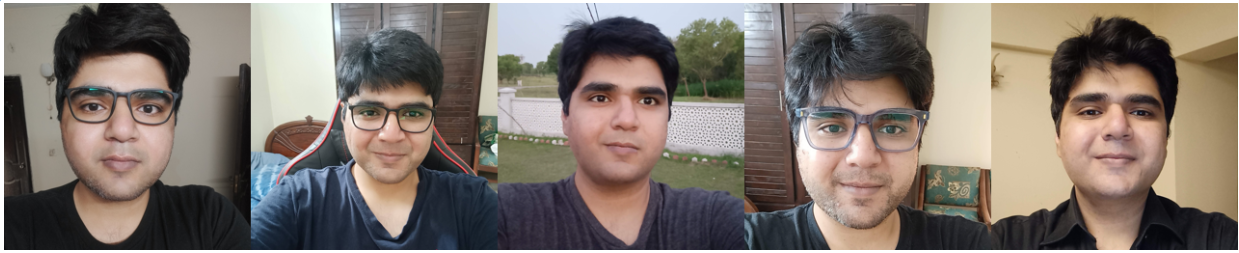
Jetzt stimmen wir unser Modell mit diesen fünf Bildern über das AutoTrain-DreamBooth-Skript fein ab.
!autotrain dreambooth \
--model $MODEL_NAME \
--project-name $PROJECT_NAME \
--image-path $DATA_DIR \
--prompt "A photo of Abid Ali Awan wearing casual clothes, taking a selfie, and smiling." \
--resolution 1024 \
--batch-size 1 \
--num-steps 500 \
--gradient-accumulation 4 \
--lr 1e-4 \
--fp16 \
--gradient-checkpointing \
--push-to-hub \
--token $HF_TOKEN \
--repo-id $REPO_ID
Das Training dauerte 2 Stunden und 15 Minuten, anschließend wurden die LoRA-Gewichte zu Hugging Face gepusht.
LoRA, kurz für Low-Rank Adaptation, fügt einem bestehenden Modell kleine trainierbare Schichten hinzu, ohne die Originalgewichte zu verändern.
Der Vorteil von LoRA: Neue Konzepte wie Stile, Figuren oder Themen lassen sich in das Modell integrieren, ohne große Rechenleistung oder viel Speicher zu benötigen.
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 14.49s/it, loss=0.119, lr=0.0001]Model weights saved in Dreambooth_SDXL/pytorch_lora_weights.safetensors
Steps: 100%|█████████| 500/500 [2:15:11<00:00, 16.22s/it, loss=0.119, lr=0.0001]
pytorch_lora_weights.safetensors: 100%|████| 23.4M/23.4M [00:01<00:00, 11.9MB/s]
Statt eine 7-GB-Modelldatei zu speichern, sichern wir einen 23,4-MB-LoRA-Adapter, der bei der Inferenz an das Basismodell angehängt wird.
Bild von kingabzpro/sdxl-lora-abid
Wir erstellen eine Diffusion-Pipeline zur Bildgenerierung mit einem angepassten VAE-Decoder und dem SDXL-Basismodell in FP16.
Anschließend laden wir die LoRA-Gewichte und hängen sie über unsere Hugging-Face-Repo-ID an das Basismodell an.
Zum Schluss lassen wir die Pipeline mit dem Prompt laufen und erzeugen drei Bilder.
from diffusers import DiffusionPipeline, AutoencoderKL, StableDiffusionXLImg2ImgPipeline

import torch

vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16
)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
)
pipe.to("cuda");
pipe.load_lora_weights(REPO_ID, weight_name="pytorch_lora_weights.safetensors")


prompt = "A photo of Abid Ali Awan participating in a marathon."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
Die Ergebnisse sind beeindruckend. Wir haben das Modell erfolgreich darauf trainiert, Bilder des Autors „Abid Ali Awan“ zu erzeugen.
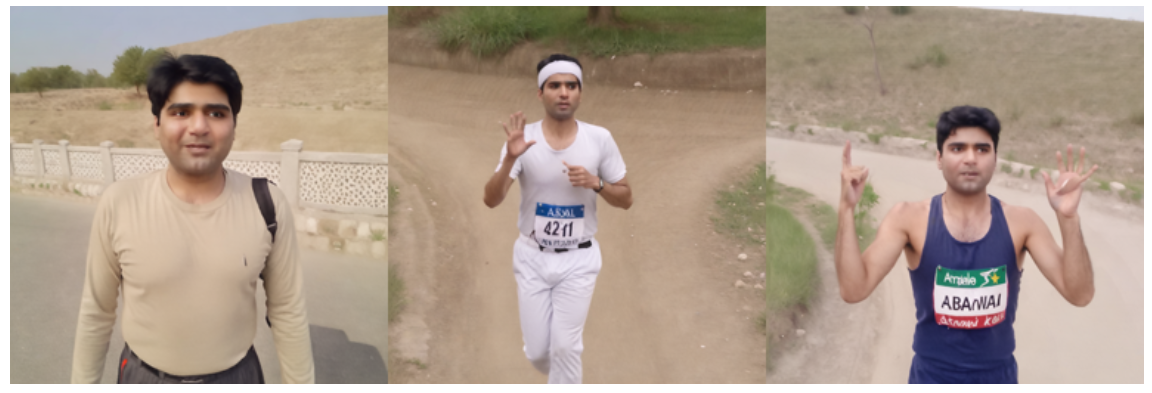
Versuchen wir es mit einem weiteren Prompt.
prompt = "A photo of Abid Ali Awan giving a press conference."

image = pipe(prompt=prompt, num_inference_steps=25, num_images_per_prompt = 3)
image_grid(image.images, 1, 3)
Auch hier sind die Resultate hervorragend.
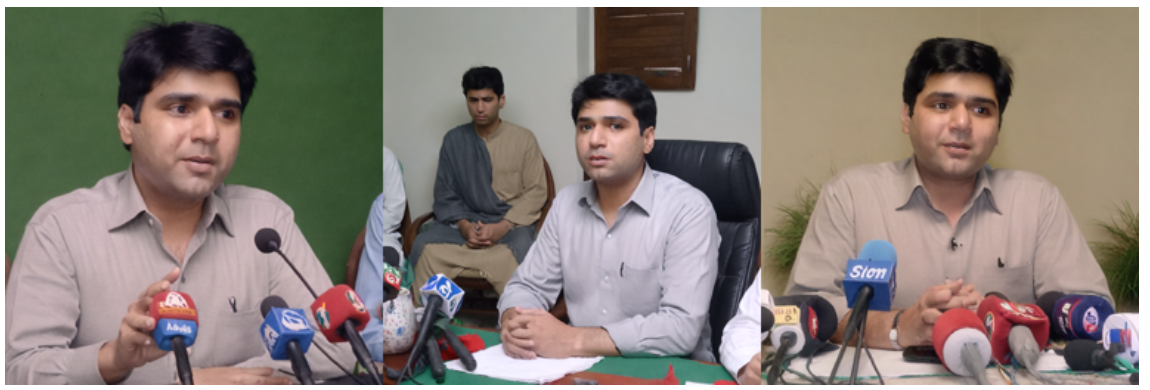
In diesem Abschnitt verbessern wir das generierte Bild mit dem SDXL Refiner 1.0.
Zuerst erzeugen wir das Bild mit der Stable-Diffusion-Pipeline und setzen eine manuelle Seed, um Reproduzierbarkeit sicherzustellen.
prompt = "A photo of Abid Ali Awan wearing a business suit at an office meeting."

seed = 65
generator = torch.Generator("cuda").manual_seed(seed)
image = pipe(prompt=prompt, num_inference_steps=25, generator=generator).images[0]
image.resize((300, 300))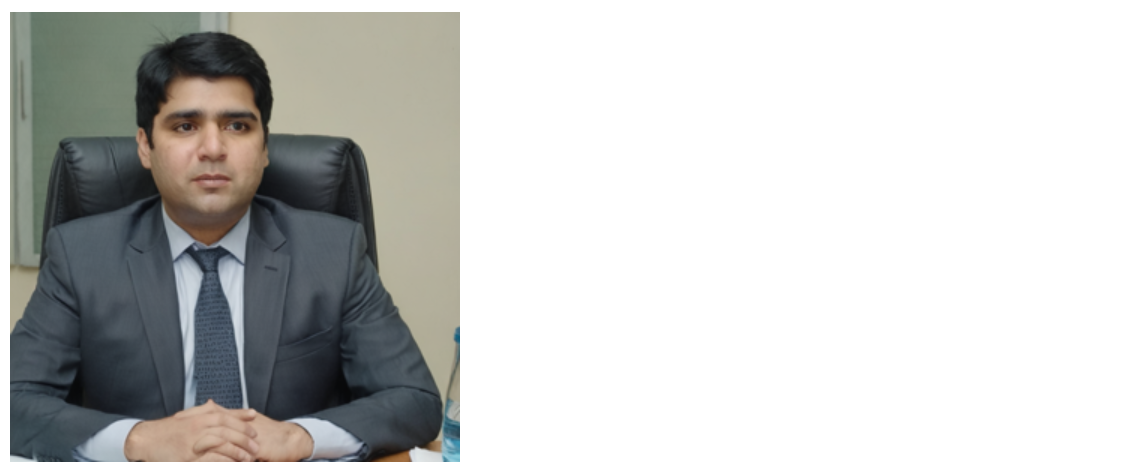
Als nächstes laden wir den SDXL Refiner und lassen die Refiner-Pipeline mit demselben Prompt, Generator und Bild laufen.
refiner = StableDiffusionXLImg2ImgPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    vae=vae,
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
)
refiner.to("cuda");

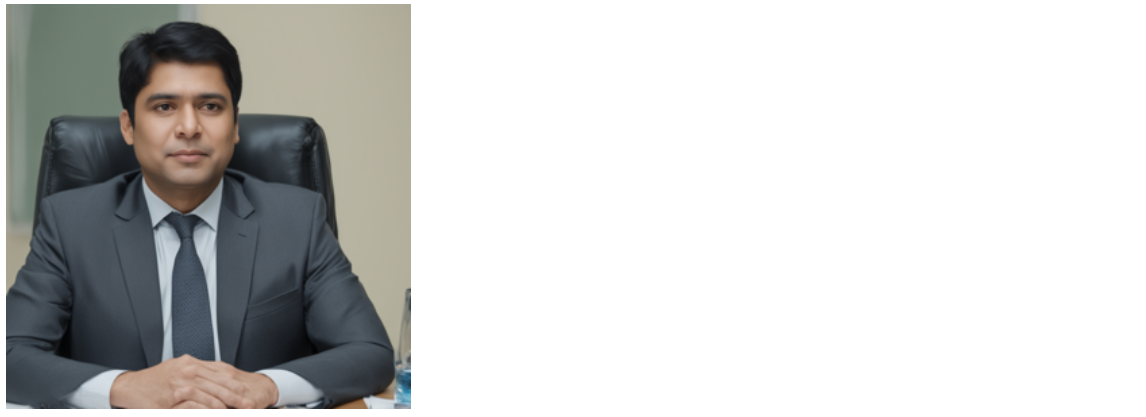
image = refiner(prompt=prompt, num_inference_steps=25, generator=generator, image=image)
image.images[0].resize((300, 300))
Der Refiner hat die Bildqualität verbessert, das Ergebnis ähnelt jedoch nicht mehr dem ursprünglichen Foto des Autors, sondern zeigt einen generischen Geschäftsmann aus Südasien. Für feinabgestimmte Modelle ist es möglicherweise besser, auf den Refiner zu verzichten.
Nach der Feinabstimmung des SDXL-Modells ist der nächste Schritt, eine Generative-AI-Anwendung zu bauen. Inspiration für dein Projekt findest du im Blog 5 Projects Built with Generative Models and Open Source Tools.
In diesem Tutorial hast du das Stable-Diffusion-XL-Modell und die DreamBooth-Technik kennengelernt. Zudem hast du gesehen, wie du Stable Diffusion XL mit dem DreamBooth-Skript von AutoTrain Advanced für personalisierte Bildgenerierung feinabstimmst.
Nach dem Laden des SDXL-Basismodells haben wir mit nur fünf Fotos des Autors einen schlanken LoRA-Adapter trainiert. Anschließend wurden die LoRA-Gewichte an das SDXL-Basismodell angehängt, sodass es hochwertige Bilder des Autors in verschiedensten erdachten Szenarien erzeugt — bei gleichzeitiger Beibehaltung der Fähigkeiten des vollständigen Modells mit mehreren Milliarden Parametern.
Der SDXL Refiner hebt zwar die Bildqualität an, war bei generischen Prompts am wirkungsvollsten und schien einen Teil der Personalisierung aus der Feinabstimmung zu überschreiben. Trotzdem zeigt das Tutorial, wie unkompliziert sich ein SDXL-Modell mit AutoTrain Advanced schon mit wenigen Bildern feinabstimmen lässt.
Wenn du neu in der KI-Welt bist und verstehen willst, worum sich der Hype dreht, empfehlen wir den Kurs AI Fundamentals. Dort lernst du Generative KI und große Sprachmodelle kennen. Außerdem kannst du mit dem Machine Learning Scientist with Python-Lernpfad deine Karriere im KI-Engineering starten. Dieses umfassende Programm führt dich in Natural Language Processing, Bildverarbeitung und verbreitete Python-ML-Packages wie scikit-learn, PySpark und Keras ein.
Starte heute deine KI-Reise!
Lernpfad
Lernpfad