
{count, plural, one {कोर्स} other {कोर्स}}
Google ADK के साथ AI एजेंट बनाना
{hours} घंटा
7.6K
Gemini 3 Pro वह अत्याधुनिक AI मॉडल है जिसका हम सभी इंतज़ार कर रहे थे—एक मिलियन टोकन का विशाल संदर्भ विंडो जो एक ही पास में डेटासेट, दस्तावेज़, वीडियो और कोडबेस को सरलता से संभाल लेता है। यह PhD-स्तरीय रीजनिंग देता है और पाठ, छवि, ऑडियो और वीडियो के मल्टीमोडल प्रोसेसिंग में उत्कृष्ट है, जिससे क्रिएटिव वर्कफ़्लो सहज बनते हैं।
इस प्रोजेक्ट-आधारित ट्यूटोरियल में, मैं आपको दिखाऊँगा कि Gemini 3 API का उपयोग करके मल्टी-एजेंट एप्लिकेशन कैसे बनाएँ जो उपयोगकर्ता द्वारा दिए गए CSV डेटासेट पर गहन डेटा एनालिटिक्स करें।
संक्षेप में, मल्टी-एजेंट ऐप यह कार्य करेगा:
यदि आप एजेंटिक AI वर्कफ़्लो बनाना और सीखना चाहते हैं, तो हमारा Google Antigravity गाइड, Gemini 3 Flash ट्यूटोरियल, और AI Agent Fundamentals स्किल ट्रैक देखें।
1. हमारी मल्टी-एजेंट ऐप के लिए सभी आवश्यक पैकेज इंस्टॉल करने हेतु यह कमांड चलाएँ:
!pip install -q google-genai langgraph langsmith grandalf pydantic pandas matplotlib markdown2 weasyprint markdown-it-py mdit-py-pluginsपैकेज विवरण:
नोट: हम यह प्रोजेक्ट बनाने के लिए Jupyter Notebook का उपयोग कर रहे हैं।
2. Google AI Studio पर जाएँ और अपना API कुंजी जेनरेट करें। सुनिश्चित करें कि आपके खाते पर बिलिंग सेटअप है, क्योंकि Gemini 3 Pro मॉडल फ्री टियर में उपलब्ध नहीं है।
3. इसके बाद, एक नि:शुल्क LangSmith खाता बनाएँ और API कुंजी जेनरेट करें।
4. दोनों API कुंजियों को अपने लोकल सिस्टम में environment variables के रूप में सहेजें। LANGSMITH_API_KEY और GEMINI_API_KEY सेट करें।
5. अपने नोटबुक में सभी आवश्यक Python पैकेज इम्पोर्ट करें:
from google import genai
from google.genai import types
from pydantic import BaseModel
from langgraph.graph import StateGraph, END
import os, json, textwrap, traceback
from pathlib import Path
import pandas as pd
import markdown2
import weasyprint
6. LangSmith प्रोजेक्ट नाम निर्दिष्ट करने और LangSmith ट्रैकिंग सक्षम करने के लिए environment variables सेट करें:
os.environ["LANGSMITH_TRACING"] = "true"
os.environ["LANGSMITH_API_KEY"] = os.environ.get("LANGSMITH_API_KEY", "YOUR_LANGSMITH_KEY")
os.environ["LANGSMITH_PROJECT"] = os.environ.get("LANGSMITH_PROJECT", "autolab-gemini3pro")
7. वह फ़ोल्डर बनाएँ जहाँ सभी छवियाँ और PDF सहेजे जाएँगे:
ARTIFACTS_DIR = Path("artifacts")
ARTIFACTS_DIR.mkdir(exist_ok=True)इस अनुभाग में, हम Gemini API क्लाइंट सेट करेंगे और मॉडल कॉल्स को इस तरह रैप करेंगे कि वे LangSmith में ट्रेस और लॉग हो सकें। साथ ही, हम टोकन उपयोग की मेटाडेटा निकालेंगे और उसे LangSmith‑फ्रेंडली फ़ॉर्मैट में लौटाएँगे।
पहले, हम API कुंजी देकर Gemini GenAI क्लाइंट इनिशियलाइज़ करेंगे:
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3-pro-preview"
इसके बाद, हम Gemini मॉडल कॉल के चारों ओर एक छोटा रैपर लिखेंगे ताकि LangSmith स्वतः ट्रेसिंग सक्षम हो। @traceable डेकोरेटर का उपयोग कर, हम फ़ंक्शन को एक LLM रन के रूप में रजिस्टर करते हैं।
इस फ़ंक्शन के भीतर, कोड प्रॉम्प्ट को Gemini को भेजेगा और टोकन उपयोग विवरण निकालेगा, जो सटीक LangSmith ट्रैकिंग के लिए आवश्यक हैं, और ट्रेसिंग दिशानिर्देशों का पालन करेगा।
अंत में, फ़ंक्शन मॉडल का टेक्स्ट आउटपुट, टोकन आँकड़ों और रॉ रिस्पॉन्स के साथ उस फ़ॉर्मैट में लौटाएगा जिसकी LangSmith अपेक्षा करता है, ताकि UI में रन सही ढंग से दिखे।
from langsmith import traceable
@traceable(name="gemini_generate_content", run_type="llm")
def gemini_call(prompt: str, thinking_level: str = "high"):
    """
    Gemini wrapper that:
    - uses correct ThinkingConfig schema
    - returns LangSmith LLM-run format so token usage shows in UI
    """
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            thinking_config=types.ThinkingConfig(thinking_level=thinking_level)
        ),
    )

    usage = getattr(resp, "usage_metadata", None)
    token_usage = None
    if usage:
        token_usage = {
            "prompt_tokens": usage.prompt_token_count,
            "completion_tokens": usage.candidates_token_count,
            "total_tokens": usage.total_token_count,
            "thoughts_tokens": getattr(usage, "thoughts_token_count", None),
        }

    return {
        "generations": [{"text": resp.text}],
        "llm_output": {
            "model_name": MODEL,
            "token_usage": token_usage,
        },
        "raw_response": resp,
}अब हम ऐसे टूल बनाएँगे जो डेटासेट निरीक्षण, सुरक्षित Python निष्पादन, और Markdown‑से‑PDF रिपोर्ट जनरेशन प्रदान करें—जिन्हें AI एजेंट वर्कफ़्लो के अंदर उपयोग किया जाएगा।
यह टूल एक फ़ाइल पथ लेता है, CSV को pandas DataFrame में पढ़ता है, और फिर सारांश बनाता है जिसमें डेटासेट का आकार, कॉलम नाम, प्रत्येक कॉलम का डेटा प्रकार, मिसिंग वैल्यू का प्रतिशत, शुरुआती पाँच पंक्तियाँ, और पूर्ण वर्णनात्मक आँकड़े शामिल होते हैं। यह सारांश लौटाया जाता है ताकि एजेंट डेटासेट को जल्दी समझ सके।
def load_dataset(path: str):
    df = pd.read_csv(path)

    summary = {
        "shape": df.shape,
        "columns": list(df.columns),
        "dtypes": {c: str(t) for c, t in df.dtypes.items()},
        "missing_pct": df.isna().mean().to_dict(),
        "head": df.head(5).to_dict(orient="records"),
        "describe": df.describe(include="all").fillna("").to_dict()
    }
return summaryयह टूल प्रतिबंधित वातावरण में डायनामिक रूप से जेनरेटेड Python कोड को सुरक्षित रूप से चलाता है। यह एक छोटा लोकल वातावरण तैयार करता है, फिर दिए गए कोड को exec के साथ निष्पादित करता है।
निष्पादित कोड से अपेक्षा होती है कि वह आर्टिफैक्ट पथ (जैसे सहेजे गए प्लॉट) और मेटाडेटा लौटाए।
def run_python(code: str):
    """
    Generated code MUST:
      - save plots to ARTIFACTS_DIR
      - collect paths in _artifacts (list[str])
      - collect meta in _charts_meta (list[dict])
      - optionally set _stdout (string)
    """
    local_env = {"ARTIFACTS_DIR": ARTIFACTS_DIR}
    try:
        exec(textwrap.dedent(code), {}, local_env)
        return {
            "ok": True,
            "stdout": local_env.get("_stdout", ""),
            "artifacts": local_env.get("_artifacts", []),
            "charts_meta": local_env.get("_charts_meta", []),
        }
    except Exception:
return {"ok": False, "traceback": traceback.format_exc()}यह टूल Markdown को सुंदर ढंग से फॉर्मैटेड PDF में बदलता है। यह पहले एक markdown पार्सर बनाता है जो टेबल, सूचियाँ, टास्क लिस्ट और फुटनोट का समर्थन करता है।
फिर render_pdf markdown टेक्स्ट को HTML में बदलता है, उसे कस्टम CSS‑स्टाइल्ड टेम्पलेट में रैप करता है (फ़ॉन्ट, टेबल की उपस्थिति, छवि आकार आदि नियंत्रित करता है), और WeasyPrint से PDF फ़ाइल जेनरेट करता है।
अंततः, यह PDF को आर्टिफैक्ट्स फ़ोल्डर में सहेज देता है और पथ लौटाता है।
from markdown_it import MarkdownIt
from mdit_py_plugins.tasklists import tasklists_plugin
from mdit_py_plugins.footnote import footnote_plugin

# Create a strong markdown parser once (supports tables, lists, etc.)
md = (
    MarkdownIt("commonmark", {"breaks": True, "html": True})
    .enable(["table", "strikethrough"])
    .use(tasklists_plugin)
    .use(footnote_plugin)
)

def render_pdf(markdown_text: str):
    """
    Better Markdown -> HTML -> PDF:
    - proper tables
    - stable lists
    - centered/small images
    - clean page breaks
    """
    html_body = md.render(markdown_text)

    html_template = f"""
    <html>
    <head>
      <meta charset="utf-8">
      <style>
        body {{
          font-family: Arial, sans-serif;
          font-size: 12px;
          line-height: 1.5;
          color: #111;
        }}

        h1 {{ font-size: 20px; margin-bottom: 6px; }}
        h2 {{ font-size: 16px; margin-top: 18px; margin-bottom: 6px; }}
        h3 {{ font-size: 13px; margin-top: 12px; margin-bottom: 4px; }}

        p {{ margin: 6px 0; }}

        ul, ol {{
          margin: 6px 0 6px 18px;
        }}
        li {{ margin: 2px 0; }}

        table {{
          width: 100%;
          border-collapse: collapse;
          margin: 8px 0 12px 0;
          font-size: 11px;
        }}
        th, td {{
          border: 1px solid #ccc;
          padding: 6px;
          text-align: left;
        }}
        th {{ background: #f2f2f2; }}

        img {{
          display: block;
          margin: 8px auto 8px auto;
          max-width: 70%;
          height: auto;
          page-break-inside: avoid;
        }}

        .chart-block {{
          page-break-inside: avoid;
          margin-bottom: 12px;
        }}

        code {{
          background: #f6f6f6;
          padding: 2px 4px;
          border-radius: 4px;
          font-size: 11px;
        }}
        pre code {{
          display: block;
          padding: 8px;
          overflow-x: auto;
        }}
      </style>
    </head>
    <body>
      {html_body}
    </body>
    </html>
    """

    pdf_path = ARTIFACTS_DIR / "report.pdf"
    weasyprint.HTML(
        string=html_template,
        base_url=str(ARTIFACTS_DIR.parent.resolve())
    ).write_pdf(str(pdf_path))

    return str(pdf_path)
यह केवल इन तीनों फ़ंक्शनों को एजेंट द्वारा उपयोग के लिए उपलब्ध टूल्स के रूप में रजिस्टर करता है।
TOOLS = [load_dataset, run_python, render_pdf]यह क्लास एक साझा state ऑब्जेक्ट परिभाषित करती है जो एजेंट वर्कफ़्लो द्वारा निर्मित सब कुछ रखता है: जैसे डेटासेट पथ, प्रोफाइलिंग जानकारी, जनरेट की गई योजना, कोड, निष्पादन परिणाम, इनसाइट्स और अंतिम रिपोर्ट—साथ ही अनंत लूप से बचने के लिए पुन: प्रयास सीमा और त्रुटि संदेश।
class State(BaseModel):
    dataset_path: str
    profile: dict | None = None
    plan: dict | None = None
    code: str | None = None
    exec_result: dict | None = None
    charts_meta: list | None = None
    insights: str | None = None
    report_md: str | None = None
    report_pdf: str | None = None

    retry_count: int = 0          # NEW: stop infinite loops
    last_error: str | None = None # NEW: pass traceback to coder

MAX_RETRIES = 2अब हम ऐसे AI एजेंट बनाएँगे जो मिलकर डेटासेट का प्रोफाइल बनाएँ, विश्लेषण कोड लिखें और चलाएँ, इनसाइट्स जनरेट करें, और अंतिम PDF रिपोर्ट तैयार करें।
यह एजेंट डेटासेट को समझने और एक संरचित विश्लेषण योजना बनाने के लिए ज़िम्मेदार है। यह पहले load_dataset टूल का उपयोग करके डेटासेट लोड करता है, जो उसे आकार, मिसिंग वैल्यू, कॉलम प्रकार, वर्णनात्मक आँकड़े और उदाहरण पंक्तियों सहित सारांश देता है।
फिर यह बहुत स्पष्ट निर्देशों के साथ यह डेटासेट सारांश LLM को भेजता है: कार्य प्रकार की पहचान करें, लागू होने पर एक लक्षित कॉलम चुनें, कौन से एक्सप्लोरेटरी स्टेप लेने हैं तय करें, कौन से चार्ट बनाए जाने चाहिए प्रस्तावित करें, और यदि डेटासेट क्लासिफिकेशन या रिग्रेशन सुझाता है तो किसी भी मॉडलिंग स्टेप की रूपरेखा दें।
LLM एक JSON संरचना लौटाता है जो इस योजना का प्रतिनिधित्व करती है, और एजेंट इसे पार्स करता है—यदि JSON पार्सिंग विफल होती है तो कच्चा टेक्स्ट सहेजने पर वापस गिरता है।
अंततः, यह डेटासेट प्रोफ़ाइल और जनरेट की गई योजना दोनों को साझा स्टेट में सहेजता है ताकि अगले एजेंट्स के पास आवश्यक सभी जानकारी हो।
@traceable(name="profiler_agent")
def profiler_agent(state: State):
    profile = load_dataset(state.dataset_path)

    prompt = f"""
    You are the Data Profiler Agent.
    Produce a JSON analysis plan with:
      - task_type: "classification"|"regression"|"eda_only"
      - target_column (if any)
      - eda_steps (list)
      - charts_to_make (list)  # 5-10 max, most informative
      - baseline_model_steps (list if modeling)
      - risks_or_data_issues (list)

    Dataset profile:
    {json.dumps(profile, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    text = resp["generations"][0]["text"]

    try:
        plan = json.loads(text)
    except:
        plan = {"raw_plan": text}

    state.profile = profile
    state.plan = plan
return stateयह एजेंट विश्लेषण योजना को निष्पादन योग्य Python कोड में बदलता है। इसे डेटासेट प्रोफ़ाइल, योजना और किसी भी पूर्व निष्पादन त्रुटि का संदर्भ मिलता है। इस पूरे संदर्भ का उपयोग करके, यह LLM से केवल Python कोड आउटपुट करने को कहता है।
प्रॉम्प्ट में सख्त आवश्यकताएँ शामिल हैं: डेटासेट लोड करें, योजना का ठीक-ठीक पालन करें, प्रत्येक निर्दिष्ट चार्ट जनरेट करें, प्लॉट्स को ARTIFACTS_DIR में सहेजें, पथ और चार्ट मेटाडेटा को ट्रैक करें, कंसोल आउटपुट कैप्चर करें, सहेजने के बाद फ़िगर्स बंद करें, और वैकल्पिक रूप से मॉडलिंग मेट्रिक्स की गणना करें।
यह सुनिश्चित करता है कि कोड सैंडबॉक्स में पुनरुत्पाद्य और सुरक्षित रहे। परिणाम state.code में संग्रहीत होता है, जिसे एग्जीक्यूटर चलाने को तैयार है।
@traceable(name="code_writer_agent")
def code_writer_agent(state: State):
    prompt = f"""
    You are the Code Writer Agent.
    Write Python code ONLY (no markdown).

    Previous error to fix (if any):
    {state.last_error}

    HARD REQUIREMENTS:
    1. Load dataset from: {state.dataset_path}
    2. Follow the plan exactly.
    3. Create ALL charts in charts_to_make.
    4. Save every chart in ARTIFACTS_DIR with filenames like:
         ARTIFACTS_DIR / "chart_01_<short_name>.png"
    5. Track saved plot paths in _artifacts (list[str]).
    6. Track chart metadata in _charts_meta (list[dict]) with:
         {{
           "title": "<human readable chart title>",
           "filename": "artifacts/chart_01_x.png",
           "description": "<what this plot shows (1-2 sentences)>",
           "one_liner": "<ONE line insight from the chart>"
         }}
       The one_liner MUST be a single sentence, max ~20 words.

    7. Store useful console output in _stdout.

    IMPORTANT:
    - import matplotlib.pyplot as plt
    - plt.close() after saving each plot
    - ensure _artifacts and _charts_meta exist even if empty
    - if modeling, add baseline metrics to _stdout

    Dataset profile:
    {json.dumps(state.profile, indent=2)}

    Analysis plan:
    {json.dumps(state.plan, indent=2)}

    Return ONLY executable python code.
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.code = resp["generations"][0]["text"]
return stateयह एजेंट Code Writer द्वारा तैयार Python कोड को पृथक run_python सैंडबॉक्स में चलाता है। यह निष्पादन परिणाम, चार्ट मेटाडेटा, स्टैंडर्ड आउटपुट और बने आर्टिफैक्ट्स कैप्चर करता है।
यदि कोड सफलतापूर्वक चलता है, तो परिणाम सहेजे जाते हैं और वर्कफ़्लो सामान्य रूप से आगे बढ़ता है। यदि यह विफल होता है, तो एजेंट रीट्राई काउंटर बढ़ाता है और ट्रेसबैक स्टोर करता है ताकि अगली कोशिश में Code Writer एजेंट त्रुटि सुधार सके।
MAX_RETRIES द्वारा लूप सीमित होने से, यह एजेंट अनंत साइक्लिंग रोकता है और स्व‑सुधार के लिए आवश्यक फ़ीडबैक सिग्नल प्रदान करता है।
@traceable(name="executor_agent")
def executor_agent(state: State):
    result = run_python(state.code)
    state.exec_result = result
    state.charts_meta = result.get("charts_meta", [])

    if not result["ok"]:
        state.retry_count += 1
        state.last_error = result.get("traceback", "Unknown error")

return stateयह एजेंट पूरे विश्लेषण की व्याख्या करता है। यह डेटासेट प्रोफ़ाइल, निष्पादन आउटपुट और चार्ट मेटाडेटा लेता है और मानव-पठनीय विश्लेषणात्मक इनसाइट्स तैयार करता है।
यह LLM को स्ट्रक्चर्ड इनसाइट्स जनरेट करने का निर्देश देता है: प्रत्येक चार्ट के लिए दो निष्कर्ष और एक जोखिम दें, फिर सीमित संख्या में ओवरऑल इनसाइट्स बनाएँ।
एजेंट को सुनिश्चित करना होता है कि कोई खाली बुलेट न हों, कोई दोहराव न हो, और इनसाइट्स डेटासेट‑विशिष्ट हों, सामान्य नहीं।
उत्पन्न इनसाइट रिपोर्ट state.insights में संग्रहीत होती है, जो अंतिम रिपोर्टिंग चरण के लिए इनपुट बनती है।
@traceable(name="insights_agent")
def insights_agent(state: State):
    prompt = f"""
    You are the Insights Agent.

    HARD REQUIREMENTS:
    - No empty bullets.
    - No repeated bullets.
    - Be specific to this dataset and these charts.
    - Output format:

      ### Chart Insights
      For each chart in charts_meta:
      - **<title>**
        - Takeaway 1 (one sentence)
        - Takeaway 2 (one sentence)
        - Caveat/Risk (one sentence)

      ### Overall Insights
      - 3-5 bullets max, each one sentence.

    Inputs:
    Profile:
    {json.dumps(state.profile, indent=2)}

    Execution result:
    {json.dumps(state.exec_result, indent=2)}

    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.insights = resp["generations"][0]["text"]
return stateयह अंतिम संश्लेषण एजेंट है। यह पूरी पाइपलाइन के आउटपुट—प्रोफ़ाइल, इनसाइट्स, चार्ट मेटाडेटा, निष्पादन लॉग—का उपयोग कर एक संपूर्ण, साफ़-सुथरी Markdown रिपोर्ट तैयार करता है।
प्रॉम्प्ट सख्त फ़ॉर्मैटिंग नियम लागू करता है: शीर्षक दोहराए नहीं जाएँ, स्पेसिंग सुसंगत हो, हर चार्ट को एक मानकीकृत HTML ब्लॉक में ठीक एक बार प्रदर्शित किया जाए, और इनसाइट्स साफ़ ढंग से एकीकृत हों।
जब Markdown तैयार हो जाता है, एजेंट render_pdf को कॉल करता है ताकि WeasyPrint का उपयोग करके उसे परिष्कृत PDF में बदला जा सके। Markdown और PDF पथ दोनों साझा स्टेट में सहेजे जाते हैं, जिससे विश्लेषण वर्कफ़्लो पूरा होता है।
@traceable(name="report_agent")
def report_agent(state: State):
    prompt = f"""
    You are the Report Agent.
    Create a neat Markdown report (HTML allowed).

    HARD REQUIREMENTS:
    - Do NOT repeat section titles or chart titles.
    - Do NOT output empty bullet points. If a bullet would be empty, skip it.
    - Keep spacing consistent: one blank line between sections.
    - Use charts_meta as the ONLY source of charts.
    - Include EVERY chart, exactly once, in the same order as charts_meta.
    - For each chart output EXACTLY this block:

      <div class="chart-block">
        <h3>Chart {{i}}: {{title}}</h3>
        <img src="{{filename}}" alt="{{title}}">
        <p><b>What it shows:</b> {{one_liner}}</p>
      </div>

      Where:
      - title, filename, one_liner come from charts_meta
      - one_liner must be ONE sentence, max ~20 words.

    Sections:
    1. Dataset Overview (short)
    2. Data Quality Notes (bullets)
    3. Exploratory Analysis (chart-by-chart blocks only, no extra chart titles)
    4. Modeling Results (if any; use a markdown table)
    5. Key Insights (use insights text)
    6. Recommendations / Next Steps (bullets)

    Inputs:
    Profile: {json.dumps(state.profile, indent=2)}
    Exec stdout: {state.exec_result.get("stdout","")}
    Exec ok: {state.exec_result.get("ok")}
    Traceback (if any): {state.exec_result.get("traceback","")}
    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    Insights:
    {state.insights}

    Return ONLY the Markdown report.
    """

    resp = gemini_call(prompt, thinking_level="low")
    state.report_md = resp["generations"][0]["text"]
    state.report_pdf = render_pdf(state.report_md)
return stateयह अंतिम चरण सभी एजेंट्स को एक स्टेट‑ड्रिवन ग्राफ़ में असेंबल करके संपूर्ण मल्टी‑एजेंट वर्कफ़्लो का निर्माण करता है।
एक साझा State मॉडल के साथ StateGraph बनाया जाता है, जिससे वर्कफ़्लो के आगे बढ़ने पर हर एजेंट उसी विकसित होते स्टेट ऑब्जेक्ट के साथ इंटरेक्ट करता है। प्रोफ़ाइलर, कोड राइटर, एग्जीक्यूटर, इनसाइट्स राइटर और रिपोर्ट बिल्डर जैसे प्रत्येक घटक को ग्राफ़ में अलग नोड के रूप में जोड़ा जाता है, जो पाइपलाइन के विशिष्ट चरण का प्रतिनिधित्व करता है।
वर्कफ़्लो हमेशा प्रोफ़ाइलर एजेंट से शुरू होता है, जिसे एंट्री पॉइंट नामित किया जाता है। यह सुनिश्चित करता है कि प्रक्रिया डेटासेट की गहन समझ और विश्लेषण योजना के निर्माण से शुरू हो।
एजेस प्रक्रिया के प्रवाह को परिभाषित करने के लिए स्थापित किए जाते हैं। प्रोफाइलिंग के बाद आउटपुट को कोड राइटर को भेजा जाता है, जो आगे एग्जीक्यूटर में फीड होता है। मुख्य लॉजिक एग्जीक्यूटर से कंडीशनल रूटिंग में निहित है।
एक हेल्पर फ़ंक्शन, retry_or_continue, निष्पादन परिणाम की जाँच करता है। यदि कोड सफलतापूर्वक निष्पादित होता है, तो वर्कफ़्लो इनसाइट्स एजेंट पर आगे बढ़ता है।
यदि यह विफल होता है लेकिन रीट्राई उपलब्ध हैं, तो यह स्वतः-सुधार के लिए कोड राइटर पर वापस लूप करता है।
यदि कोई रीट्राई शेष नहीं है, तो यह आगे के विश्लेषण को बायपास करता है और सीधे रिपोर्ट जेनरेटर पर चला जाता है, जिससे सिस्टम अंतहीन लूप में प्रवेश न करे। कंडीशनल एजेस एग्जीक्यूटर नोड में शामिल किए जाते हैं ताकि निष्पादन की सफलता या विफलता के आधार पर वर्कफ़्लो अनुकूलित हो सके।
अंत में, ग्राफ़ इनसाइट्स चरण को रिपोर्ट चरण से जोड़ता है, और रिपोर्ट चरण से वर्कफ़्लो के समापन तक। फिर ग्राफ़ को एक निष्पादन योग्य संरचना में कम्पाइल किया जाता है, और फ्लो को विज़ुअलाइज़ करने के लिए एक ASCII डायग्राम जेनरेट किया जाता है।
यह मल्टी‑एजेंट ग्राफ़ पूरे अनुकूली विश्लेषण पाइपलाइन का ऑर्केस्ट्रेशन करता है, त्रुटि रिकवरी, चरण-दर-चरण समन्वय, और एजेंट्स के बीच सहज संक्रमण सक्षम करता है।
g = StateGraph(State)

g.add_node("profiler", profiler_agent)
g.add_node("code_writer", code_writer_agent)
g.add_node("executor", executor_agent)
g.add_node("insights", insights_agent)
g.add_node("report", report_agent)

g.set_entry_point("profiler")
g.add_edge("profiler", "code_writer")
g.add_edge("code_writer", "executor")

def retry_or_continue(state: State):
    # success path
    if state.exec_result and state.exec_result.get("ok"):
        return "insights"
    # stop retrying after MAX_RETRIES
    if state.retry_count >= MAX_RETRIES:
        return "report"
    return "code_writer"

g.add_conditional_edges(
    "executor",
    retry_or_continue,
    {"code_writer": "code_writer", "insights": "insights", "report": "report"}
)

g.add_edge("insights", "report")
g.add_edge("report", END)

graph = g.compile()

print(graph.get_graph().draw_ascii())
+-----------+
| __start__ |
+-----------+
*
*
*
+----------+
| profiler |
+----------+
*
*
*
+-------------+
| code_writer |
+-------------+
.
.
.
+----------+
| executor |
+----------+
.. ..
.. ..
. ..
+----------+ .
| insights | ..
+----------+ ..
** ..
** ..
* .
+--------+
| report |
+--------+
*
*
*
+---------+
| __end__ |
+---------+ पूरी पाइपलाइन चलाने के लिए, आप बस एक डेटासेट पथ दें, प्रारंभिक State ऑब्जेक्ट बनाएँ, और कम्पाइल किए गए ग्राफ़ को इनवोक करें। हमारे मामले में, हम Boston Housing डेटासेट दे रहे हैं।
DATASET_PATH = "/work/housing.csv"  # <-- change this

state = State(dataset_path=DATASET_PATH)
out = graph.invoke(state)
इनवोक करने पर, मल्टी‑एजेंट सिस्टम स्वतः संपूर्ण विश्लेषण करता है: डेटासेट का प्रोफाइलिंग, योजना जनरेट करना, Python कोड लिखना और चलाना, इनसाइट्स निकालना, और Markdown व PDF रिपोर्ट दोनों तैयार करना।
--- Modeling Baseline Results ---
Dataset Shape: (489, 4)
Linear Regression -> RMSE: 82,395.54, R2: 0.6911
Random Forest     -> RMSE: 56,931.38, R2: 0.8525
Observations: Random Forest typically outperforms Linear Regression due to capturing non-linear relationships (e.g., LSTAT).
रन पूरा होने के बाद, आप अपना LangSmith डैशबोर्ड खोलकर “autolab-gemini3pro” प्रोजेक्ट पर जा सकते हैं। हर एजेंट रन वहाँ दिखेगा।
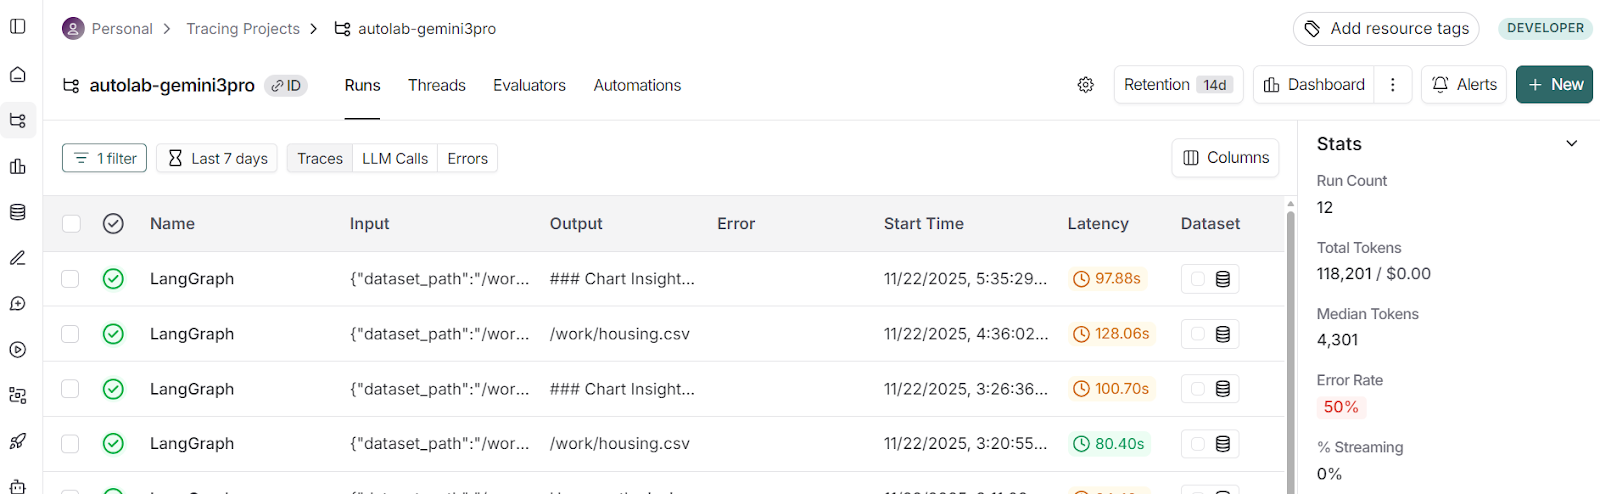
हाल के रन पर क्लिक करके Waterfall दृश्य में स्विच करने पर प्रत्येक चरण की टाइमलाइन दिखती है: एजेंट्स ने कितना समय लिया और कौन से टूल्स उपयोग किए।

आप किसी भी एजेंट में जाकर यह जाँच सकते हैं:
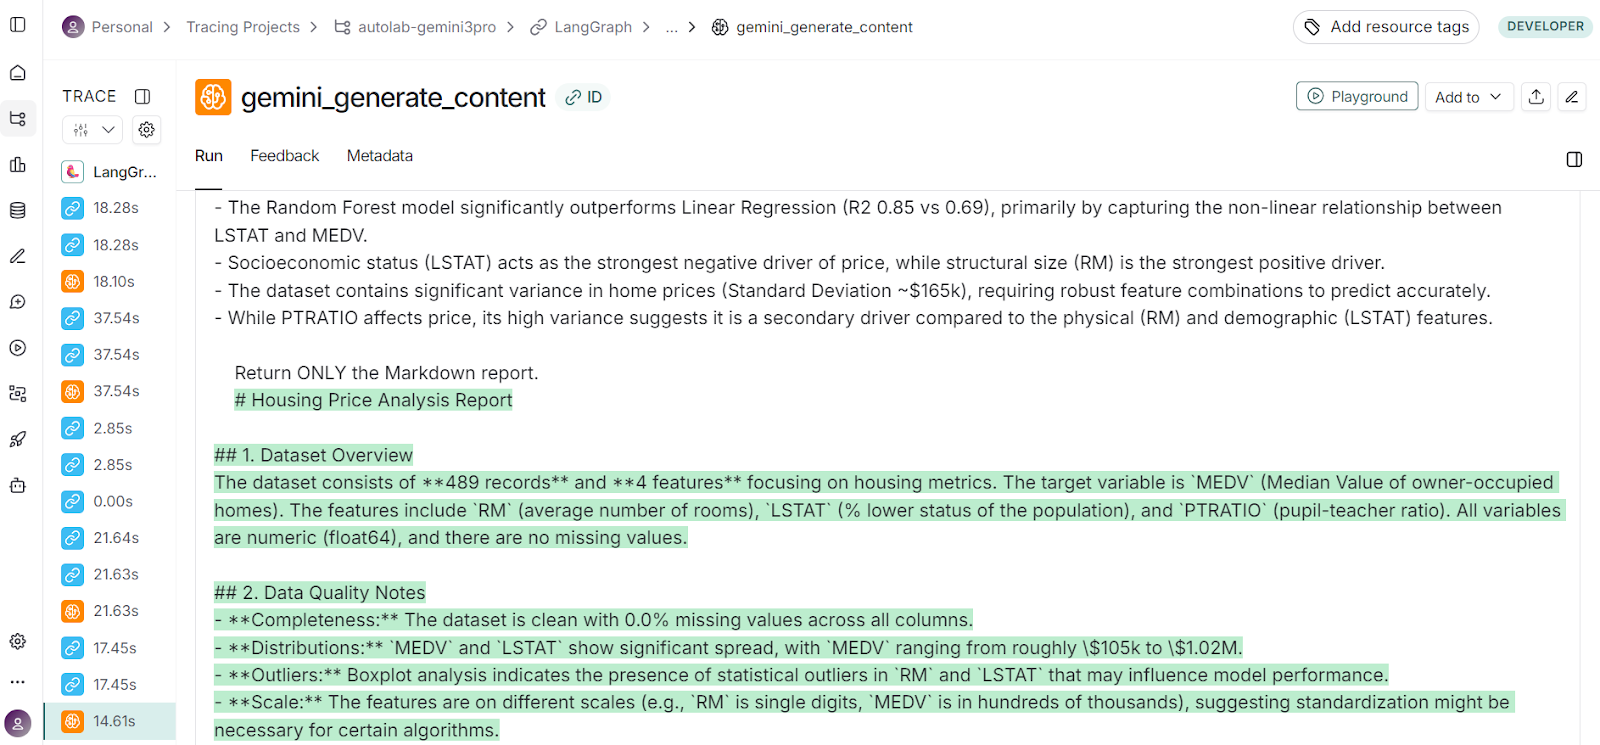
LangSmith पूरे वर्कफ़्लो को बेहतर बनाने में बेहद सहायक रहा। जो आप देख रहे हैं वह अंतिम संस्करण है, लेकिन इस प्रोजेक्ट को सही बनाने में कई प्रयास लगे, और LangSmith ने एजेंट्स में समस्याएँ डिबग करने में मेरी मदद की।
मल्टी‑एजेंट वर्कफ़्लो पूरा होने के बाद, आप सीधे अपने नोटबुक में जनरेट की गई Markdown रिपोर्ट देख सकते हैं।
Markdown संस्करण विश्लेषण को जल्दी रिव्यू करने, इनसाइट्स पढ़ने और अपने वर्कस्पेस छोड़े बिना रिपोर्ट संरचना देखने के लिए उपयोगी है।
print(out["report_md"][:2000])# Housing Price Analysis Report
## 1. Dataset Overview
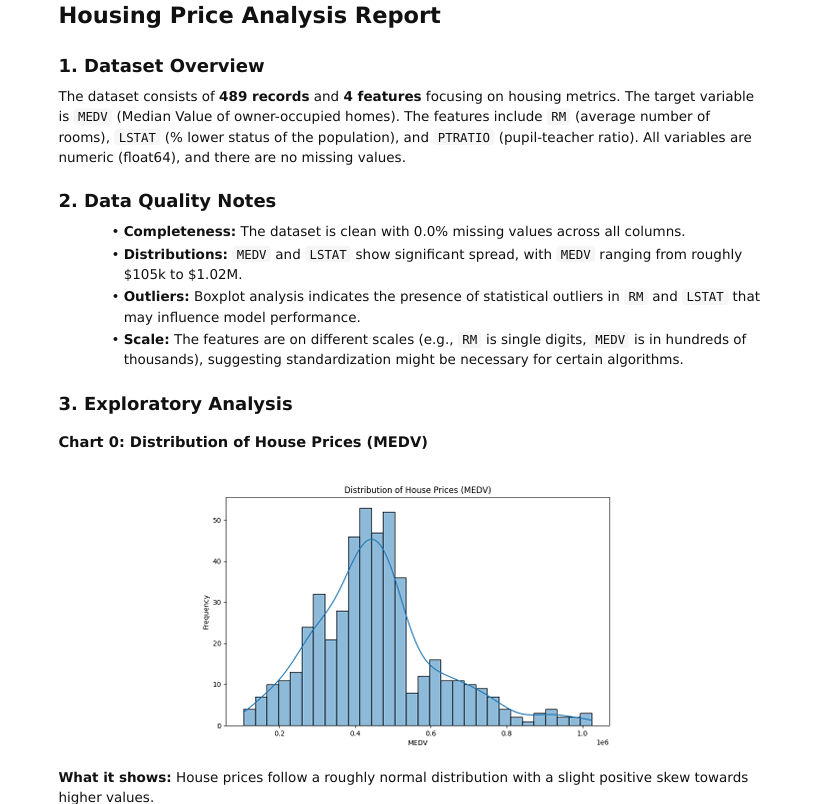
The dataset consists of **489 records** and **4 features** focusing on housing metrics. The target variable is `MEDV` (Median Value of owner-occupied homes). The features include `RM` (average number of rooms), `LSTAT.............Markdown के अलावा, वर्कफ़्लो एक परिष्कृत PDF रिपोर्ट भी बनाता है। PDF स्वचालित रूप से आर्टिफैक्ट्स फ़ोल्डर में सहेजा जाता है, और आप पथ इस तरह देख सकते हैं:
print("PDF saved at:", out["report_pdf"])PDF saved at: artifacts/report.pdfजनरेटेड PDF बेहतरीन है और विश्लेषण के सभी प्रमुख घटक समेटता है: कथात्मक व्याख्याएँ, विज़ुअल रूप से रेंडर किए गए चार्ट, चार्ट की व्याख्याएँ, मॉडलिंग सारांश, और अंतिम सिफ़ारिशें।
यह टीममेट्स, सुपरवाइज़र्स या क्लाइंट्स के साथ साझा करने के लिए आदर्श है—विशेषकर जब आपको परिणामों का एक साफ़, प्रेजेंटेशन‑रेडी संस्करण चाहिए।
इस प्रोजेक्ट पर काम करते हुए यह स्पष्ट हुआ कि आधुनिक AI मॉडल और ग्राफ‑आधारित एजेंट वर्कफ़्लो कितने आगे बढ़ चुके हैं। कुछ समय पहले तक, कई टूल वाले एक अकेले एजेंट को बनाना भी कई दिनों की ट्यूनिंग, डिबगिंग और अनिश्चित व्यवहारों से जूझने जैसा था।
आज, Gemini 3 Pro जैसे मॉडलों के साथ, सिस्टम डेटासेट को समझ सकता है, सटीक कोड जनरेट कर सकता है, विश्लेषण चला सकता है, विज़ुअलाइज़ेशन की व्याख्या कर सकता है, और उल्लेखनीय विश्वसनीयता के साथ एक परिष्कृत रिपोर्ट असेंबल कर सकता है।
इस प्रोजेक्ट में, हमने एक संपूर्ण मल्टी‑एजेंट डेटा‑विश्लेषण एप्लिकेशन बनाया है जो किसी भी CSV डेटासेट को लेकर एंड‑टू‑एंड एक्सप्लोरेटरी विश्लेषण करता है, बेसलाइन मॉडल चलाता है, इनसाइट्स जनरेट करता है, और पूरी तरह फ़ॉर्मैटेड PDF रिपोर्ट बनाता है।
यह प्रोजेक्ट पाँच समन्वित एजेंट्स का उपयोग करता है: प्रोफाइलिंग और प्लानिंग, कोड जनरेशन, रीट्राई के साथ निष्पादन, इनसाइट्स जनरेशन, और रिपोर्टिंग—और तीन कोर टूल्स डेटासेट लोडिंग, सुरक्षित कोड निष्पादन, और Markdown‑से‑PDF रेंडरिंग।
परिणाम एक साफ़, स्वचालित विश्लेषण प्रवाह है जो विज़ुअलाइज़ेशन द्वारा समर्थित प्रोफ़ेशनल, नैरेटिव‑ड्रिवन रिपोर्ट तैयार करता है।
शीर्ष DataCamp पाठ्यक्रम
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}