
Kurs
KI-Agenten mit dem Google ADK entwickeln
1 Std.
7.5K
Gemini 3 Pro ist das KI-Spitzenmodell, auf das wir gewartet haben: mit einem riesigen Kontextfenster von einer Million Tokens, das Datasets, Dokumente, Videos und Codebasen mühelos in einem Durchlauf verarbeitet. Es liefert Argumentationen auf Promotionsniveau und glänzt bei der multimodalen Verarbeitung von Text, Bildern, Audio und Video für nahtlose kreative Workflows.
In diesem praxisorientierten Tutorial zeige ich dir, wie du die Gemini 3 API nutzt, um Multi-Agent‑Anwendungen zu bauen, die ein vom Nutzer bereitgestelltes CSV‑Dataset verwenden und tiefgehende Datenanalysen durchführen.
Kurz gesagt, die Multi‑Agent‑App führt Folgendes aus:
Wenn du mehr über agentische KI‑Workflows lernen willst, schau dir unseren Guide zu Google Antigravity, das Gemini 3 Flash‑Tutorial und den AI Agent Fundamentals Lernpfad an.
1. Führe diesen Befehl aus, um alle benötigten Pakete für unsere Multi‑Agent‑App zu installieren:
!pip install -q google-genai langgraph langsmith grandalf pydantic pandas matplotlib markdown2 weasyprint markdown-it-py mdit-py-pluginsPakete im Überblick:
Hinweis: Wir bauen dieses Projekt in einem Jupyter Notebook.
2. Gehe zu Google AI Studio und erstelle deinen API‑Schlüssel. Stelle sicher, dass das Billing in deinem Konto aktiviert ist, da das Gemini 3 Pro‑Modell nicht in der Free‑Tier enthalten ist.
3. Lege als Nächstes einen kostenlosen LangSmith‑Account an und generiere den API‑Schlüssel.
4. Speichere beide API‑Schlüssel als Umgebungsvariablen in deinem lokalen System. Setze LANGSMITH_API_KEY und GEMINI_API_KEY.
5. Importiere alle benötigten Python‑Pakete in deinem Notebook:
from google import genai
from google.genai import types
from pydantic import BaseModel
from langgraph.graph import StateGraph, END
import os, json, textwrap, traceback
from pathlib import Path
import pandas as pd
import markdown2
import weasyprint
6. Setze die Umgebungsvariablen, um den LangSmith‑Projektnamen festzulegen und das Tracking zu aktivieren:
os.environ["LANGSMITH_TRACING"] = "true"
os.environ["LANGSMITH_API_KEY"] = os.environ.get("LANGSMITH_API_KEY", "YOUR_LANGSMITH_KEY")
os.environ["LANGSMITH_PROJECT"] = os.environ.get("LANGSMITH_PROJECT", "autolab-gemini3pro")
7. Erstelle den Ordner, in dem alle Bilder und PDFs gespeichert werden:
ARTIFACTS_DIR = Path("artifacts")
ARTIFACTS_DIR.mkdir(exist_ok=True)In diesem Abschnitt richten wir einen Gemini API‑Client ein und kapseln Modellaufrufe, damit sie in LangSmith nachverfolgt und geloggt werden. Zusätzlich extrahieren wir Metadaten zur Token‑Nutzung und geben sie in einem LangSmith‑kompatiblen Format zurück.
Zuerst initialisieren wir den Gemini GenAI‑Client, indem wir den API‑Schlüssel angeben:
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3-pro-preview"
Als Nächstes schreiben wir einen kleinen Wrapper um den Aufruf eines Gemini‑Modells, um automatisches Tracing durch LangSmith zu aktivieren. Mit dem @traceable‑Decorator registrieren wir die Funktion als LLM‑Run.
Innerhalb der Funktion sendet der Code den Prompt an Gemini und extrahiert Details zur Token‑Nutzung. Diese sind essenziell für präzises LangSmith‑Tracking gemäß den Tracing‑Richtlinien.
Abschließend gibt die Funktion die Textausgabe des Modells zusammen mit Token‑Statistiken und der Rohantwort in dem von LangSmith erwarteten Format zurück, sodass der Run korrekt in der UI angezeigt wird.
from langsmith import traceable
@traceable(name="gemini_generate_content", run_type="llm")
def gemini_call(prompt: str, thinking_level: str = "high"):
    """
    Gemini wrapper that:
    - uses correct ThinkingConfig schema
    - returns LangSmith LLM-run format so token usage shows in UI
    """
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            thinking_config=types.ThinkingConfig(thinking_level=thinking_level)
        ),
    )

    usage = getattr(resp, "usage_metadata", None)
    token_usage = None
    if usage:
        token_usage = {
            "prompt_tokens": usage.prompt_token_count,
            "completion_tokens": usage.candidates_token_count,
            "total_tokens": usage.total_token_count,
            "thoughts_tokens": getattr(usage, "thoughts_token_count", None),
        }

    return {
        "generations": [{"text": resp.text}],
        "llm_output": {
            "model_name": MODEL,
            "token_usage": token_usage,
        },
        "raw_response": resp,
}Jetzt erstellen wir Tools für Dataset‑Inspektion, sichere Python‑Ausführung und Markdown‑zu‑PDF‑Reporting, die innerhalb eines KI‑Agent‑Workflows genutzt werden.
Dieses Tool nimmt einen Dateipfad, liest die CSV in ein pandas‑DataFrame und erstellt dann eine Zusammenfassung mit Dataset‑Form, Spaltennamen, Datentyp jeder Spalte, Anteilen fehlender Werte, den ersten fünf Zeilen und vollständigen beschreibenden Statistiken. Es gibt die Zusammenfassung zurück, damit ein Agent das Dataset schnell versteht.
def load_dataset(path: str):
    df = pd.read_csv(path)

    summary = {
        "shape": df.shape,
        "columns": list(df.columns),
        "dtypes": {c: str(t) for c, t in df.dtypes.items()},
        "missing_pct": df.isna().mean().to_dict(),
        "head": df.head(5).to_dict(orient="records"),
        "describe": df.describe(include="all").fillna("").to_dict()
    }
return summaryDieses Tool führt dynamisch generierten Python‑Code sicher in einer eingeschränkten Umgebung aus. Es bereitet ein kleines lokales Environment vor und führt den bereitgestellten Code dann mit exec aus.
Der ausgeführte Code soll Pfade zu Artefakten (z. B. gespeicherte Plots) und Metadaten zurückgeben.
def run_python(code: str):
    """
    Generated code MUST:
      - save plots to ARTIFACTS_DIR
      - collect paths in _artifacts (list[str])
      - collect meta in _charts_meta (list[dict])
      - optionally set _stdout (string)
    """
    local_env = {"ARTIFACTS_DIR": ARTIFACTS_DIR}
    try:
        exec(textwrap.dedent(code), {}, local_env)
        return {
            "ok": True,
            "stdout": local_env.get("_stdout", ""),
            "artifacts": local_env.get("_artifacts", []),
            "charts_meta": local_env.get("_charts_meta", []),
        }
    except Exception:
return {"ok": False, "traceback": traceback.format_exc()}Dieses Tool wandelt Markdown in ein ansprechend formatiertes PDF um. Zuerst wird ein Markdown‑Parser erstellt, der Tabellen, Listen, Aufgabenlisten und Fußnoten unterstützt.
Dann konvertiert render_pdf den Markdown‑Text in HTML, bettet ihn in ein Template mit benutzerdefiniertem CSS (Schriftarten, Tabellendarstellung, Bildgrößen etc.) und erzeugt mit WeasyPrint eine PDF‑Datei.
Abschließend wird das PDF im Artefakte‑Ordner gespeichert und der Pfad zurückgegeben.
from markdown_it import MarkdownIt
from mdit_py_plugins.tasklists import tasklists_plugin
from mdit_py_plugins.footnote import footnote_plugin

# Create a strong markdown parser once (supports tables, lists, etc.)
md = (
    MarkdownIt("commonmark", {"breaks": True, "html": True})
    .enable(["table", "strikethrough"])
    .use(tasklists_plugin)
    .use(footnote_plugin)
)

def render_pdf(markdown_text: str):
    """
    Better Markdown -> HTML -> PDF:
    - proper tables
    - stable lists
    - centered/small images
    - clean page breaks
    """
    html_body = md.render(markdown_text)

    html_template = f"""
    <html>
    <head>
      <meta charset="utf-8">
      <style>
        body {{
          font-family: Arial, sans-serif;
          font-size: 12px;
          line-height: 1.5;
          color: #111;
        }}

        h1 {{ font-size: 20px; margin-bottom: 6px; }}
        h2 {{ font-size: 16px; margin-top: 18px; margin-bottom: 6px; }}
        h3 {{ font-size: 13px; margin-top: 12px; margin-bottom: 4px; }}

        p {{ margin: 6px 0; }}

        ul, ol {{
          margin: 6px 0 6px 18px;
        }}
        li {{ margin: 2px 0; }}

        table {{
          width: 100%;
          border-collapse: collapse;
          margin: 8px 0 12px 0;
          font-size: 11px;
        }}
        th, td {{
          border: 1px solid #ccc;
          padding: 6px;
          text-align: left;
        }}
        th {{ background: #f2f2f2; }}

        img {{
          display: block;
          margin: 8px auto 8px auto;
          max-width: 70%;
          height: auto;
          page-break-inside: avoid;
        }}

        .chart-block {{
          page-break-inside: avoid;
          margin-bottom: 12px;
        }}

        code {{
          background: #f6f6f6;
          padding: 2px 4px;
          border-radius: 4px;
          font-size: 11px;
        }}
        pre code {{
          display: block;
          padding: 8px;
          overflow-x: auto;
        }}
      </style>
    </head>
    <body>
      {html_body}
    </body>
    </html>
    """

    pdf_path = ARTIFACTS_DIR / "report.pdf"
    weasyprint.HTML(
        string=html_template,
        base_url=str(ARTIFACTS_DIR.parent.resolve())
    ).write_pdf(str(pdf_path))

    return str(pdf_path)
Damit registrieren wir einfach alle drei Funktionen als Tools, die der Agent verwenden kann.
TOOLS = [load_dataset, run_python, render_pdf]Diese Klasse definiert ein gemeinsames state‑Objekt, das alles enthält, was der Agent‑Workflow produziert: z. B. den Dataset‑Pfad, Profiling‑Infos, den erzeugten Plan, Code, Ausführungsergebnisse, Insights und den finalen Report sowie Retry‑Limits und Fehlermeldungen, um Endlosschleifen zu verhindern.
class State(BaseModel):
    dataset_path: str
    profile: dict | None = None
    plan: dict | None = None
    code: str | None = None
    exec_result: dict | None = None
    charts_meta: list | None = None
    insights: str | None = None
    report_md: str | None = None
    report_pdf: str | None = None

    retry_count: int = 0          # NEW: stop infinite loops
    last_error: str | None = None # NEW: pass traceback to coder

MAX_RETRIES = 2Jetzt erstellen wir KI‑Agenten, die gemeinsam das Dataset profilieren, Analyse‑Code schreiben und ausführen, Insights generieren und einen finalen PDF‑Report produzieren.
Dieser Agent versteht das Dataset und erstellt einen strukturierten Analyseplan. Er lädt zuerst das Dataset mit dem Tool load_dataset, das eine Zusammenfassung mit Form, fehlenden Werten, Spaltentypen, beschreibenden Statistiken und Beispielzeilen liefert.
Dann sendet er diese Dataset‑Zusammenfassung mit sehr klaren Anweisungen an das LLM: Aufgabentyp bestimmen, ggf. eine Zielspalte wählen, geeignete Explorationsschritte festlegen, die zu erstellenden Diagramme vorschlagen und Modellierungsschritte skizzieren, falls das Dataset auf Klassifikation oder Regression hindeutet.
Das LLM gibt eine JSON‑Struktur als Plan zurück. Der Agent parst sie und fällt bei Fehlern auf den Rohtext zurück.
Zum Schluss speichert er sowohl das Dataset‑Profil als auch den Plan im gemeinsamen State, damit die nächsten Agenten alle Informationen parat haben.
@traceable(name="profiler_agent")
def profiler_agent(state: State):
    profile = load_dataset(state.dataset_path)

    prompt = f"""
    You are the Data Profiler Agent.
    Produce a JSON analysis plan with:
      - task_type: "classification"|"regression"|"eda_only"
      - target_column (if any)
      - eda_steps (list)
      - charts_to_make (list)  # 5-10 max, most informative
      - baseline_model_steps (list if modeling)
      - risks_or_data_issues (list)

    Dataset profile:
    {json.dumps(profile, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    text = resp["generations"][0]["text"]

    try:
        plan = json.loads(text)
    except:
        plan = {"raw_plan": text}

    state.profile = profile
    state.plan = plan
return stateDieser Agent übersetzt den Analyseplan in ausführbaren Python‑Code. Er erhält das Dataset‑Profil, den Plan und ggf. den letzten Ausführungsfehler. Mit diesem Kontext weist er das LLM an, ausschließlich Python‑Code auszugeben.
Der Prompt enthält strikte Vorgaben: Dataset laden, Plan exakt befolgen, jedes angegebene Diagramm erzeugen, Plots in ARTIFACTS_DIR speichern, Pfade und Chart‑Metadaten tracken, Konsolenausgaben erfassen, Figuren nach dem Speichern schließen und optional Modellmetriken berechnen.
So ist der Code reproduzierbar und in der Sandbox sicher. Das Ergebnis wird in state.code gespeichert und steht für die Ausführung bereit.
@traceable(name="code_writer_agent")
def code_writer_agent(state: State):
    prompt = f"""
    You are the Code Writer Agent.
    Write Python code ONLY (no markdown).

    Previous error to fix (if any):
    {state.last_error}

    HARD REQUIREMENTS:
    1. Load dataset from: {state.dataset_path}
    2. Follow the plan exactly.
    3. Create ALL charts in charts_to_make.
    4. Save every chart in ARTIFACTS_DIR with filenames like:
         ARTIFACTS_DIR / "chart_01_<short_name>.png"
    5. Track saved plot paths in _artifacts (list[str]).
    6. Track chart metadata in _charts_meta (list[dict]) with:
         {{
           "title": "<human readable chart title>",
           "filename": "artifacts/chart_01_x.png",
           "description": "<what this plot shows (1-2 sentences)>",
           "one_liner": "<ONE line insight from the chart>"
         }}
       The one_liner MUST be a single sentence, max ~20 words.

    7. Store useful console output in _stdout.

    IMPORTANT:
    - import matplotlib.pyplot as plt
    - plt.close() after saving each plot
    - ensure _artifacts and _charts_meta exist even if empty
    - if modeling, add baseline metrics to _stdout

    Dataset profile:
    {json.dumps(state.profile, indent=2)}

    Analysis plan:
    {json.dumps(state.plan, indent=2)}

    Return ONLY executable python code.
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.code = resp["generations"][0]["text"]
return stateDieser Agent führt den vom Code‑Schreiber erzeugten Python‑Code in der isolierten run_python‑Sandbox aus. Er erfasst Ausführungsergebnisse, Chart‑Metadaten, Standardausgabe und erzeugte Artefakte.
Läuft der Code erfolgreich, werden die Ergebnisse gespeichert und der Workflow läuft normal weiter. Bei Fehlern erhöht der Agent den Retry‑Zähler und speichert das Traceback, damit der Code‑Schreiber den Fehler im nächsten Versuch beheben kann.
Mit MAX_RETRIES als Limit verhindert der Agent Endlosschleifen und liefert die nötigen Feedback‑Signale zur Selbstkorrektur.
@traceable(name="executor_agent")
def executor_agent(state: State):
    result = run_python(state.code)
    state.exec_result = result
    state.charts_meta = result.get("charts_meta", [])

    if not result["ok"]:
        state.retry_count += 1
        state.last_error = result.get("traceback", "Unknown error")

return stateDieser Agent interpretiert die gesamte Analyse. Er nimmt das Dataset‑Profil, die Ausgabedaten der Ausführung und die Chart‑Metadaten und erstellt verständliche analytische Insights.
Das LLM wird angewiesen, strukturierte Insights zu erzeugen: Für jedes Diagramm zwei Take‑aways und ein Risiko, dazu eine begrenzte Zahl übergeordneter Erkenntnisse.
Der Agent stellt sicher: keine leeren Bulletpoints, keine Wiederholungen, und die Insights sind datensatzspezifisch statt generisch.
Der entstehende Insight‑Bericht wird in state.insights gespeichert und dient als Input für das finale Reporting.
@traceable(name="insights_agent")
def insights_agent(state: State):
    prompt = f"""
    You are the Insights Agent.

    HARD REQUIREMENTS:
    - No empty bullets.
    - No repeated bullets.
    - Be specific to this dataset and these charts.
    - Output format:

      ### Chart Insights
      For each chart in charts_meta:
      - **<title>**
        - Takeaway 1 (one sentence)
        - Takeaway 2 (one sentence)
        - Caveat/Risk (one sentence)

      ### Overall Insights
      - 3-5 bullets max, each one sentence.

    Inputs:
    Profile:
    {json.dumps(state.profile, indent=2)}

    Execution result:
    {json.dumps(state.exec_result, indent=2)}

    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.insights = resp["generations"][0]["text"]
return stateDies ist der finale Synthese‑Agent. Er nutzt alle Pipeline‑Outputs – Profil, Insights, Chart‑Metadaten, Ausführungslogs – und erstellt einen vollständigen, aufgeräumten Markdown‑Report.
Der Prompt erzwingt strenge Formatregeln: keine doppelten Titel, konsistente Abstände, jedes Diagramm genau einmal in einem standardisierten HTML‑Block, und die Insights sauber eingebunden.
Sobald das Markdown fertig ist, ruft der Agent render_pdf auf, um es mit WeasyPrint in ein sauberes PDF zu konvertieren. Sowohl das Markdown als auch der PDF‑Pfad werden im gemeinsamen State gespeichert und schließen den Analyse‑Workflow ab.
@traceable(name="report_agent")
def report_agent(state: State):
    prompt = f"""
    You are the Report Agent.
    Create a neat Markdown report (HTML allowed).

    HARD REQUIREMENTS:
    - Do NOT repeat section titles or chart titles.
    - Do NOT output empty bullet points. If a bullet would be empty, skip it.
    - Keep spacing consistent: one blank line between sections.
    - Use charts_meta as the ONLY source of charts.
    - Include EVERY chart, exactly once, in the same order as charts_meta.
    - For each chart output EXACTLY this block:

      <div class="chart-block">
        <h3>Chart {{i}}: {{title}}</h3>
        <img src="{{filename}}" alt="{{title}}">
        <p><b>What it shows:</b> {{one_liner}}</p>
      </div>

      Where:
      - title, filename, one_liner come from charts_meta
      - one_liner must be ONE sentence, max ~20 words.

    Sections:
    1. Dataset Overview (short)
    2. Data Quality Notes (bullets)
    3. Exploratory Analysis (chart-by-chart blocks only, no extra chart titles)
    4. Modeling Results (if any; use a markdown table)
    5. Key Insights (use insights text)
    6. Recommendations / Next Steps (bullets)

    Inputs:
    Profile: {json.dumps(state.profile, indent=2)}
    Exec stdout: {state.exec_result.get("stdout","")}
    Exec ok: {state.exec_result.get("ok")}
    Traceback (if any): {state.exec_result.get("traceback","")}
    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    Insights:
    {state.insights}

    Return ONLY the Markdown report.
    """

    resp = gemini_call(prompt, thinking_level="low")
    state.report_md = resp["generations"][0]["text"]
    state.report_pdf = render_pdf(state.report_md)
return stateIm letzten Schritt konstruieren wir den kompletten Multi‑Agent‑Workflow, indem wir alle Agenten zu einem zustandsgetriebenen Graphen zusammenfügen.
Ein StateGraph wird mit einem gemeinsamen State‑Modell erstellt. So interagiert jeder Agent während des Workflows mit demselben fortschreitenden Zustandsobjekt. Komponenten wie Profiler, Code‑Schreiber, Executor, Insights‑Schreiber und Report‑Builder werden als eigene Knoten hinzugefügt – jede Phase der Pipeline als separater Schritt.
Der Workflow startet immer mit dem Profiler‑Agenten als Einstiegspunkt. So beginnt der Prozess mit einem gründlichen Verständnis des Datasets und einem Analyseplan.
Kanten definieren den Ablauf: Nach dem Profiling geht es zum Code‑Schreiber, dann zum Executor. Die Schlüssellogik liegt im konditionalen Routing vom Executor.
Eine Hilfsfunktion, retry_or_continue, prüft das Ausführungsergebnis. Läuft der Code erfolgreich, geht es zum Insights‑Agenten.
Scheitert er, aber es sind noch Retries übrig, wird automatisch zum Code‑Schreiber zurückgesprungen.
Sind keine Retries mehr vorhanden, wird die weitere Analyse übersprungen und direkt der Report‑Generator angesteuert – so vermeidest du Endlosschleifen. Die konditionalen Kanten sind im Executor‑Knoten hinterlegt, damit der Workflow je nach Erfolg oder Fehler adaptiv reagiert.
Abschließend verbindet der Graph die Insights‑Phase mit der Report‑Phase und von dort zum Ende des Workflows. Der Graph wird kompiliert und als ASCII‑Diagramm visualisiert.
Dieser Multi‑Agent‑Graph orchestriert die ganze adaptive Analyse‑Pipeline: Fehlererholung, Schritt‑für‑Schritt‑Koordination und reibungslose Übergänge zwischen den Agenten.
g = StateGraph(State)

g.add_node("profiler", profiler_agent)
g.add_node("code_writer", code_writer_agent)
g.add_node("executor", executor_agent)
g.add_node("insights", insights_agent)
g.add_node("report", report_agent)

g.set_entry_point("profiler")
g.add_edge("profiler", "code_writer")
g.add_edge("code_writer", "executor")

def retry_or_continue(state: State):
    # success path
    if state.exec_result and state.exec_result.get("ok"):
        return "insights"
    # stop retrying after MAX_RETRIES
    if state.retry_count >= MAX_RETRIES:
        return "report"
    return "code_writer"

g.add_conditional_edges(
    "executor",
    retry_or_continue,
    {"code_writer": "code_writer", "insights": "insights", "report": "report"}
)

g.add_edge("insights", "report")
g.add_edge("report", END)

graph = g.compile()

print(graph.get_graph().draw_ascii())
+-----------+
| __start__ |
+-----------+
*
*
*
+----------+
| profiler |
+----------+
*
*
*
+-------------+
| code_writer |
+-------------+
.
.
.
+----------+
| executor |
+----------+
.. ..
.. ..
. ..
+----------+ .
| insights | ..
+----------+ ..
** ..
** ..
* .
+--------+
| report |
+--------+
*
*
*
+---------+
| __end__ |
+---------+ Um die komplette Pipeline auszuführen, gibst du einfach einen Dataset‑Pfad an, erstellst ein initiales State‑Objekt und rufst den kompilierten Graphen auf. In unserem Fall verwenden wir das Boston Housing‑Dataset.
DATASET_PATH = "/work/housing.csv"  # <-- change this

state = State(dataset_path=DATASET_PATH)
out = graph.invoke(state)
Nach dem Aufruf führt das Multi‑Agent‑System automatisch die gesamte Analyse durch: Dataset profilieren, Plan generieren, Python‑Code schreiben und ausführen, Insights extrahieren sowie einen Markdown‑ und einen PDF‑Report erzeugen.
--- Modeling Baseline Results ---
Dataset Shape: (489, 4)
Linear Regression -> RMSE: 82,395.54, R2: 0.6911
Random Forest     -> RMSE: 56,931.38, R2: 0.8525
Observations: Random Forest typically outperforms Linear Regression due to capturing non-linear relationships (e.g., LSTAT).
Nach Abschluss kannst du im LangSmith‑Dashboard zum Projekt „autolab-gemini3pro“ navigieren. Jeder Agent‑Run ist dort sichtbar.
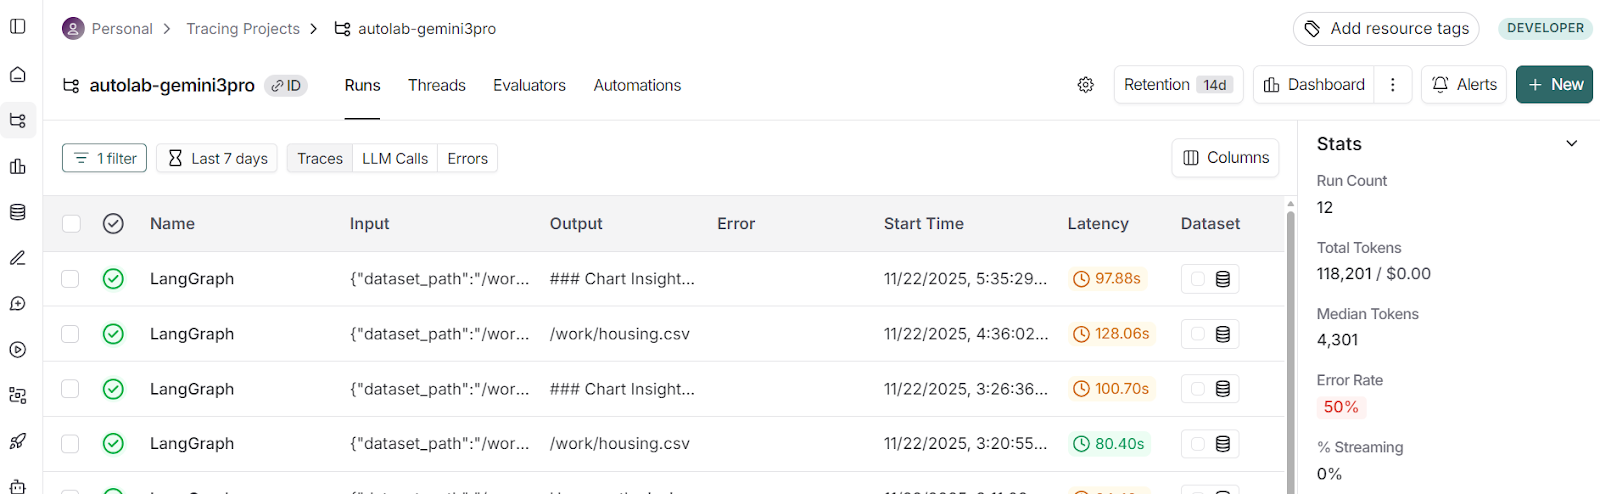
Wenn du den neuesten Run öffnest und zur Waterfall‑Ansicht wechselst, siehst du die Timeline jedes Schritts: Dauer der Agenten und verwendete Tools.

Du kannst jeden Agenten öffnen und dir ansehen:
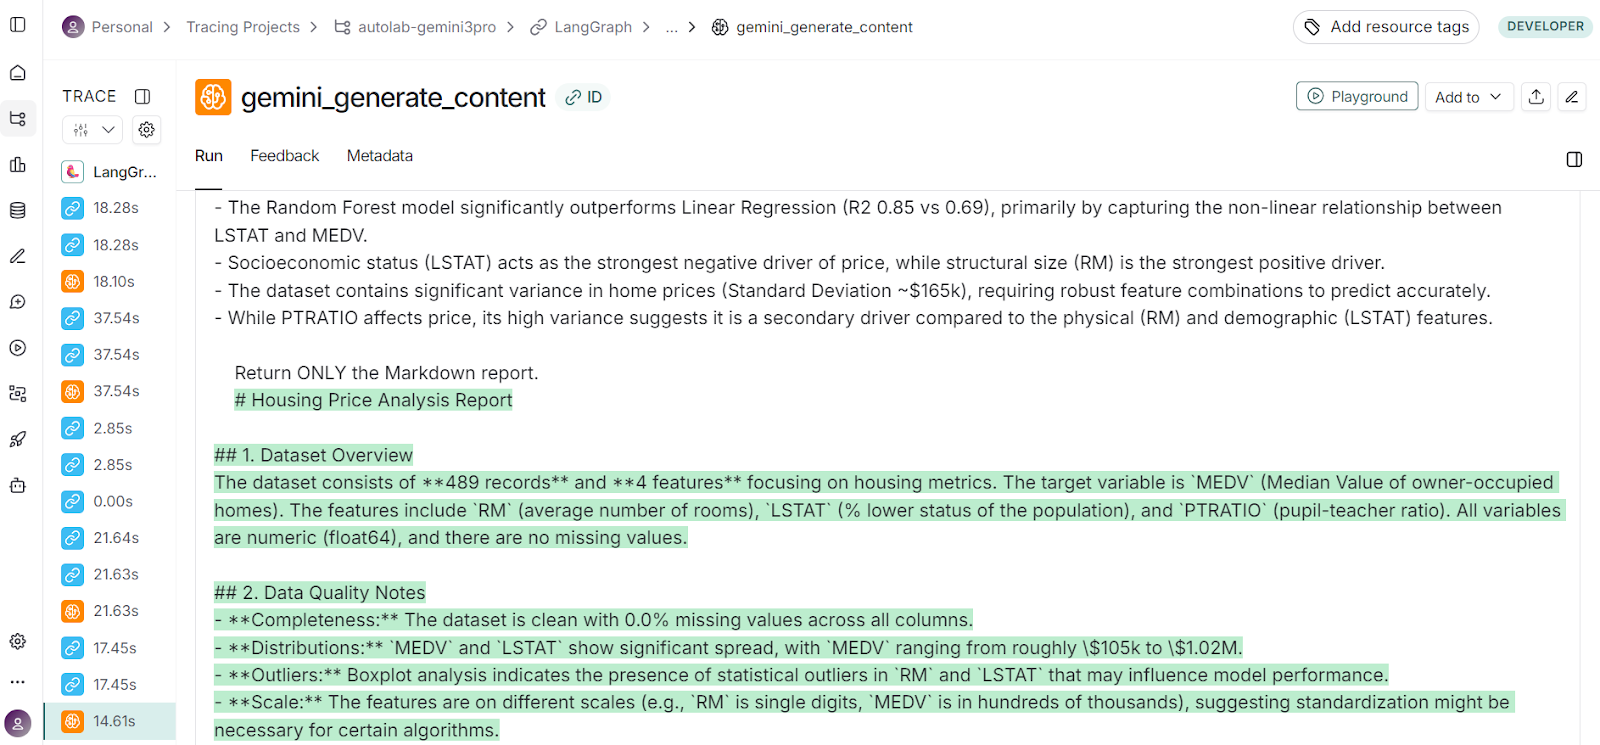
LangSmith war entscheidend, um den gesamten Workflow zu verbessern. Du siehst hier die finale Version – doch es brauchte viele Anläufe, bis alles passte, und LangSmith hat mir beim Debuggen der Agenten geholfen.
Sobald der Multi‑Agent‑Workflow abgeschlossen ist, kannst du den erzeugten Markdown‑Report direkt im Notebook prüfen.
Die Markdown‑Version eignet sich, um die Analyse schnell zu überfliegen, Insights zu lesen und die Report‑Struktur zu prüfen, ohne den Workspace zu verlassen.
print(out["report_md"][:2000])# Housing Price Analysis Report
## 1. Dataset Overview
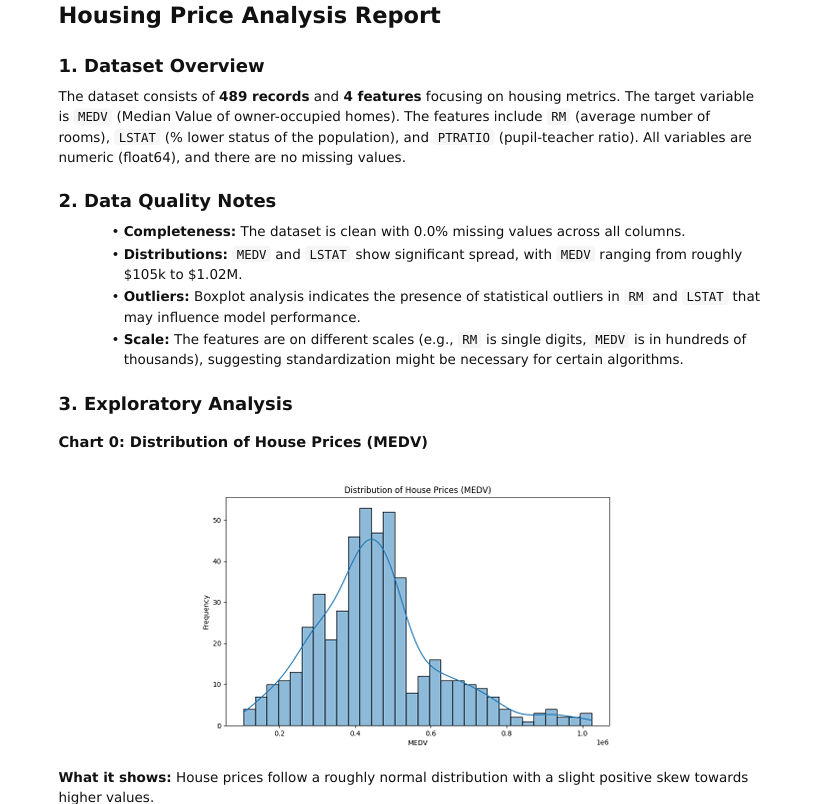
The dataset consists of **489 records** and **4 features** focusing on housing metrics. The target variable is `MEDV` (Median Value of owner-occupied homes). The features include `RM` (average number of rooms), `LSTAT.............Neben dem Markdown erzeugt der Workflow auch einen sauberen PDF‑Report. Das PDF wird automatisch im Artefakte‑Ordner gespeichert, und du kannst den Pfad so anzeigen:
print("PDF saved at:", out["report_pdf"])PDF saved at: artifacts/report.pdfDas erzeugte PDF ist stimmig und enthält alle Schlüsselelemente der Analyse: erklärende Texte, gerenderte Diagramme, Chart‑Interpretationen, Modellierungs‑Zusammenfassungen und finale Empfehlungen.
Damit eignet es sich ideal zum Teilen mit Teamkolleg:innen, Führungskräften oder Kund:innen – besonders, wenn du eine präsentationsreife Version der Ergebnisse brauchst.
Dieses Projekt zeigt, wie weit moderne KI‑Modelle und graphbasierte Agent‑Workflows sind. Noch vor Kurzem brauchte man für einen einzelnen Agenten mit mehreren Tools Tage an Tuning, Debugging und dem Umgang mit unvorhersehbarem Verhalten.
Gemini 3 Pro ermöglicht es heute, Datasets zu verstehen, präzisen Code zu generieren, Analysen auszuführen, Visualisierungen zu deuten und einen sauberen Report mit beeindruckender Zuverlässigkeit zusammenzustellen.
In diesem Projekt haben wir eine komplette Multi‑Agent‑Datenanalyse‑Anwendung gebaut, die jedes CSV‑Dataset annimmt, eine End‑to‑End‑Exploration durchführt, Baseline‑Modelle laufen lässt, Insights generiert und einen vollständig formatierten PDF‑Report erstellt.
Dabei kommen fünf koordinierte Agenten zum Einsatz: Profiling & Planung, Codegenerierung, Ausführung mit Retries, Insights‑Generierung und Reporting – sowie drei Kern‑Tools für Dataset‑Laden, sichere Code‑Ausführung und Markdown‑zu‑PDF‑Rendering.
Das Ergebnis ist ein schlanker, automatisierter Analyse‑Flow, der einen professionellen, erzählerisch aufgebauten Report mit Visualisierungen liefert.
Top DataCamp Courses
Kurs
Kurs
Kurs