
Curso
Creación de agentes de IA con Google ADK
1 h
7.5K
Gemini 3 Pro es el modelo de IA de vanguardia que estábamos esperando: ofrece una ventana de contexto de un millón de tokens que maneja sin esfuerzo datasets, documentos, vídeos y bases de código en una sola pasada. Aporta razonamiento a nivel doctoral y brilla en el procesamiento multimodal de texto, imágenes, audio y vídeo para flujos creativos sin fricciones.
En este tutorial práctico basado en un proyecto, te mostraré cómo usar la API de Gemini 3 para crear aplicaciones multiagente que trabajen con un dataset CSV proporcionado por el usuario y realicen analítica avanzada.
En pocas palabras, la app multiagente realizará:
Si quieres profundizar en flujos de trabajo agentivos, te recomiendo echar un vistazo a nuestra guía de Google Antigravity, el tutorial de Gemini 3 Flash y el itinerario de aprendizaje AI Agent Fundamentals.
1. Ejecuta este comando para instalar todos los paquetes necesarios para nuestra app multiagente:
!pip install -q google-genai langgraph langsmith grandalf pydantic pandas matplotlib markdown2 weasyprint markdown-it-py mdit-py-pluginsResumen de paquetes:
Nota: estamos usando Jupyter Notebook para construir este proyecto.
2. Ve a Google AI Studio y genera tu clave de API. Asegúrate de tener la facturación activada en tu cuenta, ya que el modelo Gemini 3 Pro no está disponible en el plan gratuito.
3. A continuación, crea una cuenta gratuita en LangSmith y genera su clave de API.
4. Guarda ambas claves de API como variables de entorno en tu sistema local. Define LANGSMITH_API_KEY y GEMINI_API_KEY.
5. Importa todos los paquetes de Python necesarios en tu notebook:
from google import genai
from google.genai import types
from pydantic import BaseModel
from langgraph.graph import StateGraph, END
import os, json, textwrap, traceback
from pathlib import Path
import pandas as pd
import markdown2
import weasyprint
6. Establece las variables de entorno para indicar el nombre del proyecto en LangSmith y habilitar su trazabilidad:
os.environ["LANGSMITH_TRACING"] = "true"
os.environ["LANGSMITH_API_KEY"] = os.environ.get("LANGSMITH_API_KEY", "YOUR_LANGSMITH_KEY")
os.environ["LANGSMITH_PROJECT"] = os.environ.get("LANGSMITH_PROJECT", "autolab-gemini3pro")
7. Crea la carpeta donde se guardarán todas las imágenes y PDFs:
ARTIFACTS_DIR = Path("artifacts")
ARTIFACTS_DIR.mkdir(exist_ok=True)En esta sección configuraremos un cliente de la API de Gemini y envolveremos las llamadas al modelo para poder trazarlas y registrarlas en LangSmith. Además, extraeremos metadatos de uso de tokens y los devolveremos en un formato compatible con LangSmith.
Primero, inicializamos el cliente de Gemini GenAI proporcionando la clave de API:
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3-pro-preview"
Después, escribiremos un pequeño wrapper alrededor de una llamada al modelo Gemini para habilitar el trazado automático con LangSmith. Con el decorador @traceable registramos la función como una ejecución de LLM.
Dentro de esta función, el código envía el prompt a Gemini y extrae los detalles de uso de tokens, fundamentales para un seguimiento preciso en LangSmith, siguiendo sus directrices de trazado.
Por último, la función devuelve el texto del modelo junto con las estadísticas de tokens y la respuesta en bruto en el formato que espera LangSmith, garantizando que la ejecución se muestre correctamente en la interfaz.
from langsmith import traceable
@traceable(name="gemini_generate_content", run_type="llm")
def gemini_call(prompt: str, thinking_level: str = "high"):
    """
    Gemini wrapper that:
    - uses correct ThinkingConfig schema
    - returns LangSmith LLM-run format so token usage shows in UI
    """
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            thinking_config=types.ThinkingConfig(thinking_level=thinking_level)
        ),
    )

    usage = getattr(resp, "usage_metadata", None)
    token_usage = None
    if usage:
        token_usage = {
            "prompt_tokens": usage.prompt_token_count,
            "completion_tokens": usage.candidates_token_count,
            "total_tokens": usage.total_token_count,
            "thoughts_tokens": getattr(usage, "thoughts_token_count", None),
        }

    return {
        "generations": [{"text": resp.text}],
        "llm_output": {
            "model_name": MODEL,
            "token_usage": token_usage,
        },
        "raw_response": resp,
}Ahora crearemos herramientas para la inspección del dataset, la ejecución segura de Python y la generación de informes Markdown‑a‑PDF que se usarán dentro del flujo del agente de IA.
Esta herramienta recibe una ruta de archivo, lee el CSV en un DataFrame de pandas y construye un resumen con la forma del dataset, nombres de columnas, tipo de dato por columna, porcentaje de valores ausentes, las cinco primeras filas y estadísticas descriptivas completas. Devuelve este resumen para que un agente comprenda el dataset rápidamente.
def load_dataset(path: str):
    df = pd.read_csv(path)

    summary = {
        "shape": df.shape,
        "columns": list(df.columns),
        "dtypes": {c: str(t) for c, t in df.dtypes.items()},
        "missing_pct": df.isna().mean().to_dict(),
        "head": df.head(5).to_dict(orient="records"),
        "describe": df.describe(include="all").fillna("").to_dict()
    }
return summaryEsta herramienta ejecuta con seguridad código Python generado dinámicamente en un entorno restringido. Prepara un entorno local mínimo y luego ejecuta el código proporcionado con exec.
El código ejecutado debe devolver rutas de artefactos (como gráficos guardados) y metadatos.
def run_python(code: str):
    """
    Generated code MUST:
      - save plots to ARTIFACTS_DIR
      - collect paths in _artifacts (list[str])
      - collect meta in _charts_meta (list[dict])
      - optionally set _stdout (string)
    """
    local_env = {"ARTIFACTS_DIR": ARTIFACTS_DIR}
    try:
        exec(textwrap.dedent(code), {}, local_env)
        return {
            "ok": True,
            "stdout": local_env.get("_stdout", ""),
            "artifacts": local_env.get("_artifacts", []),
            "charts_meta": local_env.get("_charts_meta", []),
        }
    except Exception:
return {"ok": False, "traceback": traceback.format_exc()}Esta herramienta convierte Markdown en un PDF con buen formato. Primero construye un parser de Markdown que soporta tablas, listas, listas de tareas y notas al pie.
Luego, render_pdf convierte el Markdown a HTML, lo envuelve en una plantilla con CSS personalizado (controlando tipografías, tablas, tamaño de imágenes, etc.) y usa WeasyPrint para generar el PDF.
Por último, guarda el PDF en la carpeta de artefactos y devuelve su ruta.
from markdown_it import MarkdownIt
from mdit_py_plugins.tasklists import tasklists_plugin
from mdit_py_plugins.footnote import footnote_plugin

# Create a strong markdown parser once (supports tables, lists, etc.)
md = (
    MarkdownIt("commonmark", {"breaks": True, "html": True})
    .enable(["table", "strikethrough"])
    .use(tasklists_plugin)
    .use(footnote_plugin)
)

def render_pdf(markdown_text: str):
    """
    Better Markdown -> HTML -> PDF:
    - proper tables
    - stable lists
    - centered/small images
    - clean page breaks
    """
    html_body = md.render(markdown_text)

    html_template = f"""
    <html>
    <head>
      <meta charset="utf-8">
      <style>
        body {{
          font-family: Arial, sans-serif;
          font-size: 12px;
          line-height: 1.5;
          color: #111;
        }}

        h1 {{ font-size: 20px; margin-bottom: 6px; }}
        h2 {{ font-size: 16px; margin-top: 18px; margin-bottom: 6px; }}
        h3 {{ font-size: 13px; margin-top: 12px; margin-bottom: 4px; }}

        p {{ margin: 6px 0; }}

        ul, ol {{
          margin: 6px 0 6px 18px;
        }}
        li {{ margin: 2px 0; }}

        table {{
          width: 100%;
          border-collapse: collapse;
          margin: 8px 0 12px 0;
          font-size: 11px;
        }}
        th, td {{
          border: 1px solid #ccc;
          padding: 6px;
          text-align: left;
        }}
        th {{ background: #f2f2f2; }}

        img {{
          display: block;
          margin: 8px auto 8px auto;
          max-width: 70%;
          height: auto;
          page-break-inside: avoid;
        }}

        .chart-block {{
          page-break-inside: avoid;
          margin-bottom: 12px;
        }}

        code {{
          background: #f6f6f6;
          padding: 2px 4px;
          border-radius: 4px;
          font-size: 11px;
        }}
        pre code {{
          display: block;
          padding: 8px;
          overflow-x: auto;
        }}
      </style>
    </head>
    <body>
      {html_body}
    </body>
    </html>
    """

    pdf_path = ARTIFACTS_DIR / "report.pdf"
    weasyprint.HTML(
        string=html_template,
        base_url=str(ARTIFACTS_DIR.parent.resolve())
    ).write_pdf(str(pdf_path))

    return str(pdf_path)
Con esto registramos las tres funciones como herramientas disponibles para que las use el agente.
TOOLS = [load_dataset, run_python, render_pdf]Esta clase define un objeto state compartido que guarda todo lo que produce el flujo del agente: ruta del dataset, perfilado, plan generado, código, resultados de ejecución, insights e informe final, además de límites de reintentos y mensajes de error para evitar bucles infinitos.
class State(BaseModel):
    dataset_path: str
    profile: dict | None = None
    plan: dict | None = None
    code: str | None = None
    exec_result: dict | None = None
    charts_meta: list | None = None
    insights: str | None = None
    report_md: str | None = None
    report_pdf: str | None = None

    retry_count: int = 0          # NEW: stop infinite loops
    last_error: str | None = None # NEW: pass traceback to coder

MAX_RETRIES = 2Ahora crearemos agentes de IA que cooperan para perfilar el dataset, escribir y ejecutar código de análisis, generar insights y producir un informe PDF final.
Este agente se encarga de comprender el dataset y crear un plan de análisis estructurado. Primero carga el dataset usando la herramienta load_dataset, que le proporciona un resumen con forma, valores ausentes, tipos de columna, estadísticas descriptivas y filas de ejemplo.
Después envía este resumen al LLM con instrucciones muy claras: identificar el tipo de tarea, elegir una columna objetivo si aplica, decidir los pasos exploratorios, proponer los gráficos a generar y esbozar pasos de modelado si el dataset sugiere clasificación o regresión.
El LLM devuelve una estructura JSON con este plan, y el agente la analiza, guardando texto en bruto si fallase el parseo de JSON.
Por último, guarda tanto el perfil del dataset como el plan generado en el estado compartido para que los siguientes agentes tengan toda la información necesaria.
@traceable(name="profiler_agent")
def profiler_agent(state: State):
    profile = load_dataset(state.dataset_path)

    prompt = f"""
    You are the Data Profiler Agent.
    Produce a JSON analysis plan with:
      - task_type: "classification"|"regression"|"eda_only"
      - target_column (if any)
      - eda_steps (list)
      - charts_to_make (list)  # 5-10 max, most informative
      - baseline_model_steps (list if modeling)
      - risks_or_data_issues (list)

    Dataset profile:
    {json.dumps(profile, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    text = resp["generations"][0]["text"]

    try:
        plan = json.loads(text)
    except:
        plan = {"raw_plan": text}

    state.profile = profile
    state.plan = plan
return stateEste agente convierte el plan de análisis en código Python ejecutable. Recibe el perfil del dataset, el plan y cualquier error de ejecución previo. Con ese contexto, pide al LLM que devuelva únicamente código Python.
El prompt incluye requisitos estrictos: cargar el dataset, seguir el plan al pie de la letra, generar cada gráfico especificado, guardar los plots en ARTIFACTS_DIR, registrar rutas y metadatos de gráficos, capturar la salida de consola, cerrar las figuras tras guardarlas y, opcionalmente, calcular métricas de modelado.
Así garantizamos que el código sea reproducible y seguro en el sandbox. El resultado se guarda en state.code, listo para que el ejecutor lo corra.
@traceable(name="code_writer_agent")
def code_writer_agent(state: State):
    prompt = f"""
    You are the Code Writer Agent.
    Write Python code ONLY (no markdown).

    Previous error to fix (if any):
    {state.last_error}

    HARD REQUIREMENTS:
    1. Load dataset from: {state.dataset_path}
    2. Follow the plan exactly.
    3. Create ALL charts in charts_to_make.
    4. Save every chart in ARTIFACTS_DIR with filenames like:
         ARTIFACTS_DIR / "chart_01_<short_name>.png"
    5. Track saved plot paths in _artifacts (list[str]).
    6. Track chart metadata in _charts_meta (list[dict]) with:
         {{
           "title": "<human readable chart title>",
           "filename": "artifacts/chart_01_x.png",
           "description": "<what this plot shows (1-2 sentences)>",
           "one_liner": "<ONE line insight from the chart>"
         }}
       The one_liner MUST be a single sentence, max ~20 words.

    7. Store useful console output in _stdout.

    IMPORTANT:
    - import matplotlib.pyplot as plt
    - plt.close() after saving each plot
    - ensure _artifacts and _charts_meta exist even if empty
    - if modeling, add baseline metrics to _stdout

    Dataset profile:
    {json.dumps(state.profile, indent=2)}

    Analysis plan:
    {json.dumps(state.plan, indent=2)}

    Return ONLY executable python code.
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.code = resp["generations"][0]["text"]
return stateEste agente ejecuta el código Python producido por el redactor de código usando el sandbox aislado run_python. Captura resultados de ejecución, metadatos de gráficos, salida estándar y cualquier artefacto creado.
Si el código se ejecuta correctamente, se guardan los resultados y el flujo avanza con normalidad. Si falla, el agente incrementa el contador de reintentos y almacena el traceback para que el redactor pueda corregir el error en el siguiente intento.
Con MAX_RETRIES limitando el bucle, este agente evita ciclos infinitos y proporciona las señales de feedback necesarias para la autocorrección.
@traceable(name="executor_agent")
def executor_agent(state: State):
    result = run_python(state.code)
    state.exec_result = result
    state.charts_meta = result.get("charts_meta", [])

    if not result["ok"]:
        state.retry_count += 1
        state.last_error = result.get("traceback", "Unknown error")

return stateEste agente interpreta todo el análisis. Toma el perfil del dataset, la salida de la ejecución y los metadatos de los gráficos y produce insights analíticos en lenguaje natural.
Instruye al LLM para generar insights estructurados: para cada gráfico, dos conclusiones y un riesgo, y luego un conjunto limitado de insights globales.
El agente debe asegurar que no haya viñetas vacías, que no se repitan puntos y que los insights sean específicos del dataset, no genéricos.
El informe de insights resultante se guarda en state.insights, convirtiéndose en entrada para la fase final de reporting.
@traceable(name="insights_agent")
def insights_agent(state: State):
    prompt = f"""
    You are the Insights Agent.

    HARD REQUIREMENTS:
    - No empty bullets.
    - No repeated bullets.
    - Be specific to this dataset and these charts.
    - Output format:

      ### Chart Insights
      For each chart in charts_meta:
      - **<title>**
        - Takeaway 1 (one sentence)
        - Takeaway 2 (one sentence)
        - Caveat/Risk (one sentence)

      ### Overall Insights
      - 3-5 bullets max, each one sentence.

    Inputs:
    Profile:
    {json.dumps(state.profile, indent=2)}

    Execution result:
    {json.dumps(state.exec_result, indent=2)}

    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.insights = resp["generations"][0]["text"]
return stateEste es el agente de síntesis final. Usa todas las salidas del pipeline: perfil, insights, metadatos de gráficos, logs de ejecución, y compone un informe Markdown completo y limpio.
El prompt impone reglas estrictas de formato: sin títulos repetidos, espaciado coherente, cada gráfico mostrado una sola vez en un bloque HTML estandarizado e integración clara de los insights.
Una vez generado el Markdown, el agente llama a render_pdf para convertirlo en un PDF pulido con WeasyPrint. Tanto el Markdown como la ruta del PDF se guardan en el estado compartido, cerrando el flujo de análisis.
@traceable(name="report_agent")
def report_agent(state: State):
    prompt = f"""
    You are the Report Agent.
    Create a neat Markdown report (HTML allowed).

    HARD REQUIREMENTS:
    - Do NOT repeat section titles or chart titles.
    - Do NOT output empty bullet points. If a bullet would be empty, skip it.
    - Keep spacing consistent: one blank line between sections.
    - Use charts_meta as the ONLY source of charts.
    - Include EVERY chart, exactly once, in the same order as charts_meta.
    - For each chart output EXACTLY this block:

      <div class="chart-block">
        <h3>Chart {{i}}: {{title}}</h3>
        <img src="{{filename}}" alt="{{title}}">
        <p><b>What it shows:</b> {{one_liner}}</p>
      </div>

      Where:
      - title, filename, one_liner come from charts_meta
      - one_liner must be ONE sentence, max ~20 words.

    Sections:
    1. Dataset Overview (short)
    2. Data Quality Notes (bullets)
    3. Exploratory Analysis (chart-by-chart blocks only, no extra chart titles)
    4. Modeling Results (if any; use a markdown table)
    5. Key Insights (use insights text)
    6. Recommendations / Next Steps (bullets)

    Inputs:
    Profile: {json.dumps(state.profile, indent=2)}
    Exec stdout: {state.exec_result.get("stdout","")}
    Exec ok: {state.exec_result.get("ok")}
    Traceback (if any): {state.exec_result.get("traceback","")}
    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    Insights:
    {state.insights}

    Return ONLY the Markdown report.
    """

    resp = gemini_call(prompt, thinking_level="low")
    state.report_md = resp["generations"][0]["text"]
    state.report_pdf = render_pdf(state.report_md)
return stateEste último paso consiste en montar el flujo multiagente completo ensamblando todos los agentes en un grafo guiado por estado.
Se crea un StateGraph usando un modelo de State compartido, garantizando que cada agente interactúe con el mismo objeto de estado a medida que avanza el flujo. Cada componente —profiler, redactor de código, ejecutor, redactor de insights y generador de informes— se añade al grafo como un nodo independiente que representa una etapa concreta del pipeline.
El flujo siempre comienza con el agente de perfilado, definido como punto de entrada. Así nos aseguramos de iniciar con una comprensión sólida del dataset y un plan de análisis.
Se establecen aristas para definir la secuencia. Tras el perfilado, la salida va al redactor de código, que alimenta al ejecutor. La clave está en el enrutamiento condicional desde el ejecutor.
Una función auxiliar, retry_or_continue, examina el resultado de la ejecución. Si el código se ejecuta con éxito, el flujo continúa al agente de insights.
Si falla pero aún quedan reintentos, vuelve al redactor de código para la corrección automática.
Si no quedan reintentos, se salta el análisis posterior y pasa directamente al generador de informes, evitando bucles sin fin. Las aristas condicionales se incorporan en el nodo del ejecutor para que el flujo se adapte según el éxito o fallo de la ejecución.
Finalmente, el grafo conecta la etapa de insights con la de informe, y de esta con la conclusión del flujo. El grafo se compila a una estructura ejecutable y se genera un diagrama ASCII para visualizar el flujo.
Este grafo multiagente orquesta toda la canalización de análisis adaptativo, permitiendo recuperación ante errores, coordinación paso a paso y transiciones fluidas entre agentes.
g = StateGraph(State)

g.add_node("profiler", profiler_agent)
g.add_node("code_writer", code_writer_agent)
g.add_node("executor", executor_agent)
g.add_node("insights", insights_agent)
g.add_node("report", report_agent)

g.set_entry_point("profiler")
g.add_edge("profiler", "code_writer")
g.add_edge("code_writer", "executor")

def retry_or_continue(state: State):
    # success path
    if state.exec_result and state.exec_result.get("ok"):
        return "insights"
    # stop retrying after MAX_RETRIES
    if state.retry_count >= MAX_RETRIES:
        return "report"
    return "code_writer"

g.add_conditional_edges(
    "executor",
    retry_or_continue,
    {"code_writer": "code_writer", "insights": "insights", "report": "report"}
)

g.add_edge("insights", "report")
g.add_edge("report", END)

graph = g.compile()

print(graph.get_graph().draw_ascii())
+-----------+
| __start__ |
+-----------+
*
*
*
+----------+
| profiler |
+----------+
*
*
*
+-------------+
| code_writer |
+-------------+
.
.
.
+----------+
| executor |
+----------+
.. ..
.. ..
. ..
+----------+ .
| insights | ..
+----------+ ..
** ..
** ..
* .
+--------+
| report |
+--------+
*
*
*
+---------+
| __end__ |
+---------+ Para ejecutar la canalización completa, basta con proporcionar la ruta del dataset, crear un objeto State inicial e invocar el grafo compilado. En nuestro caso, usamos el dataset Boston Housing.
DATASET_PATH = "/work/housing.csv"  # <-- change this

state = State(dataset_path=DATASET_PATH)
out = graph.invoke(state)
Una vez invocado, el sistema multiagente realiza automáticamente todo el análisis: perfila el dataset, genera un plan, escribe y ejecuta el código en Python, extrae insights y produce un informe en Markdown y otro en PDF.
--- Modeling Baseline Results ---
Dataset Shape: (489, 4)
Linear Regression -> RMSE: 82,395.54, R2: 0.6911
Random Forest     -> RMSE: 56,931.38, R2: 0.8525
Observations: Random Forest typically outperforms Linear Regression due to capturing non-linear relationships (e.g., LSTAT).
Cuando termine, abre tu panel de LangSmith y navega al proyecto “autolab-gemini3pro”. Verás allí cada ejecución de agente.
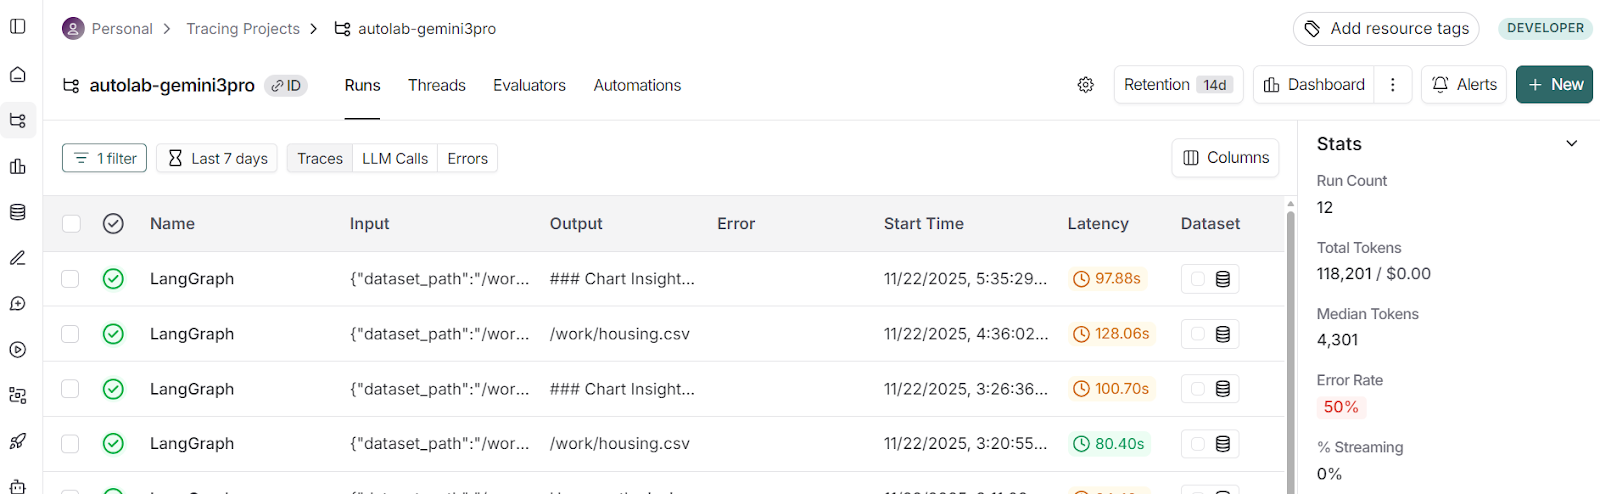
Al hacer clic en la ejecución más reciente y cambiar a la vista Waterfall verás la cronología de cada paso: cuánto tardaron los agentes y qué herramientas usaron.

Puedes entrar en cualquier agente para inspeccionar:
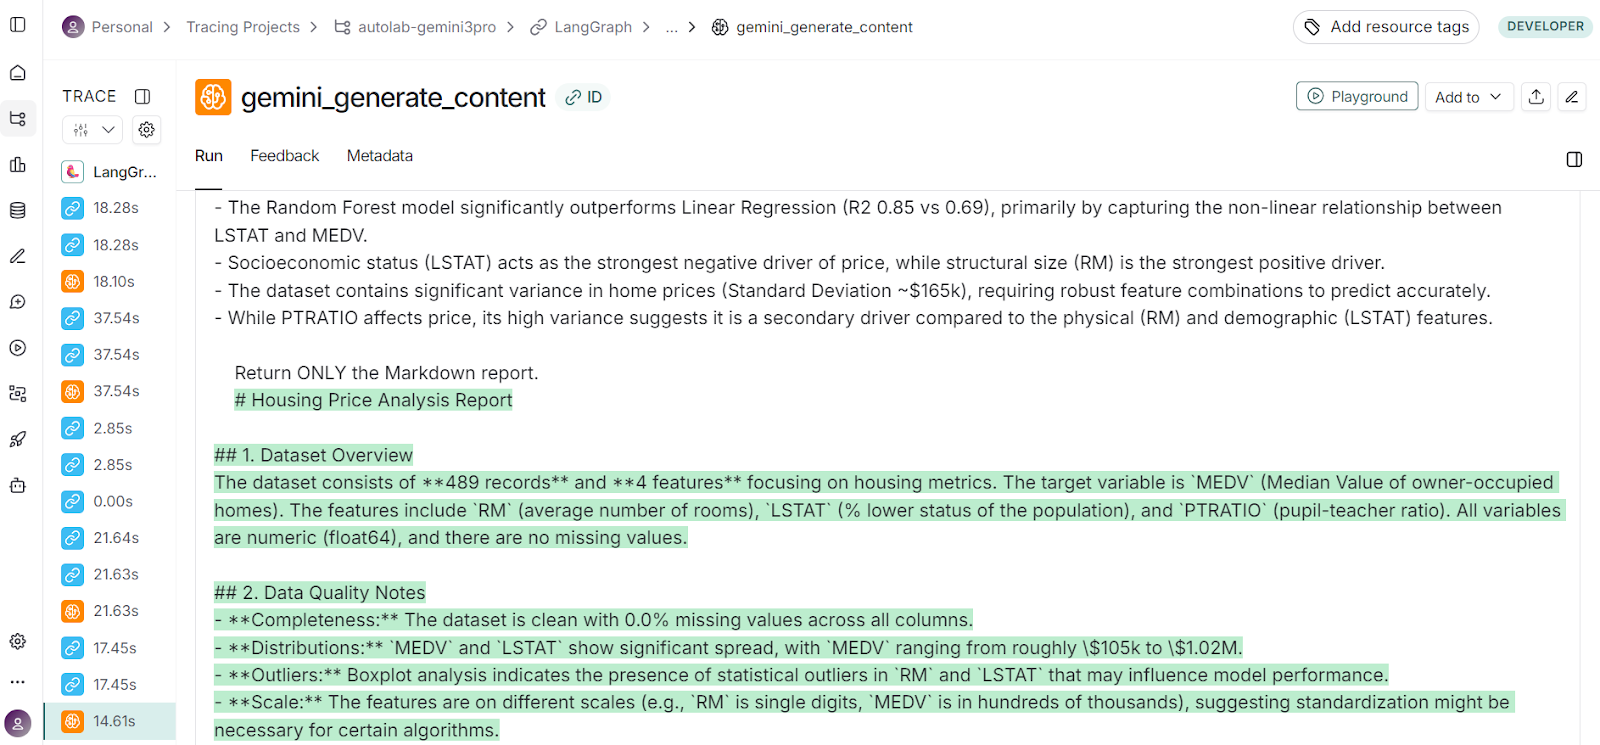
LangSmith fue clave para mejorar todo el flujo. Lo que ves es la versión final, pero hicieron falta muchos intentos para dejarlo fino, y LangSmith me ayudó a depurar los problemas en los agentes.
Cuando el flujo multiagente termina, puedes revisar directamente el informe Markdown generado dentro del notebook.
La versión en Markdown es útil para revisar rápido el análisis, leer los insights y examinar la estructura del informe sin salir de tu espacio de trabajo.
print(out["report_md"][:2000])# Housing Price Analysis Report
## 1. Dataset Overview
The dataset consists of **489 records** and **4 features** focusing on housing metrics. The target variable is `MEDV` (Median Value of owner-occupied homes). The features include `RM` (average number of rooms), `LSTAT.............Además del Markdown, el flujo también produce un PDF pulido. El PDF se guarda automáticamente en la carpeta de artefactos y puedes ver su ruta así:
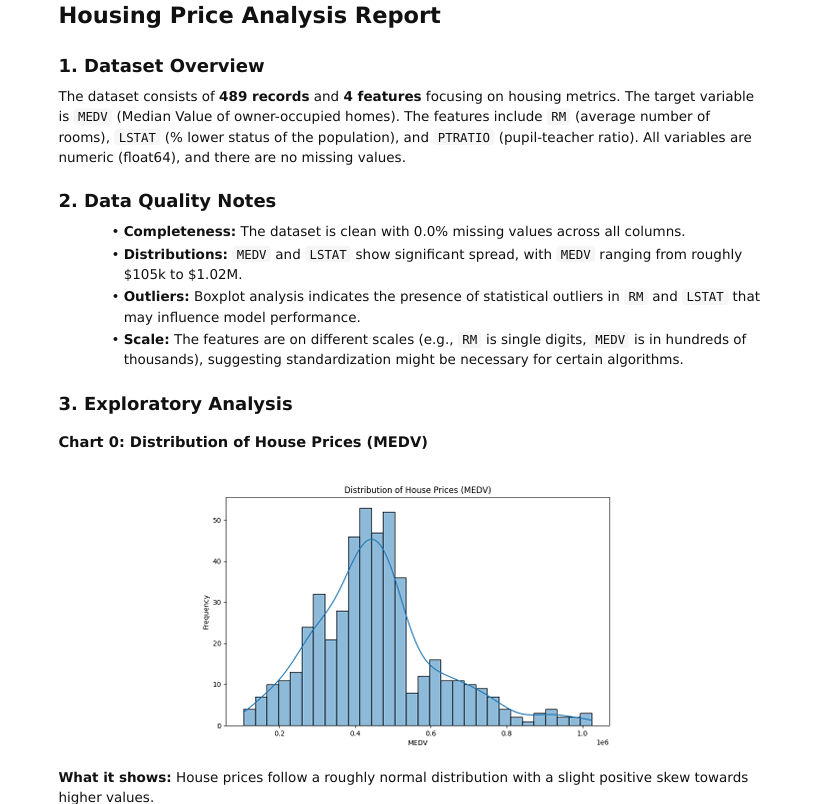
print("PDF saved at:", out["report_pdf"])PDF saved at: artifacts/report.pdfEl PDF generado es redondo y contiene todos los componentes clave del análisis: explicaciones narrativas, gráficos renderizados, interpretación de gráficos, resúmenes de modelado y recomendaciones finales.
Es ideal para compartir con tu equipo, responsables o clientes cuando necesitas una versión limpia y lista para presentar.
Trabajar en este proyecto deja claro hasta qué punto han evolucionado los modelos de IA modernos y los flujos de trabajo de agentes basados en grafos. No hace tanto, construir un solo agente con varias herramientas llevaba días de ajuste, depuración y comportamientos impredecibles.
Hoy, con modelos como Gemini 3 Pro, el sistema entiende el dataset, genera código preciso, ejecuta análisis, interpreta visualizaciones y arma un informe pulido con una fiabilidad notable.
En este proyecto hemos construido una aplicación completa de análisis de datos multiagente capaz de tomar cualquier dataset CSV, realizar análisis exploratorio de extremo a extremo, ejecutar modelos base, generar insights y producir un informe PDF totalmente formateado.
Este proyecto usa cinco agentes coordinados: perfilado y planificación, generación de código, ejecución con reintentos, generación de insights y reporting, y tres herramientas clave para carga de datasets, ejecución segura de código y renderizado de Markdown a PDF.
El resultado es un flujo de análisis limpio y automatizado que produce un informe profesional y con narrativa, respaldado por visualizaciones.
Cursos destacados de DataCamp
Curso
Curso
Curso
blog
Matt Crabtree
13 min
blog
Abid Ali Awan
10 min
Tutorial
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Zoumana Keita
12 min
Tutorial
Ryan Ong
12 min




