
Curso
Criando agentes de IA com o Google ADK
1 h
7.5K
Gemini 3 Pro é o modelo de IA de ponta que todo mundo estava esperando, com uma janela de contexto gigantesca de um milhão de tokens que lida com datasets, documentos, vídeos e bases de código em uma única passada. Ele oferece raciocínio em nível de PhD e é excelente no processamento multimodal de texto, imagens, áudio e vídeo para fluxos criativos sem atritos.
Neste tutorial prático por projeto, vou mostrar como usar a API do Gemini 3 para criar aplicações multiagente que usam um dataset CSV fornecido pelo usuário e realizam análises aprofundadas de dados.
Em resumo, o app multiagente vai realizar:
Se você quiser se aprofundar na construção de workflows agentic em IA, recomendo conferir nosso guia do Google Antigravity, o tutorial do Gemini 3 Flash e a trilha de aprendizado AI Agent Fundamentals.
1. Rode este comando para instalar todos os pacotes necessários para nosso app multiagente:
!pip install -q google-genai langgraph langsmith grandalf pydantic pandas matplotlib markdown2 weasyprint markdown-it-py mdit-py-pluginsResumo dos pacotes:
Observação: estamos usando o Jupyter Notebook para construir este projeto.
2. Acesse o Google AI Studio e gere sua chave de API. Garanta que o faturamento esteja configurado na sua conta, pois o modelo Gemini 3 Pro não está disponível no nível gratuito.
3. Em seguida, crie uma conta gratuita no LangSmith e gere a chave da API.
4. Salve ambas as chaves de API como variáveis de ambiente no seu sistema local. Defina LANGSMITH_API_KEY e GEMINI_API_KEY.
5. Importe todos os pacotes Python necessários no seu notebook:
from google import genai
from google.genai import types
from pydantic import BaseModel
from langgraph.graph import StateGraph, END
import os, json, textwrap, traceback
from pathlib import Path
import pandas as pd
import markdown2
import weasyprint
6. Defina as variáveis de ambiente para especificar o nome do projeto no LangSmith e ativar o rastreamento do LangSmith:
os.environ["LANGSMITH_TRACING"] = "true"
os.environ["LANGSMITH_API_KEY"] = os.environ.get("LANGSMITH_API_KEY", "YOUR_LANGSMITH_KEY")
os.environ["LANGSMITH_PROJECT"] = os.environ.get("LANGSMITH_PROJECT", "autolab-gemini3pro")
7. Crie a pasta onde todas as imagens e PDFs serão salvos:
ARTIFACTS_DIR = Path("artifacts")
ARTIFACTS_DIR.mkdir(exist_ok=True)Nesta seção, vamos configurar um cliente da API do Gemini e encapsular chamadas ao modelo para que possam ser rastreadas e registradas no LangSmith. Além disso, vamos extrair metadados de uso de tokens e retorná-los em um formato compatível com o LangSmith.
Primeiro, vamos inicializar o cliente Gemini GenAI fornecendo a chave de API:
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3-pro-preview"
Em seguida, escreveremos um pequeno wrapper em torno de uma chamada ao modelo Gemini para habilitar o rastreamento automático pelo LangSmith. Usando o decorador @traceable, registramos a função como uma execução de LLM.
Dentro dessa função, o código envia o prompt ao Gemini e extrai detalhes de uso de tokens, essenciais para o rastreamento preciso no LangSmith, seguindo as diretrizes de tracing.
Por fim, a função retorna a saída em texto do modelo junto com estatísticas de tokens e a resposta bruta no formato esperado pelo LangSmith, garantindo que a execução apareça corretamente na interface.
from langsmith import traceable
@traceable(name="gemini_generate_content", run_type="llm")
def gemini_call(prompt: str, thinking_level: str = "high"):
    """
    Gemini wrapper that:
    - uses correct ThinkingConfig schema
    - returns LangSmith LLM-run format so token usage shows in UI
    """
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            thinking_config=types.ThinkingConfig(thinking_level=thinking_level)
        ),
    )

    usage = getattr(resp, "usage_metadata", None)
    token_usage = None
    if usage:
        token_usage = {
            "prompt_tokens": usage.prompt_token_count,
            "completion_tokens": usage.candidates_token_count,
            "total_tokens": usage.total_token_count,
            "thoughts_tokens": getattr(usage, "thoughts_token_count", None),
        }

    return {
        "generations": [{"text": resp.text}],
        "llm_output": {
            "model_name": MODEL,
            "token_usage": token_usage,
        },
        "raw_response": resp,
}Agora, vamos criar ferramentas que oferecem inspeção do dataset, execução segura de Python e geração de relatório Markdown‑para‑PDF, que serão usadas dentro do workflow do agente de IA.
Esta ferramenta recebe um caminho de arquivo, lê o CSV em um DataFrame do pandas e monta um resumo com o shape do dataset, nomes das colunas, tipo de dado de cada coluna, percentuais de valores ausentes, as cinco primeiras linhas e estatísticas descritivas completas. Ela retorna esse resumo para que um agente entenda rapidamente o dataset.
def load_dataset(path: str):
    df = pd.read_csv(path)

    summary = {
        "shape": df.shape,
        "columns": list(df.columns),
        "dtypes": {c: str(t) for c, t in df.dtypes.items()},
        "missing_pct": df.isna().mean().to_dict(),
        "head": df.head(5).to_dict(orient="records"),
        "describe": df.describe(include="all").fillna("").to_dict()
    }
return summaryEsta ferramenta executa com segurança código Python gerado dinamicamente dentro de um ambiente restrito. Ela prepara um pequeno ambiente local e então executa o código fornecido com exec.
Espera-se que o código executado retorne caminhos de artefatos (como gráficos salvos) e metadados.
def run_python(code: str):
    """
    Generated code MUST:
      - save plots to ARTIFACTS_DIR
      - collect paths in _artifacts (list[str])
      - collect meta in _charts_meta (list[dict])
      - optionally set _stdout (string)
    """
    local_env = {"ARTIFACTS_DIR": ARTIFACTS_DIR}
    try:
        exec(textwrap.dedent(code), {}, local_env)
        return {
            "ok": True,
            "stdout": local_env.get("_stdout", ""),
            "artifacts": local_env.get("_artifacts", []),
            "charts_meta": local_env.get("_charts_meta", []),
        }
    except Exception:
return {"ok": False, "traceback": traceback.format_exc()}Esta ferramenta converte Markdown em um PDF bem formatado. Primeiro, ela constrói um parser de Markdown que suporta tabelas, listas, listas de tarefas e notas de rodapé.
Depois, o render_pdf converte o texto Markdown em HTML, envolve em um template com CSS personalizado (controlando fontes, aparência de tabelas, tamanho de imagens etc.) e usa o WeasyPrint para gerar um arquivo PDF.
Por fim, salva o PDF na pasta de artefatos e retorna o caminho.
from markdown_it import MarkdownIt
from mdit_py_plugins.tasklists import tasklists_plugin
from mdit_py_plugins.footnote import footnote_plugin

# Create a strong markdown parser once (supports tables, lists, etc.)
md = (
    MarkdownIt("commonmark", {"breaks": True, "html": True})
    .enable(["table", "strikethrough"])
    .use(tasklists_plugin)
    .use(footnote_plugin)
)

def render_pdf(markdown_text: str):
    """
    Better Markdown -> HTML -> PDF:
    - proper tables
    - stable lists
    - centered/small images
    - clean page breaks
    """
    html_body = md.render(markdown_text)

    html_template = f"""
    <html>
    <head>
      <meta charset="utf-8">
      <style>
        body {{
          font-family: Arial, sans-serif;
          font-size: 12px;
          line-height: 1.5;
          color: #111;
        }}

        h1 {{ font-size: 20px; margin-bottom: 6px; }}
        h2 {{ font-size: 16px; margin-top: 18px; margin-bottom: 6px; }}
        h3 {{ font-size: 13px; margin-top: 12px; margin-bottom: 4px; }}

        p {{ margin: 6px 0; }}

        ul, ol {{
          margin: 6px 0 6px 18px;
        }}
        li {{ margin: 2px 0; }}

        table {{
          width: 100%;
          border-collapse: collapse;
          margin: 8px 0 12px 0;
          font-size: 11px;
        }}
        th, td {{
          border: 1px solid #ccc;
          padding: 6px;
          text-align: left;
        }}
        th {{ background: #f2f2f2; }}

        img {{
          display: block;
          margin: 8px auto 8px auto;
          max-width: 70%;
          height: auto;
          page-break-inside: avoid;
        }}

        .chart-block {{
          page-break-inside: avoid;
          margin-bottom: 12px;
        }}

        code {{
          background: #f6f6f6;
          padding: 2px 4px;
          border-radius: 4px;
          font-size: 11px;
        }}
        pre code {{
          display: block;
          padding: 8px;
          overflow-x: auto;
        }}
      </style>
    </head>
    <body>
      {html_body}
    </body>
    </html>
    """

    pdf_path = ARTIFACTS_DIR / "report.pdf"
    weasyprint.HTML(
        string=html_template,
        base_url=str(ARTIFACTS_DIR.parent.resolve())
    ).write_pdf(str(pdf_path))

    return str(pdf_path)
Isso apenas registra as três funções como ferramentas disponíveis para o agente usar.
TOOLS = [load_dataset, run_python, render_pdf]Esta classe define um objeto state compartilhado que guarda tudo o que o workflow do agente produz: como o caminho do dataset, informações de perfil, plano gerado, código, resultados de execução, insights e relatório final, além de limites de tentativa e mensagens de erro para evitar loops infinitos.
class State(BaseModel):
    dataset_path: str
    profile: dict | None = None
    plan: dict | None = None
    code: str | None = None
    exec_result: dict | None = None
    charts_meta: list | None = None
    insights: str | None = None
    report_md: str | None = None
    report_pdf: str | None = None

    retry_count: int = 0          # NEW: stop infinite loops
    last_error: str | None = None # NEW: pass traceback to coder

MAX_RETRIES = 2Agora vamos criar agentes de IA que vão trabalhar juntos para perfilar o dataset, escrever e executar código de análise, gerar insights e produzir um relatório final em PDF.
Este agente é responsável por entender o dataset e criar um plano estruturado de análise. Ele primeiro carrega o dataset usando a ferramenta load_dataset, que fornece um resumo com shapes, valores ausentes, tipos de colunas, estatísticas descritivas e linhas de exemplo.
Depois, ele envia esse resumo do dataset ao LLM com instruções bem explícitas: identifique o tipo de tarefa, selecione uma coluna-alvo se aplicável, defina quais passos exploratórios devem ser feitos, proponha os gráficos a serem gerados e descreva quaisquer etapas de modelagem se o dataset sugerir classificação ou regressão.
O LLM retorna uma estrutura JSON representando esse plano, e o agente faz o parse; caso falhe, armazena o texto bruto.
Por fim, ele salva tanto o perfil do dataset quanto o plano gerado no estado compartilhado, para que os próximos agentes tenham tudo o que precisam.
@traceable(name="profiler_agent")
def profiler_agent(state: State):
    profile = load_dataset(state.dataset_path)

    prompt = f"""
    You are the Data Profiler Agent.
    Produce a JSON analysis plan with:
      - task_type: "classification"|"regression"|"eda_only"
      - target_column (if any)
      - eda_steps (list)
      - charts_to_make (list)  # 5-10 max, most informative
      - baseline_model_steps (list if modeling)
      - risks_or_data_issues (list)

    Dataset profile:
    {json.dumps(profile, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    text = resp["generations"][0]["text"]

    try:
        plan = json.loads(text)
    except:
        plan = {"raw_plan": text}

    state.profile = profile
    state.plan = plan
return stateEste agente converte o plano de análise em código Python executável. Ele recebe o perfil do dataset, o plano e qualquer erro de execução anterior. Com esse contexto, pede ao LLM que retorne apenas código Python.
O prompt inclui exigências rígidas: carregar o dataset, seguir o plano à risca, gerar cada gráfico especificado, salvar os plots em ARTIFACTS_DIR, rastrear caminhos e metadados dos gráficos, capturar a saída do console, fechar as figuras após salvar e, opcionalmente, calcular métricas de modelagem.
Isso garante que o código seja reproduzível e seguro no sandbox. O resultado é armazenado em state.code, pronto para execução.
@traceable(name="code_writer_agent")
def code_writer_agent(state: State):
    prompt = f"""
    You are the Code Writer Agent.
    Write Python code ONLY (no markdown).

    Previous error to fix (if any):
    {state.last_error}

    HARD REQUIREMENTS:
    1. Load dataset from: {state.dataset_path}
    2. Follow the plan exactly.
    3. Create ALL charts in charts_to_make.
    4. Save every chart in ARTIFACTS_DIR with filenames like:
         ARTIFACTS_DIR / "chart_01_<short_name>.png"
    5. Track saved plot paths in _artifacts (list[str]).
    6. Track chart metadata in _charts_meta (list[dict]) with:
         {{
           "title": "<human readable chart title>",
           "filename": "artifacts/chart_01_x.png",
           "description": "<what this plot shows (1-2 sentences)>",
           "one_liner": "<ONE line insight from the chart>"
         }}
       The one_liner MUST be a single sentence, max ~20 words.

    7. Store useful console output in _stdout.

    IMPORTANT:
    - import matplotlib.pyplot as plt
    - plt.close() after saving each plot
    - ensure _artifacts and _charts_meta exist even if empty
    - if modeling, add baseline metrics to _stdout

    Dataset profile:
    {json.dumps(state.profile, indent=2)}

    Analysis plan:
    {json.dumps(state.plan, indent=2)}

    Return ONLY executable python code.
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.code = resp["generations"][0]["text"]
return stateEste agente executa o código Python produzido pelo Code Writer usando o sandbox isolado run_python. Ele captura resultados de execução, metadados dos gráficos, saída padrão e quaisquer artefatos criados.
Se o código rodar com sucesso, os resultados são armazenados e o workflow segue normalmente. Se falhar, o agente incrementa o contador de tentativas e guarda o traceback para que o Code Writer corrija o erro na tentativa seguinte.
Com MAX_RETRIES limitando o loop, este agente evita ciclos infinitos e fornece sinais de feedback para autocorreção.
@traceable(name="executor_agent")
def executor_agent(state: State):
    result = run_python(state.code)
    state.exec_result = result
    state.charts_meta = result.get("charts_meta", [])

    if not result["ok"]:
        state.retry_count += 1
        state.last_error = result.get("traceback", "Unknown error")

return stateEste agente interpreta toda a análise. Ele recebe o perfil do dataset, a saída da execução e os metadados dos gráficos e produz insights analíticos em linguagem natural.
Ele instrui o LLM a gerar insights estruturados: para cada gráfico, traga duas observações e um risco; depois, produza um conjunto conciso de insights gerais.
O agente deve garantir que não haja bullets vazios, nem pontos repetidos, e que os insights sejam específicos do dataset, não genéricos.
O relatório de insights resultante é armazenado em state.insights, tornando-se insumo para a etapa final de relatório.
@traceable(name="insights_agent")
def insights_agent(state: State):
    prompt = f"""
    You are the Insights Agent.

    HARD REQUIREMENTS:
    - No empty bullets.
    - No repeated bullets.
    - Be specific to this dataset and these charts.
    - Output format:

      ### Chart Insights
      For each chart in charts_meta:
      - **<title>**
        - Takeaway 1 (one sentence)
        - Takeaway 2 (one sentence)
        - Caveat/Risk (one sentence)

      ### Overall Insights
      - 3-5 bullets max, each one sentence.

    Inputs:
    Profile:
    {json.dumps(state.profile, indent=2)}

    Execution result:
    {json.dumps(state.exec_result, indent=2)}

    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.insights = resp["generations"][0]["text"]
return stateEste é o agente de síntese final. Ele usa toda a saída do pipeline: perfil, insights, metadados dos gráficos, logs de execução e monta um relatório completo e limpo em Markdown.
O prompt impõe regras rígidas de formatação: sem títulos repetidos, espaçamento consistente, cada gráfico exibido exatamente uma vez em um bloco HTML padronizado e insights integrados de forma limpa.
Assim que o Markdown é produzido, o agente chama render_pdf para convertê-lo em um PDF caprichado usando o WeasyPrint. Tanto o Markdown quanto o caminho do PDF são armazenados no estado compartilhado, concluindo o workflow de análise.
@traceable(name="report_agent")
def report_agent(state: State):
    prompt = f"""
    You are the Report Agent.
    Create a neat Markdown report (HTML allowed).

    HARD REQUIREMENTS:
    - Do NOT repeat section titles or chart titles.
    - Do NOT output empty bullet points. If a bullet would be empty, skip it.
    - Keep spacing consistent: one blank line between sections.
    - Use charts_meta as the ONLY source of charts.
    - Include EVERY chart, exactly once, in the same order as charts_meta.
    - For each chart output EXACTLY this block:

      <div class="chart-block">
        <h3>Chart {{i}}: {{title}}</h3>
        <img src="{{filename}}" alt="{{title}}">
        <p><b>What it shows:</b> {{one_liner}}</p>
      </div>

      Where:
      - title, filename, one_liner come from charts_meta
      - one_liner must be ONE sentence, max ~20 words.

    Sections:
    1. Dataset Overview (short)
    2. Data Quality Notes (bullets)
    3. Exploratory Analysis (chart-by-chart blocks only, no extra chart titles)
    4. Modeling Results (if any; use a markdown table)
    5. Key Insights (use insights text)
    6. Recommendations / Next Steps (bullets)

    Inputs:
    Profile: {json.dumps(state.profile, indent=2)}
    Exec stdout: {state.exec_result.get("stdout","")}
    Exec ok: {state.exec_result.get("ok")}
    Traceback (if any): {state.exec_result.get("traceback","")}
    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    Insights:
    {state.insights}

    Return ONLY the Markdown report.
    """

    resp = gemini_call(prompt, thinking_level="low")
    state.report_md = resp["generations"][0]["text"]
    state.report_pdf = render_pdf(state.report_md)
return stateEsta etapa final envolve montar o workflow completo multiagente reunindo todos os agentes em um grafo orientado a estado.
Um StateGraph é criado usando um modelo de State compartilhado, garantindo que cada agente interaja com o mesmo objeto de estado em evolução conforme o workflow avança. Cada componente, como o profiler, o escritor de código, o executor, o escritor de insights e o construtor do relatório, é adicionado ao grafo como um nó distinto, representando uma etapa específica do pipeline.
O workflow sempre começa com o agente profiler, definido como ponto de entrada. Isso garante que o processo se inicie com uma compreensão sólida do dataset e a geração de um plano de análise.
As arestas definem o fluxo do processo. Após o profiling, a saída vai para o escritor de código, que alimenta o executor. A lógica principal está no roteamento condicional a partir do executor.
Uma função auxiliar, retry_or_continue, examina o resultado da execução. Se o código executa com sucesso, o workflow segue para o agente de insights.
Se falhar, mas ainda houver tentativas disponíveis, ele volta ao escritor de código para correção automática.
Se não houver mais tentativas, ele ignora análises adicionais e vai direto para o gerador de relatório, garantindo que o sistema não entre em um loop sem fim. As arestas condicionais são incorporadas ao nó executor para que o workflow se adapte conforme sucesso ou falha da execução.
Por fim, o grafo conecta a etapa de insights à etapa de relatório e, do relatório, à conclusão do workflow. O grafo é então compilado em uma estrutura executável, e um diagrama ASCII é gerado para visualizar o fluxo.
Este grafo multiagente orquestra todo o pipeline de análise adaptativa, permitindo recuperação de erros, coordenação passo a passo e transições suaves entre agentes.
g = StateGraph(State)

g.add_node("profiler", profiler_agent)
g.add_node("code_writer", code_writer_agent)
g.add_node("executor", executor_agent)
g.add_node("insights", insights_agent)
g.add_node("report", report_agent)

g.set_entry_point("profiler")
g.add_edge("profiler", "code_writer")
g.add_edge("code_writer", "executor")

def retry_or_continue(state: State):
    # success path
    if state.exec_result and state.exec_result.get("ok"):
        return "insights"
    # stop retrying after MAX_RETRIES
    if state.retry_count >= MAX_RETRIES:
        return "report"
    return "code_writer"

g.add_conditional_edges(
    "executor",
    retry_or_continue,
    {"code_writer": "code_writer", "insights": "insights", "report": "report"}
)

g.add_edge("insights", "report")
g.add_edge("report", END)

graph = g.compile()

print(graph.get_graph().draw_ascii())
+-----------+
| __start__ |
+-----------+
*
*
*
+----------+
| profiler |
+----------+
*
*
*
+-------------+
| code_writer |
+-------------+
.
.
.
+----------+
| executor |
+----------+
.. ..
.. ..
. ..
+----------+ .
| insights | ..
+----------+ ..
** ..
** ..
* .
+--------+
| report |
+--------+
*
*
*
+---------+
| __end__ |
+---------+ Para rodar o pipeline completo, basta fornecer um caminho de dataset, criar um objeto State inicial e invocar o grafo compilado. No nosso caso, usamos o dataset Boston Housing.
DATASET_PATH = "/work/housing.csv"  # <-- change this

state = State(dataset_path=DATASET_PATH)
out = graph.invoke(state)
Uma vez invocado, o sistema multiagente executa automaticamente toda a análise: perfil do dataset, geração de plano, escrita e execução de código Python, extração de insights e produção de um relatório em Markdown e em PDF.
--- Modeling Baseline Results ---
Dataset Shape: (489, 4)
Linear Regression -> RMSE: 82,395.54, R2: 0.6911
Random Forest     -> RMSE: 56,931.38, R2: 0.8525
Observations: Random Forest typically outperforms Linear Regression due to capturing non-linear relationships (e.g., LSTAT).
Após a execução, você pode abrir o seu painel do LangSmith e navegar até o projeto “autolab-gemini3pro”. Cada execução de agente aparece lá.
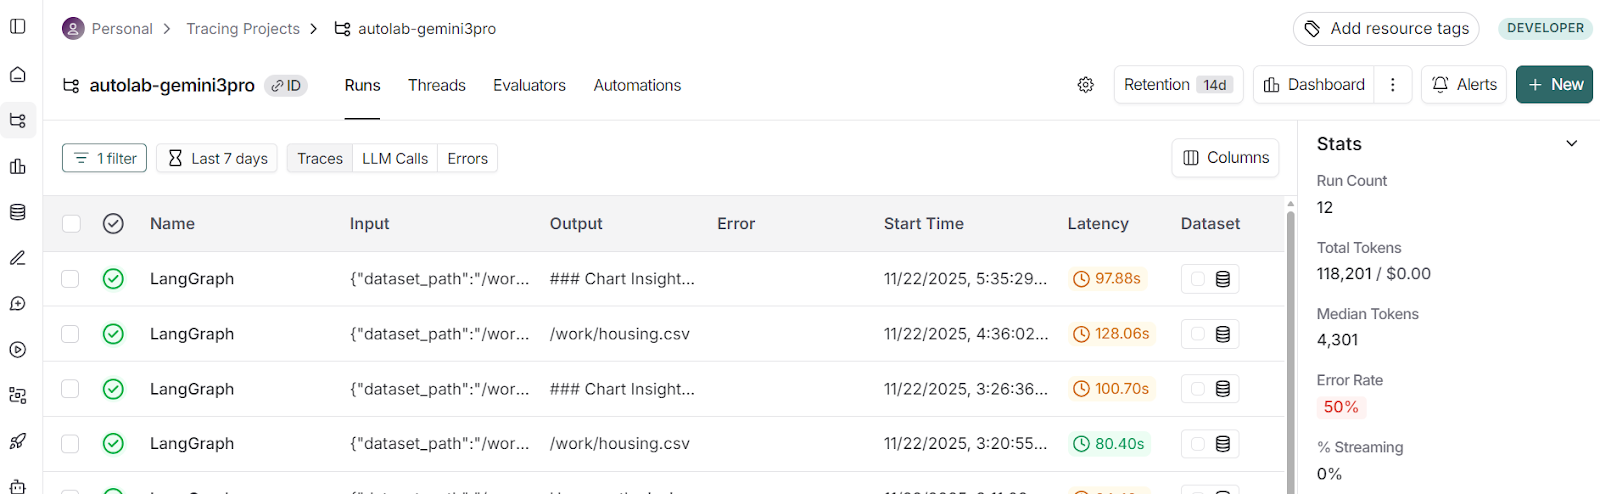
Clicando na execução mais recente e alternando para a visualização Waterfall, você vê a linha do tempo de cada etapa: quanto tempo cada agente levou e quais ferramentas foram usadas.

Você pode clicar em qualquer agente para inspecionar:
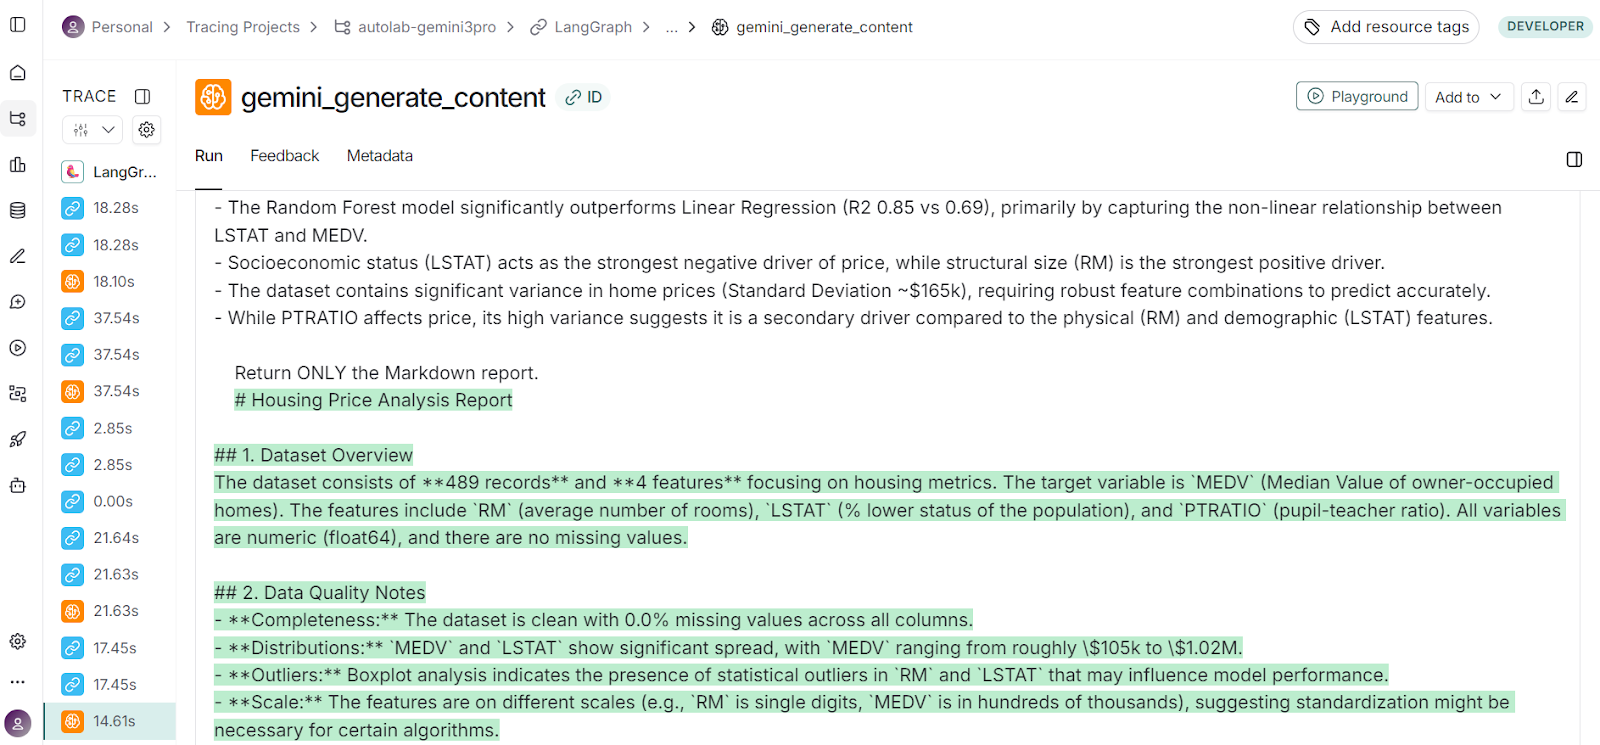
LangSmith foi essencial para melhorar todo o workflow. O que você vê é a versão final, mas foram necessárias muitas tentativas para acertar este projeto, e o LangSmith me ajudou a depurar os problemas nos agentes.
Quando o workflow multiagente termina, você pode inspecionar diretamente o relatório em Markdown gerado no seu notebook.
A versão em Markdown é útil para revisar rapidamente a análise, ler os insights e examinar a estrutura do relatório sem sair do seu ambiente de trabalho.
print(out["report_md"][:2000])# Housing Price Analysis Report
## 1. Dataset Overview
The dataset consists of **489 records** and **4 features** focusing on housing metrics. The target variable is `MEDV` (Median Value of owner-occupied homes). The features include `RM` (average number of rooms), `LSTAT.............Além do Markdown, o workflow também produz um relatório em PDF caprichado. O PDF é salvo automaticamente na pasta de artefatos, e você pode ver o caminho assim:
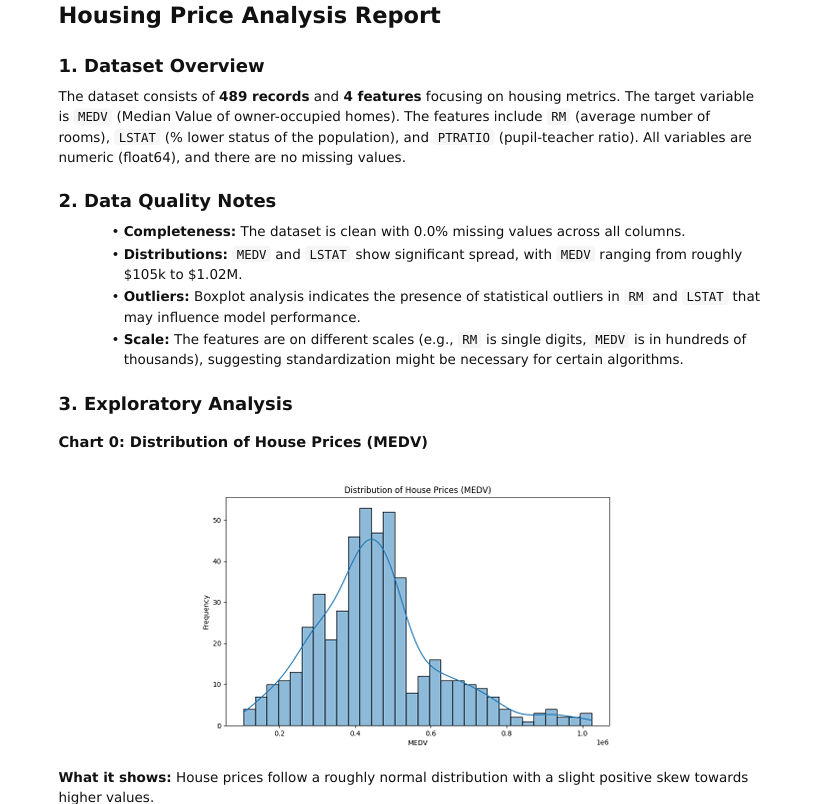
print("PDF saved at:", out["report_pdf"])PDF saved at: artifacts/report.pdfO PDF gerado fica impecável e contém todos os componentes-chave da análise: explicações em texto, gráficos renderizados, interpretações dos gráficos, resumos de modelagem e recomendações finais.
Isso o torna ideal para compartilhar com colegas, gestores ou clientes, especialmente quando você precisa de uma versão limpa e pronta para apresentação dos resultados.
Trabalhar neste projeto deixou claro o quanto os modelos de IA modernos e workflows de agentes baseados em grafos evoluíram. Não faz muito tempo, criar um único agente com várias ferramentas exigia dias de ajustes, depuração e lidar com comportamentos imprevisíveis.
Hoje, com modelos como o Gemini 3 Pro, o sistema consegue entender o dataset, gerar código preciso, rodar análises, interpretar visualizações e montar um relatório polido com uma confiabilidade impressionante.
Neste projeto, construímos uma aplicação completa de análise de dados multiagente capaz de receber qualquer dataset CSV, realizar análise exploratória de ponta a ponta, rodar modelos de baseline, gerar insights e produzir um relatório em PDF totalmente formatado.
Este projeto usa cinco agentes coordenados: profiling e planejamento, geração de código, execução com novas tentativas, geração de insights e relatório, e três ferramentas centrais para carregamento do dataset, execução segura de código e renderização de Markdown para PDF.
O resultado é um fluxo de análise limpo e automatizado que produz um relatório profissional, com narrativa e sustentado por visualizações.
Principais cursos da DataCamp
Curso
Curso
Curso
Tutorial
Tutorial
Moez Ali
12 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
Tutorial
Abid Ali Awan
12 min





