
Leerpad
Basisinfo over lama's
4 uur
Meta’s nieuwste LLaMA 4-modellen, Scout en Maverick, zijn gebouwd voor redeneren met lange context, multimodale interpretatie en efficiënte inferentie op schaal. In combinatie met vLLM, een high-throughput-inferentie-engine met OpenAI-compatibele API’s, worden deze modellen praktisch voor toepassingen in de echte wereld.
In deze blogpost laat ik je zien hoe je LLaMA 4 Scout implementeert op een multi-GPU RunPod-instance met vLLM en hoe je het serveert via een lokale of externe OpenAI-compatibele API-endpoint. We behandelen de modelsetup, implementatie en API-interactie met zowel tekst- als beeldinvoer.
Aan het einde van deze tutorial heb je ook twee volledige demo’s:
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week samenvat. Abonneer je en blijf scherp in een paar minuten per week:
vLLM (virtual large language model) is een geoptimaliseerd LLM-inferentiekader dat oorspronkelijk is ontwikkeld in UC Berkeley’s Sky Computing Lab. Het introduceert PagedAttention, een nieuw geheugensysteem dat GPU-geheugenfragmentatie minimaliseert en efficiënte key-value caching mogelijk maakt voor extreem lange sequenties. Lees meer in deze tutorial over vLLM.
Dit is waarom vLLM de ideale engine is om LLaMA 4 te serveren:
In deze sectie lopen we door hoe je een krachtige multi-GPU-instance op RunPod inricht, Meta’s LLaMA 4 Scout-model met vLLM implementeert en een OpenAI-compatibele API blootstelt voor zowel lokale als externe inferentie.
Zorg voordat je het model start dat je RunPod-account is ingesteld:
Laten we nu een pod inrichten die het 17B LLaMA 4 Scout-model kan hosten:
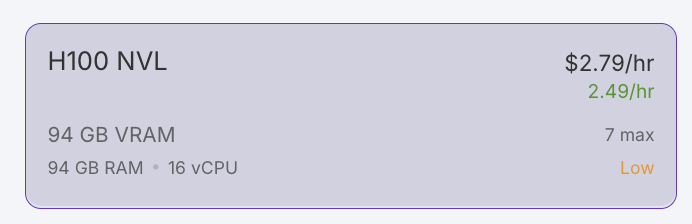
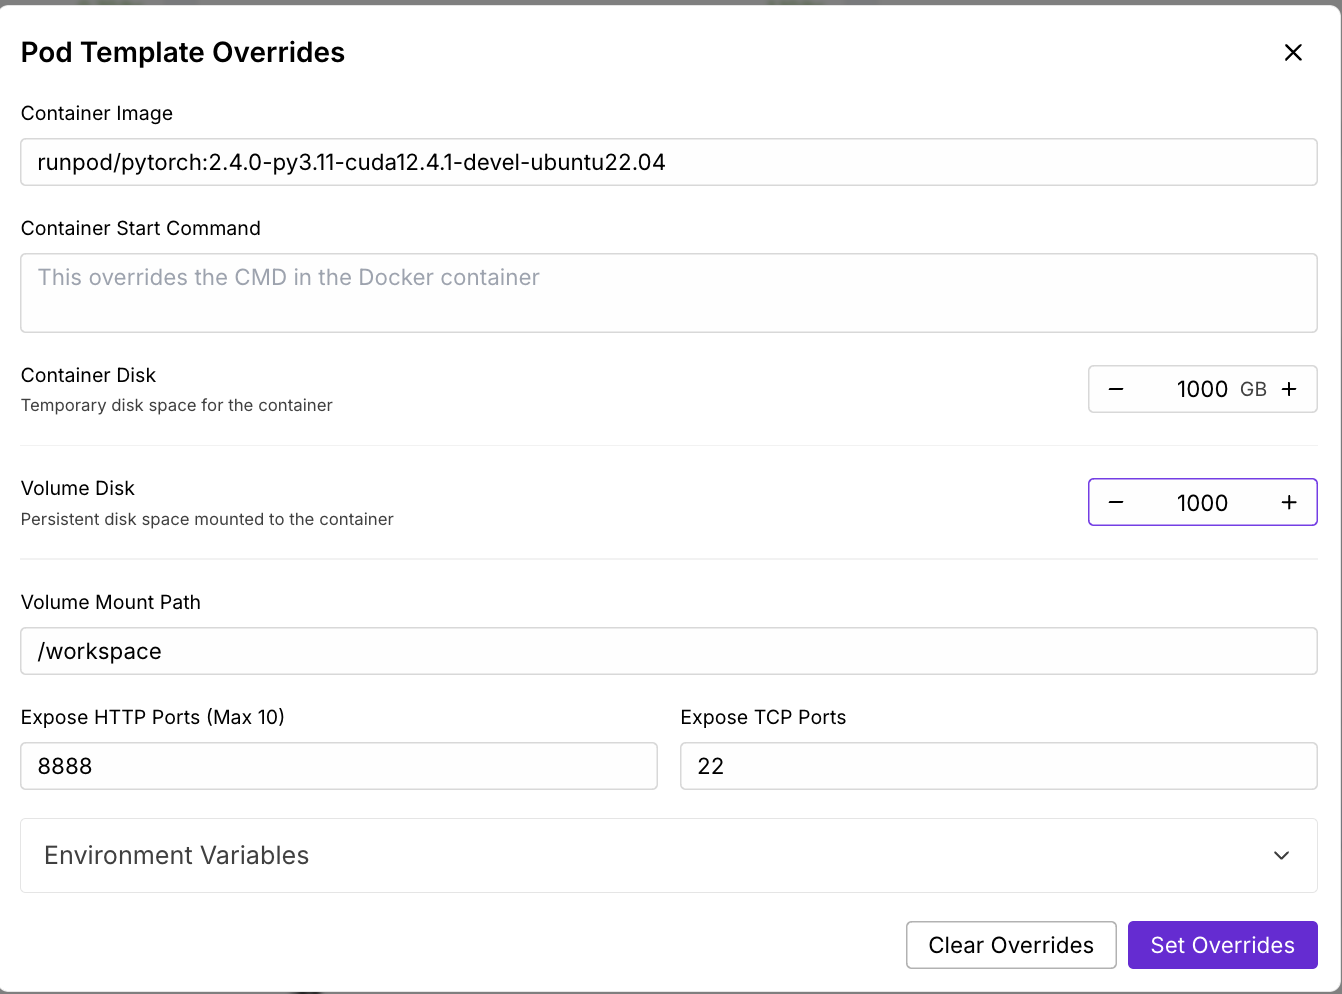
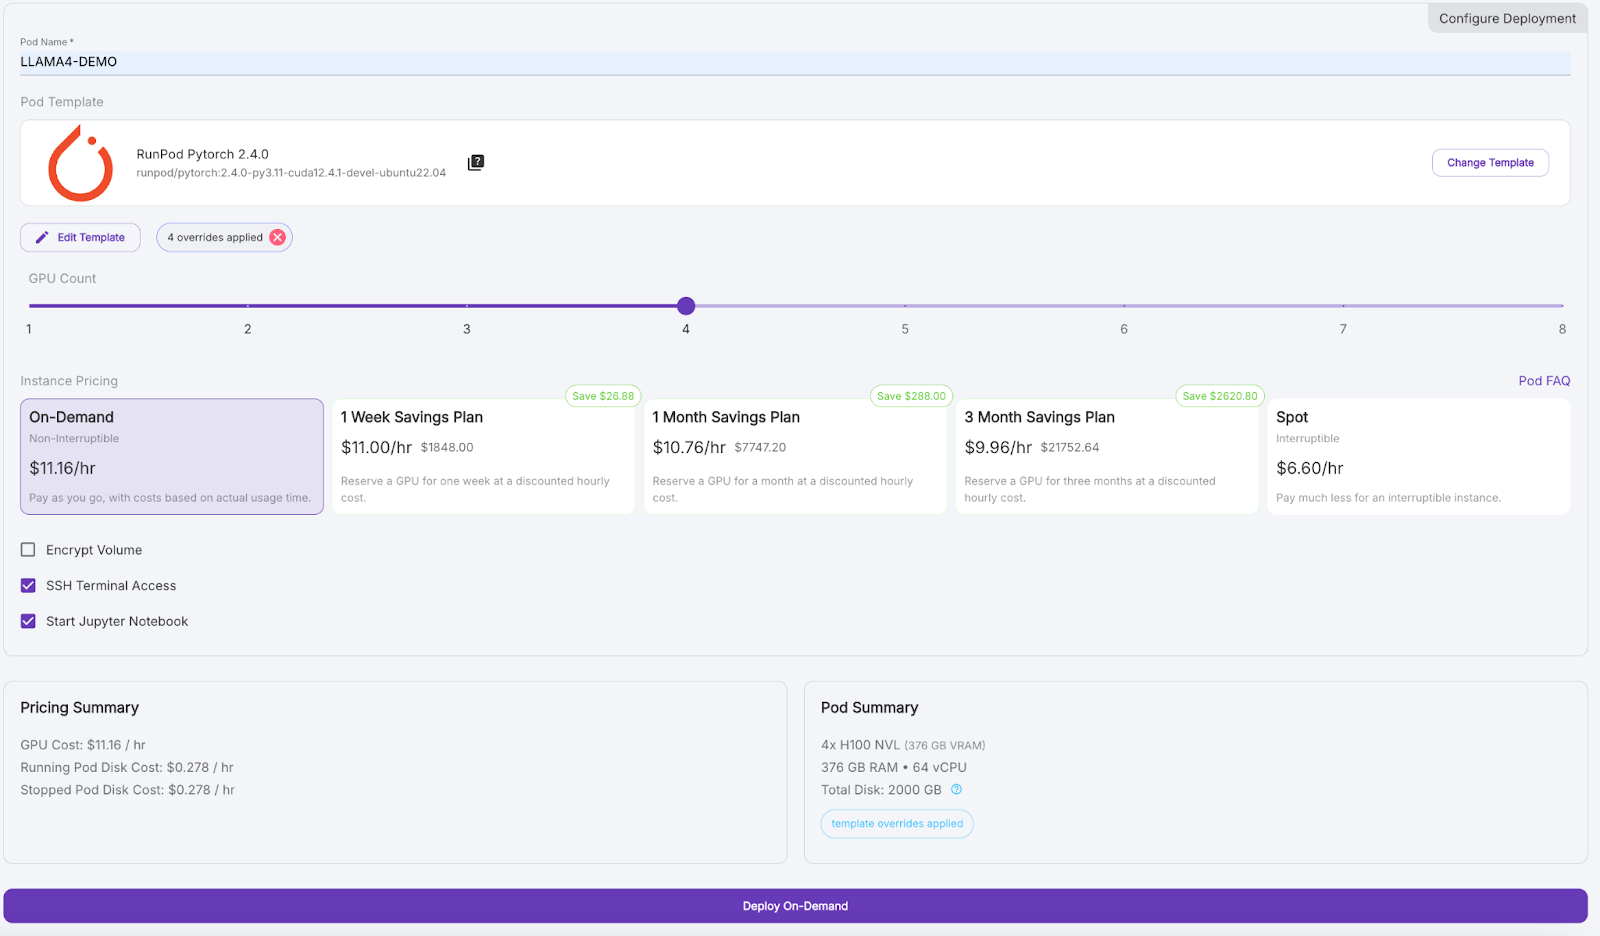
Wacht een paar minuten tot de pod is ingericht.
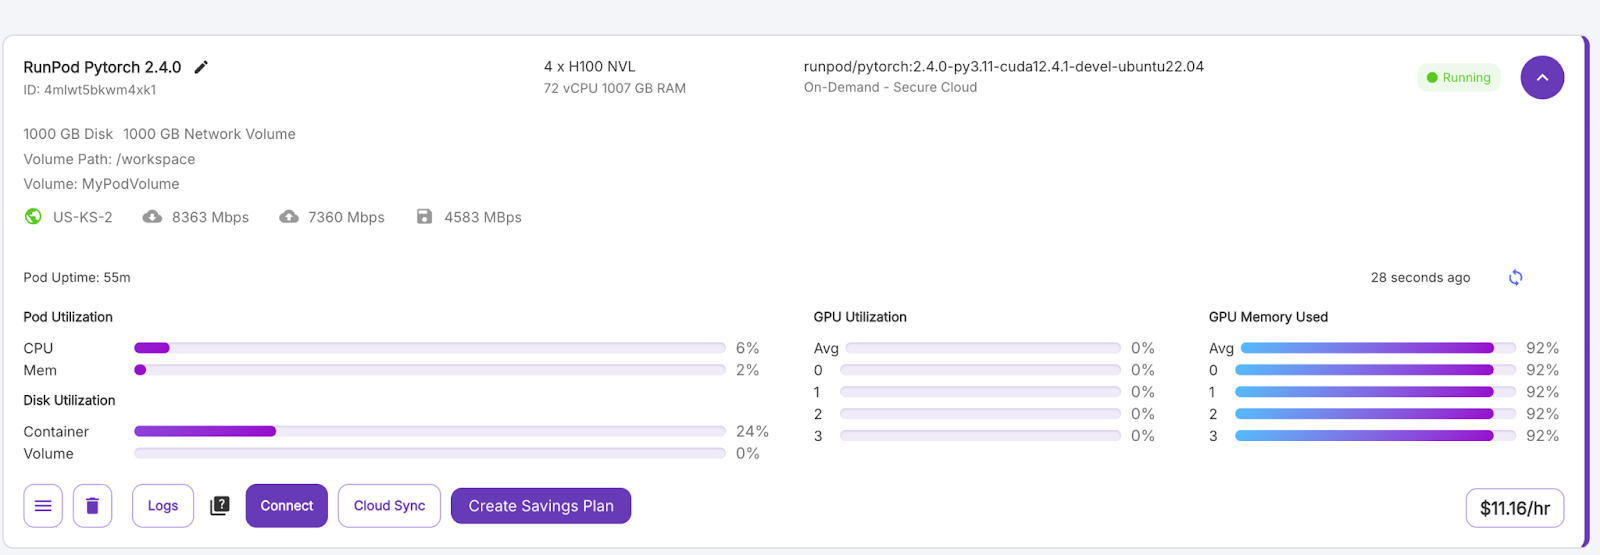
Zodra de knop “Connect” paars wordt, klik je erop. Je ziet meerdere verbindingsopties—je kunt ofwel:
Installeer in de terminal binnen je pod vLLM en de afhankelijkheden. Installeer vLLM en andere libraries binnen de pod-omgeving.
pip install -U vllm
pip install transformers accelerate pillow #optionalVervolgens starten we de LLaMA 4 Scout-modelserver met het volgende commando:
VLLM_DISABLE_COMPILE_CACHE=1 vllm serve meta-llama/Llama-4-Scout-17B-16E-Instruct \
--tensor-parallel-size 4 \
--max-model-len 100000 --override-generation-config='{"attn_temperature_tuning": true}'
Dit commando doet het volgende:
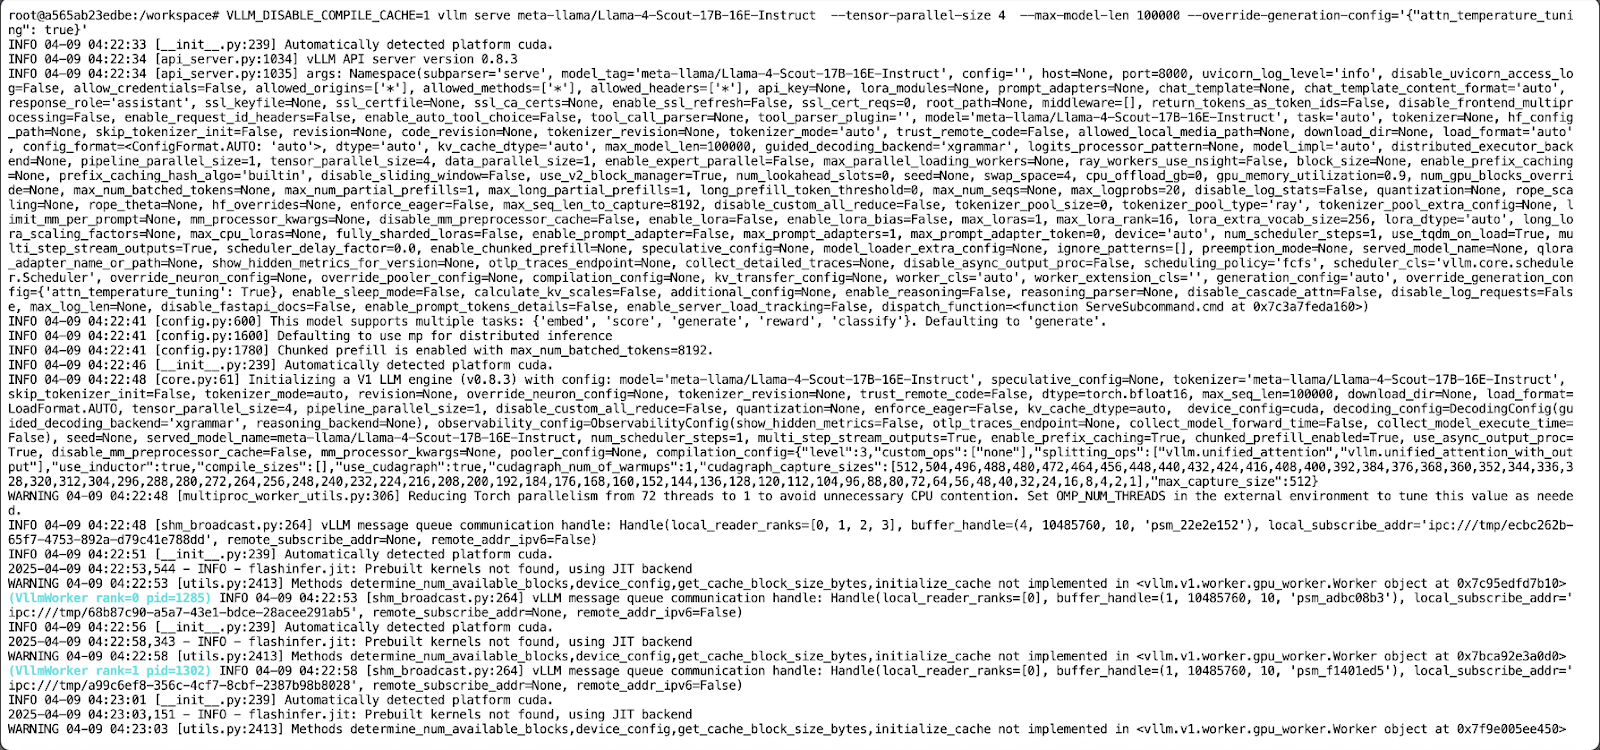
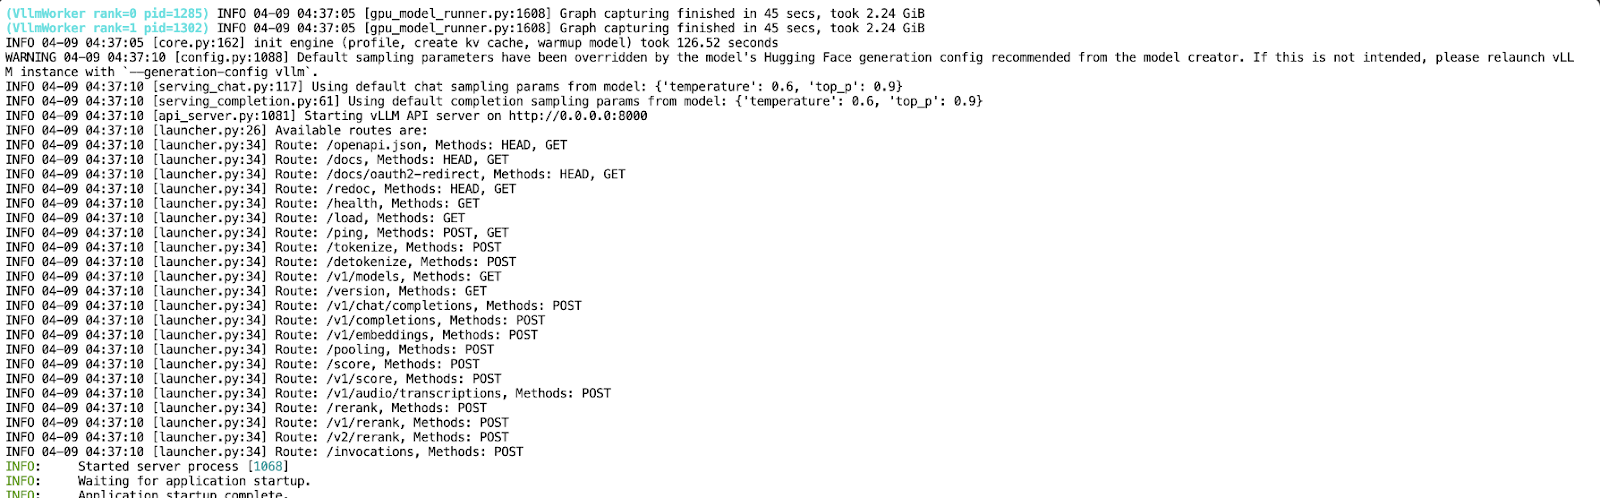
Nu je API op poort 8000 draait, maak je een nieuw Jupyter Notebook aan in dezelfde pod-omgeving.
In deze demo gaan we interageren met het lokaal gehoste LLaMA 4 Scout-model dat via vLLM wordt geserveerd met een eenvoudig Python-script. Het model is via een API beschikbaar, waardoor we een conversatie-assistent kunnen bouwen die multi-turn-dialogen ondersteunt.
We gebruiken de officiële OpenAI Python SDK om met de vLLM-API te communiceren en de Colorama-library voor gekleurde terminaluitvoer. Je kunt beide installeren met:
pip install openai coloramaImporteer na installatie de benodigde modules:
from openai import OpenAI
from colorama import Fore, Style, initWe configureren de OpenAI-client om te verwijzen naar onze lokaal draaiende vLLM-server. Als je implementatie geen API-sleutel vereist (de standaard voor lokale runs), geef je "EMPTY" door als sleutel:
# Initialize colorama
init(autoreset=True)
# Set up client
openai_api_key = "EMPTY"
openai_api_base = "http://localhost:8000/v1"
client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)
Deze code initialiseert de Colorama-library voor gekleurde terminaluitvoer met automatische reset na elke print. Daarna wordt een OpenAI-compatibele client opgezet met de OpenAI-klasse, gericht op een lokaal gehoste vLLM-API.
Stap 3: Start de chatloop
Vervolgens implementeren we een eenvoudige lus voor continue interactie met het model. De gespreksgeschiedenis blijft bewaard over beurten heen, zodat multi-turn-gedrag mogelijk is.
# Initialize message history
messages = [
    {"role": "system", "content": "You are a helpful assistant."}
]
print("Start chatting with the assistant! Type 'exit' or 'quit' to end.\n")
while True:
    user_input = input(f"{Fore.BLUE}User: {Style.RESET_ALL}")
    if user_input.strip().lower() in ["exit", "quit"]:
        print("Exiting chat. Goodbye!")
        break
    messages.append({"role": "user", "content": user_input})
    chat_response = client.chat.completions.create(
        model="meta-llama/Llama-4-Scout-17B-16E-Instruct",
        messages=messages,
    )
    assistant_message = chat_response.choices[0].message.content
    print(f"{Fore.GREEN}Assistant: {assistant_message}\n{Style.RESET_ALL}")
    messages.append({"role": "assistant", "content": assistant_message})
Er wordt een eenvoudige, terminalgebaseerde chatinterface geïnitialiseerd met een gespreksgeschiedenis en een system prompt, die continu gebruikersinvoer in een lus accepteert. Elk gebruikersbericht wordt aan de geschiedenis toegevoegd en verzonden naar het Llama-4-Scout-17B-16E-Instruct-model via de client.chat.completions.create()-API-aanroep.
De reactie van het model wordt in het groen afgedrukt met Colorama en terug aan de geschiedenis toegevoegd, zodat een multi-turn-dialoog mogelijk is totdat de gebruiker "exit" of "quit" typt.
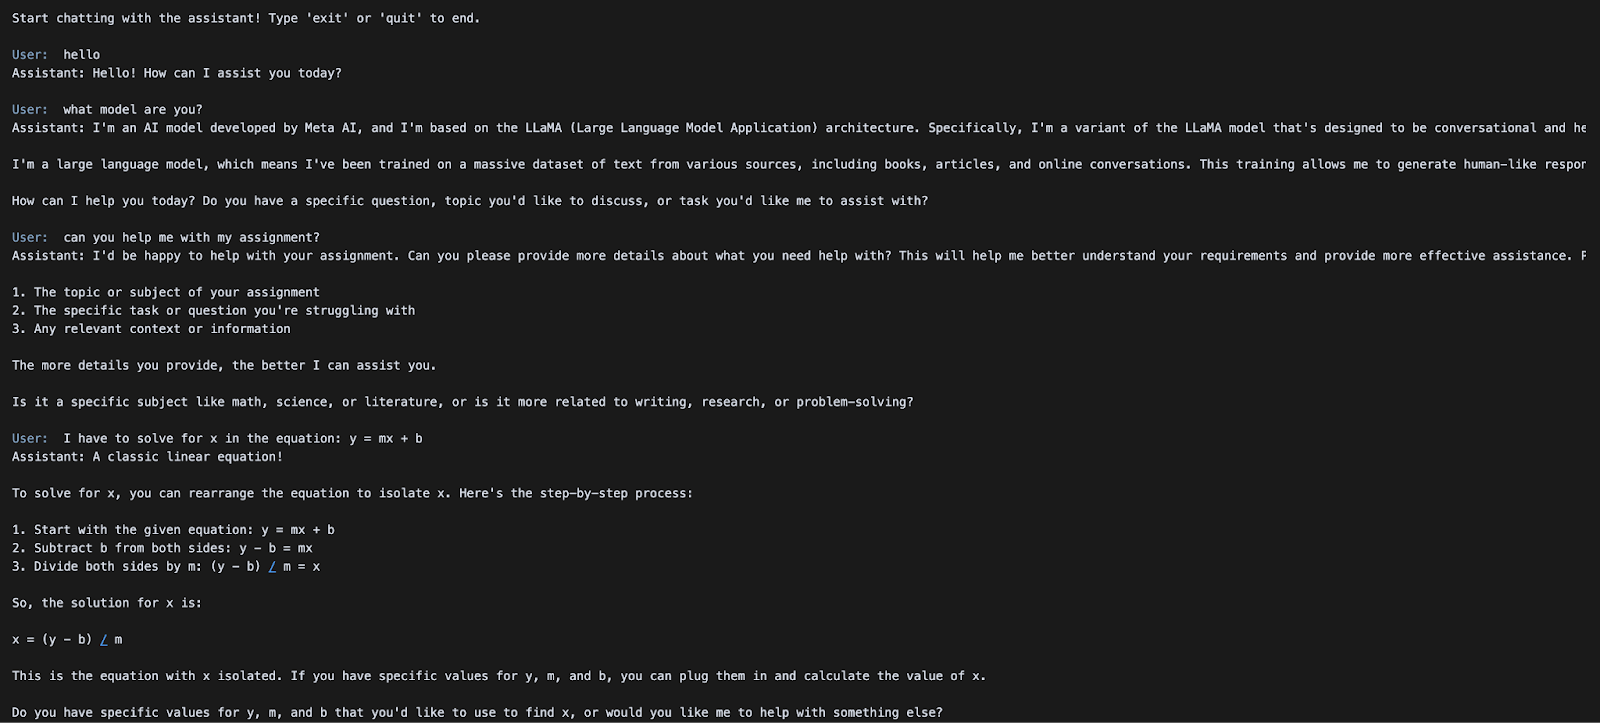
In de volgende sectie bekijken we hoe je multimodale inferentie met beeld + tekst-invoer draait met dezelfde API.
In deze demo laten we zien hoe je zowel beeld- als tekstinvoer naar het LLaMA 4 Scout-model stuurt dat via vLLM wordt gehost, met gebruik van de native multimodale mogelijkheden. Hiermee kun je visueel redeneren, afbeeldingsbijschriften genereren of multimodale Q&A uitvoeren—allemaal via één OpenAI-compatibele API.
In dit voorbeeld gebruiken we de OpenAI SDK om met de vLLM-server te communiceren. Als deze nog niet is geïnstalleerd, kun je uitvoeren:
pip install openaiImporteer vervolgens de vereiste module:
from openai import OpenAIVerbind met je lokale vLLM-server via de OpenAI-compatibele interface. Als je server geen authenticatie vereist, gebruik dan "EMPTY" als API-sleutel.
openai_api_key = "EMPTY"
openai_api_base = "http://localhost:8000/v1"
client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)
Bovenstaande code initialiseert een OpenAI-compatibele client voor lokale inferentie via de vLLM-server. De api_key is ingesteld op "EMPTY" (geen authenticatie vereist) en base_url wijst naar het lokale vLLM API-endpoint.
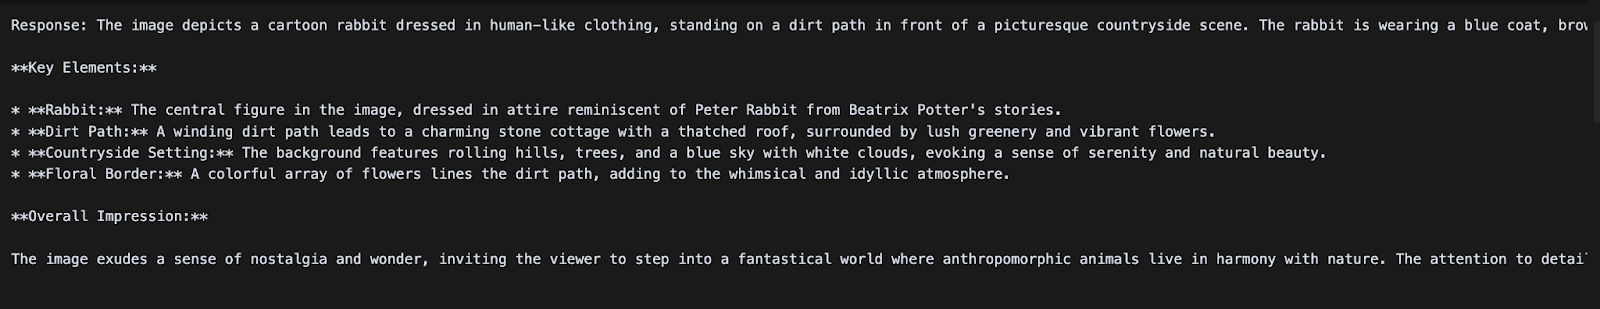
We sturen nu een chatprompt die zowel een afbeelding als een tekstinstructie bevat. LLaMA 4 Scout verwerkt de afbeelding samen met de vraag en geeft een beschrijvend antwoord.
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image_url", "image_url": {"url": image_url1}},
            {"type": "text", "text": "Can you describe what's in this image?"}
        ]
    }
]
chat_response = client.chat.completions.create(
    model="meta-llama/Llama-4-Scout-17B-16E-Instruct",
    messages=messages,
)
print("Response:", chat_response.choices[0].message.content)
Zodra de multimodale inferentie met het LLaMA 4 Scout-model draait, construeren we een chatstijl-invoer met zowel een afbeeldings-URL als een tekstprompt, geformatteerd volgens het OpenAI-chatchema. De methode client.chat.completions.create() wordt gebruikt om dit multimodale verzoek naar het model te sturen, dat de afbeelding en begeleidende tekst verwerkt om een contextueel antwoord te genereren.
In deze tutorial hebben we Meta’s LLaMA 4 Scout-model gehost met vLLM op RunPod, en het toegankelijk gemaakt via OpenAI-compatibele endpoints voor zowel tekst- als multimodale inferentie. Door de hoge doorvoer van vLLM te combineren met de krachtige infrastructuur van RunPod, hebben we een kosteneffectieve setup gecreëerd om state-of-the-art LLM’s met lange context en visiemogelijkheden te serveren.
Meer weten over LLaMA 4 en vLLM? Bekijk:
Leer AI met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

