

Cursus
Werken met Llama 3
2 uur
15.8K
Oefen en volg je voortgang.
Ga Verder Met GoogleMeta heeft zojuist de Llama 4-suite van modellen aangekondigd, met daarin twee uitgebrachte modellen—Llama 4 Scout en Llama 4 Maverick—en een derde die nog in training is: Llama 4 Behemoth.
De varianten Scout en Maverick zijn nu beschikbaar, openlijk uitgebracht onder Meta’s gebruikelijke open-weight-licentie—met één opvallende kanttekening: als je diensten meer dan 700 miljoen maandelijkse actieve gebruikers hebben, moet je een aparte licentie van Meta verkrijgen, die al dan niet naar eigen goeddunken wordt verleend.
Llama Scout ondersteunt een contextvenster van 10 miljoen tokens, het grootste van alle publiek uitgebrachte modellen. Llama Maverick is een generalistisch model en richt zich op GPT-4o, Gemini 2.0 Flash en DeepSeek-V3. Llama Behemoth, nog in training, dient als een high-capacity teachermodel.
In deze introductieblog geef ik je een overzicht van de Llama 4-suite. Ons team heeft het model al getest, en ik raad deze tutorials aan als je je kennis wilt uitbreiden:
Update: Na ongeveer een jaar stilte heeft Meta zijn nieuwste LLM uitgebracht. Voor een overzicht, bekijk onze gids over Muse Spark.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagse nieuwsbrief die de belangrijkste verhalen van de week uitpluist. Abonneer je en blijf scherp in slechts een paar minuten per week:
Llama 4 is Meta’s nieuwe familie van grote taalmodellen. De release omvat twee modellen die al beschikbaar zijn—Llama 4 Scout en Llama 4 Maverick—en een derde, Llama 4 Behemoth, die nog in training is.
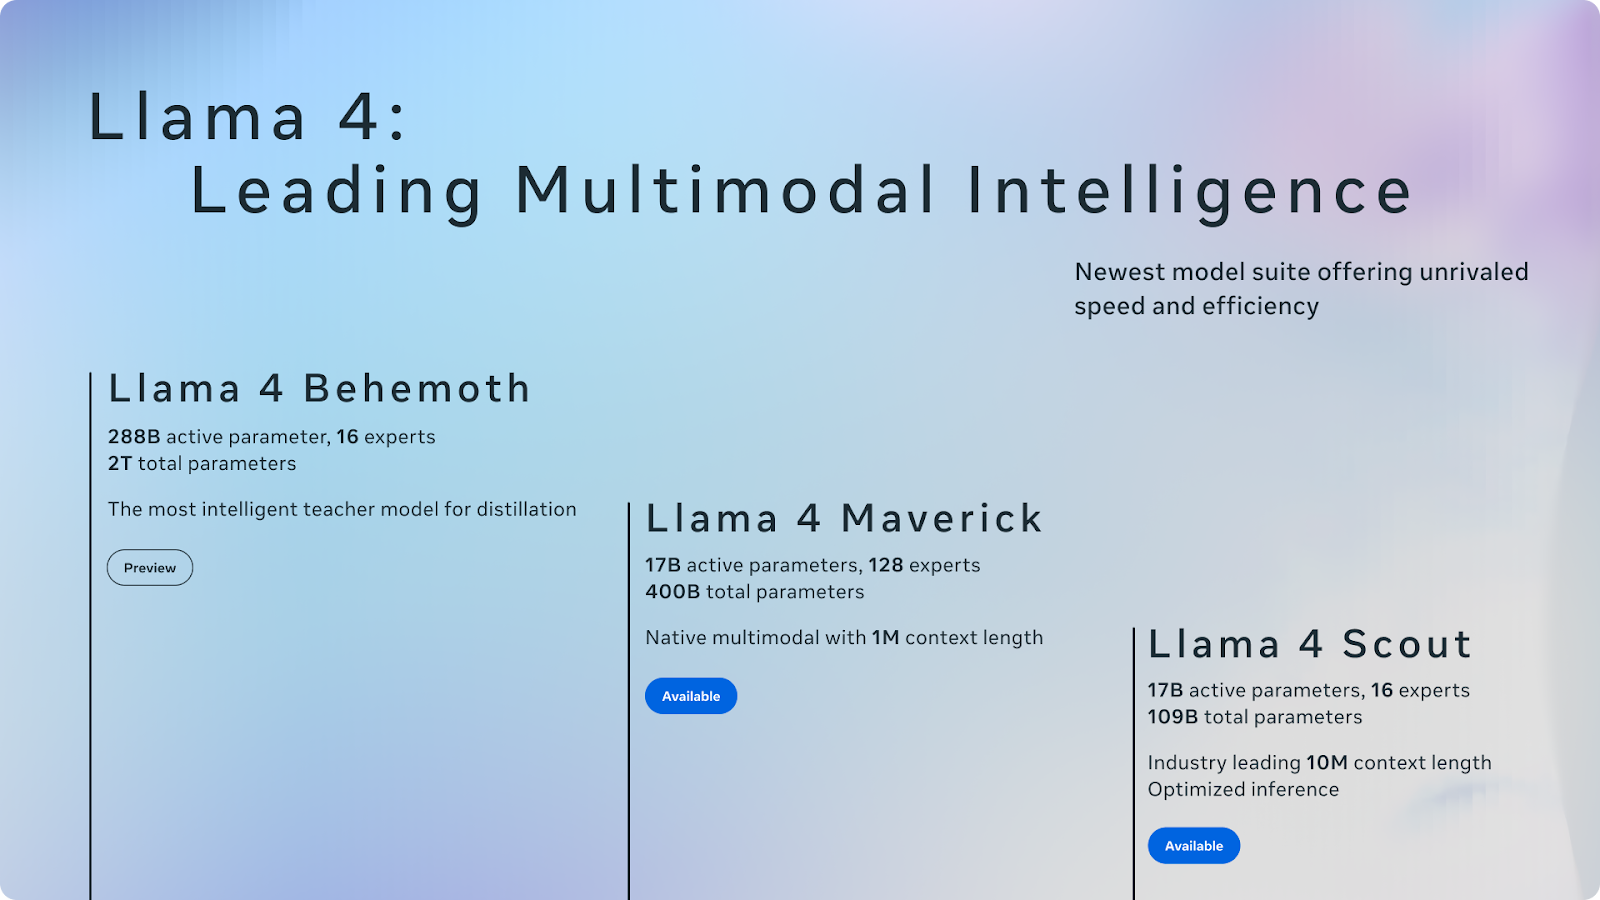
Bron: Meta AI
Llama 4 introduceert substantiële verbeteringen. Met name bevat het een mixture-of-experts (MoE)-architectuur, bedoeld om de efficiëntie en prestaties te verbeteren door alleen de noodzakelijke componenten voor specifieke taken te activeren (straks meer hierover). Dit ontwerp markeert een verschuiving naar meer schaalbare en gespecialiseerde AI-modellen.
Llama 4 zet Meta’s strategie voort om open-weight-modellen uit te brengen—maar met een kanttekening. Als je bedrijf diensten aanbiedt met meer dan 700 miljoen maandelijkse actieve gebruikers, heb je een aparte licentie van Meta nodig, die mogelijk wel of niet wordt verleend. Los van die beperking voelt de release nog steeds als een groot moment in het open-weight-landschap, al is dat landschap de afgelopen maanden snel veranderd.
Als Llama 2 en 3 ooit de categorie bepaalden, dan komt Llama 4 nu binnen in een veel competitiever veld. DeepSeek is verschenen met sterke redeneercapaciteiten. Alibaba’s Qwen-serie presteert goed op meertalige en code-benchmarks. Google’s Gemma-modellen betreden dezelfde ruimte met kleinere, efficiënte architecturen. En nog maar enkele dagen geleden kondigde OpenAI plannen aan om een open-weight-model uit te brengen, een verschuiving die een jaar geleden onwaarschijnlijk leek.
Laten we meer details over elk model bekijken.
Llama 4 Scout is het lichtere model in de nieuwe suite, maar misschien wel het meest intrigerend. Het draait op één H100-GPU en ondersteunt een contextvenster van 10 miljoen tokens. Daarmee is Scout het meest contexthongerige open-weight-model tot nu toe en mogelijk het meest bruikbaar voor taken als samenvatten van meerdere documenten, langvormig redeneren over code en het parseren van activiteiten.
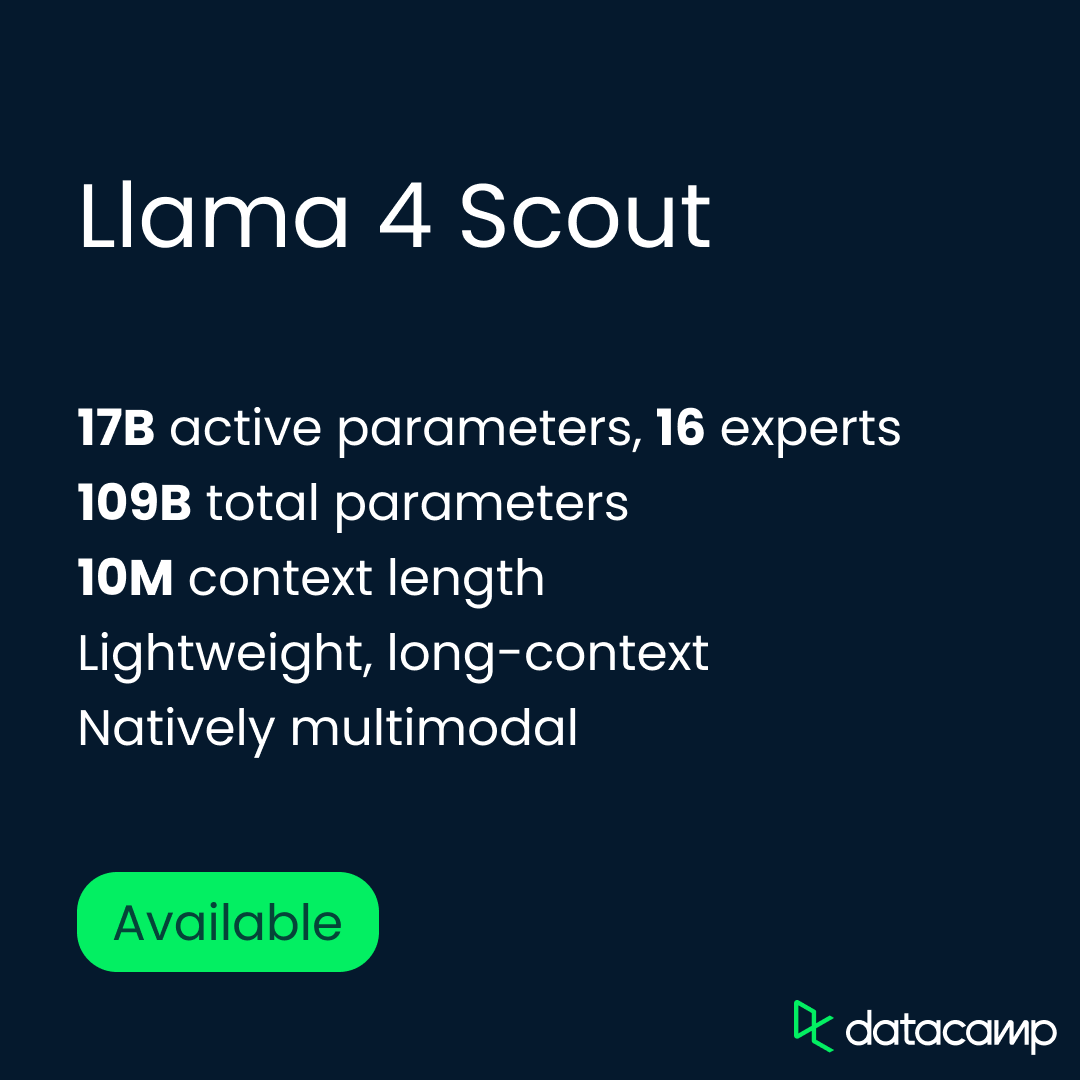
Scout heeft 17 miljard actieve parameters, georganiseerd via 16 experts, met in totaal 109 miljard parameters. Het is voorgetraind en nageschoold met een contextvenster van 256K, maar Meta zegt dat het daar ver voorbij goed generaliseert (die claim moet nog getest worden). In de praktijk opent dit de deur naar workflows met complete codebases, sessiegeschiedenissen of juridische documenten—allemaal verwerkt in één forward pass.
Qua architectuur is Scout gebouwd met Meta’s mixture-of-experts (MoE)-raamwerk, waarbij per token slechts een subset van parameters wordt geactiveerd—in tegenstelling tot dichte modellen zoals GPT-4o, waarbij alle parameters worden geactiveerd. Dat betekent dat het zowel rekenefficiënt als zeer schaalbaar is.
Los van de kernarchitectuur benadrukte Meta de multimodale capaciteiten van Scout. Het is voorgetraind op tekst-, beeld- en videogegevens met early fusion, waardoor het combinaties van tekst- en visuele prompts van nature aankan. Bij beeldintensieve taken zoals visual grounding en VQA (visual question answering) presteert Scout beter dan elk eerder Llama-model—en kan het zich meten met veel grotere systemen.
Kortom, Scout is gebouwd voor breedte en schaal. Het is ontworpen om efficiënt te draaien, meer input te verwerken dan enig eerder open model, en goed te presteren bij zowel tekst- als beeldtaken. We gaan die 10M-contextlimiet snel testen—en komen erop terug.
Llama 4 Maverick is de generalist van de reeks—een grootschalig, multimodaal model dat is gebouwd voor prestaties bij chat, redeneren, beeldbegrip en code. Terwijl Scout de grenzen van de contextlengte oprekt, richt Maverick zich op gebalanceerde, hoogwaardige output over taken heen. Het is Meta’s antwoord op GPT-4o, DeepSeek-V3 en Gemini 2.0 Flash.
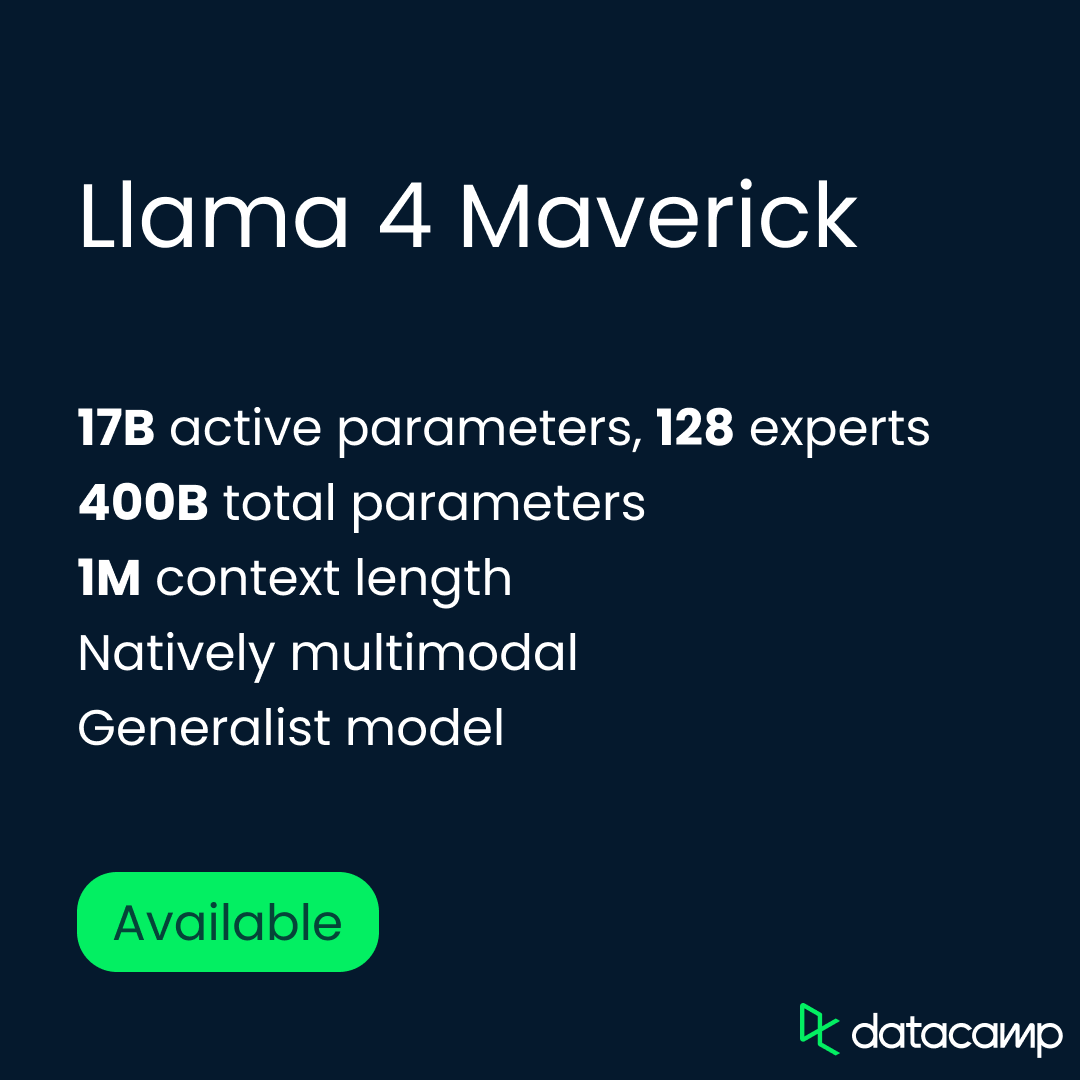
Maverick heeft net als Scout 17 miljard actieve parameters, maar met een grotere MoE-configuratie: 128 experts en een totaal van 400 miljard parameters. Net als Scout gebruikt het een mixture-of-experts-architectuur, die slechts een deel van het model per token activeert—waardoor de inferentiekosten dalen terwijl de capaciteit schaalt. Het model draait op één H100 DGX-host, maar kan ook met gedistribueerde inferentie worden ingezet voor grootschaliger toepassingen.
Meta koos hier voor een andere aanpak van natraining, met een mix van lichtgewicht, begeleid fine-tunen, online reinforcement learning en direct preference optimization. Doel was om de prestaties op moeilijke prompts aan te scherpen zonder het model te veel te beknotten. Daarvoor filterde Meta meer dan 50% van de trainingsvoorbeelden weg die door eerdere Llama-modellen als “makkelijk” waren aangemerkt en bouwde het een curriculum dat zwaarder inzette op lastig redeneren, coderen en multimodale taken.
Maverick is ook mede-gedistilleerd uit Llama 4 Behemoth, Meta’s veel grotere interne model, wat hielp de prestaties te verhogen zonder extra trainingskosten. Volgens Meta zorgde deze distillatiepijplijn voor een merkbare sprong in redeneer- en chatkwaliteit.
Llama 4 Behemoth is Meta’s krachtigste en grootste model tot nu toe—maar het is nog niet beschikbaar. Nog in training, en geen redeneermodel in dezelfde zin als DeepSeek-R1 of OpenAI’s o3, die zijn gebouwd en geoptimaliseerd voor meerstaps chain-of-thought-taken.
Op basis van wat we tot nu toe weten, lijkt het ook niet ontworpen als product voor direct gebruik. In plaats daarvan fungeert het als teachermodel, gebruikt om te distilleren en zowel Scout als Maverick te vormen. Eenmaal uitgebracht zou het anderen ook in staat kunnen stellen hun eigen modellen te distilleren.
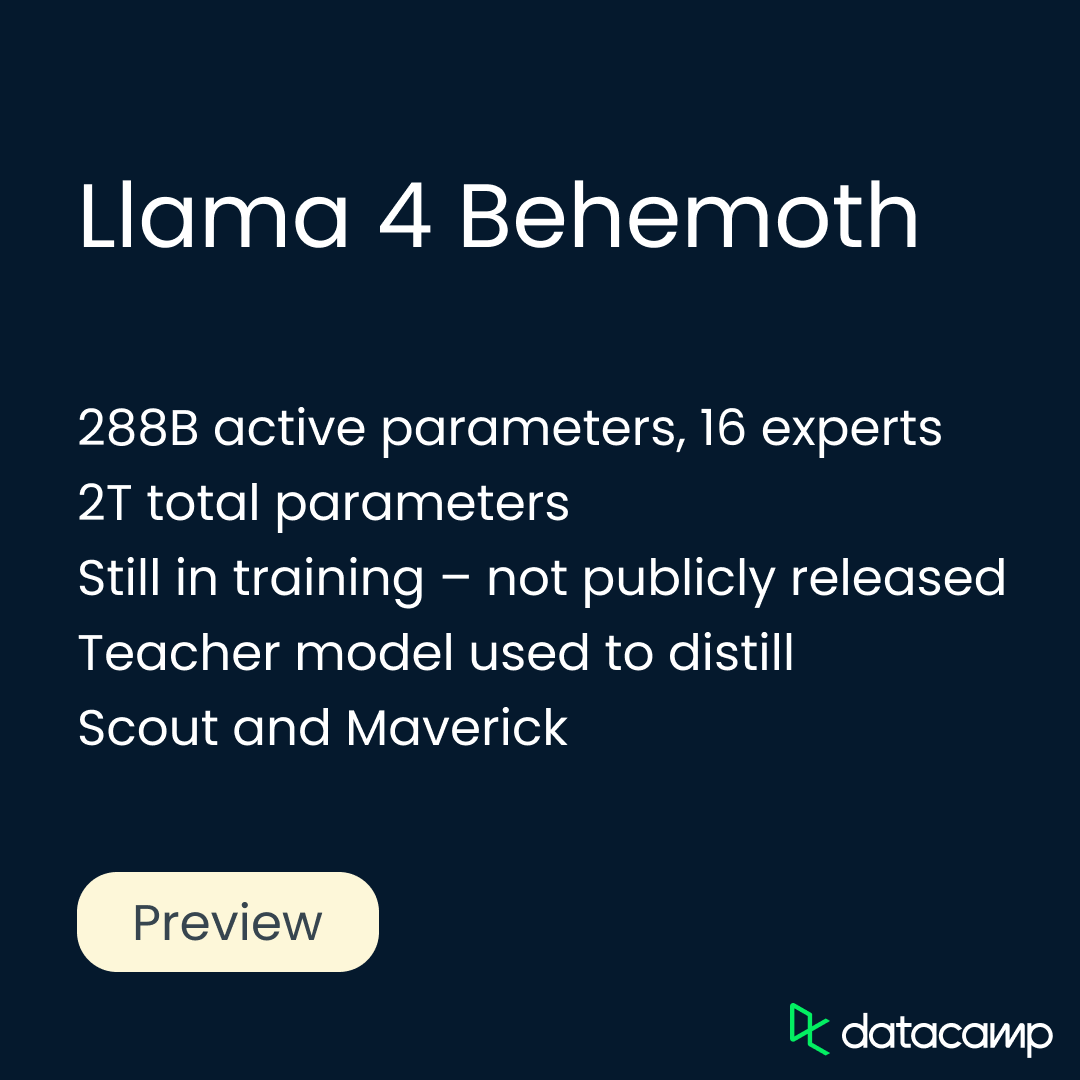
Behemoth heeft 288 miljard actieve parameters, georganiseerd via 16 experts, met een totaal aantal parameters dat bijna 2 biljoen bereikt. Meta bouwde een geheel nieuwe trainingsinfrastructuur om Behemoth op deze schaal te ondersteunen. Het introduceerde asynchrone reinforcement learning, curriculum-sampling op basis van promptmoeilijkheid en een nieuwe distillatiedoelfunctie die soft en hard targets dynamisch in balans brengt.
Ook voor natraining had Behemoth een ander recept nodig. Meta verwierp meer dan 95% van de SFT-voorbeelden om zich te richten op moeilijke prompts en focuste reinforcement learning op complexe redenering, coderen en meertalige scenario’s. Sampling van uiteenlopende systeeminstructies hielp het model generaliseren, terwijl dynamische filtering prompts met lage waarde verwijderde tijdens RL-training.
Meta heeft interne benchmarkresultaten vrijgegeven voor elk van de Llama 4-modellen, vergeleken met zowel eerdere Llama-varianten als verschillende concurrerende open-weight- en frontier-modellen.
In deze sectie neem ik je mee door de benchmarkhoogtepunten voor Scout, Maverick en Behemoth, op basis van Meta’s eigen cijfers. Zoals altijd raad ik voorzichtigheid aan met zelfgerapporteerde benchmarks—maar deze scores bieden een nuttige eerste indruk van hoe elk model presteert bij verschillende taken en waar ze staan in het huidige landschap. Laten we beginnen met Scout.
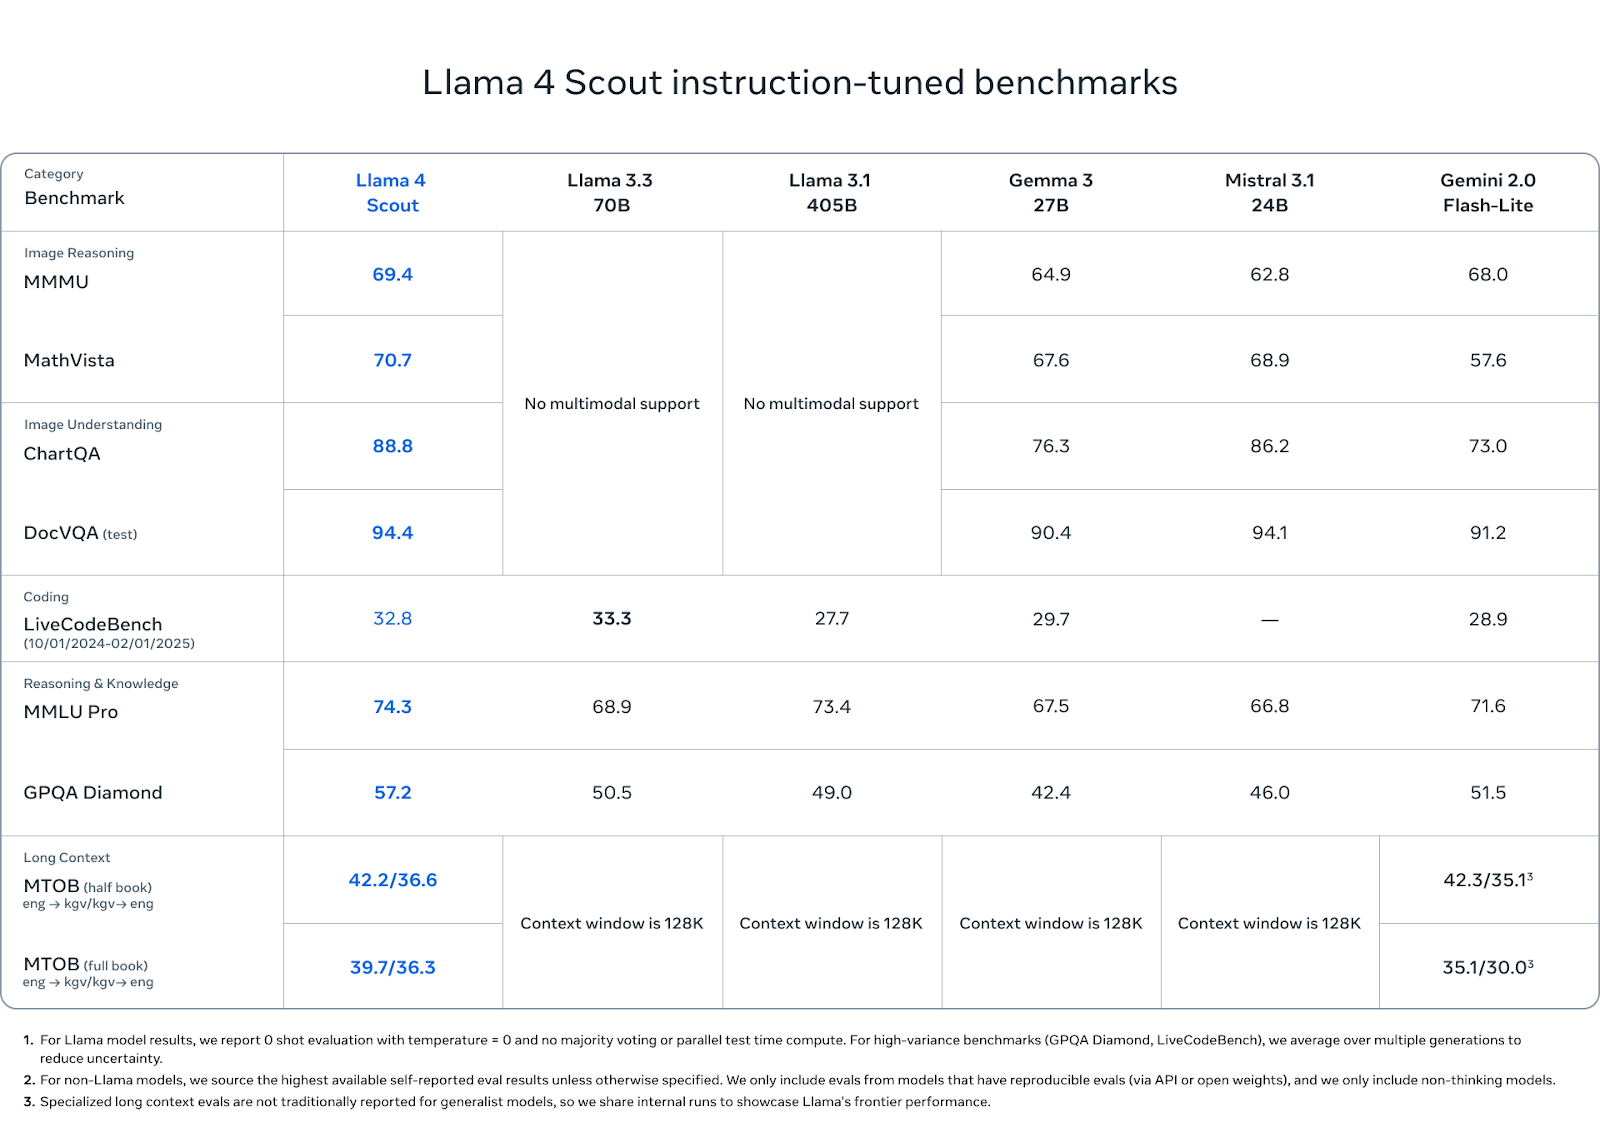
Llama 4 Scout presteert goed over een mix van redeneer-, code- en multimodale benchmarks—zeker gezien het kleinere aantal actieve parameters en de footprint op één GPU.
Bron: MetaAI
Bij beeldbegrip verslaat Scout de concurrentie nipt: het scoort 88,8 op ChartQA en 94,4 op DocVQA (test), beter dan Gemini 2.0 Flash-Lite (respectievelijk 73,0 en 91,2) en gelijk of iets beter dan Mistral 3.1 en Gemma 3 27B.
Op beeldredenering-benchmarks zoals MMMU (69,4) en MathVista (70,7) voert het ook de open-weight-klasse aan, en presteert het beter dan Gemma 3 (64,9; 67,6), Mistral 3.1 (62,8; 68,9) en Gemini Flash-Lite (68,0; 57,6).
Bij coderen scoort Scout 32,8 op LiveCodeBench, boven Gemini Flash-Lite (28,9) en Gemma 3 27B (29,7), maar net onder Llama 3.3 met 33,3. Het is geen model dat primair op code is gericht, maar het staat zijn mannetje.
Op kennis en redeneren behaalt Scout 74,3 op MMLU Pro en 57,2 op GPQA Diamond, beter dan elk ander open-weight-model op beide. Deze benchmarks belonen langvormig meerstapsredeneren, dus Scouts sterke prestaties hier zijn opvallend, zeker op deze schaal.
Tot slot tonen de langcontext-capaciteiten van Scout echt potentieel. Op MTOB (Massive Textual Overlap Benchmark), dat het vermogen van het model test om tussen Engels en KGV, een taal met weinig middelen, te vertalen, scoort het 42,2/36,6 op de half-book-test en 39,7/36,3 op de full-book-test. Op de half-book-test ligt Gemini 2.0 Flash-Lite met 42,3 net iets voor, maar Scout maakt het goed op de full-book en presteert beter dan Gemini’s 35,1/30,0.
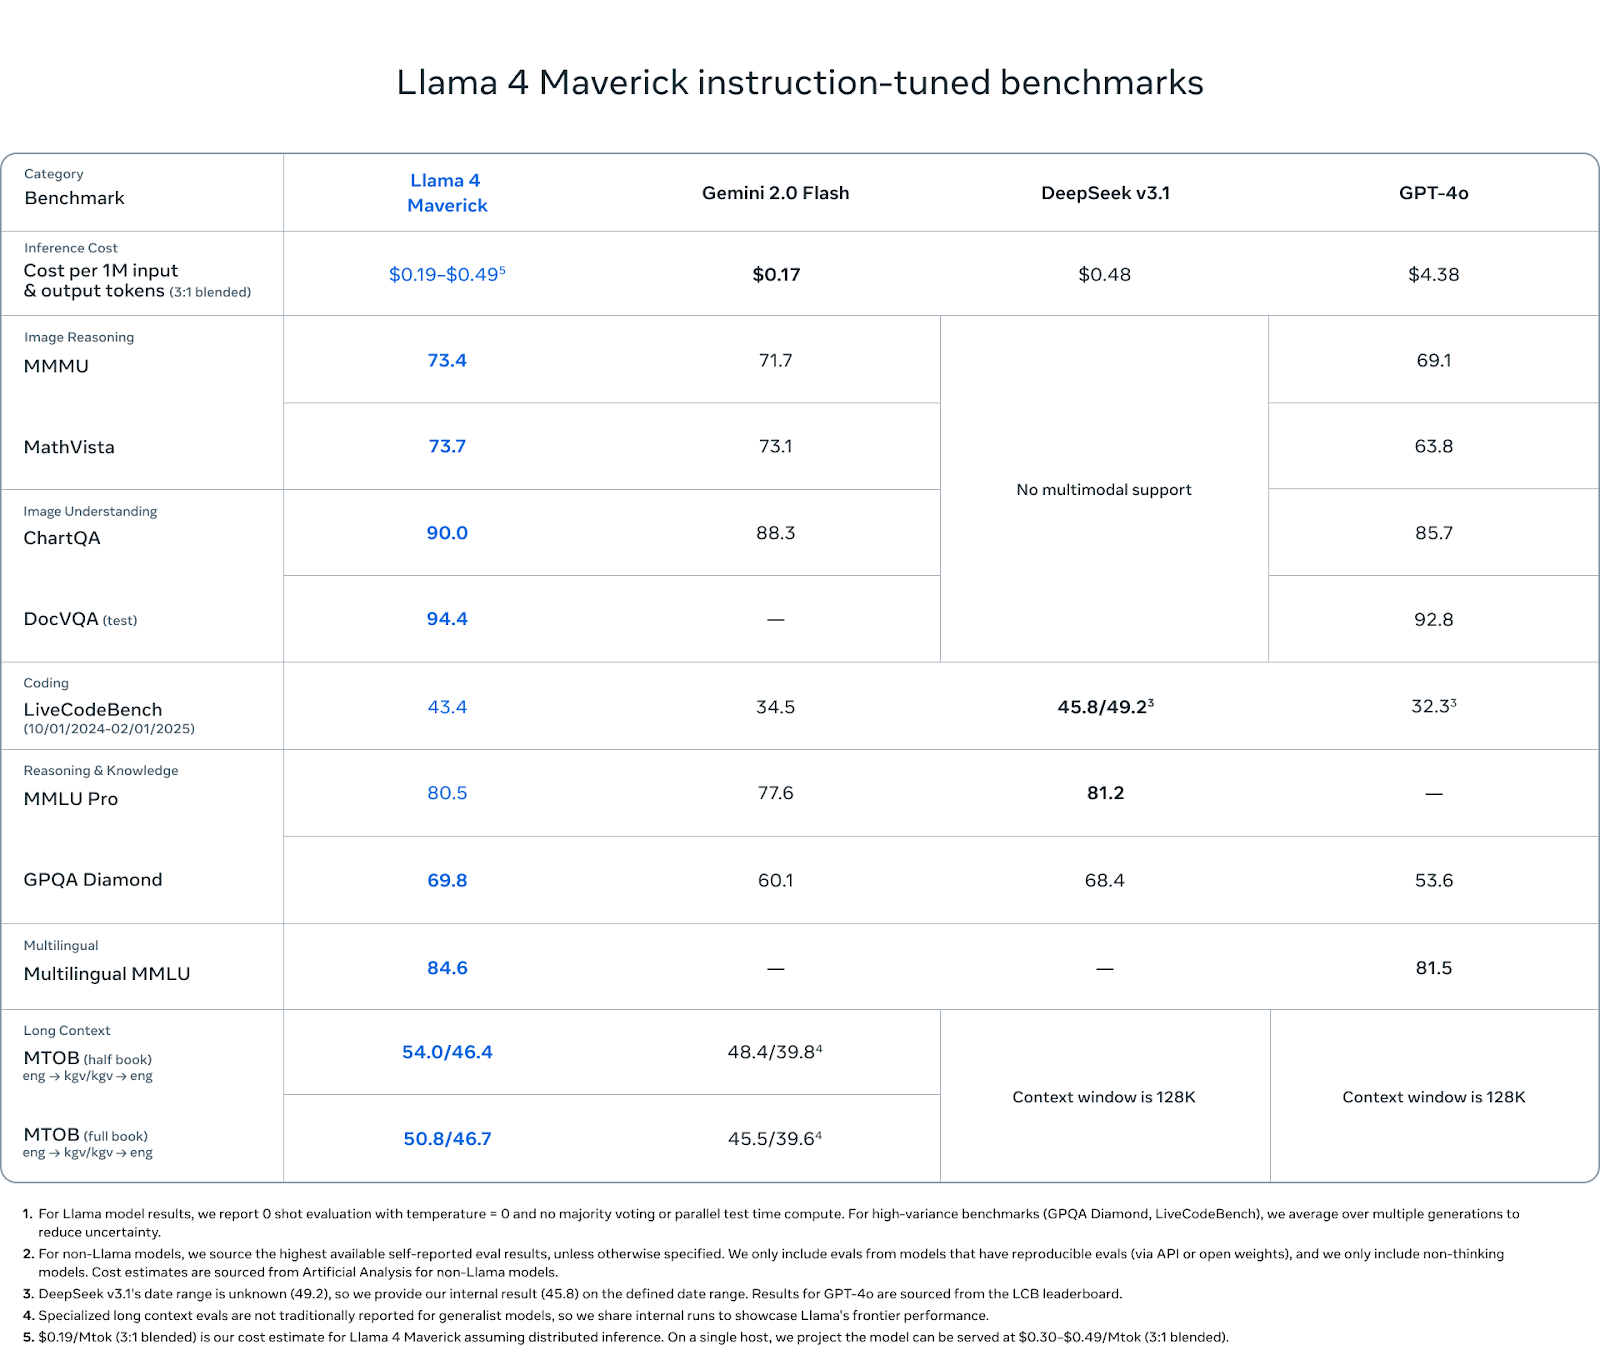
Maverick is het meest uitgebalanceerde model in de Llama 4-reeks—en de benchmarkresultaten weerspiegelen dat. Hoewel het niet mikt op de contextlengte-extremen van Scout of de ruwe schaal van Behemoth, presteert het consistent over elke relevante categorie: multimodale redenering, coderen, taalbegrip en langcontextretentie.
Bron: MetaAI
Bij beeldredenering scoort Maverick 73,4 op MMMU en 73,7 op MathVista, beter dan Gemini 2.0 Flash (71,7 en 73,1) en GPT-4o (69,1 en 63,8). Op ChartQA (beeldbegrip) scoort het 90,0, net boven Gemini’s 88,3 en ruim boven GPT-4o’s 85,7. In DocVQA haalt Maverick 94,4, gelijk aan Scout en beter dan GPT-4o’s 92,8.
Bij coderen scoort Maverick 43,4 op LiveCodeBench, boven GPT-4o (32,3), Gemini Flash (34,5) en dicht bij DeepSeek v3.1 met 45,8.
Op redeneren en kennis scoort Maverick 80,5 op MMLU Pro en 69,8 op GPQA Diamond, opnieuw beter dan Gemini Flash (77,6 en 60,1) en GPT-4o (geen gerapporteerde MMLU Pro, 53,6 op GPQA). DeepSeek v3.1 loopt met 0,7 voor op MMLU Pro.
Maverick presteert ook goed in meertalig begrip, met 84,6 op Multilingual MMLU, net boven Gemini’s 81,5. Dat geeft het een voorsprong voor ontwikkelaars die in meerdere talen of regio’s werken.
Bij langcontext-evaluaties (MTOB) scoort Maverick 54,0/46,4 op de half-book-test en 50,8/46,7 op de full-book—aanzienlijk boven Gemini’s respectievelijk 48,4/39,8 en 45,5/39,6. Deze scores suggereren dat, hoewel Maverick zijn contextlengte niet zo luid adverteert als Scout, het toch merkbaar profiteert van het uitgebreide venster.
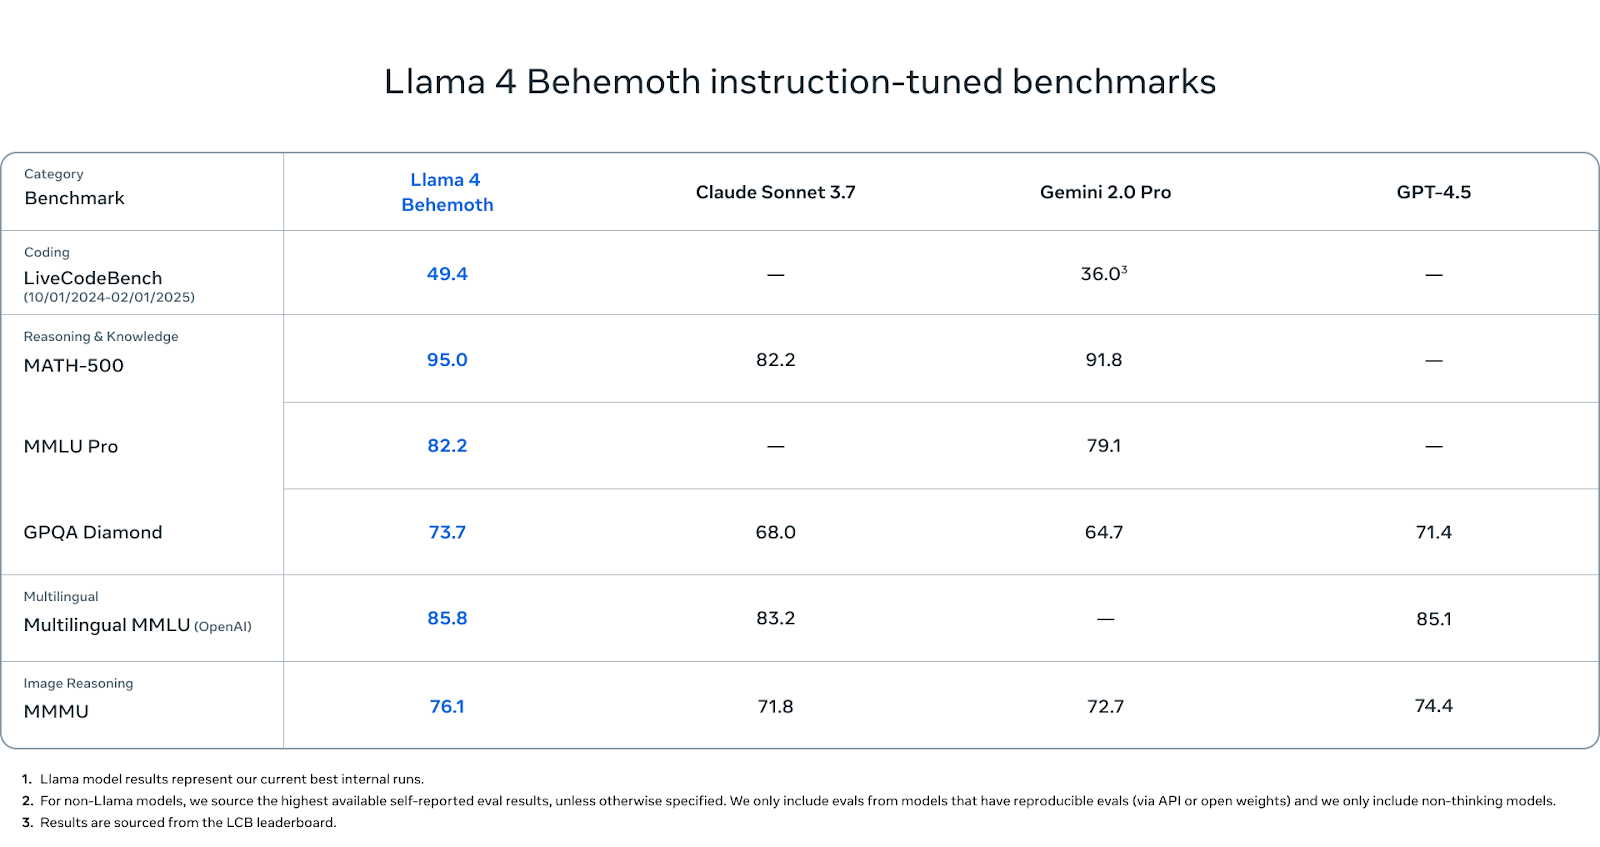
Behemoth is nog niet uitgebracht, maar de benchmarkcijfers zijn het bekijken waard.
Bron: MetaAI
Op STEM-zware benchmarks presteert Behemoth uitzonderlijk goed. Het scoort 95,0 op MATH-500—dat is hoger dan Gemini 2.0 Pro (91,8) en aanzienlijk boven Claude Sonnet 3.7 (82,2). Op MMLU Pro scoort Behemoth 82,2, terwijl Gemini Pro 79,1 haalt (voor Claude is geen score gerapporteerd). En op GPQA Diamond, een andere benchmark die feitelijke diepgang en precisie beloont, komt Behemoth uit op 73,7, boven Claude (68,0), Gemini (64,7) en GPT-4.5 (71,4).
Bij meertalig begrip scoort Behemoth 85,8 op Multilingual MMLU, iets beter dan Claude Sonnet (83,2) en GPT-4.5 (85,1). Deze scores zijn belangrijk voor wereldwijde ontwikkelaars die buiten het Engels werken, en Behemoth leidt momenteel deze categorie.
Bij beeldredenering haalt Behemoth 76,1 op MMMU, boven Gemini (71,8), Claude (72,7) en GPT-4.5 (74,4). Hoewel dit niet de hoofdfocus is, presteert het nog steeds competitief met toonaangevende multimodale modellen.
Bij codegeneratie scoort Behemoth 49,4 op LiveCodeBench. Dat ligt ruim boven Gemini 2.0 Pro (36,0).
Zowel Llama 4 Scout als Llama 4 Maverick zijn nu beschikbaar onder Meta’s open-weight-licentie. Je kunt ze rechtstreeks downloaden van de officiële Llama-website of via Hugging Face.
Om de modellen via Meta’s eigen diensten te gebruiken, kun je met Meta AI communiceren op verschillende platforms: WhatsApp, Messenger, Instagram en Facebook. Toegang vereist momenteel inloggen met een Meta-account, en er is geen zelfstandige API-endpoint voor Meta AI—althans nog niet.
Als je van plan bent de modellen te integreren in je eigen applicaties of infrastructuur, houd dan rekening met de licentieclausule: als je product of dienst meer dan 700 miljoen maandelijkse actieve gebruikers heeft, moet je aparte toestemming van Meta verkrijgen. Verder zijn de modellen te gebruiken voor onderzoek, experimenten en de meeste commerciële toepassingen.
Scout introduceert ongekende contextlengte op een enkele GPU. Maverick houdt zich staande tegenover grotere modellen bij redeneren, code en multimodale taken. En Behemoth, nog in training, laat zien hoe teachermodellen efficiëntere en inzetbare varianten kunnen vormgeven.
De open-weight-ruimte is competitiever dan ooit. DeepSeek, Qwen, Gemma en binnenkort OpenAI komen allemaal met sterke releases. Llama 4 is een voortzetting van Meta’s voortdurende inspanning om schaalbare, open beschikbare modellen te bieden voor een reeks use-cases.
Leer AI met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

