
Cursus
Agentic Systems ontwerpen met LangChain
3 uur
14.8K
Je vertelt je chatbot dat je vegetariër bent. De volgende dag stelt hij een biefstukrecept voor. Dat is geen bug. Zo werken LLM’s nu eenmaal. Ze hebben geen geheugen tussen sessies en behandelen elk gesprek als een schone lei.
Voor casual gebruik is dat prima. Maar als je echte toepassingen bouwt voor echte gebruikers, wordt die stateless-werkwijze een probleem. Je gebruikers verwachten dat de AI hén onthoudt.
Mem0 lost dit op door een geheugenlaag toe te voegen aan elke LLM. Het slaat informatie over gebruikers op, haalt die op en werkt die bij over sessies heen, zodat je AI in de loop van de tijd echt kan leren en zich kan aanpassen.
In deze tutorial bouw je een persoonlijke AI-assistent die voorkeuren onthoudt, gespreksgeschiedenis bijhoudt en bij elke interactie slimmer wordt. We behandelen zowel cloud- als self-hosted setups, zodat je kunt kiezen wat bij je project past.
Als je er nog niet mee gewerkt hebt, volg dan deze course om te leren werken met de OpenAI API.
Mem0 is een open-source geheugenlaag tussen je applicatie en de LLM. Het extraheert automatisch relevante informatie uit gesprekken, slaat die op en haalt die op wanneer nodig. Het project haalde in oktober 2025 $24 miljoen op en werkt met elke LLM-provider: OpenAI, Anthropic, Ollama of je eigen modellen.
Mem0 organiseert herinneringen in drie scopes:
Gebruikersgeheugen: Blijft bestaan over alle gesprekken met een specifieke persoon. Als iemand zegt liever ’s ochtends te studeren, blijft dat feit beschikbaar in elke toekomstige sessie.
Sessiegeheugen: Houdt context bij binnen één gesprek, zoals het huidige recept waarover je praat.
Agentgeheugen: Slaat informatie op die specifiek is voor een bepaalde AI-agentinstantie.
Je kunt deze scopes combineren om complexe apps te bouwen waarin verschillende agents delen (of isoleren) wat ze over gebruikers weten.
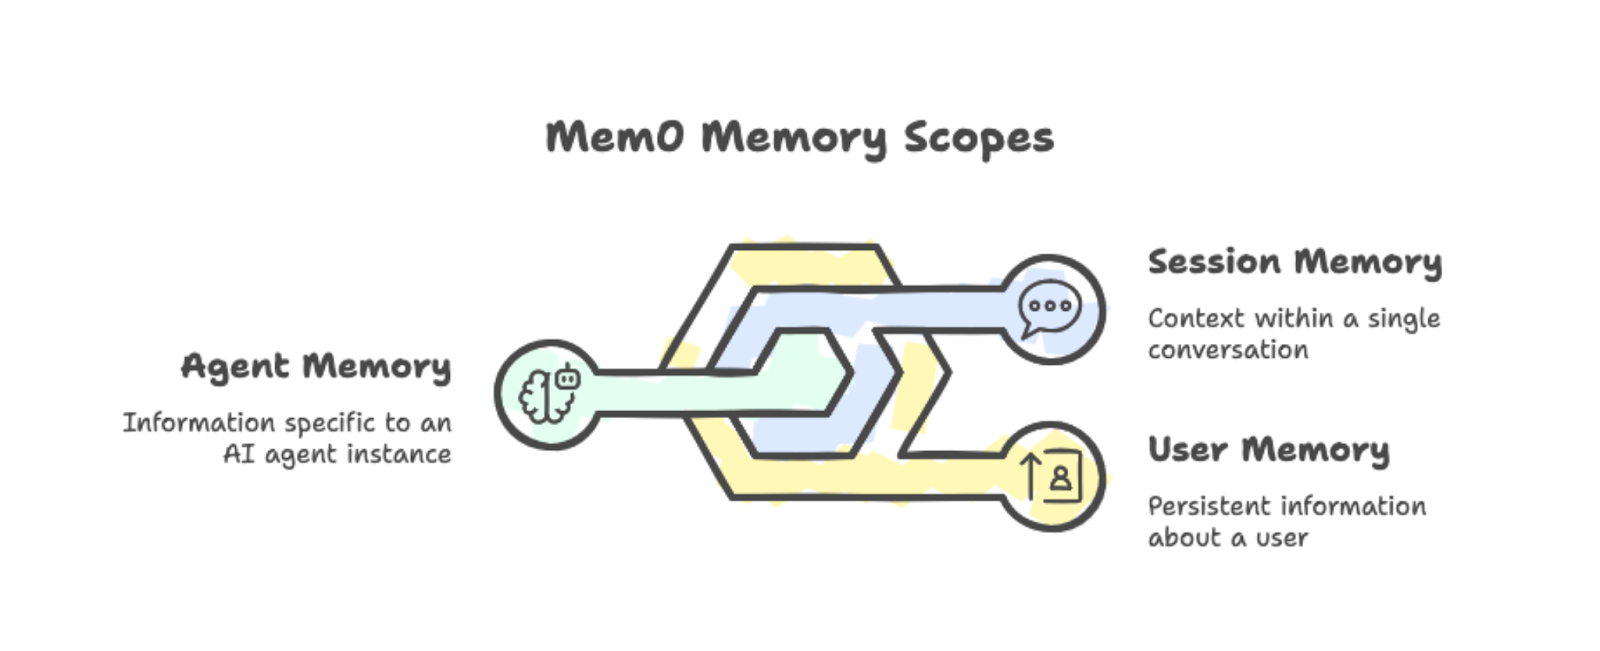
De drie geheugenscopes: gebruiker, sessie en agent, met voorbeelden.
Onder de motorkap combineert Mem0 vector search met grafrelaties. Wanneer je een gesprek toevoegt aan het geheugen, extraheert het automatisch de belangrijkste punten. Je hoeft niet handmatig te taggen wat onthouden moet worden.
Wanneer je app context nodig heeft, haalt Mem0 relevante herinneringen op op basis van de huidige vraag en voegt die toe aan de prompt. Dit is beter dan je volledige gespreksgeschiedenis in elke aanvraag proppen.
Je kunt Mem0 op twee manieren draaien:
Platform: De cloudgebaseerde beheerde service op app.mem0.ai biedt snelle setup en een API.
Self-hosted: Geeft je volledige controle over je infrastructuur en laat je je eigen vectordatabank en embeddingmodel kiezen.
Beide opties gebruiken dezelfde Python-SDK, dus wisselen is eenvoudig.
De prestatiewinst is reel, zoals het onderzoekspaper van Mem0 laat zien. Op de LOCOMO-benchmark scoorde Mem0 26% hoger dan de ingebouwde geheugenfunctie van OpenAI. Het reageert ook 91% sneller door selectief relevante herinneringen op te halen in plaats van de volledige gespreksgeschiedenis te verwerken. Het tokengebruik daalt met ongeveer 90% vergeleken met full-contextbenaderingen.
Nu je weet wat Mem0 doet, gaan we het instellen.
Installeer het pakket samen met python-dotenv om API-sleutels te beheren:
pip install mem0ai python-dotenvMeld je aan op app.mem0.ai en haal je API-sleutel op uit het dashboard. Maak een .env-bestand in je projectmap:
MEM0_API_KEY=your-api-key-hereInitialiseer nu de client met de API-sleutel:
from mem0 import MemoryClient
from dotenv import load_dotenv
import os

load_dotenv()

client = MemoryClient(api_key=os.getenv("MEM0_API_KEY"))
Om een herinnering op te slaan, geef je een gesprek door in het OpenAI-chatformaat. Met de parameter user_id scope je herinneringen tot een specifieke gebruiker:
messages = [
	{"role": "user", "content": "I'm a vegetarian and allergic to nuts."},
	{"role": "assistant", "content": "Got it! I'll remember that."}
]
client.add(messages, user_id="user123")
De geheugenverwerking gebeurt op de achtergrond. De methode add() retourneert direct met een pending-status terwijl Mem0 de relevante feiten extraheert en opslaat.
Om herinneringen op te halen, gebruik je search() met een zoekvraag in natuurlijke taal:
results = client.search("dietary restrictions", filters={"user_id": "user123"})De response bevat de geëxtraheerde herinneringen met relevantiescores:
{'results': [
	{'memory': 'User is allergic to nuts', 'user_id': 'user123', 'score': 0.66},
	{'memory': 'User is a vegetarian', 'user_id': 'user123', 'score': 0.65}
]}
Let op dat Mem0 "vegetarian” en “allergic to nuts" automatisch heeft opgesplitst in twee losse feiten. Het systeem verzorgt de extractie en geeft bij het zoeken de meest relevante herinneringen terug op basis van semantische gelijkenis.
Met de basis op orde bouwen we nu iets praktischer.
De basisworkflow add/search is handig, maar echte toepassingen vragen meer verfijning. Laten we een leercompagnon bouwen die autonoom beslist wanneer hij herinneringen opslaat, ophaalt en bijwerkt. We gebruiken de OpenAI Agents SDK om onze agent geheugen-tools te geven die hij zelfstandig kan aanroepen.
Ben je nieuw in het bouwen van agents met LLM’s? Bekijk dan onze tutorial over LangChain-agents bouwen voor de basisconcepten. Voor een verdiepende blik op de OpenAI Agents SDK specifiek, zie de OpenAI Agents SDK-tutorial.
Installeer de OpenAI Agents SDK naast Mem0:
pip install openai-agents mem0ai python-dotenvVoeg je OpenAI API-sleutel toe aan het .env-bestand:
MEM0_API_KEY=your-mem0-key
OPENAI_API_KEY=your-openai-key
Initialiseer nu beide clients en maak een contextklasse om gebruikersinformatie aan tools door te geven:
import os
from dataclasses import dataclass
from agents import Agent, Runner, function_tool, RunContextWrapper
from mem0 import MemoryClient
from dotenv import load_dotenv

load_dotenv()

mem0 = MemoryClient(api_key=os.getenv("MEM0_API_KEY"))

@dataclass
class UserContext:
	user_id: str
De dataclass UserContext bevat gebruikersspecifieke data die tools nodig hebben. Met RunContextWrapper kunnen we deze context meegeven aan elke tool die de agent aanroept.
De agent heeft drie tools nodig: zoeken, opslaan en bijwerken. We gebruiken de @function_tool-decorator om deze aan de agent bloot te stellen.
Eerst haalt de zoektool relevante herinneringen op. We nemen geheugen-ID’s op in de output zodat de agent ze kan gebruiken voor updates:
@function_tool
def search_memory(ctx: RunContextWrapper[UserContext], query: str) -> str:
	"""Search through past learning history and memories."""
	memories = mem0.search(
    	query,
    	filters={"user_id": ctx.context.user_id},
    	limit=5
	)
	if memories and memories.get("results"):
    	return "\n".join([
         	f"- [ID: {m['id']}] {m['memory']}" for m in memories["results"]
     	])
 	return "No relevant memories found."
Vervolgens slaat de opslaantool nieuwe informatie op:
@function_tool
def save_memory(ctx: RunContextWrapper[UserContext], content: str) -> str:
 	"""Save new information about the user's learning journey."""
 	mem0.add(
     	[{"role": "user", "content": content}],
     	user_id=ctx.context.user_id
 	)
 	return "Memory saved successfully."
Tot slot wijzigt de updatetool bestaande herinneringen wanneer informatie verandert:
@function_tool
def update_memory(ctx: RunContextWrapper[UserContext], memory_id: str, new_text: str) -> str:
 	"""Update an existing memory with new information."""
 	mem0.update(memory_id=memory_id, text=new_text)
return f"Memory {memory_id} updated."Maak nu de agent met instructies over wanneer elke tool te gebruiken:
agent = Agent(
 	name="Learning Companion",
 	instructions="""You are a helpful learning companion with memory.
            Use search_memory to recall what the user is learning and their level.
            Search results include memory IDs in format [ID: xxx].
            Use save_memory to store new topics, preferences, or progress.
            Use update_memory when information changes. First search to find the memory ID, then call update_memory with that ID and the new text.
            Always check memory before responding to personalize your answers.""",
 	tools=[search_memory, save_memory, update_memory],
 	model="gpt-4o"
)
We gebruiken hier gpt-4o, maar voor beter redeneervermogen bij toolgebruik raad ik GPT-5 aan. Bekijk gerust onze GPT-5 API-tutorial om zijn nieuwe features in actie te zien.
De chatfunctie geeft de gebruikerscontext door aan de agent:
def chat(user_input: str, user_id: str) -> str:
	result = Runner.run_sync(
     	agent,
     	user_input,
         context=UserContext(user_id=user_id)
	)
	return result.final_output
Elke aanroep van Runner.run_sync() is volledig onafhankelijk van alle andere aanroepen. De OpenAI Agents SDK bewaart standaard geen gespreksgeschiedenis tussen aanroepen.
Dit is bewust voor onze demo: als de agent gebruikersinformatie onthoudt over aanroepen heen, moet dat geheugen uit Mem0 komen, niet uit een verborgen agentstate.
Laten we testen met vragen die echt geheugenophaling vereisen. De agent kan het goede antwoord niet raden zonder opgeslagen informatie te raadplegen.
Sla eerst wat gebruikersinformatie op:
response = chat(
	"My name is Alex. I am learning data visualization with matplotlib. "
	"I am at intermediate level.",
	"student_01"
)
print(response)
Got it, Alex! You're learning data visualization with Matplotlib at an intermediate level. How can I assist you today?Wacht een paar seconden op de asynchrone verwerking en test dan de herinnering:
response = chat("What is my name and what library am I learning?", "student_01")
print(response)
Your name is Alex, and you're learning data visualization using Matplotlib at an intermediate level.Test nu de updatefunctionaliteit:
response = chat(
	"I switched from matplotlib to seaborn. Please update your memory.",
	"student_01"
)
print(response)
Got it! I've updated your learning preference to Seaborn for data visualization at an intermediate level. If you need help with anything specific, just let me know!Controleer of de update werkte:
response = chat("What visualization library am I using now?", "student_01")
print(response)
You are currently using Seaborn for data visualization at an intermediate level.Test tot slot de persistentie over gesprekken heen:
response = chat("Give me a summary of everything you know about me.", "student_01")
print(response)
Here's what I know about you:
- Your name is Alex.
- You are learning data visualization with Seaborn at an intermediate level.
Is there anything else you'd like to update or add?De agent kiest op basis van het gesprek welke tool hij aanroept.
Vraagt de gebruiker naar zijn profiel, dan roept hij search_memory aan. Deelt iemand nieuwe informatie, dan gebruikt hij save_memory. Zegt iemand dat informatie is veranderd, dan zoekt hij eerst om de geheugen-ID te vinden en roept daarna update_memory aan.
We geven nooit expliciet aan welke tool hij per bericht moet gebruiken.
Dit verschilt van de handmatige add/search-workflow in Sectie 3. Daar riepen we expliciet methoden aan. Hier neemt de agent die beslissingen. Dit patroon schaalt beter voor complexe apps waarin je niet elk interactietype kunt voorspellen.

Vergelijking van handmatige en agentgestuurde workflows voor schaalbaarheid
Belangrijk om te weten: geheugenverwerking is asynchroon. Na het aanroepen van save_memory zit er een korte vertraging voordat de nieuwe herinnering doorzoekbaar wordt. In productie wil je hiermee rekening houden in je interface.
De basisagent kan geheugenbewerkingen aan, maar productie-apps hebben fijnmazigere controle nodig over wat wordt opgeslagen en hoe het wordt opgehaald. Mem0 biedt projectinstellingen die de geheugenkwaliteit verbeteren, waaronder aangepaste categorieën voor organisatie, door de gebruiker gedefinieerde instructies voor filtering, gerichte zoekopdrachten en opschoningsacties.
Standaard gebruikt Mem0 generieke categorieën zoals eten, reizen en hobby’s. Voor specifieke toepassingen zoals onze leercompagnon helpt dat niet veel. Je kunt je eigen categorieën definiëren die passen bij jouw domein:
client.project.update(custom_categories=[
	{"name": "topics", "description": "Programming languages, frameworks, or subjects"},
	{"name": "skill_levels", "description": "Proficiency: beginner, intermediate, advanced"},
	{"name": "goals", "description": "Learning objectives and targets"},
	{"name": "progress", "description": "Completed courses, chapters, or milestones"},
	{"name": "preferences", "description": "Learning style, schedule, or format preferences"}
])
Zodra dit is ingesteld, tagt de classifier van Mem0 inkomende herinneringen automatisch met jouw categorieën. Wanneer Alex zegt: "I'm learning Python at a beginner level," tagt het systeem dit met zowel topics als skill_levels. Je hoeft je agentcode niet te wijzigen. De categorisering gebeurt tijdens de geheugenextractie.
Aangepaste instructies stellen je in staat precies te bepalen wat uit gesprekken wordt geëxtraheerd. Je schrijft richtlijnen in natuurlijke taal en Mem0 volgt die bij het verwerken van nieuwe herinneringen:
client.project.update(custom_instructions="""
Extract and remember:
- Programming topics and technologies mentioned
- Current skill level for each topic
- Learning goals and deadlines
- Progress updates and completions
- Preferred learning resources (videos, docs, exercises)

Do not store:
- Personal identifiers beyond the user_id
- Payment or financial information
- Off-topic conversation that isn't about learning
""")
Dit is belangrijk voor productie-apps. Zonder instructies kan Mem0 irrelevante details of gevoelige informatie opslaan. Aangepaste instructies werken als een filter en houden herinneringen gefocust op wat jouw toepassing echt nodig heeft. Voor compliance-scenario’s zoals de AVG kun je expliciet categorieën met persoonsgegevens uitsluiten.
Met gecategoriseerde herinneringen kan je zoektool preciezer zijn. In plaats van alle herinneringen te doorzoeken, filter je op categorie om precies te krijgen wat je nodig hebt:
@function_tool
def search_memory(
	ctx: RunContextWrapper[UserContext],
	query: str,
	category: str = None
) -> str:
	"""Search learning history. Optionally filter by category."""
	filters = {"user_id": ctx.context.user_id}
	if category:
    	filters["categories"] = {"contains": category}

	memories = mem0.search(query, filters=filters, limit=5)
	if memories and memories.get("results"):
    	return "\n".join([
        	f"- [ID: {m['id']}] {m['memory']}" for m in memories["results"]
     	])
	return "No relevant memories found."
Wanneer de agent moet antwoorden op "Welke onderwerpen heb ik geleerd?", kan hij zoeken met category="topics" en irrelevante herinneringen over voorkeuren of doelen overslaan. De agentinstructies moeten deze categorieën noemen, zodat hij weet wanneer hij gefilterde zoekopdrachten moet gebruiken.
Gebruikers willen soms verouderde of onjuiste herinneringen verwijderen. Voeg een deletetool toe om de agent deze mogelijkheid te geven:
@function_tool
def delete_memory(ctx: RunContextWrapper[UserContext], memory_id: str) -> str:
	"""Delete a specific memory by ID."""
	mem0.delete(memory_id=memory_id)
	return f"Memory {memory_id} deleted."
Voor bulkacties kun je alle herinneringen voor een gebruiker in één keer wissen:
mem0.delete_all(user_id="student_01")Verwijderen is handig wanneer informatie volledig verandert in plaats van bijgewerkt wordt. Als een gebruiker zegt: "vergeet alles over mijn Python-leren", kan de agent relevante herinneringen zoeken en ze één voor één verwijderen, of je biedt een resetoptie die hun profiel helemaal leegt.
Deze vier configuratie-opties tillen de agent van een demo naar iets dat je kunt uitrollen. Categorieën organiseren herinneringen automatisch, instructies zorgen dat alleen relevante informatie wordt opgeslagen, gefilterde zoekopdrachten halen precies op wat nodig is, en verwijderen regelt de opschoning. De wijzigingen in de agentcode zijn minimaal omdat het meeste op projectniveau geconfigureerd wordt.
Voor meer details over deze features, zie de officiële Mem0-documentatie.
Standaardgeheugen slaat losse feiten op, zoals "Alex leert Seaborn" en "Alex kent matplotlib." Maar het legt niet vast dat Alex eerst matplotlib leerde en daarna overstapte op Seaborn. Grafgeheugen voegt deze relatielaag toe. Wanneer volgorde, progressie of verbanden tussen entiteiten belangrijk zijn, geeft grafgeheugen je agent rijkere context.
Let op: grafgeheugen is alleen beschikbaar met een Pro-abonnement ($249/maand) of hoger.
Je kunt grafgeheugen op projectniveau activeren:
client.project.update(enable_graph=True)Een andere optie is om enable_graph=True mee te geven bij individuele requests:
client.add(messages, user_id="student_01", enable_graph=True)Zodra het actief is, extraheert Mem0 automatisch entiteiten (personen, onderwerpen, tools, datums) en de relaties ertussen uit natuurlijke gesprekken.
Wanneer je zoekt met grafgeheugen, retourneert Mem0 zowel herinneringen als een relations-array die laat zien hoe entiteiten verbonden zijn:
results = client.search(
	"What has Alex learned?",
	filters={"user_id": "student_01"},
	enable_graph=True
)

# Results include both memories and relations
print(results.get("relations"))
De relaties tonen verbindingen zoals "Alex → learned → matplotlib" en "Alex → switched to → seaborn." Je agent kan nu vragen over progressie beantwoorden zonder dat jij die relaties expliciet hoeft op te slaan.
Grafgeheugen voegt verwerkingsoverhead toe, dus gebruik het als relaties ertoe doen:
Leerplatforms die vaardigheidsprogressie volgen
Klantenondersteuning die interactiegeschiedenis analyseert
Projectmanagement dat taakafhankelijkheden in kaart brengt
Gezondheidszorg die symptomen en behandelingen door de tijd verbindt
Voor eenvoudige feitenophaling is standaardgeheugen sneller. Schakel grafgeheugen in wanneer je agent moet redeneren over volgordes of verbanden tussen opgeslagen informatie.
Mem0 is er in twee varianten: Platform en open source.
In deze tutorial gebruikten we de Platform-versie, de beheerde clouddienst die je benadert via MemoryClient en een API-sleutel van app.mem0.ai. Beide versies delen kerngeheugenoperaties (add(), search(), update(), delete()), maar verschillen in setup, prijs en controle.
Platform is de gehoste service van Mem0. Je meldt je aan, krijgt een API-sleutel en begint binnen enkele minuten herinneringen toe te voegen. Mem0 regelt infrastructuur, schaalbaarheid en securitycertificeringen (zoals SOC 2 Type II of GDPR).
Er zijn vier prijsniveaus:
Gratis: 10.000 herinneringen, geschikt voor prototyping.
Starter: $19/maand, met hogere limieten.
Pro: $249/maand, voor productie-workloads.
Enterprise: Maatwerkprijs met dedicated support.
Platform bevat features die niet beschikbaar zijn in open source: grafgeheugen voor relatie-tracking, webhooks voor realtime meldingen, groepschat met sprekertoewijzing en ingebouwde analytics.
Je betaalt per gebruik, maar bespaart op infrastructuur en DevOps-tijd.
De open-sourceversie draait op je eigen servers. Je installeert het mem0ai-pakket, configureert je vectordatabank en beheert de uitrol zelf. Dit vergt meer setup, maar geeft je volledige controle.
Er zijn meerdere keuzes voor de infrastructuur:
Vectordatabanken: 24+ opties, waaronder Qdrant, Chroma, Pinecone, PostgreSQL (pgvector) en MongoDB
LLM-providers: 16+ opties, waaronder OpenAI, Anthropic, Ollama, Groq en lokale modellen
Embeddingmodellen: OpenAI, HuggingFace of custom embedders
Open source gebruikt de klasse Memory in plaats van MemoryClient.
Je kosten zijn wat je betaalt voor infrastructuur (cloud-VM’s, databasehosting, API-calls naar LLM-providers). Op schaal kan dit goedkoper zijn dan Platform-prijzen, maar je bent zelf verantwoordelijk voor onderhoud, back-ups en compliance.
Raadpleeg de volgende tabel voor een vergelijking tussen de gehoste en open-sourceversies van Mem0:
|
Aspect |
Platform |
Open source |
|
Installatietijd |
Minuten |
Uren tot dagen |
|
Infrastructuur |
Volledig beheerd |
Zelf beheerd |
|
Prijzen |
$0–249+/maand |
Jouw infrastructuurkosten |
|
Vector-DB-opties |
Beheerd |
24+ keuzes |
|
LLM-opties |
Beheerd |
16+ keuzes |
|
Compliancecerts |
SOC 2, GDPR inbegrepen |
Zelf implementeren |
|
Gegevenslocatie |
Servers van Mem0 |
Jouw servers |
Mijn advies: kies Platform voor snel prototypen, productie-apps zonder DevOps-overhead of wanneer je ingebouwde compliance nodig hebt.
Ligt je focus op datasoevereiniteit, aangepaste modelconfiguraties of kostenoptimalisatie op grote schaal, dan is open source de juiste keuze.
Voor gedetailleerde set-upgidsen, zie de Platform-quickstart of het open-sourceoverzicht.
In deze tutorial heb je geleerd hoe je met Mem0 persistent geheugen toevoegt aan LLM-toepassingen. Je begon met basisgeheugenbewerkingen en bouwde vervolgens een leercompagnon die zijn eigen geheugen autonoom beheert met de OpenAI Agents SDK. Daarna heb je het geheugenbeheer geconfigureerd met aangepaste categorieën, instructies en gefilterde zoekopdrachten. Tot slot heb je de Platform- en open-sourceopties vergeleken.
Voor productiegebruik: voeg foutafhandeling toe rond geheugenbewerkingen en houd rekening met korte vertragingen na het opslaan van nieuwe herinneringen. Houd ook rekening met ratelimieten als je de gratis Platformschaal gebruikt.
Klaar om verder te gaan dan losse componenten en de volledige stack van AI-app-ontwikkeling onder de knie te krijgen? Schrijf je in voor de AI Engineer for Developers-carrièretrack.
Cursussen over AI-agents
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

