
Leerpad
Wetenschapper op het gebied van machine learning in Python
85 uur
Stel je voor dat je geblinddoekt het laagste punt tussen de heuvels probeert te vinden. Omdat je alleen op je tast kunt vertrouwen, voel je alleen de grond direct om je heen om te bepalen welke kant naar beneden is. Dit is in essentie wat machinelearning-algoritmen doen wanneer ze de beste oplossing voor een probleem proberen te vinden.
Ze vatten het probleem samen in een wiskundige functie waarvan de invoer en uitvoer een heuvelachtig landschap voorstellen. Het minimum van deze functie vinden betekent dat je de beste oplossing voor het probleem hebt bereikt. Een van de populairste algoritmen om dit proces uit te voeren heet Stochastic Gradient Descent (SGD).
In deze tutorial leer je alles wat je over het algoritme moet weten, inclusief wat eerste intuïtie zonder de wiskunde, de wiskundige details en hoe je het in Python implementeert.
Stochastic Gradient Descent (SGD) is een optimalisatietechniek die in machine learning wordt gebruikt om fouten in voorspellende modellen te minimaliseren. In tegenstelling tot gewone gradient descent, die de volledige dataset gebruikt om de gradiënt te berekenen en modelparameters bij te werken, past SGD de parameters aan met slechts één datapunt per keer. Dit maakt het sneller en efficiënter voor grote datasets, al kan het onrustiger en minder stabiel zijn. SGD helpt bij het vinden van de optimale waarden voor modelparameters om de nauwkeurigheid van voorspellingen te verbeteren.
Het eerste wat we meteen moeten begrijpen, is dat stochastic gradient descent (SGD) geen machinelearning-algoritme is. Het is eerder simpelweg een optimalisatietechniek die kan worden toegepast op ML-algoritmen.
Wat is optimalisatie dan? Om dit te begrijpen, werken we ons op vanaf de fase van de probleemdefinitie in machine learning.
Stel dat we diamantprijzen proberen te voorspellen op basis van hun karaatwaarde (één karaat is 0,2 gram). Dit is een regressieprobleem, omdat het model numerieke waarden produceert.
Om het probleem op te lossen hebben we een breed scala aan algoritmen tot onze beschikking, maar laten we kiezen voor Eenvoudige lineaire regressie, met de simpele formule f(x) = mx + b waarbij:
b de basisprijs van de diamant ism de prijsstijging per karaat isx de karaatwaarde van de diamant isf(x) de voorspelde prijs van de diamant isDeze lineaire vergelijking stelt ons model voor. Ons doel is de beste waarden te vinden voor m en b die onze voorspellingen zo nauwkeurig mogelijk maken voor alle diamanten in onze dataset.
Als we nog een kenmerk in onze dataset hadden, zoals het volume van de diamant, verandert onze formule naar f(x1, x2) = m1*x1 + m2*x2 + b, waarbij:
b de basisprijs van de diamant ism1 de prijsstijging per karaat ism2 de prijsstijging per volume-eenheid isx1 de karaatwaarde van de diamant isx2 het volume van de diamant isf(x) de voorspelde prijs van de diamant isNu moeten we de optimale waarden vinden voor m1, m2 en b.
In het algemeen hebben alle machinelearning-modellen vergelijkingen zoals hierboven met één of meer parameters. De definitie van optimalisatie in deze context wordt dus: “Gegeven dit model en deze dataset, vind de optimale waarden voor de parameters in de vergelijking.”
Er zijn veel optimalisatiealgoritmen die deze taak kunnen uitvoeren, zoals Stochastic Gradient Descent — de focus van onze tutorial. Maar om volledig te begrijpen hoe SGD werkt, bekijken we eerst enkele fundamentele ideeën erachter.
Om SGD te begrijpen, moeten we het reguliere gradient-descent-algoritme (GD) leren kennen, dat veel fundamentele ideeën deelt met de stochastische variant. Simpele gradient descent begint met het concept ‘fout’ in machine learning.
ML-algoritmen raden meestal wat het juiste antwoord is op een probleem. We noemen dit antwoord een voorspelling, en die is niet altijd nauwkeurig. Daarom introduceren we een nieuwe term, “fout” of “verlies”, die het verschil weergeeft tussen het werkelijke antwoord en de voorspelling van het model. Ons doel is een model te bouwen dat deze fout minimaliseert.
Als ons model f(x) $10.000 raadt voor een diamant die in werkelijkheid $12.000 kost, is de fout $2.000. We moeten ons model aanpassen om deze fout te verkleinen. Maar de voorspellingen van het model moeten goed zijn voor elke diamant, niet slechts één. Daarom hebben we een manier nodig om de fouten voor alle diamanten in onze dataset te combineren. Hier komen kostfuncties om de hoek kijken.
Een kostfunctie combineert alle individuele fouten tot één getal dat de algehele prestatie van ons model weergeeft. Een lagere totale kost betekent dat de voorspellingen van ons model beter zijn.
Kostfuncties variëren afhankelijk van het soort probleem dat we oplossen.
Bij regressieproblemen voorspelt het model numerieke waarden, zoals hoeveel een diamant kost of hoe lang het duurt om een baantje te zwemmen. Bij classificatie voorspelt het model tot welke categorie iets behoort. Bijvoorbeeld: is een paddenstoel eetbaar of niet, of is het object op de afbeelding een kat, hond of paard?
Er zijn nog andere soorten problemen, maar het belangrijkste punt is dat elk type andere kostfuncties vereist. In deze tutorial focussen we op Mean Squared Error (MSE), dat vaak wordt gebruikt bij regressie.
Het verschil tussen de werkelijke waarden (ground truth) en de voorspellingen van het model heet een fout of verlies. Bijgevolg wordt een functie die al deze fouten of verliezen combineert een foutfunctie, verliesfunctie of kostfunctie genoemd. Verschillende bronnen gebruiken deze termen door elkaar; in deze tutorial gebruiken we voortaan de term verliesfunctie.
Bij regressieproblemen zie je vaak de volgende grafiek waarin werkelijke waarden (ground truth) worden uitgezet tegen de voorspellingen van het model.
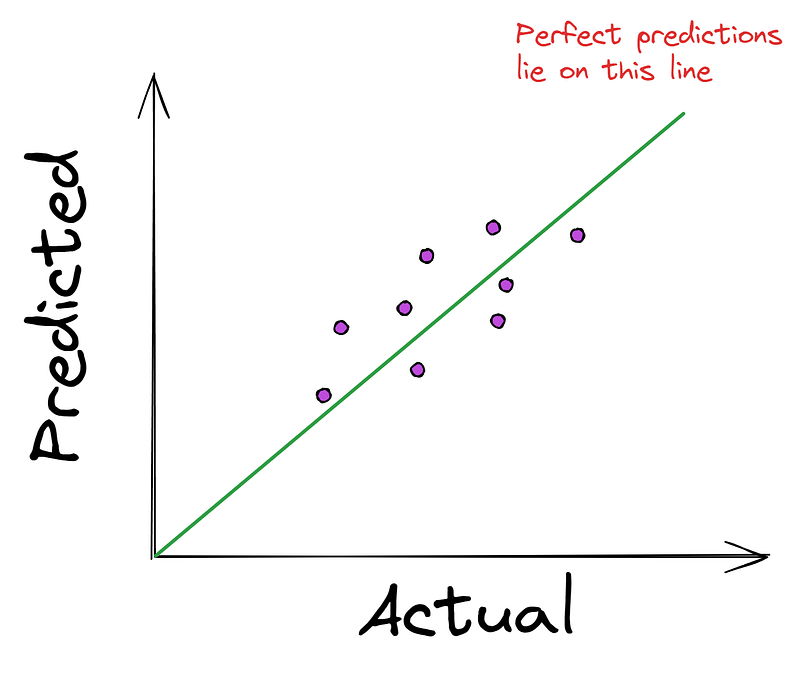
Hoe dichter de punten bij de rechte lijn liggen, hoe beter de modelvoorspellingen zijn. Daarom proberen de meeste regressie-algoritmen de gemiddelde afstand van de punten tot de perfecte lijn te minimaliseren. En zoals we eerder noemden, gebeurt die minimalisatie met een kostfunctie zoals Mean Squared Error (MSE).
MSE neemt de werkelijke en voorspelde waarden als invoer en produceert de kwadratische gemiddelde afstand tot de perfecte lijn.
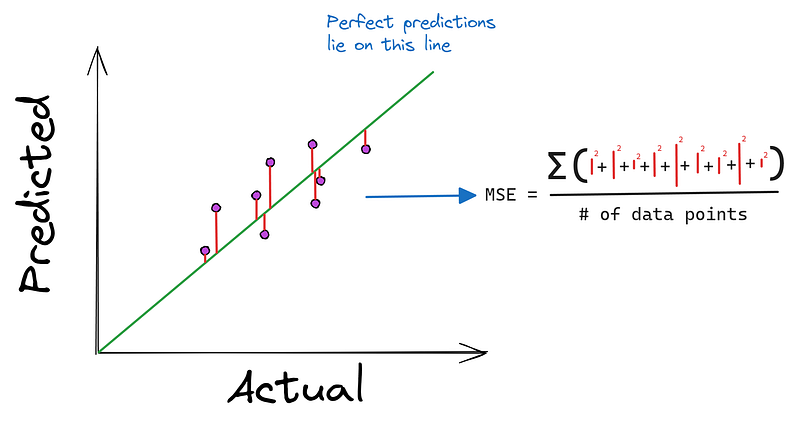
Je vraagt je misschien af: “Waarom de verschillen kwadrateren in plaats van hun absolute waarde te nemen?” De eerste reden is dat de afgeleide van een kwadratische functie heel eenvoudig te vinden is. Bovendien benadrukt het kwadrateren grotere fouten, waardoor het model zwaarder wordt bestraft voor zijn slechtste voorspellingen.
Daarom heeft MSE de voorkeur boven alternatieven zoals Mean Absolute Error (MAE), die op het eerste gezicht eenvoudiger lijken maar moeilijker te differentiëren zijn.
Het volgende stukje in de gradient-descentpuzzel is de gradiënt zelf. Laten we teruggaan naar onze “de heuvel af”-analogie om dit beter te begrijpen.
We stonden geblinddoekt op de top van de heuvel en wilden zo snel mogelijk beneden komen. Als we water bij onze voeten zouden gieten, welke kant stroomt het dan op? Het stroomt bergafwaarts in de richting van de steilste afdaling.
Dit is precies wat de gradiënt ons vertelt, maar dan in de tegenovergestelde richting. De gradiënt wijst bergop — in de richting van de steilste stijging. Als we de fout willen minimaliseren, gaan we simpelweg in de tegenovergestelde richting van de gradiënt om de snelste weg naar beneden te vinden.
Wiskundig gezien vertelt de gradiënt ons hoe de uitvoer van een functie verandert wanneer we de invoer veranderen. Meer specifiek wijst hij ons in de richting waarin de functie het snelst toeneemt.
In de context van machine learning, waar we de fout proberen te minimaliseren met een verliesfunctie, wordt de gradiënt onze gids om het snelste pad te vinden om die fout te verminderen.
De gradiënt wordt weergegeven als een vector — één component voor elke invoerparameter van onze functie. Elk getal in deze vector vertelt ons hoeveel de functie zou veranderen als we een kleine aanpassing doen aan de overeenkomstige parameter.
Hoe vind je dan de gradiënt van een functie?
Voor éénvariabele functies zoals f(x) = x ** 2 is de gradiënt de afgeleide van de functie, gegeven als een vector met één element — [2x].
Voor multivariabele functies zoals f(x1, x2) = x1 ** 3 - x2 ** 2 bevat de gradiënt de partiële afgeleiden van de functie naar elke invoer. Voor de tweede functie is de gradiëntvector dus [3x1 ** 2, 2*x2].
Terug naar MSE, met de volgende formule:
MSE = (1/n) * Σ(y - f(x))² waarbij:
f(x) gelijk is aan mx + bm en b de variabelen van de functie zijnx de karaatwaarde van de diamanten isn het aantal datapunten isy de werkelijke prijs van diamanten isDe gradiënt daarvan zijn de partiële afgeleiden van MSE naar m en b:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
The gradient = [∂/∂m (MSE), ∂/∂b (MSE)]
Maak je niet te veel zorgen over deze formules. Het belangrijkste is dat ze ons vertellen hoe de mean squared error verandert als we m of b een klein beetje veranderen.
Nu hebben we alles wat we nodig hebben om gradient descent uit te voeren of, met andere woorden, zo efficiënt mogelijk de heuvel af te gaan. Maar springen we in die richting of zetten we kleine stapjes? Dat wordt toch bepaald door de gradiënt? De grootte van de gradiënt vertelt ons hoe ver we bij elke stap naar beneden gaan.
Maar stel dat de gradiënt zo groot is dat we in plaats van de bodem te bereiken, eroverheen schieten en in één stap op een andere heuveltop eindigen. Verrassend genoeg gebeurt dit vaak bij gradient descent, dus introduceren we een parameter, de stapgrootte, die het effect van de gradiënt regelt.
Voordat we een stap zetten, vermenigvuldigen we de gradiënt simpelweg met de stapgrootte, waardoor de grootte afneemt. Als onze gradiënt ons bijvoorbeeld vertelt om 3,56 stappen bergafwaarts te zetten, maakt een stapgrootte van 0,1 de afstand 0,356.
Het zal langer duren om de bodem te bereiken, maar nu lopen we niet het risico die helemaal over te slaan.
Learning rate is de gebruikelijke term in machine learning voor stapgrootte en ligt meestal tussen 0,001 en 0,3.
Laten we nu de wiskundige versie van dit proces bekijken.
Eerst geven we de m- en b-parameters van ons model willekeurige waarden:
m = 0.215  # Generated randomly
b = 0.059
Met deze waarden berekenen we de initiële MSE op de volledige dataset:
MSE = (1/n) * Σ(y - (0.215 * x + 0.059))² = ...Om deze fout te verlagen, moeten we nu een kleine stap in de tegenovergestelde richting van de gradiënt zetten; met andere woorden, we moeten m en b bijwerken met de gradiënt en de learning rate:
m_new = 0.215 - alpha * (∂/∂m (MSE))
b_new = 0.059 - alpha * (∂/∂b (MSE))
De meeste bronnen gebruiken alpha of α (de Griekse letter) om de learning rate aan te duiden.
Nadat we nieuwe waarden voor m en b hebben, berekenen we opnieuw de MSE:
MSE_new = (1/n) * Σ(y - (m_new * x + b_new))²Nu berekenen we opnieuw de gradiënt en gaan we zo door totdat we een stopconditie bereiken.
Leer visueel hoe de learning rate de training beïnvloedt door dit artikel over gradient descent te bekijken.
Omdat we geblinddoekt zijn, kunnen we niet echt zien wanneer we de bodem hebben bereikt, zeker niet als we kleine stapjes zetten.
We hebben dus voorwaarden nodig om onze afdaling te stoppen. Meestal worden deze regels gebruikt:
Deze regels stel jij, de ML-engineer, in wanneer je gradient descent uitvoert. Python-implementaties van het algoritme hebben meestal argumenten om deze regels in te stellen; we zullen er later een paar zien.
Voordelen:
Uitdagingen:
In de volgende sectie zien we hoe Stochastic Gradient Descent enkele van deze uitdagingen aanpakt, met name voor grote datasets.
Zodra je de reguliere gradient descent begrijpt, wordt SGD heel eenvoudig om te snappen.
Hoewel gradient descent een van de elegantste optimalisatiealgoritmen is, heeft het een belangrijk nadeel bij grote datasets. Onthoud dat we bij elke stap de gradiënt berekenen met alle datapunten in onze dataset:
∂/∂m (MSE) = (-2/n) * Σ(x * (y - (mx + b)))
∂/∂b (MSE) = (-2/n) * Σ(y - (mx + b))
Hier zijn x en y arrays met alle karaatwaarden en werkelijke prijzen van diamanten. Dat betekent dat we bij elke stap de informatie van elke diamant gebruiken om parameters bij te werken.
Zoals je je kunt voorstellen, wordt dit computationeel duur en tijdrovend wanneer we miljoenen datapunten hebben. In het tijdperk van big data kan deze beperking reguliere gradient descent onpraktisch maken voor veel realistische machinelearning-problemen.
“Stochastic” betekent “willekeurig bepaald”, en dat is precies wat SGD doet: het introduceert willekeur in ons optimalisatieproces.
In plaats van alle datapunten te gebruiken om de gradiënt te berekenen, selecteert SGD bij elke stap willekeurig één datapunt. Het gebruikt dit ene punt om een schatting van de gradiënt te berekenen en de parameters bij te werken.
Omdat SGD telkens maar één datapunt bekijkt, kan het vaker parameterupdates uitvoeren. Hierdoor kan het sneller het foutenlandschap (de heuvel) doorkruisen, vooral bij grote datasets.
Deze snelheid heeft echter een prijs. Omdat we een enkel datapunt gebruiken om de gradiënt van de hele dataset te schatten, zijn onze schattingen veel ‘ruiziger’. Dit betekent dat ons pad omlaag over het foutenoppervlak minder soepel en grilliger is.
Om SGD uit te voeren, definiëren we eerst een stochastische kostfunctie.
In plaats van de Mean Squared Error over alle datapunten te berekenen, kijken we nu naar de kwadratische fout voor één willekeurig gekozen punt:
Cost = (y - f(x))²Waarbij y de werkelijke prijs is van de willekeurig gekozen diamant, en f(x) = mx + b onze voorspelde prijs voor die diamant is.
Vervolgens berekenen we de stochastische gradiënt van deze kostfunctie naar onze parameters m en b:
∂/∂m (Cost) = -2x(y - (mx + b))
∂/∂b (Cost) = -2(y - (mx + b))
The stochastic gradient = [∂/∂m (Cost), ∂/∂b (Cost)]
Met deze stochastische gradiënt werken we onze parameters bij op dezelfde manier als bij reguliere gradient descent:
m_new = m_old - learning_rate * ∂/∂m (Cost)
b_new = b_old - learning_rate * ∂/∂b (Cost)
Het kernidee in SGD is dat elke stap één willekeurig gekozen datapunt omvat. De regels om te stoppen blijven hetzelfde als bij reguliere gradient descent.
In de praktijk wordt ‘vanilla’ SGD, waarbij parameters voor elk trainingsvoorbeeld worden bijgewerkt, zelden gebruikt. De reden is dat de updates van het algoritme een te hoge variantie hebben, waardoor de verliesfunctie kan schommelen en het lastiger wordt om naar het exacte minimum te convergeren.
Reguliere gradient descent is krachtig en levert stabielere resultaten op, maar zoals we eerder noemden, gebruikt het bij elke stap alle datapunten, wat het onpraktisch maakt voor huidige datasets.
Om de balans te vinden tussen stabiliteit en snelheid wordt mini-batch gradient descent vaak gebruikt, vooral in neurale netwerken. Bij mini-batch GD wordt in plaats van één willekeurig voorbeeld een batch met voorbeelden gebruikt bij het bijwerken van parameters. Veelvoorkomende batchgroottes zijn 16, 32, 64 enzovoort.
Dus als je een batchgrootte van 1 gebruikt, heb je SGD. Als je batchgrootte gelijk is aan de datasetgrootte, heb je reguliere gradient descent. Elke andere batchgrootte levert mini-batch gradient descent op.
Hier is een tabel die de verschillen samenvat en wanneer je welke gebruikt:
| Type | Updatefrequentie | Computationele efficiëntie | Geheugenvereisten | Convergiestabiliteit | Beste gebruiksscenario |
| Gradient Descent (GD) | Volledige dataset per update | Traagst door gebruik van volledige dataset | Vereist volledige dataset in het geheugen | Meest stabiel, maar het traagst | Kleine datasets waar stabiliteit cruciaal is |
| Stochastic Gradient Descent (SGD) | Eén voorbeeld per update | Allersnelst, verwerkt telkens één voorbeeld | Lage geheugenvraag | Hoge variantie, kan schommelen | Grote datasets die snelle updates nodig hebben |
| Mini-batch Gradient Descent | Batch met voorbeelden per update | Balanceert efficiëntie en snelheid, efficiënter dan GD, trager dan SGD | Vereist geheugen voor één batch | Stabieler dan SGD, minder stabiel dan GD | Grote datasets die balans tussen stabiliteit en efficiëntie vereisen |
Een belangrijk concept in elk type optimalisatie-algoritme is een epoch. Dit verwijst naar één volledige doorgang door de gehele trainingsdataset.
In een epoch verwerkt het algoritme elk voorbeeld in de trainingsdataset precies één keer. Voor elk voorbeeld (of mini-batch) doet het model voorspellingen, berekent het verlies en werkt het de gewichten bij op basis van de gradiënt van het verlies. Een epoch markeert een cyclus van verbetering voor het model. Na elke epoch kun je doorgaans zien hoe de prestaties van het model zijn veranderd.
Training omvat meestal meerdere epochs (minstens 10 wordt aanbevolen). Het aantal epochs is een hyperparameter die je kunt afstemmen. Vaak worden de gegevens voor elke epoch geschud om te voorkomen dat het model de volgorde van de trainingsvoorbeelden leert.
In onze geblinddoekte heuvelverkenningsanalogie is een epoch één volledige verkenning van het hele landschap. Tijdens elke epoch:
Na elke volledige verkenning begin je opnieuw vanaf je nieuwe positie. Meerdere epochs geven het model herhaaldelijk de kans om het verlieslandschap te verkennen, waardoor de kans toeneemt om een goed minimum te vinden.
Meerdere epochs garanderen echter niet dat het globale minimum wordt gevonden, en het hele proces kan worden beïnvloed door factoren zoals het startpunt of de complexiteit van het verlieslandschap.
In deze sectie implementeren we SGD met ondersteuning voor batchgrootte (mini-batch GD) met alleen Numpy.
Laten we eerst de benodigde libraries importeren:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
We gebruiken 10.000 datapunten uit de Diamonds-dataset die beschikbaar is in Seaborn. We nemen alleen het kenmerk carat en de kolom price als doelvariabele:
# Load the data
dataset_size = 10_000
diamonds = sns.load_dataset('diamonds')
# Extract the target and the feature
xy = diamonds[['carat', 'price']].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
(10000, 2)
Laten we de gegevens nu splitsen in trainings- en testsets, waarbij we de trainingsgrootte instellen op 80% van het totaal.
# Split the data
np.random.shuffle(xy)
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(8000, 2)
Definieer vervolgens onze modelfunctie:
def model(m, x, b):
   """Simple linear model"""
   return m * x + b
We doen eenvoudige lineaire regressie met slechts twee onafhankelijke variabelen m en b.
We moeten ook onze verliesfunctie MSE definiëren:
def loss(y_true, y_pred):
   """Mean squared error"""
   return np.mean((y_true - y_pred) ** 2)
Nu definiëren we een functie genaamd stochastic_gradient_descent die zes argumenten neemt:
x en y staan voor het enkele kenmerk en de doelvariabele in ons probleemepochs geeft aan hoe vaak we de afdaling willen uitvoeren (later meer)learning_rate is de stapgroottebatch_size om te bepalen hoe vaak we parameterupdates doenstopping_threshold stelt de minimale daling van de loss per stap indef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD met ondersteuning voor mini-batches.
"""Om te beginnen initialiseren we de parameters die we willen optimaliseren met willekeurige waarden en zetten we de loss op oneindig:
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infVervolgens starten we een for-lus met de parameter epochs. In de lus schudden we de gegevens om de berekeningen robuuster te maken:
for i in range(epochs):
# Shuffle the data
indices = np.random.permutation(n)
x = x[indices]
y = y[indices]Daarna begint de eigenlijke gradiëntberekening binnen een andere for-lus.
for j in range(0, n, batch_size):
x_batch = x[j:j + batch_size]
y_batch = y[j:j + batch_size]We halen de batch uit x en y en berekenen de gradiënten:
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)We gebruiken de functie model die we hierboven hebben gemaakt om een voorspelling te doen met de huidige waarden van m en b. Vervolgens vinden we de partiële afgeleiden die de gradiënt vormen met de formule die we eerder noemden.
Met de partiële afgeleiden en de learning rate werken we de parameters bij:
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientHier is de volledige code tot nu toe:
def stochastic_gradient_descent(
   x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
   """
   SGD met ondersteuning voor mini-batches.
   """
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x)
previous_loss = np.inf
for i in range(epochs):
   # Shuffle the data
   indices = np.random.permutation(n)
   x = x[indices]
   y = y[indices]
for j in range(0, n, batch_size):
   x_batch = x[j:j + batch_size]
   y_batch = y[j:j + batch_size]
# Compute the gradients
y_pred = model(m, x_batch, b)
m_gradient = -2 * np.mean(x_batch * (y_batch - y_pred))
b_gradient = -2 * np.mean(y_batch - y_pred)
# Update the model parameters
m -= learning_rate * m_gradient
b -= learning_rate * b_gradientBuiten de binnenste lus gaan we verder en berekenen we de loss voor de epoch:
# Compute the loss
y_pred = model(m, x, b)
current_loss = loss(y, y_pred)
Als de current_loss kleiner is dan de stopping_threshold stoppen we het hele proces:
if previous_loss - current_loss < stopping_threshold:
   break
previous_loss = current_loss
Anders zetten we previous_loss op current_loss. Tot slot geven we de geoptimaliseerde parameters m en b terug:
return m, bIk heb de volledige code geplakt in deze GitHub-gist zodat je het geheel kunt bekijken.
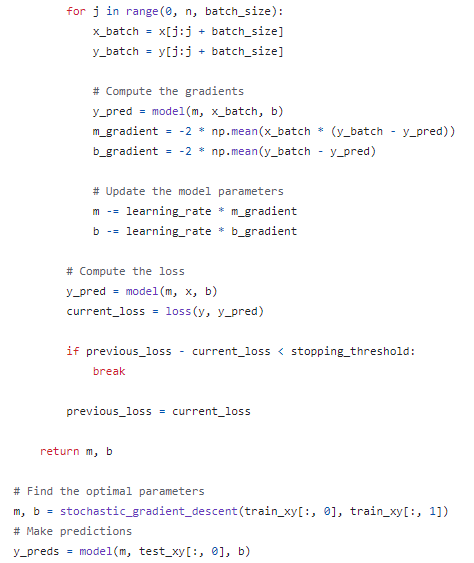
Laten we testen hoe goed de gevonden parameters werken door het model op de testset uit te voeren:
# Find the optimal parameters
m, b = stochastic_gradient_descent(train_xy[:, 0], train_xy[:, 1])
# Make predictions
y_preds = model(m, test_xy[:, 0], b)
# Compute and print the loss
mean_squared_error = loss(test_xy[:, 1], y_preds)
mean_squared_error ** 0.5
1595.3955619759456
De wortel van de MSE is ongeveer $1.600, wat betekent dat ons model er gemiddeld $1.600 naast zit. Om de fout te verbeteren kunnen we het aantal epochs verhogen of een grotere dataset gebruiken.
De implementatie van SGD in de vorige sectie is grof en inefficiënt. Hij dient enkel om de intuïtie die we in eerdere secties hebben opgebouwd, te versterken met een code-walkthrough.
In de praktijk herimplementeer je SGD bijna nooit handmatig, maar gebruik je beschikbare versies in populaire frameworks.
Zo biedt Scikit-learn de SGDRegressor- en SGDClassifier-schatters om diverse ML-algoritmen te trainen, zoals:
met SGD als optimalisatie-algoritme.
from sklearn.linear_model import SGDRegressor, SGDClassifier
# SGD for Linear Regression with 1000 epochs
regressor = SGDRegressor(loss='squared_loss', max_iter=1000)
In PyTorch is het beschikbaar als de klasse SGD in de module optim:
import torch.optim as optim
optimizer = optim.SGD(model.parameters(), lr=0.01)
Om te leren hoe je modellen traint en optimaliseert in PyTorch, bekijk de DataCamp-cursus Introduction to PyTorch.
In Keras is SGD onder dezelfde naam beschikbaar:
from tensorflow.keras.optimizers import SGD
optimizer = SGD(learning_rate=0.01)
Om te leren hoe je modellen traint en optimaliseert in TensorFlow, bekijk de DataCamp-cursus Introduction to TensorFlow.
Er zijn veel best practices en tips voor het gebruik van SGD of soortgelijke algoritmen. Hieronder lichten we er een aantal uit:
Vandaag hebben we een van de kernoptimalisatie-algoritmen in machine learning geleerd — Stochastic Gradient Descent.
Eerst hebben we intuïtie en de fundamentele ideeën opgebouwd door een regulier gradient-descent-algoritme te bekijken. We hebben uitgebreid een heuvelanalogie gebruikt waarin we geblinddoekt de bodem proberen te vinden.
We hebben geleerd dat SGD en reguliere GD verschillen in de hoeveelheid datapunten die worden gebruikt bij parameterupdates. Om onze intuïtie te verstevigen en de wiskundige details uit te werken, hebben we SGD in Numpy geïmplementeerd.
Onthoud dat SGD slechts een onderdeel is van het hele ML-trainingsproces. Om meer te leren over de rol ervan, bekijk de volgende bronnen:
Topcursussen op DataCamp
Leerpad
Leerpad
Leerpad
blog
Adel Nehme
15 min

