Curso
Claude Code 101
3 h
28.3K
O Meta Superintelligence Labs lançou seu primeiro modelo de geração de imagens, o Muse Image, já disponível no app Meta AI. Ele vem após o Muse Spark, o primeiro modelo de texto do laboratório, e se soma à família Muse, que a Meta está usando para substituir a linha Llama.
Alexandr Wang, que lidera o Meta Superintelligence Labs, descreve o Muse Image como "agêntico": ele trabalha em conjunto com o modelo de linguagem Muse Spark para raciocinar sobre o prompt, buscar na web e planejar o layout antes de renderizar.
Nos benchmarks internos da Meta, o Muse Image fica atrás do GPT Image 2 da OpenAI em qualidade geral, mas supera o Nano Banana 2 do Google em tarefas de edição de imagem única e multi-imagem.
Neste artigo, eu trago tudo o que há de novo no Muse Image: recursos, a abordagem de raciocínio em primeiro lugar, preços e acesso, e a questão de privacidade envolvendo usar fotos públicas do Instagram em imagens de IA (com passo a passo para desativar). Também aponto onde o Muse Video entra no roadmap da Meta. Aproveite e confira nosso guia sobre o novo Muse Glimmer.
O Muse Image é o primeiro modelo de geração de imagens criado pelo Meta Superintelligence Labs, originalmente codinome "Mango", segundo a CNBC. Ele impulsiona a criação de imagens no app Meta AI, no meta.ai na web, no Instagram e no WhatsApp — com Facebook e Messenger chegando em breve.
A grande decisão de design é que o Muse Image não transforma um prompt diretamente em pixels. Ele usa uma camada intermediária de raciocínio, trabalhando com o Muse Spark para planejar a composição, buscar contexto em tempo real na web e combinar múltiplas fotos de referência antes de gerar qualquer coisa.
Uma análise técnica independente no YouTube afirma que o modelo efetivamente escreve antes um plano interno da imagem, o que melhora a precisão composicional em cenas complexas com vários objetos.
Nas comparações internas da Meta, o Muse Image fica atrás do GPT Image 2 em qualidade geral, mas vence o Nano Banana 2 tanto em edição de imagem única quanto multi-imagem.
Esse posicionamento deixa claro o foco: resultados realistas e seguros para marcas, pensando em criadores e anunciantes — não uma "personalidade artística" marcante como a de outros modelos.
O Muse Image gira em torno de recursos pensados para quem quer ir da ideia à imagem pronta para compartilhar sem ter que dominar prompt engineering. Veja os destaques.
Você pode explicar o que quer em linguagem conversacional e deixar a Meta AI cuidar da composição.
Como o Muse Image raciocina sobre o prompt antes, ele se sai melhor em pedidos que envolvem relações espaciais — como posicionar vários objetos de um jeito específico — do que um modelo de difusão que trabalha direto do texto.
O modelo também rendeiriza texto dentro das imagens de forma legível, então dá para pedir um infográfico ou um passo a passo com rótulos estilizados e fáceis de ler.
A própria Meta divulga que ele consegue até criar um QR code funcional a partir de um prompt.
Mas vale o alerta de testadores independentes: tipografia fina ainda é inconsistente. Textos pequenos em placas, mockups de UI e rótulos de produtos podem sair embaralhados — então encare a promessa de "texto legível" como "na maioria das vezes", não "sempre".
O Muse Image vem com um painel de presets com prompts sugeridos para você não encarar uma caixa em branco.
Com um toque, dá para restaurar uma foto antiga da família, testar um corte de cabelo que está bombando ou se transformar em um boneco de massinha ou herói de game 16-bit retrô.
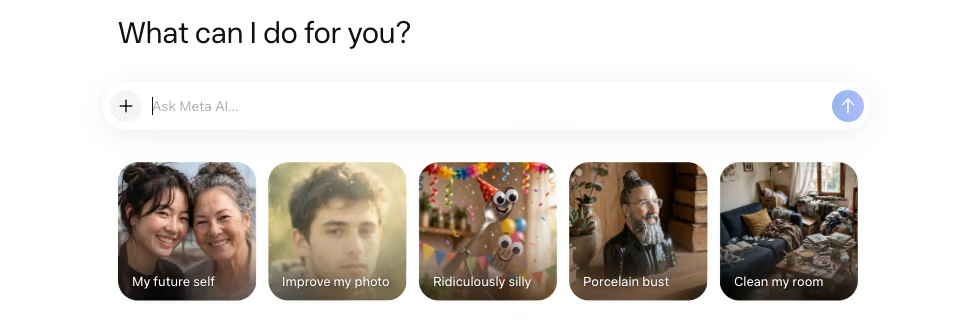
O que você criar pode ser compartilhado como preset com amigos, para eles rodarem nas próprias fotos.
Essa é a mecânica na qual a Meta aposta para viralizar dentro dos seus apps — a mesma por trás dos 30+ novos efeitos de IA chegando aos Stories do Instagram, começando pelos EUA antes de um lançamento mais amplo.
Você pode fotografar um ambiente e pedir para a Meta AI repaginar usando produtos reais coletados da web ou do Facebook Marketplace.
Sugira um estilo ou peça para puxar o que está em alta, e ela renderiza seu espaço com um makeover completo usando itens que você realmente pode comprar.
Esse é o gancho comercial mais evidente do lançamento.
Conectar a geração de imagens diretamente a anúncios do Marketplace transforma um mockup divertido em funil de compras — exatamente por isso anunciantes terão acesso via Meta Advantage+ creative nas próximas semanas.
Você pode @-mencionar uma conta do Instagram dentro de um prompt na Meta AI, e o modelo vai usar as fotos públicas daquela conta para montar uma imagem com a semelhança da pessoa.
A Meta posiciona isso para convites personalizados de eventos ou criações colaborativas.
É o recurso que mais chama atenção — com razão.
Permitir que qualquer um incorpore fotos públicas do Instagram de outra pessoa em imagens geradas por IA levanta questões óbvias de consentimento e mau uso, mesmo com filtros de segurança ativos da Meta.
Vou explicar a configuração de opt-out numa seção à parte, porque ela é mais importante que qualquer preset — mas veja abaixo o recurso em ação.
Para alterar uma imagem gerada, toque no ícone de marcação e circule, rascunhe ou anote a edição por cima da foto.
Como a Meta AI lembra todo o contexto da conversa, dá para continuar refinando, trocando estilos ou adicionando elementos sem recomeçar do zero.
Uma limitação honesta, apontada por quem testou cedo: o modelo ainda não acompanha de forma confiável o "estado da cena" ao longo de muitas edições sequenciais, e não há controle por camadas como em uma ferramenta de design dedicada.
É ótimo para ajustes iterativos; já para composições precisas e multi-passos, nem tanto.
O recurso de @-menção permite que a Meta AI crie uma imagem a partir de fotos públicas do Instagram de alguém quando você marca o @usuário — e é aqui que vale pausar.
Isso significa que suas fotos públicas de perfil podem virar material de origem para imagens que outras pessoas geram, o que é bem diferente de simplesmente exibir as fotos.
A Meta diz que você tem controle sobre permitir esse reuso, oferecendo uma configuração para desativar o recurso a qualquer momento.
Se você prefere que suas fotos públicas do Instagram não sejam usadas nas criações de IA de outras pessoas, ajuste a opção de marcação para criação por IA nos controles do seu Instagram.
Abra o app do Instagram e toque no ícone do seu perfil.
Toque no menu hambúrguer (três linhas horizontais) no canto superior direito e selecione Configurações e atividade.
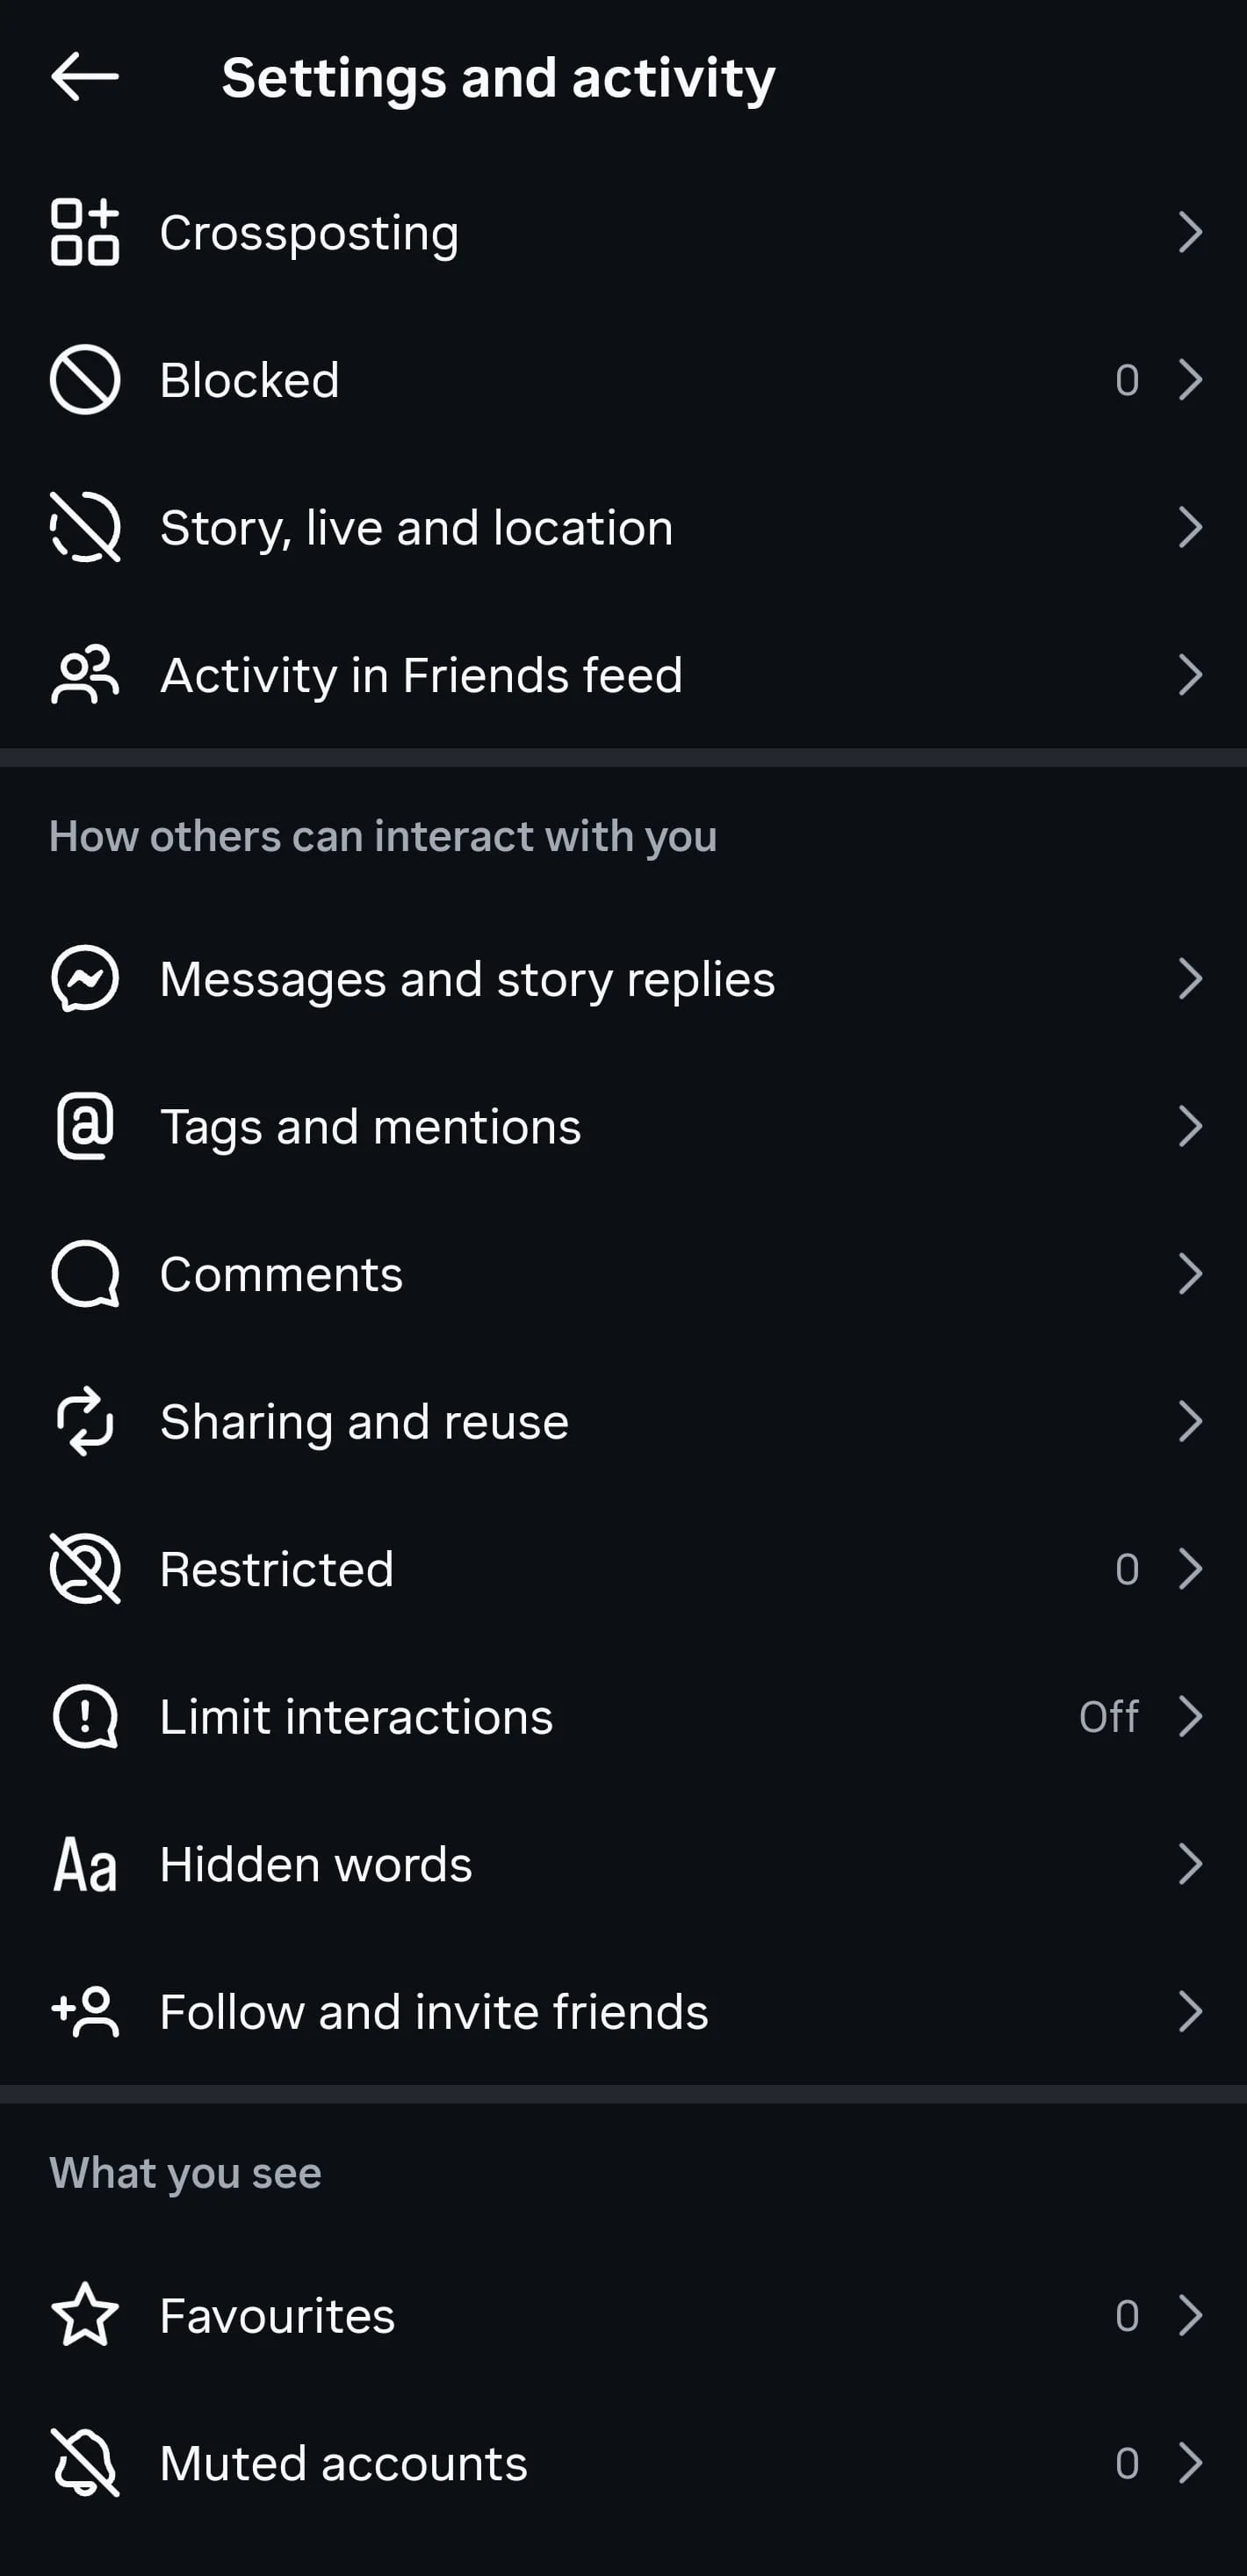
Role e toque em Compartilhamento e reutilização.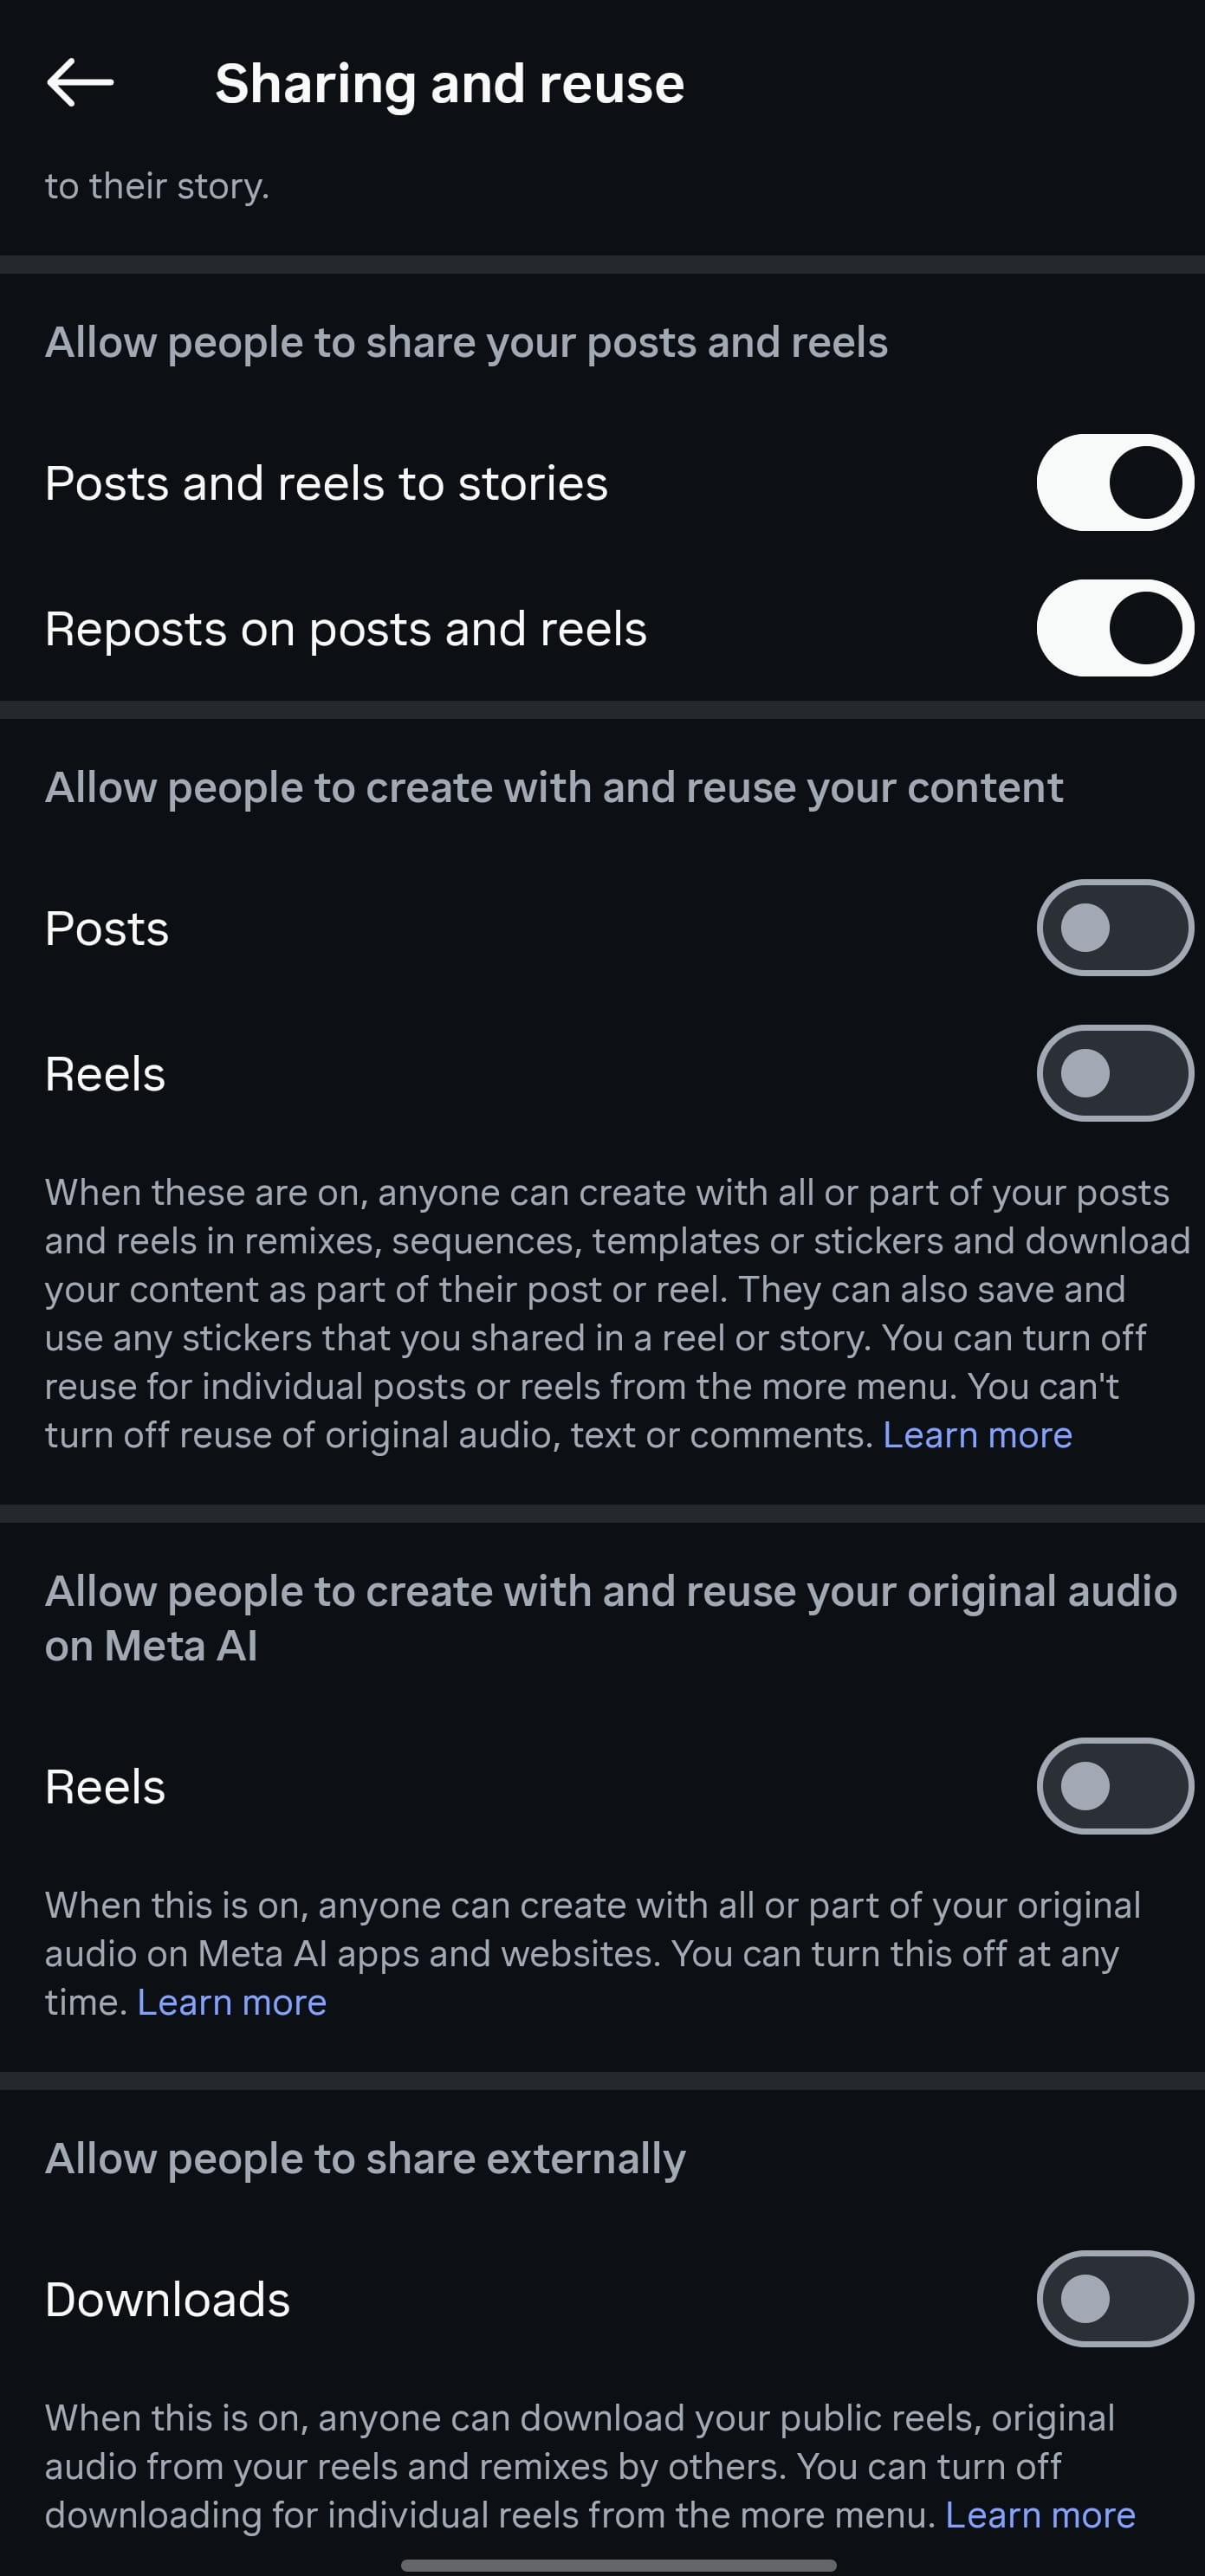
Desligue as chaves individuais. Dependendo da versão do seu app, você pode ver opções separadas para posts, Reels e áudio original.
Minha opinião: deixar o opt-out como padrão coloca o peso no usuário — e a maioria nunca vai achar essa opção. Se você tem um perfil público e isso te preocupa, mude a configuração agora em vez de esperar para ver como o recurso será usado.
As promessas do Muse Image merecem teste direto: composição guiada por raciocínio, texto legível na imagem, mistura de múltiplas imagens e edições por esboço iterativo. Abaixo estão prompts que um editor humano pode rodar no app Meta AI para avaliar cada ponto. Eu não executei esses testes; as seções de resultados são espaços para o editor completar.
Foca na promessa de que o Muse Image lida melhor com relações entre objetos do que um modelo de difusão direto do texto.
Create a photorealistic image of a green bicycle leaning against a brick wall,
with a small orange cat sitting on the seat and a red umbrella open on the ground
to the left of the front wheel.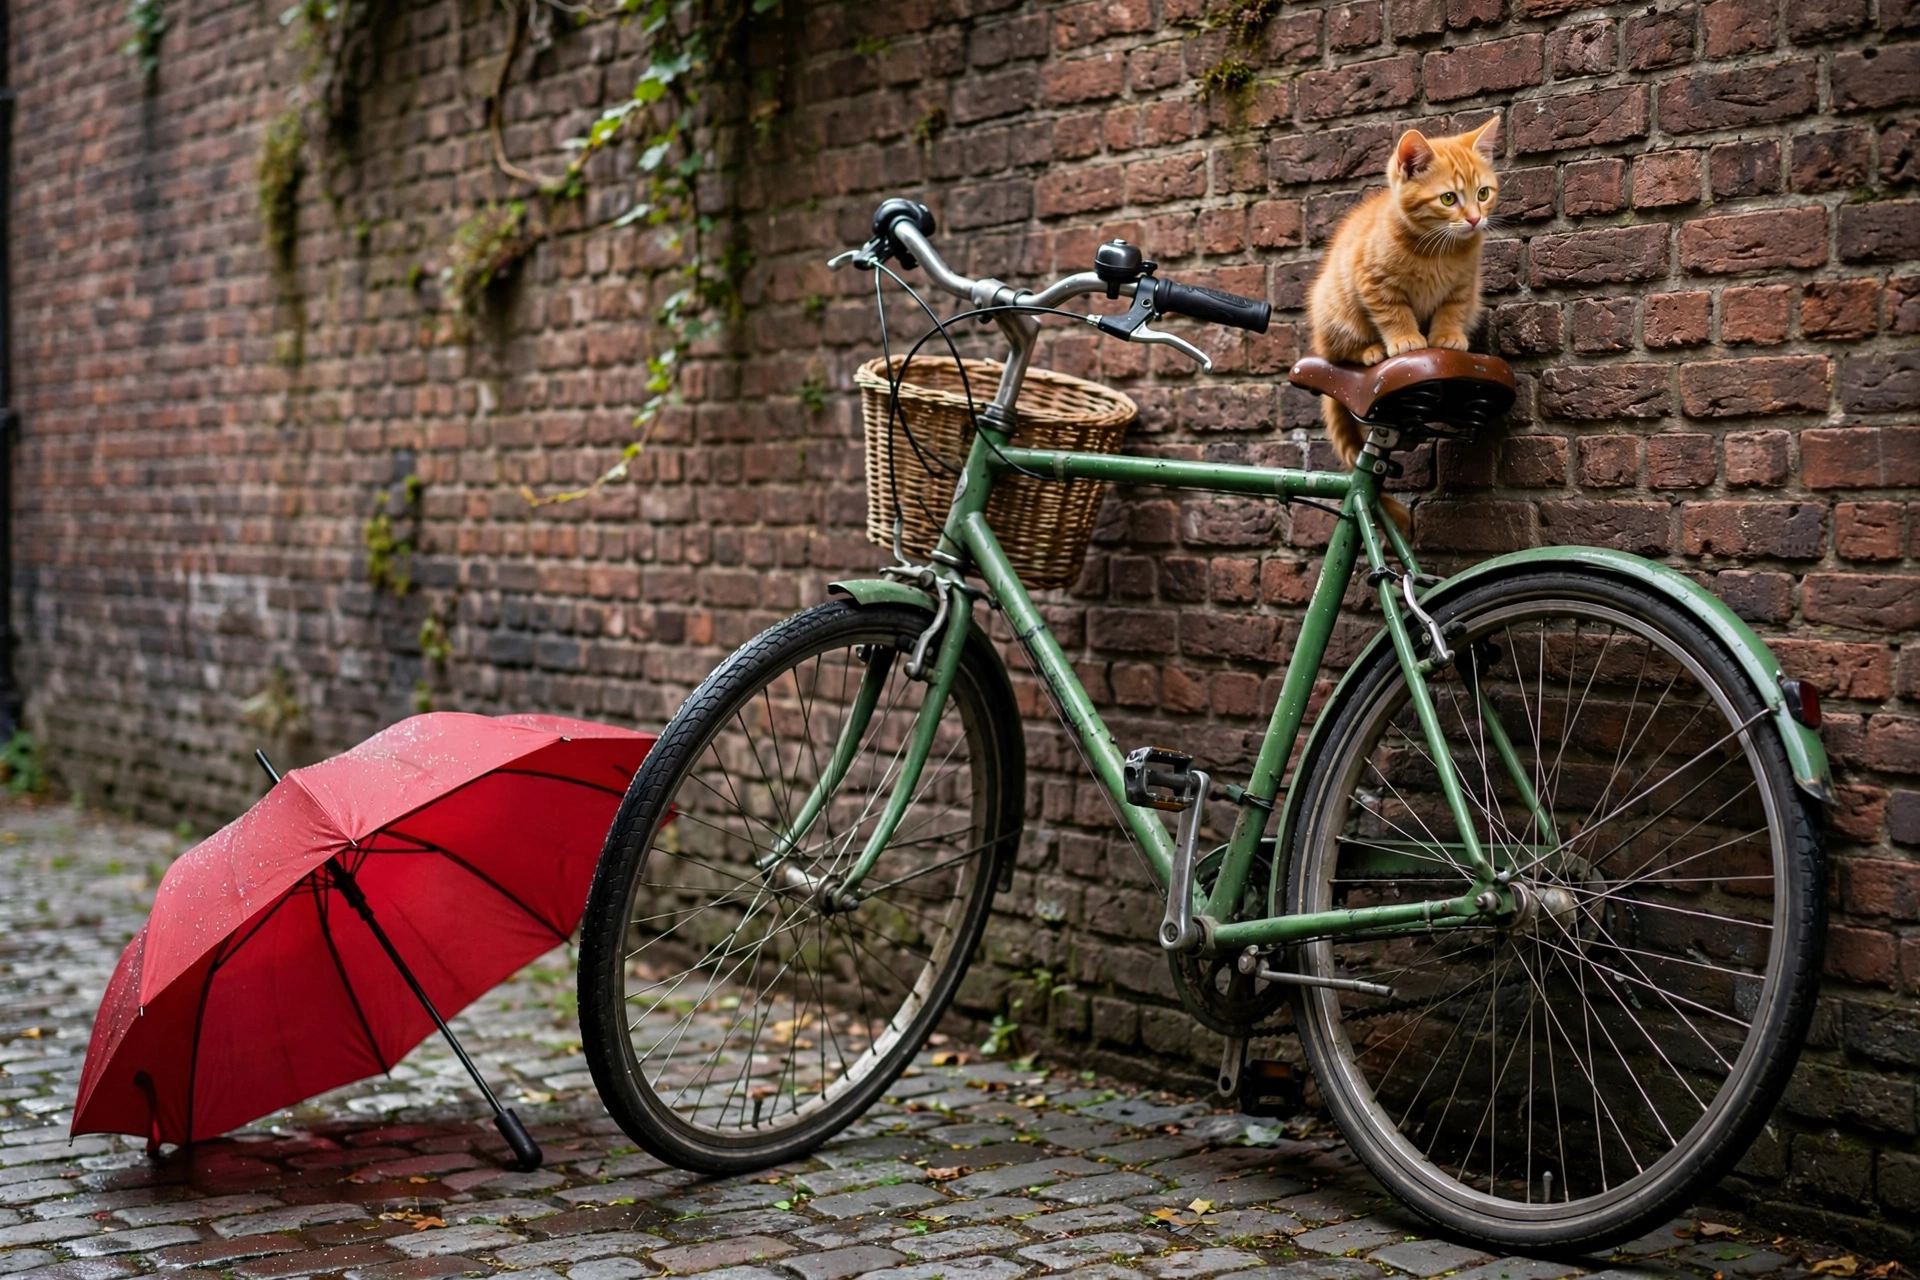
Como dá para ver, ele fez um trabalho bem decente, posicionando os objetos como pedido. Há alguns deslizes: a cesta ficou numa posição estranha e parecem existir três pedais, não dois. O gato também "salta" mais que o restante da imagem. Mas, no geral, é um bom resultado.
A Meta afirma que o Muse Image renderiza texto estilizado e legível dentro das artes. Texto pequeno é o ponto fraco conhecido, então este teste pressiona justamente aí.
Make a clean infographic titled "Morning Routine" with four numbered steps:
1. Drink water, 2. Stretch for five minutes, 3. Eat breakfast,
4. Review your to-do list. Use a minimal flat design with legible sans-serif
labels.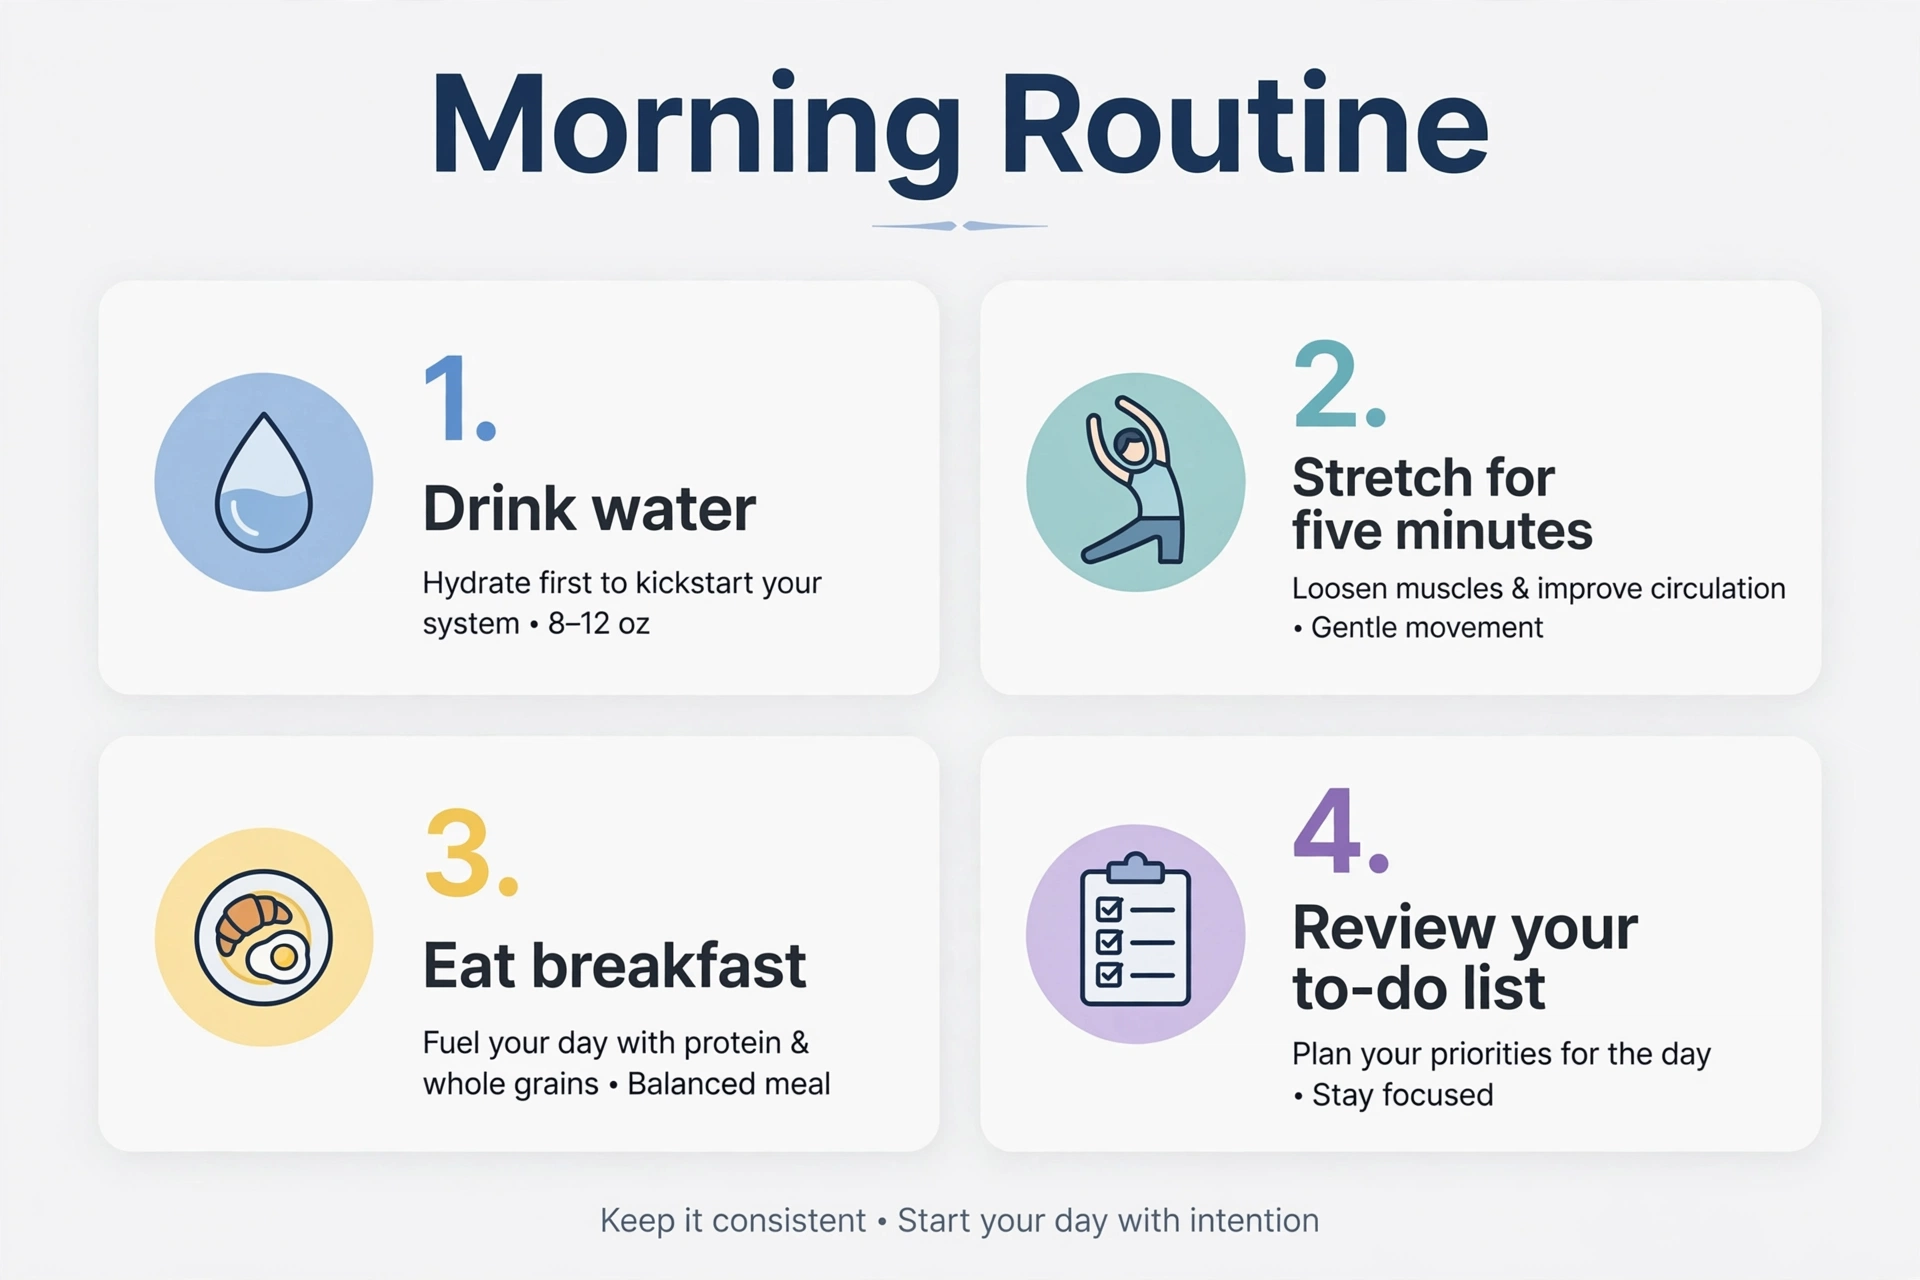
De novo, ficou ok. Os rótulos estão escritos corretamente e a fonte é aceitável, embora a escala não esteja muito consistente entre os quatro painéis. Ele acrescentou contexto extra que eu não pedi, mas até que ajuda.
Testa o fluxo de marcar e refinar e se o modelo mantém o restante da imagem consistente nas edições.
Generate a photo of a wooden kitchen table with a single white coffee mug on it. T
hen, in a follow-up, add a plate of croissants next to the mug without
changing the table, lighting, or mug.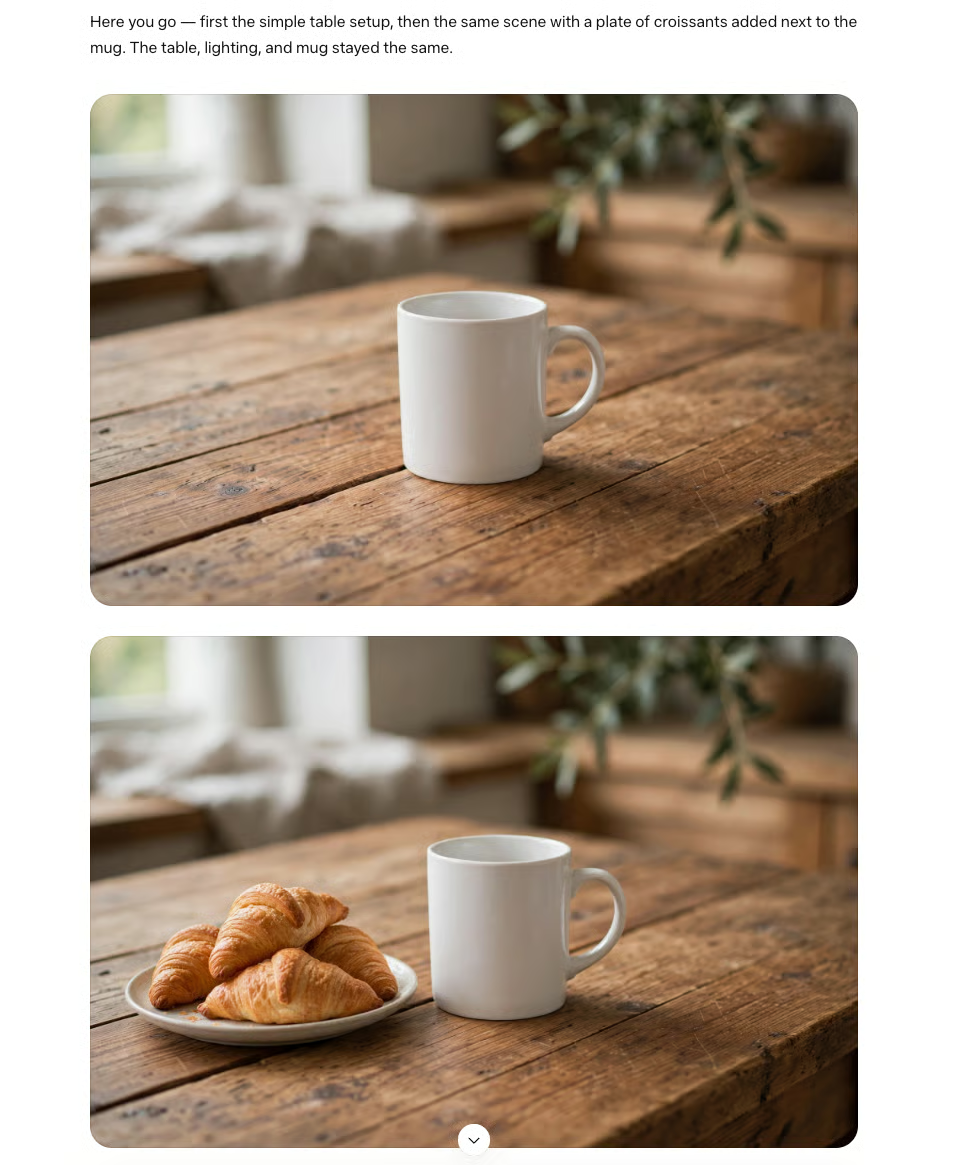
Aqui, o modelo foi bem. A cena original parece bem real e a iluminação está ok. A segunda imagem é consistente com a primeira, mas os croissants ficaram bem artificiais — tamanho e textura destoam.
A Meta não publicou uma tabela padronizada de benchmarks de terceiros para o Muse Image, como os laboratórios costumam fazer com modelos de texto. Os números existentes vêm de comparações internas da própria Meta, então encare-os com a cautela de praxe para resultados auto-relatados.
Nos benchmarks internos de edição da Meta, o Muse Image fica atrás do GPT Image 2 da OpenAI em qualidade geral, mas supera o Nano Banana 2 do Google em tarefas de edição de imagem única e multi-imagem. Em termos simples, benchmarks de edição medem o quão bem um modelo altera uma imagem existente (trocando estilos, adicionando ou removendo objetos) mantendo o resto intacto.
| Modelo (Laboratório) | Text-to-Image Arena | Single-Image Edit Arena | Multi-Image Edit Arena |
|---|---|---|---|
| GPT Image 2 (OpenAI) | Líder (pontuação: 1385) | Líder (pontuação: 1466) | Líder (pontuação: 1454) |
| Muse Image (Meta) | 2º lugar (pontuação: 1280) | 2º lugar (pontuação: 1405) | 2º lugar (pontuação: 1399) |
| Nano Banana 2 (Google) | 4º lugar (pontuação: 1270) | 7º lugar (pontuação: 1387) | 3º lugar (pontuação: 1376) |
Para quem cria no dia a dia, essa classificação sugere que o Muse Image é um editor competente, mas não o de ponta. Se seu fluxo depende da maior fidelidade de edição disponível, o GPT Image 2 ainda lidera — pelos próprios números da Meta.
Vale notar que o modelo de texto relacionado, o Muse Spark, já teve histórico de alegações internas infladas.
A Artificial Analysis descobriu que a métrica interna da Meta para Humanity's Last Exam de 50,2% caiu para 39,9% em testes independentes de agente único. Aplique o mesmo ceticismo às vitórias internas do Muse Image em edição até saírem avaliações de terceiros.
Testadores independentes e discussões na comunidade apontam limitações consistentes que nenhum gráfico de benchmark capta — e que pesam mais no uso diário do que uma nota única de qualidade.
O Muse Image já está disponível no app Meta AI, no meta.ai, em conversas diretas no WhatsApp (países limitados no lançamento) e alimentando os 30+ novos efeitos de IA nos Stories do Instagram, começando nos EUA.
Facebook e Messenger chegam em breve, e anunciantes terão acesso via Meta Advantage+ creative nas próximas semanas.
No uso cotidiano, o Muse Image é gratuito, sujeito a um limite diário ou mensal de gerações — a Meta não divulgou números exatos.
Uso mais intenso e controles avançados ficam nos planos pagos da Meta.
O Muse Image é o primeiro modelo de imagem sério da Meta para fluxos de criação social e publicitária — e a estratégia é clara: colocar uma ferramenta criativa gratuita e guiada por raciocínio na frente de bilhões de usuários do Meta AI, Instagram e WhatsApp, e direcionar a grana de compras e criativos de anúncios pelo Marketplace e pelo Advantage+.
O ritmo acelerado após o Muse Spark indica um roadmap multimodal agressivo, com o Muse Video já em desenvolvimento e prometendo competir em aderência ao prompt, fidelidade visual e consistência temporal.
Vale usar? Para criações casuais e conteúdo social, sim — ainda mais sendo gratuito.
Mas, pelos benchmarks internos da própria Meta, ele fica atrás do GPT Image 2, e testadores independentes descrevem seu estilo padrão como limpo, porém genérico, quando comparado à personalidade do Midjourney. Se você precisa de fidelidade de edição de ponta ou de um traço artístico marcante, ainda não é o modelo ideal.
O ponto para agir hoje é o recurso de @-menção no Instagram. Permitir que outras pessoas criem imagens de IA a partir das suas fotos públicas é uma mudança real; o opt-out fica escondido e o padrão incentiva participação. Se você tem perfil público, mude a configuração agora.
Se você quer entender como modelos assim raciocinam sobre prompts e geram imagens, nossa trilha de habilidades AI Fundamentals é um ótimo começo.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
blog
Richie Cotton
blog
Abid Ali Awan
8 min
blog
Abid Ali Awan
8 min
blog
Dr Ana Rojo-Echeburúa
9 min
blog
Bhavishya Pandit
8 min