Curso
Criando Aplicações de IA com Pinecone
3 h
11.6K
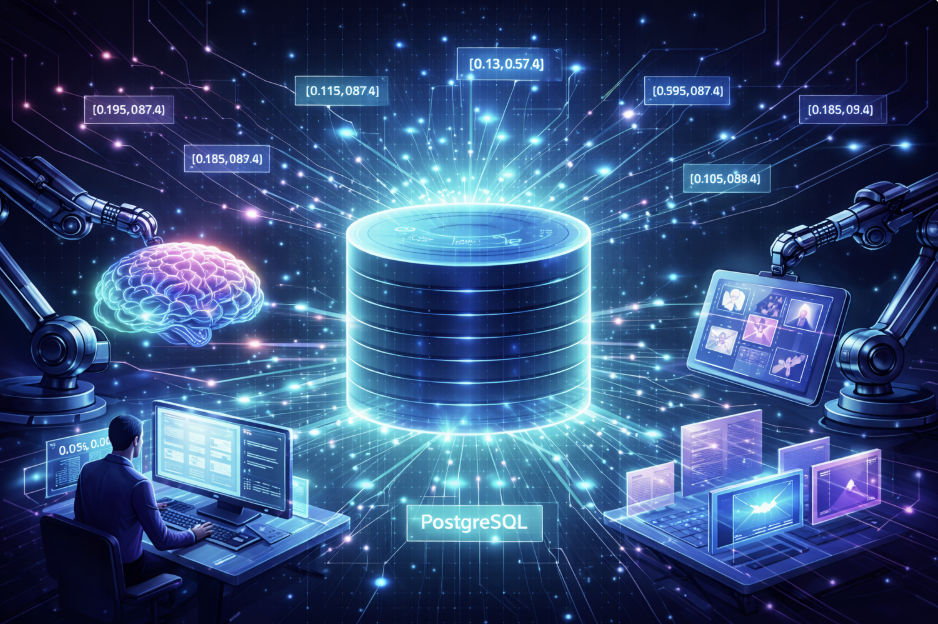
Em essência, um banco de dados vetorial é um sistema criado especificamente para armazenar e recuperar dados em formato de vetor. Aqui, vetor é um conjunto ordenado de valores numéricos que pode representar desde coordenadas espaciais até atributos de features — como nos casos de uso em machine learning e ciência de dados, em que vetores geralmente representam as características de objetos. O banco vetorial consegue armazenar e recuperar esses vetores de forma eficiente.
Imagem por Gary Alway
Embedding vetorial é o processo de representar objetos — como palavras, frases ou entidades — como vetores em um espaço contínuo. Essa técnica é usada para converter dados categóricos e de alta dimensão em vetores contínuos e de menor dimensão, que podem ser usados de forma mais eficaz por algoritmos de machine learning. Embeddings vetoriais são especialmente populares em processamento de linguagem natural (NLP), onde servem para representar palavras ou expressões.
A ideia principal por trás de embeddings é capturar relações semânticas entre objetos. No contexto de embeddings de palavras, por exemplo, termos com significados semelhantes são representados por vetores próximos no espaço vetorial. Isso permite que modelos de machine learning entendam melhor as relações contextuais e semânticas entre palavras.
Aproveitando o conceito de embeddings vetoriais, Large Language Models (LLMs) utilizam essas representações numéricas para resolver tarefas complexas de compreensão e geração de linguagem.
Como exemplo concreto, a arquitetura do modelo por trás do chat GTP envolve o uso de vetores. O modelo processa dados de entrada, como texto, convertendo-os em vetores numéricos.
Esses vetores capturam informações semânticas e contextuais da entrada, permitindo que o modelo entenda e gere respostas coerentes e relevantes para o contexto. A arquitetura Transformer, sobre a qual o GPT-3.5 é construído, utiliza mecanismos de self-attention para ponderar a importância de diferentes palavras em uma sequência, aprimorando ainda mais a capacidade do modelo de capturar relações e contexto.
Self-attention se refere à capacidade do modelo de atribuir diferentes graus de importância às palavras dentro da sequência de entrada.
Em resumo, o modelo GPT-3.5 opera sobre representações vetorizadas da linguagem para executar várias tarefas de compreensão e geração de texto. Essa abordagem baseada em vetores é um dos fatores-chave do sucesso do modelo em uma ampla gama de aplicações relacionadas à linguagem.
PG Vector é uma busca por similaridade vetorial open source para Postgres. Vamos direto ao ponto e criar um banco com Docker. Crie um arquivo chamado docker-compose.yml e, no terminal, rode: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
O próximo passo é criar uma tabela, e neste exemplo vamos catalogar os recursos de aprendizado da DataCamp, incluindo courses, blogs, tutorials, podcasts, cheat sheets, code alongs e certifications.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
A coluna embedding será gerada a partir de um objeto JSON em string que representa os atributos do recurso { name, content, slug, type }. Para criar esse embedding vetorial, vamos usar um modelo de embedding.
Um desses modelos disponível no AWS Bedrock é o amazon.titan-embed-text-v1. A configuração do Bedrock não é tratada neste artigo; é apenas um exemplo entre muitos modelos de embedding capazes de obter resultados semelhantes. O objetivo principal é receber um texto de entrada, usar um modelo de embedding para gerar vetores e então armazená-los na coluna embedding.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]Com a capacidade de armazenar dados junto de seus embeddings vetoriais, desbloqueamos o poder dos bancos vetoriais, permitindo interações em linguagem natural com o banco e a recuperação de resultados realmente relevantes.
Basta formular qualquer pergunta que você queira “fazer aos seus dados” e aplicar o mesmo embedding a esse texto. Veja como fica a consulta em SQL:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Essa consulta utiliza uma busca por similaridade cosseno. O parâmetro $1 representa o embedding resultante do texto da sua pergunta de entrada, enquanto o parâmetro $2, que funciona como um limite de similaridade, é uma variável que vale a pena experimentar. Seu valor ideal depende de fatores como o tamanho do seu dataset e o nível de relevância desejado, definindo a granularidade das informações recuperadas.
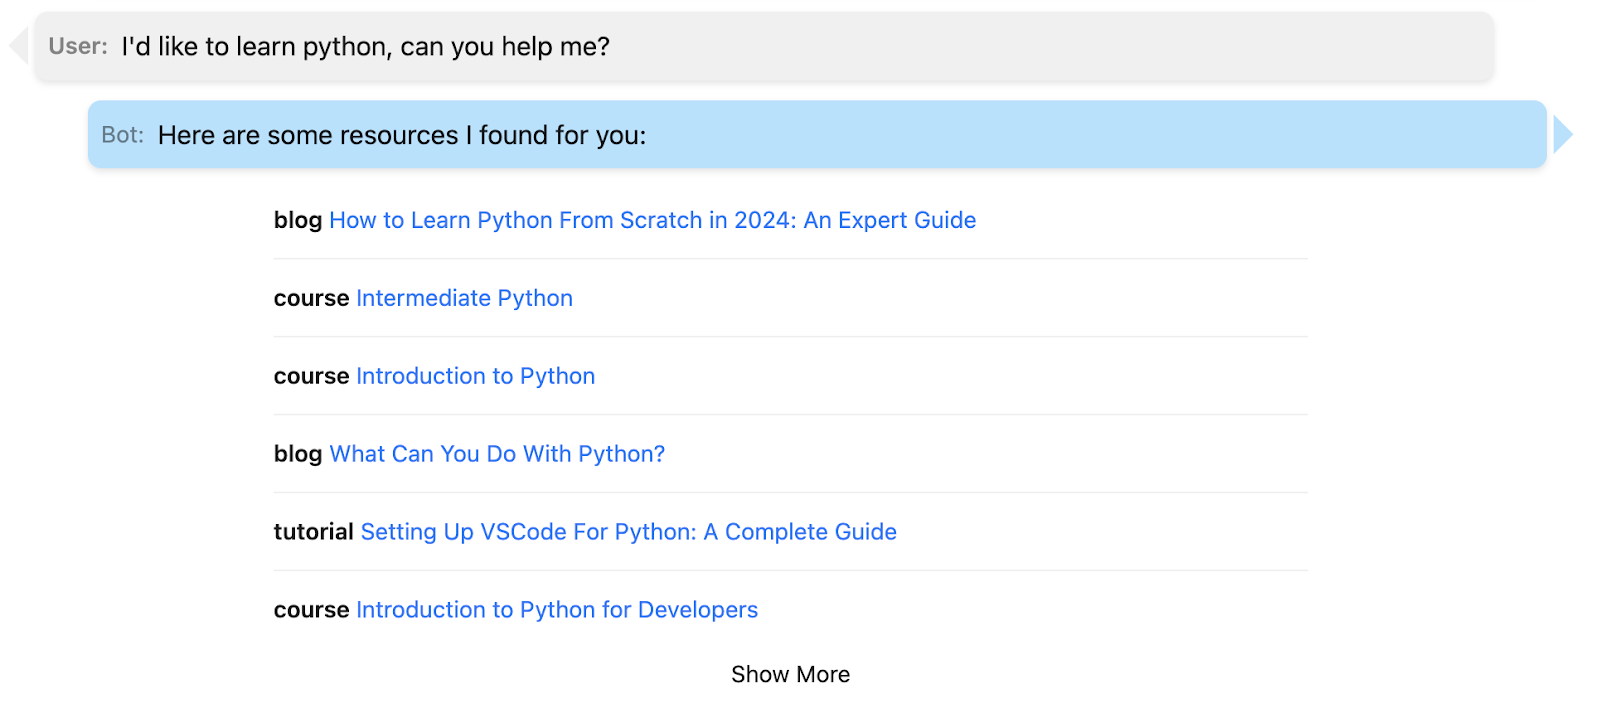
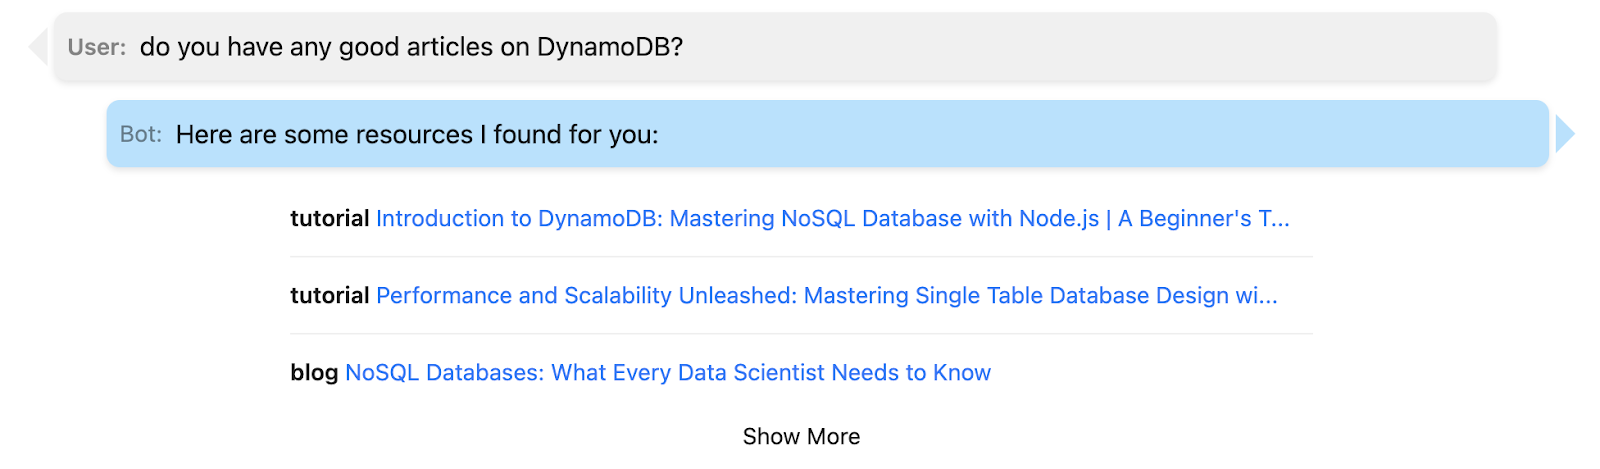
Com tudo isso pronto, criar uma interface no estilo chat fica simples. Os detalhes de implementação fogem ao escopo deste artigo, mas aqui vão alguns exemplos usando meu dataset da DataCamp, que inclui mais de 600 registros:
Neste artigo, exploramos o universo dos bancos de dados vetoriais, usando o PG Vector para potencializar nossas capacidades de armazenamento e busca. Ao iniciar sua jornada com embeddings, há muito mais para descobrir. Para se aprofundar no PG Vector, confira o readme, que traz mais detalhes e links para clientes na sua linguagem favorita.
Um passo natural após entender embeddings vetoriais é o Retrieval Augmented Generation (RAG). Esse é o processo de injetar dados contextuais em Large Language Models (LLMs). Assim, o RAG fornece ao modelo conhecimento além de seus dados de treino, viabilizando respostas mais informadas e alinhadas ao contexto.
Você também encontra diversos recursos da DataCamp que abordam outros aspectos de bancos vetoriais, incluindo:
Bom código — e que suas aventuras com vetores sejam sempre reveladoras e recompensadoras!
Continue sua jornada com vetores hoje mesmo!
Curso
Curso
Curso
blog
Moez Ali
14 min
blog
Kurtis Pykes
11 min
blog
Tutorial
Kurtis Pykes
13 min
Tutorial
Moez Ali
10 min
Tutorial
DataCamp Team
3 min