Kurs
KI-Anwendungen mit Pinecone entwickeln
3 Std.
11.6K
Im Kern ist eine Vektordatenbank ein speziell entwickeltes System zur Speicherung und zum Abruf von Vektordaten. Ein Vektor ist dabei eine geordnete Menge numerischer Werte, die alles Mögliche repräsentieren kann – von Raumkoordinaten bis hin zu Merkmalsattributen. In Machine-Learning- und Data-Science-Anwendungen werden Vektoren häufig verwendet, um die Merkmale von Objekten abzubilden. Die Vektordatenbank kann diese Merkmalsvektoren effizient speichern und wiederfinden.
Bild von Gary Alway
Vektoreinbettung (Vector Embedding) ist der Prozess, Objekte wie Wörter, Sätze oder Entitäten als Vektoren in einem kontinuierlichen Vektorraum darzustellen. Diese Technik wird häufig genutzt, um hochdimensionale und kategoriale Daten in kontinuierliche, niedrigdimensionale Vektoren zu überführen, die von Machine-Learning-Algorithmen deutlich besser verarbeitet werden können. Besonders verbreitet sind Vektoreinbettungen in der natürlichen Sprachverarbeitung (NLP), wo sie Wörter oder Phrasen repräsentieren.
Die Grundidee hinter Vektoreinbettungen ist, semantische Beziehungen zwischen Objekten abzubilden. Bei Wort-Einbettungen beispielsweise liegen Vektoren für Wörter mit ähnlicher Bedeutung näher beieinander. So können ML-Modelle kontextuelle und semantische Zusammenhänge zwischen Wörtern besser erfassen.
Aufbauend auf dem Konzept der Vektoreinbettungen nutzen Large Language Models (LLMs) diese numerischen Repräsentationen, um komplexe Aufgaben des Sprachverstehens und der Textgenerierung zu lösen.
Als konkretes Beispiel arbeitet die zugrunde liegende Architektur des Modells für ChatGPT mit Vektoren. Das Modell verarbeitet Eingaben wie Text, indem es sie in numerische Vektoren umwandelt.
Diese Vektoren erfassen semantische und kontextuelle Informationen der Eingabe, sodass das Modell zusammenhängende und kontextrelevante Antworten verstehen und erzeugen kann. Die Transformer-Architektur, auf der GPT-3.5 basiert, nutzt Self-Attention-Mechanismen, um die Bedeutung einzelner Wörter innerhalb einer Sequenz zu gewichten und so Beziehungen und Kontext noch besser einzufangen.
„Self-Attention“ beschreibt die Fähigkeit des Modells, unterschiedlichen Wörtern in der Eingabesequenz unterschiedliche Wichtigkeit zuzuweisen.
Kurz gesagt: Das GPT-3.5-Modell arbeitet mit vektorisierten Sprachrepräsentationen, um verschiedene Aufgaben der Sprachverarbeitung und -generierung auszuführen. Dieser vektorbasiere Ansatz ist ein wesentlicher Erfolgsfaktor des Modells in zahlreichen sprachbezogenen Anwendungen.
PG Vector ist eine Open-Source-Lösung für Vektor-Ähnlichkeitssuche in Postgres. Lass uns direkt einsteigen und mit Docker eine Datenbank erstellen. Lege eine Datei namens docker-compose.yml an und führe anschließend in der Kommandozeile folgenden Befehl aus: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
Als Nächstes erstellen wir eine Tabelle. In diesem Beispiel katalogisieren wir DataCamp-Lernressourcen, darunter Kurse, Blogs, Tutorials, Podcasts, Cheat Sheets, Code Alongs und Zertifizierungen.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
Die Spalte embedding wird aus einem als String serialisierten JSON-Objekt mit den Ressourcenattributen { name, content, slug, type } erzeugt. Um diese Vektoreinbettung zu erstellen, verwenden wir ein Embedding-Modell.
Ein solches Modell auf AWS Bedrock ist amazon.titan-embed-text-v1. Die Konfiguration von Bedrock behandeln wir hier nicht; das ist nur ein Beispiel für eines von vielen Embedding-Modellen mit ähnlicher Leistungsfähigkeit. Das Hauptziel ist, Texteingaben zu nehmen, mit einem Embedding-Modell Vektoreinbettungen zu erzeugen und diese dann in der Spalte embedding zu speichern.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]Indem wir Daten zusammen mit ihren Vektoreinbettungen speichern, entfalten wir die Stärken von Vektordatenbanken: Wir können in natürlicher Sprache mit unserer Datenbank „sprechen“ und dabei mühelos relevante Ergebnisse abrufen.
Formuliere einfach eine Frage, die du „an deine Daten“ stellen möchtest, und wende dieselbe Einbettung auf diesen Text an. So sieht die entsprechende SQL-Abfrage aus:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Diese Abfrage nutzt eine Kosinus-Ähnlichkeit-Suche. Parameter $1 ist das Embedding-Ergebnis deines Eingabetexts für die Frage. Parameter $2 dient als Ähnlichkeitsschwelle und sollte experimentell bestimmt werden. Der optimale Wert hängt unter anderem von der Größe deines Datensatzes und dem gewünschten Relevanzniveau ab und beeinflusst die Granularität der zurückgegebenen Informationen.
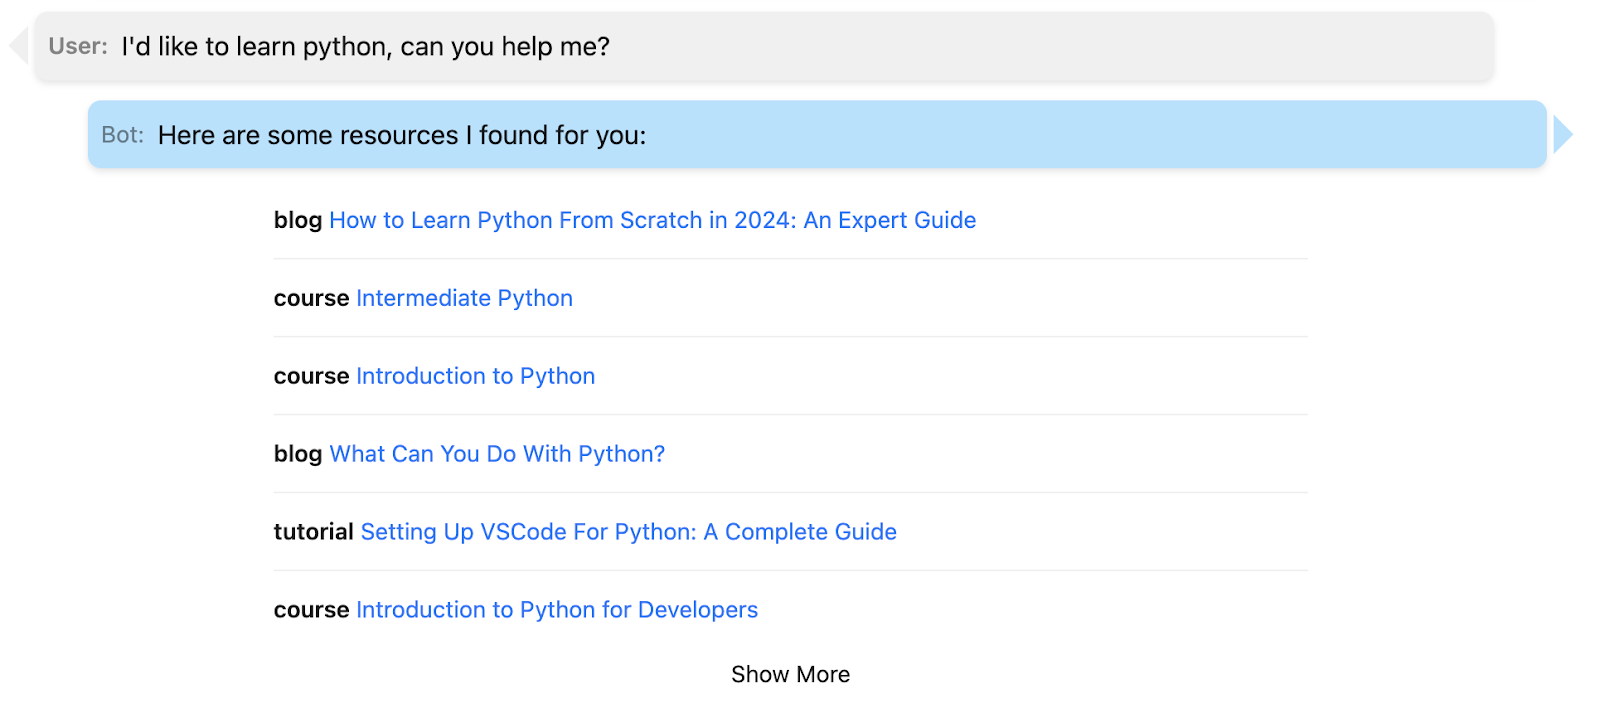
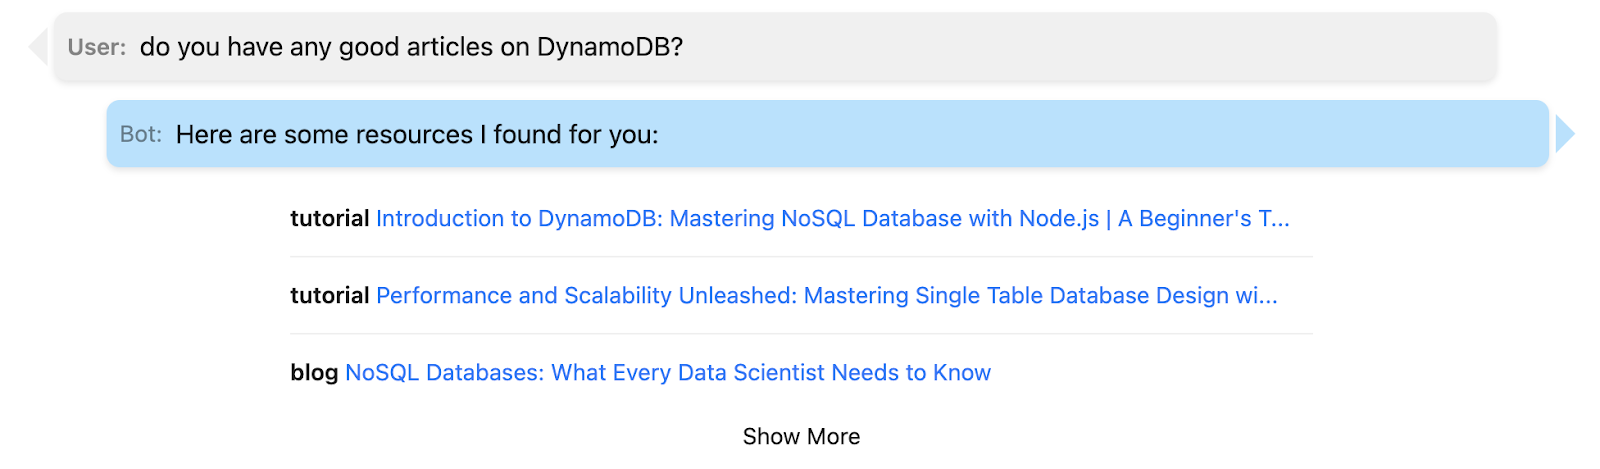
Sind all diese Bausteine vorhanden, lässt sich eine Chat-ähnliche Oberfläche leicht umsetzen. Die konkrete Implementierung sprengt den Rahmen dieses Artikels, aber hier sind einige Beispiele mit meinem DataCamp-Datensatz, der über 600 Einträge umfasst:
In diesem Artikel haben wir die Welt der Vektordatenbanken erkundet und mit PG Vector unsere Möglichkeiten zur Datenspeicherung und -abfrage erweitert. Wenn du in das Thema Vektoreinbettungen einsteigst, gibt es noch viel zu entdecken. Für einen tieferen Einstieg in PG Vector empfiehlt sich das Readme mit weiteren Details und Links zu Clients für deine bevorzugte Programmiersprache.
Ein naheliegender nächster Schritt nach dem Verständnis von Vektoreinbettungen ist Retrieval Augmented Generation (RAG). Dabei werden Large Language Models (LLMs) mit zusätzlichem Kontext angereichert. So erhält das Modell Wissen außerhalb seiner Trainingsdaten und kann fundiertere, kontextuell passendere Antworten liefern.
Außerdem findest du bei DataCamp zahlreiche Ressourcen zu weiteren Aspekten von Vektordatenbanken, darunter:
Viel Spaß beim Coden – und auf erfolgreiche, erkenntnisreiche Projekte mit Vektoren!
Starte noch heute deine Vektor-Reise!
Kurs
Kurs
Kurs